Дата-центр с ИИ — крупный и сложный потребитель электроэнергии. Но управлять его энергопотреблением так же, как на сталелитейном заводе, не выйдет. Там схема понятная: нужно высвободить мощность — отключаем часть оборудования, теряем пропорционально на производстве, потом включаем обратно.
Какие механизмы привлекать вместо этого — непонятно. С ИИ все не так однозначно, как с конвейером. Вычислительная нагрузка постоянно меняется, задачи по-разному нагружают GPU, а низкая вычислительная активность отнюдь не означает отсутствие потребления электричества. Интуитивный подход — давайте для освобождения 20% мощности просто отключим 20% задач, которые это допускают, — не работает.
Исследователи из Университета Луизианы попытались оценить, сколько мощности крупный GPU-кластер действительно способен временно отдать энергосистеме. Выяснилось, что между «эти задачи можно отложить» и «эту мощность мы можем гарантированно отдать энергосистеме» лежит довольно большая пропасть. Гибкость дата-центра существенно меньше, чем может показаться. Причем чем дольше держится снижение мощности, тем менее оно гарантировано.
Зачем энергосети гибкость?
С развитием ИИ он будет есть все больше электричества. Прогнозируют, что к 2035 году мировое потребление энергии только ИИ-дата-центрами увеличится примерно в четыре раза. США и Китай останутся главными потребителями, на долю которых придется львиная доля всей вводимой ИИ-инфраструктуры.
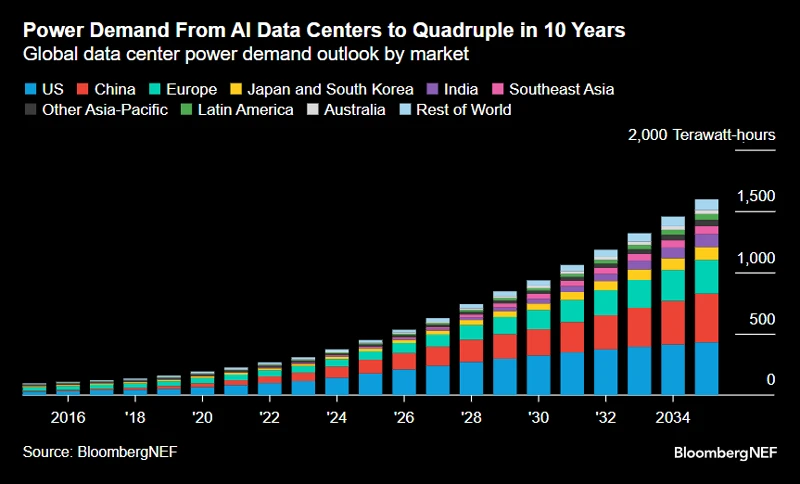
К 2030 году нагрузка на национальную энергетическую сеть США должна вырасти вдвое.
Обучение больших языковых моделей стоит миллионы долларов и длится месяцами. Но до стадии запуска отдельных электростанций под ИИ мы еще не дошли: дата-центры не существуют в энергетическом вакууме, приходится конкурировать за мощность с «обычными» потребителями.
Энергетические компании перераспределяют нагрузку по необходимости. Все включили кондиционеры или обогреватели — на обеспечение города требуется больше мощности (а ИИ, простите, подождет). Энергосистеме желательно иметь возможность временно уменьшить нагрузку хотя бы у части крупных потребителей. Так что если в критический момент дата-центр не ограничить, можно и блэкаут получить. И тогда встанет вообще все.
Принципы перераспределения нагрузки между потребителями отработаны на крупной промышленности. Если производство допускает паузу части процессов, предприятие может снизить потребление в нужный момент, а потом наверстать работу. Но можно ли применять те же подходы к ИИ-ЦОДам?
Допустим, в огромном GPU-кластере есть какая-то доля низкоприоритетных вычислений. Почему бы в момент дефицита мощности не поставить их на паузу, отдав энергию другим потребителям?
В работе Beyond Scalar Flexibility: From Eligible AI Workloads to Dependable Load Relief исследователи задались вопросом, сколько мощности можно освободить таким образом, если всё же беспокоиться о сохранности вычислений в ЦОД. Для этого они проанализировали реальные логи работы кластера из 155 410 GPU в течение 185 дней. У них в руках были сведения о выделенных и использованных GPU-часах, загрузке вычислительных блоков, типах задач, их приоритетах и других параметрах. Правда, там не оказалось непосредственных измерений энергопотребления объекта, поэтому пришлось построить математическую модель, которая восстанавливает потребляемую мощность GPU, хостов и остальной инфраструктуры.
Выводы получились довольно любопытные.
Вывод 1. Зависимость потребляемой мощности и нагрузки нелинейная
Если GPU загружен на 50%, это не значит, что он потребляет половину мощности. Исследование показало нелинейную зависимость потребляемой мощности от загрузки, то есть интуитивное сопоставление «50% загрузки — 50% мощности» не работает.
GPU потребляет электричество даже тогда, когда вычислительная загрузка невысокая. Плюс энергопотребление на самом деле зависит от типа задачи. Например, если никакого обучения не идет, а пользователь запрашивает что-то у модели онлайн, то в основном идет работа с памятью, загрузка GPU низкая, а потребление энергии высокое.
В целом только лишь GPU для оценки энергопотребления дата-центра недостаточно. Исследование показывает, что GPU дают лишь около 67% энергозатрат, еще около 31% приходится на хосты и связанные с ними компоненты. А после учета инфраструктуры и охлаждения общая мощность объекта становится еще выше.
По итогам анализа получилось:
29,37 МВт — GPU;
43,60 МВт — ИТ-инфраструктура;
52,32 МВт — весь объект с учетом охлаждения и прочих сопутствующих расходов.
То есть даже зная загрузку GPU (и тип рассчитываемой сейчас задачи), мы все равно не представляем, каково энергопотребление всего дата-центра.
Вывод 2. Усреднение мощности дает слишком большую ошибку
Это прямое следствие предыдущего пункта. Раз зависимость мощности от загрузки GPU нелинейная, усреднение даст слишком большую ошибку.
Допустим, GPU работает на 100% загрузки, но лишь половину времени. Это нельзя интерпретировать, как будто он загружен на 50% (и использовать это дальше в расчетах).
Потраченные кВт·ч для полной загрузки, но в течение половины времени, отличаются от кВт·ч, необходимых на половинную загрузку все время. Среднее от функции не равно функции от среднего. Конкретно в этой работе в стрессовом сценарии (при чередовании высокой и низкой загрузки) получилось завышение средней мощности на 22–25%.
Важное замечание: это не означает, что любой GPU всегда потребляет на 22–25% меньше, чем показывает усредненная модель. Стресс-тест был сконструирован только для демонстрации эффекта неосторожного усреднения.
В реальном дата-центре проблема еще интереснее: там одновременно считаются разные типы задач, каждая со своей зависимостью мощности от загрузки.
Вывод 3. Если мы отрубим 20% задач, то не освободим 20% мощности
Переходим непосредственно к гибкости.
Допустим, в ИИ-дата-центре есть 20% не очень критических задач, которые можно отложить в момент, когда энергосети важно сэкономить мощность. Но это не значит, что она получит 20% экономии.
Причина все та же: остановка вычислений не означает, что оборудование перестает потреблять энергию. GPU остается включенным, и его базовое потребление сохраняется. В таком сценарии мы убираем только активную часть мощности.
Авторы упомянутой статьи относят 20,39% мощности рабочей нагрузки к потенциально гибкому слою, то есть к задачам, которые можно поставить на паузу. Но если после прерывания этих задач GPU никто физически не отключает, сэкономленная мощность составит всего 6,35% медианной мощности объекта.
В подобных расчетах важно не путать:
долю задач некоторого типа;
долю мощности;
потенциально отключаемую мощность;
реальное снижение нагрузки на уровне всего объекта.
Это четыре очень разные цифры.
Вывод 4. Мы отключили задачи, получили какой-то выигрыш по мощности, но не можем удержать его долго
Предположим, мы все-таки смогли снизить нагрузку. Но на сколько времени мы можем включать такой «режим экономии»? Энергосистема вполне может запросить «потерпеть часа четыре, а то и сутки».
Выяснилось, что чем дольше период сниженного энергопотребления, тем меньше мощности на самом деле экономится.
Состав вычислительной нагрузки постоянно меняется. Низкоприоритетные задачи заканчиваются, новые запускаются, распределение работы между кластерами меняется. То, что было доступно для прерывания сейчас, через несколько часов может оказаться неактуальным.
В вычислительном эксперименте в первый час исследователи освобождали для энергосети 2,51 МВт, а на 24-й час оставалось только 1,95 МВт (рассчитывалась мощность, которую можно предоставить с 95%-й вероятностью в течение заданного периода). Для энергосети это плохая новость: если бы мы по этой средней оценке пообещали энергосистеме 2,51 МВт на 24 часа, то переоценили бы гибкость примерно на 47%.
Вывод 5. Объединение нескольких кластеров помогает перераспределять нагрузки, но не так эффективно, как хотелось бы
Еще одна интуитивная мысль: если один кластер ведет себя нестабильно, давайте соберем несколько. Если нагрузки независимы, их случайные колебания должны частично компенсировать друг друга. Один кластер сегодня загружен сильнее, другой слабее — в среднем портфель получается стабильнее, что лучше для энергосети.
И это сработало бы, если бы нагрузки были действительно независимы. На практике это не так: они могут реагировать на общие события и процессы (допустим, из планировщика), поэтому часть их нагрузки меняется согласованно. Так часть эффекта от объединения теряется.
Для описания надежности авторы используют показатель доступности: с какой вероятностью кластер способен предоставить заявленный объем снижения мощности. Например, показатель 0,656 означает, что заявленный показатель достигается в 65,6% наблюдаемых случаев. При этом сами значения мощности рассчитываются для уровня доступности 95%.
Объединение нескольких кластеров действительно помогает: чем их больше, тем стабильнее становится суммарная доступная мощность. Для одного кластера этот показатель составляет 0,378, а для 13 кластеров — уже 0,656. Но до идеального сценария все равно далеко. Если бы кластеры были полностью независимы, модель дала бы 0,729.
Вывод 6. Прерывание и повторный запуск задач тоже чего-то стоят
Допустим, часть задач мы отключили и действительно смогли снизить энергопотребление на нужный период времени. Энергосистема выстояла, все довольны. Но задачи в ИИ-дата-центре не исчезают в никуда. То, что мы отложили, придется выполнить позже.
Исследование показало, что после восстановления мощности суммарное энергопотребление может стать выше: это неизбежные затраты на перезапуск задач, повтор части уже выполненных вычислений. Авторы работы предложили довольно синтетический метод оценки, насколько растут затраты — конкретная цифра, на мой взгляд, не несет практической пользы. Но важен вывод: управление мощностью и экономия энергии — очень разные задачи.
Исследование не дает простого ответа на вопрос, сколько мощности может временно отдать ИИ-дата-центр. Вместо этого оно показывает довольно сложную картину: гибкость энергопотребления зависит от характера нагрузки, длительности ограничения, надежности и того, как именно организовано управление вычислениями. Кому интересно — в статье достаточно формул, чтобы покопаться в этом глубже.
Практический вывод здесь, пожалуй, важнее конкретных цифр: при управлении ИИ-дата-центрами опасно полагаться на простые допущения. Они легко превращаются в заметные ошибки оценки. А привычные подходы к управлению промышленной нагрузкой напрямую сюда не переносятся.
Идея «просто отключим часть задач и сэкономим соответствующую долю мощности» не работает. Придется искать более сложные способы управлять нагрузкой — с учетом того, что именно сейчас считают GPU, на какое время можно отложить работу и какую мощность действительно удастся снять.



Комментарии 0