Пару дней назад я опубликовал в LinkedIn пост про ИИ-разработку и получил довольно неожиданный комментарий от одного руководителя разработки — мол, к ИИ-разработке он относится крайне скептически.
И причины такого скепсиса, в общем-то, понятны. Я вижу много ребят, которые попробовали ИИ-инструменты пару лет назад, когда эти инструменты ещё только придумывались, и остались совсем не впечатлены качеством — на выходе у них получился самый настоящий AI slop (от английского slop — помои), и с тех пор они так и придерживаются своего мнения. Код вроде бы собирается и даже проходит тесты, но написан он совсем не так, как у вас в команде принято, повторяет худшие места проекта и разваливается от первой же правки.
Почти год назад я ушёл с позиции технического директора в каршеринге Ситидрайв, чтобы полностью окунуться в агентскую разработку, и за этот год пришёл к выводу, что чаще всего виновата не модель, а репозиторий, который не подготовили для агента. В этой статье я расскажу, почему агенту в таком репозитории так сложно писать хороший код и что нужно сделать, чтобы слоп в нём больше не появлялся.
Сто комментариев на пул-реквест
Начну я с истории, которая случилась задолго до всяких агентов. Как-то, в 2019 году, я руководил разработкой «Такси ВКонтакте», где мы на платформе VK Mini Apps делали такси прямо внутри приложения соцсети. Проект был чисто фронтендный, код писали я и ещё один разработчик, и в какой-то момент мы наняли третьего — достаточно крепкого разработчика, который, правда, привык работать по совсем другим конвенциям, нежели мы.
Записанных правил у нас, конечно же, не было, и поэтому на его первые пул-реквесты мы накидывали очень много комментариев. Как-то раз мы оставили ему рекордные сто комментариев на пул-реквест в полторы тысячи строк. И нет, код в целом был понятный и рабочий, просто он полностью выбивался из тех практик, которых мы решили дальше придерживаться в этом репозитории. С каждым пул-реквестом комментариев становилось всё меньше, и где-то через десяток их уже можно было пересчитать по пальцам одной руки.
Но была и часть подходов, про которые ему было просто неоткуда узнать. Какие-то из них мы уже выработали, но держали только в голове, а от каких-то отказались, когда-то попробовав и обжёгшись, только вот в репозитории об этом не осталось никаких артефактов. Из кода видна лишь часть решений команды, а всё остальное живёт на встречах, в курилке, на перерывах и за совместными обедами в столовой.
Новичок, который каждое утро приходит впервые
А теперь представь, что этот разработчик каждое утро обнуляется. Вчера он получил свои сто комментариев и всё поправил, а сегодня, напрочь всё забыв, снова приносит код, который не соответствует ни одной вашей договорённости. Так вот, агент — это, по сути, тот же новичок, только ревьюить за ним одни и те же ошибки изо дня в день — весьма сомнительное и неблагодарное занятие.
Стоит понимать, что у самой модели вообще нет памяти, и при каждом запросе агент отправляет ей всю историю разговора целиком. Когда контекст заполняется, агент сжимает разговор, и подробные указания из начала сессии могут потеряться. Да и весь проект он в голове не держит, а видит только то, что сам нашёл и прочитал.
И вот к чему это приводит в обычном проекте:
допустим, у тебя сто модулей, последние десять ты пишешь идеально, а девяносто старых — легаси, которое ты потихоньку выпиливаешь. Агент про это ничего не знает и за образец возьмёт какой-нибудь из старых, а может, и самый первый, самый плохой;
интеграционные тесты в Java-проекте исторически лежат в своей папке и подключаются профилем, и вся команда давно запускает их как
mvn test -P integration. Агент запустит обычныйmvn test, Maven напишетNo tests to runи следомBUILD SUCCESS, и агент со спокойной душой решит, что тесты зелёные;только что записанные данные у вас читают с мастера, потому что до реплики запись может доехать с лагом. Новичка поправят на ревью один раз, а агент будет наступать на те же грабли в каждой новой сессии.
Тут важно ещё понимать, что ошибки у агента сейчас уже не синтаксические, а смысловые. Код собирается, выглядит правильным и проходит простые тесты, но построен он на неверном допущении — агент не так понял бизнес-логику, не переспросил там, где задача была неясной, или просто пропустил edge case. И найти такую ошибку куда сложнее, чем упавшую сборку, ведь на ревью её легко пропустить.
Получается, что агента нужно онбордить точно так же, как новичка, только из сессии в сессию он помнит лишь то, что записано в файлах репозитория, поэтому и учить его приходится через сам репозиторий.
Записать то, что знает команда
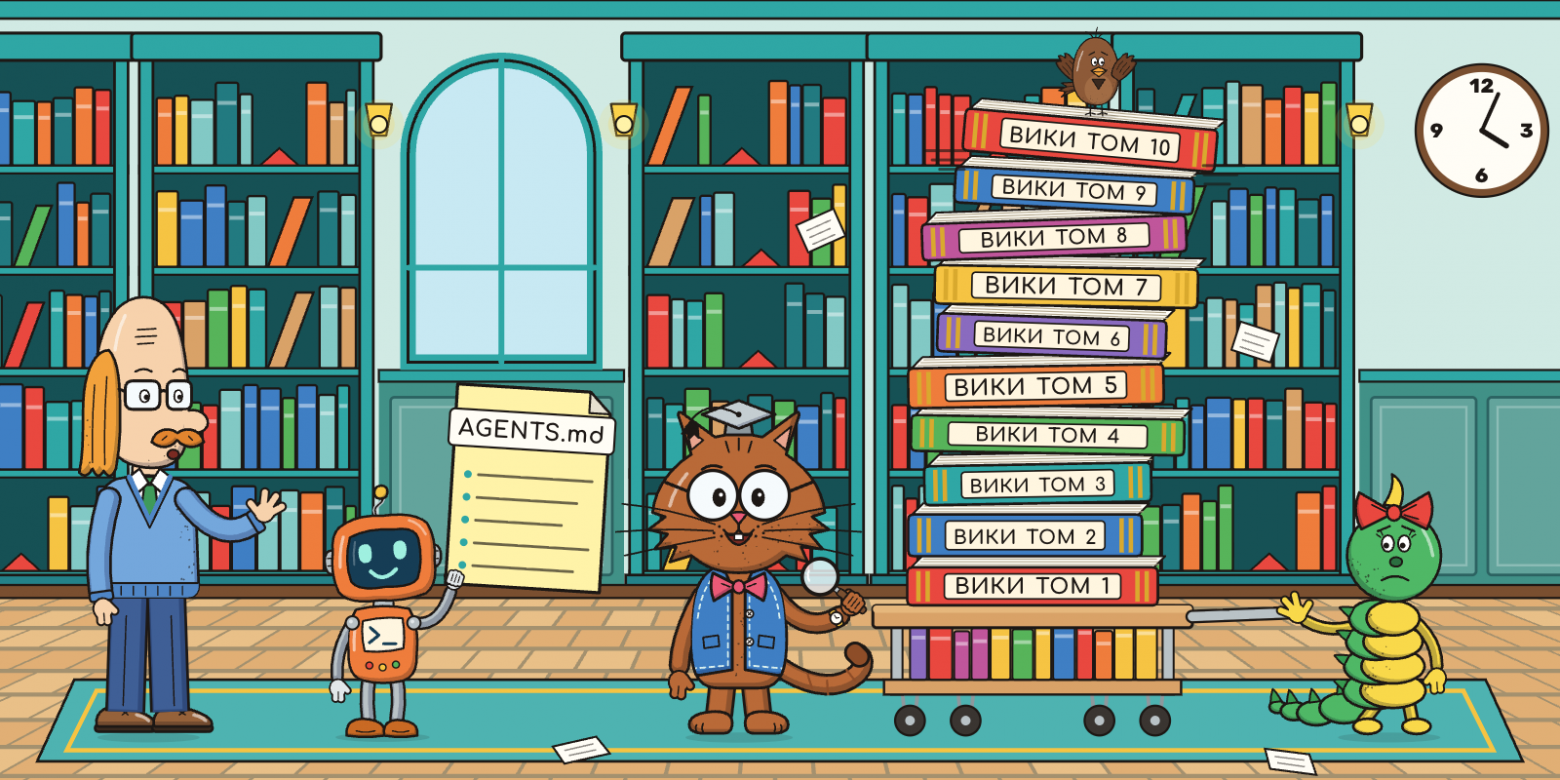
Когда-то давно я пришёл работать в Mail.ru Group, и мне, как и каждому новичку, дали конверт с письмом на одну страничку с полезной информацией — там был адрес интранета, временный пароль от почты, этаж, на котором сидит техподдержка, и где находится столовая. По сути, это и был мой AGENTS.md — файл в корне репозитория, который агент читает в начале каждой сессии и который сейчас понимают и Claude Code, и Codex, и другие агенты.
И выглядеть он должен ровно так же, как тот листочек А4, то есть быть шпаргалкой новичка на пару сотен строк, а не вики-страницей на пятьдесят листов. В нём лежит то, что нужно почти в каждой задаче и чего агент сам в коде не найдёт:
что это за репозиторий и из чего он состоит — в пяти строках;
где что лежит и за чем в какую папку идти;
команды сборки и тестов;
договорённости, которые живут у команды в головах;
словарик терминов, которыми пользуется только ваша команда.
При этом нет никакого смысла в документации, которая пересказывает код. Рано или поздно она разойдётся с кодом, и ты сам себе выстрелишь в ногу, сделав два источника правды, хотя источник правды у тебя один — код, который работает на продакшене.
Самый лучший способ собрать все накопленные командой знания — попросить агента собрать все комментарии к пул-реквестам за последний год. Останется только проревьюить этот список и оставить то, что ещё актуально, и на этих граблях агент станет спотыкаться гораздо реже.
А если агент ошибся не в правиле, а в задаче из нескольких шагов, например в том, как у вас заводят фича-флаг, и в следующий раз снова сделал так же, — это уже повод написать скилл, то есть инструкцию, которую агент подгружает, когда она ему нужна. Садиться и писать скилл с нуля тоже нет смысла: лучше выполни с агентом какую-нибудь типовую задачу и попроси его в этой же сессии собрать всё, что вы делали, и описать это по шагам в виде скилла.
Дать агенту увидеть результат своей работы
Хорошая практика для разработчика — после того как код написан, протестировать и отладить его, и агент тут должен придерживаться ровно такой же практики, только для этого ему нужна полноценная среда, где все эти проверки можно выполнить. Если проект небольшой и его можно развернуть локально, агент будет делать это локально, и тут главное — дать ему чёткую и понятную инструкцию, как этот проект собирать и разворачивать.
Конечно, хорошо, если бы у тебя была одна консольная команда, которая собирает проект полностью, но если сборка — это цепочка команд, то это тоже не беда, важно, чтобы она каждый раз давала один и тот же результат. В этом случае ты можешь записать эту цепочку в виде консольного скрипта, ведь текст инструкции агент каждый раз читает заново и может понять немного по-своему, а скрипт выполняется всегда одинаково.
Если же проект слишком большой и целиком локально его не собрать, понадобится превью-стенд — отдельное окружение, где твоя ветка работает вместе со всем проектом. Vercel, Netlify, GitLab с его Review Apps и Argo CD умеют поднимать такие стенды на пул-реквест, и остаётся только научить агента забирать из пул-реквеста динамический адрес стенда. А дальше он и сам протестирует то, что написал, — дёрнет эндпоинты и посмотрит, как поменялись данные в базе, или откроет браузер и прокликает всё по тест-кейсам.
Проверять, а не просить
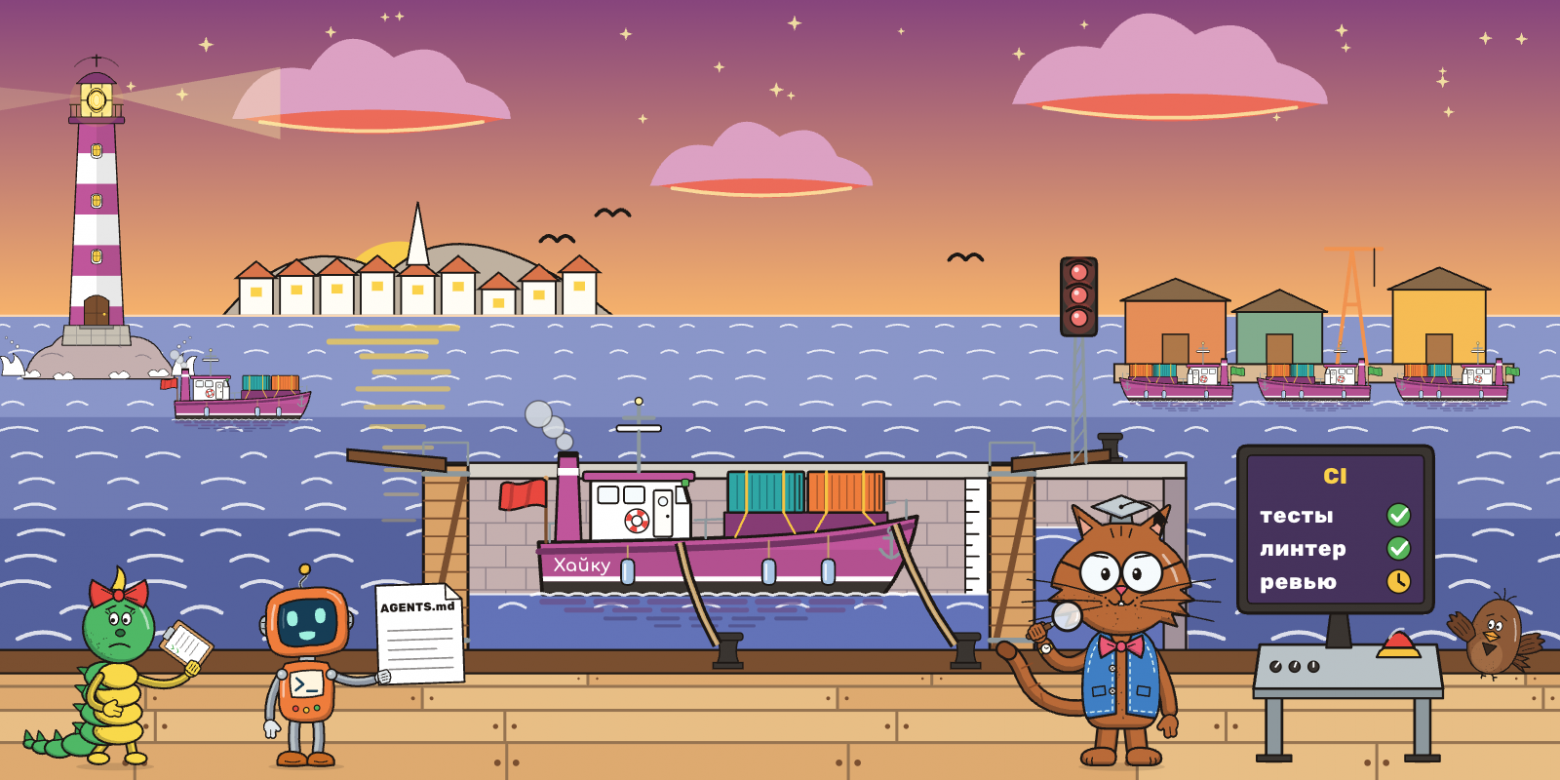
Любое правило в AGENTS.md для агента — это просьба, а не гарантия, ведь он может его не выполнить, а может и потерять, когда контекст сожмётся. Поэтому всё, что можно проверить программой, стоит проверять программой, и тут работают все те же практики, которыми мы годами пользовались, когда код мы с тобой писали руками:
сначала тест, потом код. Когда тест падает, у агента есть соблазн подогнать под код сам тест, и вот чтобы у него не было такого соблазна, нужно делать наоборот — просить его сначала писать тест, а уже потом код;
линтеры, которые объясняют, как исправить. То же правило про мастер и реплику можно записать строчкой в
AGENTS.md, а можно написать правило линтера, которое не пропустит чтение из реплики сразу после записи. И если в тексте ошибки написать, почему так нельзя и как это исправить, агент быстро поймёт, что нужно поменять;хуки. Claude Code может сам запускать линтер после каждой правки файла, хочет того модель или нет, и агент узнает об ошибке сразу, а не от ревьюера;
CI, без которого не смержить. Пул-реквест нельзя смержить, пока не прошли все обязательные проверки, и агент не должен уметь этот барьер обойти, поэтому конфиги CI и тесты меняются только с аппрувом их владельцев из
CODEOWNERS. А все проверки стоит укладывать в 20–30 минут, иначе CI уничтожит всю ту скорость, которую привносят агенты.
С ревью тоже всё поменялось. Раньше разработчик закрывал три-четыре задачи в неделю, а теперь может закрывать по три-четыре в день, и прочитать весь этот код строчка за строчкой уже физически невозможно. Поэтому один агент пишет код, а другой в свежей сессии его ревьюит, ведь тот, кто писал, помнит, что и зачем собирался сделать, и проверяет код с тем же контекстом, с которым его писал. Человеческое же внимание нужно там, где принятые решения потом сложно будет повернуть назад, — на схему базы данных, права доступа, безопасность и архитектуру, а чтобы не искать эти места в диффе на 20 тысяч строк, агент должен сам выносить ключевые решения в описание пул-реквеста.
Не дать агенту всё сломать
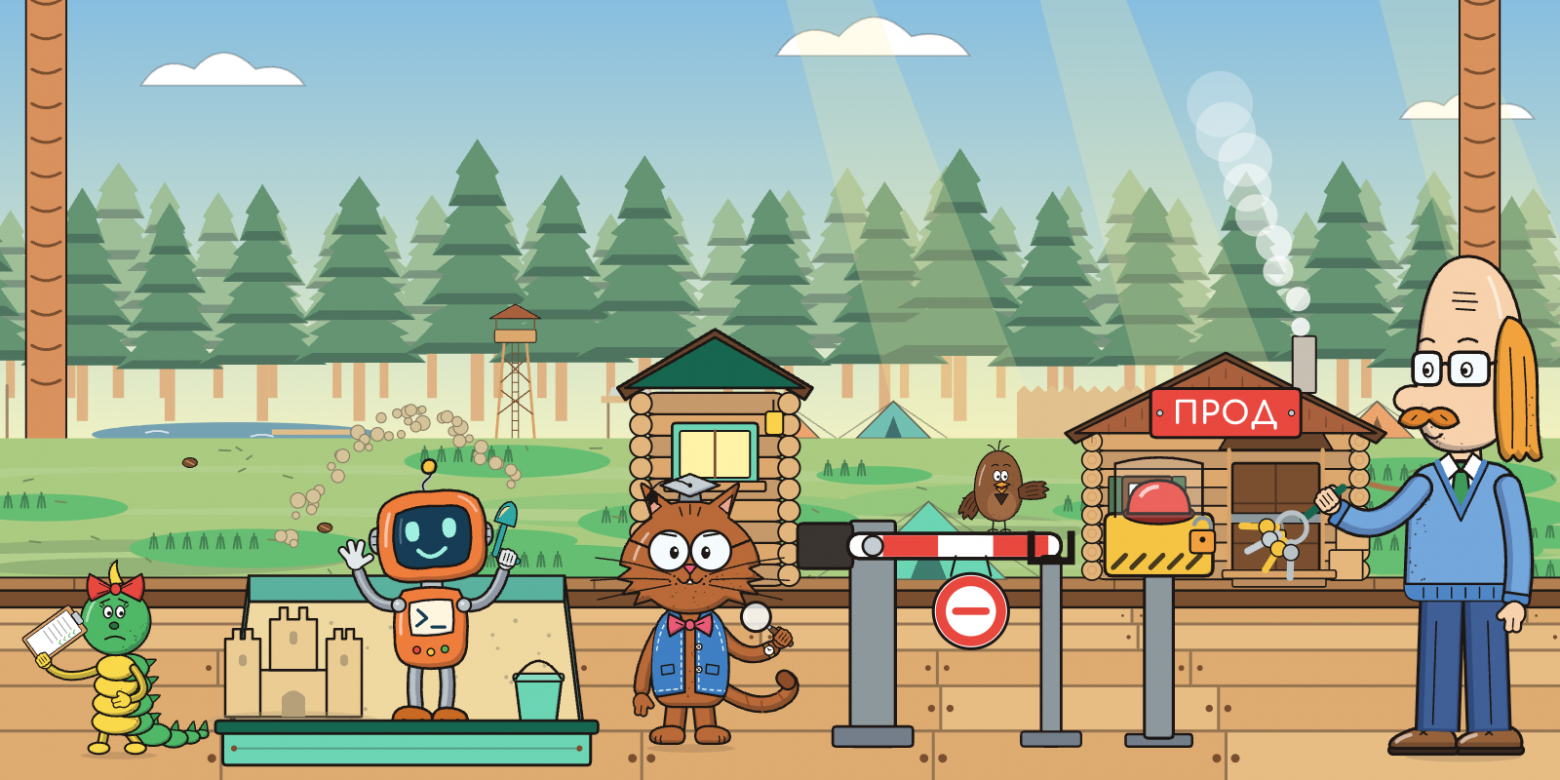
Всё, что ты сам можешь выполнить в своём терминале, доступно и твоему агенту, и если он что-то сломает, отвечать за это будешь ты, ведь агент действует от твоего имени. При этом бояться стоит не столько самого агента, сколько вредоносного кода, например из заражённой библиотеки, которую агент установит и запустит с твоими правами. Защищаться от этого можно на разных уровнях, и надёжность у них очень разная:
надёжнее всего, когда у компьютера, на котором работает агент, просто нет доступа к проду;
в песочнице или контейнере агенту можно разрешить вообще всё и не подтверждать каждую его команду, ведь за их пределами он ничего не тронет;
всё, что касается прода, агент делает только после твоего разрешения — останавливается, показывает команду и её риски и ничего не выполняет, пока ты не скажешь «да». И держится это не на просьбе в
AGENTS.md, а на хуках, которые проверяют каждую команду ещё перед тем, как агент её выполнит.
С чего начать сегодня
Чтобы понять, как агент ориентируется в твоём репозитории прямо сейчас, спроси его про ту часть проекта, которую ты сам знаешь лучше всех:
Где в этом репозитории лежит код, который отвечает за <что ищем>?
Покажи файлы и коротко объясни, как это устроено.
И посмотри, какие команды поиска он запускал, какие файлы открывал и сколько кругов ему пришлось сделать, чтобы добраться до ответа. Всё, что он искал слишком долго или нашёл неправильно, и станет первыми строчками твоего AGENTS.md.
Это только начало
Всё, что мы тут с тобой разобрали, — это самые базовые вещи. Я развил эту тему дальше и в итоге написал целую книгу, «Методичка профессора Фортрана. Как построить Agentic SDLC в своём репозитории», где каждый шаг разобран подробно, с примерами и промптами, проверенными на настоящих open-source проектах. Там и про то, как писать AGENTS.md и скиллы, и как устроить CI и ревью, когда код пишут агенты, и как сделать так, чтобы на проде агент ничего не делал без твоего разрешения, и как теперь выглядит вся разработка — от запроса до прода.
Книга бесплатная, и её свежая версия всегда лежит на GitHub: https://github.com/pulyavin/agentic-sdlc
Хорошего чтения! 😎


Комментарии 0