Машинное обучение без математики возможно на уровне использования готовых алгоритмов, но для понимания их работы и настройки моделей нужна математическая база. При этом начинать с полного университетского курса необязательно.
Нерсес Багиян, руководитель направления продвинутой аналитики в Raiffeisen CIB, преподаватель машинного обучения в НИУ ВШЭ и Karpov.Courses, отмечает:
«Если вы знаете школьную математику, условно, уровень 10–11 класса, вам этого будет достаточно».
Речь шла о подготовке для начала обучения. Сюда входит:
Арифметика. Операции с числами, возведение в степень и извлечение корня.
Уравнения. Решение квадратных уравнений и систем уравнений.
Функции. Построение графиков, понимание линейных, логарифмических, экспоненциальных и тригонометрических функций.
Векторы. Базовые линейные операции и вычисление скалярного произведения.
Привет, Хабр! Мы — Karpov.Courses, онлайн-школа, где обучают аналитике данных, ML и программированию. Давайте разберём математические основы машинного обучения на практических примерах: от векторов и производных до градиентного спуска и статистики. Выясним, какие знания необходимы на старте, а что можно освоить позже.
Коротко: какая математика нужна для машинного обучения
Алексей Биршерт, преподаватель Karpov.Courses и руководитель ML-команды, уточняет:
«Чем лучше вы знаете математику, чем лучше вы знаете линейную алгебру, матанализ, тем легче вам будет понять алгоритмы машинного обучения».
Начинающему ML-инженеру важно последовательно освоить четыре направления: линейную алгебру, математический анализ, теорию вероятностей и статистику, а также основы оптимизации.
Раздел | Нужно знать | Можно изучить позже |
Линейная алгебра | Векторы, матрицы, скалярное произведение, нормы, матричное умножение | Собственные числа, SVD, спектральные методы |
Математический анализ | Функции, производные, частные производные, градиент, правило цепочки | Матричное дифференцирование, сложные многомерные преобразования |
Теория вероятностей и статистика | Условные вероятности, ожидание, дисперсия, основные распределения, выборки и гипотезы | Теория меры, сложные вероятностные модели |
Оптимизация | Функция потерь, градиентный спуск, скорость обучения | Оптимизация второго порядка, доказательства сходимости |
Всё связано между собой. Например, простая модель получает данные в виде вектора, вычисляет предсказание с помощью умножения чисел, оценивает ошибку и изменяет параметры, чтобы уменьшить её.
Линейная алгебра: как представить данные в виде чисел
Предположим, мы разрабатываем рекомендательную систему музыкального сервиса. Нужно определить, какие треки могут заинтересовать пользователя.
Для этого необходимо математически представить его предпочтения и характеристики музыки. Пусть каждый трек описывается двумя числовыми признаками:
первый условно отражает принадлежность к року,
второй — к электронике.
Предпочтения пользователя тоже можно описать двумя числами. Так мы перейдём от слов к вычислениям.
Векторы и матрицы: как модель работает с признаками
Вектор — упорядоченный набор чисел. В машинном обучении его элементы часто соответствуют признакам объекта или компонентам числового представления.
Запишем предпочтения пользователя как вектор:

Первая координата обозначает вес первого музыкального признака, вторая — второго.
Теперь представим два трека:
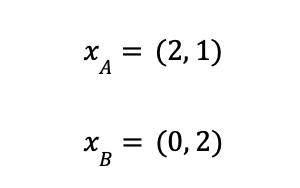
Объединим признаки треков в матрицу:
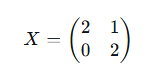
Каждая строка соответствует одному треку, а каждый столбец — определённому признаку. Размерность нашей матрицы — 2×2. В реальных задачах она может содержать миллионы строк и тысячи признаков.
Чтобы получить оценку трека, воспользуемся простой линейной моделью:
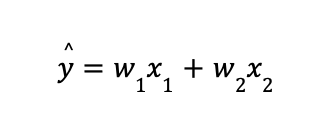
Здесь x1,x2 — признаки трека, w1,w2 — веса модели, а — предсказанная оценка.
Для трека A:
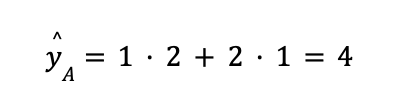
Для трека B:
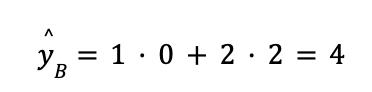
Оба трека получили одинаковую оценку. Эту операцию называют скалярным произведением векторов.
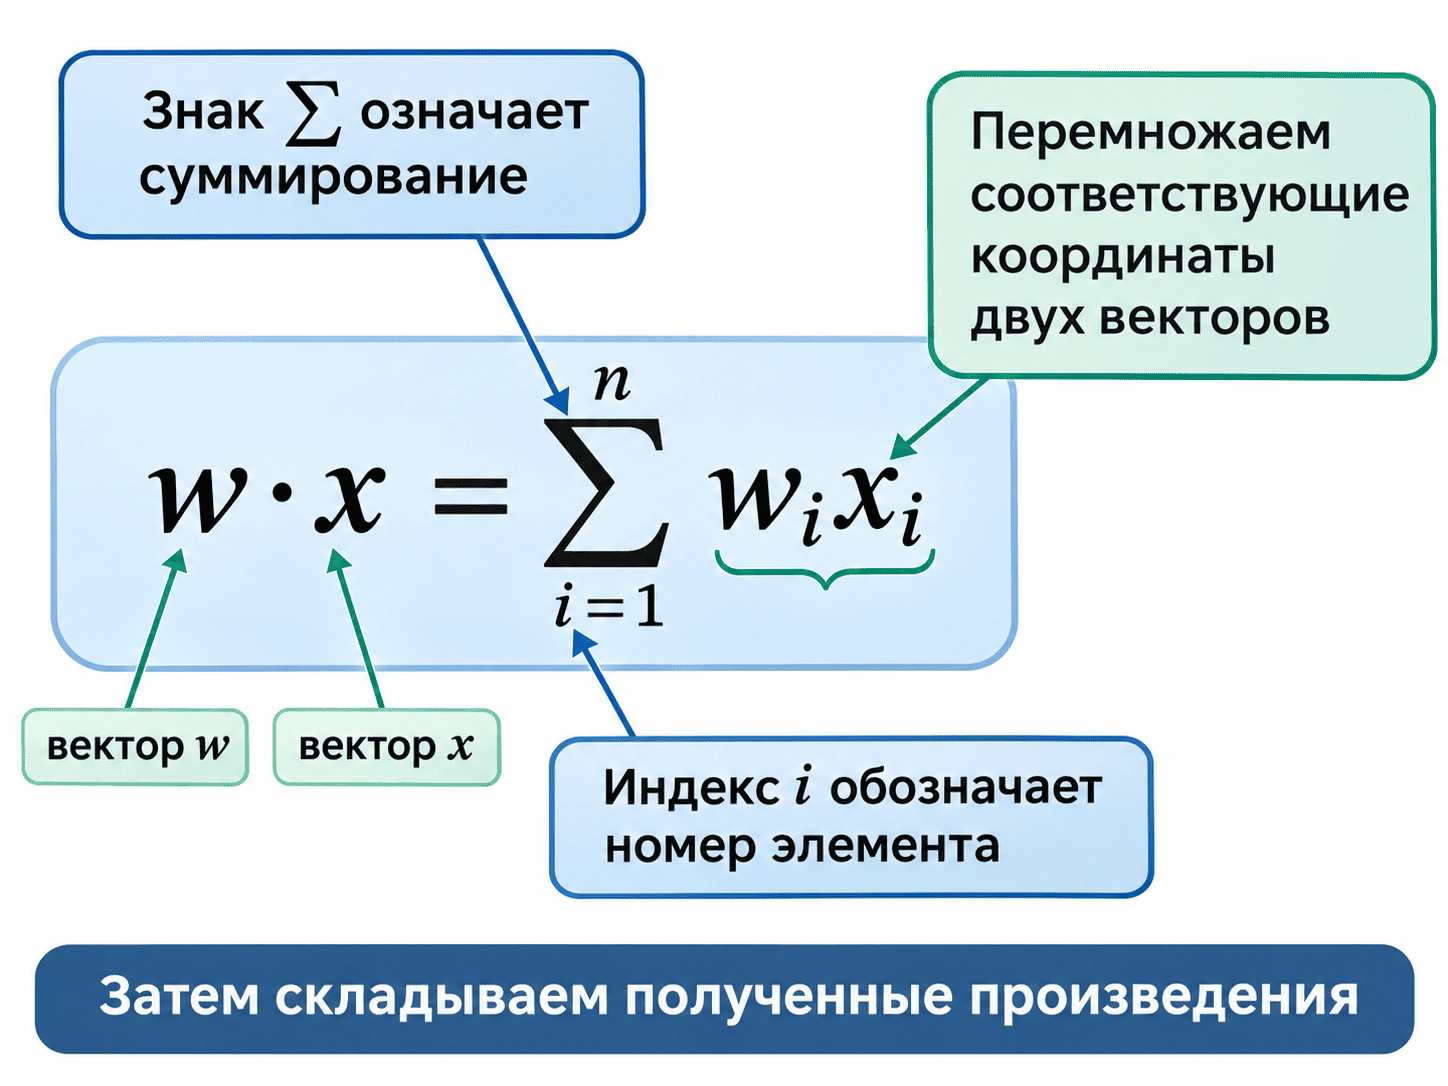
Для нескольких объектов вычисления можно выполнить одновременно:
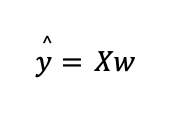
На Python это выглядит так:
import numpy as np

X = np.array([
    [2, 1],
    [0, 2]
])

w = np.array([1, 2])

predictions = X @ w

print(predictions)
# [4 4]
Оператор @ выполняет матричное умножение.
Это базовый пример, как линейная алгебра используется в ML: данные хранятся в числовом виде, а модель применяет к ним математические преобразования.
Скалярное произведение и косинусное сходство: как сравнивать объекты
Скалярное произведение можно использовать не только для вычисления оценок, но и как составную часть мер сходства.
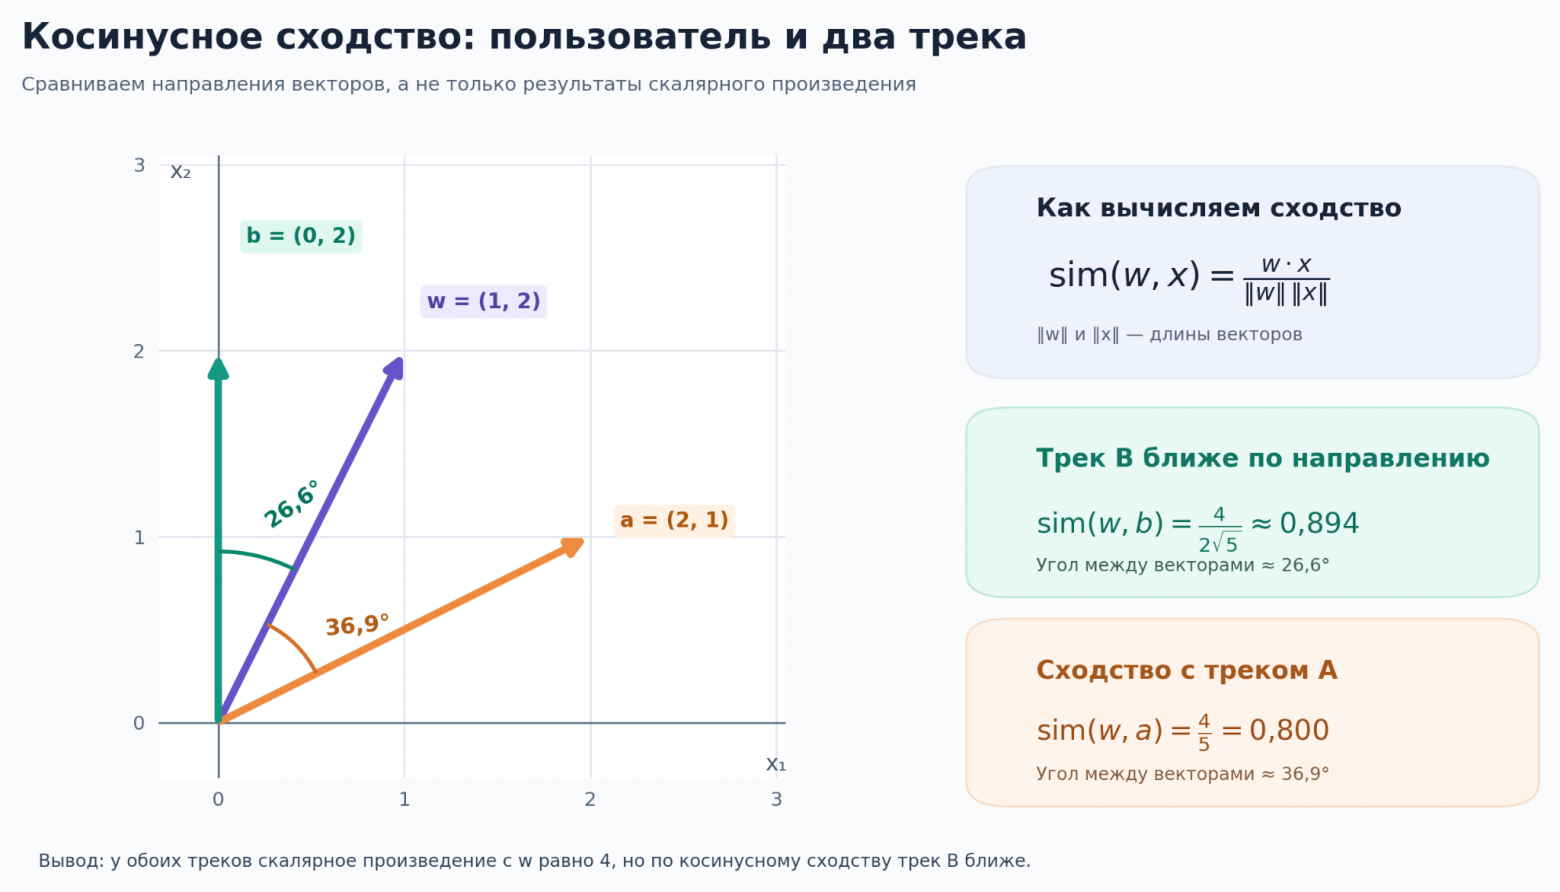
В примере оба трека получили одинаковый результат. Но означает ли это, что они одинаково похожи на вектор предпочтений пользователя? Не обязательно.
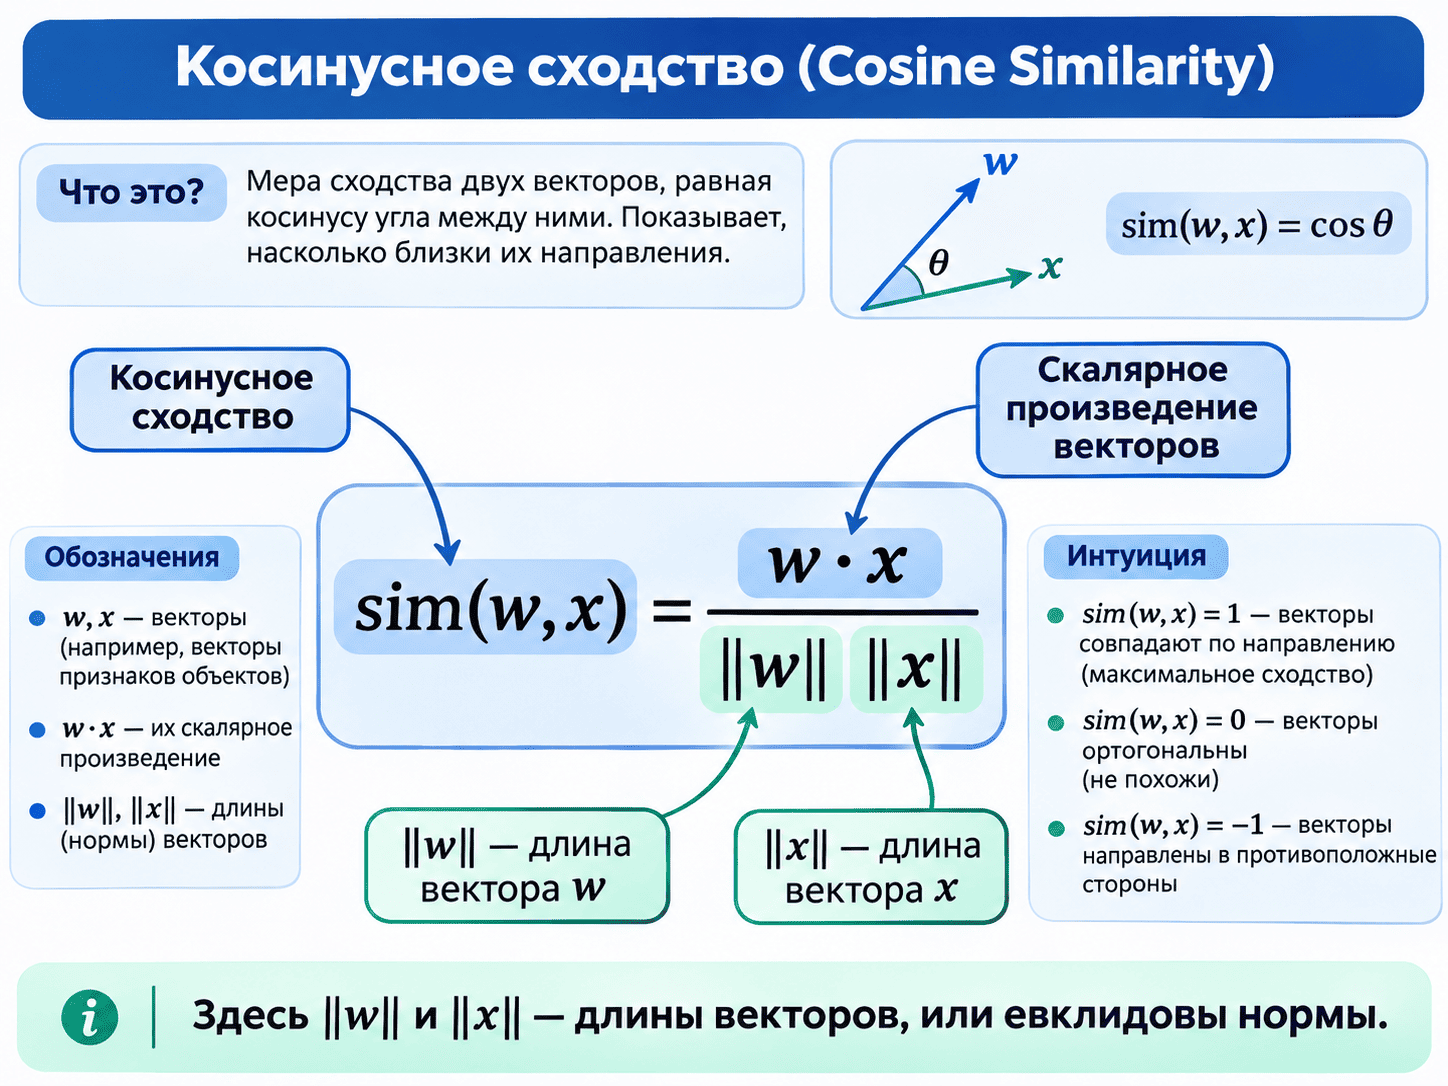
Скалярное произведение зависит как от направлений векторов, так и от их длин. Если нам важно сравнивать именно направления, можно использовать косинусное сходство.
Длина двумерного вектора рассчитывается так:
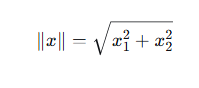
Косинусное сходство ненулевых векторов принимает значения от −1 до 1. Значение 1 соответствует одинаковому направлению, 0 — перпендикулярным векторам, а −1 — противоположным направлениям.
Посчитаем сходство наших треков с предпочтениями пользователя:
import numpy as np

user = np.array([1, 2])

track_a = np.array([2, 1])
track_b = np.array([0, 2])

def cosine_similarity(a, b):
    return np.dot(a, b) / (
        np.linalg.norm(a) * np.linalg.norm(b)
    )

print(round(cosine_similarity(user, track_a), 3))
# 0.8

print(round(cosine_similarity(user, track_b), 3))
# 0.894
Однако высокая похожесть числовых представлений не гарантирует, что человек действительно выберет композицию. Всё зависит от того, насколько удачно признаки отражают реальные интересы.
В реальном ML подобные операции применяются при работе с эмбеддингами — векторными представлениями пользователей, текстов, изображений и других объектов. Например, модель может преобразовать поисковый запрос и документы в векторы, после чего система найдёт тексты с наиболее близкими представлениями.
Что нужно знать о базисе, span и матричных разложениях
Span в линейной алгебре — это линейная оболочка набора векторов, то есть множество всех их линейных комбинаций.
Предположим, у нас есть два вектора:
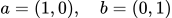
Первый направлен вправо, второй — вверх. Если умножать их на разные числа и складывать, можно получить любую точку на плоскости. Например, вектор (3, 2) получится, если первый вектор умножить на 3, а второй — на 2.
А если оба исходных вектора направлены вдоль одной прямой, их комбинации не позволят выйти за её пределы.
Эта идея помогает понять, какие признаки содержат независимую информацию, а какие могут повторять друг друга.
Есть и другие математические инструменты — например, собственные числа, собственные векторы и сингулярное разложение матрицы (SVD). Они помогают анализировать данные и сокращать количество признаков, сохраняя важную информацию.
Для первых ML-проектов подробно изучать эти темы необязательно. Сначала достаточно разобраться с векторами и матрицами, научиться выполнять скалярное произведение и матричное умножение. К более сложным понятиям можно вернуться, когда они понадобятся для конкретной задачи.
Математический анализ: как модель измеряет ошибку
Вернёмся к музыкальным рекомендациям. Наша модель получила оценки 4 для обоих треков. Теперь предположим, что пользователь действительно оценил эти композиции.
Трек A — 3 балла.
Трек B — 5 баллов.
Получается, модель ошиблась в обоих случаях. Как изменить веса, чтобы предсказания стали ближе к реальным оценкам? Здесь пригодится математический анализ.
Функция потерь: как измерить ошибку
Чтобы оценить, насколько сильно модель ошибается, используют функцию потерь (loss function). Она сравнивает предсказание с правильным ответом и показывает величину ошибки. Способ расчёта зависит от задачи.
Например, в задачах регрессии, где модель предсказывает числовое значение, часто используют среднеквадратичную ошибку (MSE). Для её расчёта находят разницу между каждым предсказанием и правильным ответом, возводят её в квадрат, а затем вычисляют среднее. Чем меньше MSE, тем ближе предсказания модели к правильным значениям.
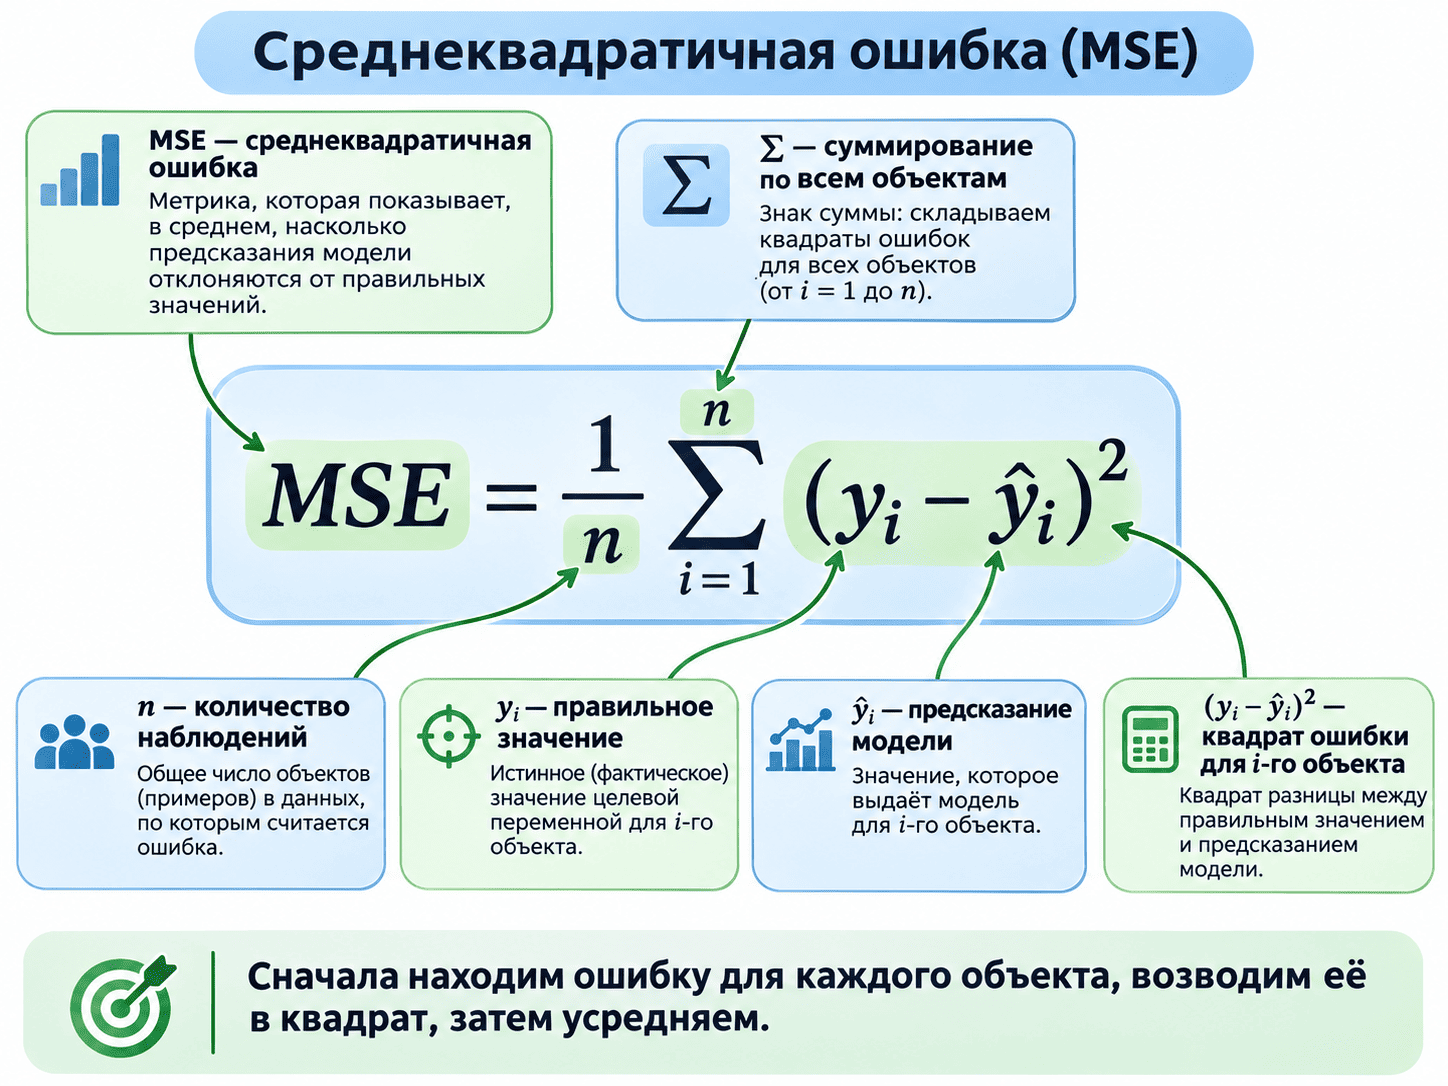
В нашем примере:
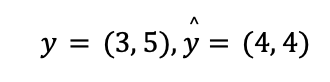
Подставим значения:
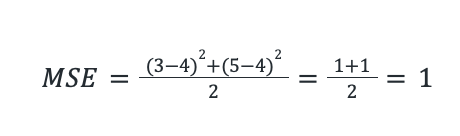
Получили значение функции потерь, равное 1.
Если мы изменим параметры модели и получим предсказания, более близкие к реальным оценкам, MSE уменьшится. Таким образом, у модели появляется математическая цель — подобрать параметры, минимизирующие ошибку.
Не во всех задачах используют MSE. Например, при вероятностной бинарной классификации часто применяют бинарную кросс-энтропию. Выбор функции потерь зависит от задачи и свойств предсказаний.
Есть и более простой способ записать ошибку классификации. Для этого используется индикаторная функция:
она принимает значение 1, если заданное условие выполняется,
0 — если нет.
Например, функцию потерь 0–1 loss можно записать так:
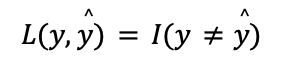
Она равна 1, если модель ошиблась в определении класса, и 0 — если предсказала правильно. Такая функция удобна для описания ошибок классификации, но её обычно не минимизируют обычным градиентным спуском. У неё нет полезного для этого градиента. Поэтому в обучении часто используют другие, дифференцируемые функции потерь.
Производная и градиент: куда изменять параметры
Производная показывает, как изменяется значение функции при небольшом изменении аргумента.
Рассмотрим простую функцию:

Её производная:

Если x=3, производная равна 6. В этой точке функция возрастает.
Если x=−3, производная равна −6. При увеличении аргумента функция в окрестности этой точки убывает.
А при x=0 производная равна нулю. Для этой функции здесь находится минимум.
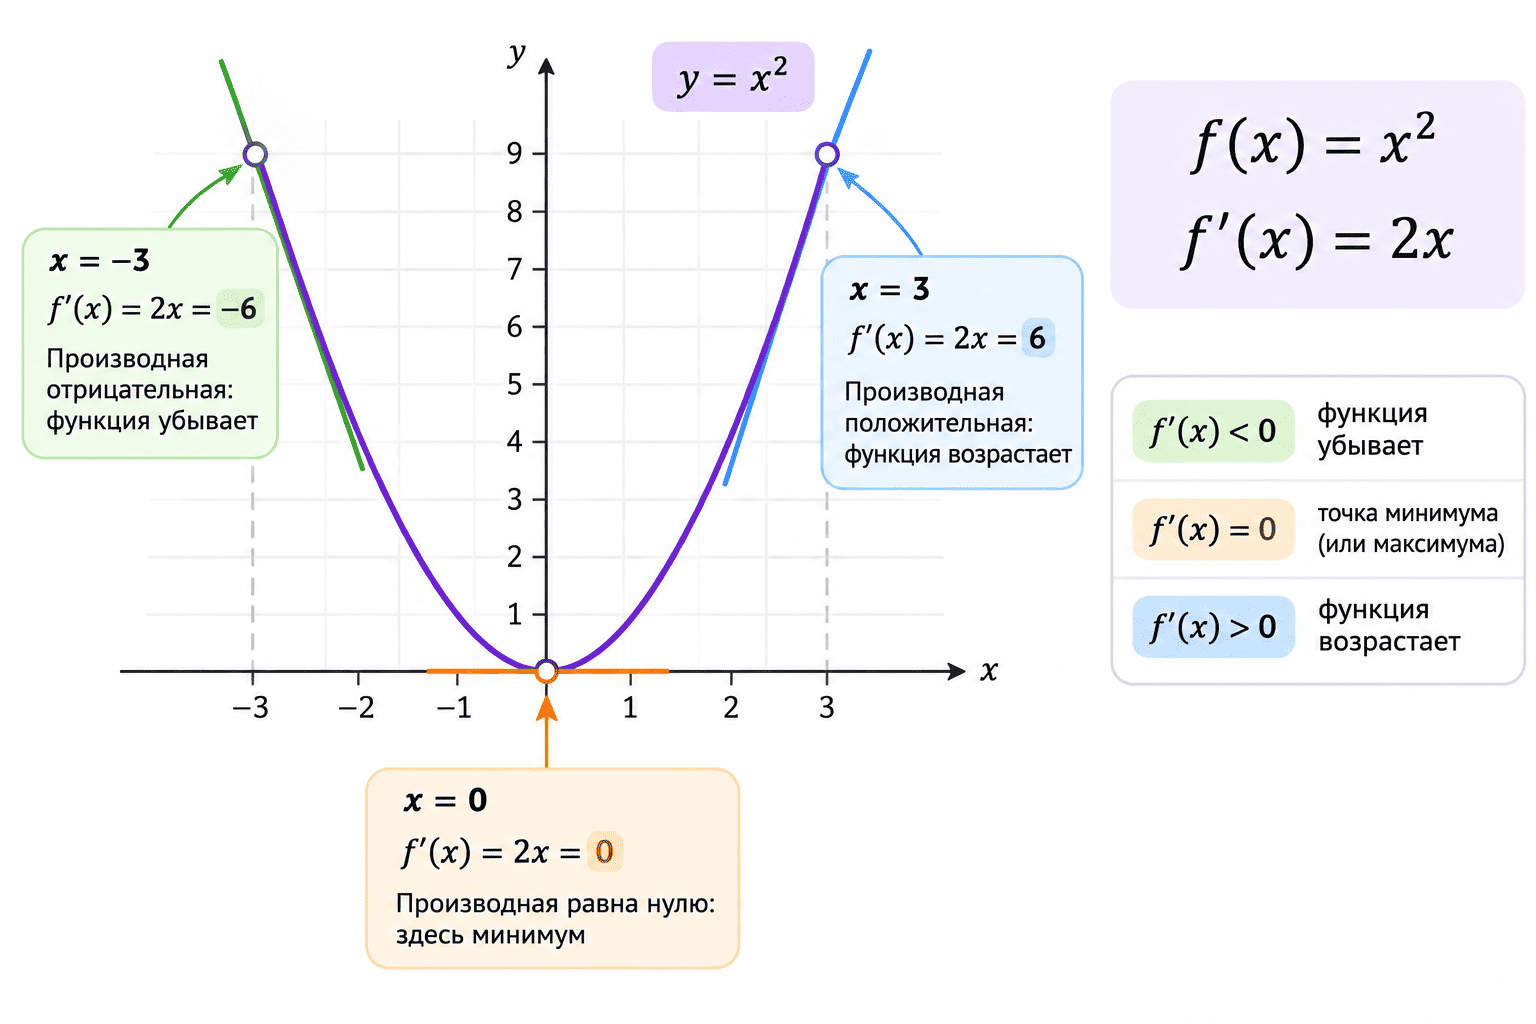
В машинном обучении идея похожая: нужно понять, как функция потерь меняется при изменении параметров. Но наша модель имеет два веса, w1 и w2, поэтому одной производной недостаточно. В таких ситуациях используют частные производные. Они показывают, как изменяется функция при изменении одного параметра, если остальные остаются постоянными.
Набор частных производных называют градиентом:
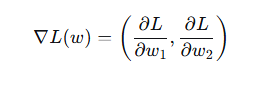
Градиент указывает направление наиболее быстрого локального роста функции. Для уменьшения потерь можно изменять параметры в противоположном направлении.
Вернёмся к нашей модели:
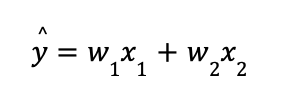
Начальные веса:
Для двух треков функция потерь имеет вид:
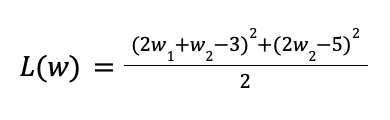
Частные производные по параметрам:
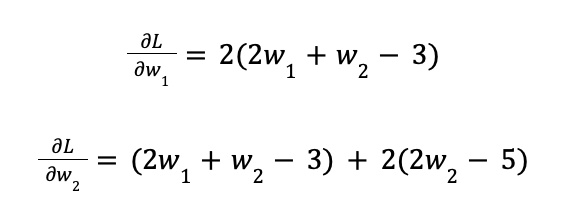
При начальных весах w=(1,2) получаем:
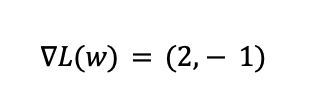
Это означает, что для уменьшения функции потерь вблизи начальной точки стоит двигаться в направлении, противоположном вектору (2,−1). На следующем этапе используем этот результат для обновления параметров модели.
Что такое композиция функций и зачем она в нейросетях
Чтобы понять, что такое композиция функций, представим последовательность вычислений, в которой результат одной функции становится аргументом другой. Например:
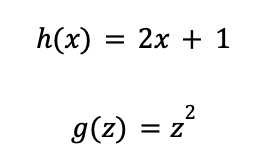
Если сначала применить h, а затем g, получим:
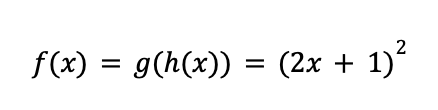
Это и есть композиция функций. Чтобы найти её производную, используют правило цепочки:
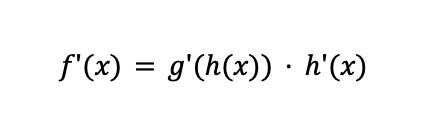
В нашем случае:
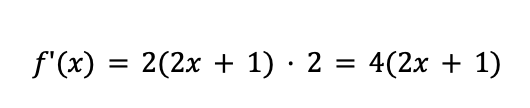
В нейронных сетях действует та же идея, только преобразования сложнее. Один слой получает данные, выполняет вычисления и передаёт результат следующему. Обычно используются линейные преобразования и нелинейные функции активации.
На правиле цепочки основан алгоритм обратного распространения ошибки — backpropagation. Он позволяет вычислять производные функции потерь по параметрам разных слоёв сети.
Для первого знакомства с нейросетями важно понимать сам принцип композиции и правила цепочки. Подробное матричное дифференцирование можно изучать позже.
Если хотите восстановить математическую базу перед изучением ML, пройдите наш бесплатный курс «Математика для анализа данных». В программе — функции, производные, векторы, матрицы, градиенты и оптимизация. Помогает систематизировать знания математического анализа и линейной алгебры.
Оптимизация: как модель находит лучшие параметры
Теперь у нас есть всё необходимое для обучения простой модели: данные, предсказания, функция потерь и градиент. Остаётся изменить веса так, чтобы ошибка уменьшилась. Один из базовых способов — градиентный спуск.
Градиентный спуск на примере музыкальных рекомендаций
Правило обновления параметров выглядит так:
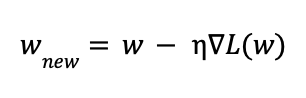
Здесь:
w — текущий вектор параметров;
L(w) — градиент функции потерь;
η — скорость обучения, или learning rate.
Вернёмся к нашему примеру.
Начальные веса:
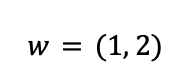
Градиент в этой точке:
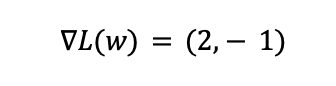
Возьмём скорость обучения:
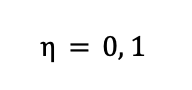
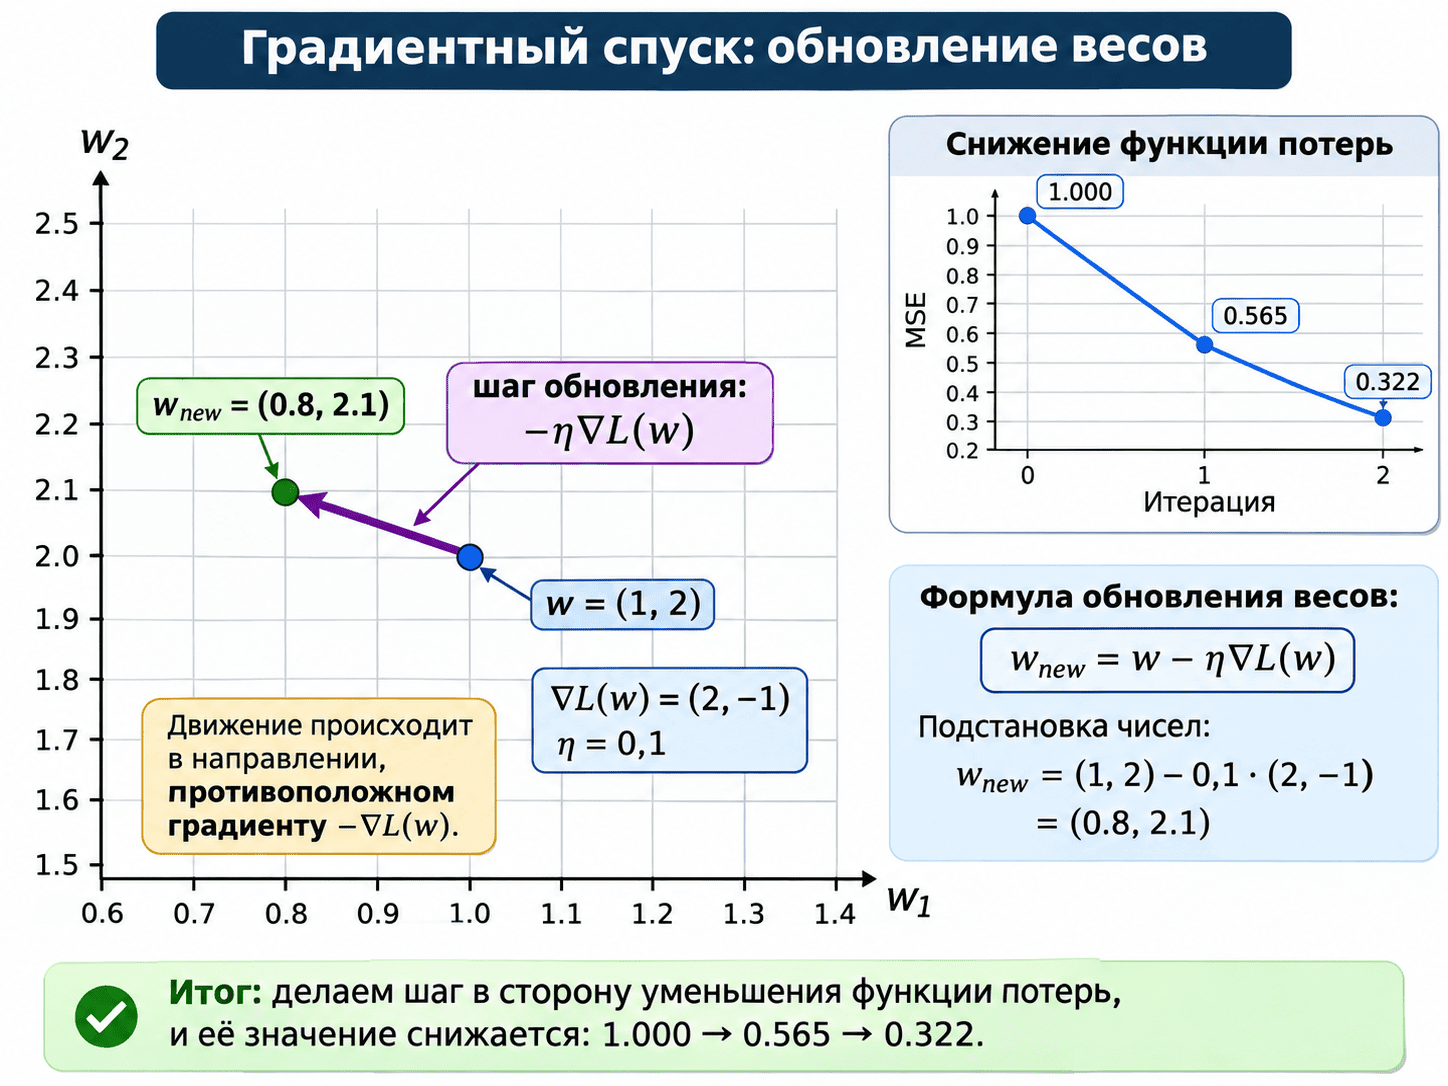
Тогда новые веса:
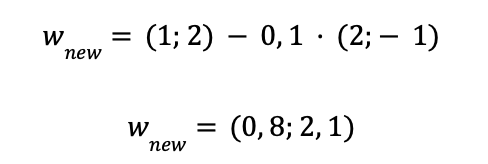
Теперь пересчитаем оценки треков.
Для трека A:
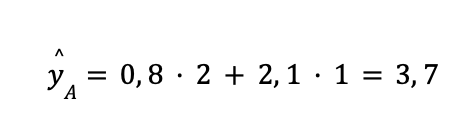
Для трека B:
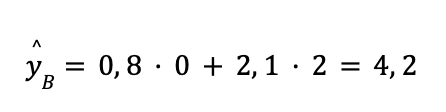
Начальная модель предсказывала 4 и 4. После первого шага — 3,7 и 4,2. Правильные оценки равны 3 и 5, поэтому ошибка уменьшилась:
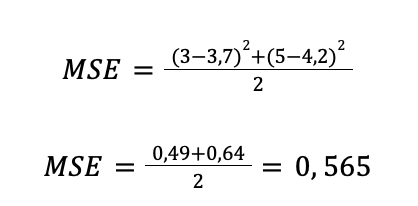
До обновления параметров функция потерь равнялась 1. После одного шага она снизилась до 0,565. Продолжая обновлять веса, можно постепенно приближать предсказания к правильным ответам.
Проверим вычисления на Python:
import numpy as np

# Признаки двух треков
X = np.array([
    [2.0, 1.0],
    [0.0, 2.0]
])

# Реальные оценки пользователя
y = np.array([3.0, 5.0])

# Начальные веса
w = np.array([1.0, 2.0])

learning_rate = 0.1

for step in range(3):
    predictions = X @ w
    loss = np.mean((predictions - y) ** 2)

    print(
        f"Шаг {step}: "
        f"w={w.round(3)}, "
        f"MSE={loss:.3f}"
    )

    gradient = (
        2 / len(y)
    ) * X.T @ (predictions - y)

    w -= learning_rate * gradient
Результат:
Шаг 0: w=[1. 2.], MSE=1.000
Шаг 1: w=[0.8 2.1], MSE=0.565
Шаг 2: w=[0.66 2.19], MSE=0.322
Мы реализовали простой вариант градиентного спуска без готового оптимизатора.
Конечно, в реальных системах модель обучают на гораздо большем количестве наблюдений, а её структура может быть значительно сложнее.
Скорость обучения и проблемы градиентного спуска
Скорость обучения определяет величину шага при обновлении параметров.
Если она слишком маленькая, модель может приближаться к минимуму очень медленно.
Если слишком большая, алгоритм способен перескакивать через минимум, колебаться или расходиться.
Попробуйте самостоятельно изменить learning_rate в нашем примере на 0.01, 0.5 и 1.0. Сравните, как изменяется функция потерь после каждого шага.
При 0.01 ошибка будет уменьшаться постепенно. При 0.5 она сначала снизится, но затем начнёт расти. А при 1.0 ошибка увеличится уже после первого шага. Так происходит потому, что слишком большой шаг мешает алгоритму приблизиться к минимуму функции потерь.
Есть и другие сложности.
Функция потерь может иметь несколько локальных минимумов и седловые точки. В глубоких нейронных сетях иногда возникают затухающие и взрывающиеся градиенты. А вычисление градиента по огромному датасету требует значительных ресурсов.
Поэтому на практике используют различные варианты градиентного спуска и алгоритмы оптимизации, например SGD и Adam. Однако для математического минимума достаточно понять три вещи: что именно минимизирует алгоритм, откуда берётся градиент и как скорость обучения влияет на изменение параметров.
Теория вероятностей и статистика: как работать с неопределённостью
В предыдущих разделах мы обучили модель предсказывать оценки музыкальных треков. Но во многих задачах ML требуется не конкретное число, а оценка вероятности события.
Например, что пользователь продлит подписку, клиент вернёт кредит или банковская операция окажется мошеннической. Даже когда модель выдаёт конкретный класс или числовой прогноз, результат может зависеть от случайных факторов и особенностей обучающих данных.
Теория вероятностей помогает описывать эту неопределённость, а математическая статистика — делать выводы на основе выборки.
Условные вероятности и формула Байеса
На одном из вебинаров Алексей Биршерт разобрал задачу банковского антифрода — поиска мошеннических транзакций.
Модель получает признаки операции: сумму перевода, время, характеристики отправителя и получателя. На исторических данных она учится отличать подозрительные операции от обычных. Но даже модель, которая обнаруживает большинство мошеннических транзакций, может создавать большое количество ложных срабатываний.
Предположим, через банк прошло 10 000 операций. Из них 100 действительно мошеннические, остальные 9 900 — обычные. Допустим, модель обнаруживает 90% мошеннических операций и ошибочно помечает как подозрительные 5% обычных.
Результат | Количество |
Обнаруженные мошеннические операции | 90 |
Пропущенные мошеннические операции | 10 |
Обычные операции, ошибочно помеченные как подозрительные | 495 |
Правильно распознанные обычные операции | 9 405 |
Всего модель пометила как подозрительные 585 операций. Однако мошенническими среди них были только 90.
Доля действительно мошеннических операций среди всех срабатываний:
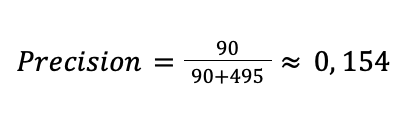
То есть около 15,4%. При этом полнота обнаружения мошенничества:
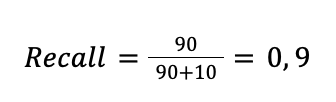
Модель обнаруживает 90% мошеннических операций, но большая часть её срабатываний оказывается ложной тревогой. Почему так происходит?
Дело в том, что мошенничество встречается редко. На 100 мошеннических операций приходится 9 900 обычных.
Эту ситуацию помогает объяснить формула Байеса:
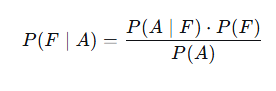
Здесь:
F — операция действительно мошенническая;
A — модель пометила операцию как подозрительную;
P(F | A) — вероятность мошенничества при условии, что модель сработала.
В нашем случае:
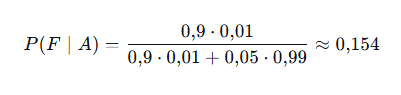
Получили те же 15,4%.
Это один из важных практических выводов теории вероятностей: при оценке классификатора нужно учитывать не только частоту его ошибок, но и распространённость предсказываемого события.
Математическое ожидание, дисперсия и основные распределения
Теория вероятностей изучает случайные величины — числовые значения, зависящие от случайного исхода. Например, количество прослушанных треков за сессию или факт продления подписки.
Одна из основных характеристик случайной величины — математическое ожидание:
E[X]
Оно описывает среднее значение, которое мы ожидаем получить при многократном повторении случайного эксперимента в одинаковых условиях. Для конечной выборки его обычно оценивают выборочным средним:
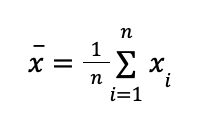
Но среднего недостаточно, чтобы понять разброс значений.
Например, две группы пользователей могут прослушивать в среднем по пять композиций за сессию. При этом в одной группе большинство слушает от четырёх до шести треков, а в другой одни пользователи включают одну композицию, другие — девять. Средние близки, но поведение пользователей отличается.
Чтобы количественно описать разброс, используют дисперсию:
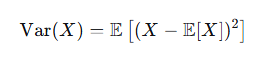
Чем больше дисперсия, тем сильнее значения случайной величины в среднем отклоняются от её математического ожидания в квадратичном смысле.
Для ML полезно знать несколько распределений.
Распределение Бернулли описывает событие с двумя возможными исходами: например, пользователь продлил подписку или нет.
Биномиальное распределение описывает количество успехов в фиксированном числе независимых испытаний Бернулли с одинаковой вероятностью успеха.
Нормальное распределение часто встречается в статистических моделях и приближениях. Например, при определённых условиях распределение выборочного среднего становится близким к нормальному при увеличении объёма выборки.
На старте достаточно понимать, какие события и величины описывают эти распределения, что означают математическое ожидание и дисперсия и в каких ситуациях можно использовать соответствующие модели.
Выборки и проверка гипотез: как понять, что модель стала лучше
Вернёмся к музыкальному сервису. Допустим, мы обучили новую рекомендательную модель и получили меньшую ошибку на обучающих данных. Значит ли это, что рекомендации стали лучше?
Пока нет.
Модель могла запомнить особенности обучающей выборки и плохо работать на новых пользователях. Поэтому её качество проверяют на данных, которые не использовались для обучения.
Для этого исходные данные разделяют на обучающую и тестовую выборки, а при подборе настроек обычно выделяют также валидационную часть. Но даже хорошее качество на тестовой выборке не гарантирует, что изменения принесут пользу продукту.
Предположим, мы хотим увеличить долю пользователей, продлевающих подписку. Для проверки эффекта можно провести A/B-тест.
Допустим, мы случайным образом разделили пользователей на две группы по 1 000 человек. В группе A подписку продлили 100 пользователей, а в группе B — 120. Получаем:
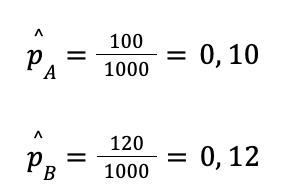
Наблюдаемая разница — 2 процентных пункта. Могла она возникнуть случайно?
Для приблизительной оценки неопределённости разницы двух независимых долей можно рассчитать стандартную ошибку:
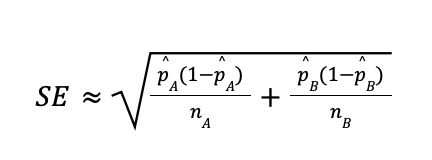
В нашем примере:
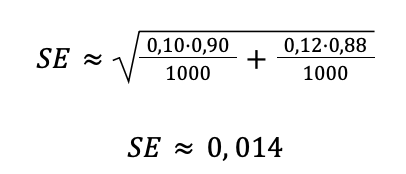
При нормальном приближении 95%-й доверительный интервал для разницы долей:
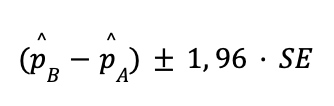
Получим приблизительно:
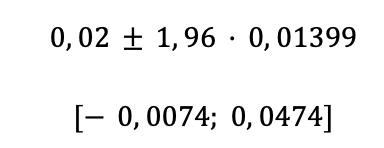
Или от −0,74 до 4,74 процентного пункта.
Интервал включает ноль. Поэтому в рамках этого приближённого расчёта нет достаточных оснований утверждать, что новая модель действительно увеличила конверсию. Это не доказывает отсутствия эффекта. Возможно, выборка недостаточна, чтобы его обнаружить.
На практике проведение A/B-тестов требует дополнительных решений: корректной рандомизации, расчёта размера выборки, выбора статистической процедуры и контроля ошибок. Но начинающему ML-инженеру важно понять основной принцип: наблюдаемая разница между метриками не всегда означает реальное улучшение.
Как выучить математический минимум для ML
Попытка сначала изучить всю высшую математику и только потом перейти к машинному обучению может надолго отложить практику. Эффективнее — изучать математические понятия последовательно и сразу проверять их на вычислениях и небольших моделях.
Алексей Биршерт, размышляя о навыках ML-инженера, называет распространённой ошибкой новичков чрезмерное увлечение теорией без практики. В начале обучения полезно после каждого нового определения самостоятельно выполнить несколько расчётов и проверить их на Python.
С чего начать изучение машинного обучения: маршрут по математике
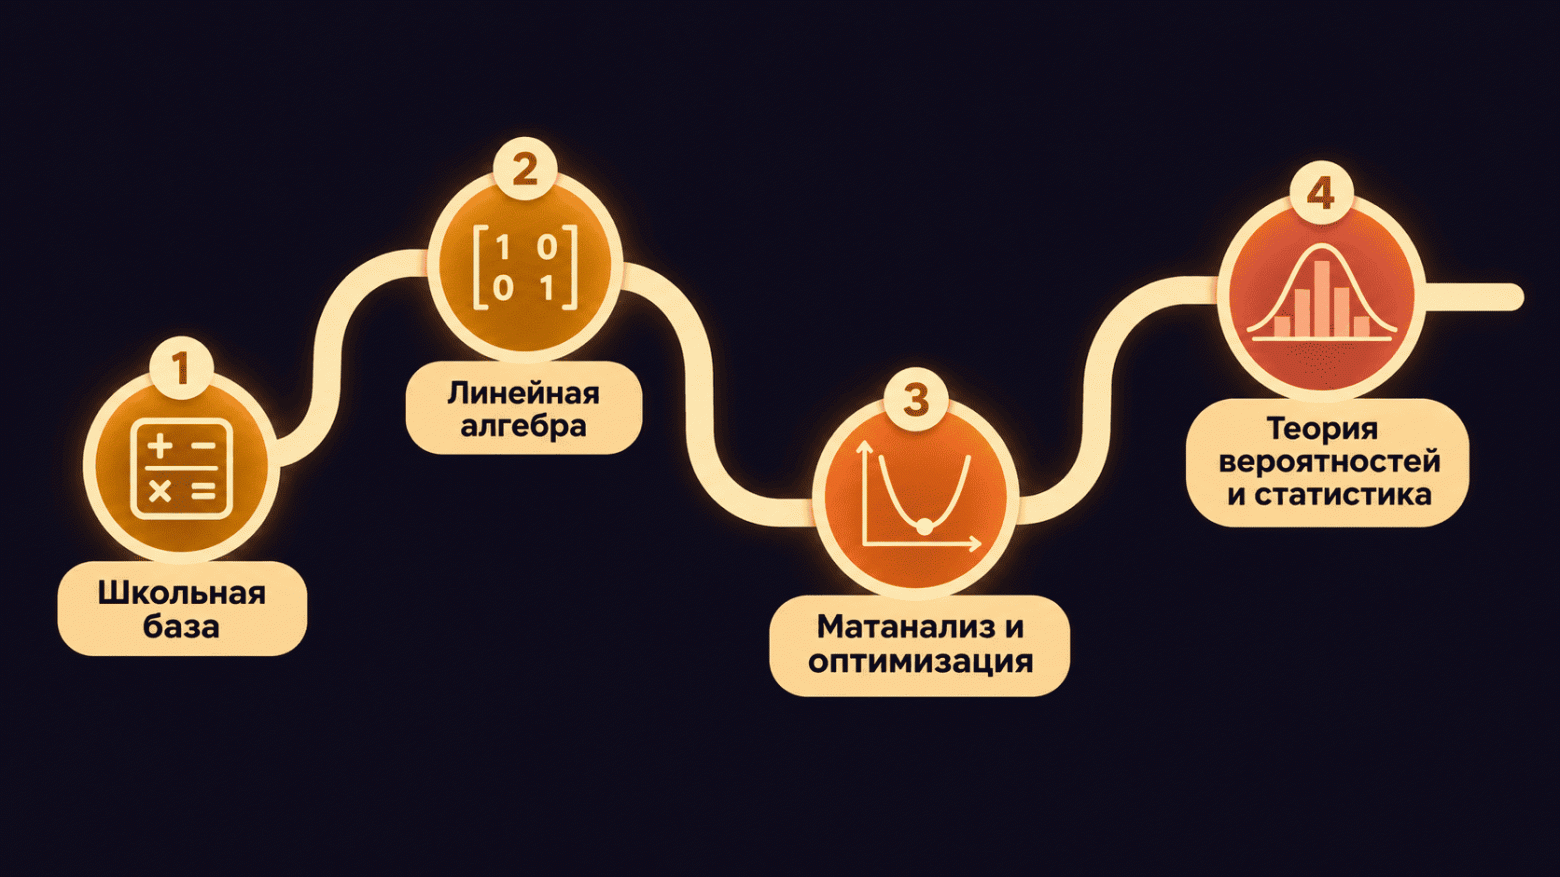
Школьная база
Начните с арифметики, степеней, дробей, уравнений, функций и графиков. Проверьте, можете ли вы преобразовать простое выражение, решить линейное уравнение и объяснить, как меняется значение функции при изменении аргумента. Эти навыки понадобятся для понимания дальнейших формул.Линейная алгебра
Разберите векторы, матрицы, скалярное произведение, нормы и матричное умножение. После этого попробуйте самостоятельно вычислить оценки двух объектов через скалярное произведение, а затем повторить расчёты с помощью NumPy.Математический анализ и оптимизация
Изучите производные простых функций, частные производные, градиент и правило цепочки. Затем реализуйте градиентный спуск для функции одной переменной или небольшой линейной модели. Проверьте, как меняется результат при разных значениях скорости обучения.Теория вероятностей и статистика
Разберите условные вероятности, формулу Байеса, математическое ожидание, дисперсию и основные распределения. Затем переходите к выборкам, доверительным интервалам и проверке гипотез. Эти знания помогут не только обучать модели, но и критически оценивать результаты экспериментов.
Курсы, книги и дополнительные материалы
Если необходимо восстановить математическую базу, можно начать с бесплатной программы «Математика для анализа данных».
Для более глубокого самостоятельного изучения пригодится учебник Mathematics for Machine Learning Марка Дайзенрота, Алдо Файзала и Чен Сун Онга. Его авторы последовательно объясняют математические основы и показывают связь с методами машинного обучения. Электронная версия и дополнительные материалы доступны на сайте книги.
Ещё один вариант — университетские лекции по линейной алгебре, математическому анализу и теории вероятностей. Их можно использовать для углублённого изучения тем, которые оказались сложными или особенно интересными.
Когда базовые понятия станут понятны, стоит переходить к полноценным ML-задачам.
Например, на программе «Инженер машинного обучения» изучают Python, подготовку данных, классические алгоритмы машинного обучения, основы глубокого обучения, статистику и A/B-тесты. В финальном проекте студенты создают систему ранжирования публикаций в социальной сети. Это позволяет связать математические методы с разработкой и оценкой работающего ML-решения.
Заключение
Математика для ML-инженера — не перечень формул, которые нужно выучить перед началом работы, а набор инструментов для решения конкретных задач.
Линейная алгебра помогает работать с признаками, математический анализ и оптимизация — обучать модели, теория вероятностей и статистика — оценивать результаты.
На старте важнее понимать эти связи и уметь применять базовые методы, чем разбираться во всех тонкостях математической теории. Сложные темы можно осваивать тогда, когда они действительно понадобятся.
Частые вопросы
Можно ли начать изучать ML, если плохо помнишь школьную математику?
Да, но отдельные пробелы придётся закрывать.Для начала полезно восстановить работу с уравнениями, функциями, степенями и графиками. Затем можно постепенно переходить к векторам, матрицам и производным. Необязательно откладывать знакомство с ML до полного повторения школьной программы. Можно параллельно изучать математику и решать простые задачи на Python.
Обязательно ли самостоятельно выводить формулы и считать производные?
В прикладных задачах большинство вычислений выполняют библиотеки. Например, PyTorch поддерживает автоматическое дифференцирование, а NumPy позволяет выполнять операции над массивами и матрицами.
Но простые формулы полезно разобрать самостоятельно.
Если вы понимаете, как вычисляется градиент и почему изменяются параметры, легче разобраться в поведении модели при обучении.
Что можно не изучать на старте?
Для первых ML-проектов необязательно разбираться во всех разделах высшей математики. Более сложные темы можно изучать по мере необходимости. Например, собственные числа и SVD пригодятся при уменьшении размерности данных, матрица Гессе — при углублённом изучении оптимизации, а дифференциальные уравнения и теория меры — в специализированных задачах.
Ещё один пример — расстояние Вассерштейна, которое используют для сравнения вероятностных распределений. Оно учитывает, насколько далеко нужно условно переместить вероятностную массу, чтобы преобразовать одно распределение в другое. Но для освоения линейной регрессии, базовых классификаторов и градиентного спуска этот инструмент не нужен.


Комментарии 0