В статье рассматривается подход к организации собственной медицинской истории с помощью ИИ-модели. Разберём, как можно организовать хранение и обработку медицинских документов, какие возможности при этом появляются и какие ограничения необходимо учитывать.
Статья преимущественно техническая, с рассмотрением устройства системы и принципов её работы. Для более широкой аудитории подготовлен небольшой рисованный ролик, где тот же подход объясняется на примерах. Видео не заменяет статью, а статья — видео, поэтому можно выбрать более удобный способ знакомства с темой.
А для тех, кто предпочитает сразу посмотреть исходники и документацию, имеется готовый шаблон на GitHub. Начать можно с README.
Проблема
Со временем у нас накапливается довольно большое количество медицинской информации: результаты анализов, заключения врачей, назначения препаратов, история обследований, измерения различных показателей и пр. При этом она может находиться в совершенно разных местах — на бумаге, в файлах, в отсканированном виде и т.п. Результаты анализов хранятся на медицинских сайтах, данные физической активности — в спортивных приложениях, сведения о приёме препаратов — в заметках или календарях.
Если нужно найти результат конкретного анализа, то это просто. Но вопрос возникает когда требуется работать не с отдельным документом, а с медицинской историей в целом.
Например, мы собираемся на приём к врачу. Хорошо бы иметь под рукой результаты предыдущих обследований, вспомнить, какие препараты принимались, какие рекомендации давали другие специалисты и как изменялось состояние за последнее время.
Или другой пример. Мы хотим посмотреть, как изменялся определённый показатель крови за последние пять лет. Для этого необходимо найти результаты анализов за соответствующий период, извлечь значения, сопоставить даты и единицы измерения, а затем построить таблицу или график. Проблема заключается в необходимости собрать их вместе и привести к удобной для восприятия форме.
Существуют специализированные медицинские информационные системы, позволяющие хранить подобные сведения. Но у них есть своя особенность: набор поддерживаемых данных и операций определяется разработчиками. Если программа умеет хранить лабораторные показатели и строить графики, это ещё не означает, что она сможет сопоставить их с назначениями препаратов или историей физической активности. Для этого должны быть предусмотрены соответствующие модели данных, интерфейсы и алгоритмы обработки.
И здесь формируется задача: как сделать так, чтобы не просто сохранять информацию, но и выполнять над ней произвольные операции?
Основная идея
Как видим, большая часть интересующих нас задач сводится к операциям над информацией: найти необходимые документы, извлечь из них сведения, сопоставить их между собой, выполнить некоторые вычисления и представить результат в удобной форме.
Но именно подобные операции сегодня хорошо умеют выполнять ИИ-модели. Если им дать локальный доступ или какое-то файловое пространство, то они могут читать и создавать файлы, выполнять программы, обрабатывать документы, строить таблицы и графики. При этом последовательность действий определяется поставленной задачей.
При этом выполняемые функции зависят от запросов и возникают из контекста. ИИ-модель позволяет создавать произвольную функциональность по щелчку пользователя — «а что если…?». Представляете? У пользователя возникает идея что-то узнать, и ИИ-модель моментально выполняет это действие. Не нужно искать в приложении как это сделать. Не нужно просить разработчиков улучшить приложение. Вы просто спрашиваете.
Например, вы полгода назад проходили курс физиотерапии. И возник вопрос — какие препараты тогда принимали и когда в последний раз были у таких-то врачей? И вы просто спрашиваете. Вы хотите построить график приема статинов и график анализов биохимии и сопоставить их. Вам не нужно иметь готовую функцию, или искать данные. Если ИИ-модель знает где находятся результаты анализов, как извлечь необходимые значения, то она построит вам график.
Организация данных
Здесь можно было бы использовать базу данных. Но при таком подходе сразу возникает необходимость определить её структуру. В медицинских документах содержится множество разных сведений. Одни хорошо укладываются в таблицы — например, лабораторные показатели. Другие представляют собой обычный текст, изображения или документы со сложной внутренней структурой.
Но, как мы выяснили, заранее невозможно предусмотреть все виды данных, которые мы захотим сохранять. Поэтому в рассматриваемой системе мы отталкиваемся от обычной файловой структуры. При этом данные должны оставаться доступными для поиска, выборки и типизации.
Документы сохраняются в исходных форматах, извлечённые сведения — в текстовом или ином удобном представлении, а для структурированной информации могут использоваться таблицы и другие форматы данных. База данных при этом не исключается. Она может применяться для отдельных задач, если это оправдано их характеристиками. Но её наличие не является обязательным условием существования системы.
Что интересно. Как мы увидим далее, само построение не исключает реорганизацию данных. ИИ-функциональность «по щелчку» можно реструктурировать и подготовить, например, ключевые показатели в NoSQL БД (например MongoDB). Но для этого нужны специфичные условия (у нас на практике такой потребности не возникало).
Теперь посмотрим на организацию файловой структуры. Для этого можно использовать инструкции, описывающие структуру проекта и правила работы с информацией. В частности, файл AGENTS.md в каждом каталоге позволяет передать модели сведения о в соответствующем иерархическом контексте (прим.: как такое устроено и работает это скорее тема для отдельной статьи; если эта тема интересна, напишите в комментариях). И здесь сразу отметим, что мы не рассматриваем подход в рамках одного из поставщиков, он сформулирован вне конкретной модели.
В результате получаем три основные составляющие:
Данные — оригинальные документы, извлечённая информация, записи и результаты обработки.
Правила — инструкции, определяющие устройство системы и порядок работы с данными.
ИИ-модель и инструменты — средства, с помощью которых выполняются пользовательские задачи.
Таким образом, вместо разработки приложения с заранее установленным перечнем функций мы организуем среду, в которой ИИ-модель может работать с накопленной информацией.
Архитектура
Исходно наша система должна получать файлы любого типа. Далее, эти файлы проходят несколько процедур обработки, каждая из которых обеспечивает определенное свойство посредством преобразования из предыдущего этапа. Откуда удобно представить систему в виде последовательного набора слоёв.
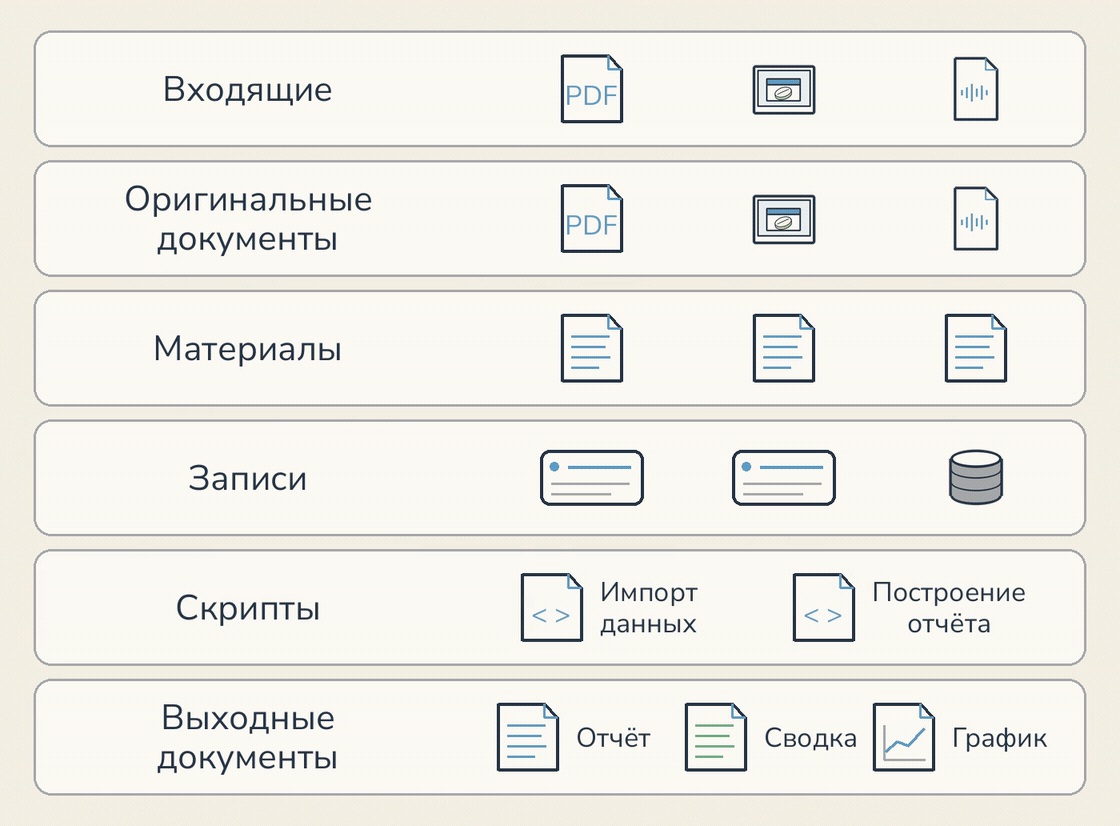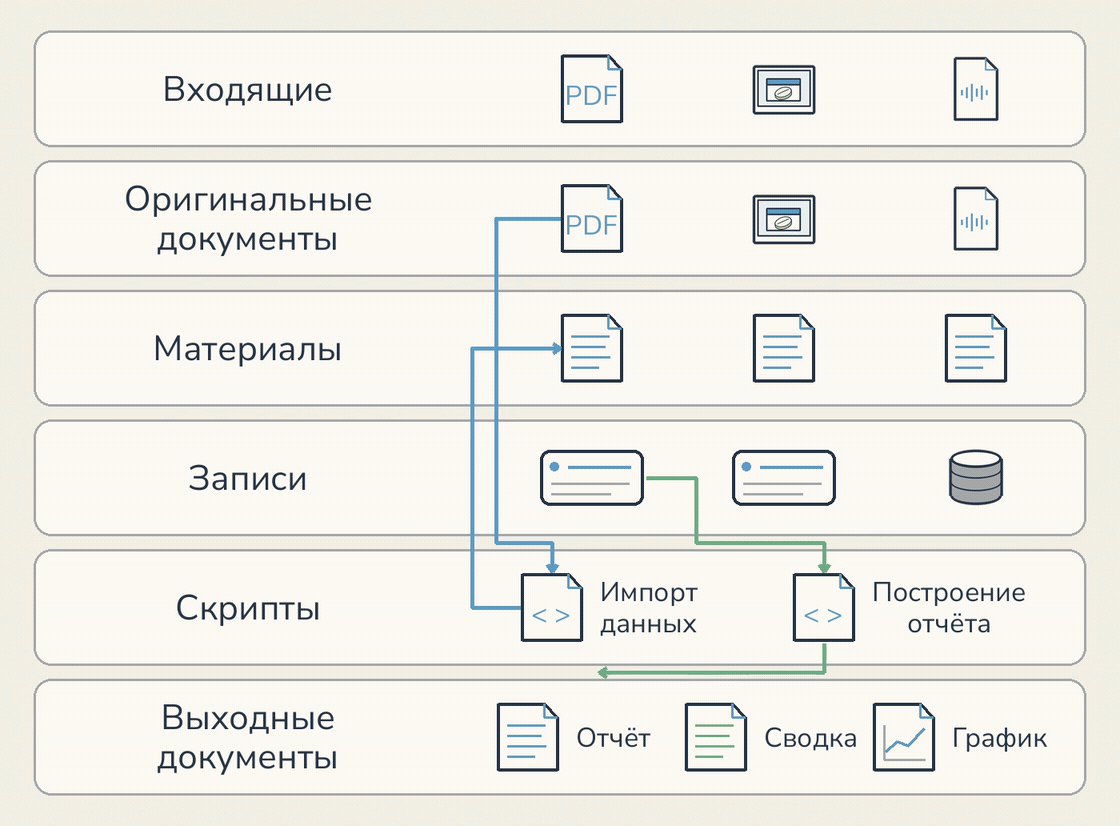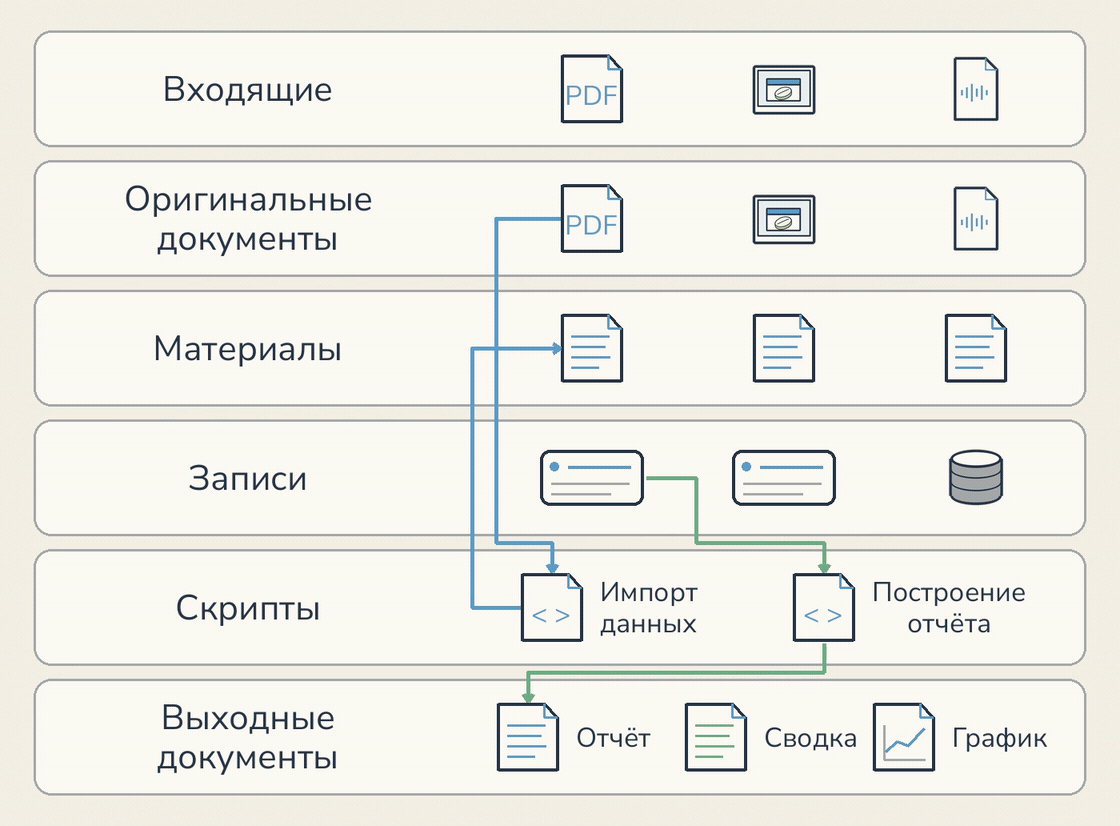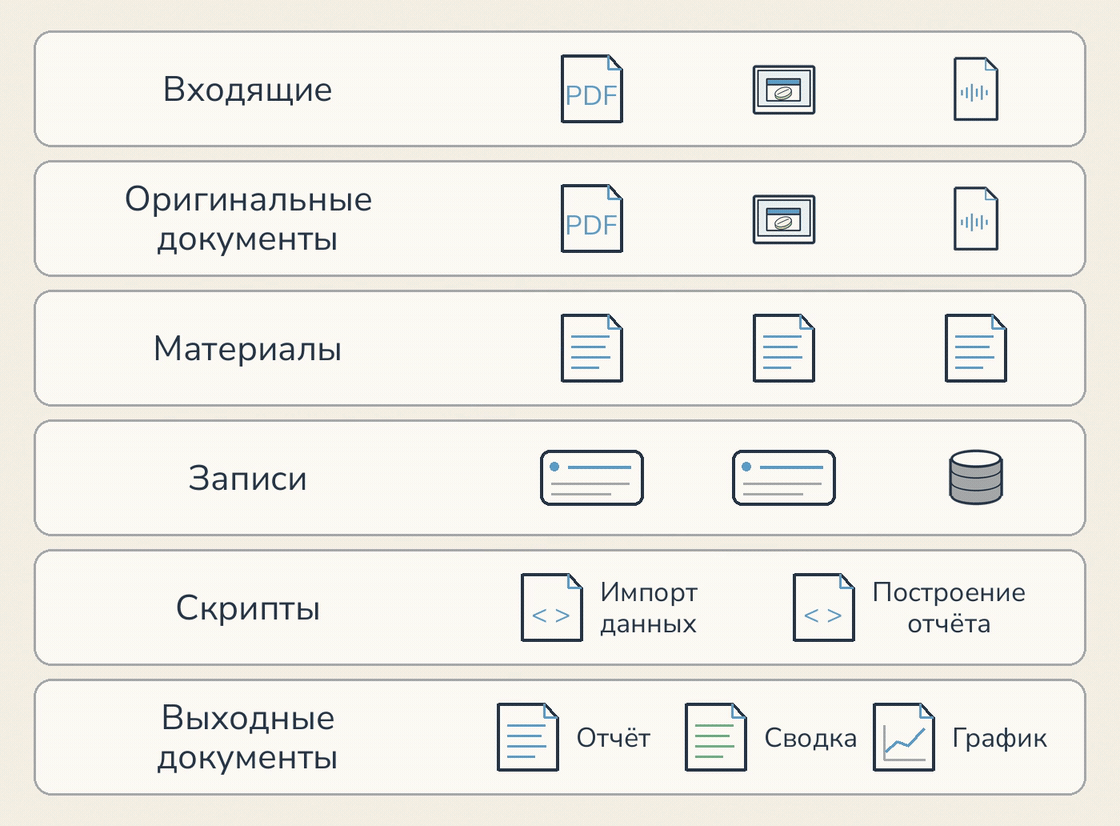
В предлагаемой системе таких слоёв шесть, четыре из которых отвечают непосредственно за организацию и обработку данных.
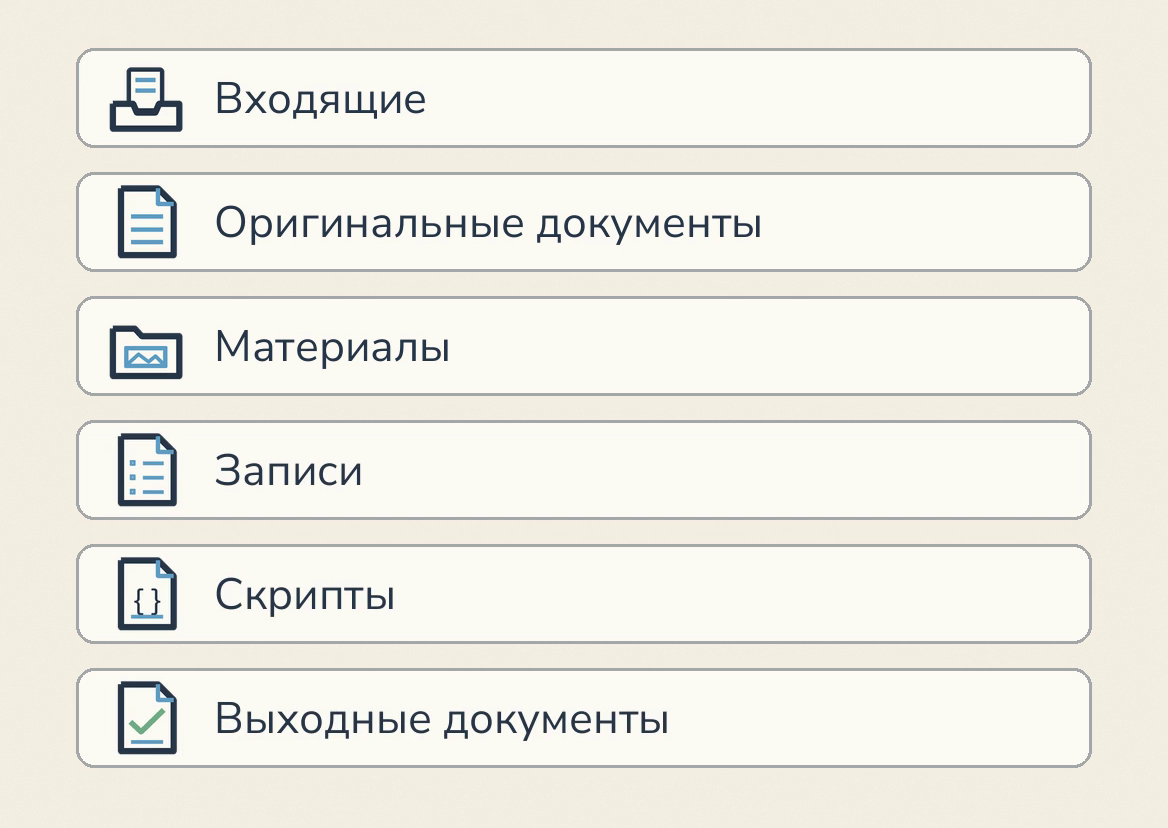
1. Входящие
Первый слой предназначен для получения новых данных. Это временное хранилище, из которого мы удаляем тогда, когда документ перейдет на следующий уровень.
Для передачи пользователь может поместить один или более файлов в каталог входящих и сообщить модели забрать их. Или другой вариант, передать прямо в приложении клиента модели файл на обработку.
Здесь на входе могут быть результаты анализов в PDF, фотографии медицинских документов, аудиозаписи, выгрузки из спортивных приложений, обычные текстовые файлы и пр. Но форма и подача может быть разная. Например, мы можем сюда поместить два изображения сканирования документа с двух сторон листа. Мы объясняем этот момент системе чтобы она могла воспринять это как один документ. Мы нашли в своем медицинском архиве несколько документов, скрепленный скрепкой. Мы еще не знаем почему, но скорее всего это одно целое. Мы отдаем набор изображений и говорим о группировке, и далее ИИ-модель разбирается насколько это соответствует действительности и мы вместе решаем как поступать с ним дальше.
Таким образом, первая задача — первичная каталогизация входных данных как цельных единиц обработки информации.
2. Оригинальные документы
Особенность этого слоя в том, что содержимое файлов не изменяется. Допускается их организация по каталогам, присвоение понятных названий и добавление сопутствующей информации, но сам исходный документ должен оставаться неизменным.
Для чего это нужно?
Предположим, мы получили фотографию лабораторного анализа и распознали её с помощью ИИ-модели. При распознавании часть информации могла быть потеряна, а некоторые значения — определены неправильно. Если исходную фотографию удалить, то проверить правильность результата уже не получится.
Кроме того, через некоторое время мы можем захотеть обработать документ другим способом. Например, использовать более качественную модель распознавания или извлечь сведения, которые при первоначальной обработке нас не интересовали.
Сохранение оригиналов позволяет выполнить такую обработку повторно, независимо от предыдущих результатов.
Таким образом, этот слой обеспечивает сохранность исходной информации и возможность вернуться к ней для проверки или повторной обработки.
3. Материалы
Теперь у нас имеется архив оригинальных документов. Но работать с ними как есть не всегда удобно. Например, PDF может содержать отсканированные страницы, фотография — текст лабораторного анализа, а аудиозапись — рекомендации врача. Если их преобразовать в текстовый документ, и еще определенного формата, то работать с ним становится значительно проще. И эту задачу решает переход на слой материалов.
В зависимости от типа документа могут применяться различные процедуры: извлечение текста из PDF, распознавание изображений, транскрипция аудиозаписей, разбор архивов и других форматов файлов. При этом задача заключается не в медицинской интерпретации, а в получении доступного для дальнейшей обработки представления исходной информации. Например, после обработки лабораторного PDF мы получаем текст с датой исследования, перечнем показателей, их значениями и единицами измерения. А после обработки аудиозаписи — текст того, что было сказано.
Отметим, если на описанных шагах или в последующем модель не может разобрать содержимое или обнаруживает неоднозначности, то она сообщает об этом пользователю, и он разрешает проблему.
Важно, что материалы сохраняют связь с оригинальными документами. Если при извлечении информации обнаружилась ошибка, можно вернуться к источнику, проверить его и при необходимости сформировать материал заново.
В результате этого этапа информация из документов разных типов становится доступной для поиска, чтения и обработки в единой среде. При этом сами оригиналы остаются неизменными.
4. Записи
После предыдущего этапа у нас имеется достаточно удобный для работы набор материалов. Однако информация в них не систематизирована и не подготовлена к работе.
Предположим, что за пять лет мы сдали анализ крови двадцать раз. Теперь мы хотим посмотреть динамику гемоглобина за этот период. В принципе, ИИ-модель может найти все двадцать документов, извлечь из них соответствующие значения, сопоставить даты и построить график. Но если такие операции повторяются, то операция станет трудоемкой. Гораздо удобнее один раз выделить из материалов необходимые сведения и сохранить их в структурированном виде.
Вторая задача слоя — выявление дубликатов, конфликтов и неоднозначностей. Например, если один и тот же результат анализа попал из документа и из личных записей, то удобно его хранить как один отдельный факт, и устранить разночтения, если такие обнаружились.
Но здесь возникает ещё одна задача. Разные лаборатории могут использовать различные обозначения одного и того же показателя, разные форматы представления данных, а иногда и разные единицы измерения. Поэтому простого извлечения значений недостаточно. Необходимо сопоставить однотипные сведения, привести их к согласованному представлению, исключить дублирование и сохранить связь с первоначальными документами.
Аналогичным способом можно организовать историю посещений врачей, назначения препаратов, результаты измерений веса или давления, сведения о физической активности и пр.
Причём записи могут иметь различную структуру в зависимости от предметной области. Лабораторные измерения удобно представлять в виде таблиц, а историю обследований — в виде событий с датами, описаниями и связями с документами.
Таким образом, этот слой обеспечивает переход от набора отдельных документов к единой структурированной истории. Информация становится пригодной для выборки, сопоставления, группировки и анализа без необходимости каждый раз возвращаться к исходным файлам.
5. Скрипты
Следующий компонент системы — программы для выполнения повторяющихся операций.
Предположим, что нам понадобилось загрузить историю тренировок из спортивного приложения. В результате экспорта получены несколько сотен файлов одинакового формата. Можно поручить модели последовательно обработать каждый из них, но это будет не самое эффективное решение. Гораздо разумнее подготовить скрипт, который выполнит необходимые преобразования над всеми файлами.
Аналогично можно организовать импорт типовых лабораторных документов, обработку данных измерительных приборов или построение определённых отчётов. Скрипты имеют ещё одно преимущество — повторяемость результата. Если одинаковая операция выполняется программой с определённой логикой, то её поведение проще проверить и воспроизвести, чем каждый раз заново поручать модели выполнять последовательность действий.
Это не означает, что всю обработку необходимо переносить в программы. Для разовых задач модель может использовать доступные инструменты непосредственно. Но при появлении повторяющихся операций имеет смысл сохранять соответствующие процедуры для дальнейшего использования. При этом ИИ-модель сама способна понять (но не всегда) что операции пользователя повторяются и подготовить соответствующие инструменты.
Таким образом, система постепенно получает набор специализированных инструментов, которые модель может применять при решении новых задач.
6. Выходные документы
Последний слой предназначен для сохранения результатов работы. Например, мы попросили модель построить график изменения определённого показателя за пять лет. Модель нашла необходимые записи, подготовила данные и создала изображение. Аналогично здесь могут сохраняться таблицы, сводки, календари, отчёты и другие подготовленные материалы.
Собирая вместе
Получаем следующую схему. Исходная информация поступает во входящие, после чего оригинальные документы сохраняются отдельно. Из них при необходимости извлекаются материалы, которые затем могут использоваться для формирования структурированных записей. Скрипты обеспечивают выполнение повторяющихся операций, а результаты пользовательских запросов сохраняются в виде выходных документов.
Обработка нового документа
Теперь рассмотрим полный процесс на примере нового лабораторного анализа.
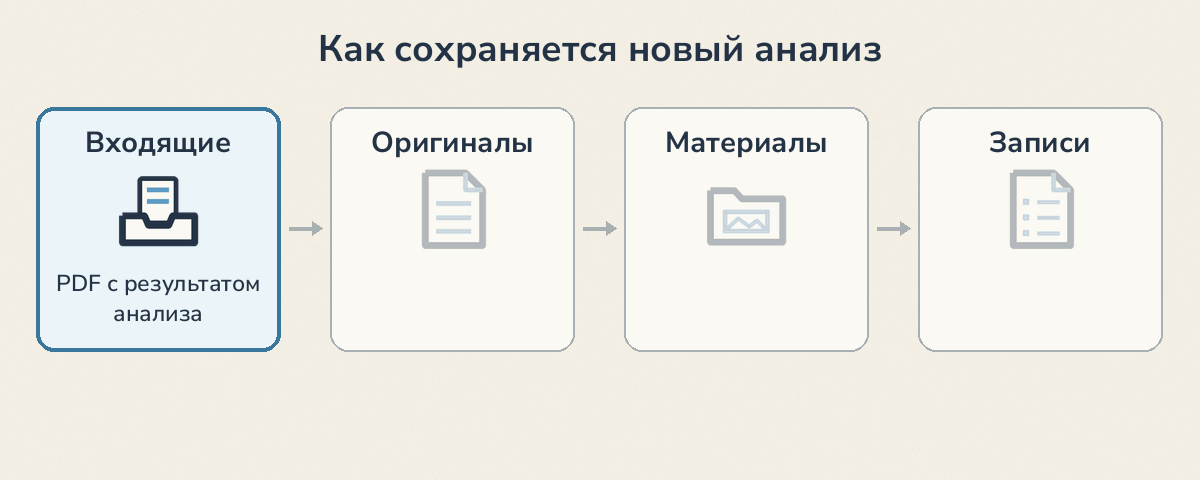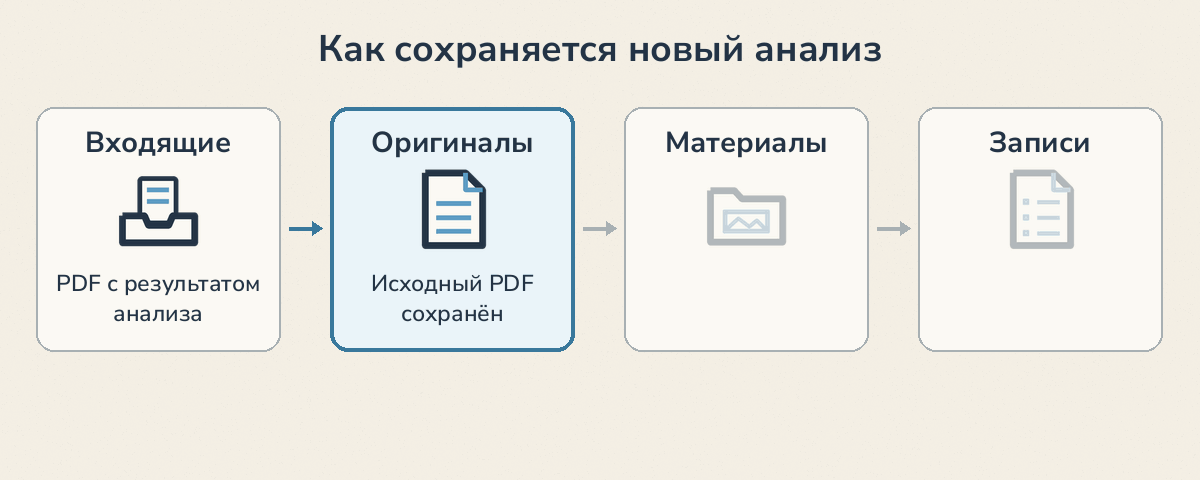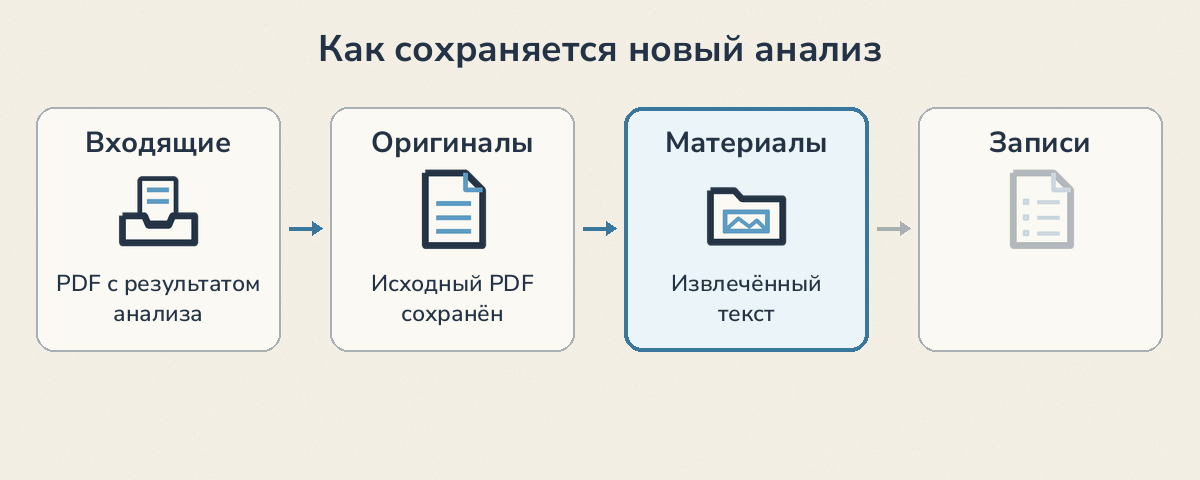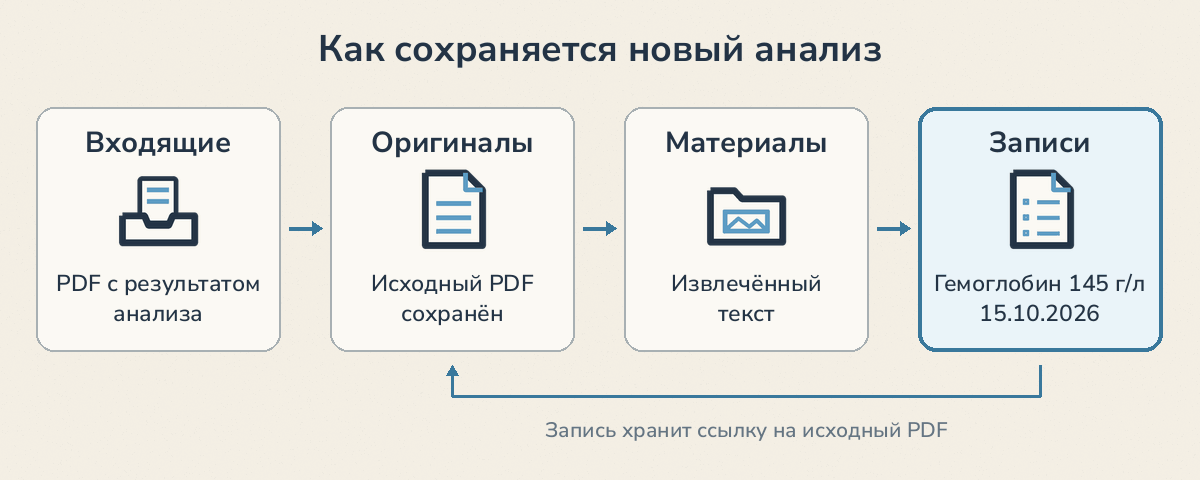
Допустим, пользователь получил файл с результатами исследования крови и передал его модели. Сначала документ сохраняется среди оригиналов. При этом необходимо определить, не был ли он уже импортирован ранее.
Далее модель извлекает содержимое файла. Если ранее был подготовлен скрипт для документов такого типа, то модель его применяет. Если же например это PDF который содержит текстовый слой, его модель читает обычными средствами. Если документ состоит из сканированных изображений, потребуется распознавание. Полученный текст сохраняется отдельно от исходного.
Теперь необходимо разобрать показатели, указанные в документе. Например, мы получили следующую информацию:
Дата исследования: 15.10.2026

Гемоглобин       145 г/л
Эритроциты       4.8 × 10¹²/л
Лейкоциты        6.2 × 10⁹/л
Значения приведены исключительно в качестве примера.
Для каждого показателя нужно определить название, значение, единицы измерения и дату взятия пробы и дату лабораторного исследования. Кроме того, необходимо сохранить связь с документом, из которого получены данные.
Теперь попробуем объединить новое измерение с ранее накопленной историей. Если соответствующий показатель уже существует, необходимо сопоставить его с новой записью. При этом название может несколько отличаться, поэтому простое сравнение строк не всегда подходит. Также нужно проверить единицы измерения, наличие дубликатов и возможные ошибки извлечения. В результате новые данные попадают в слой записей, после чего становятся доступны для последующих запросов.
Например, если пользователь попросит построить график изменения гемоглобина за последние пять лет, модель сможет взять уже подготовленные измерения, отсортировать их по датам и построить график.
Имеется ещё один момент. Предположим, что через полгода мы решили заменить инструмент извлечения текста – применить более новую или более мощную модель, или появился отдельный инструмент для обработки. Поскольку исходные документы сохранились, их можно обработать заново, не восстанавливая информацию из промежуточных результатов. Таким образом, разделение оригиналов, материалов и записей позволяет не только выполнять запросы к медицинской истории, но и изменять способы её обработки.
Использование системы
Теперь предположим, что система уже содержит несколько лет медицинской истории. Посмотрим, какие задачи можно решить на основании накопленной информации.
Подготовка к врачу
Начнём с примера, упомянутого в начале статьи.
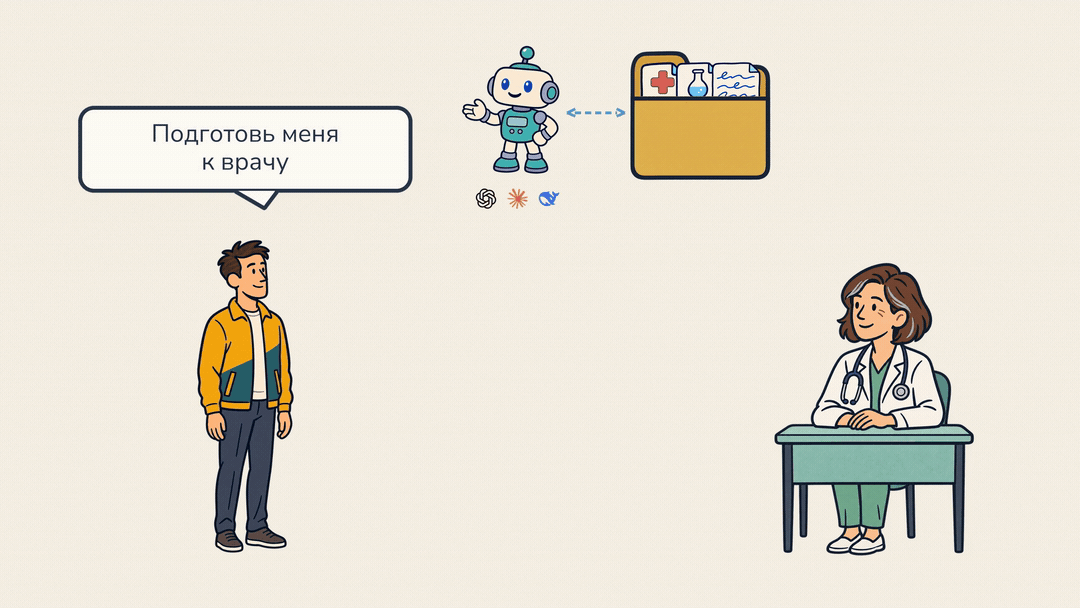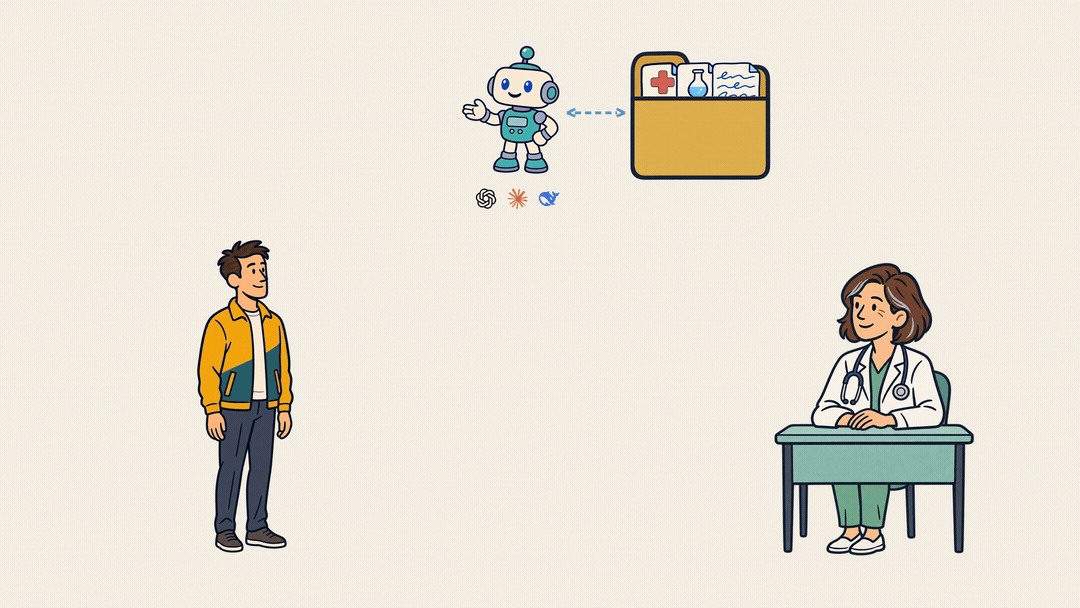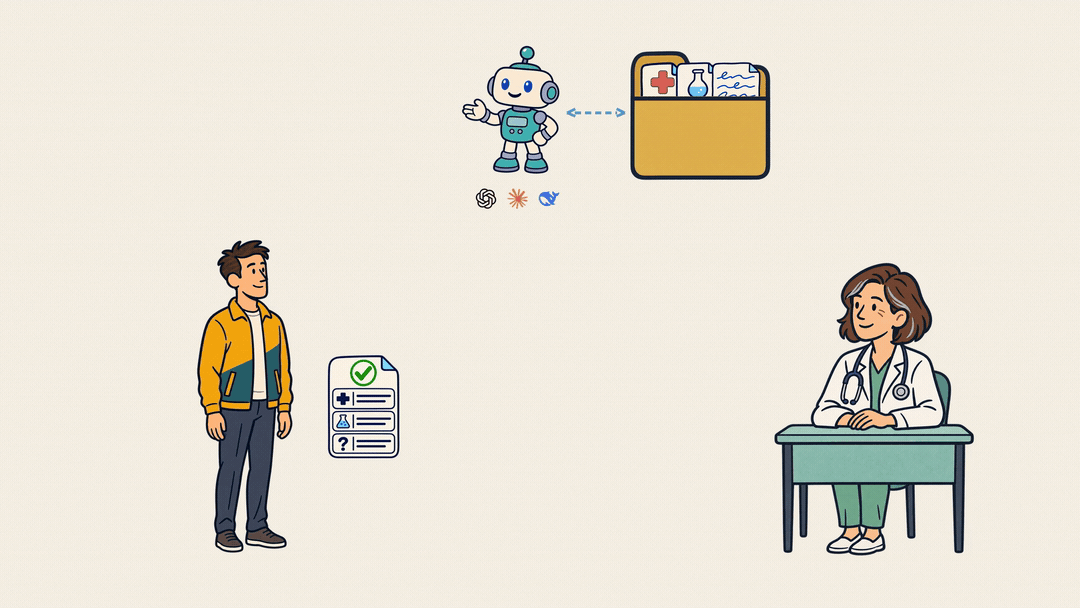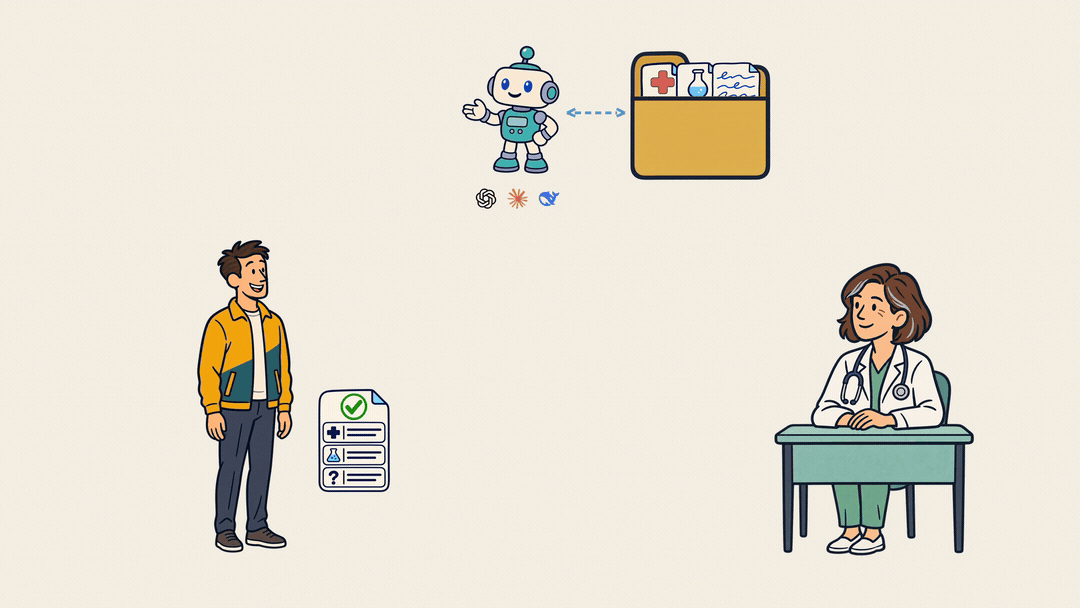
Пользователь собирается к врачу и хочет подготовить необходимые материалы. Он может поручить модели собрать историю посещений определённых специалистов, результаты последних обследований, ранее назначенные препараты и другие сведения, относящиеся к предстоящему приёму. При этом часть информации может находиться в структурированных записях, а другая — непосредственно в документах. Модели необходимо найти соответствующие материалы, определить их взаимосвязи и подготовить сводку. В зависимости от задачи результатом может стать обычный текстовый документ, таблица или перечень вопросов, которые пользователь хотел бы обсудить с врачом.
Динамика показателей
Другой пример — анализ изменений некоторого показателя во времени.
Предположим, что у нас имеются лабораторные результаты за несколько лет. И здесь требуется построить график за период, выделить выходящие за пределы нормы показатели и сопоставить результаты двух последовательных обследований. Если сведения уже нормализованы, большая часть работы сводится к выборке данных и их представлению.
Но можно поставить и другую задачу. Например, сопоставить динамику лабораторного показателя с изменением веса, физической активности или периодами приёма определённого препарата. В этом случае модель будет работать сразу с несколькими видами данных, возможно полученными из разных источников. Наличие общей системы хранения позволяет выполнять подобные запросы без предварительного объединения всех сведений в одном специализированном приложении.
Сопоставление назначений
Ещё один вариант — работа с рекомендациями врачей.
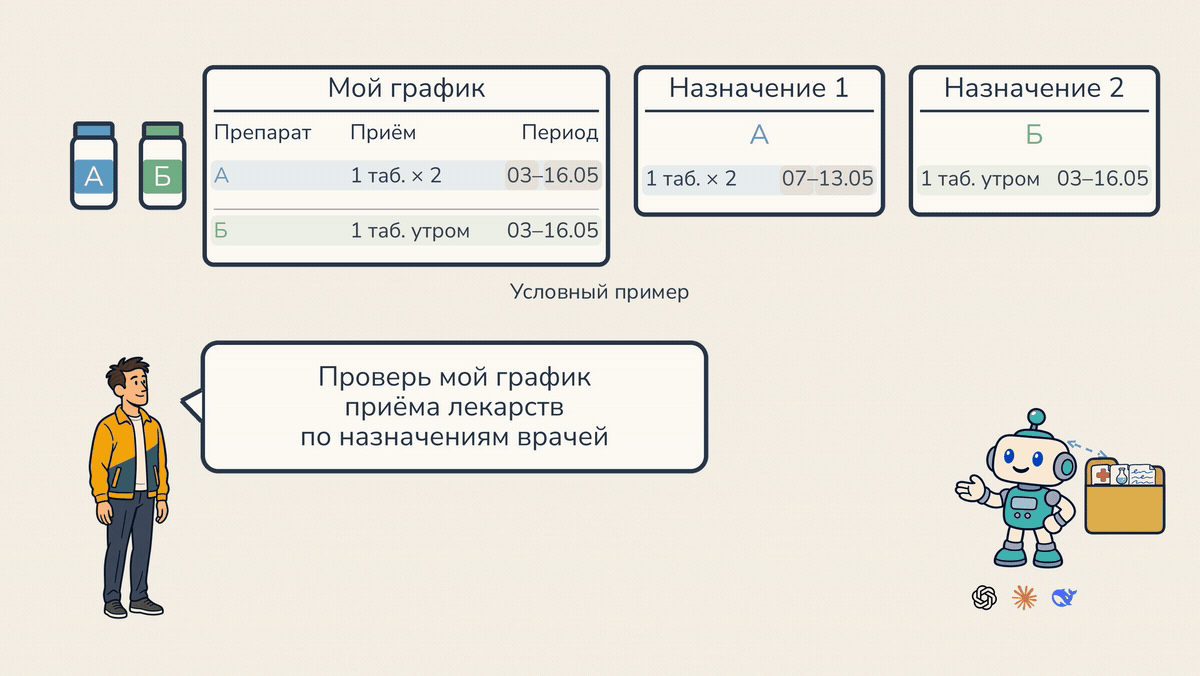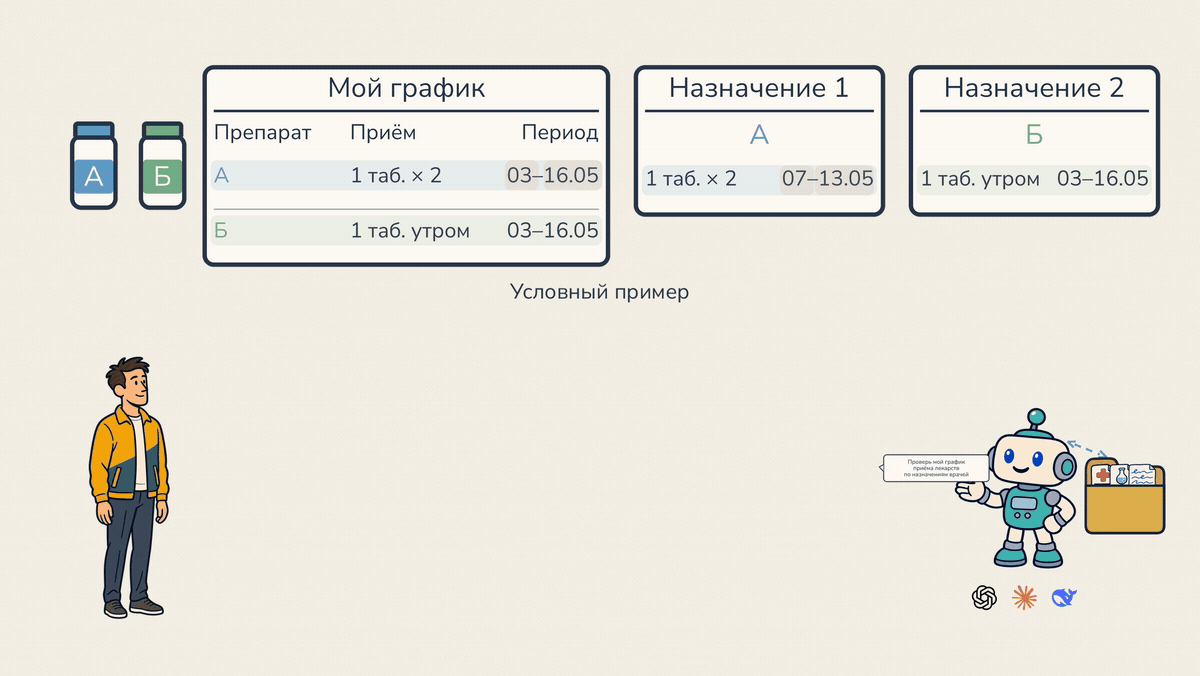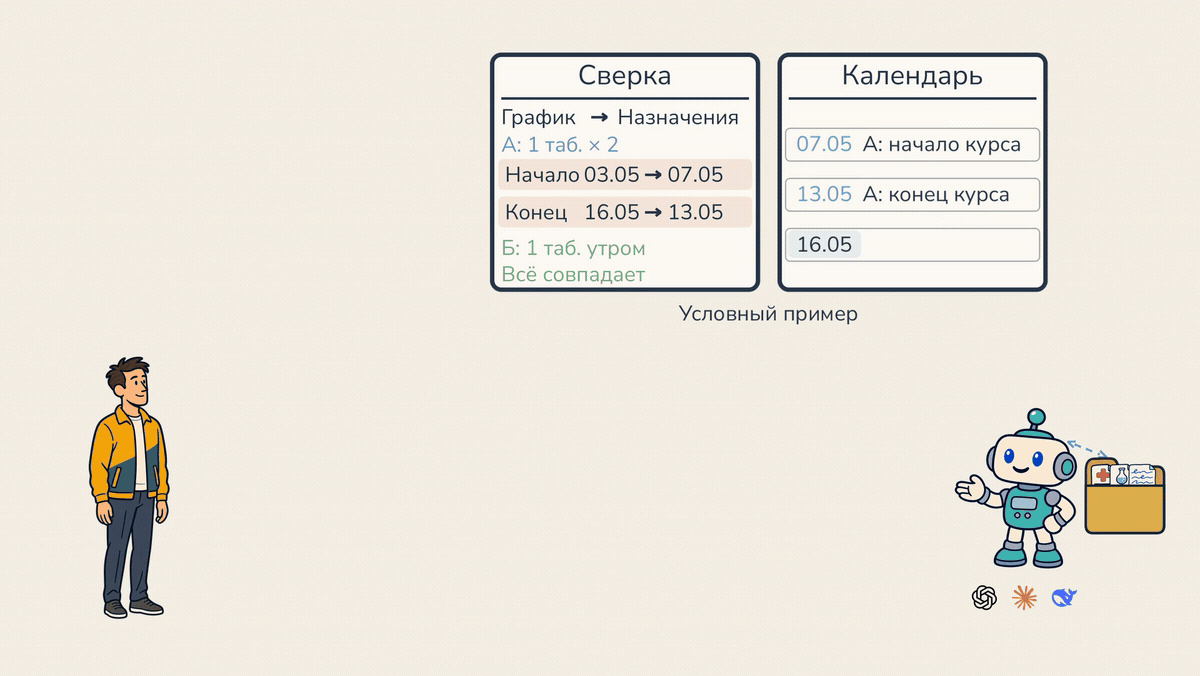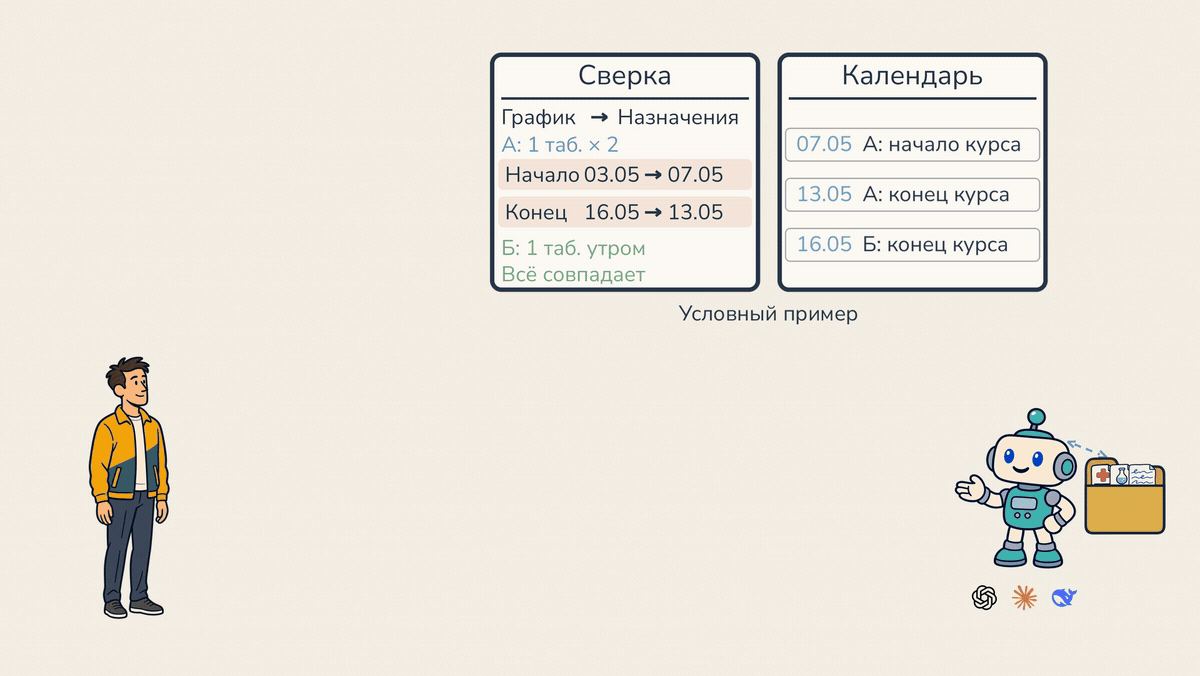
Предположим, что пользователь обращался к нескольким специалистам, каждый из которых назначал определённые препараты или давал рекомендации. При этом назначения могли меняться со временем. Модель может собрать сведения из соответствующих документов, сопоставить даты и подготовить общую таблицу или календарь.
Если обнаруживаются противоречия между назначениями, их можно отдельно выделить для уточнения у врача.
Здесь важно учитывать разницу между фактом назначения препарата и фактом его приёма. Первый может содержаться в медицинском документе, второй должен подтверждаться отдельными данными пользователя. Автоматически считать назначенный препарат принятым было бы ошибкой.
Общие свойства
Во всех рассмотренных случаях мы использовали одну и ту же систему данных, но выполняли над ними разные операции. Причём заранее не требовалось реализовывать отдельный интерфейс для подготовки к врачу, просмотра конкретного показателя или сравнения назначений. Модель определяла необходимые действия на основании пользовательского запроса и доступных инструментов.
Конечно, это не означает, что модель способна решить любую задачу. Многое зависит от полноты исходных данных, качества их организации и возможностей используемой модели. Однако перечень поддерживаемых сценариев перестаёт быть жёстко определённым набором функций приложения.
Достоверность и ограничения
Всё перечисленное работает при условии, что мы можем доверять накопленной информации. Но с ИИ-моделями здесь возникают определённые сложности. Например, при распознавании лабораторного бланка модель может неверно прочитать число, перепутать единицы измерения или связать значение не с тем показателем. Причём результат может выглядеть вполне правдоподобно.
Для снижения вероятности подобных проблем можно использовать дополнительную проверку, повторную обработку документа или сопоставление результатов нескольких инструментов. Однако ни один из этих способов сам по себе не гарантирует отсутствия ошибок.
Поэтому особое значение имеют свойства самой архитектуры. Первое — сохранение оригиналов, позволяющее в любой момент вернуться к исходному документу. Второе — прослеживаемость происхождения данных. Если в системе имеется определённое значение, желательно иметь возможность установить, из какого документа оно получено. Третье — разделение исходных сведений и результатов их интерпретации. Четвёртое — возможность повторной обработки и исправления данных. Если ошибка обнаружена, необходимо не только исправить конкретное значение, но и, при необходимости, пересмотреть результаты, которые были на его основании получены.
Безопасность
Медицинская история содержит чувствительную персональную информацию. Поэтому перед использованием системы необходимо понимать, где хранятся документы, каким инструментам модель имеет право их передавать и какие данные могут попадать во внешние сервисы. Здесь нет универсального решения. Например, использование локальной модели позволяет иначе организовать контроль над передачей данных, но не снимает требований к их защите на компьютере пользователя.
Наконец, необходимо различать работу с медицинской информацией и принятие медицинских решений. Система может помогать искать документы, сопоставлять результаты обследований, готовить сводки и вопросы для консультации. Но она не предназначена для самостоятельной постановки диагнозов или выбора лечения. Подобные решения требуют участия квалифицированных медицинских специалистов.
Как собрать собственную систему
Теперь рассмотрим, как можно воспроизвести описанный подход.
В принципе, для этого не требуется отдельная готовая программа. Достаточно создать структуру хранения данных и подготовить инструкции, по которым модель будет с ними работать.
Можно традиционно определить состав системы: какие виды информации предполагается сохранять, как разделяются оригиналы и результаты обработки, каким образом обеспечиваются связи между ними. Далее создать соответствующую структуру каталогов и файлов, описать правила работы с ними и поручить модели обработать несколько тестовых документов.
Но можно и по-другому. Передайте вашей модели текст этой статьи и попросите собрать готовую для вас систему.
Отдельно отметим, что это не жесткая структура - практика показывает, что она постоянно развивается и адаптируется под ваши потребности и обстоятельства.
Готовый шаблон
Для упрощения этой работы для вас подготовлен публичный шаблон на GitHub:
Он предназначен для организации собственной медицинской истории и содержит основу проекта, которую можно использовать при работе с ИИ-моделью. В README приведены описание системы и порядок начала работы.
Таким образом, есть варианты: спроектировать собственную структуру с нуля или по статье, или использовать готовую и при необходимости адаптировать её.
Заключение
В результате получаем систему, в которой основным элементом являются не заранее реализованные функции приложения, а данные и правила работы с ними. Информация хранится в обычных файлах, а ИИ-модель используется для выполнения операций над ними. При этом повторяющиеся действия можно выносить в отдельные скрипты, а результаты обработки сохранять для дальнейшего использования.
Особенность подхода заключается в том, что новые сценарии работы с информацией могут появляться уже в процессе эксплуатации системы, без необходимости предварительно реализовывать для каждого из них отдельный пользовательский интерфейс.
Но сама идея, на мой взгляд, применима не только к медицинской истории. Можно представить множество других областей, где накапливаются разнородные документы, информация связана между собой, а перечень будущих запросов заранее неизвестен.
И если вдруг дочитали и не заметили, то здесь отдельно напомню что для тех, кому удобнее визуальное объяснение есть рисованный ролик, в котором рассмотрены примеры работы системы и её основные компоненты: Как создать свою медицинскую систему с помощью ИИ — YouTube


Комментарии 0