Оценка сложности написанного через теорию информации — без лингвистики, без экспертов и без погружения в смысл
Каждый из нас сталкивался с текстами разной сложности. Простую инструкцию или аннотацию мы читаем быстро, «по диагонали», более сложный текст требует внимания: приходится сосредоточиваться на отдельных фразах, сверять обозначения, держать в голове несколько условий. Научная статья с формулами, сокращениями и зубодробительными символами порой вызывает ощущение, что решаешь изощрённую головоломку. В особо тяжёлых случаях приходится делать паузы, снова и снова возвращаться к уже прочитанному, возникает лёгкая паника: «Так, а я вообще понимаю, о чём это?»
Сложность текста зависит от тьмы тьмущей факторов, которые удобно разделить на «субъективные» и «объективные». Субъективные связаны с конкретным читателем: его знаниями, опытом, словарным запасом, схожестью типа мышления читателя с мышлением автора. Объективные — это формально измеримые характеристики самого текста: разнообразие слов, их длина, длина предложений, насыщенность терминами и символами. Для таких оценок существуют индексы удобочитаемости вроде ARI, они в целом неплохо работают, если коэффициенты подобраны правильно,
Но есть ещё один дистиллированно формальный путь — теория информации. Это математическая теория, которая ничего не знает ни о текстах, ни о контекстах, ни о читателе. Именно в этой «слепоте» её сила: она позволяет получить гарантированную верхнюю оценку информационного объёма текста, вовсе не вникая в смысл, на уровне букв и знаков.
Мера Хартли
Мера (формула) Хартли:

где  — мощность алфавита, то есть число различимых символов, а
 — количество информации в битах на один символ. Если текст состоит из
 символов, то его потенциальный информационный объём равен:
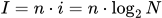
Формула предполагает, что все символы (о, ужас) равновероятны и независимы. Для реального текста это совершенно не так, но нам сейчас нужен не реальный текст, а его «потолок».
Кстати сказать, сам Ральф Хартли в статье «Transmission of Information» (1928, Bell Labs) использовал десятичный логарифм и десятичные единицы измерения, привычная запись с  и битами — конвенция более поздней эпохи, восходящая к работам Шеннона.
Почему логарифм? Так удобнее. Если два независимых символа выбираются из вариантов, общее число комбинаций равно  , информация должна складываться, логарифм как раз превращает умножение в сложение. Мера Хартли — это оценка разнообразия «в лоб», без учёта частотности букв и смысла.
Три условных типа текста
Примечание: оценки алфавитов ниже — это допущения, а не истина в последней инстанции.
Тип текста | Алфавит |
|
|
|---|---|---|---|
Простой технический | Русские буквы без учёта регистра (33) + цифры (10) + пробел и базовая пунктуация (~21) | ≈ 64 | 6,0 |
Сложный технический | Русский (33) + английский с регистром (52) + греческий с регистром (48) + цифры (10) + пробел, пунктуация и простые операторы (~37) | ≈ 180 | 7,5 |
Очень сложный научный | Всё перечисленное выше + математические глифы TeX (с запасом) | ≈ 20 180 | 14,3 |
Пара замечаний к таблице:
Пробел и пунктуация включены в оба простых алфавита — выбрасывать их «для удобства» было бы некорректно: это различимые символы, которые реально встречаются в тексте. Регистр русского, наоборот, отброшен (33 буквы вместо 66) т.к. в обычном тексте регистр почти полностью предсказуем и самостоятельной информации не несёт. Для «сложного технического» регистр оставлен, так как там он значим ( и
 в коде — разные вещи).
Про «20 000 глифов»: точное число зависит от шрифта и набора пакетов, поэтому цифра взята с запасом и осознанно. Ничего страшного: растёт медленно — если реальный набор математических глифов втрое меньше,  упадёт всего с 14,3 до 12,7 бит на символ, а все выводы ниже останутся в силе.
Итак, сложный технический текст «тяжелее» простого в 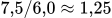 раза, а очень сложный научный — в
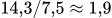 раза (в 2,4 раза тяжелее простого). Это не оценка смысла, не оценка понимания и не прогноз времени чтения — это оценка потенциального разнообразия алфавита: сколько бит в среднем мог бы нести каждый символ, если бы все символы встречались одинаково часто в абстрактном мире белого шума.
Чем полезна такая оценка
Оценка по Хартли превращает интуитивное ощущение «этот текст сложнее» в конкретные числа, причём числа обоснованы не субъективным экспертным мнением, а математической теорией. Математичность означает универсальность: теория применима не только к текстам, но и к нотным записям, кулинарным рецептам — к любой системе различимых символов‑объектов.
Как говорил Пуанкаре в книге «Наука и гипотеза» (1902):
«Математики не изучают предметов, но лишь отношения между ними; поэтому для них безразлично заместить одни предметы другими, лишь бы только не менялись отношения. Для них не важна материя; их интересует только форма».
(Пуанкаре А. Наука и гипотеза. — Москва, 1904)
Именно в этой «безразличности к материи» кроется сила формальных мер вроде меры Хартли: нам не нужно понимать смысл текста, чтобы оценить его потенциальный информационный объём. Мы работаем с формой — с набором различимых символов и их количеством.
Что можно делать с этими числами? Можно грубо оценивать информационный объём документа, сравнивать документы по насыщенности алфавита, прикидывать требования к «ширине канала» восприятия. Чего нельзя — судить по этой мере о понимании, времени чтения или качестве текста: осмысленное предложение и бессмысленная абракадабра из тех же символов дадут одинаковый результат. Мера измеряет объём, а не сложность в привычном смысле.
Для оценки сложности были бы нужны другие инструменты, например колмогоровская сложность. Нюанс, колмогоровская сложность принципиально невычислима: не существует алгоритма, который для произвольной строки гарантированно выдаст её истинную сложность [1]. В отличие от Колмогорова, мера Хартли даёт вполне вычислимую оценку: она считает информацию исходя из размера алфавита, длины сообщения и всё [2].
Граница не приговор
Естественно, это рамочная и заведомо завышенная оценка. Реальный текст использует только часть алфавита, а частоты символов неравномерны. По разным оценкам, реальная энтропия связного русского текста — порядка 1,5–2 бит на символ (с учётом контекста), то есть заметно ниже 6 бит нашего «потолка». Уточнить расчёт можно по формуле Шеннона [3], которая учитывает вероятности появления символов и состав конкретного текста, но тогда оценка перестанет быть оценкой «вообще» и привяжется к конкретному документу.
Для нашей задачи важно было показать принцип: грубейшая информационная модель позволяет гарантированно, железно очертить верхнюю границу информационного объёма, а это уже немало.
Что дальше
Ответ на вопрос в стиле «как измерить всё что угодно»: примем, что страница текста — это 2000 знаков с пробелами (лист А4 в 12‑м кегле, константа условная, но удобная). Биты переводим в байты делением на 8, а в КиБ — делением на 8192:
Простая страница:
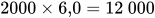 бит = 1500 байт ≈ 1,5 КиБ.
Сложная:
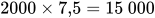 бит = 1875 байт ≈ 1,8 КиБ.
Хардкорная:
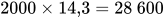 бит = 3575 байт ≈ 3,5 КиБ.
Итого (в нулевом приближении): страница текста несёт от полутора до трёх с половиной КиБ потенциальной, гипотетической информации — в зависимости от богатства её алфавита.
Спасибо за внимание. Кстати, вы только что получили до 6.8 килобайт информации.
Ссылки
[1] Невычислимость колмогоровской сложности: https://ru.wikipedia.org/wiki/Колмогоровская_сложность#Основные_следствия
[2] Мера Хартли (формула Хартли): https://ru.wikipedia.org/wiki/Формула_Хартли
[3] Формула Шеннона: https://ru.wikipedia.org/wiki/Информационная_энтропия

Комментарии 0