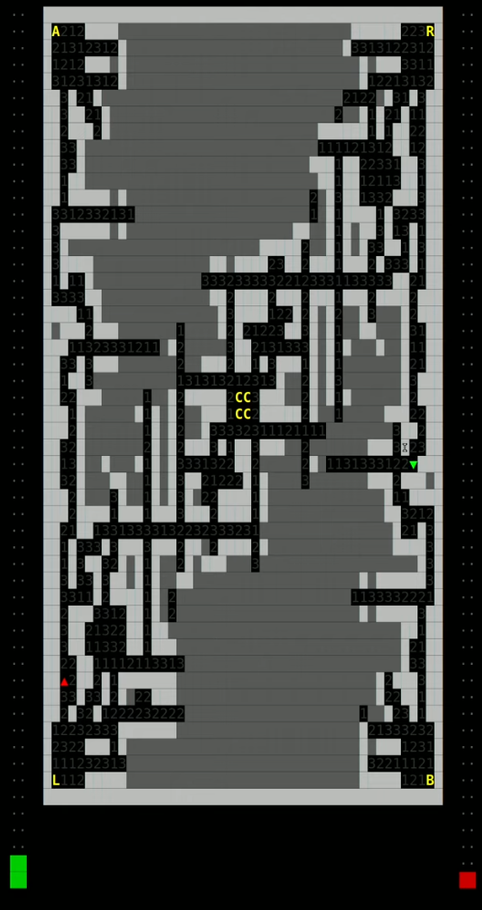
Это третья, заключительная часть рассказа о том, как я выиграл Кубок СЭРПАС 2026 на Эльбрусе. В первой части я рассказывал про особенности Эльбруса и задачу 1, во второй про свёртки сигналов и карту с пунктами выдачи, а здесь речь пойдёт о финале, где все три задачи сошлись в одном лабиринте. Ну и в конце немного про нейронки и выводы.
Оглавление
Финал: бот в лабиринте
Правила
Финальная задача, на мой взгляд, была самой интересной во всём соревновании и придумана очень классно. Лабиринт 48×48 с пещерами, коридорами и тупиками, два бота стартуют в противоположных углах и бегут одновременно. Сначала нужно добежать до одного из боковых углов, потом в центр, потом в другой угол и в конце на старт соперника, и кто доберётся быстрее, тот и выиграл. Полное условие лежит в PDF.
Фишка в том, что каждая клетка лабиринта сама по себе задача, одна из трёх отборочных. Чтобы шагнуть в новую клетку, бот получает данные, решает задачу и отправляет ответ. Решатели при этом те же, что на отборе, улучшать их нельзя, можно только адаптировать ввод-вывод и число потоков. Видно на восемь клеток вокруг, а через стены не видно вообще.
А ещё есть стан, то есть штраф за память, который выражается во времени:
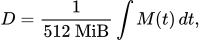
где  — время, которое бот простоит перед контрольной точкой, а
 — сколько памяти он держит в момент
 . Чем больше и дольше держишь память, тем дольше потом стоишь, пока соперник бежит. Если, например, держать 64 МиБ в течение минуты, получится
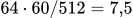 секунды стояния.
Из-за всего этого у каждого бота получаются свои скорости на разных типах клеток, а значит, и свой оптимальный маршрут. Если у тебя, допустим, третья задача решается быстрее остальных, то и идти выгоднее по клеткам с третьей задачей. Финалистам дали по 31 ядру четырёхпроцессорного сервера на Эльбрус-8СВ. Кстати, мои отборочные решатели взяли за эталон при калибровке времени клеток, чем я, если честно, немного горжусь.
Туман
Сначала нужно было понять, что делать с клетками, которые бот ещё не видел. Если считать их опасными, бот просто будет топтаться на месте, поэтому я сделал так, что неизвестная клетка считается проходимой, просто подороже. Бот идёт в туман, упирается в стену, пересчитывает путь и идёт дальше.
Чтобы выбирать путь, бот оценивает, во сколько времени обойдётся шаг в каждую клетку. Оценка зависит от того, что он о клетке уже знает, а 10 мс в таблице ниже означают цену самого хода.
Клетка | Стоимость входа |
|---|---|
Стена | ∞ |
Уже решена мной | 10 мс + сохранённое время решения |
Свободна, тип виден | 10 мс + выученная стоимость типа |
Свободна, тип не виден | 10 мс + ожидание по трём типам |
Вообще не видна | то же ожидание × вес участка маршрута |
Поиск пути
Путь ищется через A*. Точный A* «заливал» карту, потому что самая дешёвая клетка намного дешевле типичной и эвристика получается слабой. Я сделал его чуть жаднее, с весом 2: маршруты от этого стали хуже всего на 0,3%, а планирование ускорилось в три раза.
Но больше всего дало другое. Сначала планировщик думал про весь маршрут сразу, со всеми этапами. Генератор карт умел строить лабиринты и до 192×192, и я прикинул, что на таком размере бот тратил бы на раздумья около 50 секунд за гонку. Потом я заметил, что цена клетки не зависит от того, как ты в неё пришёл, а значит, маршрут — это просто сумма участков, и чтобы решить, куда шагнуть сейчас, достаточно искать путь до следующей контрольной точки. Переписал, и даже на большой карте планирование стало занимать около 2,5 мс на ход вместо 44. На финальных 48×48 бот думал практически мгновенно.
Зеркало
Лабиринт был симметричен при повороте на 180°, а значит, каждая клетка, которую я вижу, заодно показывает мне и зеркальную клетку у соперника. Иду к своему углу, вижу коридоры и уже знаю, какие коридоры у него, так что на второй половине маршрута путь по сути известен заранее.
Но реально увиденная клетка для бота всегда важнее догадки, а если путь вдруг не находится, он выкидывает все зеркальные догадки и ищет как обычно, чтобы не сломаться ни при каком генераторе. Что так делать можно, я заранее уточнил у Кирилла.
А вот к какому углу бежать первым, бот заранее просчитать не может. Со старта это почти не угадать, и в этом своя интрига, ведь даже при хороших решателях каждая карта немного лотерея, и смотреть за этим на стриме было очень интересно.
Как бот узнаёт цены
Боту нужно понимать, сколько на самом деле стоит клетка каждого типа. После каждой новой клетки он берёт время решения по серверу плюс начисленный стан, а стоимость типа считает как медиану последних пяти. Именно медиану, чтобы один медленный шаг не перевернул весь маршрут и бот вдруг не решил, что выгоднее идти по другим клеткам. Своим часам бот при этом не верит, потому что в них входит время, которое сервер не учитывает.
Сначала бот ещё мерил скорость на прогреве перед стартом, и я увидел, что из-за шума одна и та же карта проходилась то быстро, то заметно медленнее, потому что из-за чуть других цифр в начале бот принимал другие первые решения и весь маршрут получался другим. В итоге я зафиксировал стартовые значения, замеренные заранее (344, 292 и 131 мс для трёх типов), и всё стало стабильно.
Двенадцать потоков быстрее тридцати
Ядер тридцать одно, так что логично же дать всем решателям по тридцать потоков. Для первой задачи я так и сделал, там свой пул с маленькими стеками, и он нормально масштабируется. А вот во второй и третьей каждый живой OpenMP-поток держит около мегабайта, и это всё копится, а память, напомню, превращается в стан. К тому же свёртка на 16 и 30 потоках работала ещё и медленнее, чем на 12. В одном из замеров с 30 потоками во второй и третьей задаче бот финишировал за 151 с, а с 12 за 134,5 с, так что двенадцать оказались и быстрее, и дешевле. В итоге стан занимал около 6–7% времени гонки.
Симулятор и один баг
Много времени ушло на инфраструктуру, в первую очередь на симулятор гонки на основе официального генератора карт. Зато каждую идею можно было за вечер проверить на сотнях карт. Финальную версию бота я прогнал на 200 картах с обеих сторон и с разными вариантами генерации, и за 780 прогонов не случилось ни одного сбоя.
А ещё при адаптации решателей к финалу всплыл баг. В финальном профиле задачи 2 было 72 канала вместо максимум 16 на отборе, а сумма сигналов одинаковых каналов лежала в int8. На отборе всё влезало, а здесь начало бы переполняться. Поправил одну строчку (int8 → int16) и добавил проверку оценки, но урок запомнил. Если оптимизировал под конкретные ограничения, а они поменялись, перепроверять нужно всё.
Как прошёл финал
Финал шёл в прямом эфире, и это совершенно отдельное ощущение. На экране лабиринт, который открывается по мере того, как боты его видят, две точки пробираются через туман, а сбоку растут столбики стана. Повлиять уже ни на что нельзя, всё, что ты месяц настраивал, работает само, и остаётся только смотреть, свернёт ли бот в правильный коридор.
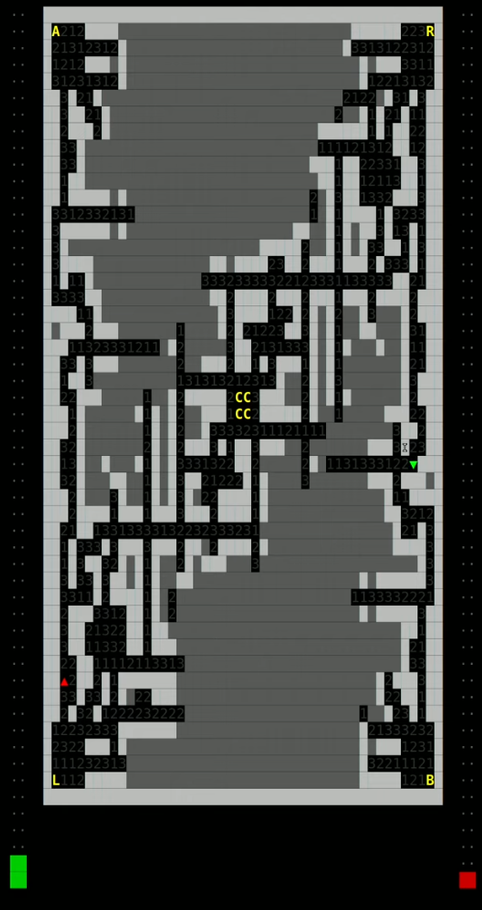
Серию я выиграл 2:0, но скучной она не была, ведь под конец соперник шёл почти вровень, и Кирилл до последнего ждал хотя бы одной ничьей. Её так и не случилось, но за последние клетки до финиша я переживал больше, чем за всю подготовку.
Где помогали нейронки
ИИ-ассистентами я, конечно, пользовался, как сейчас делают почти все. Больше всего они экономили время на рутине, когда нужно быстро набросать очередной вариант ядра для замера или написать скрипт, который разберёт логи. За счёт этого итерации шли быстрее, и за вечер получалось проверить больше идей.
Но на Эльбрусе нейронка сама по себе решает мало. Материалов про e2k в интернете немного, модели учились в основном на коде под x86 и ARM, и советы у них соответствующие. А главное, нейронка не видит железо. Любая модель скажет, что сделать на 60% меньше работы лучше, и почти везде это правда, но не здесь, и узнать это можно, только если отправить и посмотреть.
Поэтому вся оптимизация по сути была циклом экспериментов, где каждую гипотезу я проверял замером на настоящем железе. Решать, что пробовать и какой версии верить, и было основной работой. Однажды симулятор финала показывал, что одна настройка лучше, а на реальном сервере она оказалась сильно хуже (104,8 с против 85,2), и такое никто не заметит, пока сам не перемеряет.
Именно поэтому защита решений, по-моему, очень правильная штука. Сидишь перед камерой, без нейронок, запустить ничего нельзя, а тебя спрашивают, почему сделано так и что будет, если поменять вот это. Мне как первому досталось по 12 вопросов на задачу, и защита шла почти три часа подряд, после чего число вопросов сократили до трёх. Готовился я к ней не меньше, чем к самим задачам, разбирая каждое место в коде и то, почему оно сделано именно так.
Для меня нейронка такой же инструмент, как компилятор. LCC раскладывает мои циклы по широким командам лучше, чем я сделал бы руками, но решать, что и как оптимизировать, всё равно приходится программисту.
Что я понял
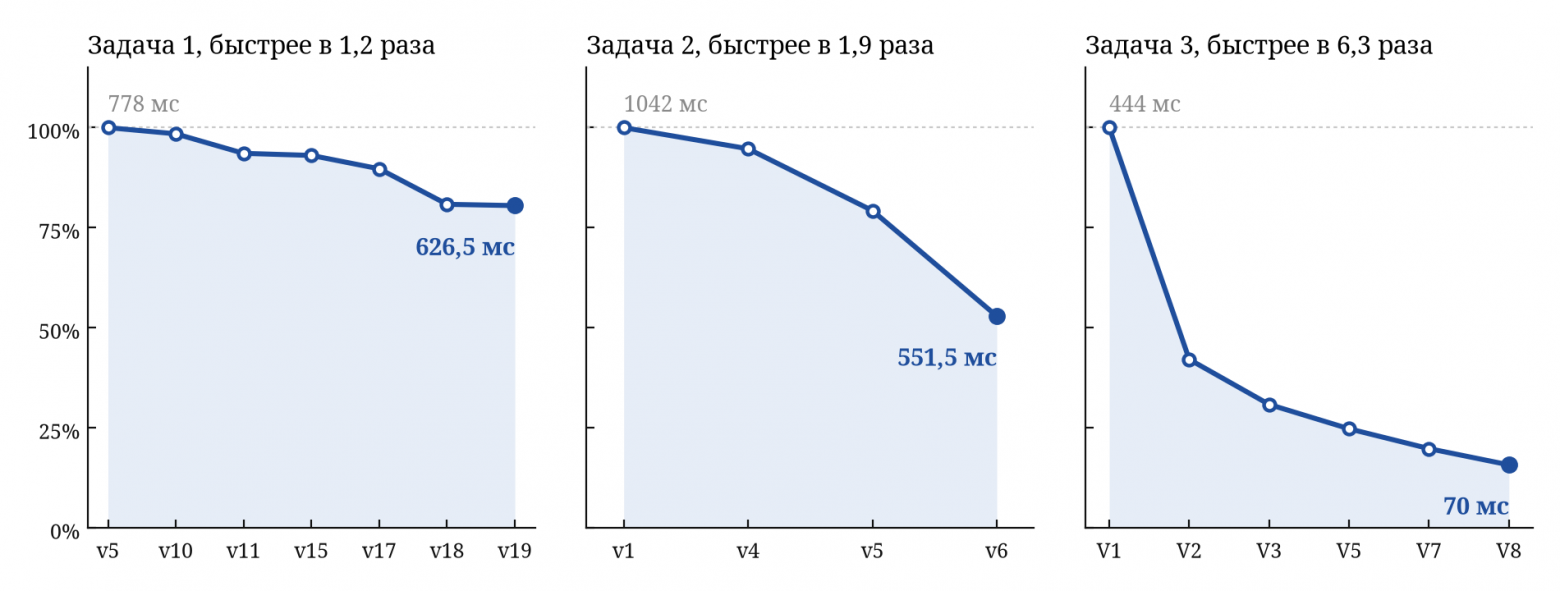
Если собрать всё вместе, то вот что я понял за это соревнование.
Сначала стоит выкинуть лишнюю работу и только потом ускорять то, что осталось, в задаче 3 одно это дало ×6,3.
Убирая работу, нельзя ломать регулярность, потому что на Эльбрусе ровный простой цикл часто быстрее хитрого.
У VLIW есть оптимальная ширина, при меньшей в широкой команде пустуют слоты, а при большей кончаются регистры.
Мерить нужно на целевом железе и именно то, что меряет тестирующая система, потому что x86, профайлер и симулятор подводили меня не раз.
Память тоже стоит времени, поэтому у меня появились свой пул вместо OpenMP и 12 потоков вместо 30.
Когда ядро уже быстрое, тормозить начинают ввод, вывод и аллокации.
Неудачи стоит записывать, потому что больше всего я узнал именно из них.
Благодарности
Огромное спасибо Кириллу Ерохину. Человек на свои деньги покупает Эльбрусы, сам всё поднимает, сам пишет задачи и сервер для финала и при этом отвечает на вопросы почти в любое время суток. Во время финала я писал ему очень много вопросов, и он всегда отвечал быстро и подробно. Без него этого соревнования просто не было бы.
Что дальше?
Дальше я собираюсь заняться научной работой на оборудовании, которое предоставил Кирилл. Хочу сравнить Эльбрус-2С3 с современными x86 и проверить, насколько хорошо нейросети оптимизируют код под Эльбрус. Результатами обязательно поделюсь здесь же.
А если вы думаете, идти ли на следующий Кубок СЭРПАС, то идите. Даже если не выиграете, про наши процессоры узнаете очень много, в том числе и то, что «меньше работы» не всегда значит «быстрее».

Комментарии 0