Почти вступление
Всем привет, я продолжаю потихоньку своё погружение в мир ИИ, и этот материал не является обучающей статьей, которая даст вам глубокие знания или объяснит выбранную тему на чётких примерах. Это агрегация полученных мною знаний, которая, на мой взгляд, будет полезна определённой группе людей, которые планируют в целом работать рядом/около с системами, построенными на использовании языковых моделей для решения различных задач (мне бы она была полезна, если бы я нашёл именно в таком формате). Это не урок — это шпаргалка.
Я уже в общем виде давал описание работы RAG‑системы: от сбора документов и чанкинга до генерации ответа, и разобрал, что происходит на каждом этапе. Здесь сосредоточимся на одном из ключевых этапов — retrieval — и представим информацию в таком контексте, чтобы мы сами могли ответить на некоторые вопросы, которые, например, у меня возникали в процессе обучения: Как вообще организовать поиск? Является ли он последовательным или может быть параллельным? Сколько ретриверов можно/нужно использовать для поиска? Являются ли функции поиска, агрегации, ранжирования и дедупликации функциями одной компоненты или это разные программы/плагины?
Вот теперь точно вступление
Для всех. Начнём с определения, куда ж мы без него, если вы только зашли сюда. Гибридный поиск — это подход, при котором используются несколько независимых каналов (лексический, семантический, графовый) с последующим объединением, фильтрацией или маршрутизацией результатов. Причина проста: ни один канал не является оптимальным для всех типов запросов. BM25 хорошо ловит точные термины и коды, но не понимает синонимы. Векторный поиск понимает смысл, но может «промахнуться» на точных терминах. Графовый поиск силён в вопросах, где логика строится от связей объекта поиска, но дорог в построении и плохо работает с нечёткой семантикой.
Для таких, как я. Если вам сложно понять смысл всего вышесказанного, давайте попроще... Мы выбираем, как нам искать: 1) точное совпадение слов/терминов/выражений; 2) смысловое совпадение по логике отдельных фрагментов; 3) через связи отдельных свойств запроса, очень в грубом выражении можно сравнить с методом дедукции, который применял Шерлок Холмс. Гибридный поиск говорит нам о том, что всё это можно использовать вместе; вопрос — в последовательности и совместимости результатов.
Продолжаем. Ниже — четыре способа организовать гибридный поиск, каждый со схемой, таблицей этапов и таблицей ролей.
1. Параллельный поиск + Fusion (RRF)
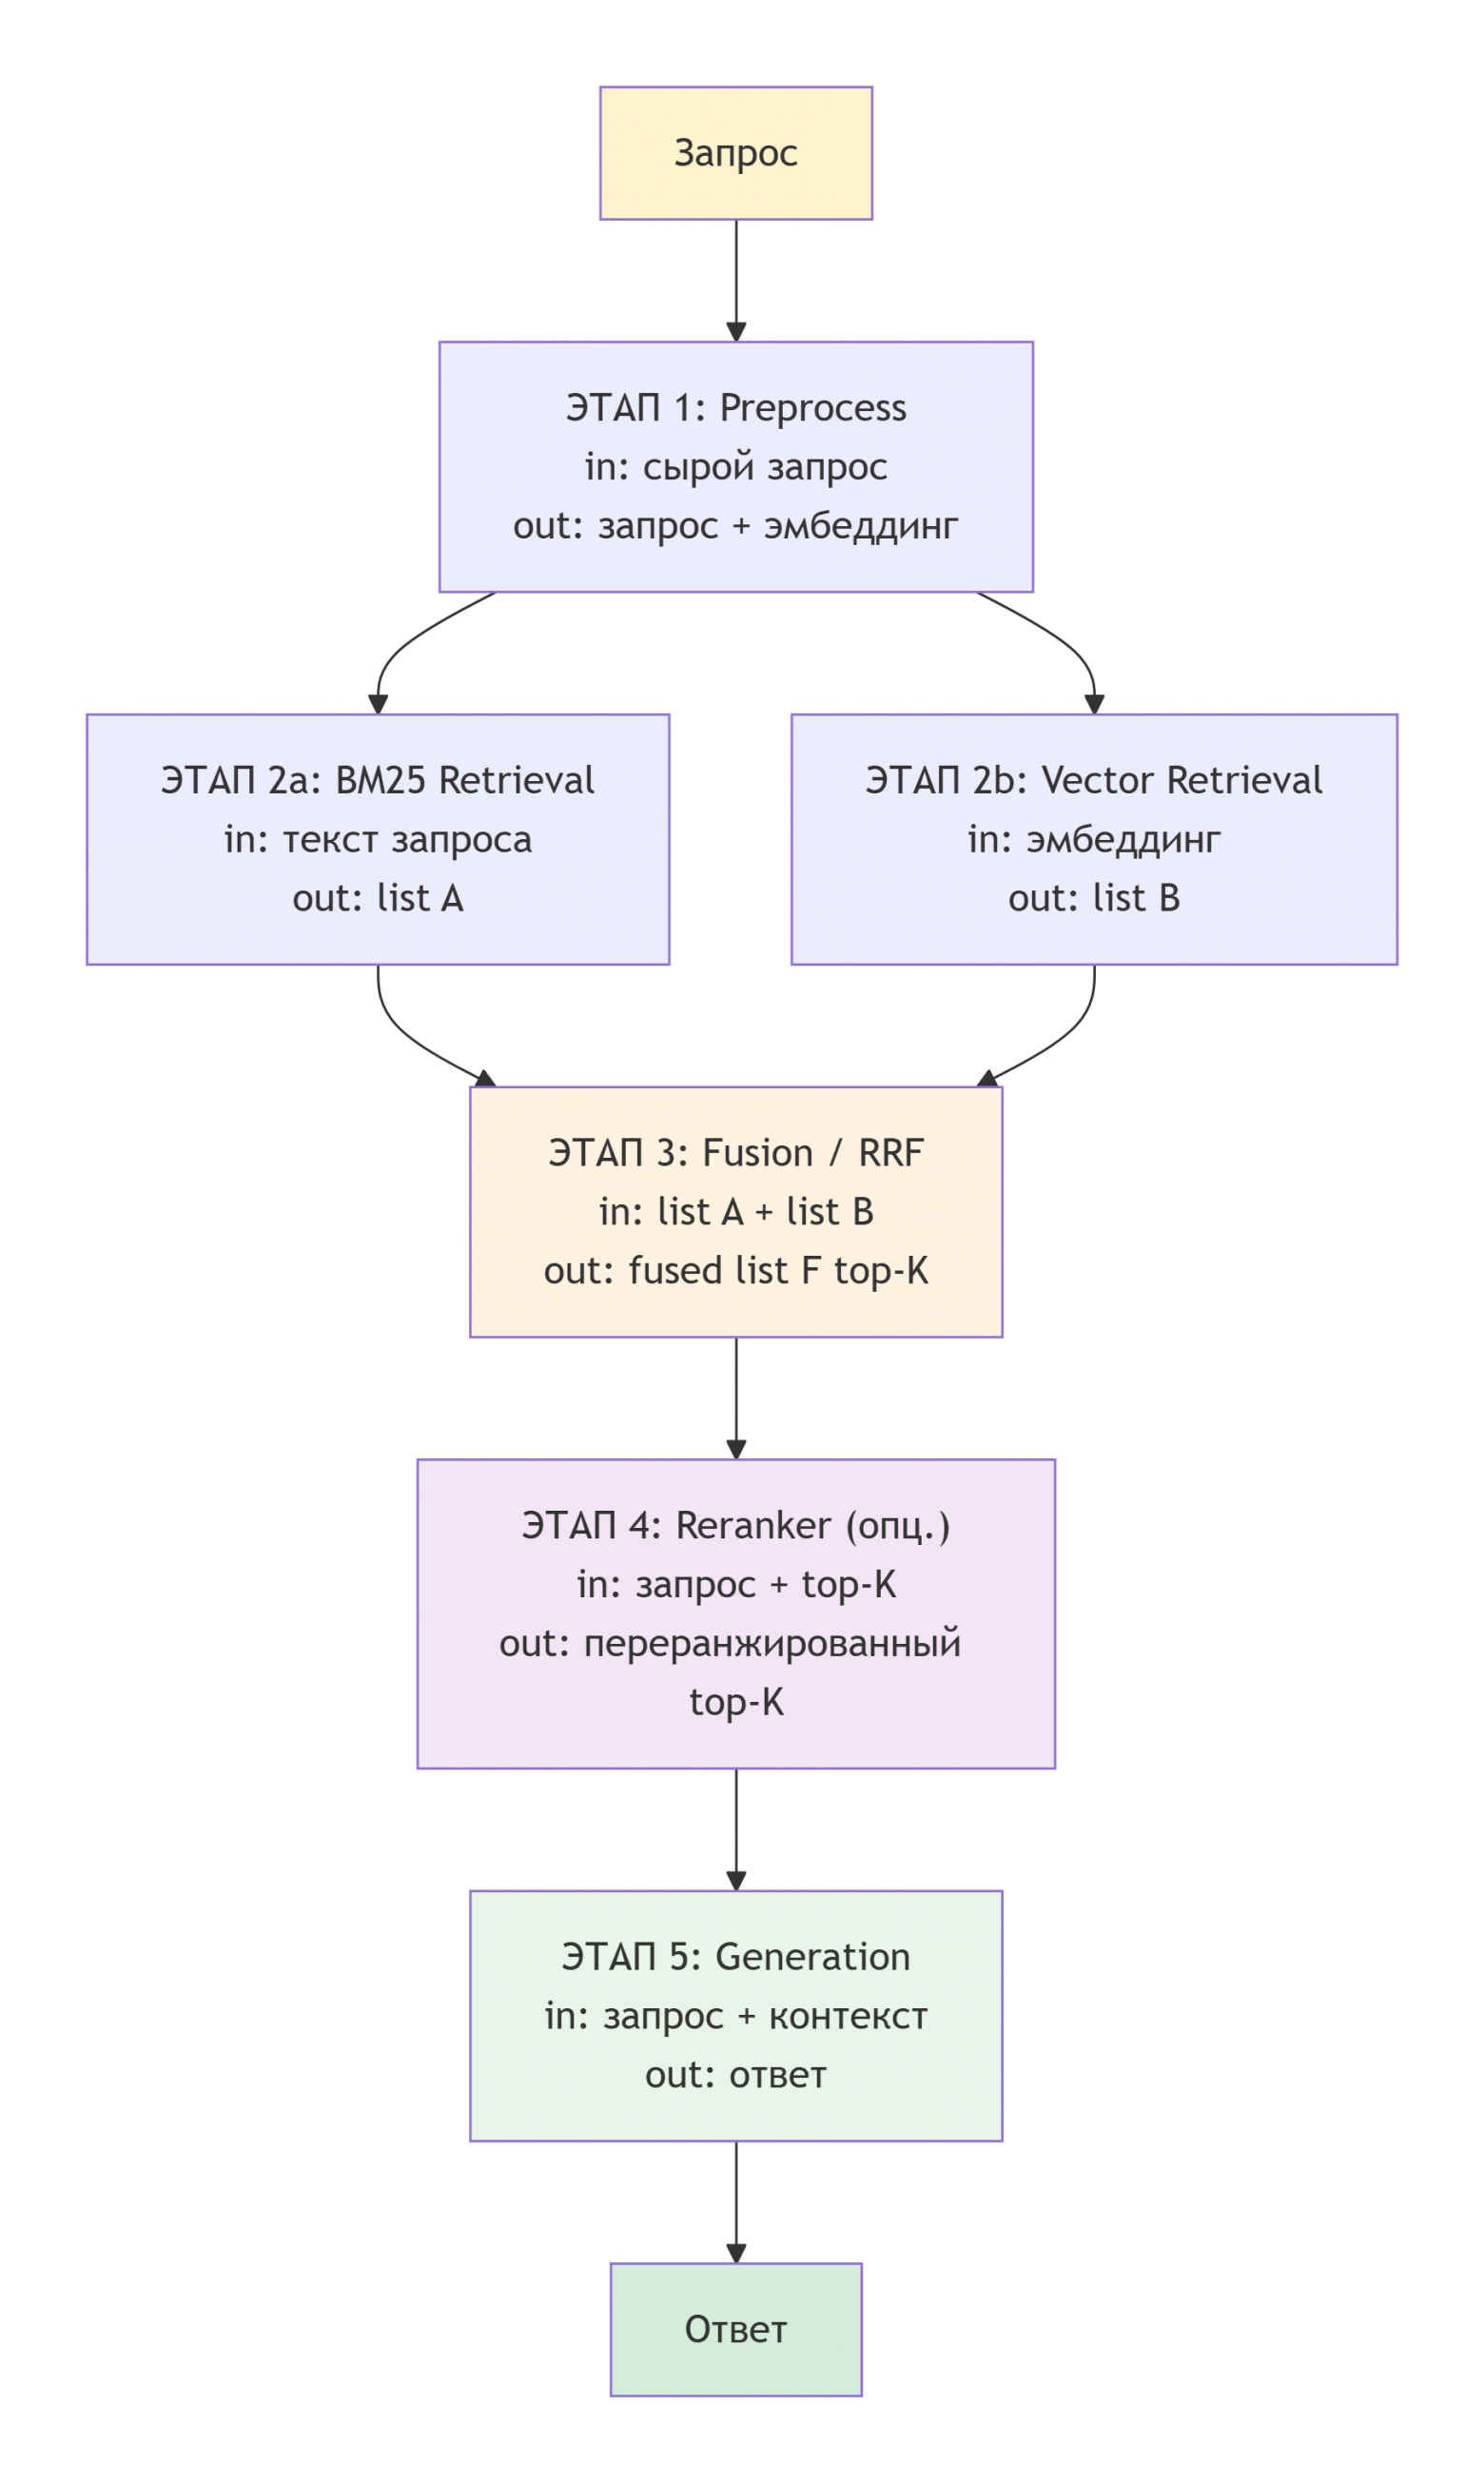
Представьте двух библиотекарей, которые одновременно ищут по вашему запросу: один листает каталог (BM25), другой — полки (векторный поиск). Затем кто‑то третий садится и объединяет их списки, отдавая предпочтение книгам, найденным обоими. Именно так работает Fusion: BM25 и векторный поиск выполняются параллельно и независимо по одному и тому же запросу, а их ранжированные списки объединяются через Reciprocal Rank Fusion (RRF) — по позициям, а не по сырым скорам, что устойчиво к разным шкалам. Опционально сверху ставится cross‑encoder reranker, который переранжирует топ‑K кандидатов, оценивая пару (запрос, документ) целиком. Это базовый паттерн гибридного retrieval: дёшево, работает «из коробки», не требует графа.
Таблица этапов:
Этап | Вход | Выход | Что передаётся дальше | Кто выполняет |
|---|---|---|---|---|
1. Preprocess | Сырой запрос | Запрос + эмбеддинг | Один и тот же запрос в оба ретривера | Orchestrator |
2 a. BM25 Retrieval | Текст запроса |
| Ранжированный список A | BM25 Retriever |
2 b. Vector Retrieval | Эмбеддинг |
| Ранжированный список B | Vector Retriever |
3. Fusion / RRF |
|
| Top‑K + исходный запрос | Fusion Module |
4. Reranker (опц.) | Запрос + top‑K | Переранжированный top‑K | Контекст + исходный запрос | Reranker |
5. Generation | Запрос + контекст | Ответ | - | LLM |
2. Каскадный поиск (Cascade)
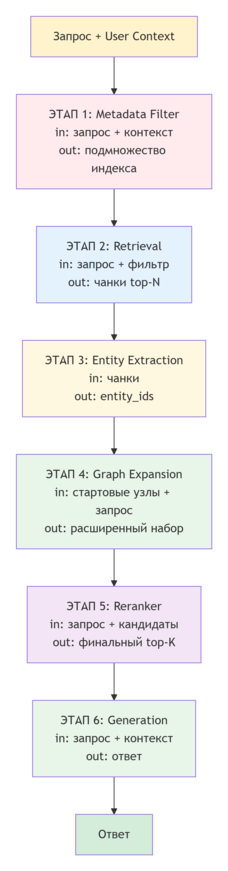
Представьте, что вы пришли в архив с ограниченным доступом. Сначала охрана проверяет ваш пропуск (metadata‑фильтр) — и только если он действителен, вы попадаете внутрь. Затем вы ищете нужные документы в доступной вам зоне (retrieval внутри подмножества). После этого вы смотрите на связи между найденными документами (извлечение сущностей и обход графа), чтобы найти смежные материалы. И в конце вы просматриваете отобранное и оставляете самое релевантное (reranker). Это каскад: каждый следующий шаг работает только с тем, что прошло предыдущий фильтр. Сначала — жёсткий metadata‑фильтр (tenant, права, даты), авторизация по сути. Затем retrieval внутри отфильтрованного подмножества. Затем из найденных чанков извлекаются сущности, которые становятся точками входа в граф, и выполняется bounded traversal (1–2 hops). В конце — reranker, ну куда уж без него.
Таблица этапов:
Этап | Вход | Выход | Что передаётся дальше | Кто выполняет |
|---|---|---|---|---|
1. Metadata Filter | Запрос + контекст ( | Подмножество индекса | Фильтр (ограничение) + исходный запрос | Orchestrator / Vector DB |
2. Retrieval | Запрос + фильтр | Чанки top‑N | Чанки (не запрос) + исходный запрос | Retriever |
3. Entity Extraction | Чанки |
| Сущности как стартовые узлы + запрос | NER / Entity Linker |
4. Graph Expansion | Исходный запрос + стартовые узлы | Расширенный набор | Расширенный набор + запрос | Graph Engine |
5. Reranker | Запрос + кандидаты | Финальный top‑K | Контекст + запрос | Reranker |
6. Generation | Запрос + контекст | Ответ | - | LLM |
3. Роутинг (Query Routing)
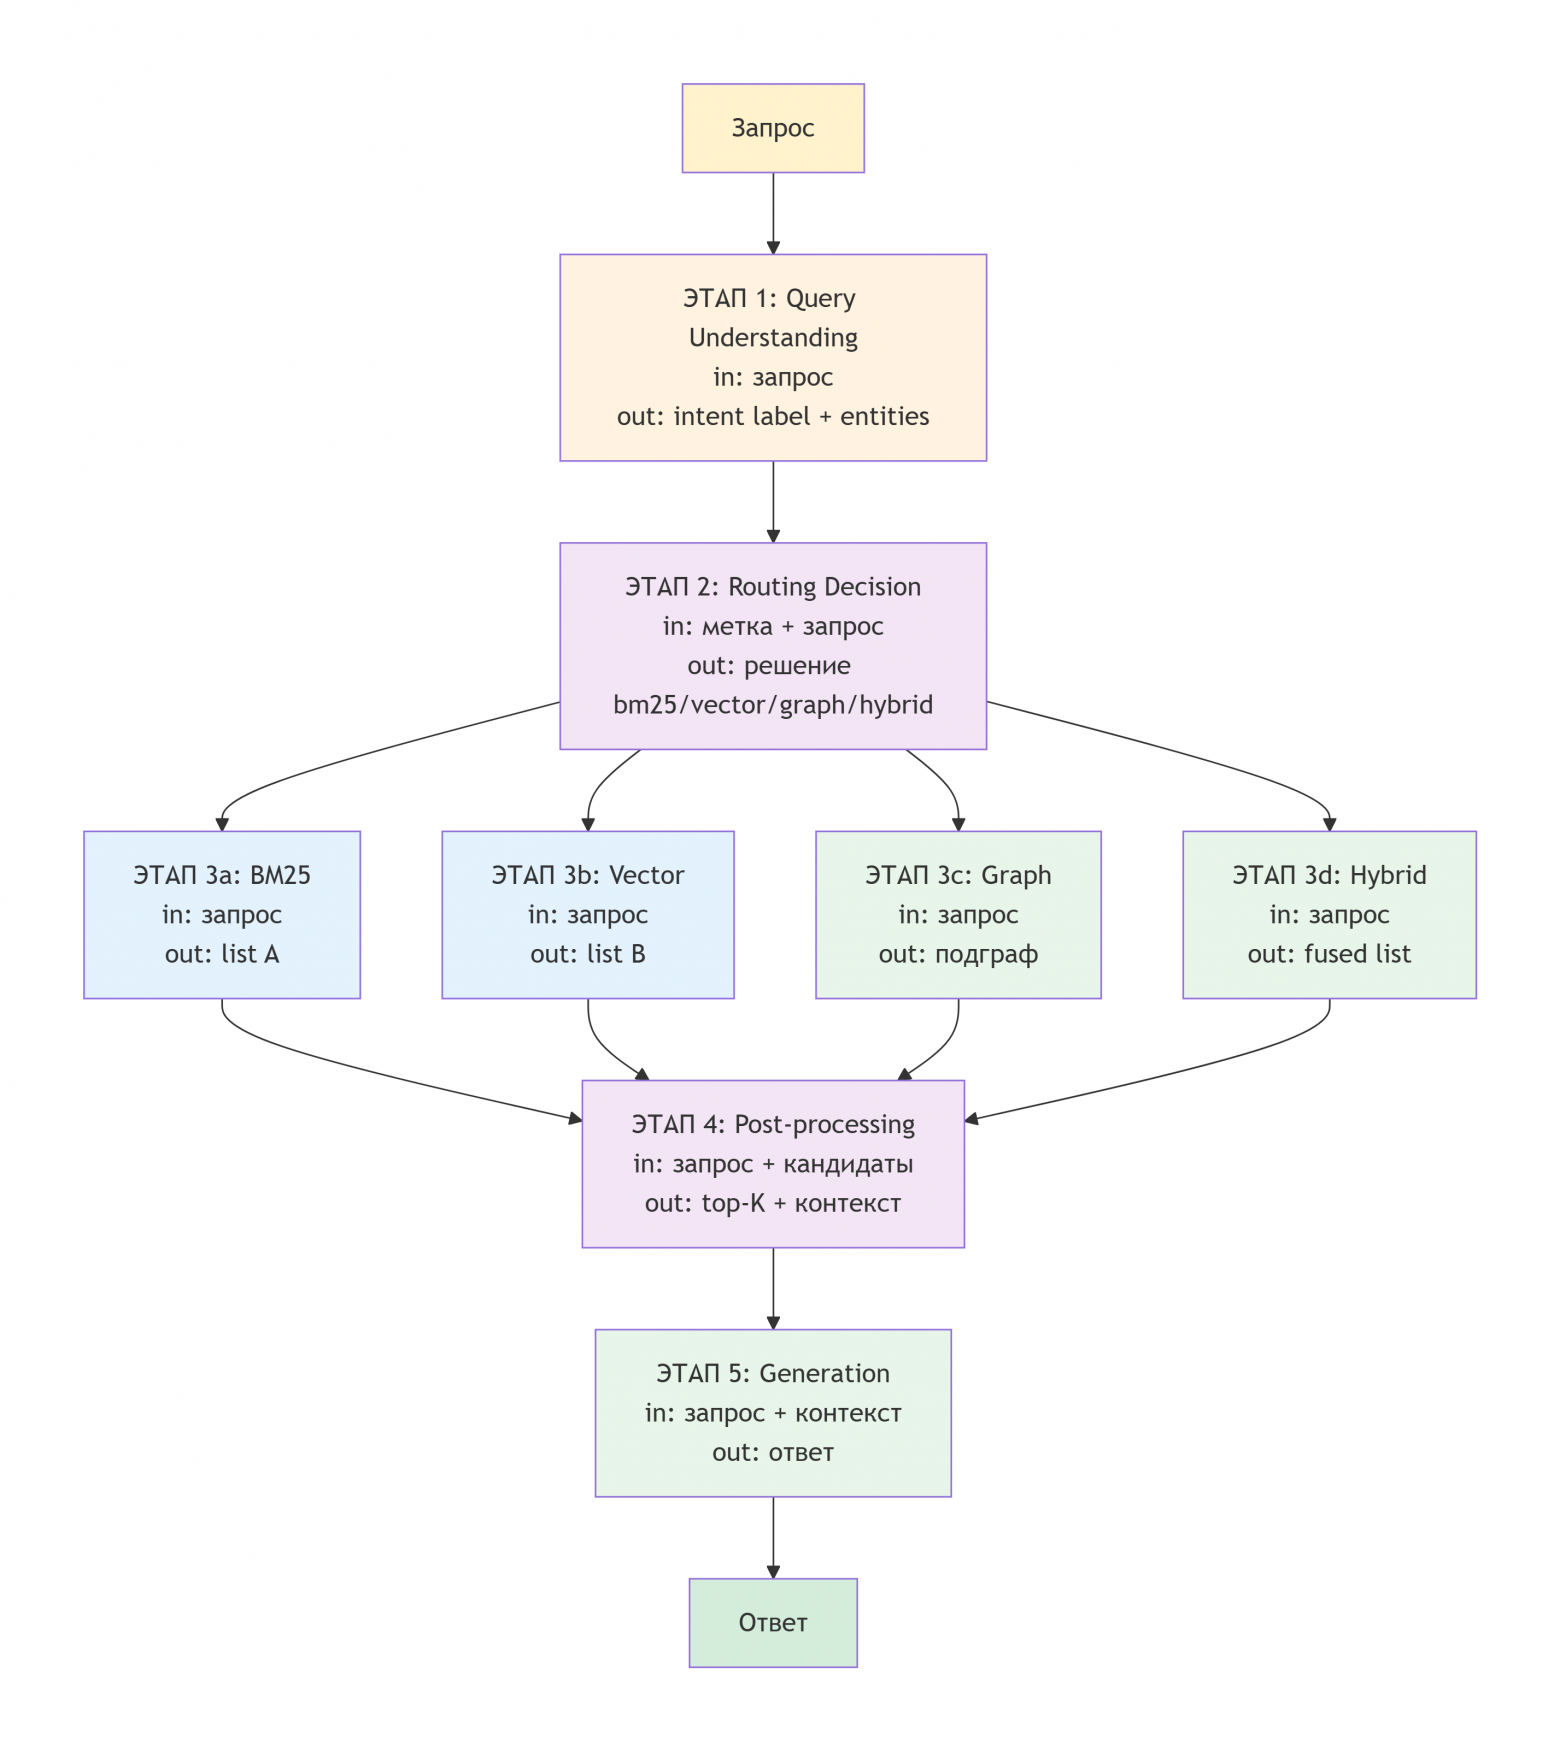
Представьте администратора в библиотеке, который выслушивает ваш вопрос и направляет вас к нужному специалисту: за точными кодами — к каталогу, за смысловыми вопросами — к библиотекарю, за связями — к архивариусу. Сам он вопрос не переписывает — просто выбирает инструмент. Так и роутинг: система классифицирует запрос и выбирает оптимальный канал (BM25, vector, graph или hybrid) вместо того, чтобы всегда запускать все ретриверы. Это экономит ресурсы и повышает точность на разных типах запросов: точные коды — в BM25, смысловые вопросы — в vector, multi‑hop — в graph, смешанные — в fusion. Роутинг — это диспетчер, а не цепочка переформулировок: запрос остаётся одним и тем же, меняется только инструмент.
Таблица этапов:
Этап | Вход | Выход | Что передаётся дальше | Кто выполняет |
|---|---|---|---|---|
1. Query Understanding | Сырой запрос | Метка + сущности | Метка + исходный запрос | Intent Classifier |
2. Routing Decision | Метка + запрос | Решение о канале | Решение + исходный запрос | Router |
3 a–3d. Execution | Запрос + решение | Кандидаты | Кандидаты + исходный запрос | Выбранный Retriever |
4. Post‑processing | Запрос + кандидаты | Top‑K + контекст | Контекст + исходный запрос | Reranker / Deduplicator |
5. Generation | Запрос + контекст | Ответ | - | LLM |
4. Graph‑first (GraphRAG)
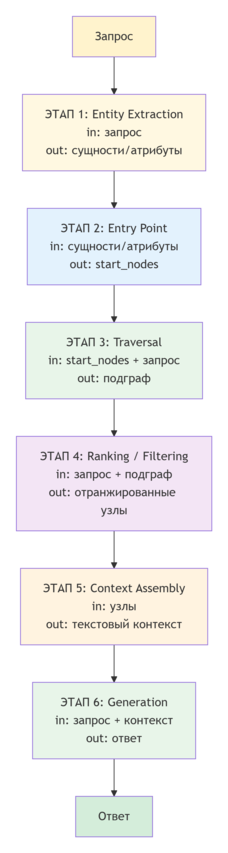
Представьте, что вы видите новость: компания «Alpha Corp» купила завод. Вам нужно понять, кто её конечный бенефициар. Вы не ищете компании, похожие на «Alpha Corp», вы идёте по цепочке: «Alpha Corp» владеет «Beta Holdings», «Beta Holdings» владеет «Gamma LLC», «Gamma LLC» принадлежит гражданину N. Ответ находится не по сходству, а по пути по связям. Это и есть Graph‑first: поиск начинается со связей, а не с похожести. Из запроса извлекаются сущности, находятся стартовые узлы. Векторы же на узлах используются для ранжирования внутри подграфа. Это смена парадигмы: граф — первичная структура, вектор — вспомогательный инструмент.
Таблица этапов:
Этап | Вход | Выход | Что передаётся дальше | Кто выполняет |
|---|---|---|---|---|
1. Entity Extraction | Сырой запрос | Сущности/атрибуты | Сущности (не запрос) | NER / LLM |
2. Entry Point | Сущности/атрибуты |
| Стартовые узлы + запрос | Property Index |
3. Traversal | Стартовые узлы + запрос | Подграф | Подграф + запрос | Graph Query Engine |
4. Ranking / Filtering | Запрос + подграф | Отранжированные узлы | Отранжированные узлы + запрос | Vector Index на узлах / Reranker |
5. Context Assembly | Отранжированные узлы | Текстовый контекст | Контекст + запрос | Context Builder |
6. Generation | Запрос + контекст | Ответ | — | LLM |
Вместо заключения
Давайте ещё раз: это шпаргалка. Я вчера это систематизировал, но ещё не отложилось в голове — открыл и быстро всё вспомнил. Нужно кому‑то быстро показать и рассказать — вот схема, по ней я прямо могу пробежаться по шагам.
Не всем и не всегда нужна очень детальная глубина, иногда нужно просто понимать суть того, о чём говорят, чтобы быть в контексте вопроса.
Спасибо!
Комментарии 0