Привет, Хабр!
Сегодня поговорим о том, что происходит с файловой системой ext4 при внезапном отключении питания. Разберёмся, как Linux записывает данные на диск, зачем нужен журнал, что на самом деле гарантирует fsync() и почему после сбоя одни файлы сохраняются, а другие теряют последние изменения. А в конце попробуем имитировать настоящий сбой (виртуальной машины) и посмотрим, что удастся восстановить.
Разберёмся, где проходит граница между записью и сохранением, что делает журнал JBD2 и почему rename() с fsync() так часто встречаются в коде, работающем с важными файлами. В конце создадим отдельный том ext4, аварийно остановим виртуальную машину, воспроизведём журнал и проверим содержимое файлов после восстановления. Проверка будет опираться на данные.
В статье рассматривается обычная локальная ext4 в Linux с журналом и режимом data=ordered. На результаты влияют параметры монтирования, ядро, накопитель и способ его подключения к виртуальной машине.
0. Вместо предисловия
Предположим, есть некий сервер, и на этом сервере работает некое приложение, которое обновило конфигурационный файл и получило успешный результат записи, а через секунду сервер отключился. После запуска файл оказался пустым или в нём осталась старая версия, при этом проверка ext4 не нашла ошибок, что вполне нормально - исправная файловая система и сохранность последних изменений приложения означают разные вещи. Журнал ext4 нужен прежде всего для восстановления согласованного состояния служебных структур. Он не хранит обязательную резервную копию каждого файла и не обещает сохранить все операции, завершившиеся до аварии.
1. Три разных результата одной аварии
Для начала разделим три требования, которые часто ошибочно считают одним.
Что требуется | Какой механизм участвует | Чего он сам по себе не обещает |
|---|---|---|
Файловая система после сбоя сохраняет согласованные служебные структуры | журнал JBD2, при необходимости | сохранения всех последних записей приложения |
Записанные байты файла переживают сбой | успешный | сохранения нового имени файла в каталоге |
Новое имя или замена файла переживают сбой |
| сохранения содержимого, которое заранее не синхронизировали |
Отсюда следует важное различие: атомарность операции, согласованность файловой системы и долговечность данных относятся к разным гарантиям. Чтобы понять их связь, придётся посмотреть, что именно ext4 записывает на диск.
2. Как ext4 связывает имя файла с его данными
Пусть существует /srv/app/config.json. Это имя не записано внутри самого файла. Каталог хранит запись, связывающую config.json с номером inode, а inode хранит сведения об объекте: размер, права доступа, число жёстких ссылок и адресацию данных.
/srv/app/                   каталог
   │
   └── config.json          запись: имя → номер inode
                                │
                                ▼
                              inode
                                │
                                ▼
                         дерево экстентов
                                │
                                ▼
                         блоки с данными
Экстент описывает последовательный диапазон блоков файла, размещённый в последовательных блоках файловой системы. Например, логические блоки файла 0–999 могут находиться в блоках ext4 8000–8999. Для такого участка достаточно одной записи вместо тысячи отдельных адресов.
Файл:      [логические блоки 0 ................................ 999]
                                  │
                                  ▼
Экстент:   [начало 8000, длина 1000 блоков]
                                  │
                                  ▼
Том ext4:  [блоки 8000 ...................................... 8999]
Номер блока ext4 не обязательно совпадает с номером физического сектора накопителя. Между файловой системой и устройством могут находиться LVM, шифрование, RAID или виртуальный диск.
Сам том разделён на группы блоков. В них учитываются свободные блоки, свободные inode и расположение служебных структур. Битовые карты показывают, какие области заняты. Размер и остальные параметры тома задаёт суперблок, его основная копия начинается со смещения 1024 байта от начала файловой системы.
Почему эти подробности понадобятся при восстановлении? Запись нового файла может изменить сразу несколько объектов: запись каталога, inode, дерево экстентов, битовую карту свободных блоков и счётчики группы, и если питание исчезнет между независимыми записями этих структур, они могут начать противоречить друг другу. Именно такую ситуацию должен учитывать журнал.
Для справкиВ суперблоке находятся размер блока, число блоков и inode, UUID, признаки возможностей формата и сведения о журнале. Описатели групп указывают, где на самом деле лежат их битовые карты и таблицы inode. При flex_bg эти структуры не обязаны находиться внутри своей группы, вычислять их адреса по картинке нельзя.
Посмотреть параметры несмонтированного тома:
dumpe2fs -h /dev/vdb 2>/dev/null | grep -E \
  'Filesystem features:|Block size:|Inode count:|Journal inode:'
В обычном режиме один бит карты блоков соответствует одному блоку, при bigalloc учёт ведётся по более крупным кластерам. Наличие ext4 не означает, что каждый inode обязательно использует экстенты: для старых файлов возможна схема прямых и косвенных указателей. Способ адресации определяется флагами inode.
Фрагментацию конкретного файла можно посмотреть через filefrag -v. Число экстентов само по себе не определяет скорость доступа: важны их размер, устройство и характер нагрузки.
3. Что происходит после write()
При обычной буферизованной записи write() обычно изменяет данные в страничном кэше ядра. Это позволяет приложению продолжить работу до того, как накопитель завершит физическую запись.
приложение: write()
         │
         ▼
страничный кэш: изменённые данные в памяти
         │
         ├── write() уже может вернуть успех
         │
         ▼
обратная запись: передача данных из памяти
         │
         ▼
ext4 выбирает место и обновляет служебные структуры
         │
         ▼
слой блочных устройств → накопитель
Для новых данных ext4 обычно использует отложенное выделение блоков (delalloc). Пока приложение пишет в память, точный диапазон блоков на диске может ещё не быть выбран. Позднее многоблочный распределитель (mballoc) подбирает свободный участок. Если он достаточно велик, файл получится менее фрагментированным. Это объясняет две особенности поведения Linux:
завершившийся
write()не означает, что данные уже переживут отключение питания.часть ошибок записи, в том числе нехватка места или ошибка устройства, может обнаружиться позже, при обратной записи или синхронизации. Поэтому для важных данных недостаточно проверять только возвращаемое значение
write().
Команда close() также не требует обязательного сохранения данных на энергонезависимом носителе. Она закрывает файловый дескриптор.
Для принудительной синхронизации файла служит fsync():
write(fd)
    │
    ▼
данные изменены в памяти
    │
    ▼
fsync(fd)
    │
    ├── дождаться записи данных файла
    ├── сохранить необходимые служебные структуры
    └── довести требуемый порядок и сброс до устройства
    │
    ▼
успешный возврат в приложение
Накопитель может иметь энергозависимый кэш записи и подтвердить обычный запрос до фактического сохранения информации. Linux использует запросы сброса кэша и, при поддержке устройства, записи с принудительной фиксацией (FUA). Гарантии fsync() действуют при условии, что контроллер, виртуальный диск и накопитель выполняют эти запросы корректно. Если устройство лжёт о завершении записи, файловая система не сможет это исправить.
fsync() файла решает вопрос сохранения его данных и необходимых для чтения метаданных. Существование имени в каталоге пока оставим в стороне: к нему вернёмся после разбора журнала.
write() может вернуть меньше байтов, чем запрошено. Для полной записи приложение должно повторять вызов, пока не отправит весь буфер, и обрабатывать ошибки. os.write() в Python даёт доступ к этой модели без дополнительной буферизации файловым объектом Python.
Возвращаемое значение fsync() и fdatasync() проверяют: вызов может завершиться ошибкой. Ошибки обратной записи могут быть сообщены через fsync(), в том числе EIO или ENOSPC. fdatasync() не обязан сохранять метаданные, не нужные для последующего чтения содержимого, например одно лишь изменение времени доступа.
df -h показывает занятость пространства, а df -i показывает наличие свободных inode. Новые файлы могут перестать создаваться при наличии свободных блоков, если исчерпаны inode.
O_DIRECT меняет способ передачи данных и обходит обычный путь через страничный кэш там, где это поддерживается, но сам по себе не заменяет fsync() и не даёт универсальной гарантии долговечности.
4. Для чего нужен журнал JBD2
Вернёмся к созданию файла. ext4 должна выделить inode, отметить блоки занятыми, связать экстенты с данными и добавить имя в каталог. Эти изменения невозможно считать одной физической записью на накопитель.
JBD2 группирует изменения метаданных в журнальные транзакции. В обычном режиме data=ordered пользовательские данные записываются в их основные блоки, а изменённые служебные блоки проходят через журнал. Для связанных с транзакцией данных ext4 обеспечивает необходимый порядок записи до фиксации метаданных.
Упрощённо журнал содержит:
[описатель транзакции № 41]
[копии изменённых блоков метаданных]
[запись о завершении транзакции № 41]

[описатель транзакции № 42]
[копии изменённых блоков метаданных]
[... питание отключилось до записи о завершении ...]
Описатель сообщает, куда относятся журнальные блоки. Запись о завершении (commit block) позволяет отличить законченную транзакцию от незаконченной. После фиксации журналируемые блоки можно переносить в основные области тома.
Теперь возможны два случая.
                  АВАРИЯ
                     │
          ┌──────────┴───────────┐
          ▼                      ▼
 транзакция завершена     транзакция не завершена
          │                      │
          ▼                      ▼
 изменения метаданных     эта транзакция не
 можно повторно           воспроизводится
 применить из журнала
          │                      │
          └──────────┬───────────┘
                     ▼
            согласованное состояние
          служебных структур после
             восстановления
При следующем монтировании ext4 или запуске e2fsck журнал может быть воспроизведён. Незавершённые транзакции не становятся завершёнными задним числом, проверки контрольных сумм и записи отмены помогают избежать применения неподходящих журнальных блоков.
Журнал не возвращает содержимое оперативной памяти. Если приложение успело выполнить write(), но не обеспечило синхронизацию, после сбоя могут оказаться доступны старая версия, новая версия или частично сохранённые изменения. Конкретный результат зависит от того, что уже дошло до накопителя. Режим data=ordered снижает опасность некоторых сочетаний новых метаданных со старыми блоками, однако он не делает каждую запись долговечной. Это также объясняет ситуацию, когда e2fsck сообщает об исправной файловой системе, хотя приложение потеряло данные. Проверка подтвердила согласованность структур, но не соответствие содержимого последней версии, которую видел процесс.
Режим | Что журналируется | Порядок записи пользовательских данных |
|---|---|---|
| метаданные | связанные данные записываются до фиксации соответствующих метаданных |
| метаданные | такого упорядочивания нет |
| метаданные и содержимое файлов | данные сначала проходят через журнал |
Обычно применяется data=ordered. Действующие параметры монтирования показывает findmnt -no FSTYPE,OPTIONS /точка/монтирования.
Журнал JBD2 часто находится во внутреннем inode 8. Он имеет собственный формат, многобайтные числа JBD2 записываются старшим байтом вперёд, в отличие от структур ext4. В записях отмены (revoke) отмечаются блоки, для которых нельзя применять устаревшее журнальное содержимое. Это особенно важно, если освобождённый блок был использован повторно.
В некоторых конфигурациях data=ordered доступна ускоренная фиксация (fast commit): вместо полных копий блоков метаданных журнал получает компактное описание допустимых изменений. При необходимости выполняется обычная транзакция JBD2.
Контрольные суммы метаданных ext4 помогают обнаруживать повреждения служебных структур. Они не заменяют резервные копии пользовательских файлов. На обычной ext4 нет универсального механизма восстановления содержимого произвольного файла по контрольной сумме и второй исправной копии.
5. Почему rename() и unlink() имеют отношение к сбоям
Теперь можно вернуться к каталогам. Имя находится в записи каталога, а данные принадлежат inode. Поэтому изменение имени и изменение содержимого файла имеют разные последствия для синхронизации.
Замена файла без промежуточной пустой версии
Допустим, приложение обновляет config.json в один приём. Простейший вариант:
with open("config.json", "wb") as f:
    f.write(new_data)
При открытии с "wb" прежний файл усекается. Если авария произойдёт до сохранения новой версии, последствия могут быть неприятными: старое содержимое уже изменено, а новое не обязано находиться на диске.
Лучше создать временный файл в том же каталоге, полностью записать и синхронизировать его, а затем заменить имя:
config.json  → inode A → старая версия
.tmp-123     → inode B → новая версия, fsync(B) выполнен
                             │
                             ▼
                     rename(.tmp-123, config.json)
                             │
                             ▼
config.json  → inode B → новая версия
                             │
                             ▼
                       fsync(каталога)
rename() позволяет атомарно заменить имя с точки зрения обращающихся к нему процессов: никто не должен увидеть промежуточное отсутствие config.json только из-за этой замены. Но это только атомарность наблюдения в работающей системе, а не самостоятельная гарантия сохранения нового имени после отключения питания. Поэтому порядок для надёжной замены такой:
Создать временный файл в том же каталоге и записать всю новую версию.
Вызвать
fsync()временного файла и убедиться в отсутствии ошибки.Выполнить
rename()с заменой старого имени.Вызвать
fsync()каталога, в котором произошло переименование.
Если переименование затрагивает разные каталоги одной файловой системы, необходимо учитывать синхронизацию обоих изменённых каталогов. Между разными файловыми системами обычный rename() не переносит объект и возвращает EXDEV.
На Linux этот порядок можно реализовать так:
import os
import tempfile
from pathlib import Path


def replace_file(path: str, data: bytes) -> None:
    target = Path(path)
    directory = target.parent
    fd, temporary = tempfile.mkstemp(prefix=".new-", dir=directory)

    try:
        try:
            offset = 0
            while offset < len(data):
                written = os.write(fd, data[offset:])
                if written <= 0:
                    raise OSError("Запись не продвигается")
                offset += written
            os.fsync(fd)
        finally:
            os.close(fd)

        os.replace(temporary, target)
        directory_fd = os.open(directory, os.O_RDONLY | os.O_DIRECTORY)
        try:
            os.fsync(directory_fd)
        finally:
            os.close(directory_fd)
    finally:
        if os.path.exists(temporary):
            os.unlink(temporary)
Пример показывает именно порядок синхронизации, он не переносит права, владельца, расширенные атрибуты и списки доступа исходного файла. Для конфигураций это может быть существенно, нужные свойства надо установить на временном файле до замены.
Что происходит при unlink()
Удаление файла начинается с имени. unlink() убирает запись из каталога и уменьшает число жёстких ссылок на inode. Если у файла есть другие имена, он остаётся доступным через них. Но даже после удаления последнего имени процесс может продолжать читать и записывать данные через открытый дескриптор. Поэтому иногда возникает знакомая администраторам ситуация: лог удалён, а место на диске так и не освободилось. Найти такие файлы помогает lsof +L1.
При аварийном отключении открытые дескрипторы исчезают вместе с процессами. На диске могут остаться inode без жёстких ссылок, блоки которых ещё не освобождены. ext4 ведёт учёт таких объектов и при восстановлении завершает их очистку. Этот механизм используется и при некоторых прерванных операциях изменения размера файла.
Дело в том, что удаление, переименование и запись файла затрагивают несколько структур файловой системы. Изменения каталогов, inode и сведений о занятых блоках не происходят одновременно. Если работу прервёт сбой, часть метаданных может остаться в промежуточном состоянии. Журнал позволяет восстановить их согласованность, но не возвращает удалённые файлы и не гарантирует сохранность последних изменений содержимого.
Поэтому атомарность rename() сама по себе не обеспечивает сохранность новой версии файла после аварии. Для надёжной замены нужно записать и синхронизировать новое содержимое, выполнить переименование, а затем синхронизировать каталог.
Жёсткая ссылка представляет собой ещё одну запись каталога на тот же inode. У такого файла нет «главного» имени. Число ссылок показывает stat имя_файла в поле Links.
auto_da_alloc в ext4 распознаёт некоторые распространённые схемы замены через rename() и усечение файла. В режиме data=ordered это помогает упорядочить выделение блоков и запись данных перед фиксацией соответствующих метаданных. Механизм снижает риск для приложений, забывших о синхронизации, но не заменяет явный fsync().
Без возможности orphan_file осиротевшие inode учитываются через связный список с началом в суперблоке. Современные тома могут использовать специальный файл orphan_file. Оба варианта нужны, чтобы завершить очистку после аварии.
6. Практика: останавливаем машину, восстанавливаем журнал, проверяем файлы
Теперь проверим утверждения на отдельном томе. Нужны Linux-хост с e2fsprogs, Python 3 и тестовая виртуальная машина Linux. Используем второй виртуальный диск, который не содержит системы.
Тест намеренно проверяет три случая:
safe.bin: новая версия записана,fsync()файла завершился успешно;config.txt: новая версия записана во временный файл, затем выполненыfsync(),rename()иfsync()каталога;unsafe.bin: новая версия записана обычнымиwrite(), но безfsync().
Имена всех трёх файлов мы заранее сохраним.
6.1. Подготовка диска на хосте
Создаём новый каталог и образ размером 1 ГиБ:
mkdir -p "$HOME/ext4-crash-lab"
cd "$HOME/ext4-crash-lab"
truncate -s 1G ext4-crash.img
mkfs.ext4 -F -b 4096 ext4-crash.img
-Fразрешает форматирование обычного файла-образа. Нельзя подставлять сюда путь к существующему диску или разделу.
Подключаем ext4-crash.img к выключенной тестовой виртуальной машине как дополнительный диск. Например, для QEMU параметры этого диска выглядят так:
-drive file=ext4-crash.img,format=raw,if=virtio,cache=none
Важно, чтобы формат подключаемого диска (образа) был именно raw!
cache=none позволяет обойти обычный страничный кэш хоста для дискового ввода-вывода QEMU.
После запуска гостевой Linux убедитесь, что дополнительный диск действительно определяется как /dev/vdb:
lsblk -o NAME,SIZE,FSTYPE,MOUNTPOINTS
В дальнейшем
/dev/vdbиспользуется просто как пример, если устройство у вас называется иначе, нужно заменить путь после проверки.
Монтируем подготовленный том:
sudo mkdir -p /mnt/ext4-crash
sudo mount -t ext4 -o data=ordered /dev/vdb /mnt/ext4-crash
findmnt -no SOURCE,FSTYPE,OPTIONS /mnt/ext4-crash
6.2. Данные до “аварии”
В гостевой системе сохраняем скрипт как /tmp/ext4-crash-probe.py:
import os
import sys
import tempfile
from pathlib import Path

ROOT = Path("/mnt/ext4-crash")
SIZE = 4 * 1024 * 1024


def write_all(fd: int, data: bytes) -> None:
    pos = 0
    while pos < len(data):
        n = os.write(fd, data[pos:])
        if n <= 0:
            raise OSError("Запись не продвигается")
        pos += n


def write_file(name: str, data: bytes, sync: bool) -> None:
    fd = os.open(ROOT / name, os.O_WRONLY | os.O_CREAT | os.O_TRUNC, 0o644)
    try:
        write_all(fd, data)
        if sync:
            os.fsync(fd)
    finally:
        os.close(fd)


def sync_directory() -> None:
    fd = os.open(ROOT, os.O_RDONLY | os.O_DIRECTORY)
    try:
        os.fsync(fd)
    finally:
        os.close(fd)


def prepare() -> None:
    write_file("safe.bin", b"O" * SIZE, True)
    write_file("unsafe.bin", b"O" * SIZE, True)
    write_file("config.txt", b"version=1\n", True)
    sync_directory()
    print("ПОДГОТОВКА: файлы и их имена синхронизированы", flush=True)


def change() -> None:
    # Сначала синхронизируем новую версию обычного файла.
    write_file("safe.bin", b"S" * SIZE, True)

    # Затем сохраняем новое содержимое и заменяем имя в каталоге.
    fd, temporary = tempfile.mkstemp(prefix=".config-", dir=ROOT)
    try:
        try:
            write_all(fd, b"version=2\n")
            os.fsync(fd)
        finally:
            os.close(fd)
        os.replace(temporary, ROOT / "config.txt")
        sync_directory()
    finally:
        if os.path.exists(temporary):
            os.unlink(temporary)

    # Последней изменяем копию без синхронизации.
    write_file("unsafe.bin", b"U" * SIZE, False)
    print("ГОТОВО: unsafe.bin закрыт без fsync", flush=True)


if __name__ == "__main__":
    if len(sys.argv) != 2 or sys.argv[1] not in ("prepare", "change"):
        raise SystemExit("Usage: probe.py prepare|change")
    {"prepare": prepare, "change": change}[sys.argv[1]]()
Выполняем один раз подготовку:
sudo python3 /tmp/ext4-crash-probe.py prepare
При успешном выполнении видим:
ПОДГОТОВКА: файлы и их имена синхронизированы
На этом этапе оба двоичных файла содержат по 4 МиБ байтов O, а config.txt содержит version=1. Вызовы fsync() зафиксировали исходное содержимое и имена файлов.
Выполняем изменение:
sudo python3 /tmp/ext4-crash-probe.py change
Скрипт должен завершиться строкой:
ГОТОВО: unsafe.bin закрыт без fsync
Это означает, что новая версия safe.bin синхронизирована, новая версия config.txt сохранена вместе с записью каталога, а запись unsafe.bin завершилась без требования сохранить данные. Теперь важно как можно быстрее прервать работу всей гостевой системы!
6.3. Аварийная остановка
На хосте, сразу после строки ГОТОВО, принудительно завершаем процесс тестовой виртуальной машины. Для отдельного процесса QEMU:
kill -9 PID_ИМЕННО_ТЕСТОВОГО_QEMU
Не выполняем в гостевой системе sync, umount, shutdown или обычную перезагрузку: они изменили бы проверяемую ситуацию. В графическом диспетчере виртуальных машин, если у вас такой имеется, нужна именно операция принудительного выключения (Stop), а не штатное завершение работы гостя (Shutdown).
SIGKILL пользовательского процесса внутри гостя тоже не подходит, после такого сигнала ядро Linux продолжает работать и может спокойно записать кэш и журнал.
Останавливая QEMU, мы моделируем потерю работающего гостевого ядра и его оперативной памяти. При этом питание физического хоста не отключается, а уже выполненные им записи остаются.
Такой опыт показывает механизм восстановления ext4, но не проверяет, насколько честно конкретный SSD или контроллер выполняет сброс кэша при реальном отключении питания, имейте это в виду.
6.4. Что сохранилось на образе до восстановления
Пока виртуальная машина выключена и образ нигде не смонтирован, возвращаемся на хост:
cd "$HOME/ext4-crash-lab"
dumpe2fs -h ext4-crash.img 2>/dev/null | \
    grep -E 'Filesystem state:|Filesystem features:'
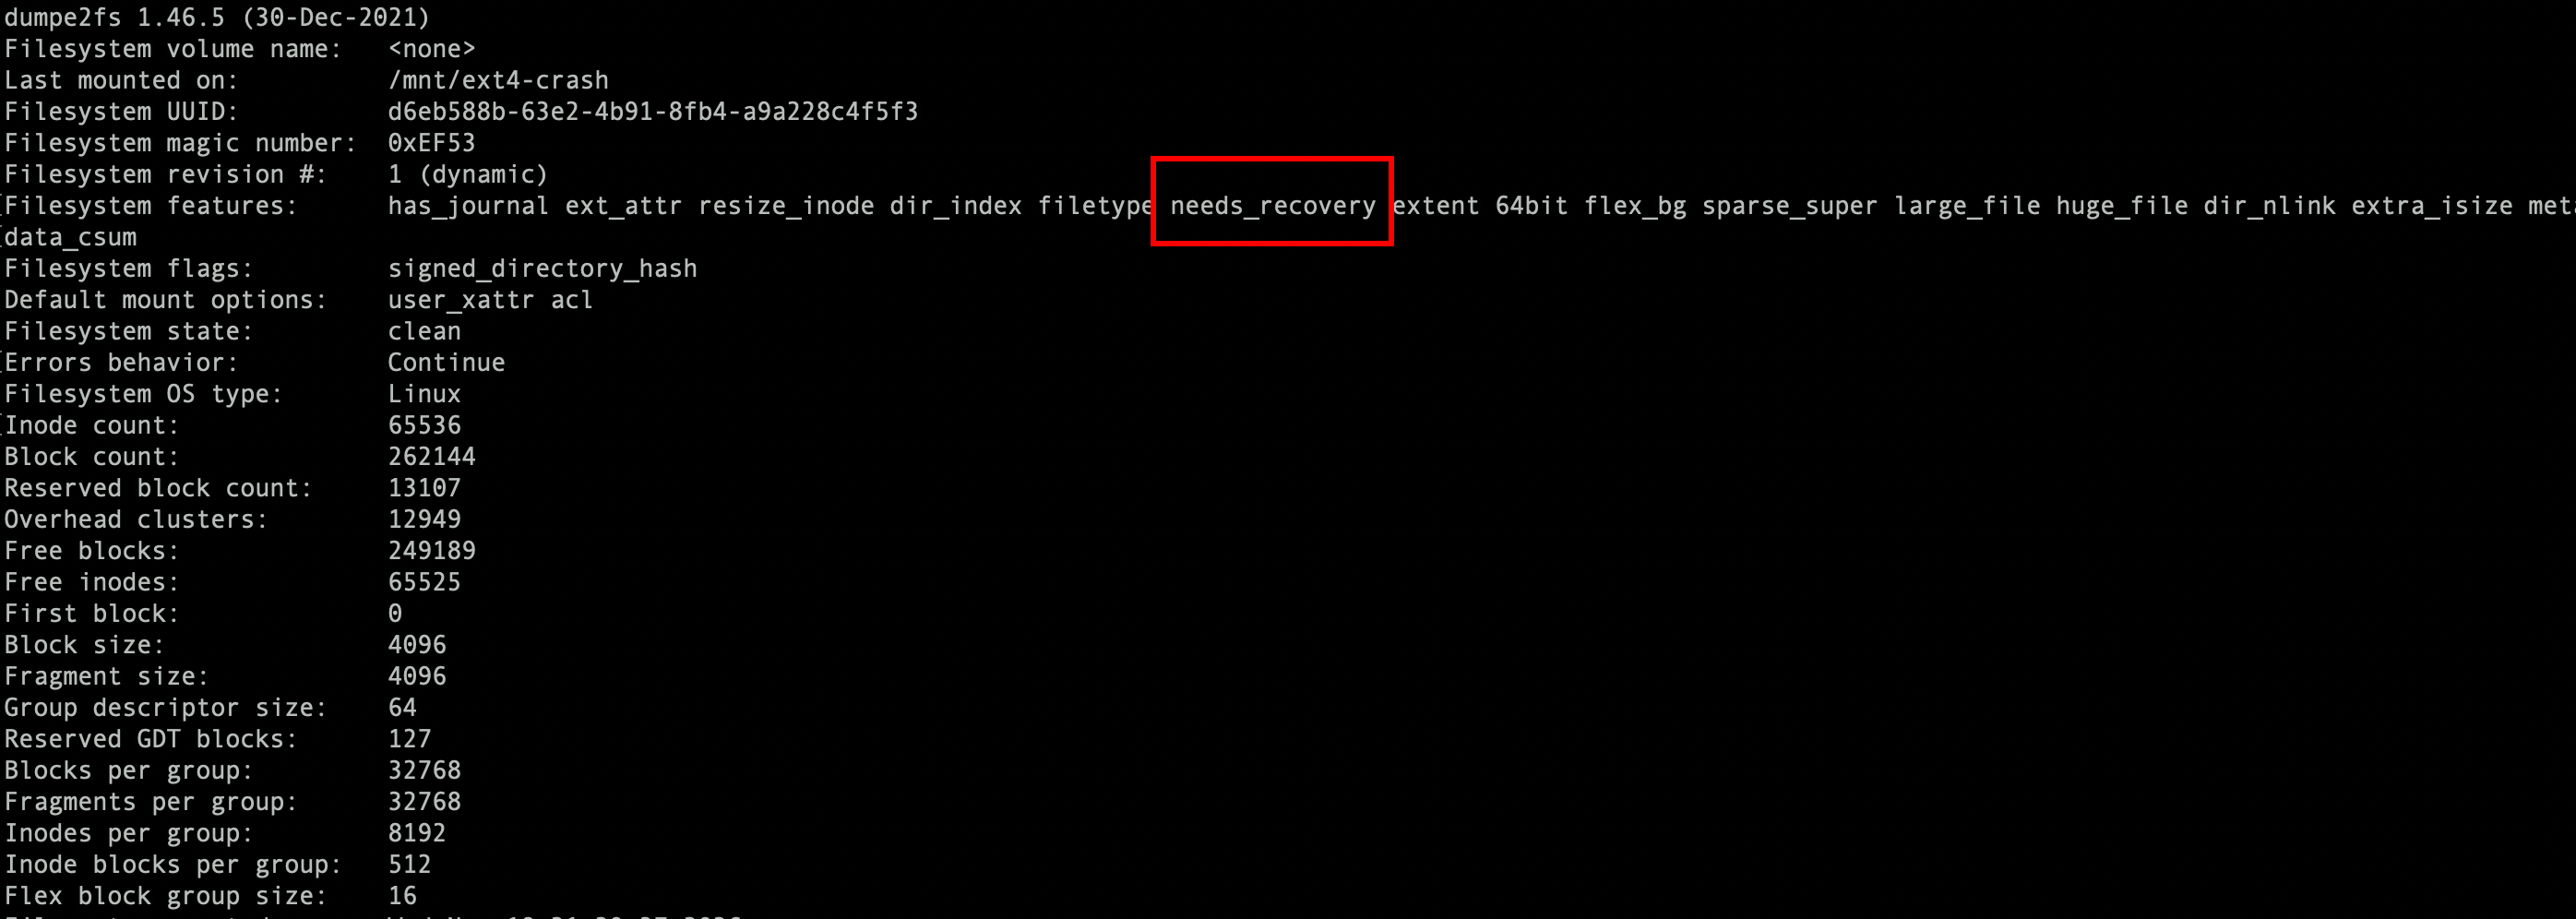
После аварии у смонтированной на запись ext4 обычно виден признак needs_recovery.
...
Filesystem features:      has_journal ext_attr resize_inode dir_index filetype needs_recovery extent 64bit flex_bg sparse_super large_file huge_file dir_nlink extra_isize metadata_csum
Filesystem state:         clean
...
Он сообщает, что предыдущий сеанс работы с журналом не завершился штатным отключением.
Не монтируйте образ до следующего шага. Даже монтирование ext4 с параметром
roспособно воспроизвести журнал и изменить образ. Для исследования исходного аварийного состояния работайте только с выключенной ВМ и, при необходимости, сохраните копию образа.
6.5. Воспроизведение журнала
На хосте выполняем:
e2fsck -E journal_only ext4-crash.img
Ключ journal_only требует обработать журнал, если это необходимо, без дальнейшей полной проверки. При наличии требующего воспроизведения журнала в выводе обычно появляется сообщение вида:
recovering journal
Утилита может вывести и другие строки, ненулевой код завершения необходимо разбирать по сообщениям и битовой маске кодов
e2fsck.
Повторяем проверку суперблока:
dumpe2fs -h ext4-crash.img 2>/dev/null | \
    grep -E 'Filesystem state:|Filesystem features:'
После успешного завершения восстановления признак needs_recovery должен исчезнуть.
Filesystem features:      has_journal ext_attr resize_inode dir_index filetype extent 64bit flex_bg sparse_super large_file huge_file dir_nlink extra_isize metadata_csum
Filesystem state:         clean
Если он остался или e2fsck сообщил об ошибке, к проверке содержимого переходить рано: сначала нужно разобраться с восстановлением.
Полную проверку с исправлениями пока не запускаем. Сначала извлечём файлы из состояния, которое получилось после воспроизведения одного только журнала, так можно отличить его результат от последующих исправлений e2fsck.
6.6. Проверка результата по содержимому файлов
Сообщение recovering journal подтверждает работу механизма журнала, но ещё не отвечает, какие байты читает приложение. Извлечём файлы из восстановленного образа, не запуская гостевую систему:
mkdir -p extracted
debugfs -R 'dump /safe.bin extracted/safe.bin' ext4-crash.img
debugfs -R 'dump /unsafe.bin extracted/unsafe.bin' ext4-crash.img
debugfs -R 'dump /config.txt extracted/config.txt' ext4-crash.img
Затем проверяем результат автоматически:
python3 - <<'PY'
from pathlib import Path

root = Path("extracted")
size = 4 * 1024 * 1024

safe = (root / "safe.bin").read_bytes()
config = (root / "config.txt").read_bytes()

safe_ok = safe == b"S" * size
config_ok = config == b"version=2\n"

print("safe.bin:  ", "PASS" if safe_ok else "FAIL")
print("config.txt:", "PASS" if config_ok else "FAIL")

unsafe_file = root / "unsafe.bin"
if not unsafe_file.exists():
    result = "MISSING"
else:
    unsafe = unsafe_file.read_bytes()
    if unsafe == b"O" * size:
        result = "OLD"
    elif unsafe == b"U" * size:
        result = "NEW"
    else:
        result = f"OTHER (size={len(unsafe)}, old/new or partial data)"
print("unsafe.bin:", result)

if not safe_ok or not config_ok:
    raise SystemExit("FAIL: an explicitly synchronized state was not recovered")
PY
Как читать результат:
Проверка | Ожидаемый вывод | Что доказано |
|---|---|---|
|
| после восстановления сохранились байты, подтверждённые |
|
| новая версия и имя сохранились после синхронизации файла и каталога |
|
| зафиксирован фактический результат записи, для которой долговечность не требовали |
Здесь PASS означает именно совпадение всех байтов с ожидаемыми, скрипт завершится с ошибкой, если хотя бы один из двух синхронизированных объектов не прошёл проверку. Третий файл, если всё сделано правильно, должен быть с результатом OLD:
safe.bin:   PASS
config.txt: PASS
unsafe.bin: OLD
Если у вас результат проверки третьего файла показан как NEW/OTHER, write() мог успеть попасть на устройство, несмотря на отсутствие fsync(). Возможно, вы слишком поздно выполнили принудительное завершение виртуальной машины.
Чтобы исследовать поведение несинхронизированных записей, опыт необходимо повторять на заново подготовленном образе и менять момент аварийной остановки. Один удачный запуск не доказывает, что приложение без fsync() безопасно переживает отключение питания.
После извлечения файлов можно выполнить полную проверку без изменения образа:
e2fsck -fn ext4-crash.img
Если обнаружены ошибки, для их исправления потребуется отдельный запуск e2fsck -f на несмонтированном образе. Сначала сохраните протокол проверки, так как исправления могут изменить состояние файлов и каталогов. Результат такой процедуры следует разбирать отдельно от восстановления журнала.
e2fsck -E journal_only обрабатывает требующий восстановления журнал, но не обязан проводить полный поиск повреждений, e2fsck -f дополнительно проверяет структуры файловой системы. Успешное окончание обоих этапов не доказывает, что каждое приложение сохранило свои последние изменения.
debugfs позволяет читать inode, каталоги и данные непосредственно из несмонтированного образа. Команда stat /имя показывает inode, blocks /имя выводит блоки файла, а dump /имя файл-на-хосте извлекает содержимое. Использование debugfs -w в этом опыте не требуется, так как запись в образ низкоуровневой утилитой изменяла бы исследуемое состояние.
При повторении опыта на другом устройстве могут измениться режим журналирования, время фоновой записи, состояние накопителя и версии ядра или e2fsprogs. Если один из ожидаемо долговечных объектов не прошёл проверку, сначала смотрят коды ошибок записи и fsync(), параметры QEMU и состояние нижележащего хранилища, а не объявляют нарушение гарантий ext4 по одному симптому.
7. Что проверять после настоящего сбоя сервера
После аварии полезно разделить задачу на проверку файловой системы и проверку данных приложения.
Симптом | Что проверить |
|---|---|
Том потребовал восстановления после аварии | сообщения ядра, |
| были ли успешные |
Конфигурация после сбоя пустая или старая | использовалось ли усечение исходного файла или замена через временный файл; был ли |
Файл удалён, но место не освобождается | открытые удалённые файлы ( |
После восстановления повреждены сами байты данных | сообщения об ошибках ввода-вывода, состояние накопителя, контрольные суммы на уровне приложения, резервные копии |
На рабочем сервере e2fsck с исправлениями нельзя запускать поверх смонтированной на запись файловой системы, при признаках аппаратных ошибок сначала нужно сохранить исходные данные или образ тома, а уже затем принимать решение о восстановлении. Повторные попытки исправления на неисправном накопителе могут ухудшить ситуацию.
P.S.
Эксперимент завершился успешно (у меня точно, надеюсь и у вас тоже). После принудительной остановки виртуальной машины мы восстановили журнал ext4 и проверили содержимое трёх файлов. Результаты, если всё было сделано правильно, получились такими:
safe.bin:   PASS
config.txt: PASS
unsafe.bin: OLD
safe.bin сохранил записанные данные благодаря вызову fsync(). С config.txt тоже всё в порядке, новая версия пережила аварию, так как при его обновлении мы сначала записали содержимое во временный файл, синхронизировали его, затем выполнили rename() и закрепили изменение имени через fsync() каталога.
А вот с unsafe.bin ситуация печальная, так как перед остановкой мы изменили его содержимое, но не вызвали fsync(), и после восстановления обнаружили старую версию файла. Последние изменения до диска не добрались.
При этом сама ext4 осталась в согласованном состоянии, журнал JBD2 позволил восстановить метаданные, но сохранить незавершённые записи пользовательских данных он не смог, и не обещал. Впрочем, при повторении эксперимента unsafe.bin вполне мог бы сохранить новую версию: без fsync() результат зависит от того, успела ли система записать изменения до аварии.
Для системного администратора / системного инженера / DevOps здесь есть существенный момент. Успешное восстановление файловой системы и отсутствие ошибок при её проверке ещё не означают, что все последние изменения файлов сохранились. Для программиста вывод касается непосредственно работы с файлами: успешный write() не гарантирует сохранность данных после отключения питания. Если запись критична, её необходимо синхронизировать. А когда приложение заменяет файл через rename(), нужно позаботиться и о сохранности изменения каталога.
Меня, признаться, удивило, насколько часто даже опытные разработчики, системные администраторы и DevOps-инженеры путают успешную запись файла с гарантией его сохранности. О журналировании слышали и знают, наверное, все. Но вот что именно восстанавливает журнал, зачем нужен fsync() и почему rename() сам по себе не спасает от потери данных, знают далеко не все. Надеюсь, эта статья и проведённый эксперимент помогли разобраться в этих тонкостях.
Комментарии 0