В этой статье я расскажу о разных способах ускорить точечные запросы в DataFusion. Материал основан на моём докладе (презентация, запись), с которым я выступил на встрече сообщества DataFusion в Бостоне в сентябре 2026 года.
DataFusion обычно воспринимают как движок для аналитических нагрузок, то есть запросов, которые обрабатывают большие объёмы данных. Однако некоторым пользователям регулярно приходится искать отдельные строки в больших файлах по произвольному ключу. На встрече сообщества DataFusion в Бостоне я пообщался с несколькими участниками, которые поделились своим опытом работы с такими нагрузками. Оказалось, что они столкнулись с теми же проблемами, о которых я рассказывал в докладе.
В этой статье я поделюсь практическими рекомендациями по поиску данных по произвольному ключу, или точечному чтению, основанными на моём опыте работы с такими нагрузками в DataFusion. В отличие от аналитических нагрузок, здесь обычно приходится выполнять гораздо больше отдельных запросов. Поэтому главная задача – максимально сократить время выполнения каждого запроса (до менее чем 1 мс), чтобы добиться приемлемой пропускной способности.
В первой части разберём оптимизации на уровне хранения данных (в нашем случае файлов Parquet), а во второй – способы ускорить выполнение запросов в DataFusion.
Методология
Для тестов будем использовать набор данных из одного файла Parquet со 100 млн строк (если не указано иное). В нём два столбца: ключ (bigint, уникальный для каждой строки) и значение (varchar, MD5-хеш ключа). Данные сгенерированы следующим SQL-запросом:
select i as k, md5(i::varchar) as v
from generate_series(1, {rows}) t(i)
Если не указано иное, в каждом тесте запрос извлекает из таблицы одну строку по случайно выбранному ключу (то есть select v from t where k = {}). Большинство тестов выполняется на виртуальной машине Google Cloud c4d-standard-4 (4 виртуальных процессора, 15 ГБ оперативной памяти). Для хранения данных используется диск HyperDisk объёмом 100 ГБ (6000 IOPS, 500 МБ/с). В тестах числа партиций выполнения и среды выполнения используется машина с большим числом процессорных ядер (c4d-highcpu-8). Каждый следующий тест опирается на результаты предыдущего.
Хранение данных (оптимизация настроек Parquet)
Сортировка данных в файле
Если файл Parquet отсортирован по ключу, для поиска по произвольному ключу достаточно прочитать минимальный объём данных. Разумеется, при условии, что отбор тоже выполняется по этому ключу. Чтобы проверить это, в первом тесте измерим пропускную способность при чтении по произвольному ключу из отсортированного (True) и неотсортированного (False) файлов.
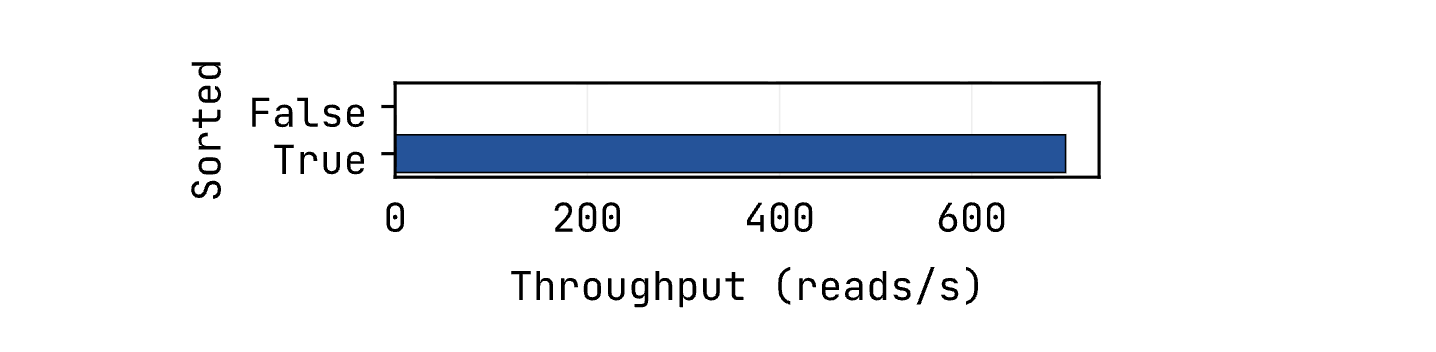
True) и неотсортированного (False) файлов.
Пропускная способность отсортированного файла оказалась в 6000 раз выше, чем неотсортированного (результат последнего даже не виден на графике). Планы выполнения запросов показывают, что при работе с неотсортированным файлом приходится обращаться в среднем к 67 группам строк и 122 страницам, тогда как для отсортированного достаточно прочитать всего одну страницу в одной группе.
Если вы не знакомы с устройством Parquet, поясню: файлы этого формата разбиты на группы строк (row groups), а данные каждого столбца внутри группы разделены на страницы (pages). Подробнее об этом можно прочитать в официальной документации Parquet. DataFusion использует статистику минимальных и максимальных значений для каждой группы и страницы, чтобы определить, нужно ли их читать. Если файл не отсортирован, диапазоны между минимальными и максимальными значениями получаются слишком широкими. Из-за этого приходится читать больше групп и страниц, как показано на схеме ниже.
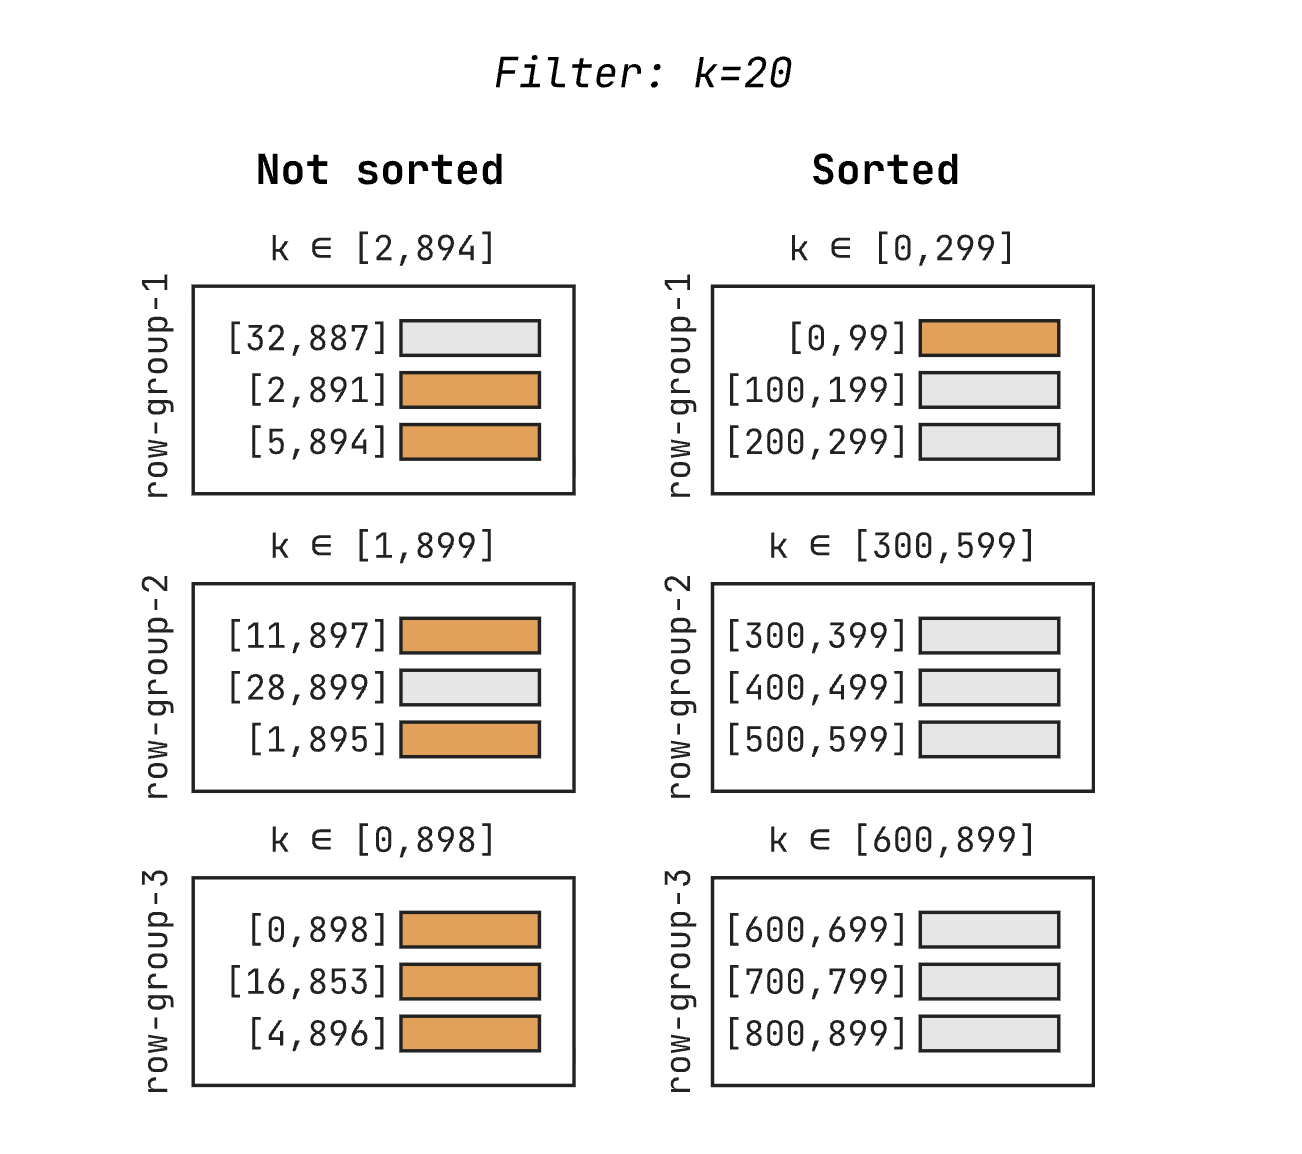
k=20.
Дополнительные метаданные
По умолчанию DataFusion записывает файлы Parquet с включённым словарным кодированием (dictionary encoding). При словарном кодировании значения столбца заменяются целочисленными кодами, что позволяет уменьшить объём занимаемого места. Особенно хорошо этот подход работает со столбцами, в которых много повторяющихся значений. На рисунке ниже показан простой пример его работы.
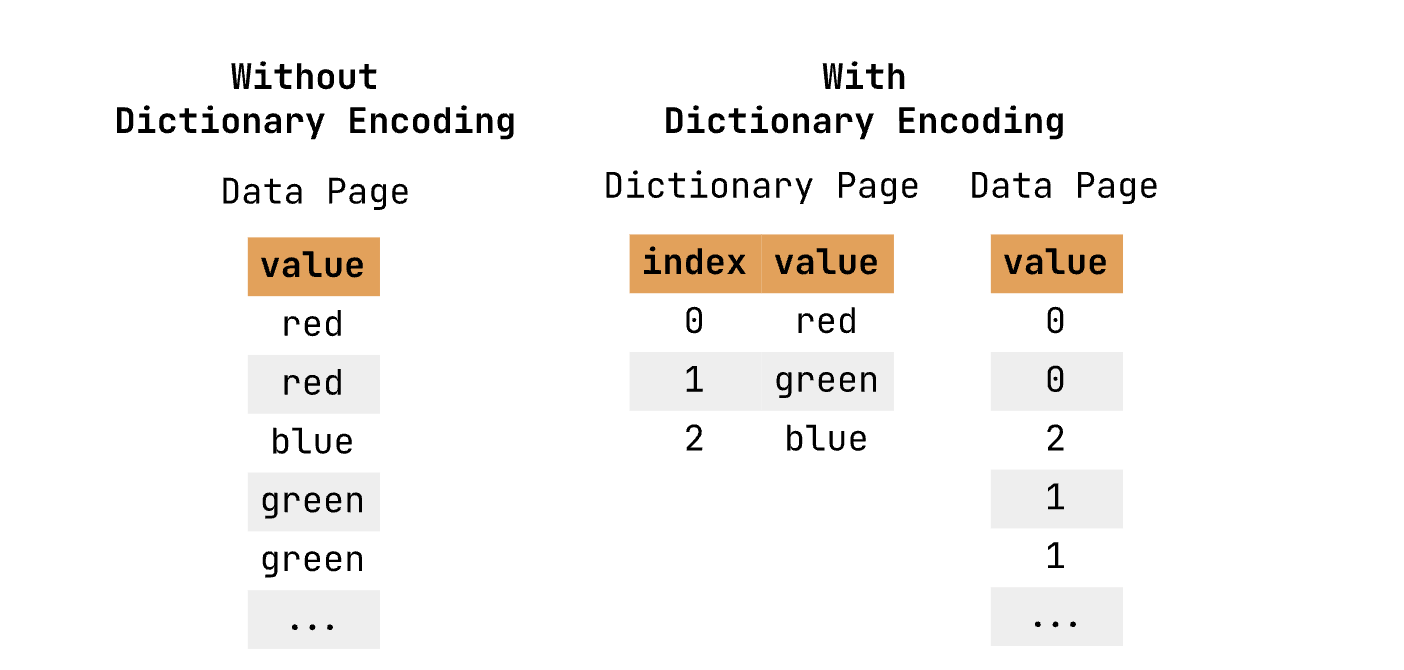
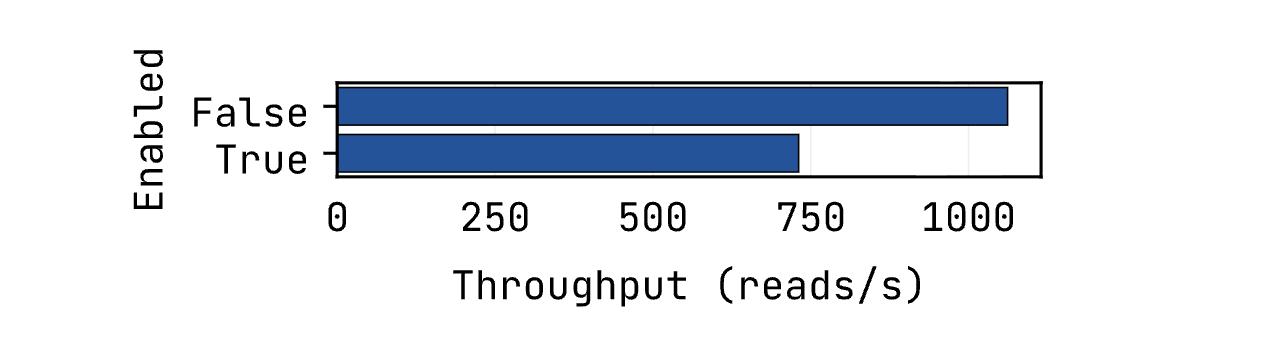
Однако если столбец содержит много уникальных значений (как в нашем наборе данных), словарь только добавляет накладные расходы. В следующем тесте сравним пропускную способность с включённым (True, по умолчанию) и отключённым (False) словарным кодированием. Как видно из результатов, отключение даёт более высокую пропускную способность.
Ещё один вид необязательных метаданных, который часто используется в файлах Parquet, – фильтры Блума. Как и статистика минимальных и максимальных значений, они помогают ускорить выполнение запросов с условиями отбора. В Parquet фильтр Блума представляет собой массив битов, который позволяет определить, что определённого значения точно нет в конкретной группе строк или что оно возможно присутствует. На рисунке 6 показан простой пример фильтра Блума и двух разных условий отбора.
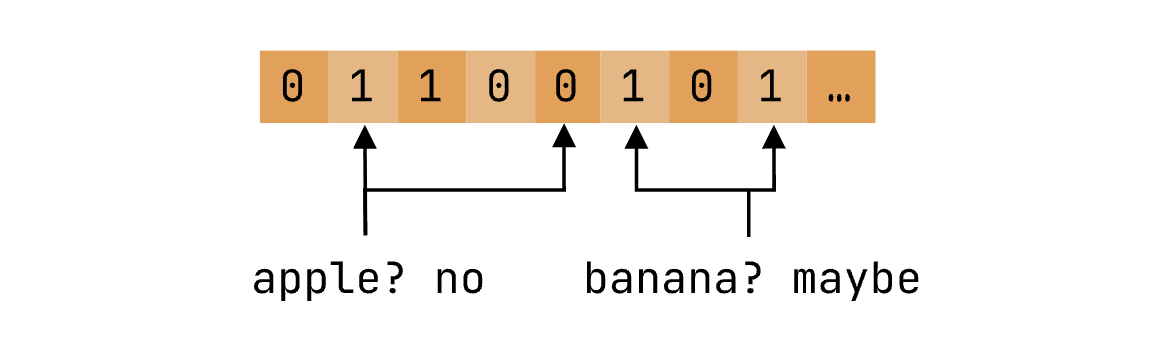
apple точно отсутствует, поскольку один из соответствующих ему битов равен 0. Значение banana может присутствовать, поскольку все соответствующие ему биты равны 1.
В нашем случае столбец, по которому выполняется отбор, содержит только уникальные значения и уже отсортирован. Поэтому статистики минимальных и максимальных значений вполне достаточно, а добавлять фильтры Блума нет смысла. По умолчанию DataFusion и так не создаёт их при записи файлов Parquet. На графике ниже сравнивается пропускная способность точечного чтения из файлов с фильтрами Блума (True) и без них (False, по умолчанию).
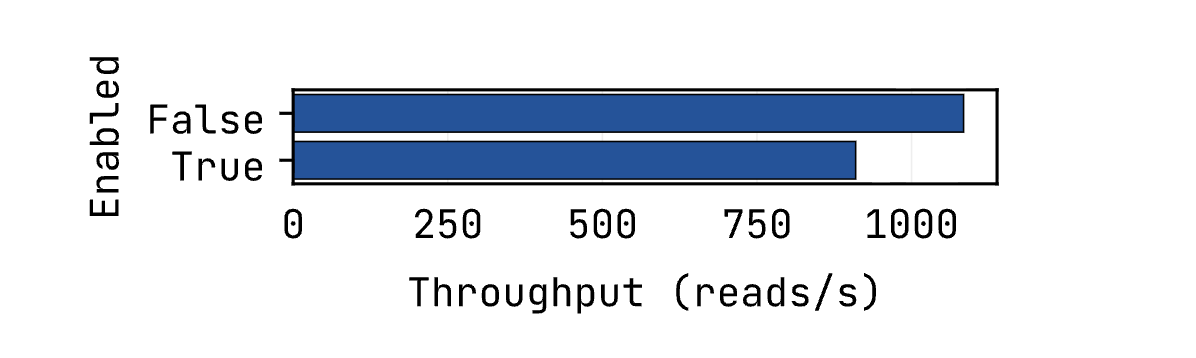
Таким образом, по крайней мере для отсортированных файлов с большим количеством уникальных значений, при записи Parquet лучше отключить и словарное кодирование, и фильтры Блума. Сделать это можно через секцию OPTIONS SQL-команды COPY или изменив параметры TableParquetOptions при вызове DataFrame::write_parquet:
COPY (...) to 't.parquet'
OPTIONS (
    DICTIONARY_ENABLED false,
    BLOOM_FILTER_ON_WRITE false
)
let mut parquet_options = ParquetOptions::default();
parquet_options.dictionary_enabled = false;
parquet_options.bloom_filter_on_write = false;
let mut table_options = TableParquetOptions::new();
table_options.global = parquet_options;
df.write_parquet(
"t.parquet",
DataFrameWriteOptions::new(),
Some(table_options)
).await?;Настройка структуры файла
Теперь разберёмся, какие размеры групп строк и страниц данных лучше подходят для точечного чтения. Для этого проведём простой перебор комбинаций параметров (grid search). Тепловая карта на рисунке 8 показывает пропускную способность при разных сочетаниях размеров.
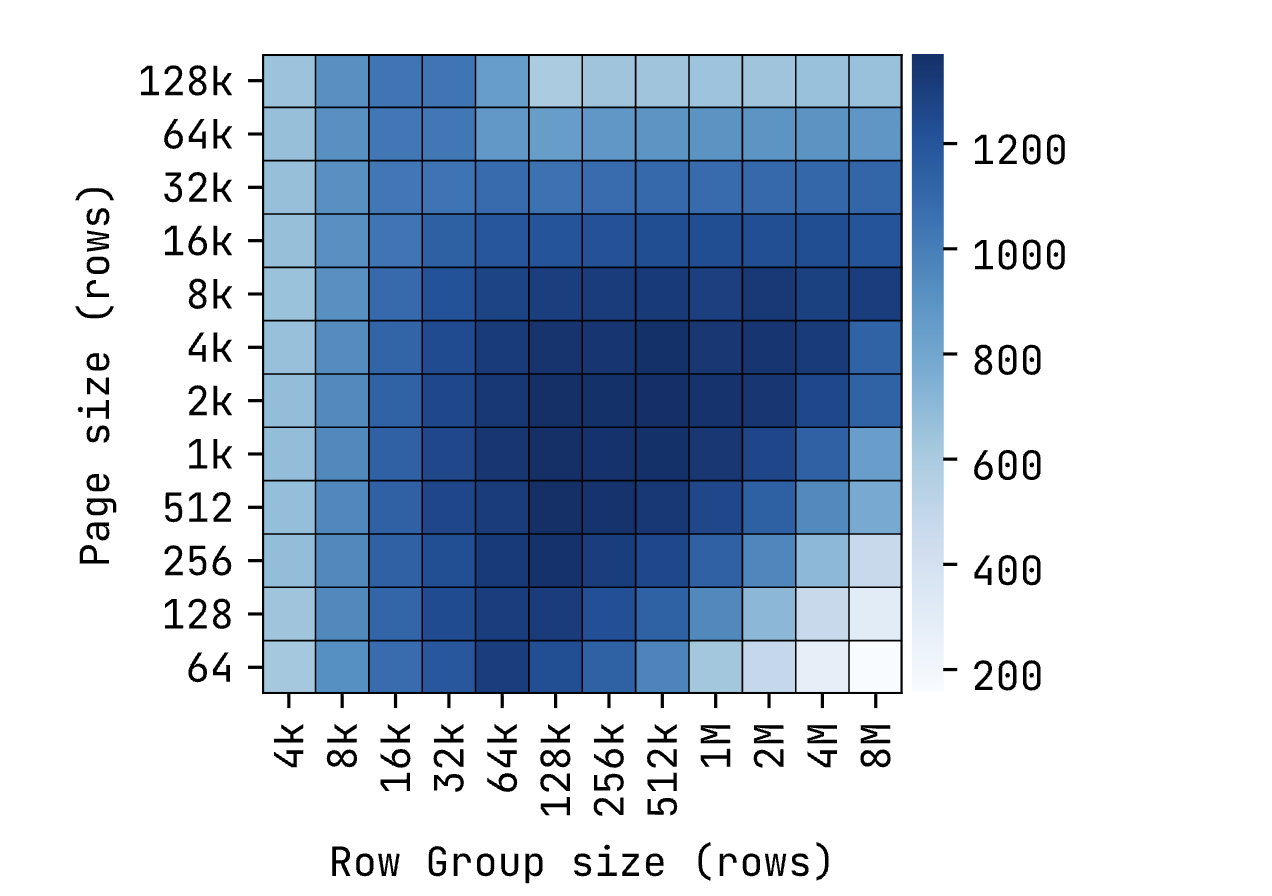
Судя по результатам, для точечного чтения лучше всего подходят настройки около 128 тыс. строк на группу и 1 тыс. строк на страницу. Это заметно меньше значений по умолчанию в DataFusion: 1 млн строк на группу и 20 тыс. строк на страницу.
Если группы или страницы слишком маленькие, их становится очень много, а значит, больше времени уходит на отсечение ненужных данных. С другой стороны, при слишком больших группах или страницах удаётся отсечь меньше данных, поэтому приходится сканировать больше строк.
Но что, если одни и те же файлы Parquet нужны и для точечного чтения, и для аналитических нагрузок? Можно ли подобрать настройки, которые обеспечат хорошую производительность в обоих случаях? Чтобы выяснить это, проведём ещё один перебор параметров. На этот раз зафиксируем размер группы на уровне 512 тыс. строк и будем менять количество строк, считываемых за один запрос (ось X), и размер страницы данных (ось Y). Результаты показаны на рисунке 9.
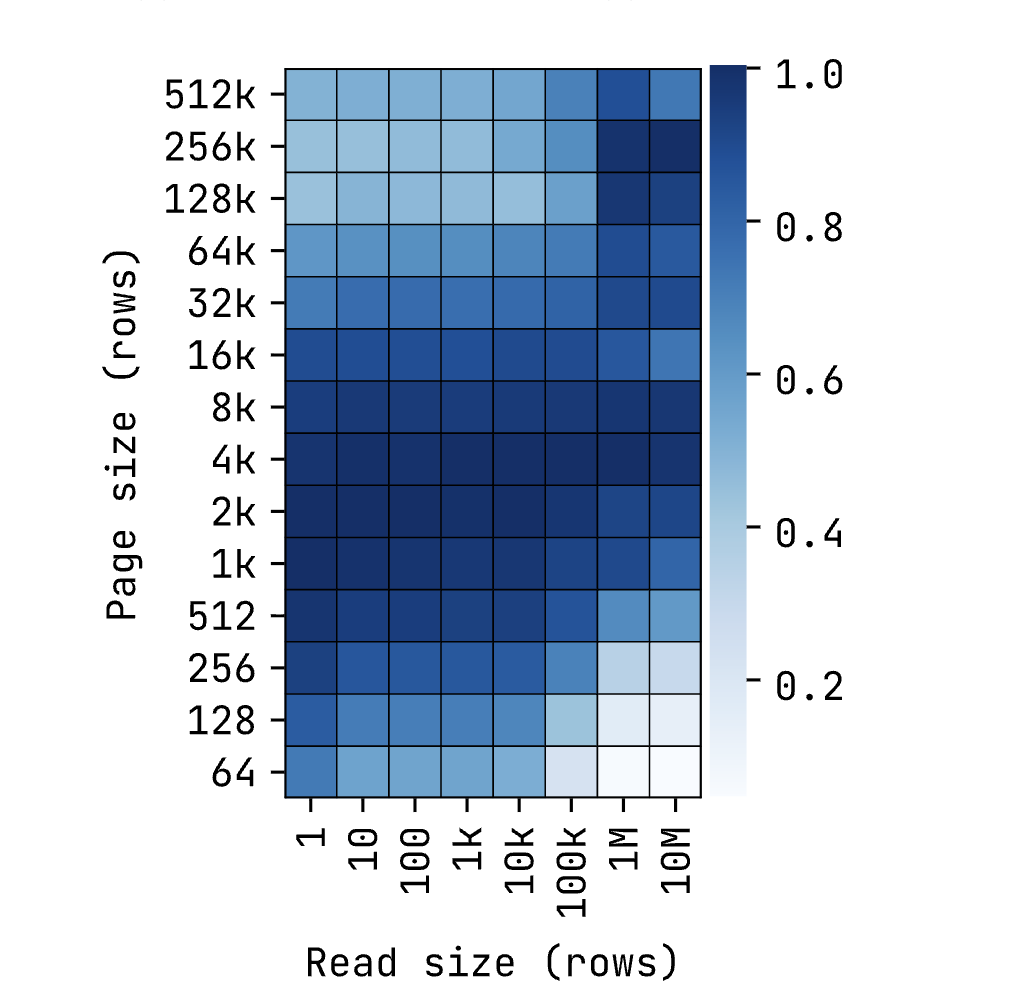
Как видим, для чтения больших объёмов данных лучше подходят крупные страницы, а для небольших запросов – более мелкие. Однако при размере страницы около 2–4 тыс. строк можно добиться хорошей пропускной способности для обоих типов нагрузки. То есть необязательно жертвовать производительностью одного сценария ради другого.
Эти параметры также можно задать через секцию OPTIONS SQL-команды COPY или изменить TableParquetOptions при вызове DataFrame::write_parquet:
COPY (...) to 't.parquet'
OPTIONS (
    MAX_ROW_GROUP_SIZE 131072,
    DATA_PAGE_ROW_COUNT_LIMIT 2048
)
Сжатие
Наконец, посмотрим, как сжатие влияет на производительность. Оптимальные настройки здесь зависят и от набора данных, и от требований пользователя: что важнее, скорость декодирования или экономия места. Поэтому выводы этого раздела могут быть применимы не во всех случаях. На рисунке 10 показана пропускная способность в зависимости от объёма чтения и алгоритма сжатия, а на рисунке 11 – размер файла при использовании каждого алгоритма.
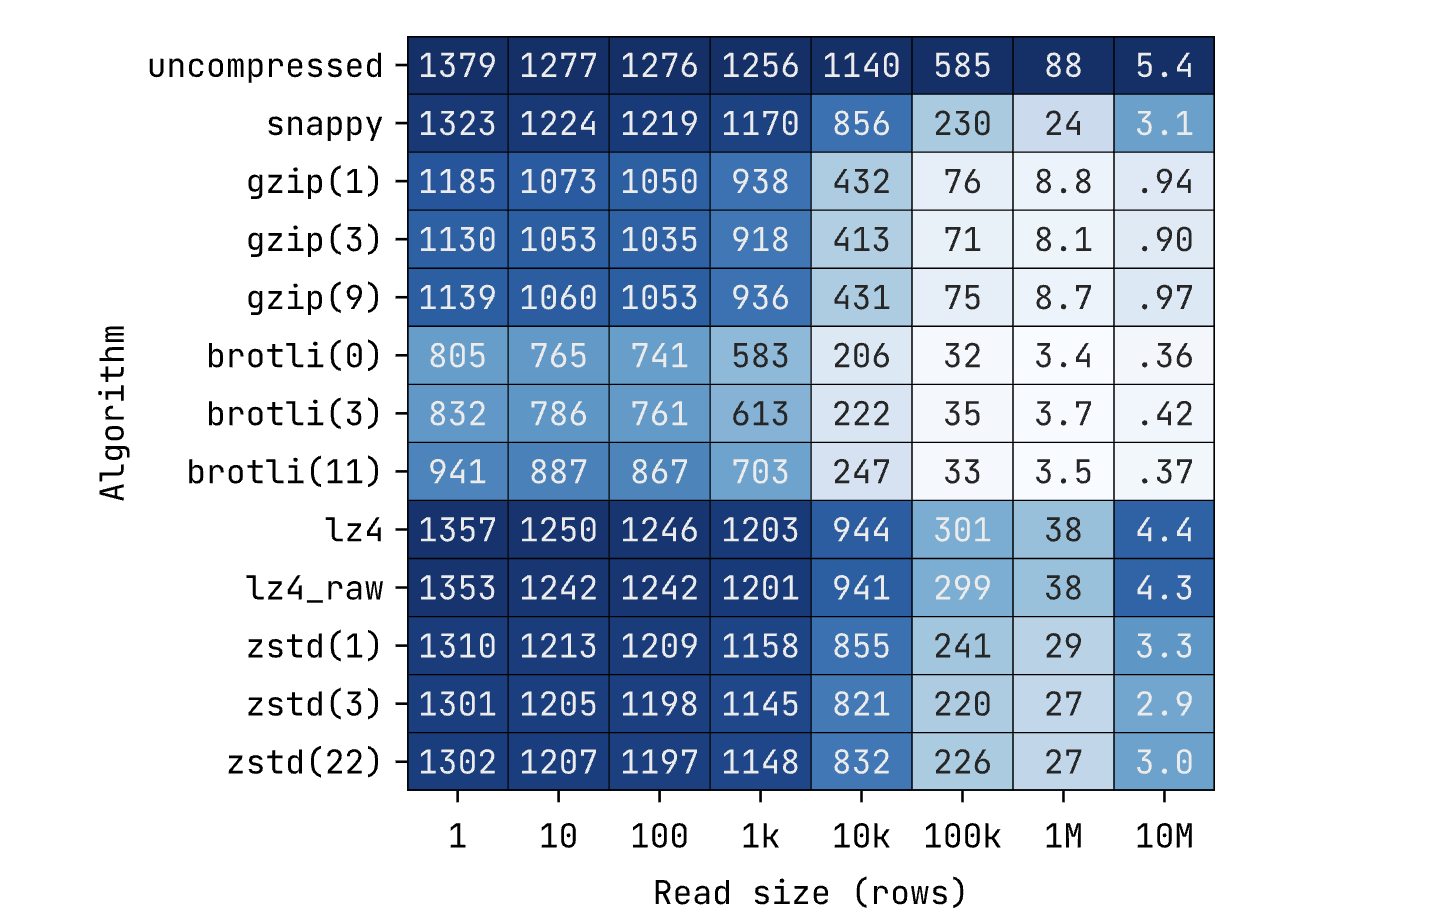
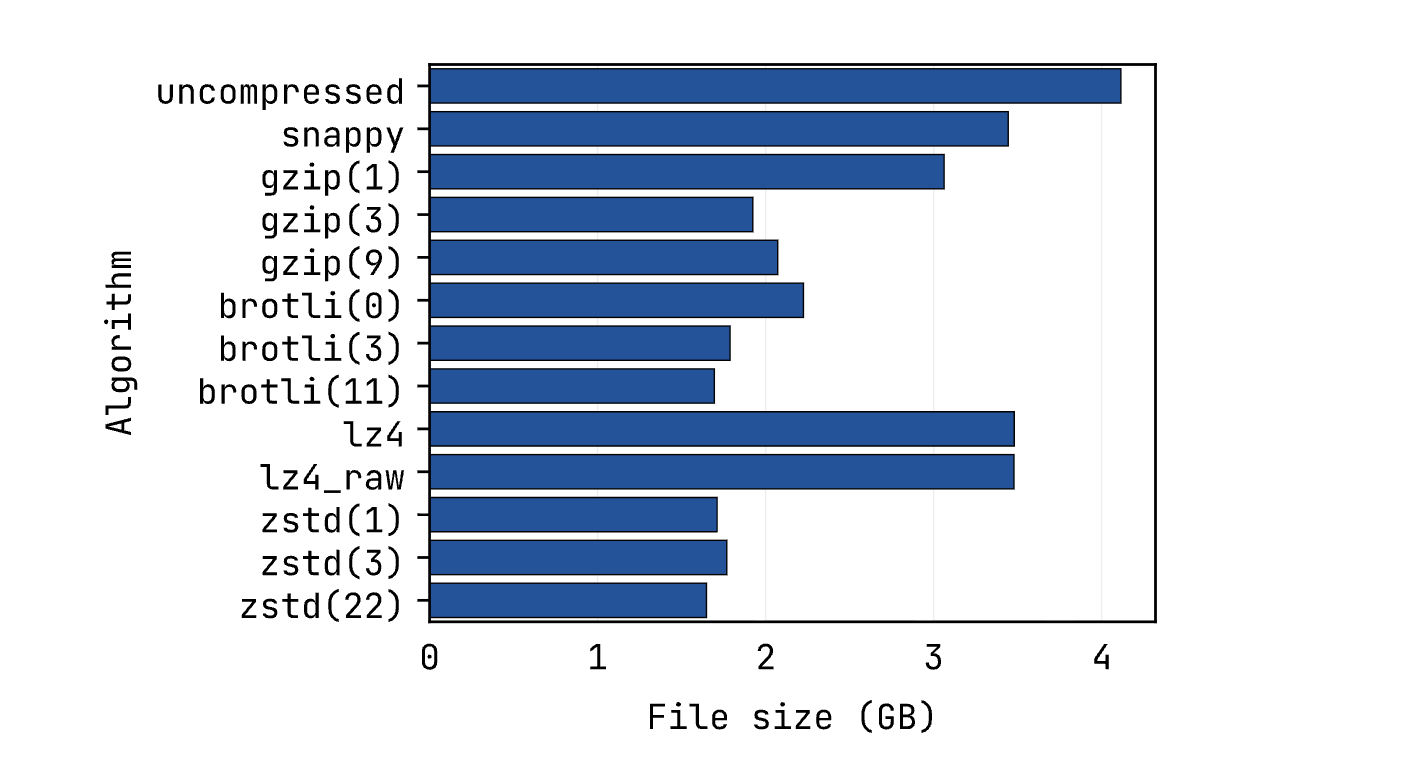
Главный вывод: для нашего набора данных лучше использовать lz4, если приоритет – скорость (а возможно, даже uncompressed, то есть вообще без сжатия). При этом zstd обеспечивает лучший компромисс между размером файла и скоростью работы. Именно этот алгоритм используется в DataFusion по умолчанию.
Алгоритм snappy тоже довольно распространён. Например, он используется по умолчанию при записи файлов Parquet в Spark и DuckDB. На нашем наборе данных он обеспечивает примерно такой же размер файла, как lz4, но в DataFusion работает медленнее при сканировании больших объёмов данных.
Выполнение запросов (оптимизация настроек DataFusion)
Число партиций выполнения
Теперь перейдём к оптимизации самого выполнения запросов. Начнём с параметра target_partitions в DataFusion. Он определяет степень параллелизма при выполнении запроса и по умолчанию равен числу доступных процессорных ядер.
Однако точечное чтение требует настолько мало вычислений, что накладные расходы на распределение нагрузки между несколькими ядрами перевешивают пользу от параллелизма. Поэтому в следующем тесте (рисунок 12) сравним пропускную способность при точечном чтении и сканировании больших объёмов данных с одной и восемью партициями (значение по умолчанию).
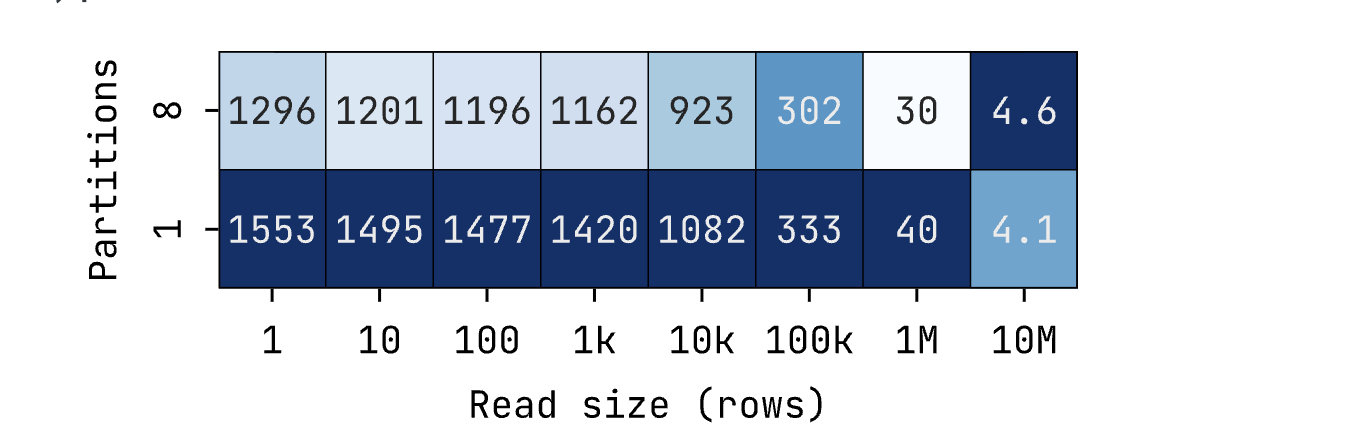
Результаты показывают, что небольшие объёмы данных быстрее читаются с одной партицией. Дополнительные партиции создают накладные расходы, поскольку затем их приходится объединять в одну.
С другой стороны, при чтении больших объёмов данных (в нашем случае 10 млн строк) дополнительные партиции ускоряют работу за счёт параллелизма. Поэтому оптимальное значение этого параметра сильно зависит от характера нагрузки. К счастью, его можно менять прямо во время работы с помощью команды SET datafusion.execution.target_partitions = ....
Проталкивание фильтров
Теперь рассмотрим ещё один параметр DataFusion – pushdown_filters. Он позволяет применять фильтры непосредственно при сканировании Parquet, без отдельного узла FilterExec.
Даже когда эта возможность отключена (по умолчанию), DataFusion всё равно отсекает ненужные данные на уровне страниц. Разницу между включённым и отключённым проталкиванием фильтров при поиске по произвольному ключу хорошо видно на следующих фрагментах физического плана выполнения:
# pushdown_filters disabled
FilterExec k=<VAL> (output_rows=1)
  DataSourceExec predicate=k=<VAL> (output_rows=1k)

# pushdown_filters enabled
DataSourceExec predicate=k=<VAL> (output_rows=1)
При настройках по умолчанию DataSourceExec возвращает 1 тыс. строк, то есть содержимое одной страницы данных. Затем FilterExec отфильтровывает их, оставляя только нужную строку.
Если включить pushdown_filters, вся фильтрация выполняется внутри крейта Arrow, и на выходе сразу получаем одну строку.
Чтобы выяснить, какой вариант лучше, сравним производительность при чтении разных объёмов данных. Результаты показаны на рисунке 13.
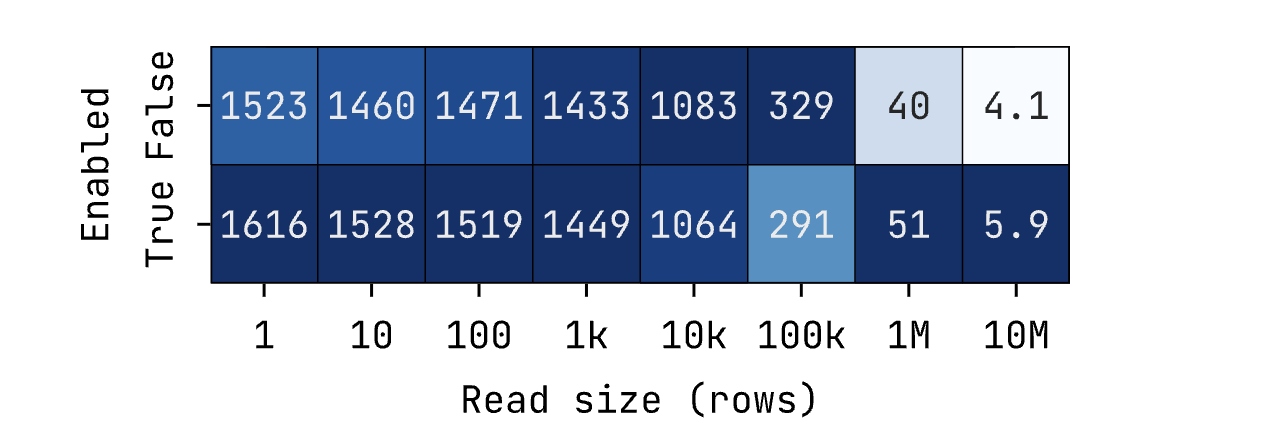
True) и отключённым (False) параметром pushdown_filters. Цвет каждой ячейки отражает отношение полученной пропускной способности к максимальному значению в соответствующем столбце (чем темнее, тем лучше).
Как для небольших объёмов чтения (менее 10 тыс. строк), так и для больших (более 100 тыс. строк) включение pushdown_filters повышает пропускную способность.
Любопытно, что при чтении средних объёмов данных (от 10 до 100 тыс. строк) запросы, наоборот, выполняются быстрее с отключённым pushdown_filters. Почему так происходит, пока не совсем понятно. Скорее всего, дело в сочетании особенностей операций ввода-вывода и эффективности представления фильтров. Я несколько раз повторял тесты на разных машинах и каждый раз наблюдал одну и ту же картину.
На момент написания статьи эта возможность по умолчанию отключена, поскольку она замедляет некоторые запросы. Подробнее об этом можно прочитать в обсуждениях #3463 и #20324.
Кеш метаданных
Чтобы найти данные в файле Parquet, DataFusion сначала должен прочитать и разобрать встроенные метаданные файла. Сам по себе этот предварительный этап может занимать в несколько раз больше времени, чем точечный поиск.
Поэтому начиная с версии 50.0.0 DataFusion по умолчанию кеширует метаданные Parquet, чтобы не обрабатывать их заново при каждом чтении (подробнее в #17000).
Чтобы понять, насколько это важно, сравним пропускную способность точечного чтения с кешированием метаданных и без него для таблиц разного размера. Результаты показаны на рисунке 14.
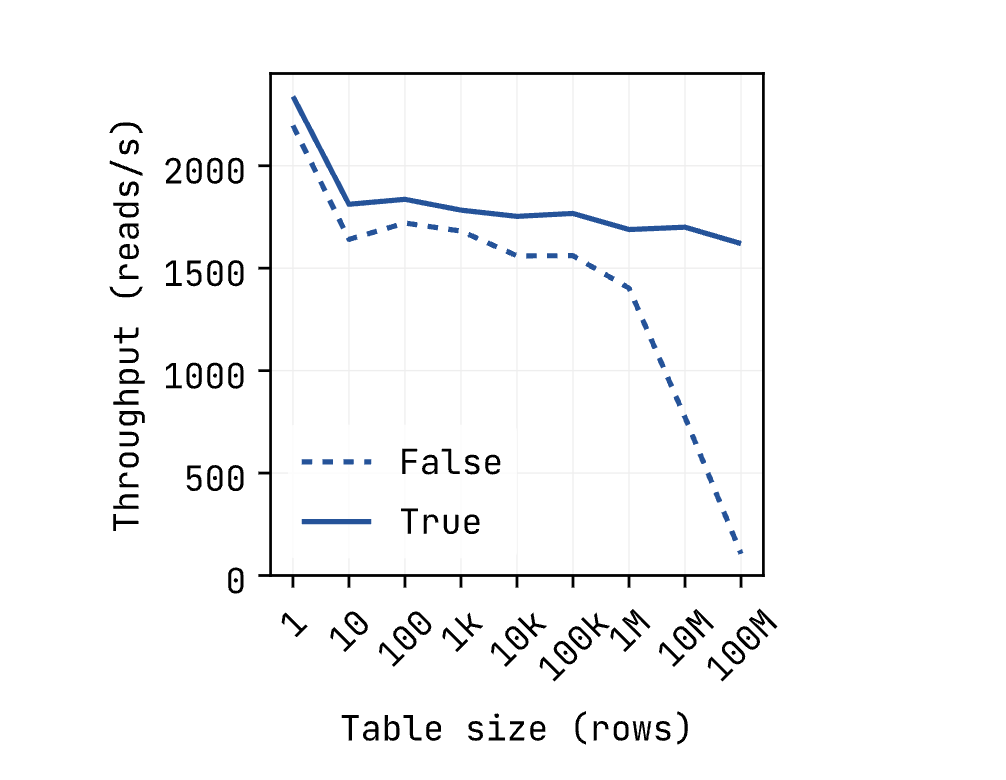
True) и без него (False) в зависимости от размера таблицы.
При включённом кеше метаданных пропускная способность почти не меняется с ростом размера файла. Без кеша она быстро падает на больших файлах: чем больше файл, тем больше метаданных приходится обрабатывать и тем больше времени на это уходит.
Поэтому, если мы собираемся обращаться к одному файлу несколько раз, кеширование метаданных лучше оставить включённым. Единственное, что может потребоваться, – увеличить лимит кеша, если одновременно выполняются запросы к большому количеству крупных файлов. Для этого используется параметр datafusion.runtime.metadata_cache_limit (по умолчанию 50 МБ).
Посмотреть содержимое кеша можно через инструмент datafusion-cli, вызвав функцию metadata_cache():
> SELECT path, metadata_size_bytes, hits FROM metadata_cache();
+-----------+---------------------+------+
| path      | metadata_size_bytes | hits |
+-----------+---------------------+------+
| t.parquet | 19752725            | 1    |
+-----------+---------------------+------+
Подготовленные запросы
Прежде чем выполнить SQL-запрос, DataFusion строит и оптимизирует логический план, а затем на его основе создаёт и оптимизирует физический план выполнения. При точечном чтении эти этапы занимают значительную часть времени, что хорошо видно на рисунке 15 с результатами профилирования процессорного времени.
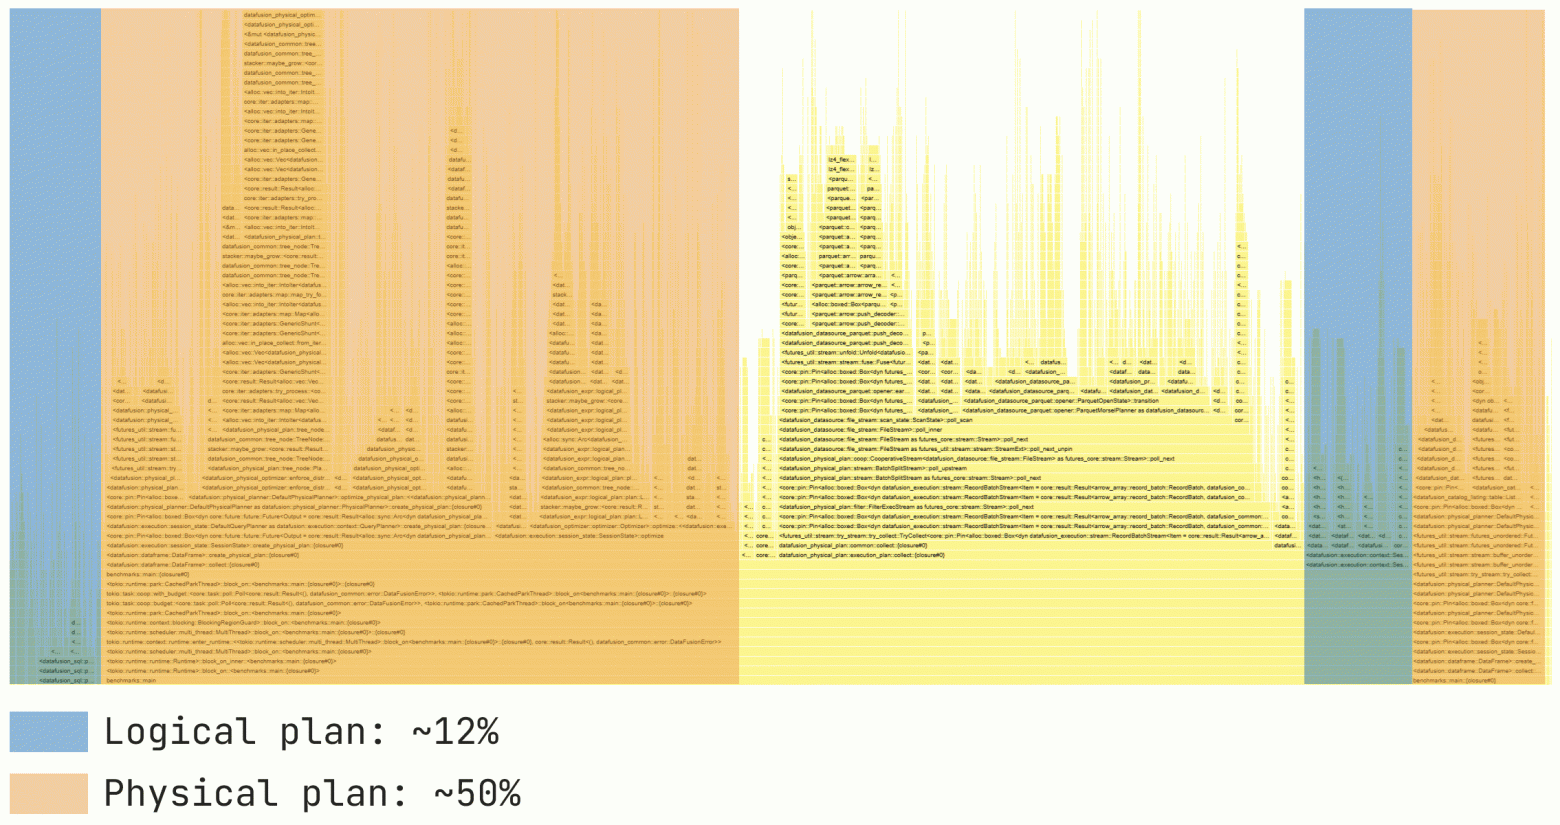
Около 12% всего процессорного времени уходит на построение логического плана, а ещё 50% – на физический план. Если мы многократно выполняем один и тот же запрос или меняем только его параметры, имеет смысл кешировать планы с помощью подготовленных запросов (prepared statements). Однако сейчас в DataFusion подготовленные запросы позволяют повторно использовать только логический план.
Чтобы оценить потенциальную пользу от повторного использования физического плана, я реализовал собственный вариант подготовленных запросов. В нём план строится с параметрами-заполнителями и сохраняется в кеше. Затем при выполнении запроса создаётся копия этого плана, а все узлы с параметрами-заполнителями (например, DataSourceExec, FilterExec, ProjectionExec) пересоздаются уже с конкретными значениями параметров.
На рисунке 16 сравнивается пропускная способность для разных типов точечных запросов при трёх вариантах: с моей реализацией повторного использования физического плана (physical), со стандартными подготовленными запросами DataFusion (logical) и вообще без подготовленных запросов (no).
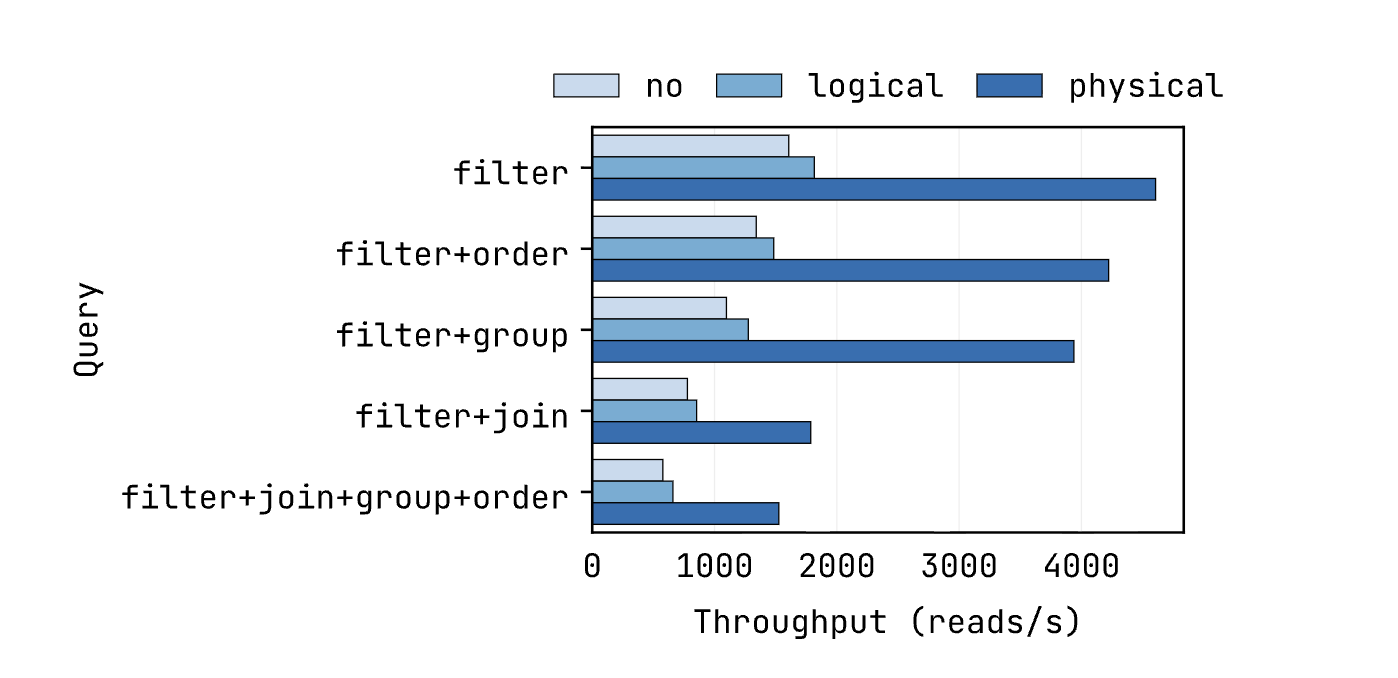
no), со встроенным механизмом подготовленных запросов DataFusion (logical) и с собственной реализацией повторного использования физических планов (physical).
Повторное использование логического плана уже даёт прирост производительности по сравнению с выполнением без кеширования планов. Но повторное использование физического плана повышает пропускную способность гораздо сильнее, ускоряя выполнение запросов в два, а иногда и в три раза.
Пока такой возможности в DataFusion нет. Подробнее об этом можно прочитать в #26706.
Аллокатор памяти
Ещё один фактор, заметно влияющий на производительность DataFusion, – используемый аллокатор памяти. Как видно на рисунке 17, это важно и для точечного чтения, и для сканирования больших объёмов данных.
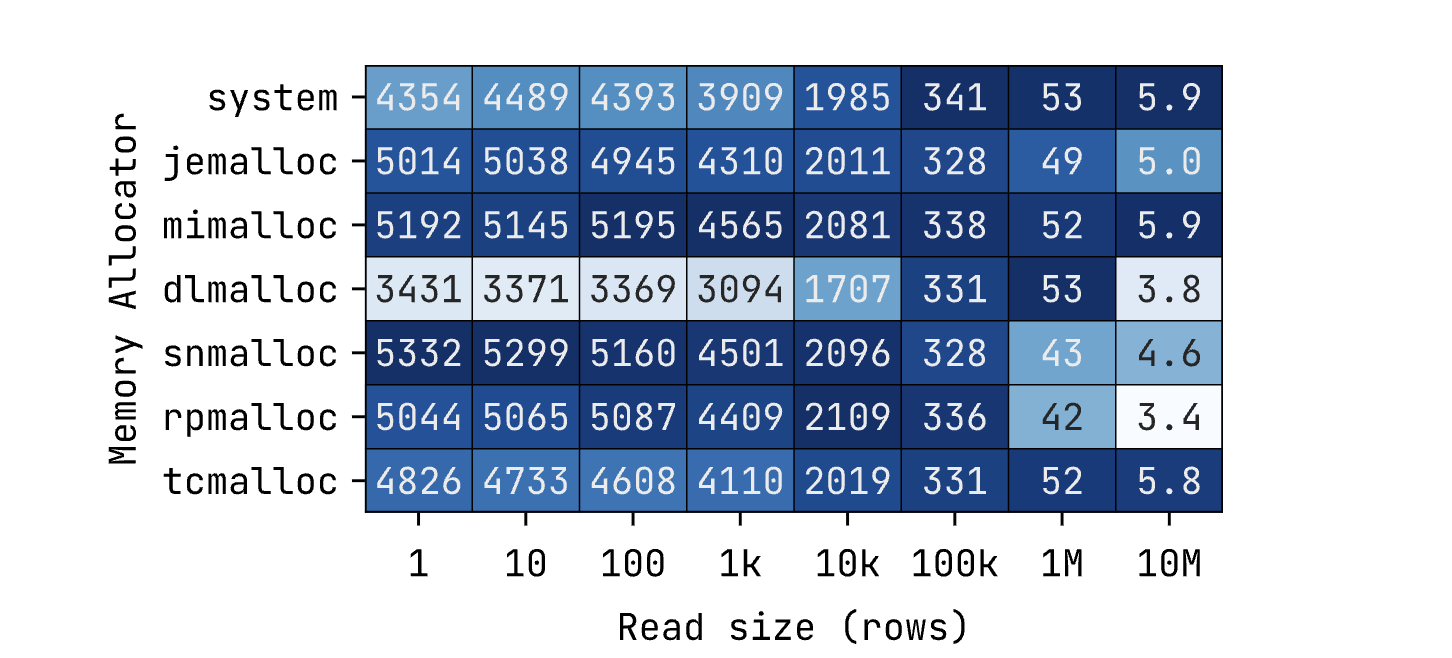
system используется по умолчанию). Цвет каждой ячейки отражает отношение полученной пропускной способности к максимальному значению в соответствующем столбце (чем темнее, тем лучше).
Результаты показывают, что пропускная способность при использовании разных аллокаторов может сильно различаться. Для небольших объёмов чтения лучше подходят snmalloc и mimalloc, а для крупных – system, mimalloc или tcmalloc.
Таким образом, для нашей нагрузки mimalloc выглядит лучшим универсальным вариантом. Неудивительно, что именно он используется в datafusion-cli и Python-библиотеке DataFusion.
Среда выполнения
Последняя тема, которую мы рассмотрим, – среда выполнения tokio, используемая в DataFusion. Библиотека tokio обеспечивает асинхронное выполнение задач в Rust. Для DataFusion это особенно полезно, поскольку при получении данных запросам часто приходится ждать завершения операций ввода-вывода или сетевых запросов. В это время текущий поток можно освободить для выполнения другой задачи.
Однако я заметил, что при нагрузке с несколькими клиентами, каждый из которых выполняет множество запросов к небольшим объёмам данных, пропускная способность масштабируется хуже, чем хотелось бы.
Изначально я использовал самый простой подход: создавал отдельную задачу tokio::task для каждого клиента, причём у каждого был собственный SessionContext:
tokio::task::spawn(
    async move {
        let ctx = SessionContext::new();
        // выполнение работы
    }
)
Поэкспериментировав с разными конфигурациями, я обнаружил, что отдельная однопоточная среда выполнения для каждого клиента обеспечивает лучшее масштабирование. Это подтверждают результаты на рисунке 18:
tokio::task::spawn(async move {
    std::thread::spawn(move || {
        let rt = tokio::runtime::Builder::new_current_thread()
            .enable_all()
            .build()
            .unwrap();
        rt.block_on(async {
            let ctx = SessionContext::new();
            // выполнение работы
        })
    })
})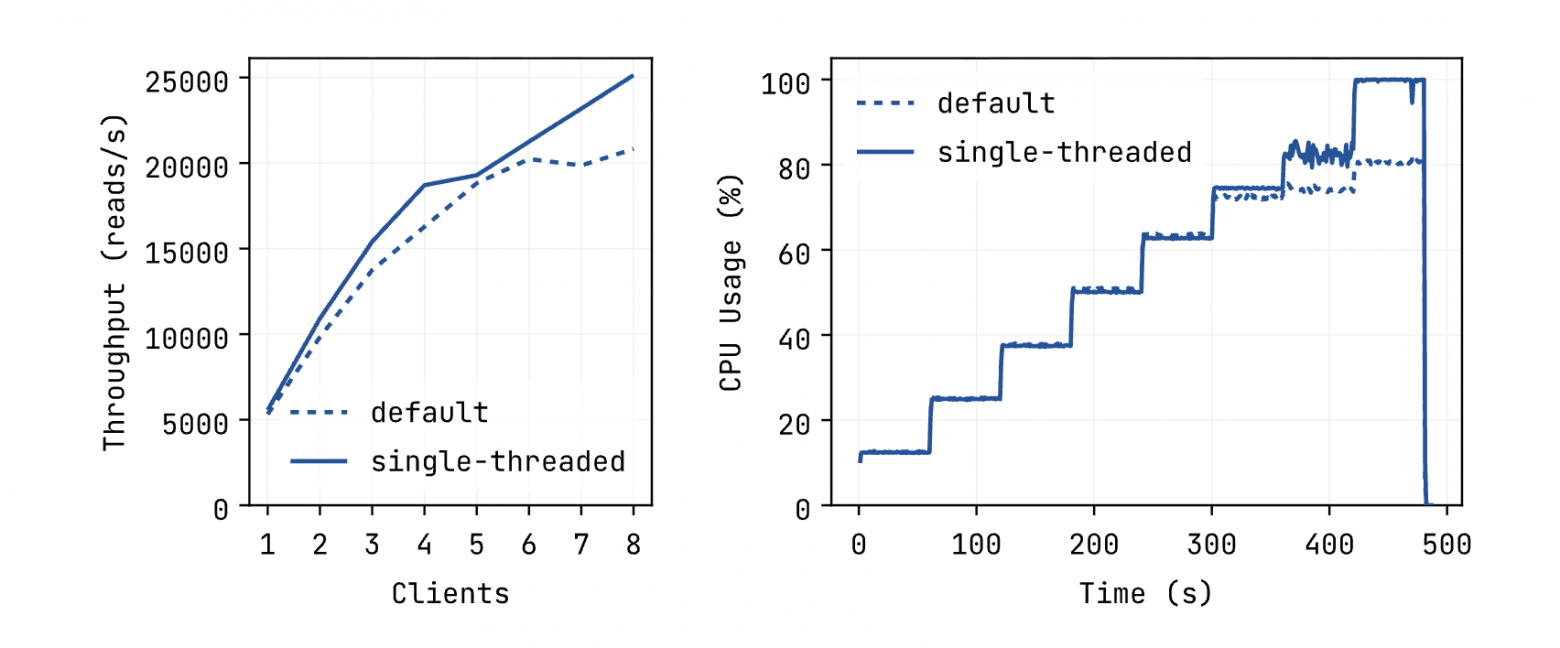
default) и нескольких однопоточных сред выполнения (single-threaded).
Из результатов видно, что в стандартном варианте при 7–8 клиентах пропускная способность практически перестаёт расти, хотя процессор ещё не загружен полностью. При использовании нескольких однопоточных сред выполнения такой проблемы нет.
Конечно, у этого подхода есть ограничение: каждый аналитический запрос сможет использовать только один поток. Поэтому рекомендовать такую конфигурацию можно лишь для точечных запросов.
Итоги
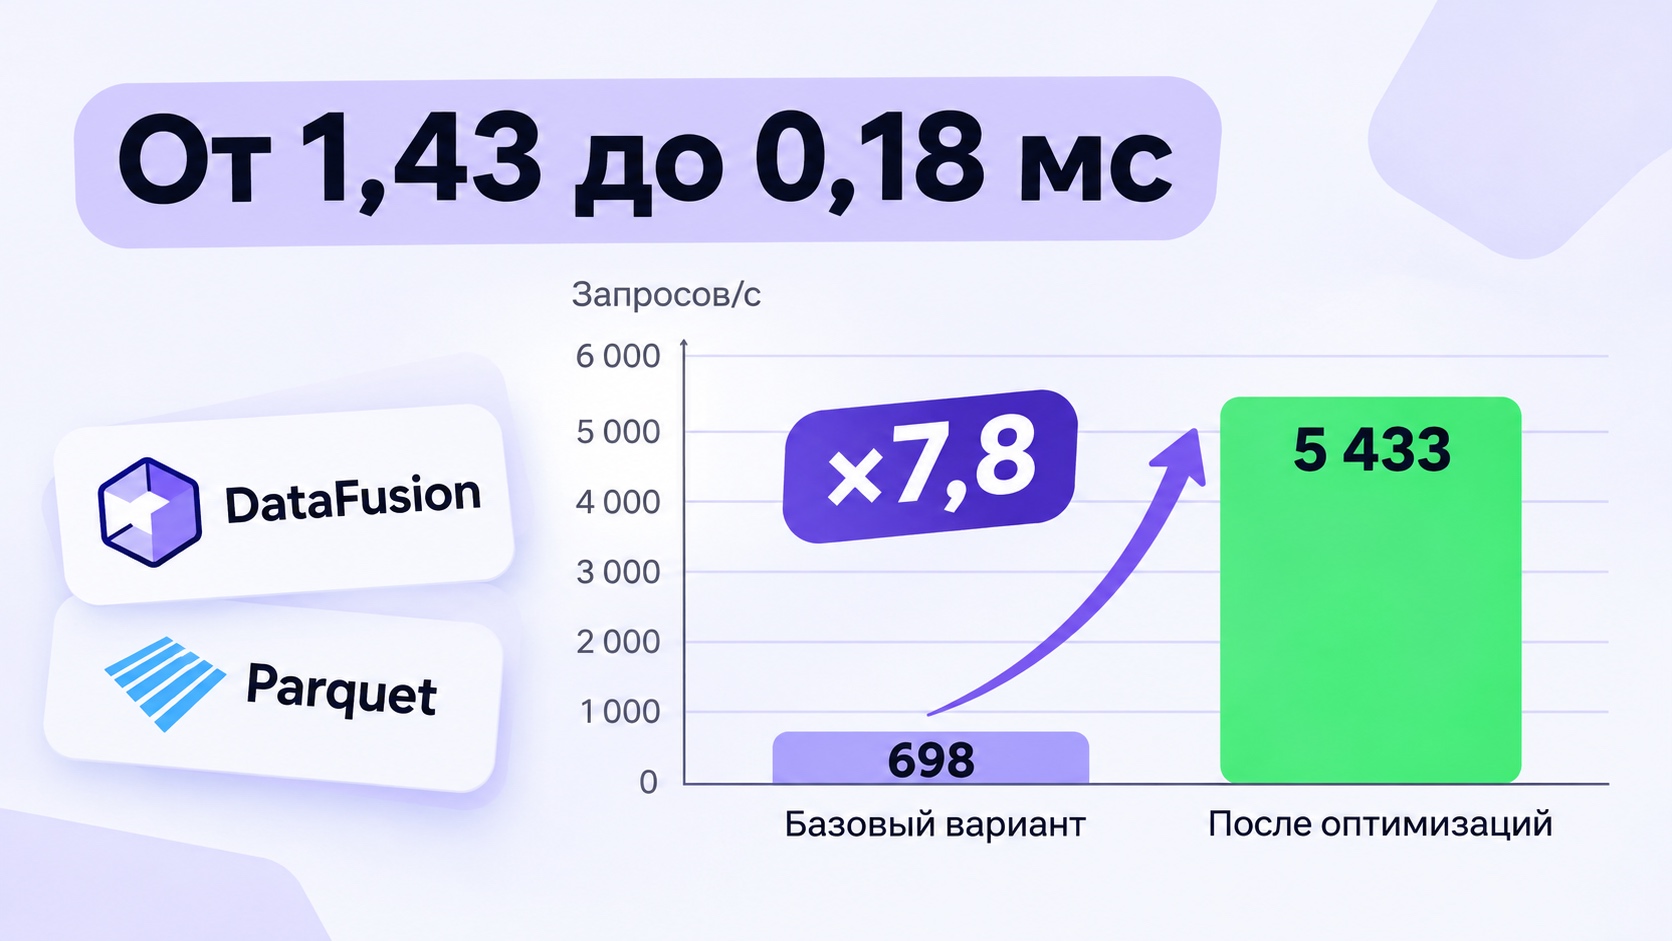
В таблице 1 собраны основные оптимизации, которые мы протестировали. В итоге нам удалось увеличить пропускную способность почти в 8 раз по сравнению с базовым вариантом и сократить время отклика до менее чем 0,2 мс. Это показывает, что DataFusion вполне способен эффективно справляться с нагрузками, связанными с точечным чтением.
Таблица 1: Пропускная способность и время отклика при точечном чтении в зависимости от применённых оптимизаций (один клиент; каждая следующая оптимизация добавляется к предыдущим).
Оптимизация | Пропускная способность (чтений/с) | Время отклика (мс) |
|---|---|---|
Сортировка данных в файле | 698 | 1,43 |
Отключение словарного кодирования | 1062 | 0,94 |
Настройка размеров групп строк и страниц данных | 1370 | 0,73 |
Настройка числа партиций выполнения | 1553 | 0,64 |
Проталкивание фильтров | 1616 | 0,62 |
Подготовленные запросы | 4606 | 0,22 |
Аллокатор памяти | 5192 | 0,19 |
Однопоточные среды выполнения | 5433 | 0,18 |
При работе с точечными запросами производительность часто упирается не в объём данных, а в накладные расходы: создание потоков, планирование выполнения, повторную обработку одних и тех же данных. Похожие проблемы возникают и за пределами DataFusion. На этих бесплатных уроках разберём, как искать узкие места под нагрузкой и использовать кеширование для ускорения работы систем.
30 ноября, 20:00. «Почему Java-сервис тормозит: пулы и виртуальные потоки на нагрузочном тесте». Записаться
10 декабря, 20:00. «Продвинутые алгоритмы кэширования». Записаться
Больше открытых уроков от преподавателей Otus можно найти в календаре мероприятий.

Комментарии 0