На Human Benchmark я дошёл до 13-го уровня в Sequence Memory и до 12-го в Chimp Test. В какой-то момент заметил, что начал запоминать картину группами. Стало интересно, можно ли натренировать такой способ и на других заданиях.
Сами упражнения мне нравились. А вот ради пяти минут каждый раз открывать отдельный сайт, уже не очень. Obsidian у меня и так запущен почти каждый день: там дневник, проекты, заметки о самочувствии и куча вещей, к которым я регулярно возвращаюсь. Захотелось поселить несколько таких игр прямо там.
Получился Brumalt — бесплатный офлайн-плагин с шестью играми, короткими сессиями и статистикой. Открываешь небольшое окно поверх заметки, играешь и возвращаешься к работе.
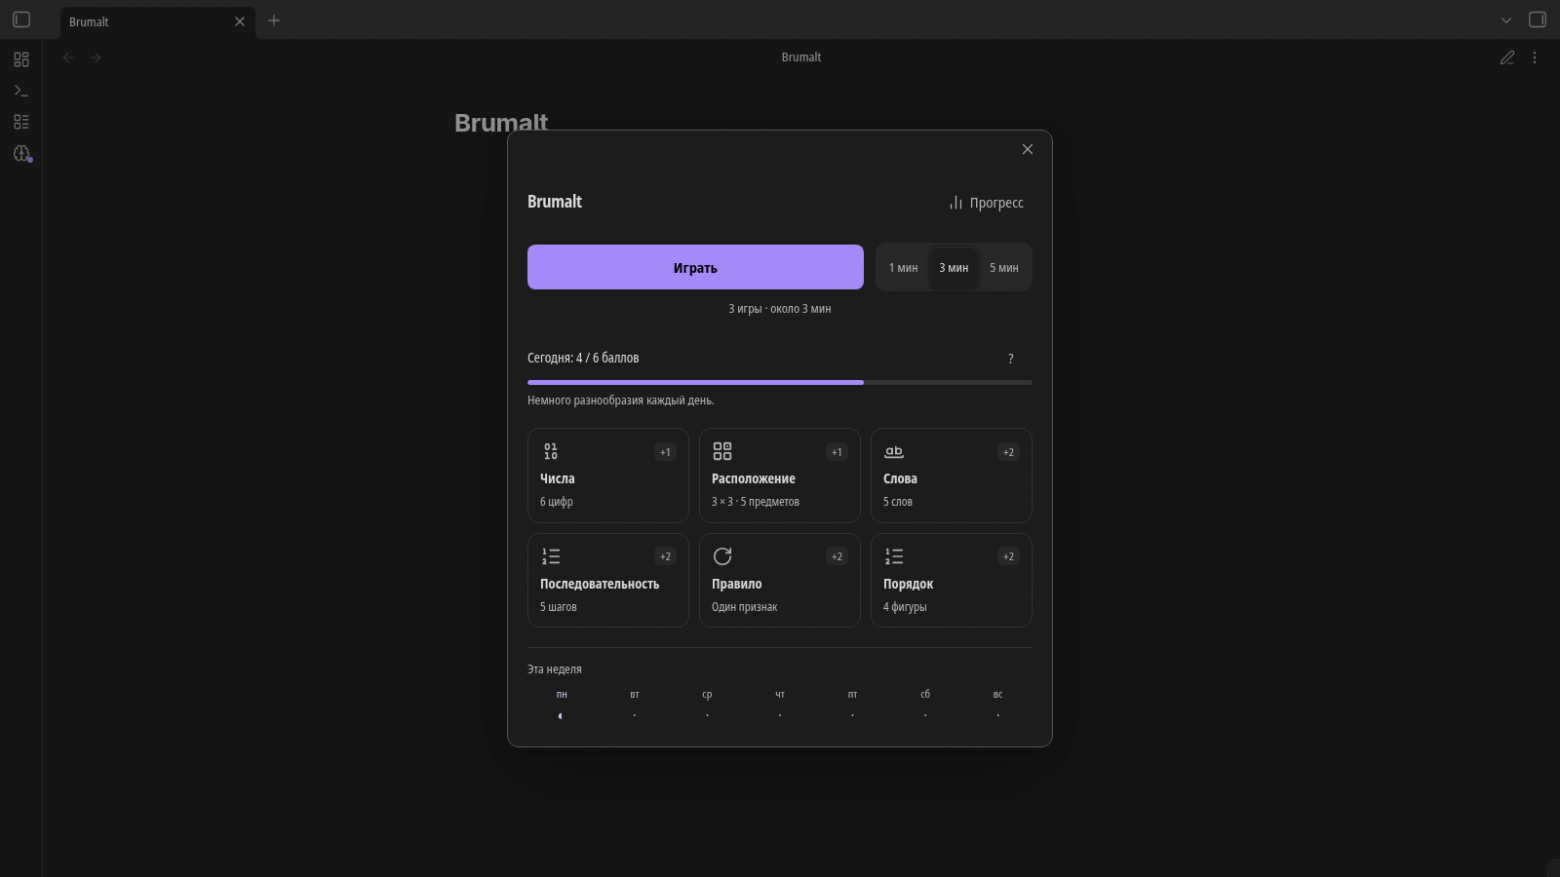
Главный экран в Obsidian. Статистика на скриншоте демонстрационная.
Во что можно поиграть
Четыре игры посвящены запоминанию:
Числа — запомнить ряд от 4 до 13 цифр и ввести его. Нули в начале тоже считаются.
Расположение — увидеть предметы на сетке, а затем показать, где находился нужный.
Слова — выбрать ранее показанные слова среди отвлекающих вариантов. Это узнавание, вводить слова по памяти не требуется.
Последовательность — повторить порядок вспышек плиток. Здесь важно именно следование, включая повторы одной плитки.
Ещё две игры — логические. В Правиле надо понять, как меняется фигура, глядя на примеры преобразований. В Порядке — восстановить расположение фигур по условиям вроде «круг левее квадрата» или «треугольник сразу справа от ромба».
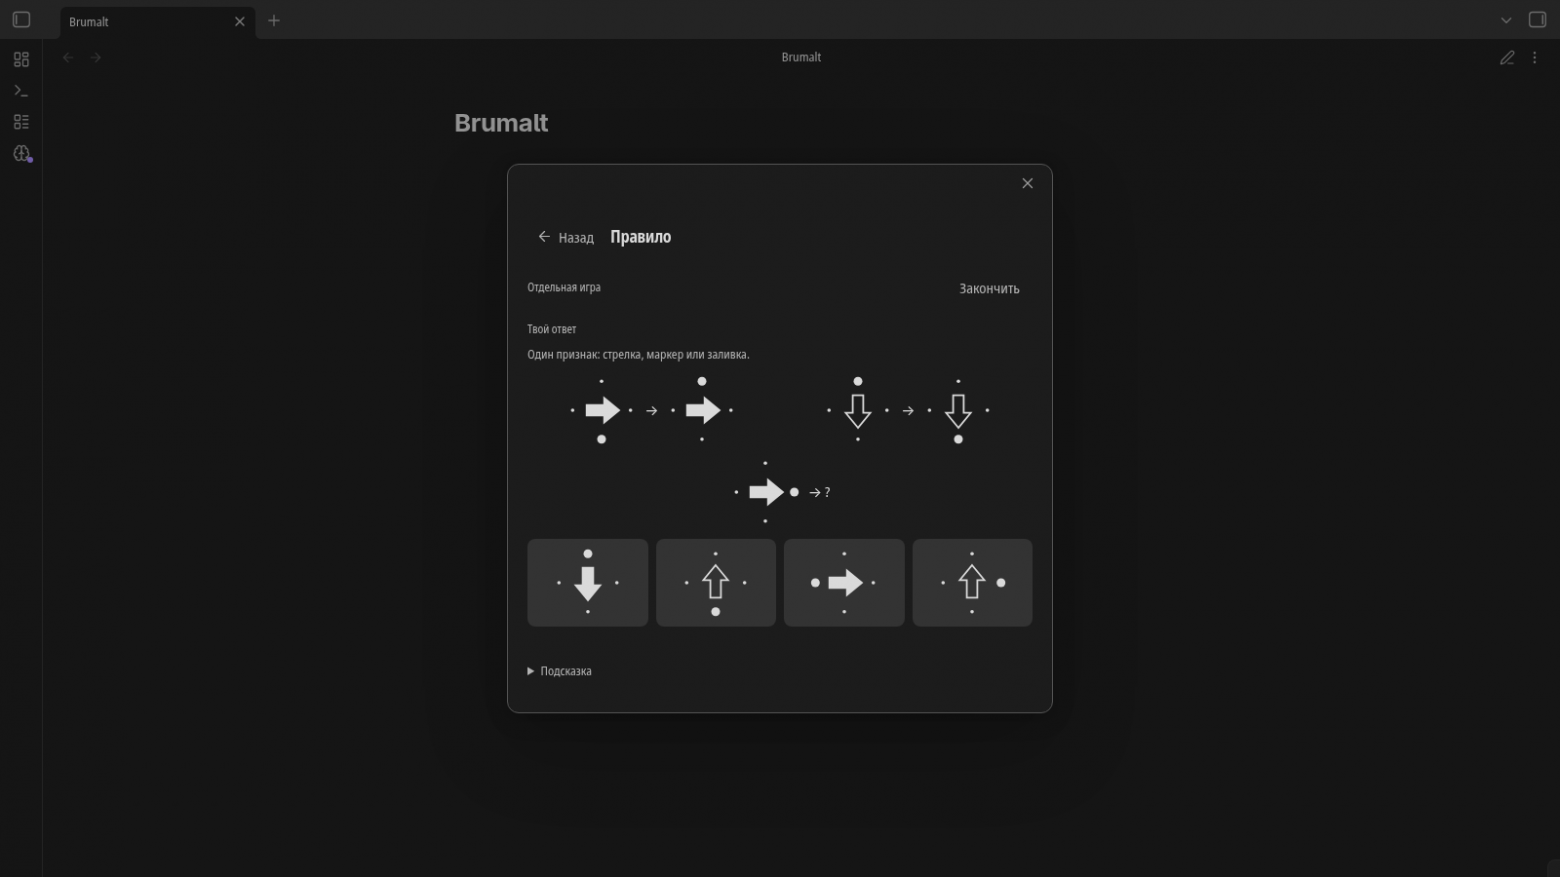
«Правило»: примеры, новая фигура и четыре варианта ответа.
Есть отдельные игры и смешанные сессии примерно на одну, три или пять минут. Длительность приблизительная: плагин планирует число попыток и даёт закончить начатую, даже если время уже вышло.
Мне важно, чтобы плагин не заглядывал в мои записи. Brumalt не читает содержимое заметок, не делает сетевых запросов и не собирает телеметрию. История попыток и настройки хранятся локально в данных самого плагина.
Что пришлось переделывать в процессе
Я разрабатывал Brumalt с помощью Codex: описывал поведение, получал реализацию и проверял её в Obsidian. Причём первые проблемы обнаружились задолго до того, как захотелось разбираться в формулах.
Сначала игры открывались в отдельной большой вкладке. На первый взгляд нормально. Но ради короткого перерыва я не хотел уходить с текущей заметки, поэтому перенёс всё в компактное всплывающее окно.
Потом взялся за навигацию. На главной странице было слишком много пояснений, выбор языка занимал место рядом с запуском, недельная статистика перетягивала внимание. Я сократил карточки, убрал язык в настройки, перенёс недельный блок ниже и несколько раз переделал путь обратно к главному экрану.
Однажды открыл очередную сборку и обнаружил два крестика закрытия: мой и встроенный в Obsidian. Убрал лишний. Заодно проверил поведение незавершённой попытки: при выходе теперь можно отменить игру или остаться, не получив случайный проигрыш из-за закрытого окна.
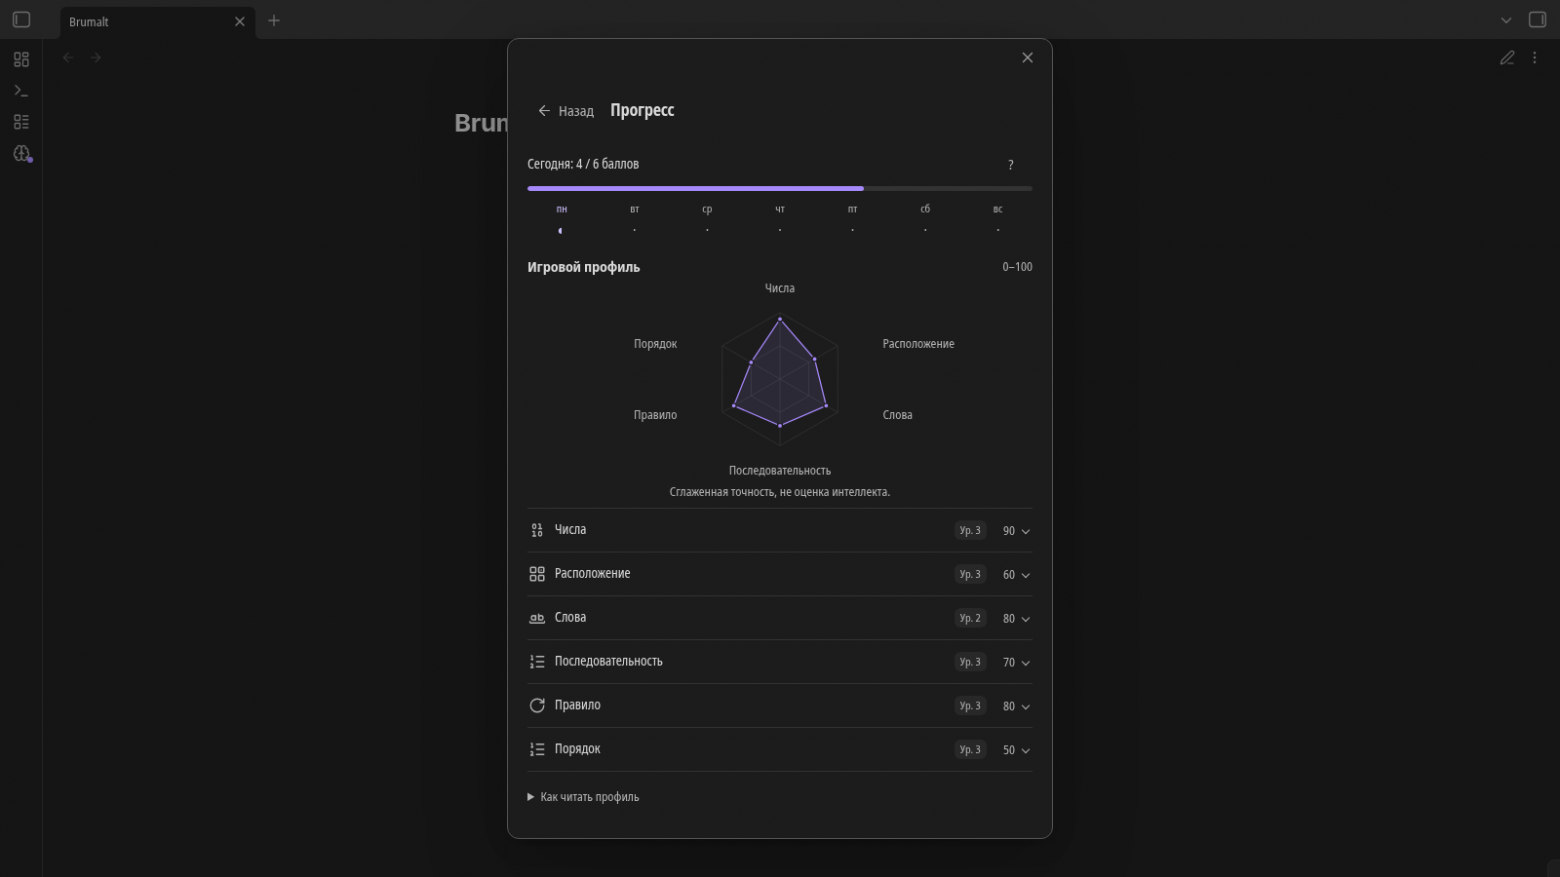
Экран прогресса после нескольких итераций интерфейса. Результаты демонстрационные.
Полной недели регулярных занятий через Brumalt у меня пока нет. Поэтому я могу предметно рассказать о разработке и тестировании механик, но не буду приписывать себе несуществующие рекорды в самом плагине.
Как генератор проверяет задания
Больше всего возни было с двумя логическими играми. Случайно выбрать фигуры и придумать условие недостаточно: игрок вполне может найти второй ответ, который тоже подходит.
«Порядок» и 24 перестановки
Генератор сначала выбирает расстановку, а затем составляет верные для неё подсказки. После этого он перебирает все возможные порядки фигур и проверяет каждую подсказку. Для четырёх фигур возможны всего 4! = 24 перестановки. Полный перебор здесь проще любого хитрого решателя.
Вот реальная функция из src/games/order.ts:
export function solveOrder(
  c: Pick<OrderChallenge, 'objects' | 'clues'>
): number[][] {
  return permutations(c.objects).filter(order =>
    c.clues.every(clue => satisfies(order, clue))
  );
}
Дальше генератор пробует удалять подсказки по одной. Если после удаления остаётся ровно одно решение, подсказка была лишней. Допустим, уже есть «круг левее квадрата» и «квадрат левее треугольника». Дополнительное «круг левее треугольника» ничего не меняет — его можно убрать.
Так получаются более короткие условия, хотя алгоритм не обещает математически минимальный набор из всех возможных. Число попыток генерации ограничено, после них предусмотрен проверяемый запасной вариант.
В «Правиле» проверяется предсказание
Фигуры отличаются направлением, положением маркера и заливкой. Генератор использует заранее известные преобразования: поворот, перемещение, смену заливки; на более высоком уровне — сочетания операций.
Он перебирает все разрешённые правила, которые объясняют примеры, и применяет их к новой фигуре. Если подходящие правила предсказывают разные результаты, задача отбрасывается. Если ответ у них одинаковый, можно играть: выбор из четырёх вариантов будет однозначным в пределах этого набора правил. Реализация лежит в src/games/rule.ts.
Как меняется сложность
У каждой игры своя шкала. Плагин смотрит на четыре последние завершённые попытки на текущем уровне.
Игра | Повышение на один уровень | Понижение на один уровень |
|---|---|---|
Числа, Расположение, Последовательность | 4 из 4 попыток с точностью ≥ 90% | 3 из 4 попыток с точностью ≤ 50% |
Слова | 4 из 4 безошибочных наборов | В 3 из 4 попыток — не менее двух неправильных выборов в каждой |
Правило, Порядок | 4 из 4 правильных ответов | 3 из 4 неправильных ответов |
После смены уровня окно очищается. Прерванные задания на сложность не влияют. Алгоритм простой, его целиком можно прочитать в adaptation.ts.
Есть ещё дневная цель. Первая завершённая попытка в каждой игре приносит два балла, вторая — один, следующие продолжают сохраняться в историю, но баллов цели не дают. Чтобы набрать стандартные шесть баллов, надо сыграть хотя бы в две игры. Ошибочные завершённые попытки тоже считаются участием. Цель и напоминания необязательны; штрафов за пропуски нет.
Почему на диаграмме нельзя сразу получить 100
Для статистики я сделал диаграмму с шестью осями — по одной на игру. Но точность одной последней попытки слишком резко скачет: сегодня 100%, завтра 0%, и график каждый раз выглядит совершенно другим.
Индекс для каждой оси считается не более чем по десяти последним сопоставимым попыткам: с одинаковыми уровнем, правилами, режимом и параметрами. Пока результатов меньше десяти, пустые места в формуле условно получают значение точности 0,5.
индекс = 100 × (сумма точностей + 0,5 × (10 − n)) / 10

n — количество сопоставимых попыток, от 1 до 10
Получившееся число округляется до ближайшего кратного пяти. Одна идеальная попытка даст 55, четыре — 70, десять — 100. Смена условий игры переключает статистику на другую группу попыток; если данных нет совсем, на оси показывается отсутствие результата. Код расчёта.
Чем это отличается от готовых приложений
У Lumosity и Peak есть собственные библиотеки игр и системы прогресса. Это отдельные сервисы, к которым нужно возвращаться. Мне хотелось обходиться уже открытым Obsidian.
Brain Workshop интересен тем, кто хочет заниматься именно n-back — отдельным типом заданий на рабочую память. Мне хотелось чередовать несколько разных механик, включая простые логические задачи.
Есть и Obsidian Spaced Repetition. Он помогает повторять материал из собственных заметок по расписанию. У Brumalt другой сценарий: он вообще не использует заметки как задания. Можно закрыть сложный документ, переключиться на пару минут и вернуться к нему.
Помогают ли такие игры памяти
В обзоре Simons и коллег (2016) много данных о прогрессе в самих тренировочных заданиях, меньше — о переносе на близкие задачи и мало — о пользе для повседневной деятельности. В эксперименте Owen и коллег (2010) с 11 430 участниками за шесть недель результаты упражнений выросли, но переноса на независимые тесты исследователи не обнаружили. [1], [2]
Есть и более оптимистичные результаты: Au и коллеги (2015) обнаружили небольшой положительный эффект n-back в метаанализе 20 исследований. Но Melby-Lervåg, Redick и Hulme (2016), проанализировав 87 публикаций и 145 сравнений, не нашли убедительных улучшений в далёком переносе при сопоставлении с активной контрольной группой. Выбор контроля здесь сильно влияет на вывод. [3], [4]
В работе Li, Liu и Chen (2026), метаанализе 45 исследований с нейровизуализацией (1 492 участника), улучшения нашли и на тренировавшихся, и на нетренировавшихся заданиях, но на вторых они заметно слабее: g ≈ 0,36 против 0,68 (для ориентира: около 0,2 — малый эффект, 0,5 — средний, 0,8 — большой). Причём «нетренировавшиеся» не значит «совсем другой навык»: во многих работах это были другие задания на рабочую память, в том числе n-back, то есть близкий перенос. [5]
Масштаб программ тоже несопоставим с Brumalt: около 39 минут за занятие, почти пять раз в неделю, в среднем 4,65 недели — грубо около 14 часов за курс (это ориентир по средним, а не точная нагрузка). Выборка смешанная: средний возраст около 34 лет, примерно две трети участников когнитивно здоровы, остальные из клинических групп. Сами авторы допускают, что часть эффекта объясняется практикой и освоением стратегий. Ожидать того же от пятиминутных сессий оснований нет. [5]
Что дальше
Brumalt пока совсем свежий. Мне самому интересно, буду ли я открывать его через неделю и через месяц, когда пройдёт интерес к новой игрушке. Ради этого всё и затевалось: чтобы можно было запустить короткую игру между делами, прямо в Obsidian.
Если попробуете, напишите в комментариях к статье или в Issues на GitHub. Расскажите, на каких играх задержались, где было слишком легко или непонятно, что мешало пользоваться окном. Особенно интересны впечатления после нескольких дней, а не только первого запуска.
Исходники Brumalt · Релиз 0.3.5 · MIT. Сейчас плагин устанавливается вручную в каталог .obsidian/plugins/, требуется Obsidian 1.13.0+. При обновлениях сохраняйте brumalt/data.json — там история результатов.
Исследования
Simons D. J. et al. (2016). Do “Brain-Training” Programs Work? Psychological Science in the Public Interest. DOI:
10.1177/1529100616661983.Owen A. M. et al. (2010). Putting brain training to the test. Nature. DOI:
10.1038/nature09042.Au J. et al. (2015). Improving fluid intelligence with training on working memory: a meta-analysis. Psychonomic Bulletin & Review. DOI:
10.3758/s13423-014-0699-x.Melby-Lervåg M., Redick T. S., Hulme C. (2016). Working Memory Training Does Not Improve Performance on Measures of Intelligence or Other Measures of “Far Transfer”: Evidence From a Meta-Analytic Review. Полный текст в PubMed Central. DOI:
10.1177/1745691616635612.Li G., Liu Y., Chen A. (2026). Meta-analysis of computerised working memory training: behavioural gains, training parameters, transfer mechanisms, and neural correlates. npj Digital Medicine. DOI:
10.1038/s41746-026-02478-9.


Комментарии 0