Scatter/Gather — паттерн, который почти каждый, кто проектировал интеграцию с несколькими источниками, хотя бы раз рисовал. Не все знают, что у схемы есть название, и ещё меньше тех, кто помнит про побочный эффект: чем больше источников опрашиваешь параллельно, тем сильнее система зависит от самого медленного из них.
Я системный аналитик, проектирую интеграции в корпоративном сегменте. В этой статье разберу главу про Scatter/Gather из книги Брендана Бёрнса «Распределённые системы. Паттерны проектирования» и покажу, что это за паттерн и как он работает в интеграциях, где источники данных чаще всего чужие.
Что будет в статье:
какую задачу решает паттерн и чем он отличается от репликации и шардирования;
почему параллельный опрос не бесплатный: эффект отстающего и немного математики;
что делать, когда данных слишком много: шардирование и репликация;
что остаётся, когда источники чужие и вторую копию API не поднять.
С чего всё начинается
Прилетает задача: спроектировать интеграцию, в которой нужно забрать данные из пяти источников и отдать пользователю один агрегированный ответ.
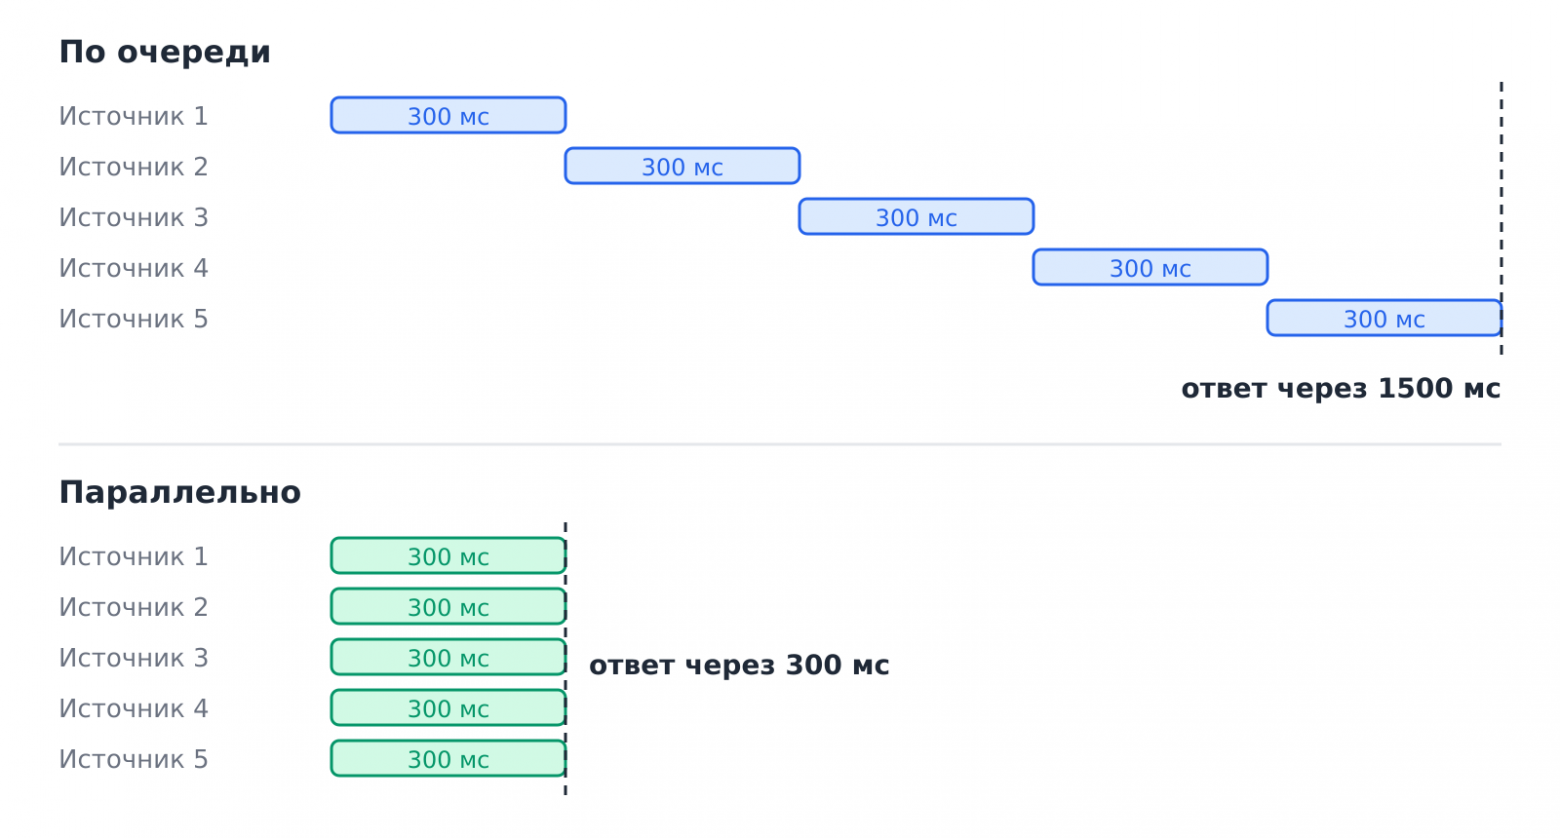
Первый вариант — дёргать источники по очереди. Работает, но если каждый запрос занимает 300 мс, пользователь ждёт полторы секунды. Не катастрофа, но и не быстро, а с ростом числа источников время растёт линейно.
Второй вариант — уйти в асинхронную обработку поверх очереди сообщений. Тоже рабочий путь, но это смена модели целиком: синхронный ответ пользователю превращается в асинхронный процесс, а сборку итогового результата из частичных ответов всё равно придётся писать самому поверх очереди.
Третий вариант решает именно эту задачу и называется Scatter/Gather.
Что такое Scatter/Gather
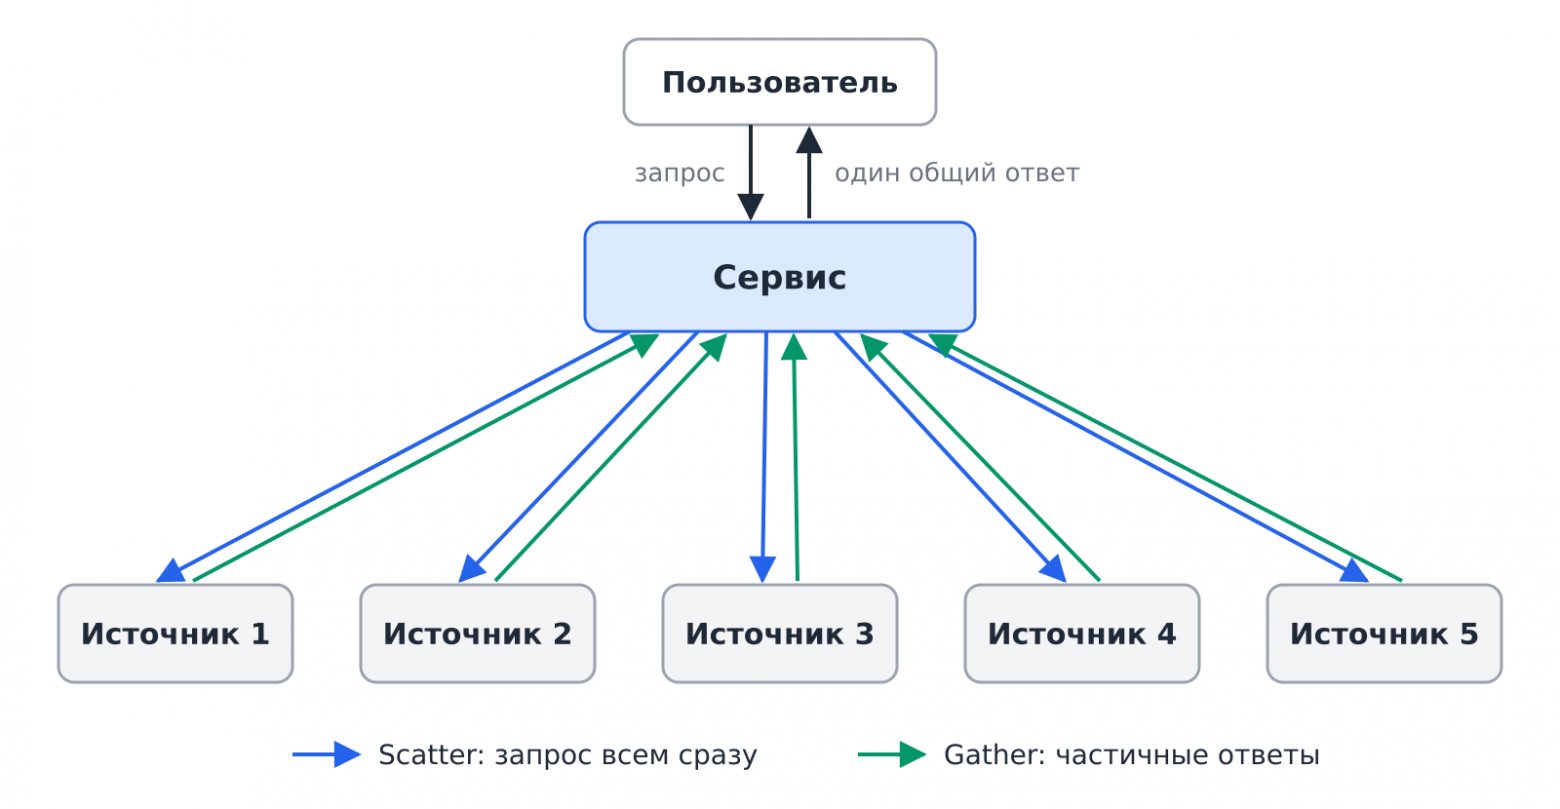
Идея простая. Вместо обхода по очереди сервис (у Бёрнса он называется корневым узлом) рассылает запрос всем источникам одновременно. Это Scatter, «разбросать». Каждый источник обрабатывает свою часть и возвращает частичный ответ. Сервис собирает частичные ответы и склеивает их в один результат. Это Gather, «собрать».
У Бёрнса это отдельный вид масштабирования. До него в книге разбираются два других:
репликация — несколько одинаковых копий сервиса, чтобы выдерживать больше запросов в секунду;
шардирование — данные делятся на части (шарды) и раскладываются по разным машинам, чтобы хранить больше, чем помещается на одну.
Scatter/Gather не делает ни того, ни другого. Он не увеличивает пропускную способность и не позволяет хранить больше данных. Он сокращает время ответа на конкретный запрос за счёт параллельной обработки.
На пальцах: пять запросов по 300 мс, отправленные одновременно, занимают не полторы секунды, а те же 300 мс. Общее время равно не сумме, а самому долгому из ответов.
Бёрнс объясняет ту же идею через ядра процессора: задача, которая на одном ядре считается минуту, на 30 ядрах займёт около двух секунд. Но у одной машины есть потолок, поэтому Scatter/Gather раздаёт работу уже не ядрам, а нескольким машинам.
Цена параллельности: эффект отстающего
Звучит как бесплатный обед. Но что, если один из пяти источников сегодня отвечает медленно?
Сервис не отдаст ответ, пока не дождётся всех. Значит, скорость системы равна скорости самого медленного источника. И чем больше источников, тем выше вероятность, что хотя бы один из них окажется медленным именно на этом запросе.
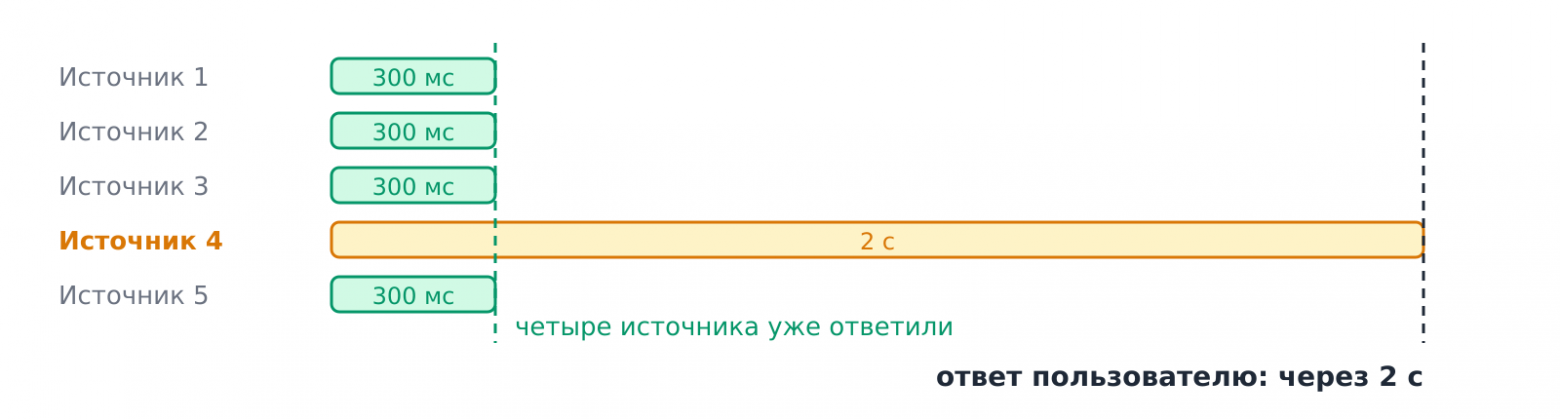
Допустим, один источник обычно отвечает быстро, но примерно в одном запросе из ста выдаёт заметно медленный ответ, скажем, две секунды. На первый взгляд терпимо: тормозит только 1 % запросов.
Теперь отправим запрос сразу в пять таких источников. Чтобы общий ответ был быстрым, должно повезти со всеми пятью одновременно. Вероятность этого — 0,99 в пятой степени, примерно 95 %. Значит, хотя бы один источник окажется медленным и затормозит весь ответ уже в 5 % случаев, а не в 1 %.
Дальше хуже. Та же оценка для разного числа источников, если каждый медленно отвечает в 1 % случаев:
Источников | Вероятность, что хотя бы один ответит медленно |
|---|---|
1 | 1 % |
5 | ≈ 5 % |
10 | ≈ 10 % |
50 | ≈ 40 % |
100 | ≈ 63 % |
При ста источниках медленными окажутся примерно два запроса из трёх, хотя каждый отдельный источник по-прежнему «тормозит только в 1 % случаев». На этой же арифметике построена известная статья инженеров Google Джеффа Дина и Луиса Баррозу «The Tail at Scale» (2013): чем на большее число узлов расходится запрос, тем чаще редкая медленная реакция одного узла становится обычным опытом пользователя.
Отсюда вывод, который Бёрнс называет одной из ключевых проблем паттерна: добавлять параллельность не всегда выгодно. Каждый новый узел — это накладные расходы на сеть, разбор запроса и сборку ответа. И чем больше узлов, тем сильнее бьёт эффект отстающего.
В какой-то момент добавление источников перестаёт ускорять систему и начинает работать против неё.
Когда данных слишком много: шардирование
Всё описанное выше — простейший вариант паттерна: источники одинаковые, и каждый может ответить на любой запрос целиком. Это ускоряет обработку, но не отвечает на второй вопрос: что делать, если данных больше, чем помещается на одну машину.
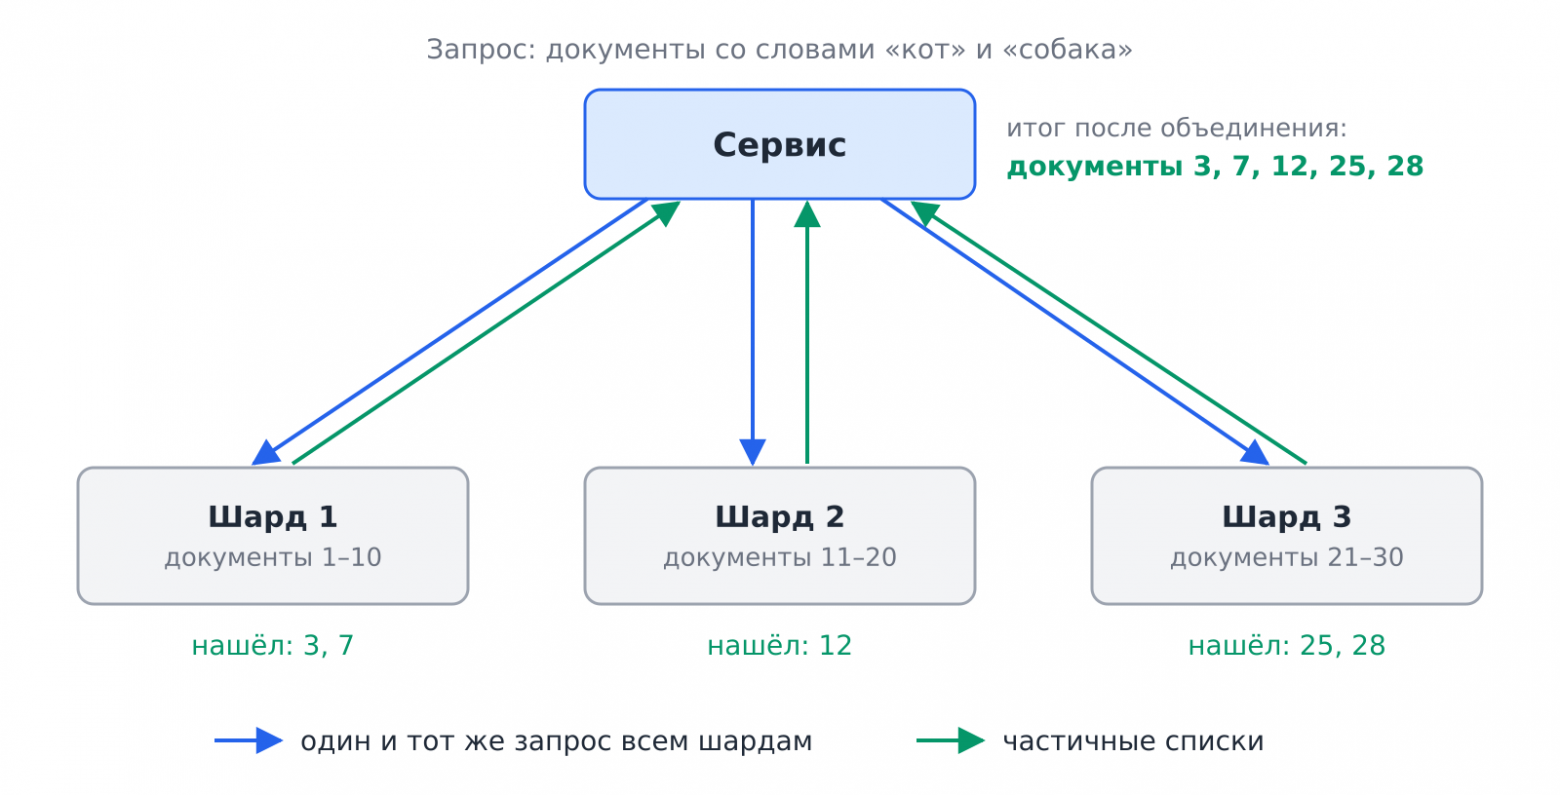
Бёрнс разбирает это на примере полнотекстового поиска: нужно найти документы, в которых одновременно встречаются два слова, например «кот» и «собака».
Наивный вариант перебрать все документы и проверить каждый, получится долго.
Логичное ускорение построить индекс: словарь, где ключ слово, а значение список документов,
в которых оно встречается. Тогда поиск по одному слову становится быстрым обращением к словарю, а поиск по двум — пересечением двух списков.
Поиск по «кот» и поиск по «собака» друг от друга не зависят. Их можно выполнить параллельно, каждый на своей машине, а пересечение списков посчитает сервис. Это тоже Scatter/Gather, только запрос делится не между одинаковыми копиями, а по словам запроса.
Теперь вопрос масштаба: что, если сам массив документов не помещается на одну машину? Тогда делить приходится данные: первая часть документов лежит на одной машине, вторая на другой и так далее. Это и есть шарды. И логика меняется: сервис отправляет один и тот же запрос всем шардам сразу. Каждый шард ищет совпадения только в своей части данных и возвращает свой список. Сервис эти списки уже не пересекает, а объединяет: каждый шард отвечает за свой кусок общего массива, и нужны все совпадения со всех шардов.
Шардирование без репликации хрупкое
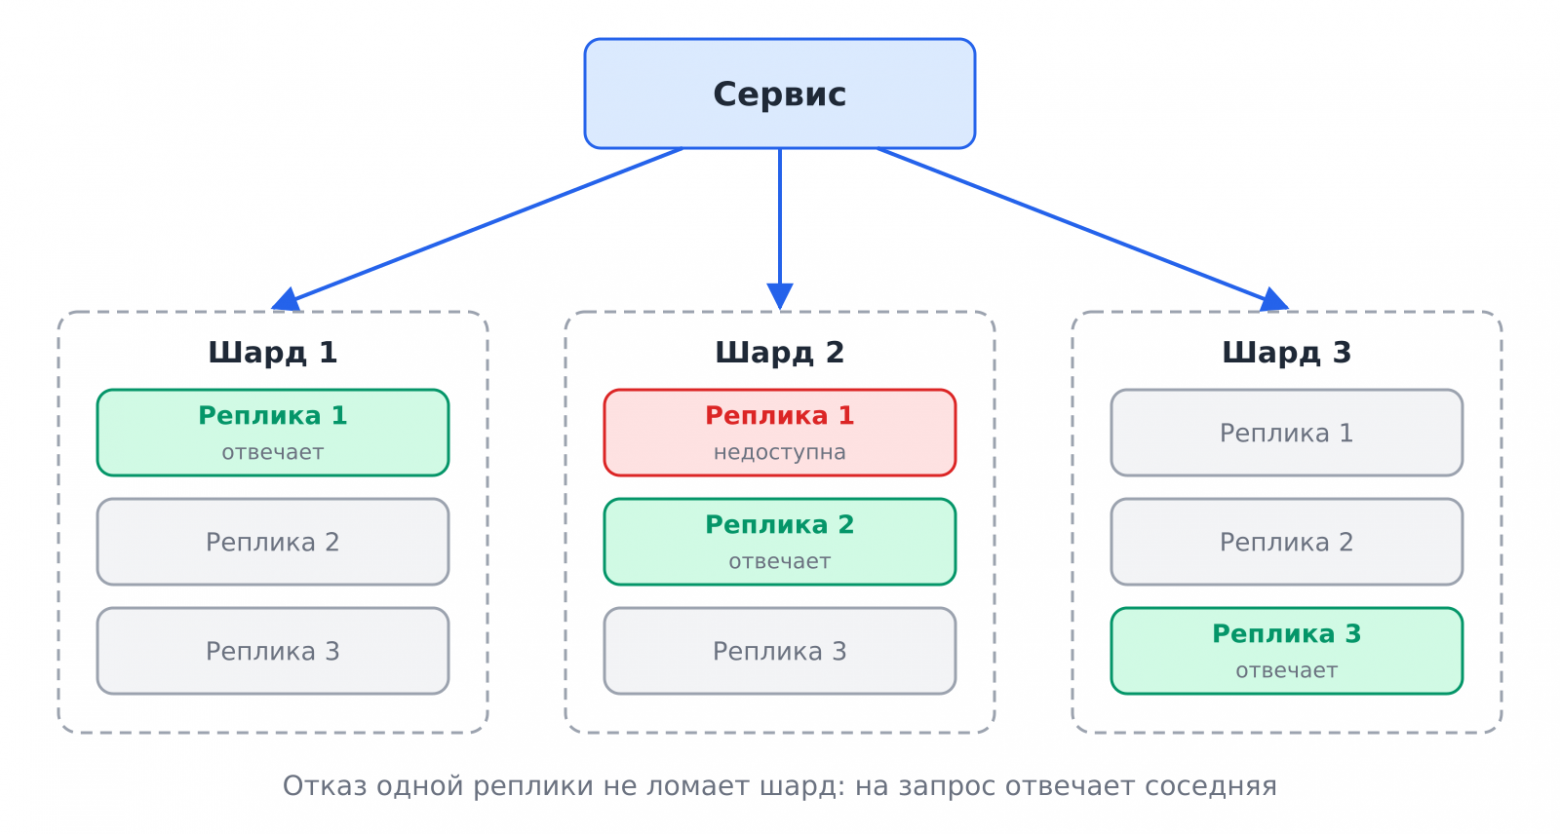
Шардирование решает проблему объёма, но создаёт проблему надёжности. Если каждый шард существует в единственном экземпляре, отказ любого из них ломает всю систему: каждый запрос должен пройти через все шарды, и без одного полного ответа не будет. По той же причине проблемой становится обновление: пока обновляется один шард, система не отвечает вообще.
Решение — завести у каждого шарда несколько копий (реплик). Шард становится не одной машиной, а группой одинаковых машин, и запросы внутри группы распределяются между исправными. Упала одна реплика — отвечают остальные. Обновлять тоже можно без простоя:
по одной реплике за раз.
Получается двухуровневая конструкция: сервис разбрасывает запрос по шардам, а внутри каждого шарда балансировщик выбирает, какая из реплик ответит.
Что делать, когда источники не твои
Против эффекта отстающего книга даёт один универсальный ответ — репликацию. Если отстал один узел, то сервис обращается к его дублёру, и система не проседает.
Это работает, когда узлы твои. Если у тебя сто миллионов документов на своих серверах — подними реплики, распредели нагрузку и перенаправляй запросы на те, что отвечают быстрее.
Но в реальных интеграциях источники очень часто чужие: это внешние системы, которые тебе не принадлежат и скорость ответа которых ты не контролируешь. Поднять вторую копию чужого API нельзя. Остаётся не решение из книги, а более приземлённая развилка.
Ждать всех до последнего. Самый простой вариант. Весь ответ упирается в самого медленного, и с ростом числа источников это становится всё болезненнее — та самая таблица с вероятностями.
Ставить таймаут и собирать то, что успело прийти. Результат может быть неполным, зато предсказуем по времени. Главное — заранее договориться, какой неполный ответ приемлем для конкретного бизнес-кейса, и дать потребителю возможность отличить частичный ответ от полного.
Заранее решать, что делать с «молчунами». Игнорировать источник, который не ответил; повторить запрос — с риском ещё сильнее нагрузить и без того перегруженную систему; или подставить значение по умолчанию вместо реального ответа.
Ни один вариант не бесплатный: в одном случае платишь скоростью, в другом полнотой данных, в третьем предсказуемостью поведения. Где-то критична полнота, и тогда приходится ждать всех. Где-то важнее уложиться во время ответа, и тогда таймаут с частичным результатом единственный разумный вариант.
Практический вывод аналитика/архитектора: эту развилку нужно проходить на этапе требований, а не на этапе инцидента. В постановке стоит явно записать:
какие источники обязательны, а без каких ответ всё ещё считается валидным;
какой таймаут на каждый источник и на запрос целиком;
как в ответе помечается, что данные неполные и какого источника не хватает;
допустимы ли повторные запросы и сколько.
Резюме
Scatter/Gather пригодится, когда нужно собрать один ответ из нескольких источников. Сервис опрашивает их все сразу, и пользователь ждёт столько, сколько отвечает самый медленный, а не сумму всех ответов. Если данных так много, что они не помещаются на одну машину, их делят на шарды, а чтобы отказ одной машины не ломал весь ответ, у каждого шарда заводят реплики.
Но за скорость приходится платить. Чем больше источников, тем чаще хотя бы один из них отвечает медленно и тормозит весь запрос. Когда источники твои, это лечится репликами. Когда чужие, остаётся выбирать: ждать всех, резать по таймауту или подставлять значение по умолчанию. И решать это лучше в требованиях, а не когда прилетит бага с прода.
А у вас бывало, что один тормозящий источник ронял весь ответ? Как выкручивались? Расскажите в комментариях, соберём варианты.
Помимо основной работы, я веду телеграм-канал о том, как на самом деле устроена работа в IT: архитектура, требования, интеграции, разборы книг и каки, знакомые и аналитикам, и разработчикам, и тестировщикам, и менеджерам. Если статья была полезной, подписывайтесь.
Комментарии 0