Зачем всё это
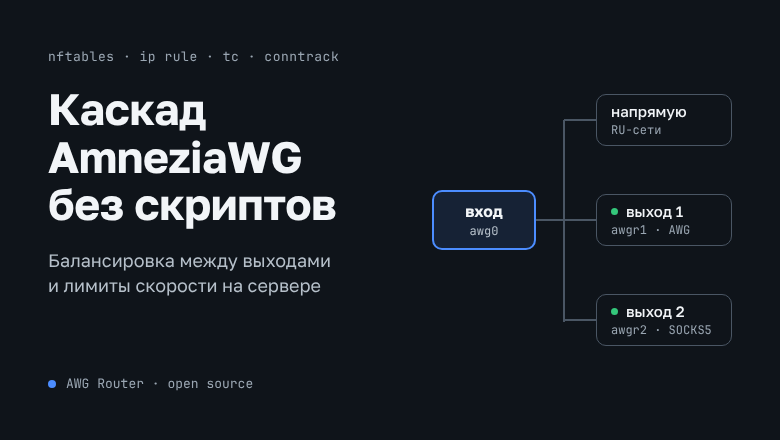
Каскадный VPN на AmneziaWG, где российские сайты открываются с российского IP, а остальное уходит через зарубежный сервер, давно перестал быть экзотикой. Кто его собирал, знает, как это выглядит изнутри: второй интерфейс, ip rule с метками, отдельная таблица маршрутизации, ipset с российскими сетями, который надо как-то обновлять, NAT, MSS clamping и пара сотен строк bash, которые страшно трогать.
Пока выход один, а клиенты — это вы и ваш телефон, такая конструкция живёт. Проблемы начинаются, когда появляются второй выход, родственники со своим маршрутом, лимиты трафика и вопрос «что будет, если зарубежный сервер упадёт». Скрипт превращается в систему, а система без интерфейса и тестов разваливается при первом же обновлении ядра.
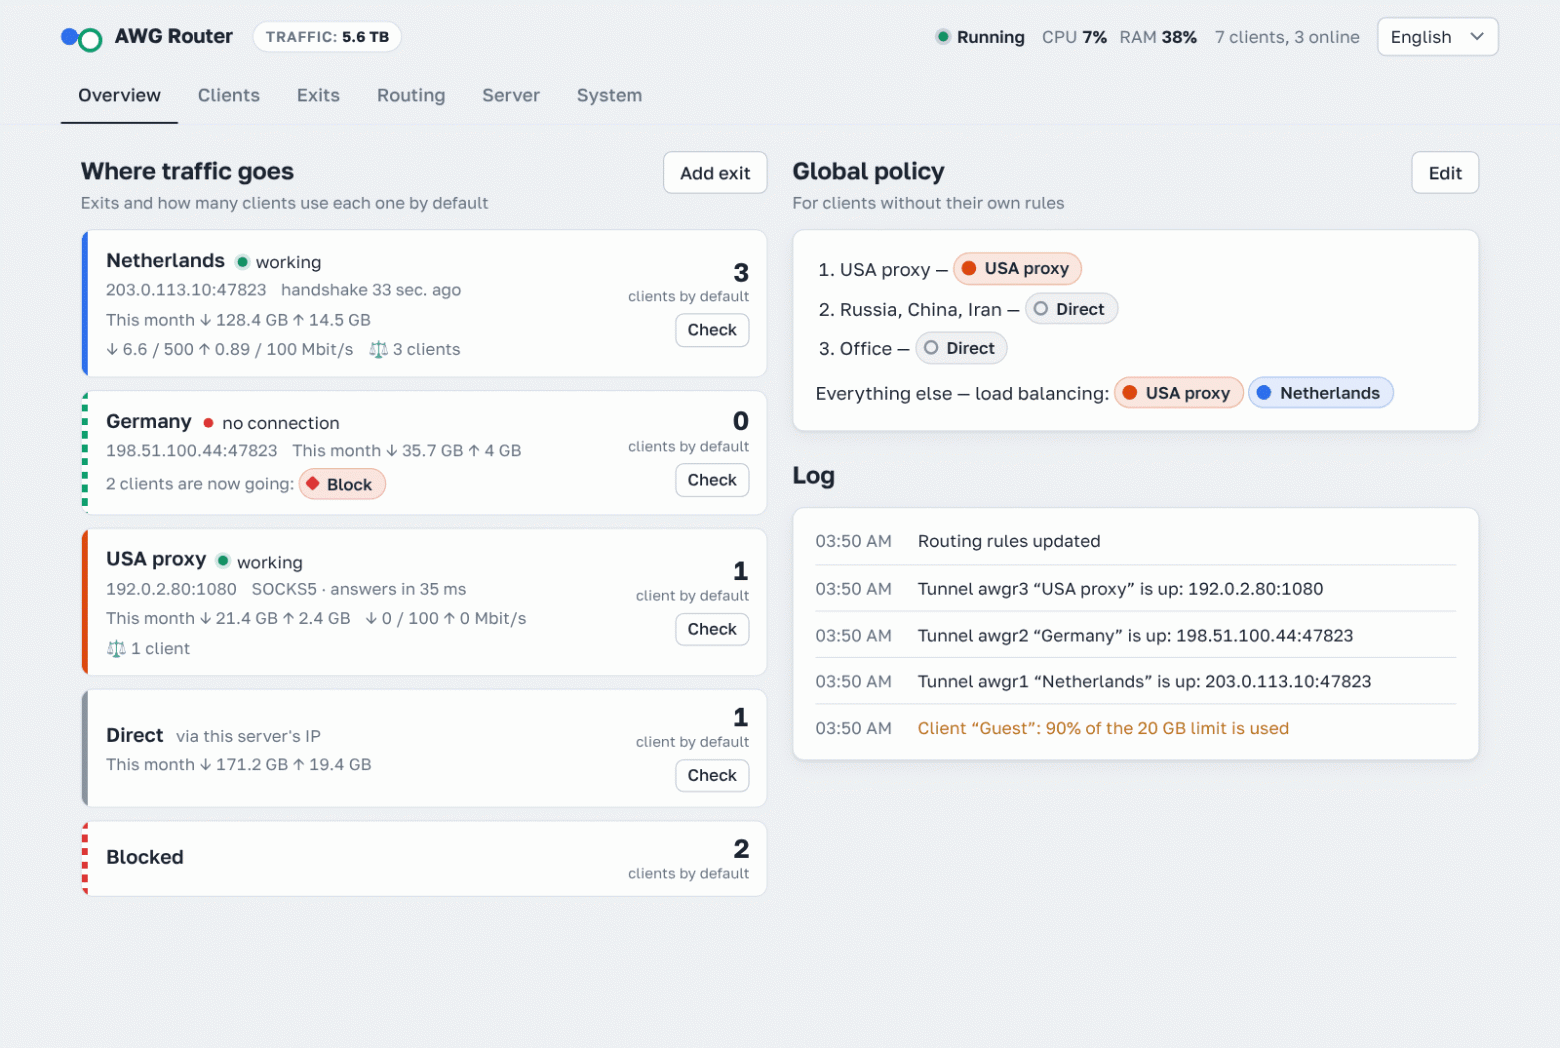
AWG Router — попытка превратить такой набор скриптов в галочки в веб-панели. Ниже я расскажу не столько про интерфейс, сколько про то, что панель делает с сетью сервера: какие правила nftables она генерирует, как устроен каскад без утечек, как балансируются выходы, как режется скорость и почему DNS в каскаде — отдельная проблема. Код открытый, лицензия MIT, все листинги ниже взяты из него.
Как устроена панель
Панель стоит на том же сервере, что и AmneziaWG, и трафик через себя не пропускает. Она раскладывает правила в ядро и следит за выходами, а пакеты маршрутизирует сам Linux. Поэтому остановка или обновление панели не рвёт VPN: клиенты продолжают работать по тем же правилам. Исключение — правила по доменам и DNS на сервере, про них ниже.
Сама панель — один процесс на Python без сторонних зависимостей, даже HTTP-сервер свой. Решение вынужденное: у панели фактически root на сервере, и чем меньше в ней чужих пакетов, тем проще её проверить и тем реже она ломается при обновлениях. Она живёт в отдельном контейнере с network_mode: host, pid: host и privileged. Сервер AmneziaWG при этом может работать либо в своём Docker-контейнере, либо на хосте службой awg-quick@awg0. В коде эти два варианта спрятаны за абстракцией Target со своими путями к конфигу и способом перезапуска. Сетевые команды панель выполняет через nsenter в сетевом пространстве сервера AWG. Так правила, туннели к выходам и очереди tc оказываются ровно там, где ходит трафик клиентов.
браузер / Telegram-бот
        │
   панель (main.py, web.py)  ──  state.json, traffic.json
        │
   engine.py  ──►  сервер AWG (контейнер или хост)
        │          выходы: туннели awgrN, SOCKS5-прокси
        ├─ nftables / ip rule / tc   (маршрутизация, учёт, скорость)
        ├─ sniproxy.py               (правила по доменам)
        └─ dnsproxy.py               (DNS на сервере)
Состояние хранится в JSON. state.json записывается с fsync, предыдущая версия остаётся рядом как .bak, и при повреждении файла панель стартует с неё. В Docker-образ кроме самой панели входят amneziawg-go, amneziawg-tools, hev-socks5-tunnel и lego для Let’s Encrypt.
Каскад и защита от утечек
Клиенты подключаются только к входному серверу, а тот решает, через какой выход отправить каждое соединение. Выход — это конфиг клиента другого сервера AmneziaWG или SOCKS5-прокси. Главное требование к каскаду — когда зарубежный сервер падает, трафик не должен молча уходить напрямую с российского адреса. Ниже — как это сделано.
               ┌── российские сайты ────────► интернет (российский IP)
телефон ──AWG──► сервер в РФ ─┤
               ├── всё остальное ──AWG──► сервер за границей ──► интернет
               └── клиент «Папа» ──AWG──► другой сервер ──► интернет
Для каждого выхода с номером N поднимается интерфейс awgrN и обычная цепочка policy routing. На пакет ставится метка 0x2000 + N, ip rule с приоритетом 20000 + N отправляет его в таблицу 2000 + N. Логика выбора выхода собрана в одной таблице nftables ip awgr, а генерирует её чистая функция nftgen.generate() без обращений к системе. Вот её вывод для простого случая: российские сети напрямую, всё остальное в выход 1, один клиент целиком в выход 2 (список сетей сокращён):
table ip awgr {
	set l_ru {
		type ipv4_addr
		flags interval
		auto-merge
		elements = { 5.3.0.0/16, 31.13.0.0/18, ... }
	}
	map clients {
		type ipv4_addr : verdict
		elements = { 10.8.1.7 : goto p_1 }
	}
	chain c_prerouting {
		type filter hook prerouting priority mangle; policy accept;
		iifname != "awg0" return
		ip daddr @local4 return
		ip saddr vmap @clients
		goto p_global
	}
	chain p_global {
		ip daddr @l_ru goto o_direct
		goto o_u1
	}
	chain p_1 {
		goto o_u2
	}
	chain o_direct { accept }
	chain o_block  { meta mark set 0xb10c accept }
	chain o_u1     { meta mark set 0x2001 accept }
	chain o_u2     { meta mark set 0x2002 accept }
	chain c_forward {
		type filter hook forward priority filter; policy accept;
		meta mark 0xb10c reject with icmp type admin-prohibited
		oifname "awgr1" tcp flags & (syn | rst) == syn tcp option maxseg size > 1240 tcp option maxseg size set 1240
		...
	}
	chain c_postrouting {
		type nat hook postrouting priority srcnat; policy accept;
		oifname "awgr1" snat to 10.66.66.2
	}
}
Личная политика клиента находится одним поиском в vmap @clients, сколько бы клиентов ни было. MSS clamping под MTU туннеля стоит в обе стороны: без него в каскаде получается классический «сайт открывается наполовину». Адрес туннеля из конфига выхода не назначается интерфейсу, а подставляется через SNAT: у второго сервера почти наверняка та же подсеть 10.8.1.0/24, что и у клиентов первого. Чтобы rp_filter не выбрасывал входящие пакеты, интерфейс получает служебный адрес 169.254.200.N/32, а rp_filter ставится в loose.
Защита от утечек — это вторая из трёх команд на выход:
ip rule add fwmark 0x2001 lookup 2001 priority 20001
ip route replace unreachable default metric 4096 table 2001
ip route replace default dev awgr1 table 2001
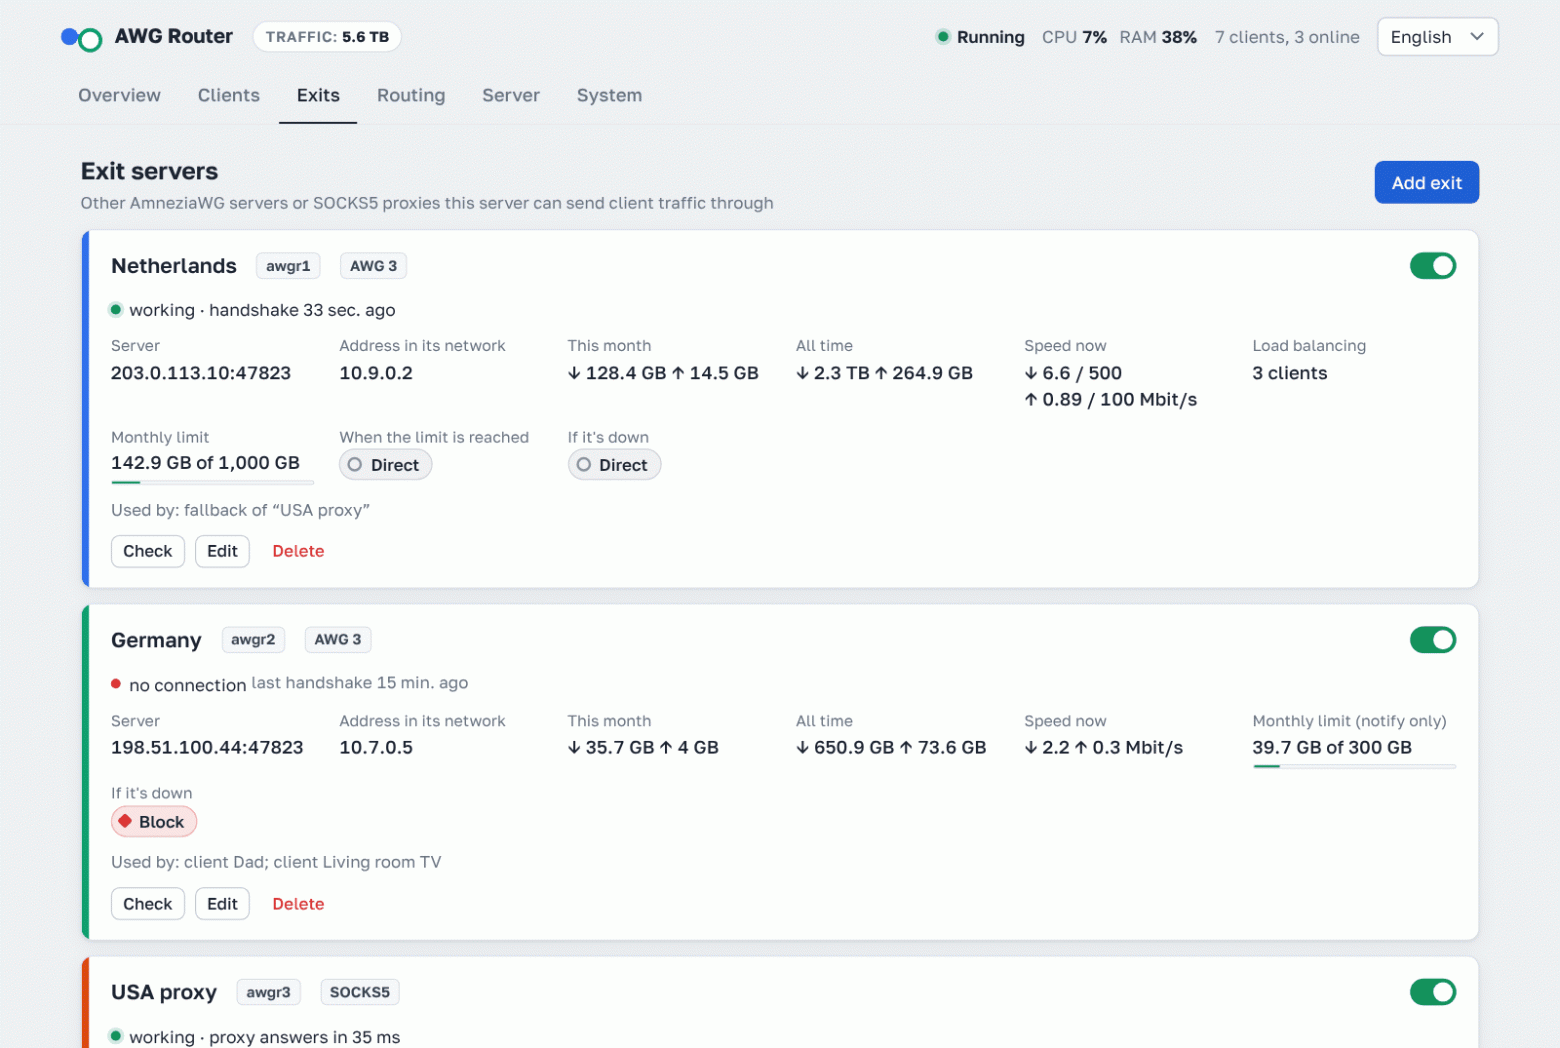
Если интерфейс awgr1 пропадёт, ядро уберёт маршрут через него, и в таблице останется только unreachable. Пакет с меткой выхода не провалится в основную таблицу и не уйдёт с адреса входного сервера, даже пока панель ещё не заметила проблему. Замечает она её по возрасту последнего рукопожатия в awg show dump: рукопожатие старше RekeyAfter + 70 секунд означает мёртвый туннель. SOCKS5-выходы проверяются настоящим запросом через прокси. После этого правила пересобираются по тому варианту, который задан у выхода на случай падения: напрямую, блокировка или другой выход. Резервные выходы можно выстраивать цепочкой.
У резервирования есть неочевидная ловушка. Два выхода на один и тот же сервер, скажем AmneziaWG и SOCKS5 поверх одного адреса, — это один путь, а не два. Если адрес заблокируют целиком, откажут оба. Резерв имеет смысл только на другом адресе, у другого хостера, в другой автономной системе.
Правила, списки и свой маршрут у каждого клиента
Маршрут задаётся упорядоченным набором правил «список → выход» и выходом по умолчанию, например «Россия → напрямую, остальное → выход 1». Деление происходит на сервере, а не на устройстве: в конфиге клиента обычный AllowedIPs = 0.0.0.0/0 и никаких списков. Поэтому схема одинаково работает на телефоне, роутере и телевизоре, а при смене правил конфиги перераздавать не нужно. У отдельного клиента может быть свой выход и свои правила вместо общих.
Каждое правило становится строкой ip daddr @список goto выход в цепочке политики, в том же порядке. Списки — множества nftables с flags interval и auto-merge, так что даже список российских сетей на десятки тысяч префиксов проверяется одним поиском по дереву интервалов. Хвостовые правила, которые ведут туда же, куда и выход по умолчанию, генератор отбрасывает. Одинаковые личные политики схлопываются в одну цепочку, а клиенты с общими настройками в карту clients вообще не попадают.
Страны берутся из ipverse: сначала фактическая регистрация сетей с субаллокациями, потом делегирование RIR и ipdeny. Автономные системы берутся из анонсов BGP через ipverse, запасной источник — RIPEstat. Есть также списки по ссылке, свои подсети и списки доменов, и все они обновляются по расписанию. На практике для конкретного сервиса точнее список по его ASN: страна по данным регистратора и страна, где физически стоит сервер, совпадают не всегда. Чтобы разбираться в длинных наборах правил, есть проверка маршрута. Она прогоняет адрес или домен через ту же логику, что и генератор, и показывает сработавшее правило с учётом тех выходов, что сейчас не работают.
SOCKS5 как выход и правила по доменам
Иногда трафик нужно вывести не через сервер в дата-центре, а через резидентный или мобильный прокси, чтобы сайт видел адрес домашнего или мобильного провайдера. Поэтому выходом может быть и SOCKS5-прокси. Для маршрутизации он ничем не отличается от туннеля AmneziaWG: те же правила, резерв и учёт трафика. Для таких выходов есть ещё правила по именам сайтов. Списки IP плохо подходят для крупных сервисов за CDN, а example.com в списке доменов означает сайт со всеми поддоменами. Понимаются простой список, форматы dnsmasq, hosts, Adblock и v2ray.
TUN-интерфейс для SOCKS5-выхода поднимает hev-socks5-tunnel. TCP идёт через прокси всегда, UDP — если прокси умеет UDP ASSOCIATE. SNAT здесь не нужен: соединения завершает сам туннель.
Правила по доменам устроены так. У клиентов с такими правилами TCP на порты 80 и 443 перенаправляется в посредник sniproxy.py в сети сервера AWG. Он читает начало соединения и достаёт имя сайта: SNI из TLS ClientHello или заголовок Host у HTTP. Если имя есть в списке, соединение открывается через SOCKS5 командой CONNECT с именем, а не адресом. Адрес находит сам прокси, поэтому подмена DNS у провайдера входного сервера не мешает. Если имени в списке нет, посредник открывает соединение к исходному адресу из SO_ORIGINAL_DST и ставит на сокет метку политики клиента через SO_MARK. Метка попадает в цепочку nftables типа route на хуке output, которая прогоняет соединение через обычные правила по адресам. Именно тип route заставляет ядро заново выбрать маршрут после смены метки.
	chain c_sniff {
		type nat hook prerouting priority dstnat; policy accept;
		iifname "awg0" meta mark 0xd000 meta l4proto tcp redirect to :10443
	}
	chain c_output {
		type route hook output priority mangle; policy accept;
		meta mark vmap { 0xd100 : goto q_p_global, 0xd101 : goto q_p_1 }
	}
После выбора пути данные в Python больше не попадают. Два сокета связываются через канал и splice() с SPLICE_F_MOVE, и байты идут внутри ядра, а цикл событий asyncio только ждёт готовности сокетов и считает байты. Это важно, потому что через посредника идёт весь HTTPS таких клиентов. QUIC (UDP 443) у них блокируется: имя сайта из него не прочитать, а браузеры в таком случае сами переходят на TCP. Если посредник не работает, перенаправление снимается целиком и остаются только правила по адресам: лучше потерять точность маршрутизации, чем интернет целиком.
Балансировка между выходами
Когда зарубежных серверов несколько, клиентов хочется распределять по ним по фактической нагрузке, а не вручную. Балансировка заменяет выход по умолчанию набором выходов: каждый клиент получает самый свободный из них. Правила по спискам и личные выходы клиентов продолжают действовать как раньше.
Наивные варианты тут не работают. Распределение по соединениям (numgen или хеш по портам) ломает сайты, которые видят одного пользователя с двух IP одновременно. Статический хеш по адресу клиента не смотрит на нагрузку: один клиент смотрит 4K, десять других читают почту. Поэтому каждый клиент закреплён за одним выходом, а за каким именно, решается по скоростям из счётчиков nftables, сглаженным экспонентой с постоянной 30 секунд. Загрузка выхода считается как доля от его ограничения скорости, если оно задано, иначе сравниваются просто мегабиты. Новый клиент или клиент упавшего выхода сразу получает самый свободный выход, а при равной загрузке решает число активных клиентов.
С переносом уже распределённых клиентов алгоритм намеренно осторожен, иначе клиенты начинают метаться между выходами. Перенос случается, только если он снизит загрузку самого загруженного выхода хотя бы на 15% и не перегрузит другой. Перекос должен держаться две минуты, а пока самый загруженный выход везёт меньше 2 Мбит/с, он вообще не считается. Переносы идут не чаще одного за три минуты, а одного клиента можно перенести не чаще раза в десять минут. Все эти числа — константы в начале balance.py.
Самое интересное — как перенести клиента и не порвать ему открытые соединения. Если просто поменять метку, следующий пакет установленного TCP-соединения уйдёт через другой сервер с другим IP, и соединение умрёт. Поэтому выход запоминается ещё и за каждым соединением в conntrack:
	chain ob_u1 {
		ct mark { 0x2001, 0x2002 } meta mark set ct mark accept
		meta mark set 0x2001 ct mark set 0x2001 accept
	}
Первый пакет соединения записывает метку выхода в ct mark, следующие берут её оттуда, пока выход жив и входит в балансировку. После переноса новые соединения идут через новый выход, старые доживают на прежнем. У упавшего выхода метка пропадает из множества живых, и его соединения сразу получают новую.
Ограничение скорости
Когда один VPN на всю семью или небольшую команду, рано или поздно кто-то запускает торрент, и у остальных всё встаёт. Ограничение бывает трёх видов: общее на всех клиентов, личное для одного клиента и отдельное для выхода, загрузка и отдача задаются по отдельности. Общий предел делится между теми, кто сейчас качает: один человек забирает всё, двое получают пополам. Соединения не рвутся, а задержка под нагрузкой не растёт. Пока ничего не задано, tc вообще не вызывается.
Клиенты ограничиваются на интерфейсе awg0: через него проходит весь трафик клиента, куда бы он дальше ни шёл. Загрузка к клиенту — это исходящая очередь awg0. С отдачей сложнее: у входящего трафика в Linux нет нормальной очереди, только policer, который просто выбрасывает пакеты. Поэтому входящий трафик перенаправляется на виртуальное устройство ifb и обрабатывается там обычной исходящей очередью. После ifb пакет возвращается в сеть так, будто пришёл на исходный интерфейс, и nftables, учёт и маршруты ничего не замечают. Выходы ограничиваются так же, на своих awgrN и awgqN. Вот что строит планировщик shaping.plan() для общего предела в 100 Мбит/с на загрузку и личного предела в 20 Мбит/с у одного из двух клиентов:
qdisc add dev awg0 root handle 7a77: htb default 2
class add dev awg0 parent 7a77: classid 7a77:1 htb rate 100000kbit ceil 100000kbit ...
class add dev awg0 parent 7a77:1 classid 7a77:2 htb rate 33333kbit ceil 100000kbit ...
qdisc add dev awg0 parent 7a77:2 fq_codel
filter add dev awg0 parent 7a77: protocol ip prio 10 handle 2: u32 divisor 256
filter add dev awg0 parent 7a77: protocol ip prio 10 u32 ht 800:: match u32 0 0 hashkey mask 0x000000ff at 16 link 2:
class add dev awg0 parent 7a77:1 classid 7a77:100 htb rate 20000kbit ceil 20000kbit ...
qdisc add dev awg0 parent 7a77:100 fq_codel
filter add dev awg0 parent 7a77: protocol ip prio 10 u32 ht 2:2: match ip dst 10.8.1.2/32 flowid 7a77:100
class add dev awg0 parent 7a77:1 classid 7a77:101 htb rate 33333kbit ceil 100000kbit ...
qdisc add dev awg0 parent 7a77:101 fq_codel
filter add dev awg0 parent 7a77: protocol ip prio 10 u32 ht 2:3: match ip dst 10.8.1.3/32 flowid 7a77:101
У каждого клиента свой класс HTB с равной гарантированной долей (rate) и потолком во весь канал (ceil), отсюда и деление между активными. Класс выбирает фильтр u32 с хеш-таблицей по последнему байту адреса, поэтому поиск не замедляется с ростом числа клиентов. В листьях стоит fq_codel, он и держит задержку. Две мелочи, которые легко упустить. burst класса не меньше 64 КБ: туннели работают с GSO, пакеты до сегментации бывают до 64 КБ, и с «учебниковым» burst класс не добирает до своей скорости. А все корневые очереди панели имеют свой номер 7a77:, чтобы не трогать чужие очереди на тех же интерфейсах.
Отдельный случай — SOCKS5-выход с правилами по доменам. Соединения, открытые посредником через CONNECT, идут к прокси мимо туннеля, и очередь tc их не видит. Их ограничивает бак токенов внутри самого посредника. Раз в секунду он смотрит, сколько идёт через туннель и через него самого, делит общий предел между двумя дорогами и выставляет долю туннеля через tc class change, не пересоздавая очередь.
Параметры AmneziaWG и маскировка I1–I5
На очень большом числе серверов стоит один и тот же I1 по умолчанию. Он изображает DNS-ответ про icloud.com, но icloud.com в нём указывает на адрес Яндекса, а не Apple. Настоящий DNS такого ответа не даст, то есть пакет неестественный. К тому же он почти целиком одинаковый у всех: случайны в нём только два байта. Маскировка, которую огромное число серверов повторяют байт в байт, сама превращается в потенциальную сигнатуру, по которой DPI может узнать VPN одной строкой. Панель находит такой I1 и заменяет его на ответ с настоящим адресом Apple и случайными полями.
Помимо этого есть несколько шаблонов, каждый из которых повторяет настоящий протокол по RFC. STUN Binding Request выглядит как проверка ICE в WebRTC. QUIC Initial сделан ровно в 1200 байт: по стандарту он не может быть короче, и короткий пакет сразу выдал бы подделку. Дальше идут DNS-запрос с EDNS0 и дополнением до 128 байт, SIP INVITE и тот самый DNS-ответ про icloud.com с адресом из сети Apple 17.0.0.0/8. Изменчивые поля — ID транзакций, имена, номера, ключи — везде случайные. Вот генератор для QUIC:
def _quic() -> str:
    # RFC 9000, Initial: long header, версия 1, DCID 8 байт, SCID 0 (как у Chrome),
    # токен 0, длина остатка (varint 2 байта) = 1182.
    # Дальше номер пакета и зашифрованные данные — на проводе это случайные байты.
    rest = 1200 - 18
    return (_b(bytes.fromhex("c300000001") + b"\x08") + "<r 8>"
            + _b(b"\x00\x00" + (0x4000 | rest).to_bytes(2, "big")) + f"<r {rest}>")
Пакет собирается из тегов: <b 0xHEX> — фиксированные байты, <r N> — случайные, <rc N> — случайные буквы, <rd N> — случайные цифры, <t> — время. Есть и другие теги, но их понимает только одна реализация: <c> есть лишь в модуле ядра, <d>, <ds> и <dz> — лишь в amneziawg-go. С чужим тегом сторона не запустится, поэтому валидатор принимает только переносимые теги и не пускает пакеты больше 1400 байт, чтобы они не фрагментировались. I1–I5 задаются и отдельному клиенту: если у кого-то провайдер начал резать один вариант, ему можно выдать другой, не трогая остальных.
Остальные параметры версии 3.1 тоже доступны: Jc/Jmin/Jmax, S1–S4, H1–H4, HeaderProtectionKey, ContentPaddingAddition, тайминги AWG 3, RandomTrailers и DisableCookies. Добавление и удаление клиентов применяются через awg syncconf без разрыва остальных, а порт, S1–S4, H1–H4 и ключ защиты заголовков требуют перезапуска интерфейса. Если syncconf упал, файлы сервера возвращаются в прежнее состояние, чтобы конфиг на диске всегда совпадал с тем, что загружено в интерфейс.
Модуль ядра или amneziawg-go
AmneziaWG работает либо модулем ядра Linux, либо программой amneziawg-go в пользовательском пространстве. Модуль быстрее и расходует в разы меньше процессора, что особенно заметно в каскаде: там каждый пакет шифруется на входном сервере дважды. amneziawg-go зато работает везде, в том числе на OpenVZ и LXC, где свой модуль ядра не загрузишь. Панель поддерживает оба варианта, и большая часть кода здесь не про установку модуля, а про то, чтобы проблема с ним не оставляла сервер без связи.
Модуль ставится на Ubuntu 22.04+ или Debian 12+, x86_64 или aarch64, через DKMS из PPA с проверкой ключа по полному отпечатку и пересобирается при обновлении ядра. Модуль старше 3.x удаляется: с конфигом AWG 3.1 он всё равно не поднимет сервер. Туннели к выходам идут на том же движке, что и сервер. Дальше начинается откат. Модуль не собрался — сервер остаётся на amneziawg-go. После обновления ядра модуль не загрузился — awg-quick сам поднимет сервер на Go, и панель сообщит об этом. Сложнее всего, когда модуль загружен, но сервер на нём не поднимается: awg-quick переходит на Go, только если модуля нет вовсе. Поэтому после двух неудачных перезапусков панель блокирует и выгружает модуль и поднимает сервер на Go. Если модуль не принял конфиг туннеля к выходу, тот же конфиг пробуется в amneziawg-go. Принял — дело в модуле, и выходы живут на Go до перезапуска сервера. Не принял — ошибка в самом конфиге.
Есть страховка и для amneziawg-go. На слабом VPS при нехватке памяти OOM killer может выбрать именно его, и тогда контейнер работает, а интерфейса уже нет. Панель замечает это и перезапускает сервер с растущими паузами. Установка модуля ещё включает kernel.panic = 10, если своё значение не задано: при сбое в ядре сервер перезагрузится сам, а не зависнет.
DNS в каскаде
Крупные сайты и CDN отвечают на DNS-запрос по-разному в зависимости от того, откуда он пришёл, и выдают ближайший узел. В каскаде это даёт неприятный эффект. Если резолвер на входном сервере спрашивает интернет прямо оттуда, он получает узел для России, а трафик потом уходит через выход в другой стране и делает крюк. На практике это медленное видео и сервисы с проверкой региона, которые непонятно почему отказывают. Решение — задавать DNS-запрос тем же путём, каким пойдёт трафик клиента.
Для этого на адресе сервера в туннеле, например 10.8.1.1, работает небольшой пересылающий dnsproxy.py. Рекурсией он не занимается, а пересылает запрос внешним серверам из настроек. Сокет запроса получает через SO_MARK метку основного выхода клиента, и запрос уходит через туннель выхода. Клиент, который ходит напрямую, получает ответ прямо с входного сервера, и для него это правильно. Кэш раздельный для каждого пути, потому что ответ CDN для Финляндии и для России — разные ответы.
По умолчанию запросы идут через DoH: он выглядит как обычный HTTPS и его труднее всего заблокировать. Можно выбрать DoT или открытый DNS. Сертификат сервера проверяется, TLS-соединения держатся в пуле на пару «путь, сервер». Если зашифрованный канал недоступен, открытый DNS вместо него не используется: клиент получает SERVFAIL и спрашивает второй DNS из своего конфига. Тихий откат на незащищённый канал сводил бы шифрование на нет.
У подхода есть ограничение. Имена разрешаются через основной выход клиента, и правила по адресам вроде «российские сети напрямую» на DNS не влияют: в момент запроса ещё неизвестно, в какую сеть имя разрешится. Для сайта на CDN это может означать зарубежный узел. DNS на сервере выключен по умолчанию и имеет смысл, когда у большинства клиентов основной путь идёт через выход.
Безопасность
Панель фактически даёт root-доступ к серверу, и решения вокруг входа исходят из этого. В адресе панели случайный порт и секретный путь, пароль длинный и случайный, после 8 неверных попыток адрес блокируется на 10 минут. Есть второй фактор TOTP, а самый закрытый вариант — убрать панель из интернета и ходить только через SSH-туннель. Закрытые ключи выходов и клиентов лежат в файле с правами 600, а резервная копия, в которой те же ключи, шифруется паролем.
Для HTTPS панель получает сертификат Let’s Encrypt через lego, в том числе на голый IP-адрес без домена. На IP Let’s Encrypt выдаёт только шестидневные сертификаты (профиль shortlived), поэтому он продлевается примерно раз в три дня без перезапуска. Если порт 80 занят nginx или Apache, туда с согласия администратора добавляется маленький конфиг только для /.well-known/acme-challenge/. Перед перезагрузкой он проверяется через nginx -t, а при любой ошибке удаляется. Образы и архив релиза собирает GitHub Actions с подписанной аттестацией сборки и SBOM, проверяются они командой gh attestation verify. Самообновление ставит только опубликованную версию и сверяет контрольную сумму архива.
Если сервер AmneziaWG уже стоит
Часто на VPS уже работает AmneziaWG, установленный из приложения AmneziaVPN в контейнер amnezia-awg2, и к нему подключены люди, которым не хочется раздавать новые конфиги. Поэтому панель умеет работать с таким контейнером как есть: ключи, порт и клиенты остаются прежними, а маршрутизация добавляется поверх уже работающего сервера. Если сервера нет, установщик ставит его сам со случайным UDP-портом, в контейнер или на хост.
В этом режиме конфиг пишется в формате приложения: общий PSK, таблица clientsTable с именами клиентов, I1–I5 в комментариях. Клиенты, созданные в панели, видны в приложении, и наоборот. Конфиг клиента, созданного не в панели, показать нельзя, потому что закрытый ключ есть только на устройстве, но маршрутизация и ограничения на него действуют так же. Отключённый клиент остаётся в конфиге закомментированным блоком, чтобы его адрес никто не занял. Есть и ограничения. Порт и подсеть такого контейнера зашиты в его скрипт запуска и из панели не меняются. Если поменять S1–S4 или H1–H4, приложение узнает об этом только после повторной проверки сервера.
Команда awg-router reconfigure переносит сервер из контейнера на хост службой awg-quick@awg0 с теми же ключами, портом, параметрами маскировки и клиентами. Перенос идёт в два шага с проверкой между ними. Если на хосте сервер не поднялся, перенос откатывается и старый контейнер запускается снова. На хосте NAT и правила пересылки добавляются через PostUp, так что VPN работает и при остановленной панели.
Как это тестируется
Код, который меняет сеть живого сервера, страшно выпускать без проверки на настоящей сети, поэтому тестов два слоя. Первый — модульные тесты без root на генераторы конфигов, правил nftables, команд tc и алгоритм балансировки. Для этого все генераторы и сделаны чистыми функциями.
Второй слой — сетевые сквозные тесты на машине GitHub Actions. Они строят топологию из сетевых пространств (netns): клиент, входной сервер, выходы и «интернет», с настоящими nftables, туннелями AmneziaWG, hev-socks5-tunnel и tc. Проверяется, что клиент по правилам уходит в нужный выход или напрямую. Что .conf и vpn:// действительно подключаются, а отключённый клиент — нет. Что правила по доменам идут через SOCKS5, ограничение скорости держится, а открытое соединение при переносе клиента остаётся на прежнем выходе. Отдельное задание ставит модуль ядра той же командой, что и у пользователей, и гоняет туннель на нём вперемешку с amneziawg-go, есть и тест переноса сервера из контейнера на хост. Бинарники для тестов собираются из тех же стадий Dockerfile, что попадут в образ, и всё это идёт на каждом пуше в main. Для работы над интерфейсом есть демо-режим без сервера:
DRY_RUN=1 PANEL_PASSWORD=demo DATA_DIR=./demo python3 -m app.main
Чего панель не умеет
В туннеле сейчас только IPv4. Подключаться к серверу можно и по IPv4, и по IPv6, но адреса клиентов и маршрутизация — только v4.
Правила по доменам работают только для SOCKS5-выходов и видят только обычные сайты (HTTP и HTTPS на портах 80 и 443). Сайт, который прячет своё имя через Encrypted Client Hello, они не узнают, и такое соединение пойдёт по правилам адресов. Если сервер AmneziaWG стоит прямо на хосте, а файрвол настроен только через nftables (например, firewalld), порт посредника придётся открыть вручную. Для iptables и ufw панель делает это сама.
Списки стран построены по данным регистраторов и не всегда совпадают с тем, где физически стоит сервис. Для конкретного сервиса точнее список сетей его компании (ASN). Для ограничения отдачи нужен модуль ядра ifb. Установщик ставит его сам, а если для вашего ядра такого пакета нет, работают все остальные ограничения, кроме этого. И последнее: в резервной копии лежат закрытые ключи сервера и всех клиентов. Её стоит шифровать паролем, особенно если бот присылает её в Telegram.
Установка и итог
Нужен сервер на Ubuntu или Debian. Установка идёт от root, Docker ставится, если его нет:
curl -fsSL https://raw.githubusercontent.com/r-slashslash/AWG-Router/main/install.sh | bash
Установщик спрашивает, чем управлять (найденным сервером или новым), какой движок ставить и как заходить в панель, и в конце показывает ссылку и пароль. awg-router uninstall удаляет панель и её правила, а сервер AmneziaWG по умолчанию оставляет работать.
Каскадный VPN давно собирается из стандартных деталей Linux: fwmark, отдельных таблиц маршрутизации, множеств nftables, conntrack и HTB. Сложность не в самих деталях, а в том, чтобы собрать их без утечек, пережить падение выхода, не рвать соединения при переносе и не сломать всё при обновлении ядра. Код открыт под MIT, и заметная часть описанного выше появилась из иссуев и пул-реквестов людей, которые гоняли панель на своих серверах. Если вы собирали похожую схему руками и решали какую-то из этих задач иначе, буду рад услышать в комментариях.
Репозиторий: github.com/r-slashslash/AWG-Router
Комментарии 0