Запись, у которой два адресата
Я написал transactional outbox для двух своих коммерческих проектов. Подходящих готовых решений на момент написания не было, а CDC на основе лога с Debezium показался слишком тяжёлым для простого требования: сохранить событие вместе с данными и отправить его позже.
Само требование появляется потому, что сервис, который меняет базу и затем публикует сообщение, пишет в две системы, а транзакция базы данных покрывает только одну из них. Если процесс умирает между коммитом и публикацией, данные изменились, а никто об этом не узнал. Поменяйте порядок местами — и сообщение уйдёт об изменении, которого не случилось.
Паттерн outbox закрывает эту дыру тем, что делает событие частью транзакции. Вместо того чтобы публиковать прямо в брокер, сервис записывает событие в таблицу рядом с бизнесданными, а доставляет его отдельный шаг, позже.
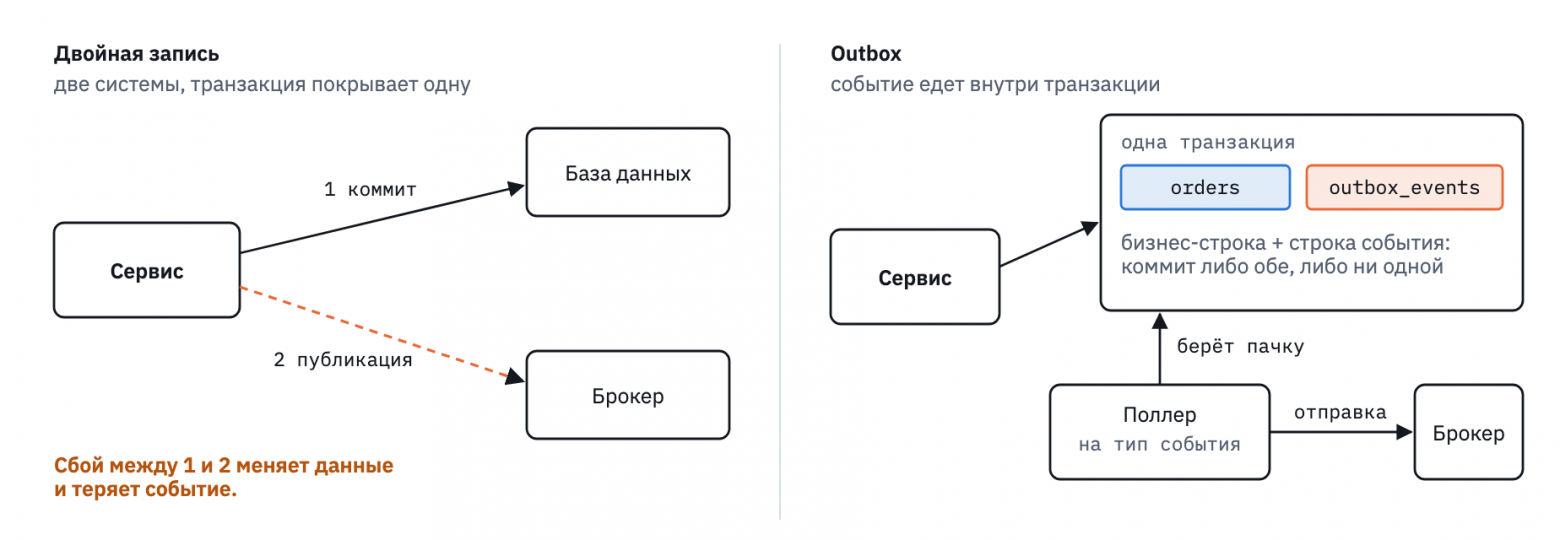
В варианте с outbox событие — это строка, закоммиченная вместе с бизнес‑данными. Публикация становится отдельным шагом с повторами, который не может потерять событие, потому что оно уже надёжно сохранено.
Outbox: одна транзакция, две строки
Публикация делается одним из двух вызовов. Ручной принимает тип события и полезную нагрузку (или список нагрузок для пачки). Декларативный — это аннотация на методе, который уже открыл транзакцию:
@Transactional
@OutboxPublish(eventType = "create-example-event")
public ExampleDto save(ExampleCreateDto dto) {
    ExampleEntity entity = repository.save(mapper.toEntity(dto));
    return mapper.toDto(entity);
}
Оба варианта пишут в outbox_events через методы с @Transactional(propagation = MANDATORY). Библиотека сама транзакцию никогда не открывает. Она присоединяется к вашей, и в этом вся гарантия: строка события коммитится или откатывается вместе с бизнесстрокой. С аннотацией полезной нагрузкой по умолчанию становится результат метода (#result), а SpEL‑выражением можно указать на параметр.
Каждое событие получает UUIDv7 в качестве id. Упорядоченные по времени id заставляют вставки попадать в хвост индекса первичного ключа, а не разбрасываться по нему — для таблицы, в которую пишется строка на каждое событие, это важно. Тот же id едет в заголовке oncebox_event_id и позже становится ключом дедупликации на стороне потребителя.
Попав в таблицу, строка проходит через небольшой набор состояний. Продвигают её четыре фоновые задачи; кто за что отвечает, показано на схеме.
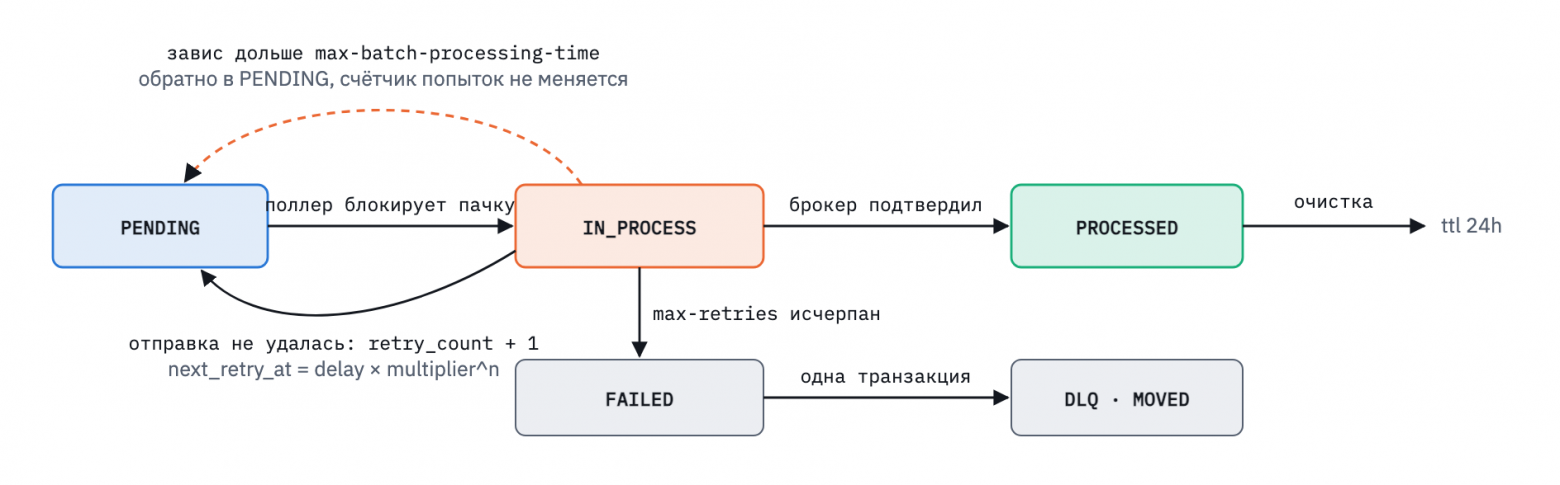
Поллер двигает события вперёд, восстановление зависших событий спасает пачку, чей публикатор умер, перенос в DLQ переносит исчерпавшие попытки события одной транзакцией (заблокировать, вставить в целевую таблицу, удалить из исходной, закоммитить), а очистка удаляет обработанные строки.
Состояние IN_PROCESS — причина, по которой упавший публикатор не теряет события. Поллер помечает пачку в момент, когда блокирует её. Если инстанс умирает до подтверждения брокера, эти строки остаются в IN_PROCESS. Воркер восстановления находит строки, которые пролежали там дольше max-batch-processing-time, и возвращает их в PENDING, не засчитывая неудачную попытку: у события не было шанса провалиться.
Доставка на этой стороне — at‑least‑once. Поллер дожидается подтверждения брокера, прежде чем пометить событие обработанным, поэтому потерянное подтверждение означает вторую отправку, но никогда не пропажу. Убирать этот дубликат — задача inbox, о нём дальше в статье.
Поллинг: как события покидают таблицу
Каждый тип события опрашивается по собственному расписанию. Управляемый библиотекой пул потоков запускает по одному поллеру на тип рядом с несколькими фоновыми задачами: восстановлением зависших событий и очисткой, а при включённом DLQ — ещё тремя. Правило размера пула: 2 + n потоков без DLQ и 5 + n с ним, где n — число типов событий.
Несколько инстансов приложения могут опрашивать одну таблицу одновременно. Запрос, забирающий пачку, использует FOR UPDATE SKIP LOCKED (на PostgreSQL — внутри CTE, который в том же выражении переводит строки в IN_PROCESS), так что каждый инстанс блокирует свой кусок ожидающих строк и не стоит в очереди за соседом.
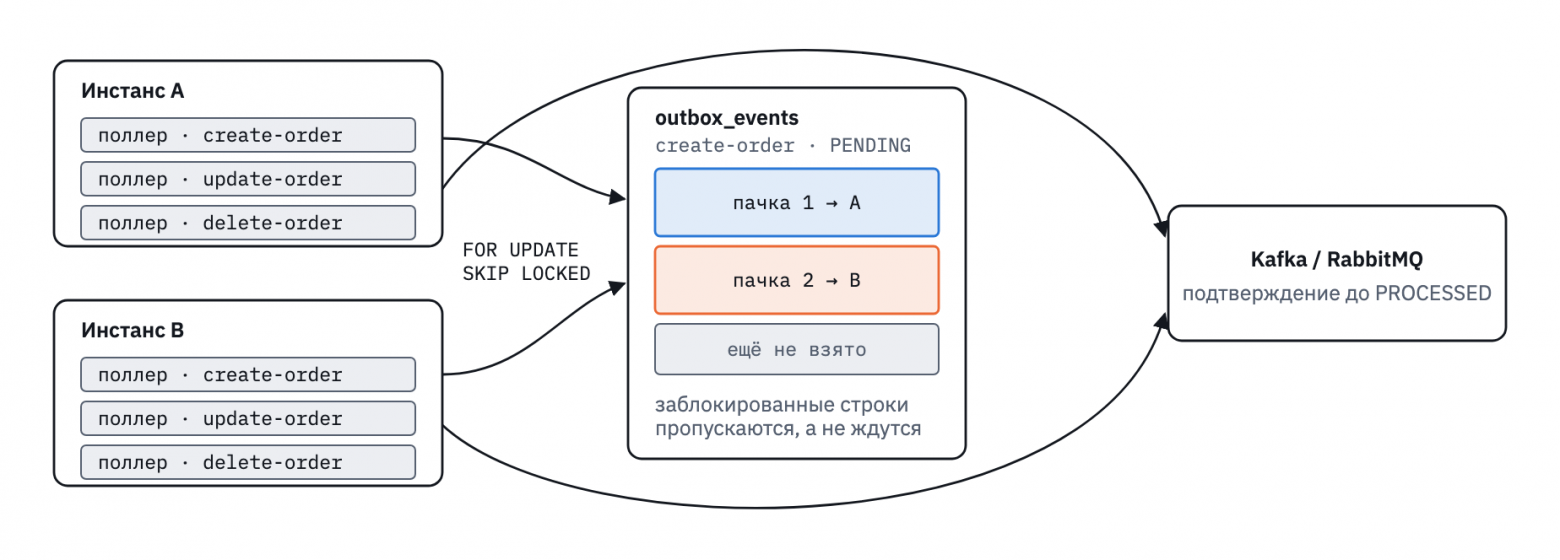
Инстансы не выбирают лидера и не общаются друг с другом. Единственная координация — блокировки строк в базе данных, и они раздают непересекающиеся пачки. Внутри типа события упорядочены по next_retry_at, а это время создания — до первой неудачи.
Замечание про MySQL. Запускайте источник данных outbox на уровне изоляции
READ COMMITTED. При уровне InnoDB по умолчанию,REPEATABLE READ, запрос поллинга берёт next‑key‑блокировки (gap locks), и несколько инстансов, опрашивающих одну таблицу, попадают в дедлок вместо того, чтобы каждый забрал свою пачку. PostgreSQL и Oracle это не затрагивает.
Остаётся один вопрос, и именно он определяет, как библиотека ведёт себя в продакшене: как часто каждому поллеру спрашивать базу, есть ли что отправлять?
Адаптивный поллинг
Фиксированная задержка вынуждает идти на компромисс. Короткая быстро выпускает события и при этом круглосуточно опрашивает пустую таблицу. Длинная дёшева, но каждому событию приходится ждать. Большую часть времени у большинства outbox'ов нечего отправлять, поэтому за короткую задержку в основном платят пустыми ответами.
Адаптивная стратегия снимает этот компромисс: задержка следует за нагрузкой. После каждого опроса поллер выставляет задержку до следующего по одному правилу:
Опрос вернул полную пачку (столько событий, сколько
batch-size): вероятно, ждут ещё, поэтому задержка сбрасывается кmin-fixed-delay.Опрос вернул неполную пачку или ничего: очередь разобрана, поэтому задержка умножается на
multiplier— вплоть доmax-fixed-delay.
С настройками по умолчанию (минимум 250ms, множитель 1.5, максимум 1m) подряд идущие пустые опросы растягивают задержку так:
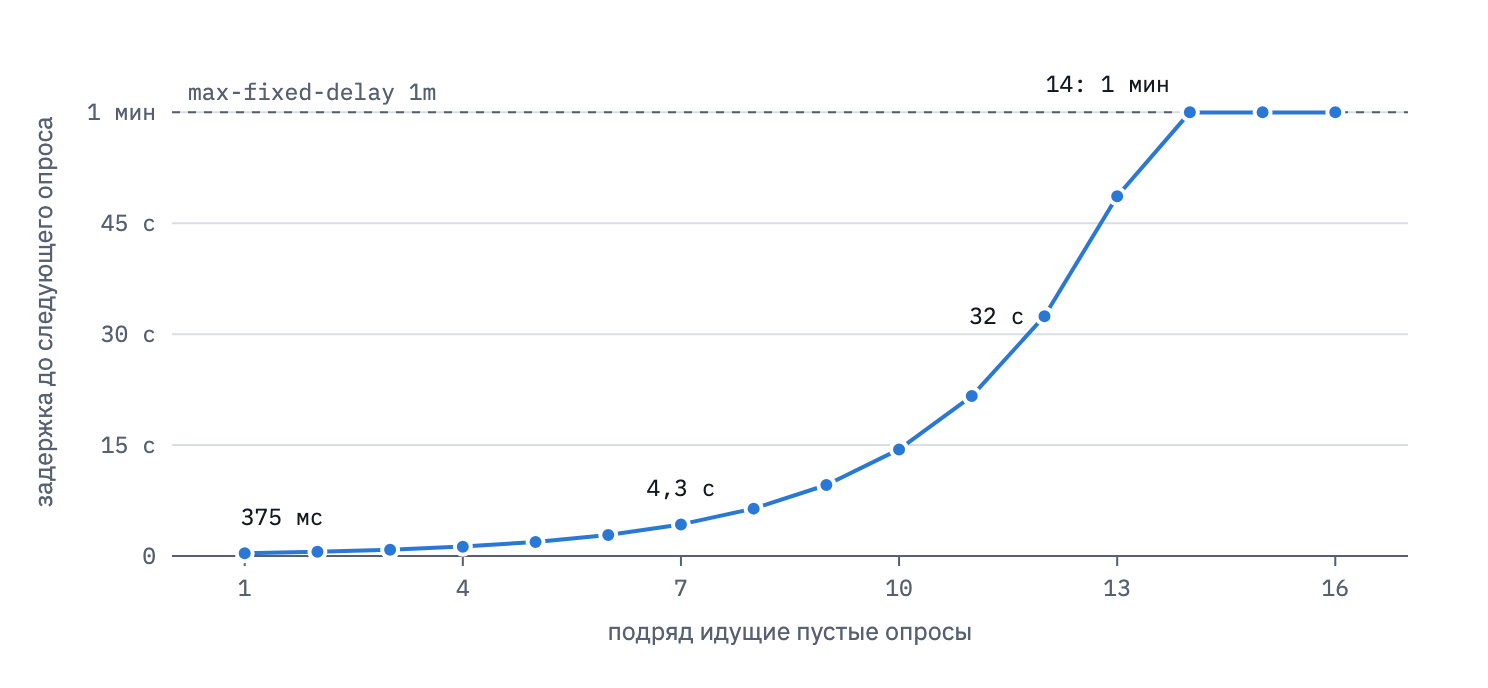
Чтобы понять, чего это стоит, посчитаем опросы одного типа события по простаивающей таблице за час на одном инстансе по тому же правилу:
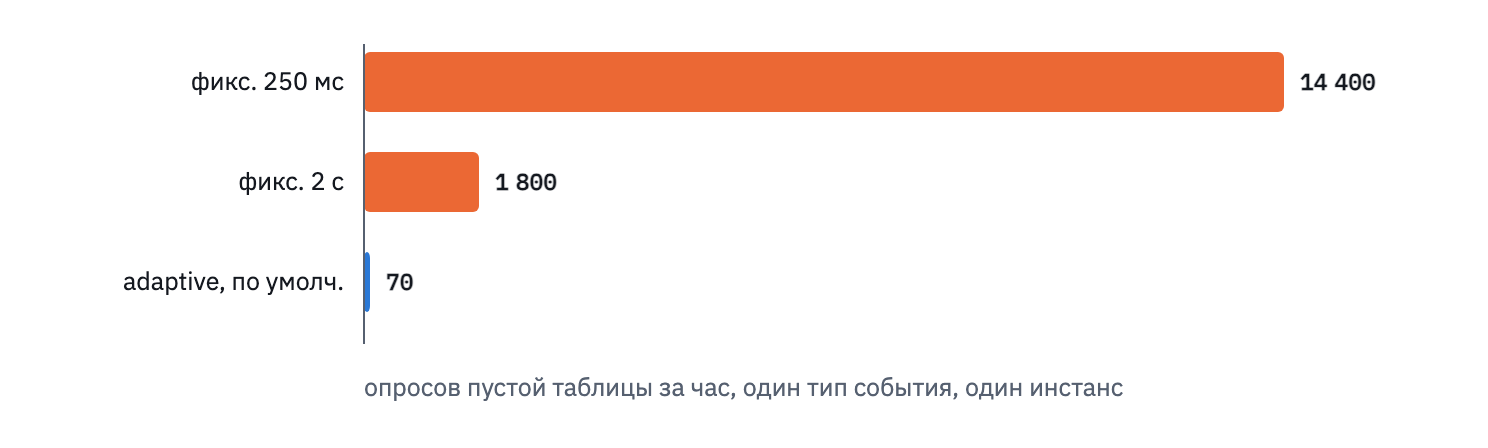
Фиксированная задержка 250 мс обращается к базе 14 400 раз; adaptive с настройками по умолчанию — около 70 раз, считая и разгон. Тот же заданный минимум, примерно в 200 раз меньше пустых ответов.
Именно правило сброса делает это безопасным под нагрузкой. Всплеск заполняет пачки целиком, каждая полная пачка возвращает задержку к минимуму, и поллер разбирает очередь с самым быстрым темпом, который настроен для типа. Как только опрос возвращает неполную пачку, поллер снова начинает замедляться.
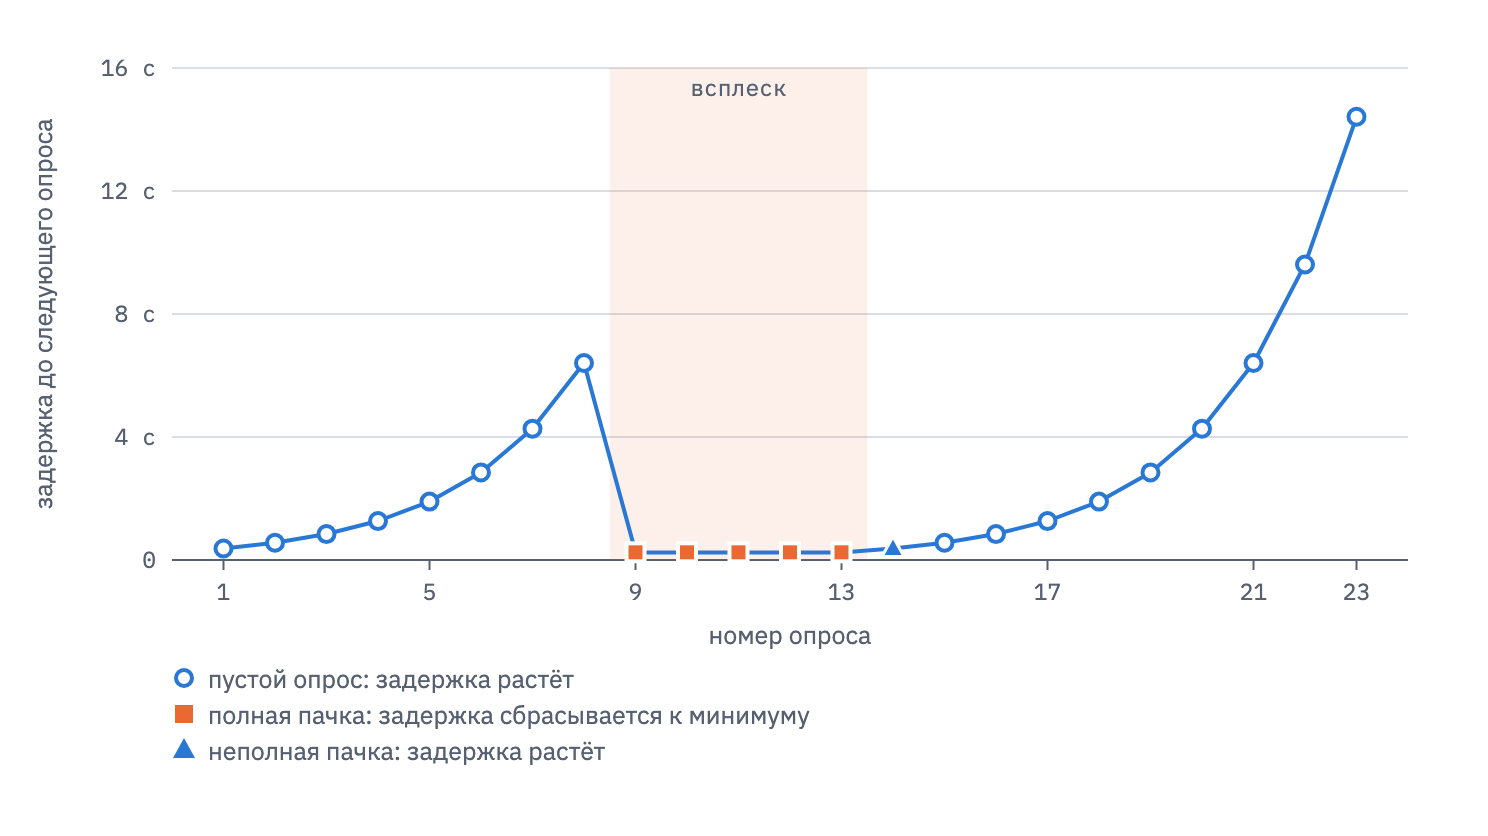
Восемь пустых опросов, всплеск из пяти полных пачек, одна неполная, затем снова простой. Как мне кажеться достаточно илюстративныый пример.
Потолок задержки заодно служит бюджетом латентности. Событие, которое появилось сразу после опроса, ждёт не дольше одной текущей задержки, так что max-fixed-delay — это самое долгое ожидание, на которое простаивающий тип может обречь событие до подхвата. Это число — настройка, и у каждого типа события она своя.
Настройки на каждый тип события
Срочность событий внутри одного сервиса редко совпадает. Подтверждение платежа должно уйти за доли секунды. Ночной отчёт может подождать минуты. Единая глобальная настройка поллинга загоняет оба в один ритм, и сервису приходится выбирать: либо база опрашивается постоянно, либо критичные события ждут.
В oncebox есть один блок defaults, и каждый тип события может переопределить в нём любую часть: стратегию поллинга и задержки, размер пачки, число повторов и backoff. Незаданные значения наследуются, поэтому тип события описывает только то, чем он отличается.
oncebox:
  outbox:
    defaults:
      batch-size: 200
      polling:
        type: adaptive
        min-fixed-delay: 250ms
        max-fixed-delay: 1m
        multiplier: 1.5
      max-retries: 3
      backoff:
        enabled: true
        delay: 10s
        multiplier: 3.0

    events:
      high-priority:
        topic: events
        polling:
          min-fixed-delay: 250ms      # всё остальное наследуется

      low-priority:
        topic: events
        polling:
          min-fixed-delay: 10s
          max-fixed-delay: 5m
          multiplier: 2.0
        backoff:
          enabled: false
Два профиля ведут себя на одной и той же простаивающей таблице очень по‑разному:
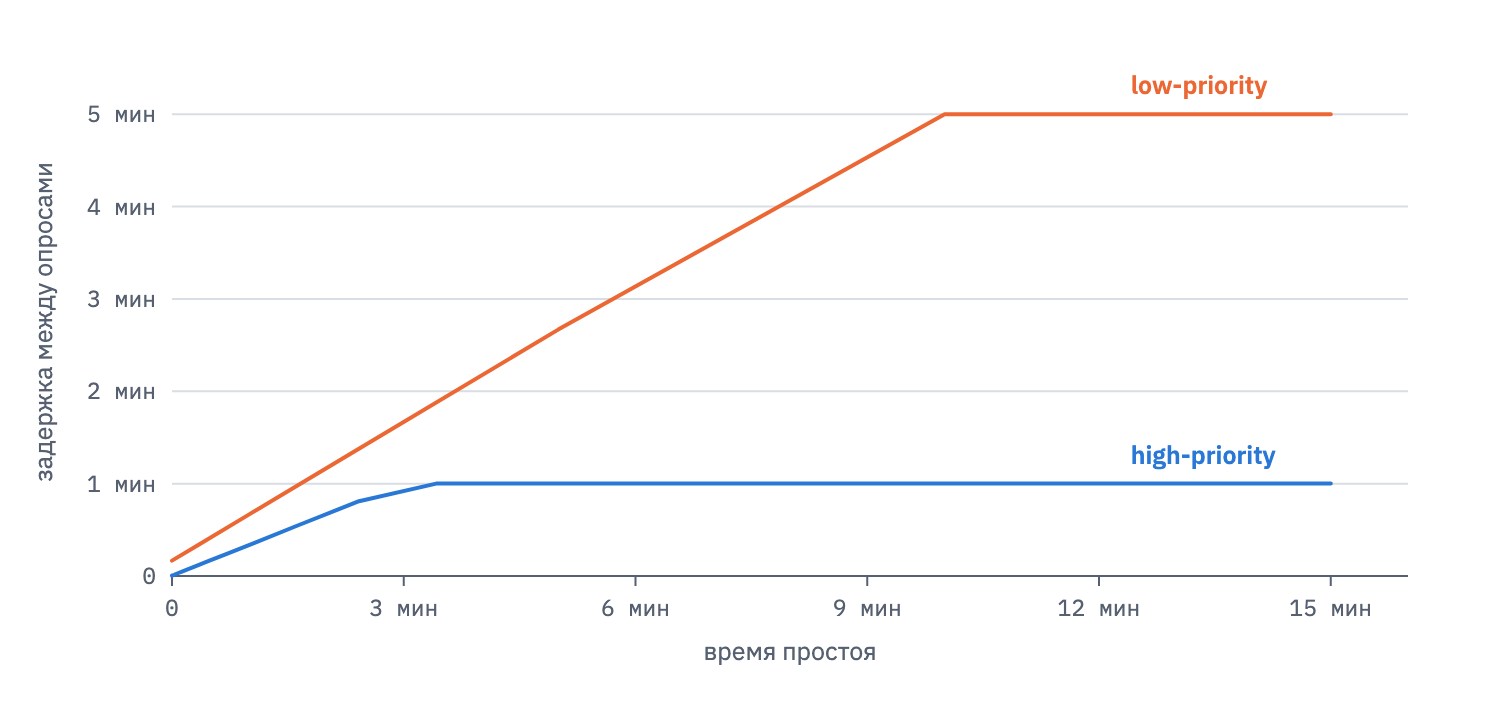
Тип события | Опросов за час простоя | Самое долгое ожидание подхвата при простое |
|---|---|---|
| 70 | 1 мин |
| 15 | 5 мин |
Повторы тоже настраиваются по типам. Задержка перед повтором — delay × multiplier^n, так что значения по умолчанию дают 10 с, 30 с, 90 с. Тип, который дёшево повторить, может повторять быстро; тип, обращающийся к хрупкой внешней системе, может отступать сильнее или остановиться после двух попыток. Когда попытки заканчиваются, событие любого типа уходит в один и тот же DLQ.
Поскольку у каждого типа свой поллер, медленный тип не задерживает быстрый. Всплеск на create-order сокращает задержку только этого типа; остальные поллеры продолжают в своём темпе.
Inbox
До сих пор речь шла о том, как надёжно выпустить событие. У надёжной доставки есть цена на принимающей стороне: at‑least‑once означает, что одно и то же событие может прийти потребителю дважды — из‑за потерянного подтверждения брокера, восстановления зависшего события или перезапуска группы потребителей. Outbox этого предотвратить не может, поэтому потребитель обязан это терпеть.
Inbox в oncebox — это таблица id обработанных событий. Он не хранит сообщения и ничего не обрабатывает асинхронно. Событие, id которого уже записан, пропускается. Всё привязано к UUIDv7, который outbox присвоил при создании события и который потребитель читает из заголовка oncebox_event_id.
public ExampleKafkaListener(@TransactionalConsumer IdempotentConsumer idempotentConsumer) { ... }

@KafkaListener(topics = "example-events", groupId = "example-group",
               containerFactory = "inboxKafkaListenerContainerFactory")
public void listen(Message<ExampleDto> message) {
    idempotentConsumer.consume(
        message,
        OnceboxHeadersUtils::extractId,
        m -> handlers.get(OnceboxHeadersUtils.extractEventType(m)).accept(m.getPayload())
    );
}
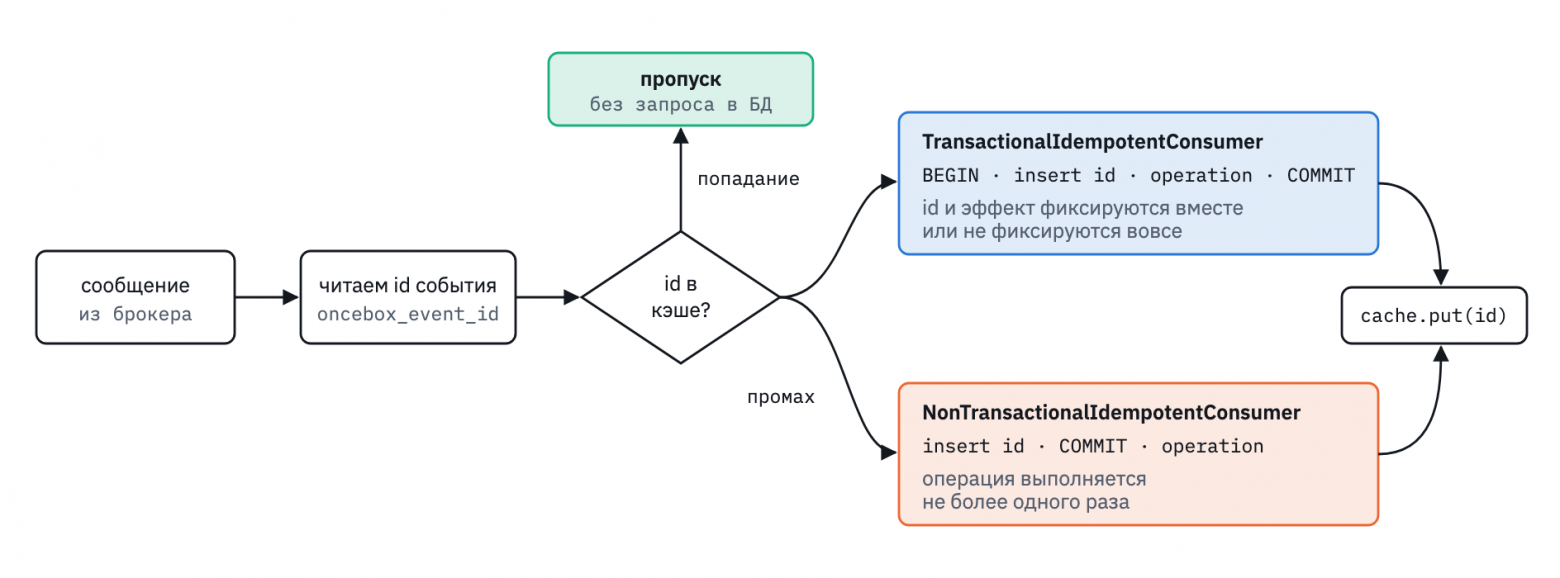
Реализаций две, и выбор между ними — ответ на вопрос, сколько вам стоит дубликат:
Квалификатор | Порядок шагов | Если операция бросает исключение |
|---|---|---|
| одна транзакция: записать id, выполнить операцию, закоммитить | id откатывается вместе с операцией, повторная доставка выполнит её снова |
| записать id и закоммитить, затем выполнить операцию | id остаётся, повторная доставка пропускается |
Транзакционный вариант подходит, когда эффект — запись в ту же базу данных: id и эффект коммитятся вместе или не коммитятся вовсе, поэтому повторно доставленное событие никогда не изменит данные дважды. Нетранзакционный — для эффектов, которые нельзя отменить, например отправки письма, где повторный побочный эффект хуже пропущенного. В README это названо effectively‑once, а не exactly‑once, потому что библиотека не может дедуплицировать внутри самого брокера.
Пачки используют тот же inbox. Когда слушатель получает список, уже обработанные id отфильтровываются, и операция получает только новые, так что частично повторно доставленная пачка обрабатывается правильно без какого‑либо кода в обработчике.
Одно правило не даёт учёту разойтись с реальностью: внутри сервиса одно событие обрабатывает один потребитель. Inbox записывает событие только по его id, независимо от того, какой потребитель его записал. Два слушателя в одном сервисе, которым нужно одно и то же событие, разделили бы его между собой, и второй его пропустил бы. Дайте каждому эффекту свой тип события или свой сервис.
Кэш: что он даёт inbox'у
Без кэша каждая доставка идёт проверять базу: поиск id, а для транзакционного потребителя ещё и вставка внутри бизнес‑транзакции. Когда повторные доставки редки, этот поиск оплачивается на каждом сообщении только ради того, чтобы поймать случайный дубликат.
Необязательный кэш выносит повторные проверки из базы. Он подключается через Spring CacheManager, так что подойдёт Redis или любой другой кэш, который у вас уже есть. При попадании потребитель возвращается, не касаясь базы. При промахе он идёт в inbox как обычно и после успешной обработки кладёт id в кэш.
oncebox:
  inbox:
    cache:
      enabled: true
      cache-name: "orders-service:oncebox:inbox"
От трёх деталей зависит, будет ли он вести себя правильно:
Имя кэша — своё для каждого сервиса. Ключом служит один только id события. Два сервиса, которые потребляют одно событие и делят один Redis под одним именем, будут помечать чужие события как уже виденные. Добавьте к имени префикс с названием сервиса или задайте каждому сервису свой префикс ключей.
Время жизни записей — за вами. Библиотека передаёт кэшу id и больше ничего. Как долго запись живёт — свойство бина
CacheManager, который вы настраиваете; поэтому кэш входит в историю про хранение ниже.Кэш — это ускоритель. Если кэш потерял запись, это стоит одного обращения к базе; источником истины остаётся таблица inbox. Вызовы
consumeдля одного события проходят через кэш, а пакетные вызовы идут напрямую в таблицу inbox.
Три часа
Inbox дедуплицирует только то, что ещё помнит. Id хранятся, пока их не удалит очистка (oncebox.inbox.clean-up.ttl), поэтому повторная доставка, пришедшая позже, воспринимается как новое событие. Каким должно быть это окно, зависит от того, как долго дубликат ещё может быть в пути, и каждая из трёх систем ведёт свои «часы», отвечающие за часть этого вопроса.
1. Брокер: как долго сообщение может вернуться
oncebox брокер не настраивает. Kafka хранит сообщения в течение срока retention независимо от того, что прочитали потребители; сброс группы потребителей или повторное проигрывание может доставить любое сообщение внутри этого срока. По умолчанию в Kafka это семь дней. RabbitMQ держит неподтверждённое сообщение, пока оно не будет подтверждено или не истечёт по TTL очереди либо сообщения, который вы зададите; неподтверждённое сообщение возвращается в очередь, если слушатель бросает исключение.
Подтверждение — на вашей стороне, и значения по умолчанию подходят для inbox. Spring Kafka коммитит смещения после возврата из слушателя, а режим AUTO в RabbitMQ подтверждает сообщение после возврата из слушателя. enabled.auto.commit=true это ломает, и стартер пишет предупреждение в лог, когда его замечает.
2. Таблица inbox: как долго помнится id
Задача очистки inbox удаляет id старше ttl — по умолчанию 24 часа — пачками, на одном инстансе за раз под распределённой блокировкой. Её поллинг адаптивный, как и всё остальное, поэтому строки живут чуть дольше ttl: задача удаляет их на следующем проходе, а не в секунду истечения.
3. Кэш: как долго работает короткий путь
Запись в кэше истекает по расписанию вашего CacheManager. Правило из README: очистка inbox происходит после того, как запись в кэше исчезла. Иначе говоря, время жизни кэша не должно превышать ttl inbox. Тогда кэш лишь сокращает путь к ответу, который дала бы таблица, а ttl inbox остаётся единственным числом, задающим окно дедупликации.
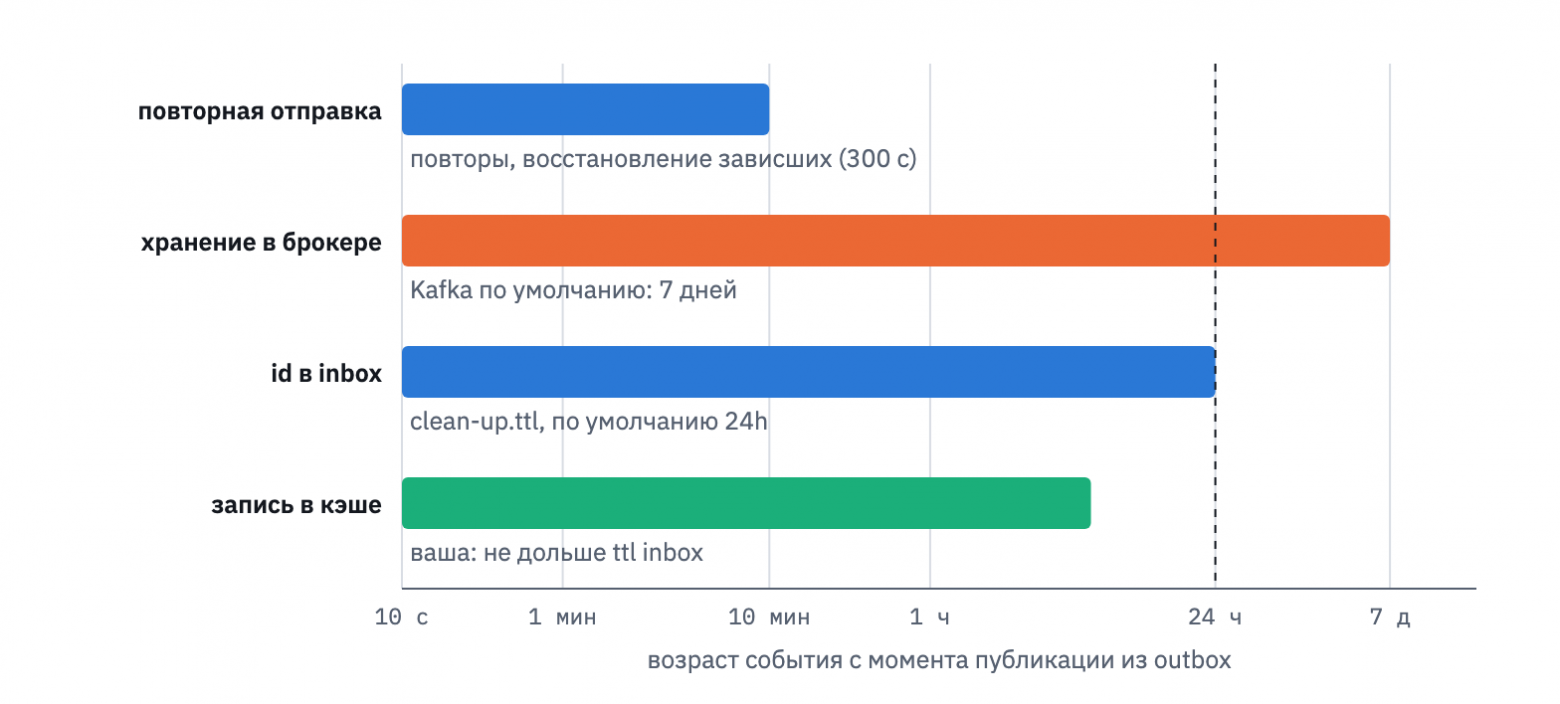
Отсюда два правила:
TTL кэша ≤ ttl inbox, чтобы id в кэше никогда не пережил строку, которая за ним стоит.
ttl inbox ≥ самое долгое время, за которое ещё может прийти дубликат: время, в течение которого outbox может переопубликовать событие (backoff повторов плюс
max-batch-processing-timeв 300 с, после которого зависшее событие отправляется снова) и, когда вы перепроигрываете или сбрасываете смещения потребителя, — retention брокера.
На значениях по умолчанию это выглядит наглядно. 24-часовой ttl inbox покрывает любую повторную публикацию, которую способен породить сам outbox, а она случается в пределах минут. Он же покрывает и обычную повторную доставку после перезапуска потребителя. Перепроигрывание из топика Kafka с семью днями истории уходит глубже 24 часов, поэтому сервис, который перечитывает старые смещения, выставляет ttl inbox под тот retention, из которого читает.
У outbox тоже есть собственный ttl очистки, тоже 24 часа по умолчанию, но он относится к другой таблице. Он удаляет строки PROCESSED из outbox_events и на дедупликацию не влияет. Как и очистка RESOLVED в DLQ.
Настройка | Где | По умолчанию | Что определяет |
|---|---|---|---|
Retention топика / TTL очереди | брокер | Kafka: 7 дней | насколько старым может быть сообщение при повторной доставке или перепроигрывании |
| таблица inbox |
| как долго id блокирует дубликат |
время жизни записи в | Redis или другой кэш | ваше | как долго на дубликат отвечают без обращения к базе |
| таблица outbox |
| как долго строки |
| восстановление в outbox |
| когда зависшая пачка отправляется снова |
Всё в одном файле
Сервису с outbox и inbox нужны стартер, ровно один модуль диалекта базы данных и один модуль брокера. Всё остальное имеет значения по умолчанию, поэтому рабочая конфигурация остаётся короткой:
oncebox:
  thread-pool-size: 5
  outbox:
    sender:
      type: kafka
    defaults:
      batch-size: 200
      polling:
        type: adaptive
        min-fixed-delay: 250ms
        max-fixed-delay: 1m
        multiplier: 1.5
    events:
      create-order:
        topic: orders
      daily-report:
        topic: reports
        polling:
          min-fixed-delay: 10s
          max-fixed-delay: 5m
    dlq:
      enabled: true
  inbox:
    source:
      type: kafka
    clean-up:
      ttl: 24h
    cache:
      enabled: true
      cache-name: "orders-service:oncebox:inbox"
Помимо описанного здесь, в библиотеке есть REST API для работы с dead letter queue (просмотр, повтор, разрешение, удаление), метрики Micrometer с кэшируемыми gauge'ами и полностью контейнеризованный пример с генератором трафика.
Репозиторий: github.com/dmitriy‑iliyov/oncebox
Пример: oncebox‑example
Комментарии 0