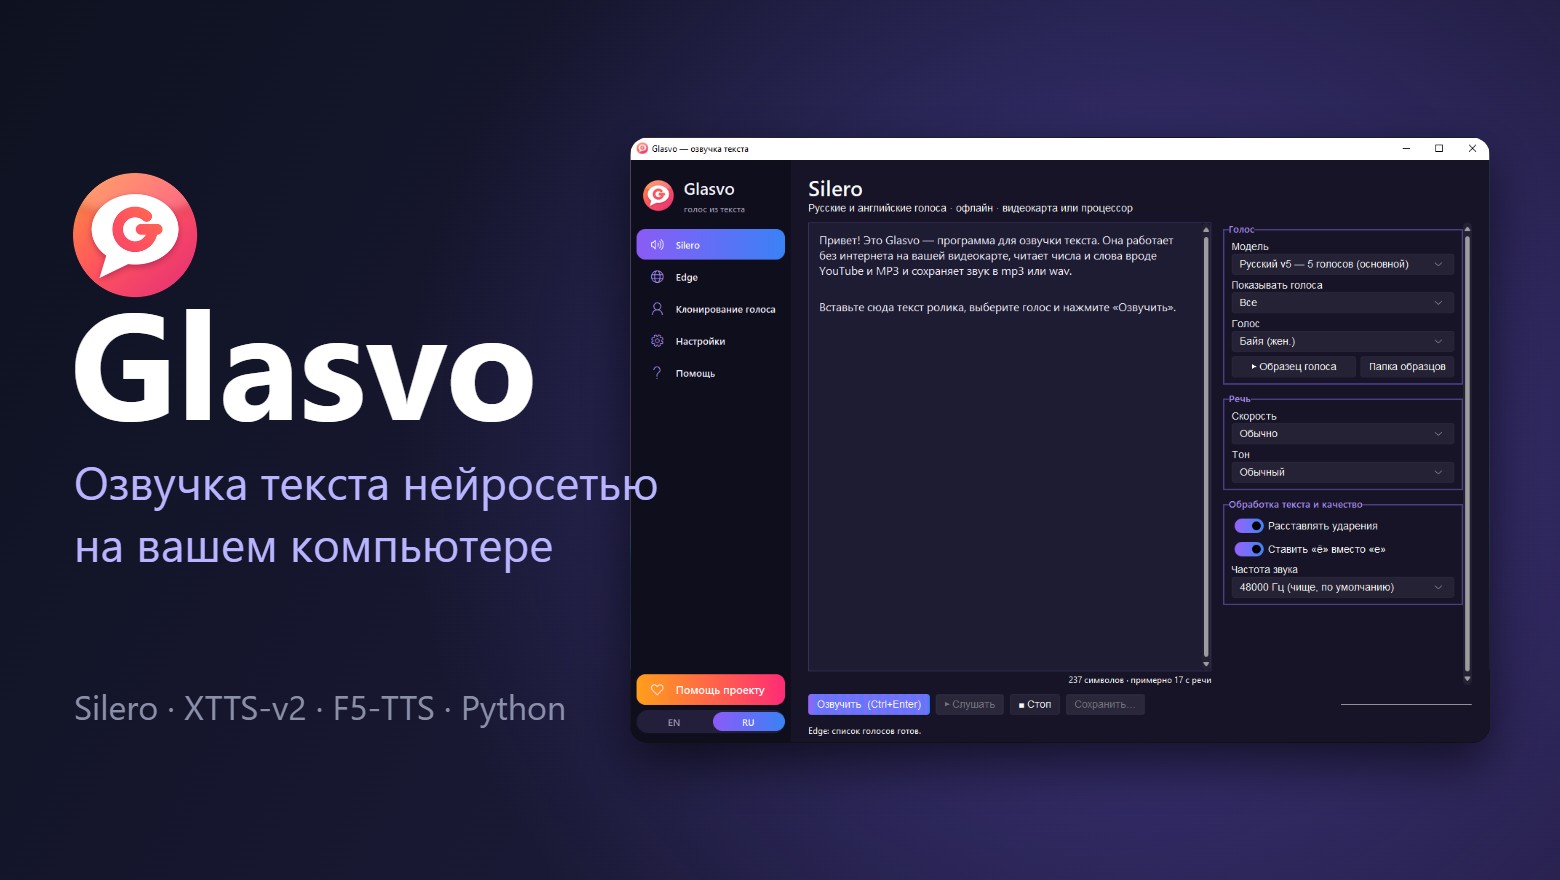
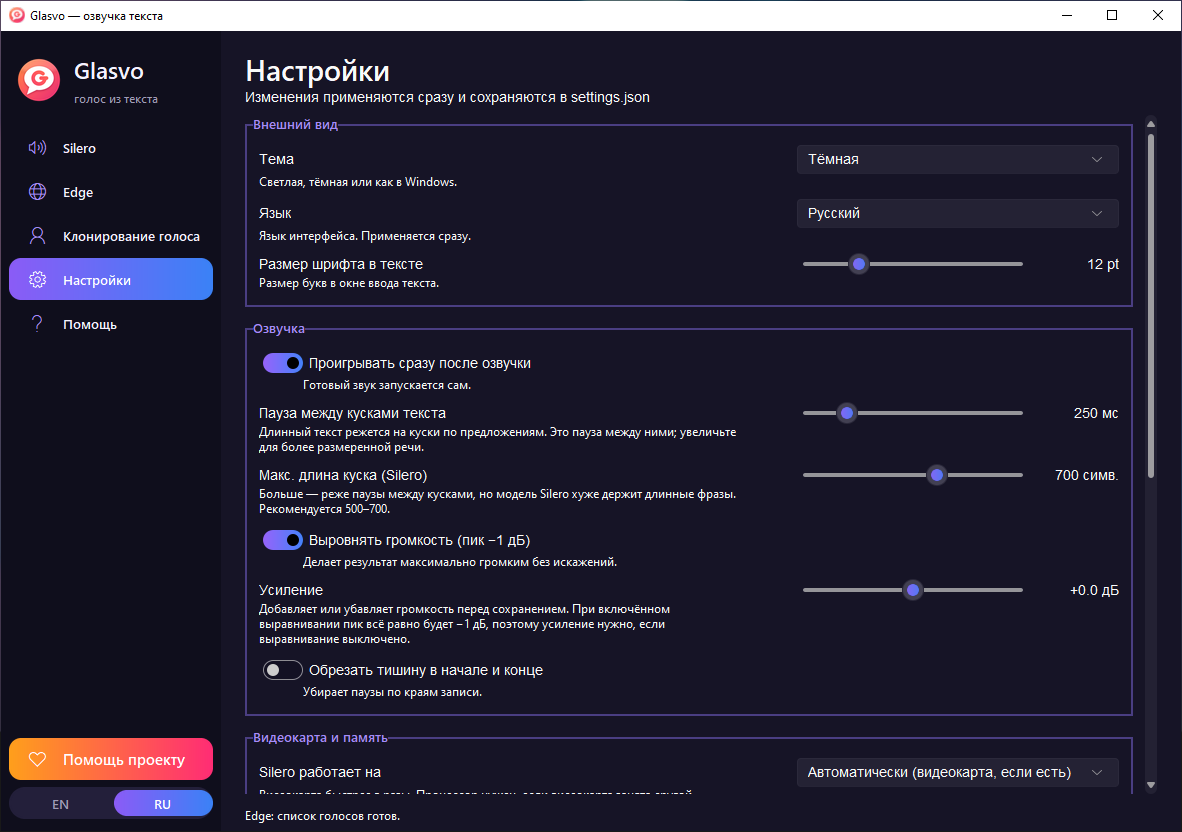
Мне регулярно нужно озвучивать русский текст, а онлайн-сервисы с бесплатным лимитом знаков и подпиской после него надоели. Нейросетевой синтез речи давно спокойно крутится на домашней видеокарте, поэтому я собрал вокруг него оболочку: окно на tkinter, в котором есть три движка, Silero, голоса Microsoft Edge и клонирование голоса (XTTS-v2 и F5-TTS). Назвал Glasvo. Код открыт, MIT: https://github.com/OlegChe77/glasvo .
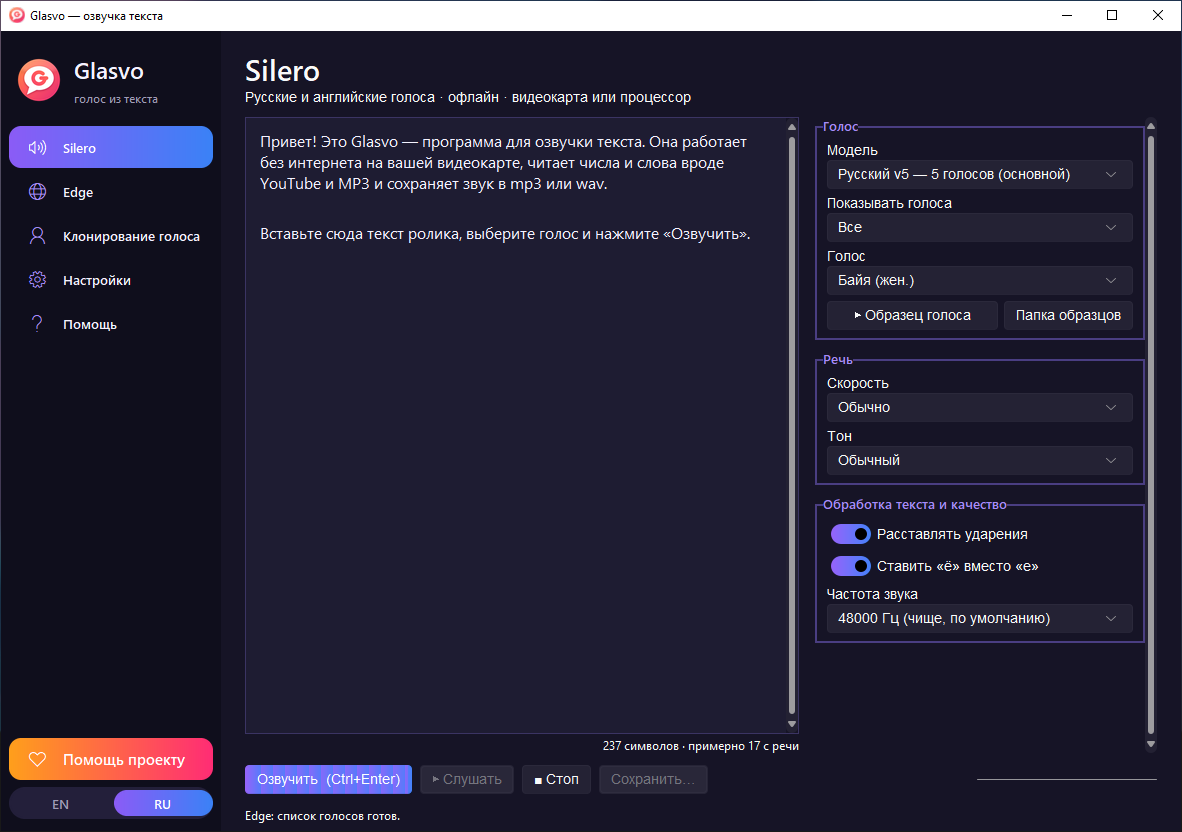
Основная часть работы оказалась не в самих моделях (их вызов это десять строк), а в мелочах вокруг: числа и латиница, которые Silero молча выкидывает, версии пакетов, которые не хотят жить вместе, и установка, после которой у человека без Python всё запускается одной кнопкой. Ниже сначала цифры, потом грабли.
Сколько это весит и что нужно
Сразу о том, что обычно выясняется после установки.
Что | Размер / требование |
|---|---|
Архив с программой | около 8 МБ (скрипты и интерфейс) |
Python 3.12 + venv с PyTorch 2.5.1 (CUDA 12.1) и 168 пакетами | около 5,5 ГБ |
Модели Silero | v5_ru 139 МБ, v5_6_ru 141 МБ, v5_cis_base 88 МБ, v4_ru 39 МБ, v3_1_ru 60 МБ, английская v3_en 55 МБ |
XTTS-v2 | 2,0 ГБ |
F5-TTS (русский чекпойнт + vocos) | 1,4 ГБ |
Whisper small (текст образца для F5) | 0,9 ГБ |
Итого со всем | около 10 ГБ |
Видеокарта | Silero и Edge: не нужна. XTTS и F5: NVIDIA, измеренный пик 2 ГБ видеопамяти на RTX 3070 (8 ГБ), рекомендую от 6 ГБ |
ОЗУ | процесс около 1,2 ГБ с Silero и около 3 ГБ с XTTS/F5 |
Замеры на одном и том же русском тексте в 285 знаков (чуть больше 17 секунд звука), RTX 3070, после прогрева:
Движок | Время на текст | Загрузка модели | Пик видеопамяти |
|---|---|---|---|
Silero v5_ru, GPU | 0,08 с | с диска, быстро | 242 МБ |
Silero v5_ru, CPU | 0,53 с | — | — |
XTTS-v2 | 5 с на 18,7 с звука | 13 с | 2019 МБ |
F5-TTS | 4,4 с на 17,3 с звука | 4 с | 1999 МБ |
Это не бенчмарк, а единичные прогоны на одной машине, но порядок понятен: Silero работает в сотни раз быстрее реального времени, клонирование примерно в три-четыре раза.
Как устроена озвучка
Общий ход у всех страниц один: класс VoicePage берёт текст, режет на куски, вызывает synthesize подкласса, склеивает результат и даёт «Слушать» и «Сохранить». Новый движок это подкласс с тремя методами: build_options, collect, synthesize.
Silero
Модели Silero это упакованные torch.package. Первая же грабля: PyTorch не открывает путь с кириллицей, а у меня и пользователей папки бывают любые. Решение — отдавать файловый объект:
with open(path, "rb") as f:
    model = PackageImporter(f).load_pickle("tts_models", "model")
model.to(torch.device("cuda"))   # или "cpu"
wav = model.apply_tts(text=chunk, speaker="xenia", sample_rate=48000,
                      put_accent=True, put_yo=True)
Скорость и тон идут через SSML, <prosody rate= pitch=>. Кусок текста у Silero не должен быть длиннее примерно 700 символов, поэтому длинный текст я режу по предложениям (split_text) и склеиваю с паузой между абзацами.
В русских моделях всего пять голосов (aidar, eugene, baya, kseniya, xenia). Остальные 29 лежат в v5_cis_base и говорят с акцентами, а 118 английских в v3_en. Английской модели флаги put_accent и put_yo передавать не нужно (для английского они не имеют смысла), поэтому в таблице моделей у каждой есть признак «русская».
То, что Silero молча выбрасывает
Это был самый неприятный сюрприз. Цифры в тексте Silero просто пропускает, и в озвучке получаются провалы вместо «две тысячи двадцать шесть». Латиница в русских моделях тоже вырезается без ошибки. Поэтому перед моделью стоят две функции.
expand_numbers на num2words превращает числа в слова: 1,5 как дробь, 1,2,3 как перечень, -7 как минус. Для падежей это не идеально («в 1990 году» прозвучит не так, как надо), и в справке я честно советую писать такие числа словами.
latin_to_cyrillic решает латиницу тремя уровнями. Частые слова берутся из словаря (YouTube в «ютуб», Windows в «виндоус»), слова ЗАГЛАВНЫМИ и без гласных читаются по буквам (USB в «ю-эс-би»), всё остальное идёт транслитом. Проверял прогоном через Whisper: ставил фразы с английскими словами, озвучивал и распознавал обратно, все слова находились. Если слово из частых прочитано неверно, его достаточно добавить в словарь LATIN_WORDS.
Порядок подготовки текста для русской модели такой:
if russian:
    text = latin_to_cyrillic(text)       # MP3 -> эм-пэ-три, YouTube -> ютуб
text = expand_numbers(text, "ru" if russian else "en")   # 2026 -> две тысячи двадцать шесть
if not has_letters(text):
    raise ValueError("в тексте нет букв")
chunks = split_text(text, limit)         # по предложениям, до ~700 знаков
Edge
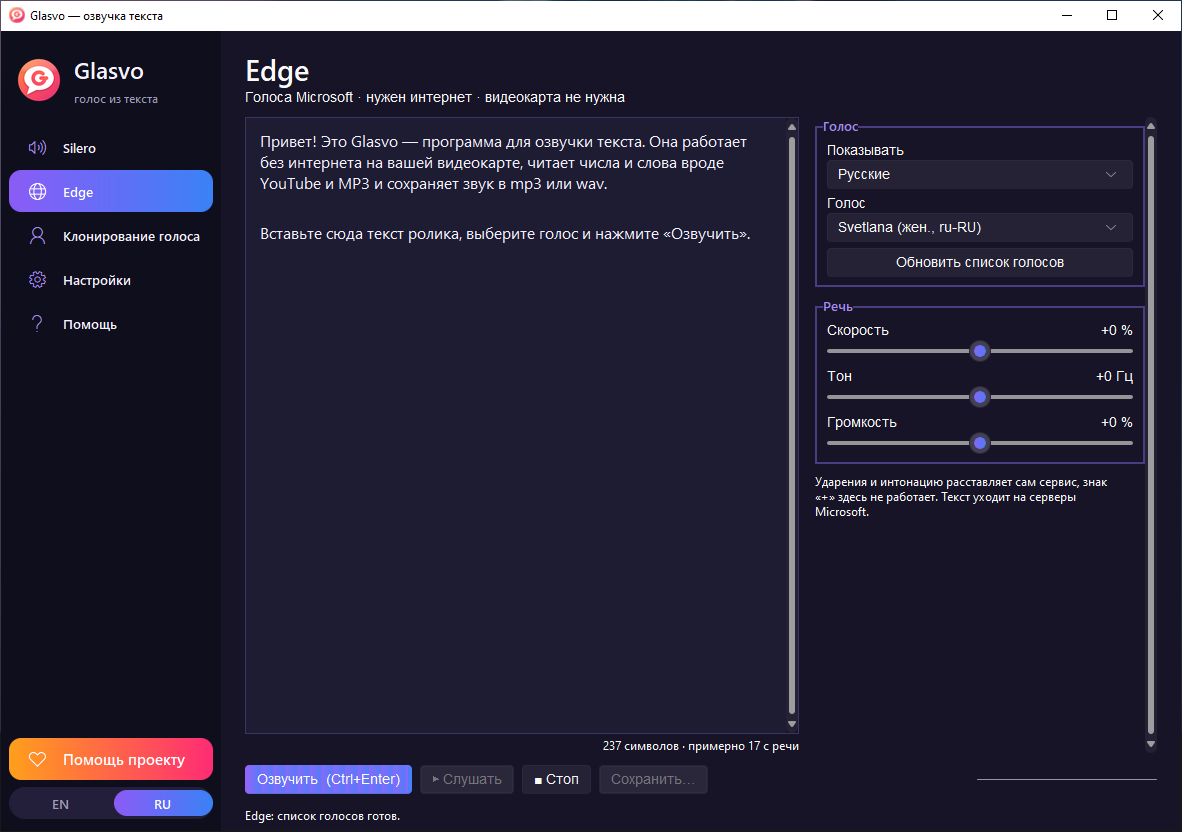
Тут проще: пакет edge-tts ходит в онлайн-голоса Microsoft, видеокарта не нужна. Русских голосов два (Дмитрий и Светлана), остальные мультиязычные. Один нюанс: символ & в русском тексте даёт NoAudioReceived, поэтому он заменяется словом, а при пустом ответе делается одна повторная попытка.
Клонирование: XTTS-v2 и F5-TTS
Образец голоса ffmpeg приводит к wav 24 кГц моно. ffmpeg берётся из imageio-ffmpeg, системный ставить не нужно. Пишется во временный файл и потом через os.replace: иначе выбор того же файла или повреждённого файла портил уже сохранённый образец.
У XTTS-v2 лимит около 182 символов на русский кусок, поэтому для него длина куска 170, а для F5 400. F5 нужен текст образца, и тут пригодился Whisper small: он распознаёт образец локально, после чего выгружается, чтобы освободить видеопамять.
# F5 сам берёт образец не длиннее ~12 с; режем заранее, чтобы текст совпал со звуком
data, sr = sf.read(ref, dtype="float32")
sf.write(ref12, data[: int(sr * 12)], sr)
ref_text = ref_text.strip() or transcribe(ref12)      # Whisper small, потом выгрузка
wav, _sr, _ = model.infer(ref_file=ref12, ref_text=ref_text, gen_text=chunk,
                          speed=speed, nfe_step=32, cfg_strength=2.0)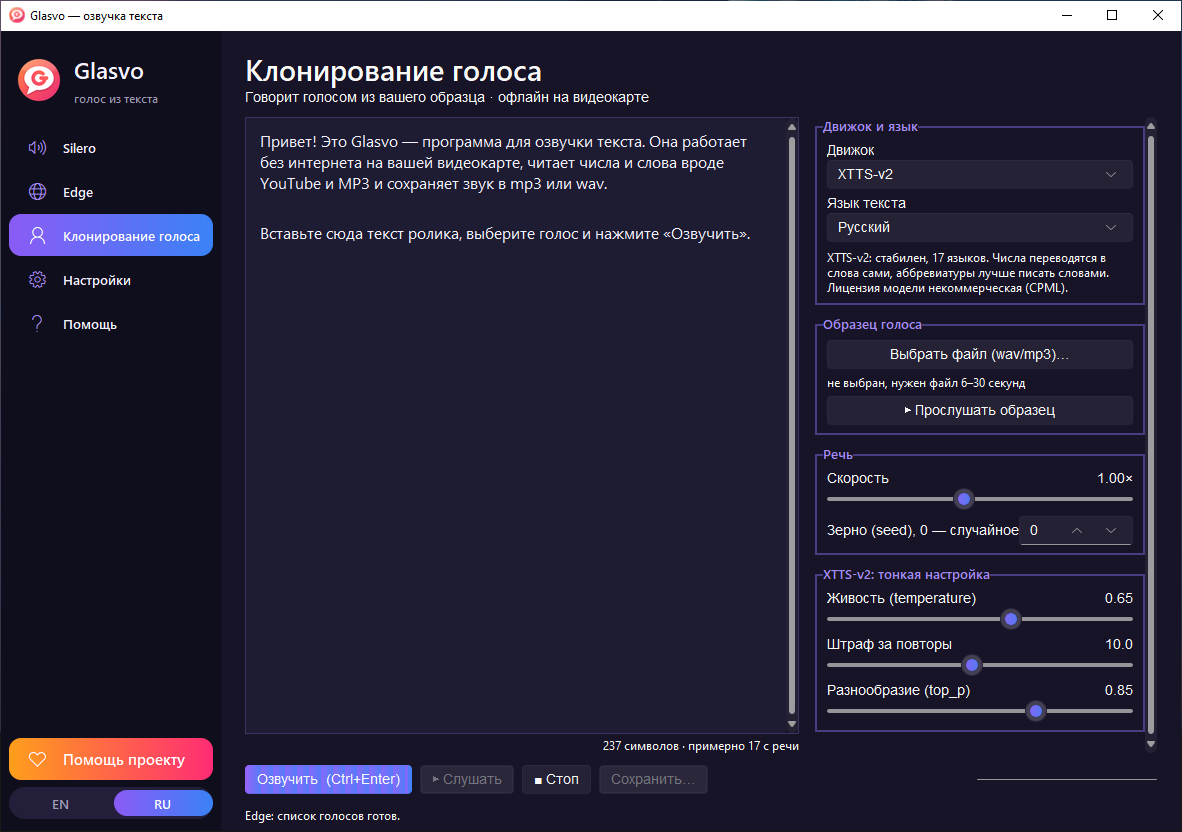
Проверял замкнутым кругом: беру голос Silero как «образец», читаю им XTTS и F5 русский текст, результат распознаю Whisper и сравниваю слова с исходным. Совпадение получилось 100% у обоих.
Версии пакетов, которые не хотят дружить
Самая долгая часть работы. Клонирование (coqui-tts, f5-tts, transformers) тянет за собой столько зависимостей, что менеджер пакетов упирается в конфликты. Что в итоге зафиксировано:
torch==2.5.1+cu121,torchaudio==2.5.1+cu121. Новее нельзя:transformers5 иdiffusers0.43 требуют torch не ниже 2.6, а это ломает остальное.transformers<5,huggingface_hub<1.0.omegaconfпришлось понизить до 2.3.1, потому что от него зависит hydra для F5. После этого проверил, что Silero продолжает работать.pip checkругается на пины f5-tts. Это нормально, всё работает.
В requirements.txt лежит точная копия рабочего окружения (pip freeze), без обычных диапазонов версий.
Установка без Python у пользователя
Ставить Python вручную и разбираться с venv ожидать от обычного человека не стоит, поэтому install.bat запускает install.ps1. Тот скачивает uv, через него Python 3.12 в папку python/, создаёт venv и ставит пакеты командой uv pip install --no-deps -r requirements.txt. Без видеокарты NVIDIA подставляется torch с +cpu вместо +cu121.
Две ловушки:
Кэш
uvлежит во временной папке с коротким путём (%TEMP%\glasvo-uv-cache), а потом удаляется. В глубокой папке пакетantlr4не собирался из-за длины пути.Модели не входят в архив и качаются при первой озвучке через
huggingface_hub.snapshot_download, только выбранные. Качать модели в одну папку двумя процессами нельзя, файлы затираются.
Автообновление: программа при запуске смотрит releases/latest на GitHub, сравнивает версию, скачивает Glasvo.zip и копирует файлы поверх, кроме settings.json. Если поменялся requirements.txt, после перезапуска снова идёт install.bat.
Мелочи интерфейса, на которых терялось время
Под
pythonw(запуск без консоли)sys.stdoutравенNone, иtqdmилиprintв движках падают. В началеapp.pyподставленdevnull.Фоновые потоки нельзя пускать в tkinter:
afterвнеmainloopпадает. Всё UI-шное идёт через очередь, которую главный поток разбирает по таймеру.Колесо мыши над
ttk.Comboboxпо умолчанию меняет значение, пока человек просто прокручивает страницу. Перехватил.Горячие клавиши Ctrl+C/V/X/A при русской раскладке не работают, если ловить символы. Ловлю по keycode.
Выбор в настройках хранится ключами (
v5_ru,medium), а не подписями, иначе смена языка интерфейса теряет выбор. Язык переключается без перезапуска: страницы пересоздаются, звук и выбор переносятся.Тема:
sv_ttk(Sun Valley) с перекрашенными спрайтами.
Лицензии
Это важное место, которое легко пропустить. Код программы под MIT, но модели в большинстве некоммерческие: Silero и русский чекпойнт F5-TTS под CC BY-NC 4.0, XTTS-v2 под Coqui Public Model License, Whisper под MIT. Для монетизированных роликов условия нужной модели надо читать отдельно. Клонировать стоит только свой голос или голос человека, давшего согласие.
Итог
Получилась программа, которая на домашней видеокарте озвучивает русский текст за секунды, а при желании читает его вашим голосом. Скачать (около 8 МБ, остальное установщик докачает): https://github.com/OlegChe77/glasvo/releases/latest/download/Glasvo.zip , исходники: https://github.com/OlegChe77/glasvo .
Если знаете, как чище решить чтение латиницы в русском тексте или удобнее поставить ударения, пишите в комментариях.

Комментарии 0