Хабр, привет! Меня зовут Артемий Наумов, я инженер данных в Лемана Тех. Наша команда развивает корпоративное хранилище данных и переносит сборку витрин с Greenplum на Data Lakehouse.
Причиной перехода стали начавшиеся регулярные проблемы в DWH: пользователи конкурировали за ресурсы, для масштабирования нужно было найти подходящее оборудование, а проверки пользовательского кода было сложно собрать в одном процессе. Мы рассмотрели Data Lakehouse, провели PoC и начали развивать новую платформу.
При миграции мы поставили две цели: сохранить эффективность сборки витрин и привычный для команд сценарий работы. Пользователи должны продолжать писать SQL, задавать параметры сборок и запускать их через Airflow. В новой архитектуре меняются хранение и вычисления, процесс разработки и обслуживание платформы.
Расскажу, какой стек мы выбрали, как переносим пользовательские сборки и что пришлось доработать. Миграция продолжается: мы перенесли 40 из 290 интеграций и оценили время сборки витрин для критической отчетности.
Как устроена сборка на Greenplum
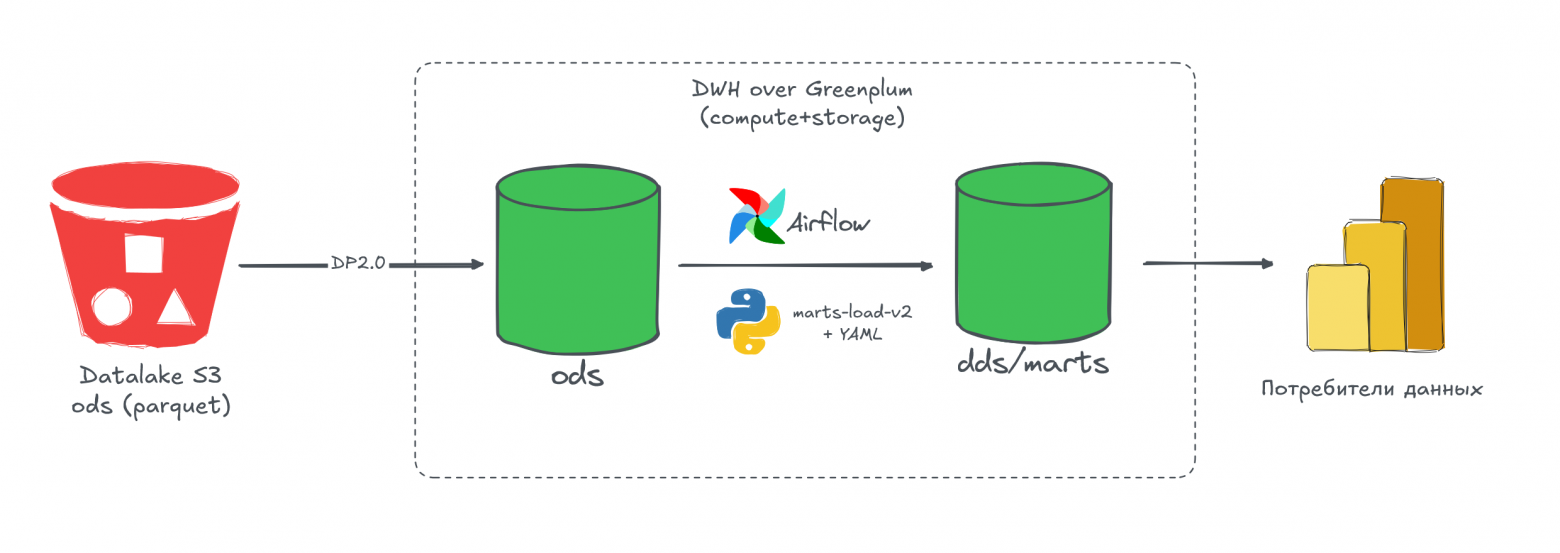
В исходном процессе данные лежат в S3 в виде Parquet-файлов, мы загружаем их через PXF в ODS-слой Greenplum и затем собираем витрины в слое marts. Запусками управляет Airflow, а DAG мы генерируем по YAML-конфигурациям. Из marts данные забирают BI-системы, аналитики и другие потребители.
Мы используем в компании подход Data Mesh: доменные команды отвечают за свои данные и витрины, а команда платформы предоставляет инфраструктуру, фреймворки и инструменты. Каждая команда должна самостоятельно разрабатывать и поддерживать свои расчеты. От удобства этого процесса зависит работа большого числа пользователей.
Greenplum хорошо подходит для этого процесса: его архитектура рассчитана на аналитические нагрузки, PostgreSQL-интерфейс привычен пользователям, а работу через SQL и YAML мы уже наладили.
По мере роста нагрузки мы столкнулись с ограничениями общего кластера, в котором объединены вычисления и хранение. Тяжелый или неоптимизированный запрос может повлиять на работу других пользователей, а проблемы общего кластера затрагивают сразу несколько команд. Когда достигаем лимитов по ресурсам или числу узлов, приходится расширять инфраструктуру, а найти и закупить оборудование, которое позволит сохранить прежнюю эффективность кластера, бывает сложно.
Проверки пользовательского кода находятся в разных местах. Некоторые необходимые нам тесты трудно встроить в существующий процесс, а подходящие готовые инструменты удается использовать с ограничениями.
Для отслеживания зависимостей между объектами, то есть lineage, у нас есть собственное решение. Оно подходит для наших задач, разработкой и сопровождением занимаемся сами.
На DWH у нас также нет единого стандарта модели данных, который последовательно применяли бы все команды, — в разных схемах используются разные подходы, которыми сложно управлять централизованно.
Из-за этих проблем мы и начали PoC на Data Lakehouse.
Что изменилось в архитектуре
В новом стеке мы разделили хранение и вычисления: данные храним в облачном S3 в таблицах Apache Iceberg, каталог метаданных — Nessie. Для разных типов нагрузки мы поднимаем отдельные кластеры Trino. Запусками управляет Airflow 2.x, сейчас готовим переход на версию 3.x. Для сборки моделей используем dbt и dbt-trino.
Данные источников поступают в ODS сразу в Iceberg. Airflow-кластер управляет сборкой marts с помощью dbt-моделей, которые выполняются на отдельном ETL-кластере Trino.
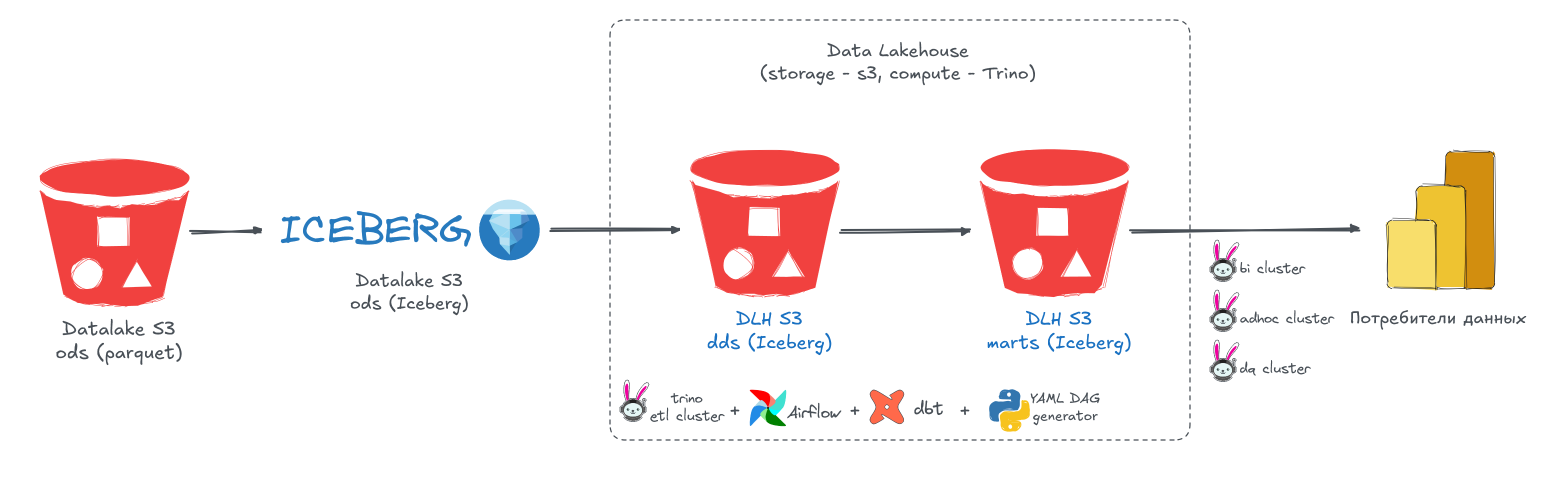
Для BI, ad hoc и проверок качества данных можно использовать другие кластеры Trino. Это дает возможность выделять вычислительные ресурсы под конкретную нагрузку и независимо настраивать каждый кластер.
Основным интерфейсом работы с данными остается SQL; аналитики и BI-разработчики обращаются к таблицам и витринам привычным способом — для них это важное условие перехода.
Как сохранили привычный процесс разработки
На DWH код объектов Greenplum — таблиц, представлений и функций — находился в монорепозитории, и в DLH мы сохранили этот подход, поэтому в одном репозитории хранится весь dbt-проект: SQL-код моделей, конфигурации, которые задают их поведение, тесты и настройки SQLFluff. Здесь же находятся проверки структуры проекта и YAML-конфигурации для генерации DAG.
Проверки структуры помогают соблюдать принятые правила организации проекта — например, именование схем и разделение объектов по слоям ODS, DDS и marts. SQLFluff используем как линтер для контроля стиля и стандартов SQL.
Для генерации DAG по dbt-проекту используем Cosmos. В YAML-конфигурации задаем параметры сборки и список моделей для запуска. По ним Cosmos строит граф задач Airflow.
Пользователь продолжает работать с SQL и YAML. В новой платформе эти файлы описывают dbt-модели и их запуск.
Локальная разработка через sandbox
Для разработки пользователь локально поднимает Airflow в Docker. Вычисления запускаются на отдельном sandbox-кластере Trino, который подключен к development-ветке каталога Nessie.
Nessie поддерживает ветки каталога. В нашем процессе main используется для production, а development-ветки создаются для разработки и тестирования.
Ветка работает со ссылками на данные, поэтому модели можно проверять на production-объемах и сохранять изменения в отдельной ветке. Закончив разработку, пользователь удаляет ветку. Мы следим за очисткой этих окружений, чтобы в каталоге не накапливались завершенные эксперименты.
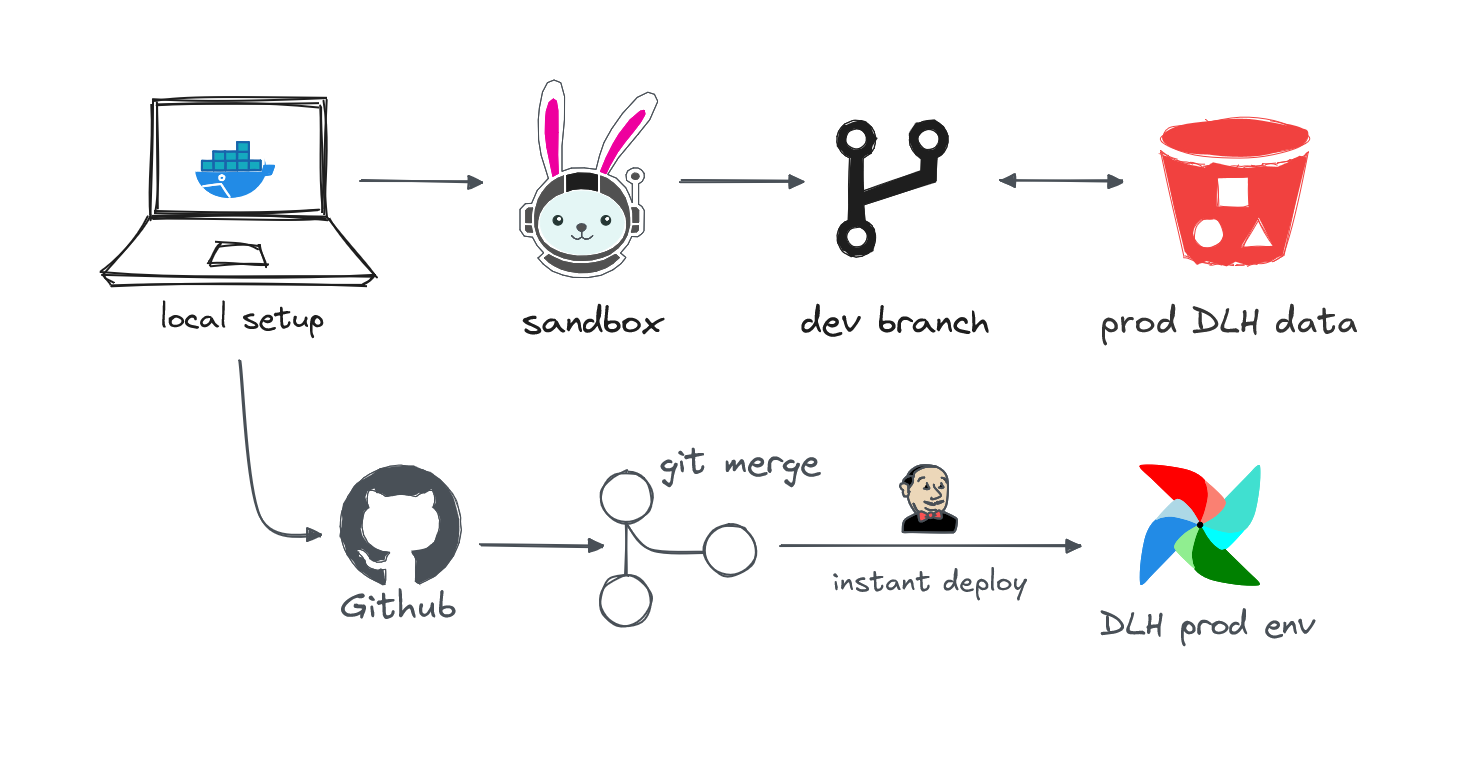
На Greenplum локальное тестирование требовало отдельно загружать данные в базу, запущенную в Docker. Проверка функции на пустой локальной базе давала мало информации о ее работе на полном наборе данных. Затем изменения попадали на dev, где можно было запустить сборку с данными и проверить технические роли. Для этого у нас был недельный релизный цикл.
С development-ветками Nessie необходимую проверку можно провести до отправки изменений в production. После merge код деплоится без ожидания недельного релиза.
Так изменился процесс доставки кода. После этого time-to-market сократился в разы, с одной недели до нескольких часов.
Почему перенос SQL требует переработки сборок
Переиспользовать SQL-скрипты сборки витрин из Greenplum «1 в 1» не получится: у диалекта Trino есть ряд отличий, под которые код нужно адаптировать. К ним относятся встроенные агрегатные и inline-функции и их сигнатуры, а также работа с некоторыми типами данных (например, HyperLogLog). Часто приходится явно приводить типы через CAST, поэтому нужно внимательнее смотреть на типы исходных данных и значения, которые должны попасть в итоговую витрину.
Для переписывания запросов мы используем ИИ-инструменты: они помогают сократить объем ручной работы с SQL. После этого проверяем запрос в новом окружении.
Более сложная часть — перенос больших функций Greenplum.
В старой сборке одна функция могла выполнять значительный объем вычислений. При переносе возникает желание поместить всю логику в одну dbt-модель и выполнить ее одним запросом с большим количеством CTE. В нашей конфигурации Trino такой запрос может достигнуть ограничений по памяти, сложности плана или другим параметрам выполнения. Постоянно увеличивать лимиты мы не можем: ресурсы нужны остальным сборкам, а рост потребления одним запросом влияет на очереди. Поэтому часть крупных сборок приходится разбивать на несколько моделей с материализацией промежуточных результатов. Они записываются в S3, затем используются на следующих шагах.
Для промежуточных моделей мы выделяем отдельные схемы с суффиксом _wrk, это помогает отделять рабочие расчеты от готовых витрин. При таком разбиении приходится дополнительно записывать и читать данные, запускать больше задач Airflow. Это нужно учитывать, когда сравниваем время сборки с Greenplum.
Какие материализации пришлось добавить
Для переноса привычных сценариев нам потребовались собственные материализации dbt: два основных примера — temp_table и delete_insert.
Временные таблицы через temp_table
В Greenplum временные таблицы часто используются внутри сборок; на Trino мы используем для этого постоянные таблицы с ограниченным сроком жизни.
При запуске материализация temp_table создает таблицу и добавляет к ее имени хеш Airflow DagRun. Промежуточные модели используют эту таблицу при сборке. В конце DagRun вызываем DROP для таблиц с соответствующим хешем. Так мы связываем временные объекты с конкретным запуском и можем удалить их после завершения работы.
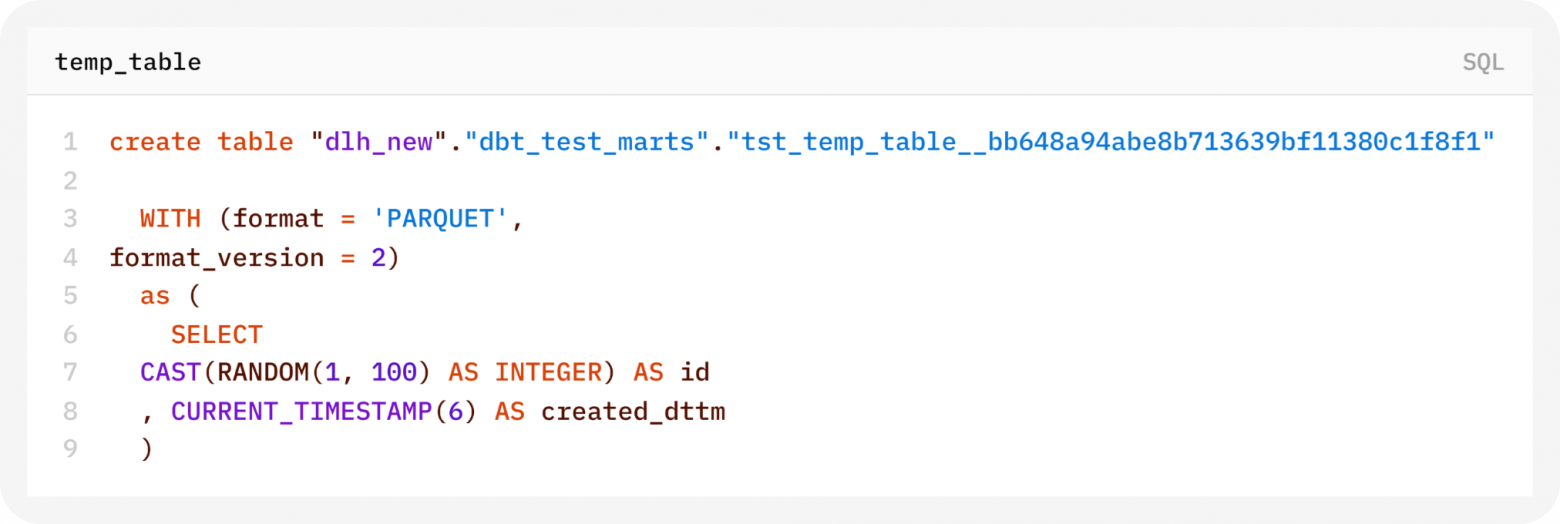
Для задачи очистки задаем trigger rule, чтобы она выполнялась независимо от того, успешно ли завершились предыдущие задачи. Удалять таблицы нужно и после сборок с ошибками.
Дополнительно проверяем оставшиеся временные объекты. Таблицы, которые старше установленного срока и уже не нужны, удаляем при отдельном обслуживании. Например, срок можно ограничить двумя неделями.
Удаление таблицы из каталога и очистка файлов в S3 в нашем процессе выполняются отдельно. К обслуживанию хранилища еще вернемся далее.
Обновление среза данных через delete_insert
Еще один распространенный сценарий на Greenplum — обновление части витрины через последовательные DELETE и INSERT.
В использованной нами стандартной стратегии delete+insert удаление связывалось с ключами поступивших строк. Для некоторых наших сборок этого недостаточно. Например, если в таблицу ранее попали некорректные ключи, удаление по ключам нового инкремента может оставить ошибочные записи. Нам нужно целиком пересчитать заданный срез — допустим, данные за бизнес-день. Для этого мы добавили материализацию delete_insert с условием удаления, которое задает пользователь. Оно может отбирать строки по бизнес-дате. После удаления модель вставляет заново рассчитанные данные.
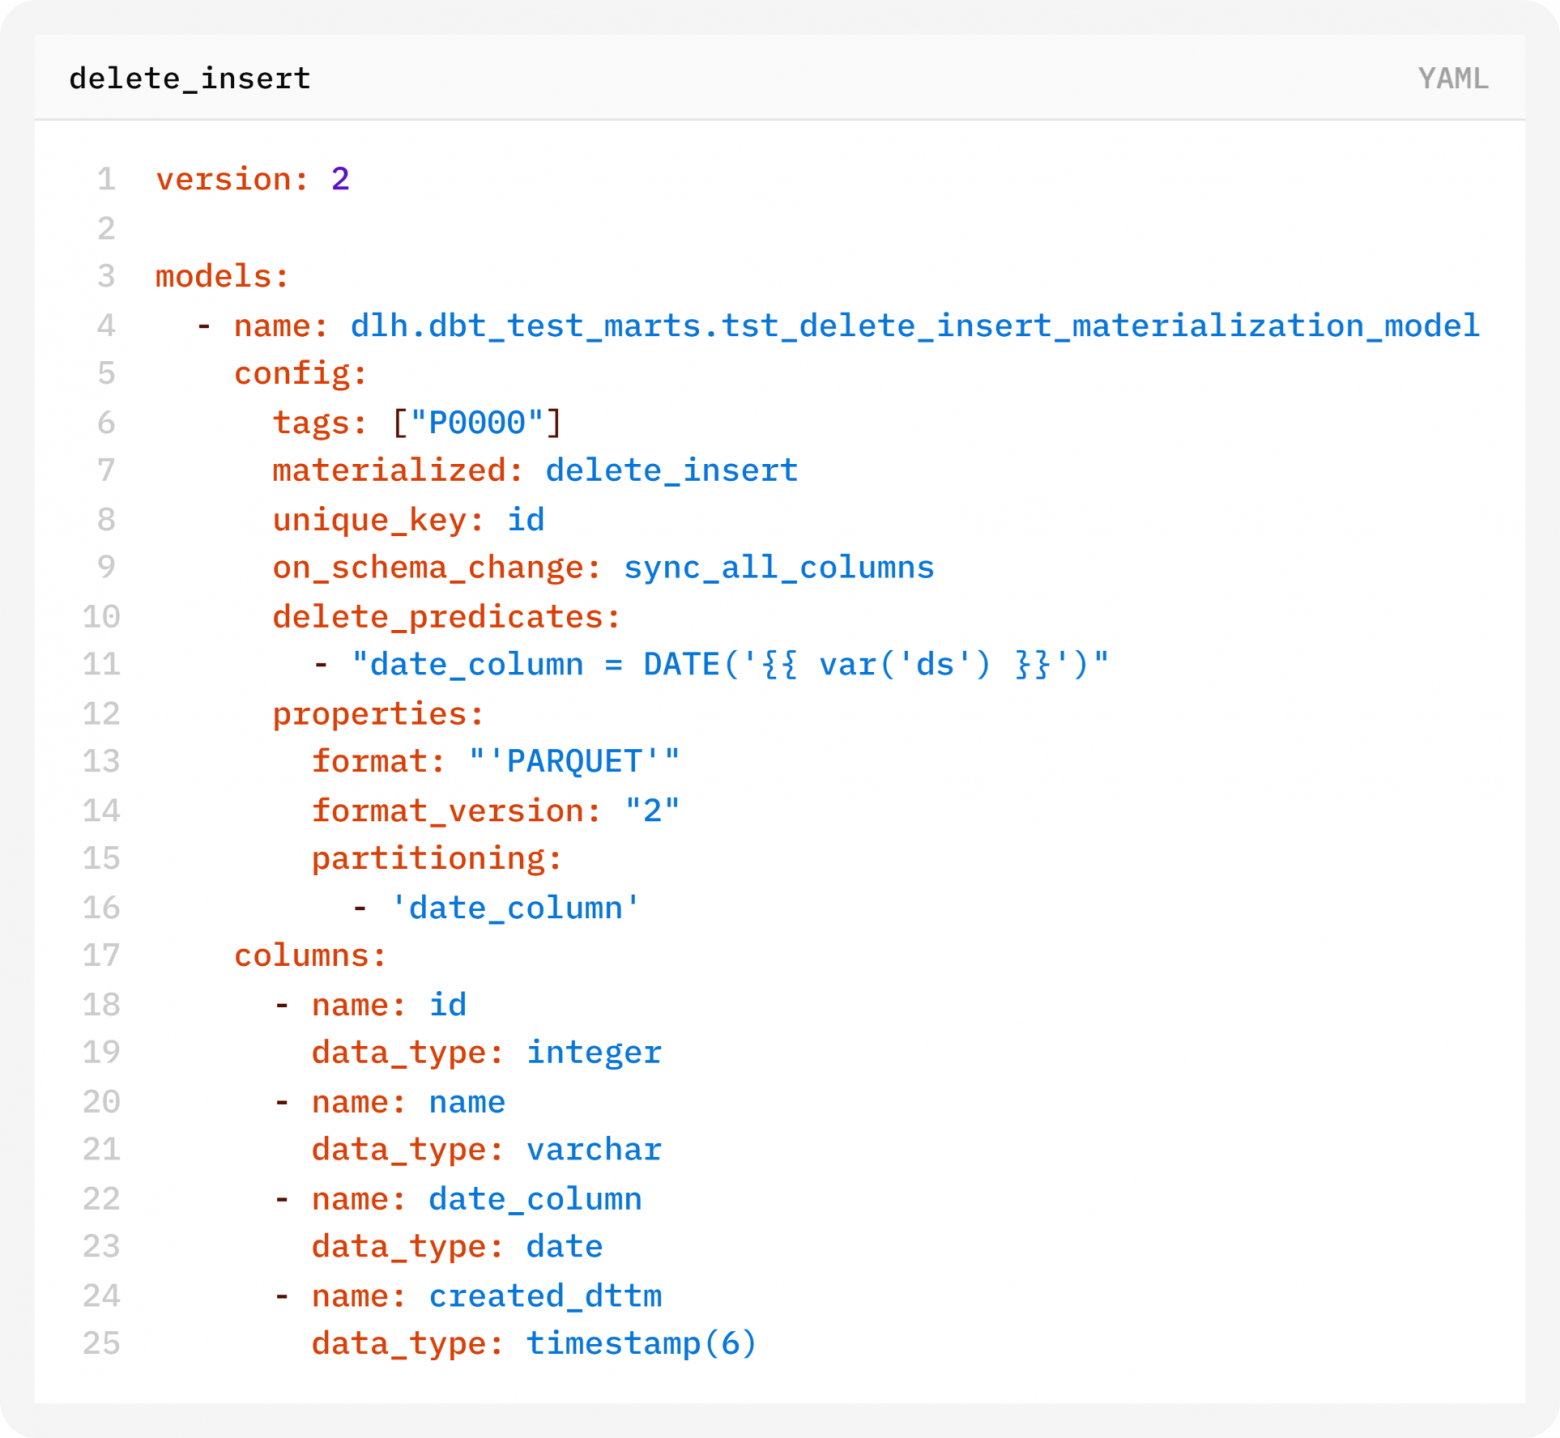
Автор модели должен проследить, чтобы фильтр удаления и вставляемый инкремент описывали один и тот же срез.
Сейчас DELETE и INSERT выполняются в отдельных транзакциях. Это существенное ограничение: если вставка завершится с ошибкой после успешного удаления, часть данных будет отсутствовать до восстановления.
Параметры моделей
В сборках на Greenplum мы активно использовали параметры функций. На DLH передаем параметры через dbt variables. Для шаблонизации используем Jinja с условиями, циклами и другими выражениями, в YAML-конфигурации DAG для этого есть параметр dbt_vars. Один набор моделей может запускаться в нескольких DAG с разными значениями переменных, например, для обработки разных временных интервалов.
Также передаем основные переменные контекста Airflow, включая логическую дату запуска.
Как организовали доступ к данным
Ролевая модель — обязательная часть нашей платформы. Когда вычисления разделены, а данные хранятся вместе, на разных кластерах должны действовать одинаковые правила доступа.
На DWH и DLH пользователи читают данные через представления. Если таблица содержит общедоступные и чувствительные атрибуты, мы создаем представления с разным набором колонок и назначаем соответствующие роли.
Для обычного чтения есть общая роль dataread-public, доступ к sensitive- и confidential-представлениям выдаем отдельно. Для сборки витрин и локальной разработки предусмотрены технические ETL- и sandbox-роли. Пользователи запрашивают доступ через внутренний IAM-сервис, владельцы данных и информационная безопасность согласовывают их запросы.
Сейчас разграничиваем доступ на уровне Trino. На основе соответствий между пользователями, группами и объектами создаем конфигурационные файлы и монтируем их в поды нужных кластеров, используя механизм file-based access control в Trino. Так одну ролевую модель можно передать на несколько инсталляций Trino. Пользователи получают доступ через кластеры, которыми мы управляем и на которых действуют эти настройки.
Ролевую модель на уровне каталога и других вычислительных движков нам еще предстоит развивать. Текущая схема рассчитана на доступ только через Trino.
Как наблюдаем за запросами и ищем причины задержек
Для базового анализа запросов мы используем Trino UI, в нем доступны статистика выполнения и план: можно посмотреть стадии запроса, чтение из S3 и запись данных.
При сопровождении сборок нам нужно связывать задачу Airflow и dbt-модель с конкретным SQL-запросом, поэтому мы дополнительно логируем query_id в задачах Airflow.
В нашей конфигурации dbt-trino идентификатор упавшего запроса было легко найти. Нас интересовали и успешные запросы, которые выполнялись слишком долго.
Найти запрос по тексту в Trino UI можно, но история ограничена. При активной работе dbt служебные запросы и обращения к метаданным быстро вытесняют нужную запись, поэтому мы экспортируем логи Trino в отдельное хранилище. В Grafana по идентификатору запроса можно получить статистику и данные для анализа, даже если запись уже исчезла из истории UI.
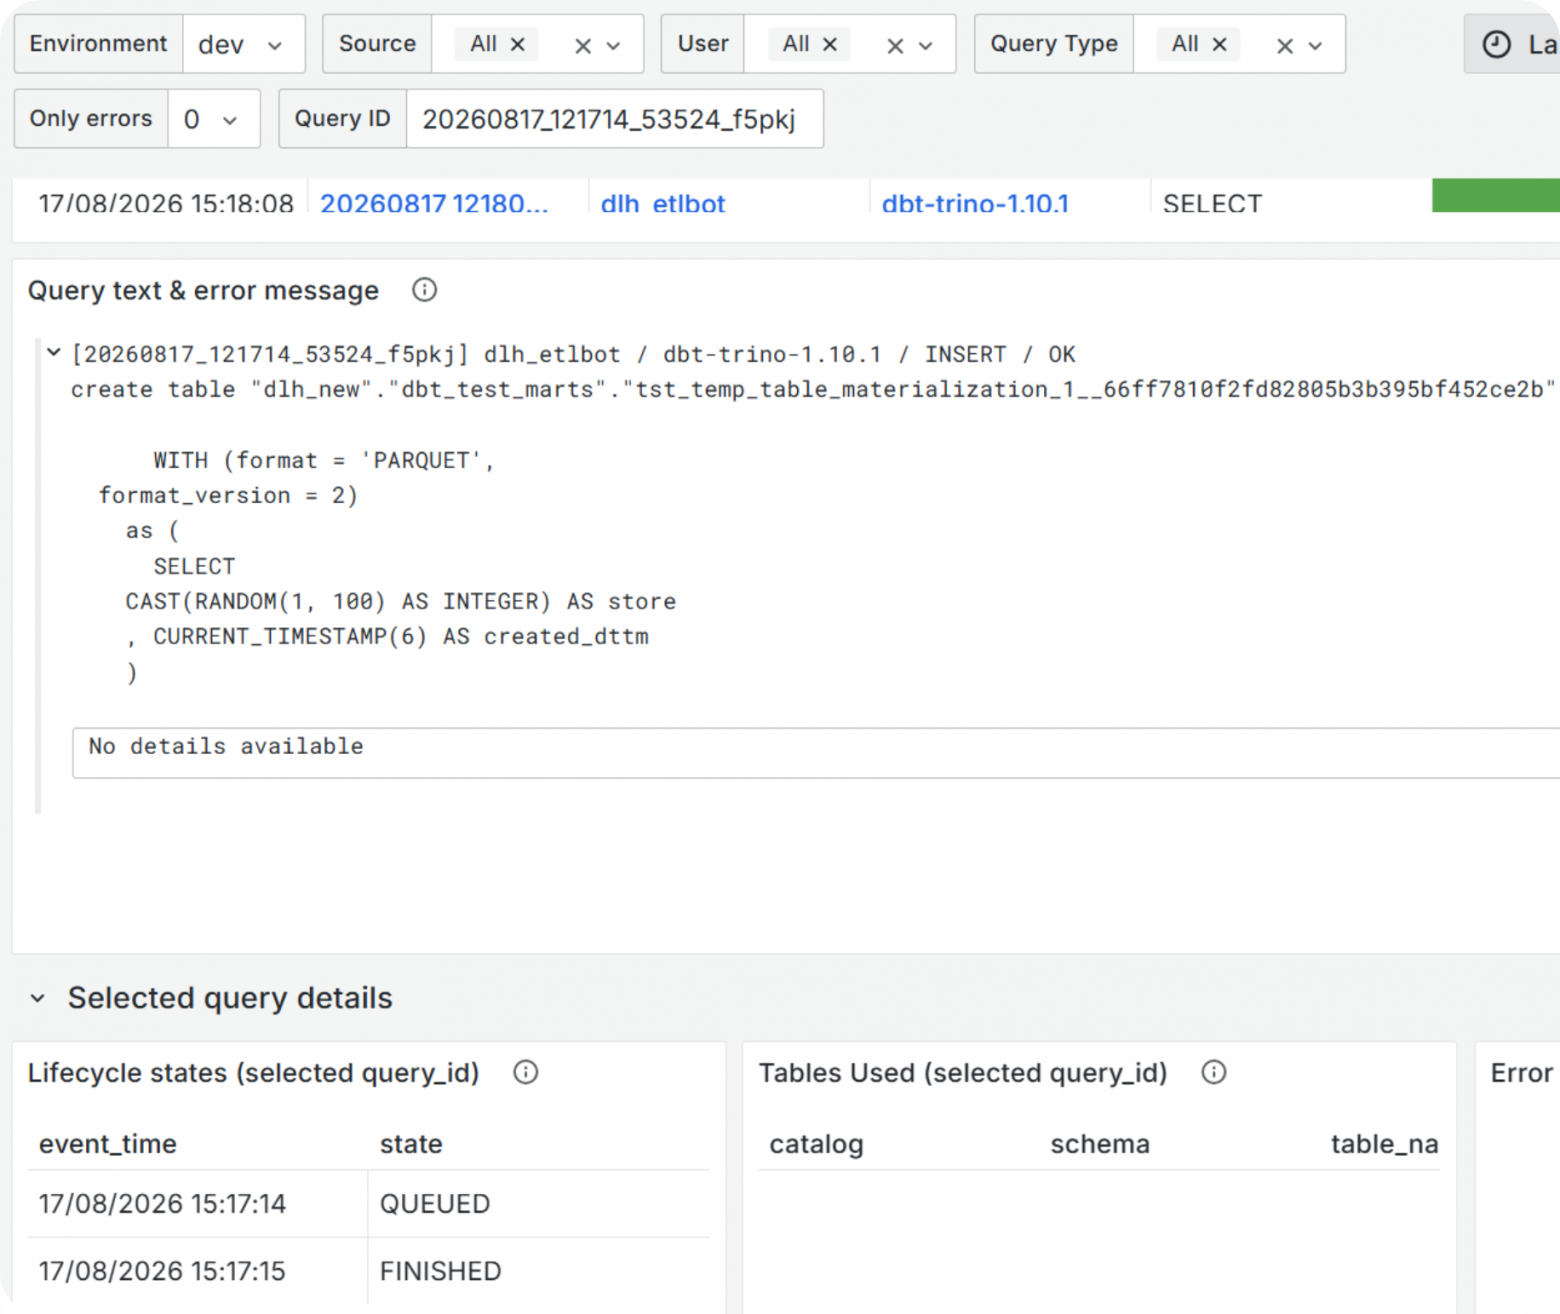
На дашбордах со статистикой по кластерам пользователи могут посмотреть нагрузку по своим схемам и учетным записям.
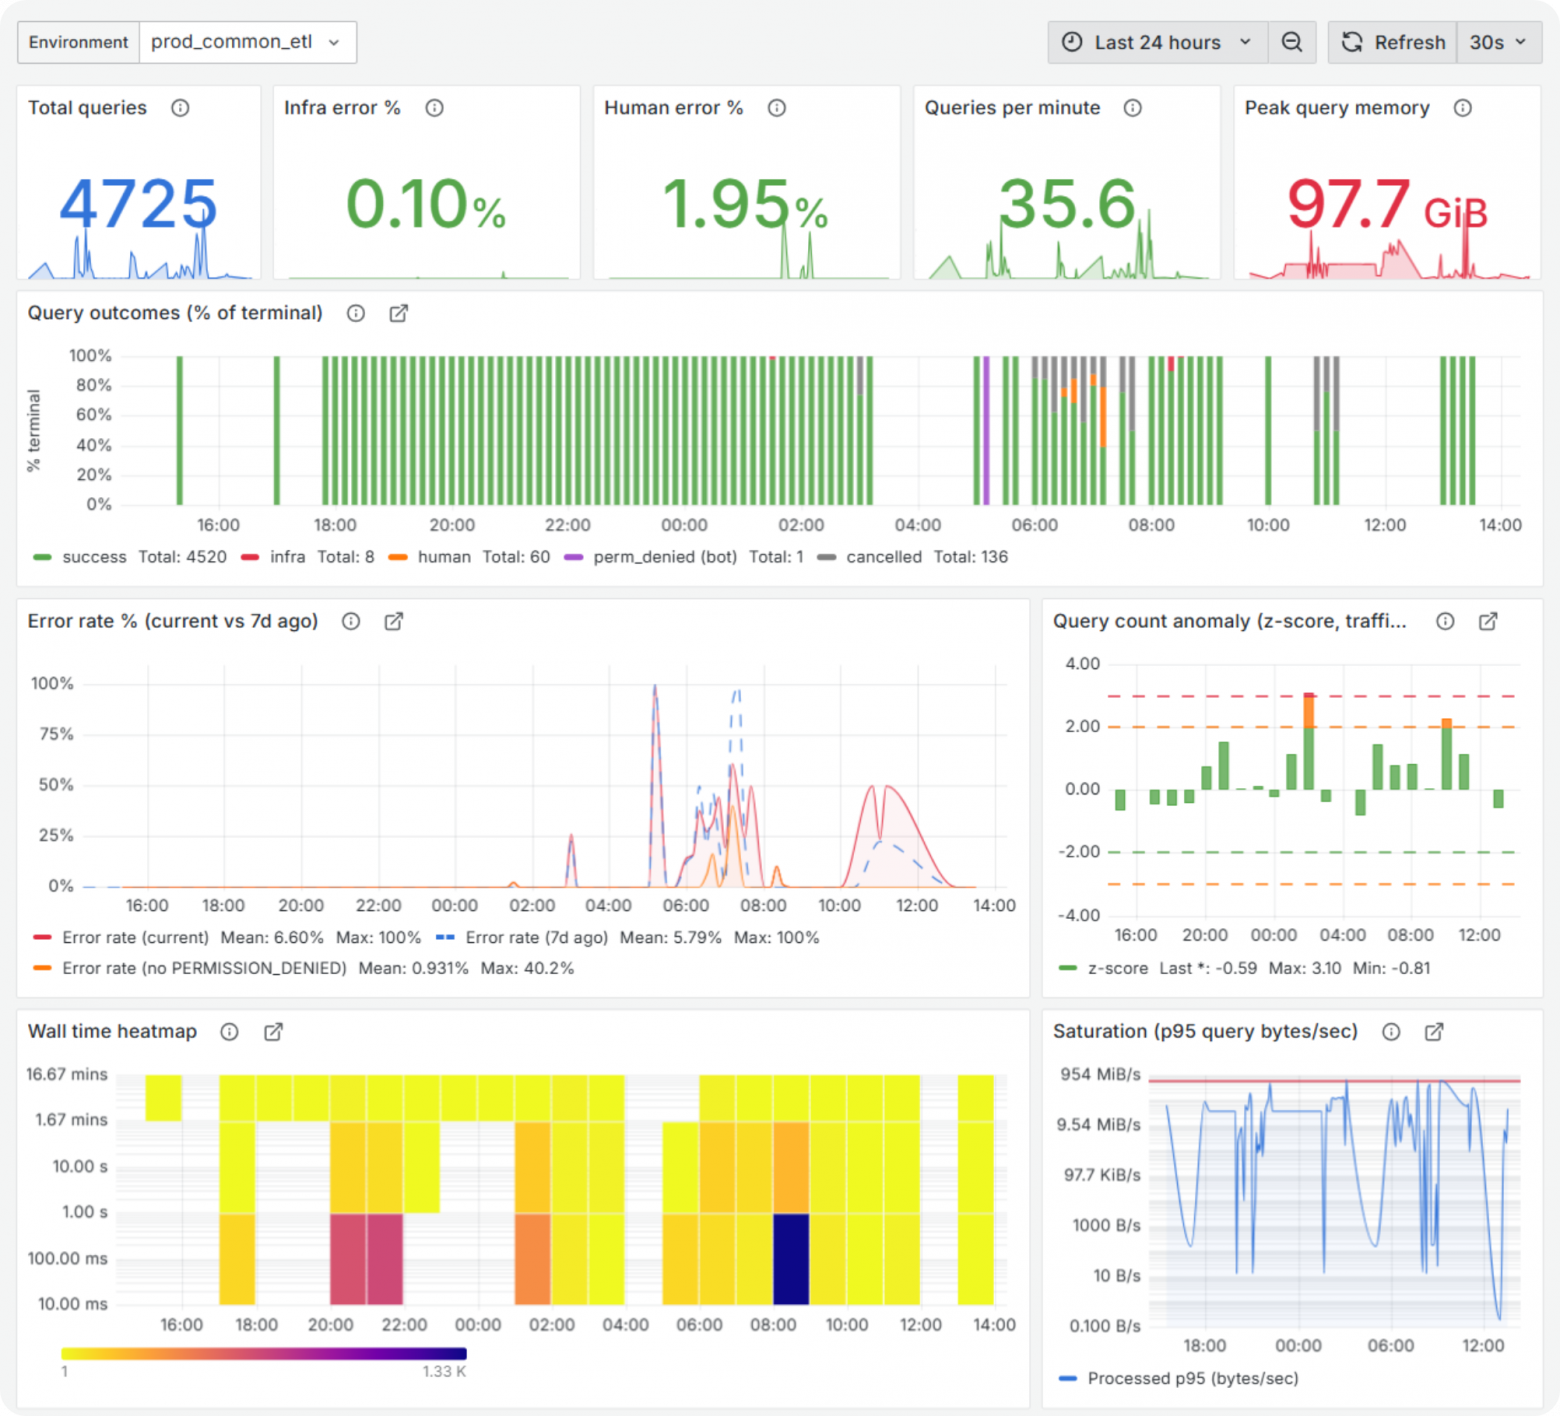
Например, рост доли ошибок утром — повод проверить, какие сборки запускаются в это время и с какими ошибками завершаются. Если ночью запросов стало необычно много, это помогает заметить изменение нагрузки и понять, где искать причину.
Если вас заинтересовал шаблон дашбордов мониторинга кластеров Trino в Grafana, то мы готовы поделиться им. Оставляйте запросы в комментариях к статье.
Почему обслуживание S3 стало частью процесса
Промежуточные материализации создают много объектов, после каждого DagRun часть таблиц удаляется, поэтому очистку каталога и хранилища нужно организовать заранее.
В нашей конфигурации DROP TABLE удаляет объект из каталога, а файлы данных и метаданных остаются в S3. Они продолжают занимать место, за которое мы платим.
Для базового обслуживания мы используем Nessie GC. Когда определяем, какие файлы можно удалить, учитываем сохраняемые ссылки и историю каталога. Эти механизмы описаны в документации Nessie.
Наш сервис находит файлы, на которые больше нет необходимых ссылок, и выставляет expiration rules на стороне облачного хранилища. Очистка выполняется асинхронно.
Внутри DAG группа dbt_task_group отвечает за выполнение моделей. Затем post_dbt_task_group запускает обслуживание каталога и S3, а задача drop_dbt_dagrun_temp_tables удаляет временные таблицы.
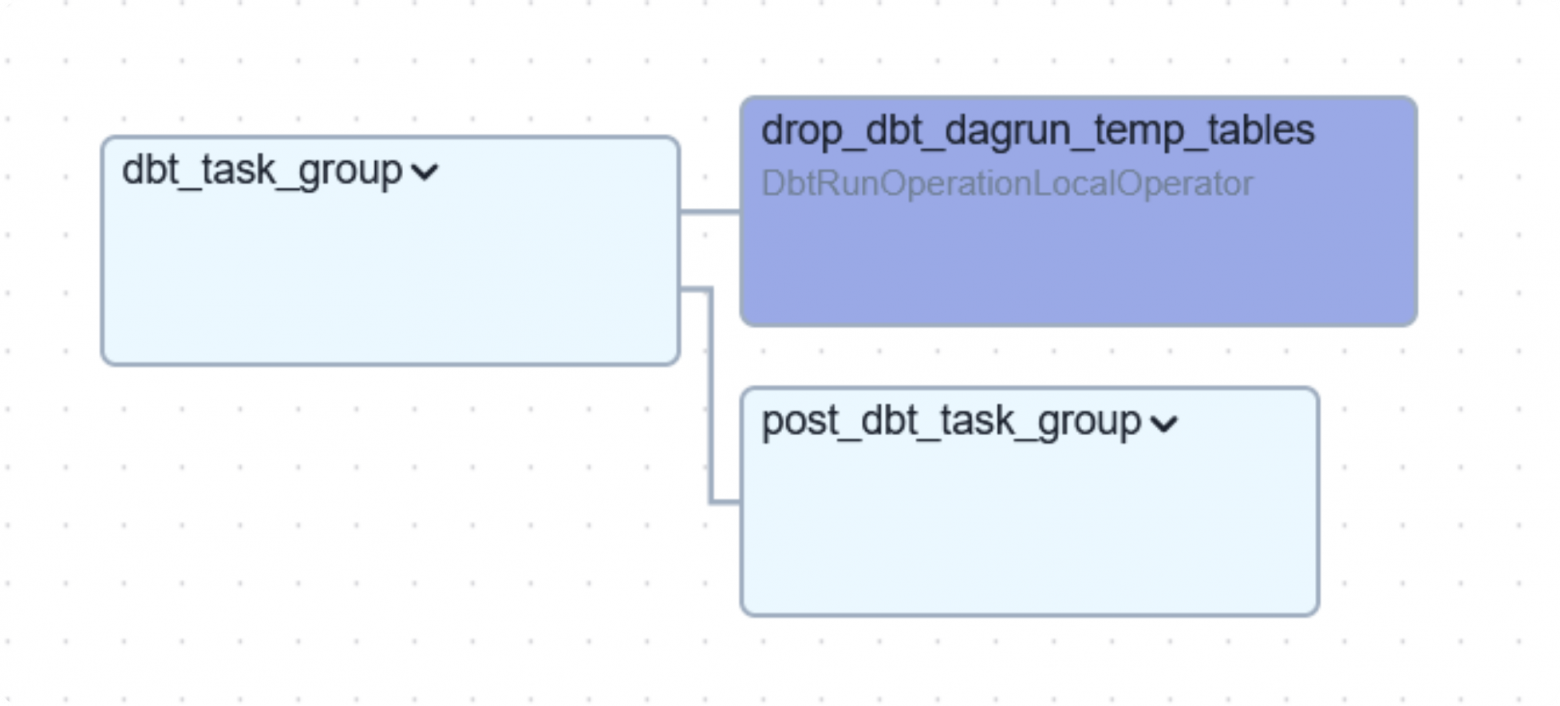
Сборка витрин запускает обслуживание через отдельный сервис. Он ставит дальнейшие операции в очередь задач, поэтому сборка не ждет, пока все файлы будут удалены. Для temp_table это особенно важно: после удаления временного объекта из каталога нужно очистить оставшиеся файлы.
Мы ожидаем, что по мере роста платформы нагрузка на обслуживание тоже будет расти. Если число таблиц и обновлений растет быстрее, чем сервис успевает их обрабатывать, могут накапливаться ненужные файлы, поэтому производительность этой части системы нужно оценивать вместе с производительностью ETL.
Что делаем с детальным слоем
На Greenplum у нас нет единой модели данных, а на DLH мы стараемся с самого начала задать общий подход к моделированию.
Для DDS выбрали Data Vault 2.0 и разрабатываем собственный фреймворк на базе AutomateDV. Планируем связывать объекты-хабы с бизнес-сущностями из дата-каталога.
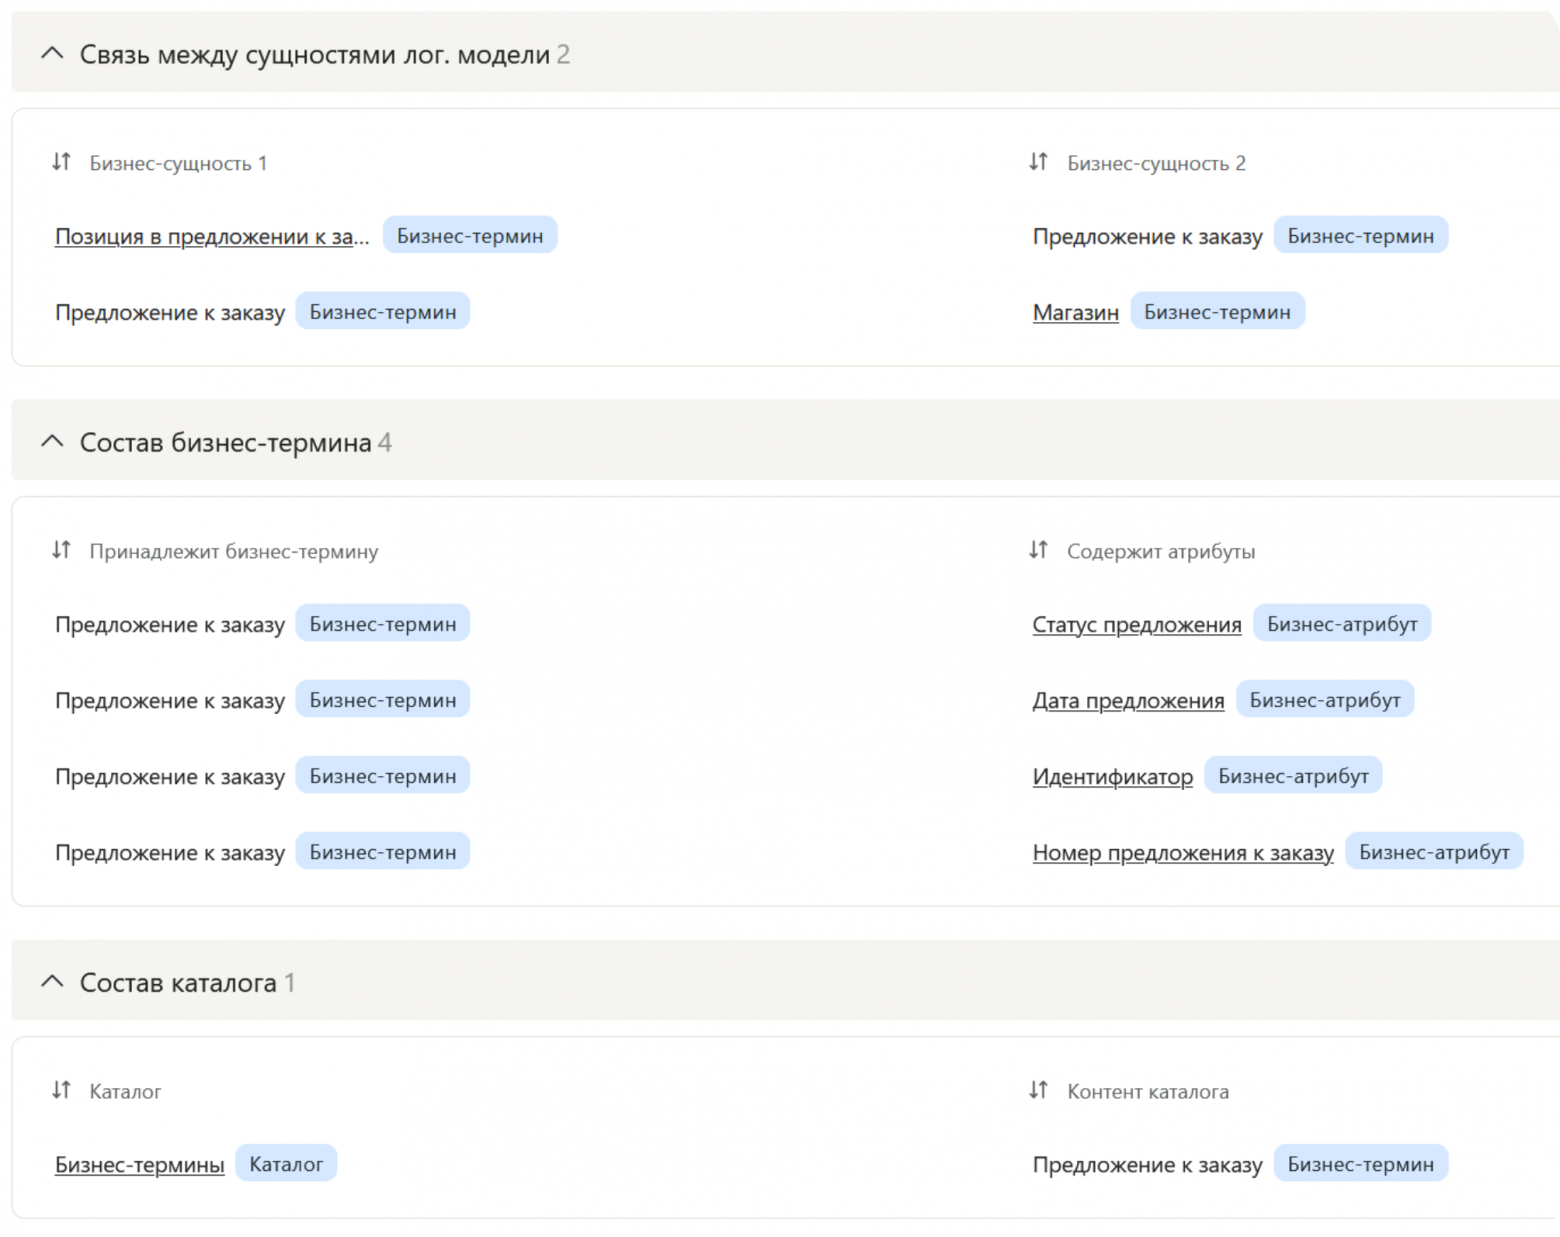
В ODS данные поступают без такого моделирования. DDS должен стать промежуточным детальным слоем, на основе которого можно собирать агрегированные marts, в том числе по схеме звезды.
Сейчас мы продолжаем работу над созданием детального слоя и хотим, чтобы он полностью соответствовал бизнес-терминам каталога и через него проходили все сборки, но пока это только цель, идеальный вариант на бумаге. Еще предстоит проверить, насколько эффективно будут работать сборки при увеличении числа соединений таблиц. При необходимости для DDS можно выделить отдельный кластер Trino с настройками под эту нагрузку.
Как организовали миграцию команд
После PoC мы начали с витрин, которые служат источниками для ключевых отчетов. Эта часть переноса уже выполнена. Теперь переходят остальные команды. Мы подготовили для них инструменты и документацию, а свои сборки они переносят сами.
В переходный период возможна параллельная работа DWH и DLH. Для этого нужны ресурсы на поддержку двух версий кода, поскольку изменения приходится вносить в обе сборки. Место для хранения данных тоже потребуется дополнительно.
Данные источников уже дублируются: мы одновременно поддерживаем исходный процесс с Parquet и новый процесс с Iceberg.
В дальнейшем планируем собирать marts на DLH и снять эту вычислительную нагрузку с Greenplum. Для сценариев, которым потребуется чтение из DWH, предполагаем экспортировать туда готовые витрины.
Полностью отказываться от DWH сейчас не планируем. Продолжаем работать с рисками: хотим использовать разные вычислительные контуры для критичной отчетности и при необходимости переключаться между ними.
Что показывают первые результаты
Мы уже перенесли в Data Lakehouse 40 из 290 интеграций источников. Объем ODS и marts составлял около 5 ТБ, а сборка витрин для критической отчетности занимала в среднем на 7% больше времени относительно DWH.
Этот объем учитывает работающую очистку ненужных файлов. В него может входить и дублирование данных на время перехода.
Рост времени сборки мы оценили на перенесенных ключевых витринах. Делать по этой выборке вывод об эффективности всех сборок пока рано: основная миграция еще впереди.
В текущем процессе есть несколько мест, которые нужно оптимизировать. Большая функция Greenplum после переноса может превратиться в несколько dbt-моделей и задач Airflow. Чем больше задач, тем сильнее на время сборки влияют планирование и очереди. Ожидание возможно и на стороне Trino.
Заметную долю времени также занимают инициализация dbt и обращения к метаданным. В одном из наблюдаемых сценариев задача выполнялась около полутора минут, а SQL самой модели — около пяти секунд. Поэтому, разбираясь с задержкой, нужно смотреть весь путь выполнения задачи.
Отдельных бенчмарков задержек BI-доступа у нас не было. Мы пока не наблюдали случаев, когда отчеты долго обновлялись именно из-за разделения compute и storage. Когда объемы вырастут, этот сценарий нужно будет оценить отдельно.
Что предстоит проверить дальше
Уже сейчас благодаря разделению хранения и вычислений мы можем распределять разные типы нагрузки по отдельным кластерам. Мы сохранили SQL-интерфейс, YAML-конфигурации и работу команд через общий репозиторий. С ветками Nessie мы изменили процесс тестирования и доставки кода.
Для переноса привычных сборок потребовались собственные материализации, очистка временных объектов, обслуживание S3, дополнительное логирование и сквозная ролевая модель. На эти задачи приходится значительная часть работы над платформой.
С ростом числа пользователей предстоит проверить очереди Airflow и Trino, нагрузку на каталог, обслуживание файлов и эффективность DDS. Зависимость от облачного S3 также остается одним из рисков текущей архитектуры.
Мы рассматриваем обновление или замену отдельных компонентов, включая каталог, и продолжаем работу над переходом на Airflow 3.x. При каждом таком изменении придется проверить доступ, обслуживание и совместимость с процессом разработки.
Мы уже знаем, какие части привычного процесса удалось сохранить и что пришлось доработать для сборки витрин на DLH. Теперь предстоит проверить этот подход на остальных командах и нагрузках. С переносом новых сборок будет больше данных для оценки производительности.

Комментарии 0