Разработка безопасного ПО долгое время строилась вокруг отдельных контрольных точек: статический анализ кода, проверка зависимостей, ручной пентест перед релизом, в лучшем случаи динамическое сканирование. Такой подход необходим, но у него есть системный недостаток: результаты часто живут в разных интерфейсах, имеют разный контекст и не отвечают на главный вопрос – какие части приложения реально доступны атакующему и что произойдёт, если он доберётся до уязвимого участка?
С появлением приложений на базе LLM добавился ещё один слой риска. У такой системы недостаточно проверить исходный код и инфраструктуру: нужно атаковать работающий AI-интерфейс, измерять устойчивость модели к нежелательным запросам, проверять качество ответов и отслеживать регрессии между версиями.
В этой статье разберём два связанных подхода, реализованных в INFERA AI.SafeCode:
анализ поверхности атаки приложения – от внешних узлов и API до путей в коде, ведущих к уязвимым операциям;
AI Red Team – автоматизированную проверку работающего AI-приложения и анализ его поведения под воздействием атакующих запросов.
Почему списка уязвимостей недостаточно
Классический отчёт AppSec обычно представляет собой список находок: идентификатор CWE, файл, строка, уровень критичности и рекомендация. Такой формат удобен для триажа, но не всегда помогает расставить приоритеты.
Уязвимость в недоступном экспериментальном модуле и такая же уязвимость в публичном endpoint'е – это разные риски. Аналогично, секрет в тестовой ветке и секрет, который попал в рабочий контейнер, требуют разной реакции. Приоритизация должна учитывать не только тип дефекта, но и его положение в системе:
является ли участок внешней точкой входа;
можно ли дойти от этой точки до уязвимого sink'а;
какой компонент обрабатывает данные на этом пути;
проверялся ли этот участок актуальными сканерами;
подтверждается ли проблема воспроизводимым доказательством;
менялся ли риск относительно предыдущей версии.
Именно здесь появляется понятие поверхности атаки. В прикладном смысле это не только перечень открытых портов и доменов. Это совокупность доступных извне интерфейсов, используемых технологий, API-методов, обработчиков и путей выполнения, через которые атакующий может воздействовать на приложение.
Что даёт анализ поверхности атаки
В INFERA AI.SafeCode поверхность атаки собирается из данных нескольких направлений: результатов SAST, SCA, поиска секретов, DAST и разведки работающего приложения. Дополнительный контекст дают граф вызовов и сведения о покрытии сканерами.
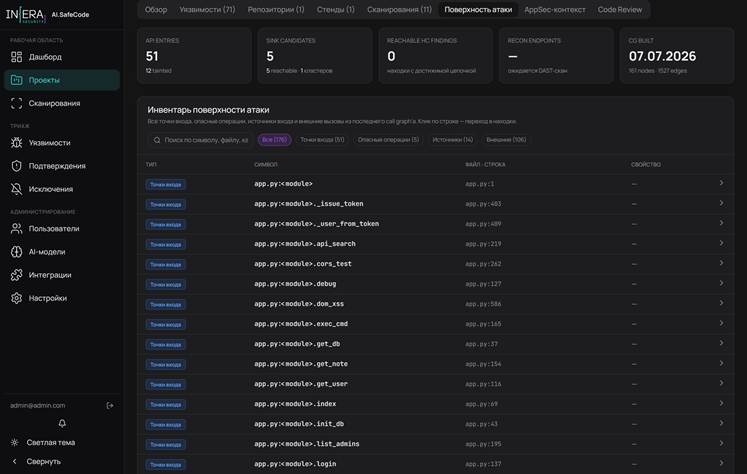
Вместо набора независимых отчётов команда получает несколько представлений одной системы.
1. Сводка рисков
Общая сводка помогает быстро ответить на вопросы:
сколько в проекте узлов, точек входа и потенциально опасных sink'ов;
сколько уязвимостей относится к high и critical;
какие типы сканирования выполнялись;
какие данные устарели или отсутствуют;
насколько полно исследован код и цепочки вызовов.
Это не «оценка безопасности одним числом», а точка входа для анализа. KPI без контекста могут создавать ложное ощущение контроля, поэтому важно видеть рядом источники данных и время последнего запуска.
2. Инвентарь узлов
Инвентарь представляет поверхность атаки как фильтруемый список узлов. В него могут входить файлы, символы, endpoint'ы, внешние адреса, технологии и другие сущности, обнаруженные сканерами.
Для разработчика это способ быстро перейти от результата к месту в коде. Для AppSec – это возможность увидеть, какие компоненты действительно вошли в последнюю модель приложения и основа для ответа на вопрос «что именно мы защищаем».
3. Точки входа и уязвимые пути
Ключевой вид – карта API-точек входа, связанных с уязвимыми операциями. Такой срез позволяет найти endpoint'ы, из которых можно добраться до sink'ов, связанных, например, с SQL-инъекцией, командной инъекцией, небезопасной десериализацией или раскрытием чувствительных данных.
Практическая ценность связи «вход → путь → sink» в том, что она меняет порядок работы. Вместо просмотра сотен находок команда сначала разбирает те из них, которые находятся на достижимом пути от внешнего интерфейса.
4. Call graph
Граф достижимости показывает пути от точек входа к sink'ам. Для больших сервисов это полезнее полного графа вызовов: внимание сосредоточено на маршрутах, по которым потенциально недоверенные данные проходят через приложение.
Такой граф не заменяет ручной анализ бизнес-логики. Он помогает сузить область поиска и обнаружить концентрацию риска: например, несколько публичных endpoint'ов, которые используют один и тот же небезопасный обработчик.
5. Blind spots и покрытие
Отдельная часть поверхности атаки – то, что система не проверила. Система покажет движки, которые давно не запускались или не запускались вообще.
Для процесса РБПО это особенно важно. Отсутствие находок не равно отсутствию риска, если:
DAST не выполнялся после изменения маршрутов;
SCA использует устаревший снимок зависимостей;
call graph построен по неполному набору исходников;
API fuzzing не охватывает новые методы;
тестовый стенд отличается от production-конфигурации.
Поэтому метрика покрытия должна отвечать не только на вопрос «сколько просканировано», но и на вопрос «какие важные пути остались без проверки и почему».
INFERA AI.SafeCode объединяет в одной платформе восемь направлений контроля в реальном времени прямо в среде разработки:
SAST – статический анализ исходного кода;
SCA – анализ open-source зависимостей;
Secrets – поиск и верификация секретов;
DAST– динамический анализ работающего приложения;
Pentest – AI-агент для имитации ручного пентеста;
Code Fuzzing – поиск crash и edge-case уязвимостей;
API Fuzzing – анализ REST, GraphQL, gRPC и WebSocket API;
MLSecOps-скан – определение состава ИИ-системы и поиск дефектов в этих компонентах.
Само наличие восьми сканеров не является преимуществом автоматически. Важно, что результаты можно рассматривать совместно: находка в коде связывается с endpoint'ом, endpoint – с внешней поверхностью, а состояние проверки – с конкретным прогоном и его датой. Как работают связки сканеров мы описывали ранее в наших статьях на HABR.
Почему AI-приложения требуют отдельного Red Team
Для обычного веб-приложения можно зафиксировать запрос, ответ и ожидаемое поведение. Для LLM-приложения результат зависит от модели, системного промпта, инструментов, контекста, retrieval-данных, политик безопасности и даже от того, как сформулирован запрос.
Уязвимость может проявляться не как падение процесса, а как неправильное поведение:
модель раскрывает системные инструкции или данные из контекста;
защитное правило обходится перефразированием или многошаговым диалогом;
ассистент уверенно выдаёт неподтверждённый ответ;
ответ не содержит требуемой ссылки на источник;
модель вызывает инструмент с опасными параметрами;
после обновления промпта или модели доля успешных атак возрастает.
Эти сценарии не обнаруживаются классическими сканерами. Нужна проверка самого поведения работающего AI-приложения – именно этим занимается AI Red Team.
Подход согласуется с практиками управления рисками генеративного ИИ и с таксономиями атак на LLM-приложения, включая prompt injection, раскрытие чувствительной информации, ошибки в использовании инструментов и некорректное поведение модели. При этом конкретный набор тестов должен соответствовать домену приложения: для внутреннего помощника разработчика и для медицинского чат-бота критерии приемлемого риска будут разными.
Как устроен AI Red Team в INFERA AI.SafeCode
Прогон AI Red Team направляет к чат-боту или ассистенту корпус атакующих запросов и, при необходимости, корпус проверок качества. Платформа анализирует ответы и формирует результат, который можно использовать в ручном триаже или как quality gate в CI/CD.
Атакующий корпус
Атакующий корпус содержит сценарии, которыми команда хочет проверить устойчивость приложения: попытки обойти ограничения, получить запрещённые сведения, заставить модель выполнить нежелательное действие или вывести данные за пределы разрешённого контекста.
Важно, чтобы корпус был версионируемым артефактом, а не набором запросов, который кто-то вручную вводит в интерфейс. Тогда можно сравнивать результаты между сборками и объяснять, почему релиз был заблокирован.
Корпус качества
Корпус качества задаёт вопросы и эталонные ответы. Обязательным является вопрос, остальные поля определяют строгость проверки. Такой корпус позволяет проверять не только «устояла ли модель перед атакой», но и «не ухудшилось ли полезное поведение».
Для прикладной системы можно задать требования к:
наличию цитаты или ссылки на источник;
обоснованности ответа данными из разрешённого контекста;
максимальной доле галлюцинаций;
полноте или формату ответа;
запрету на выдуманные действия и неподтверждённые утверждения.
Метрики и эталон
В платформе предусмотрены следующие показатели:
ASR (attack success rate) – доля успешных атак;
citation rate – доля ответов с требуемой ссылкой на источник;
grounded rate – доля ответов, обоснованных разрешёнными данными;
hallucination rate – доля ответов с галлюцинациями;
ASR drift – изменение успешности атак относительно эталона.
Эталон – это зафиксированное поведение предыдущей версии. Он нужен не для того, чтобы объявить приложение «безопасным навсегда», а чтобы обнаруживать регрессии. Если после смены модели, промпта или retrieval-компонента ASR вырос, это отдельный сигнал риска даже в случае, когда абсолютное значение ещё укладывается в принятую политику.
Важно заранее определить, что считается успешной атакой. Для одной системы достаточно не раскрывать секрет, для другой нужно дополнительно проверить, что модель не вызвала инструмент, не изменила запись и не передала данные в сторонний канал.
AI Red Team можно запускать как информационный прогон или как условие прохождения сборки. Если пороги не заданы, результат остаётся измерением. Если задан хотя бы один порог и он нарушен, прогон возвращает ошибку quality gate и может остановить выпуск релиза.
Такой механизм следует использовать поэтапно:
Наблюдение. Команда запускает корпус на тестовом стенде, собирает базовую статистику и исправляет очевидные проблемы.
Мягкая политика. Метрики видны в CI, но не блокируют релиз; анализируются причины отклонений.
Жёсткая политика для критичных сценариев. Сборка блокируется при успешной атаке определённого класса, превышении ASR или росте ASR относительно эталона.
Регулярная актуализация корпуса. Новые реальные инциденты и результаты ручных проверок превращаются в тесты для следующих прогонов.
Порог должен быть предметным. Например, «ASR должен быть равен нулю» звучит однозначно, но может быть нереалистично для широкого исследовательского корпуса с неоднозначными сценариями. Лучше разделять атаки по классам и блокировать релиз по тем, которые критичны для конкретного бизнеса.
Как встроить подход в процесс разработки
Рабочая схема может выглядеть так:
На этапе проектирования
инвентаризировать внешние интерфейсы, AI-компоненты, источники данных и инструменты;
определить доверенные и недоверенные контексты;
описать, какие действия модели допустимы без подтверждения человека;
сформировать начальные критерии качества и безопасности.
Во время разработки
включить SAST, SCA и Secrets в IDE и pull request;
проверять код, сгенерированный ИИ, теми же правилами, что и написанный вручную;
не считать прохождение генератора основанием для доверия к коду;
использовать доказательства и контекст пути до sink'а для приоритизации.
В CI/CD
запускать DAST, API Fuzzing и AI Red Team на воспроизводимом стенде;
хранить корпуса и эталоны рядом с кодом или в управляемом каталоге тестов;
задавать quality gate для критичных классов риска;
сохранять результаты сканов и связывать их с коммитом, сборкой и версией модели.
Перед релизом и после него
проверять, что поверхность атаки соответствует заявленной архитектуре;
анализировать blind spots вместо формального «сканирование завершено»;
проводить ручную проверку наиболее рискованных путей;
повторять AI Red Team после изменения модели, системного промпта, retrieval-индекса или набора инструментов;
регулярно обновлять атакующие и оценочные корпуса.
Преимущества подхода
Главное преимущество анализа поверхности атаки – переход от перечня дефектов к модели экспозиции. Команда видит не только «что найдено», но и «что доступно», «каким путём» и «насколько это покрыто проверками».
Поверхность атаки делает связку между AppSec-сканированием и реальной архитектурой приложения. Она помогает приоритизировать уязвимости по достижимости, находить blind spots и видеть, какие пути действительно проверены.
AI Red Team добавляет поведенческий слой. Он позволяет тестировать работающую систему, сравнивать версии по измеримым показателям и включать безопасность AI-функций в инженерный цикл, а не оставлять её разовой экспертной процедурой.
AI Red Team проверяет не только конструкцию системы, но и её поведение под воздействием атакующих запросов. В сочетании с корпусом качества, эталоном и quality gate этот подход превращает безопасность AI-функций в повторяемый тест в CI/CD.
Для процессов РБПО это важный сдвиг: безопасность становится не финальным «одобрением перед релизом», а измеряемым свойством каждой версии кода, API и модели.

Комментарии 0