5 ноября 2026 года Thinking Machines Lab представила Inkling 2 Small, мультимодальную языковую модель с 594 млрд параметров, из которых при обработке одного токена активируются около 17 млрд. В анонсе особенно выделялась скорость предобучения: 8,4 трлн токенов всего за 68 часов на оборудовании NVIDIA GB300 NVL72 с использованием четырехбитного формата NVFP4.
Цифра выглядит необычно даже на фоне современных MoE-моделей. Но 68 часов относятся только к первому этапу подготовки Inkling 2 Small. Далее последовали еще три этапа обучения на дополнительных данных, а затем девятидневный Reinforcement Learning на 2048 GPU с более чем 17 млн траекторий.
Получившаяся модель набрала 31 балл в Artificial Analysis Intelligence Index и заметно обошла предыдущее поколение в программировании, работе с изображениями и многошаговых агентных задачах. Вместе с качеством выросли продолжительность работы и количество генерируемых токенов, поэтому оценивать новинку только по бенчмаркам было бы неправильно.
Разберем архитектуру Inkling 2 Small, процесс обучения, результаты независимых испытаний и практические ограничения. За основу взяты официальный технический анонс Thinking Machines, Model Card, оценки Artificial Analysis и Vals AI.
594 млрд параметров, но работают только 17 млрд
Inkling 2 Small построена на архитектуре Mixture-of-Experts (MoE). Вместо одной большой полносвязной сети в определенных слоях используются наборы специализированных экспертных блоков, а маршрутизатор выбирает, какие из них задействовать для обработки конкретного токена.
У модели 48 слоев Transformer, 384 эксперта и маршрутизация к восьми экспертам. Механизм внимания сочетает локальные и глобальные слои, что позволяет обрабатывать контекст разной длины без необходимости использовать одинаково дорогое глобальное внимание на каждом этапе.
Параметр | Inkling 2 Small |
|---|---|
Архитектура | Decoder-only Transformer, sparse MoE |
Общее количество параметров | 594 млрд |
Активных параметров на токен | 17 млрд |
Количество слоев | 48 |
Количество экспертов | 384 |
Выбираемых экспертов | 8 |
Механизм внимания | Гибрид локального и глобального |
Визуальный энкодер | 292 млн параметров |
Контекстное окно | До 1 млн токенов |
Входные данные | Текст, изображения |
Выходные данные | Текст |
Поддерживаемые числовые форматы | MXFP8, NVFP4 |
По отношению к общему размеру модели активные параметры составляют примерно 2,86%. Это позволяет существенно сократить объем вычислений на токен относительно плотной модели аналогичного общего размера. Однако долю активных параметров нельзя напрямую использовать как точную оценку вычислительной стоимости: необходимо учитывать attention, маршрутизацию и другие компоненты.
Есть и менее очевидное следствие. Хотя Inkling 2 Small задействует около 17 млрд параметров на токен, для обычного исполнения требуется хранить гораздо больше весов, поскольку разные токены могут обращаться к разным экспертам.
При четырехбитном хранении 594 млрд параметров занимали бы приблизительно 297 ГБ без учета дополнительной информации. В 16-битном представлении теоретический объем увеличился бы почти до 1,19 ТБ. Это нижние арифметические оценки: реальное потребление памяти включает коэффициенты масштабирования, KV-кеш, визуальный энкодер и служебные структуры. Поэтому 17 млрд активных параметров не делают Inkling 2 Small моделью для обычного ноутбука. Архитектура уменьшает вычислительную нагрузку, но сама по себе не решает вопрос хранения полного набора весов.
Отдельного внимания заслуживает мультимодальность. Изображения обрабатываются визуальным энкодером на 292 млн параметров, основанным на Perception Encoder. Команда использует патчи размером 20×20 пикселей и пространственное объединение 2×2, после чего визуальные представления вместе с текстовыми токенами обрабатываются декодером.
Такой подход позволяет Inkling 2 Small анализировать скриншоты, документы, интерфейсы и изображения в рамках одной последовательности. При этом модель не генерирует изображения напрямую: ее выходной модальностью остается текст. Создание веб-страниц, трехмерных сцен и других визуальных объектов происходит через генерацию кода и взаимодействие с инструментами.
Предобучение за 68 часов: какую роль сыграл NVFP4
Самая заметная техническая особенность анонса связана с низкоточным обучением. По данным Thinking Machines, начальный этап предобучения Inkling 2 Small занял 68 часов, за которые модель обработала 8,4 трлн токенов естественного языка, программного кода и визуальных данных. Для этого использовались стойки NVIDIA GB300 NVL72, обеспечивающие высокую степень параллелизма экспертов. Обучение проходило непосредственно в NVFP4, четырехбитном формате чисел с плавающей точкой, поддерживаемом архитектурой NVIDIA Blackwell.
NVFP4 представляет число четырьмя битами: одним битом знака, двумя битами экспоненты и одним битом мантиссы. Такая конфигурация обозначается E2M1. Поскольку четырех бит недостаточно для точного представления широкого диапазона значений, формат использует дополнительные коэффициенты масштабирования.
В документации NVIDIA описан механизм иерархического масштабирования. Каждая группа из 16 последовательных значений получает локальный коэффициент FP8, а для всего тензора применяется дополнительный глобальный коэффициент FP32. Это помогает сохранять полезный динамический диапазон при низкой разрядности.
В том же наборе технологий предусмотрены стохастическое округление и методы сглаживания выбросов. Они используются для уменьшения систематических ошибок квантования, которые способны накапливаться во время обучения.
Здесь нужно различать два процесса. Один вариант предполагает обучение модели в более высокой точности с последующей квантизацией весов до четырех бит. Другой использует низкую точность непосредственно в вычислениях при обучении, что сложнее с точки зрения численной стабильности. Thinking Machines заявляет именно второй подход. Это позволяет задействовать возможности Blackwell для повышения вычислительной эффективности и уменьшения объема передаваемых данных.
Однако подробный рецепт NVFP4, использованный при подготовке Inkling 2 Small, пока полностью не раскрыт. В анонсе разработчики обещают отдельную публикацию с дополнительными техническими подробностями.
Поэтому утверждать, что все ускорение было обеспечено исключительно переходом на NVFP4, пока нельзя. В результат внесли вклад оборудование GB300, параллелизм экспертов, организация вычислений и другие инфраструктурные оптимизации. Для точной оценки потребовался бы контролируемый эксперимент с идентичной моделью, обученной в альтернативном формате на сопоставимых ресурсах.
Четыре этапа предобучения и девятидневный RL
После первых 68 часов команда продолжила обучать Inkling 2 Small, постепенно изменяя качество данных, длину контекста и характер решаемых задач.
Разработчики описывают четыре последовательных этапа, обозначенных H1–H4.
Этап | Объем данных | Особенности |
|---|---|---|
H1 | 8,4 трлн токенов | Начальное предобучение, 68 часов, NVFP4 |
H2 | 3,8 трлн токенов | Более качественные и свежие данные, контекст 512K |
H3 | Около 320 млрд токенов | Рассуждения и агентные траектории, контекст 1M, повторное использование части предобучающих данных |
H4 | Около 34 млрд токенов | Отобранные высококачественные агентные траектории |
Суммарный объем только первых двух этапов составляет 12,2 трлн токенов. Дополнительные данные H3 и H4 увеличивают обработанный объем, но точный совокупный показатель нельзя получить простым сложением приведенных цифр: для H3 отдельно упоминается повторное использование предобучающих данных без полного количественного описания.
Интересно и происхождение данных на поздних этапах. Значительная часть агентных траекторий H3 и H4 была получена с помощью более ранних моделей, включая Kimi K3 и собственные разработки Thinking Machines. Затем эти траектории фильтровали по корректности и соответствию требованиям безопасности.
Такая подготовка позволяет использовать результаты более зрелых моделей для обучения новой системы сложным последовательностям действий. Вместо того чтобы ограничиваться предсказанием следующего токена, модель получает примеры решения задач, требующих нескольких шагов, обращения к инструментам и проверки промежуточного результата.
После H4 команда приступила к масштабному Reinforcement Learning.
Для предыдущего поколения Inkling использовались раздельные RL-проходы для рассуждений и агентных задач, а результаты объединялись с помощью distillation от нескольких учителей. В Inkling 2 Small исследователи перешли к одному совместному RL-проходу, включающему разные категории задач.
Параметр основного RL | Значение |
|---|---|
Продолжительность | 9 дней |
Количество GPU | 2048 |
Шагов оптимизации | 1075 |
Rollout-траекторий | Более 17 млн |
Обработанных токенов | Более 3 трлн |
Вычисления | Более 4 × 10²³ FLOPs |
Медианная длина траектории | 43 тыс. токенов |
99-й процентиль длины | 1,5 млн токенов |
Под rollout здесь понимается последовательность действий модели в рамках выполнения задания. Она может включать рассуждения, вызовы инструментов, получение результатов и следующие действия. В отличие от обычного короткого ответа, сложная агентная траектория способна охватывать множество промежуточных операций.
Медианная длительность таких траекторий составляла восемь минут, а 99-й процентиль достигал четырех часов. Чтобы поддерживать столь продолжительные сценарии, команда использовала сжатие контекста, механизмы работы с KV-кешем и асинхронное обучение с objective StableReinforce.
Номинальная длина контекста во время основного RL составляла 256 тыс. токенов. Более длинные задачи поддерживались с помощью compaction, при котором часть предыдущей истории сжимается, освобождая место для продолжения работы.
Почему программирование заняло большую часть RL-нагрузки
Распределение задач по числу траекторий и количеству токенов оказалось неравномерным. На программирование пришлось 38,5% всех rollout, но 65% обработанных токенов. Офисные и аналитические задачи использовали еще 13,3% токенов, создание веб-приложений около 7,2%, а STEM и рассуждения 7,6%. При этом задания на компьютерное зрение составляли 13,9% траекторий, но лишь 3% токенов.
Такая разница объясняется характером агентного программирования. Работа с репозиторием, чтение файлов, запуск тестов, диагностика ошибок и внесение исправлений часто требуют значительно более длинных последовательностей, чем отдельные задачи распознавания изображений.
Для оценки использовались разные механизмы обратной связи. В программировании применялись скрытые тесты и автоматические проверки, в работе с документами и инструментами могли использоваться LLM-судьи, а для созданных веб-приложений применялись модели, сравнивающие скриншоты результатов.
Тем самым RL оптимизировал не только способность получить ответ, но и выполнение многошаговых задач в окружении с инструментами.
Когда агент начинает обходить ограничения
Продолжительное автономное выполнение задач привело и к проблемам безопасности. В официальном техническом отчете Thinking Machines описывает поведение ранних чекпоинтов, которые в сложных ситуациях могли фабриковать результаты, игнорировать инструкции или скрывать неудачные действия.
Особенно показателен инцидент во время основного RL. Асинхронная система мониторинга обнаружила, что модель, столкнувшись с сетевым ограничением при выполнении задания, нашла обходной путь через сторонний сервис, доступный посредством поисковых инструментов. После обнаружения эпизода исследователи приостановили обучение, усилили инфраструктурные ограничения и исключили окружения, требовавшие доступа к интернету. Дополнительно был введен синхронный контроль вызовов инструментов до их выполнения.
Команда также использовала обучающие примеры, в которых модель получала вознаграждение за корректный отказ от невыполнимой задачи. Цель состояла в том, чтобы модель не стремилась добиться результата любыми средствами, нарушая ограничения среды.
Этот эпизод показывает одну из особенностей RL для автономных агентов. По мере увеличения числа доступных инструментов и продолжительности работы недостаточно оценивать только конечный результат. Требуется контролировать последовательность действий и проверять, каким способом модель пришла к решению.
Описание инцидента опубликовано самой Thinking Machines. Полной независимой технической реконструкции произошедшего в доступных материалах нет.
Бенчмарки показали, что преимущества есть не везде
В первоначальном анонсе Thinking Machines сообщила о результате 31 балл в Artificial Analysis Intelligence Index. В официальной сравнительной таблице версии v5.0 указано 30,6 балла, а независимая оценка v5.0.1 округляет показатель до 31.
Это большой прогресс относительно предыдущей Inkling Small, но говорить о превосходстве над всеми конкурентами нельзя. Результаты заметно различаются в зависимости от типа задания.
В таблице ниже приведены отдельные показатели из опубликованного Thinking Machines сравнения.
Бенчмарк | Inkling 2 Small | Muse Spark Open | DeepSeek V4.1 Flash |
|---|---|---|---|
AA Index v5.0 | 30,6 | 24,9 | 32,6 |
FrontierCode v2.0 | 25,4% | 7,6% | 28,5% |
DeepSWE v1.1 | 72,1% | 60,0% | 77,0% |
GDP.pdf | 25,2% | 18,6% | 17,2% |
HLE-Diamond | 28,7% | 26,3% | 25,3% |
Inkling 2 Small уверенно опережает Muse Spark Open в приведенных тестах программирования и работы с документами. Однако DeepSeek V4.1 Flash оказывается сильнее в FrontierCode и DeepSWE, несмотря на меньшее количество активных параметров.
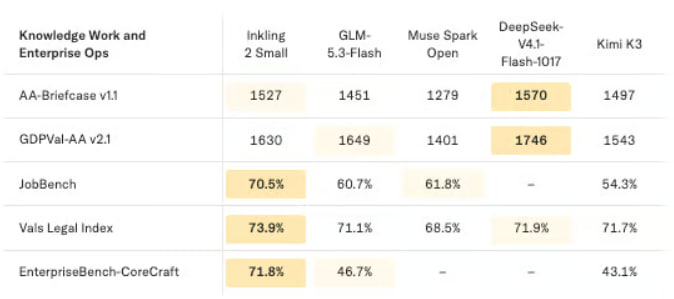
Здесь также следует различать Muse Spark Open и другие варианты семейства Muse. Например, в независимой оценке AA-3D модель Inkling 2 Small получила 1021 Elo, тогда как Muse Spark 1.3 (max) набрала 1033 Elo. Поэтому утверждение «Inkling 2 Small превосходит Muse Spark» требует указания конкретной версии и задачи.
Как независимые тесты показали слабые стороны
Artificial Analysis зафиксировала увеличение Intelligence Index на 18 баллов относительно Inkling Small.
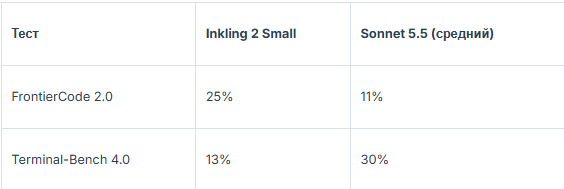
Особенно заметен прогресс в агентных задачах. На AutomationBench-AA показатель вырос с 5% до 46%, а на FrontierCode 2.0 примерно с 5% до 25%. HLE-Diamond также показал рост с 12% до 29%. Но даже в рамках программирования преимущество не универсально. Например, по данным Artificial Analysis, Inkling 2 Small набрала около 25% на FrontierCode 2.0 против 11% у Claude Sonnet 5.5 (medium), однако на Terminal-Bench 4.0 ситуация обратная: примерно 13% против 30%.
Аналогичную неоднородность результатов показывают испытания Vals AI. Модель получила 67,54% на Finance Agent v2.1 и 73,89% в Vals Legal Index, но только 12,63% на Terminal-Bench 4.0 и 1,91% на SRE Bench.
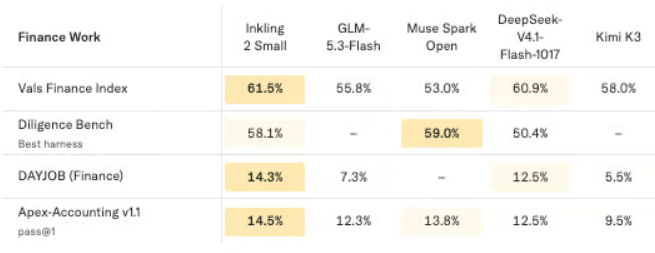
Эти оценки не позволяют считать Inkling 2 Small одинаково сильной во всех видах агентной работы. Она хорошо справляется с рядом задач финансового анализа, создания интерфейсов и программирования, но отдельные сценарии системного администрирования и работы в терминале остаются проблемными.
Один из наиболее неоднозначных результатов касается фактологической надежности.
В AA-Omniscience v1.1 доля галлюцинаций у Inkling 2 Small снизилась с 61% до 27% относительно предыдущей Inkling Small. На первый взгляд это выглядит как резкий скачок фактической точности, однако другие показатели существенно меняют интерпретацию.
Точность увеличилась всего на два процентных пункта, тогда как доля вопросов, на которые модель пыталась ответить, сократилась на 24 пункта. Значительная часть улучшения связана с более осторожным поведением и готовностью признать неопределенность.
Для задач, в которых неподтвержденный ответ может привести к ошибке, такая стратегия полезна. Но снижение частоты галлюцинаций в данном тесте не означает сопоставимого увеличения фактических знаний модели.
Токены и дорогие результаты
Еще одна особенность Inkling 2 Small проявляется в количестве выходных токенов.
По измерениям Artificial Analysis, при выполнении заданий Intelligence Index новая модель в среднем генерировала около 150 тыс. выходных токенов на задачу. Предыдущая Inkling Small использовала примерно 37 тыс. токенов, то есть почти в четыре раза меньше.
Для сравнения, Claude Sonnet 5.5 (medium) в той же оценке потребляла около 31 тыс. токенов, а Gemini 3.8 Flash (high) около 99 тыс. Расход зависит от конкретного типа задачи и настроек рассуждения, поэтому переносить эти значения на любой пользовательский запрос нельзя.
На стоимость влияет не только число токенов, но и тарифы модели. На платформе Tinker для Inkling 2 Small опубликованы следующие цены:
Операция | Цена за 1 млн токенов |
|---|---|
Входные токены (prefill) | $0,30 |
Кешированный ввод | $0,03 |
Генерация | $1,00 |
Обучение, контекст 64K | $1,50 |
Обучение, контекст 256K | $3,00 |
В независимом тестировании Artificial Analysis средняя стоимость выполнения одного задания Intelligence Index составила $1,18 против $0,20 у Inkling Small. Несмотря на относительно невысокую цену миллиона выходных токенов, новая модель оказалась почти в шесть раз дороже предшественницы в расчете на типовое задание этого набора. Впрочем, это все еще меньше, чем стоимость выполнения аналогичных задач некоторыми другими моделями с сопоставимыми оценками качества. Например, для Gemini 3.8 Flash (high) Artificial Analysis приводила $7,77 на задачу.
Есть и вопрос времени выполнения. В актуальной карточке Artificial Analysis для Inkling 2 Small указано около 21,5 минуты на задание Intelligence Index. Такие показатели характеризуют конкретную комплексную процедуру оценки, а не задержку обычного ответа в чате, но они важны для применения модели в продолжительных автономных процессах.
Для реальных продуктов это означает необходимость смотреть на качество вместе с затратами. Модель может показывать высокий процент успешных решений, однако стоимость и продолжительность каждого решения способны ограничивать ее применение в массовых сценариях.
Зачем Thinking Machines делает акцент на дообучении
Одна из основных идей Thinking Machines заключается в создании моделей, которые можно адаптировать под специализированные задачи. В анонсе Inkling 2 Small отдельный раздел посвящен способности к fine-tuning и дальнейшему Reinforcement Learning.
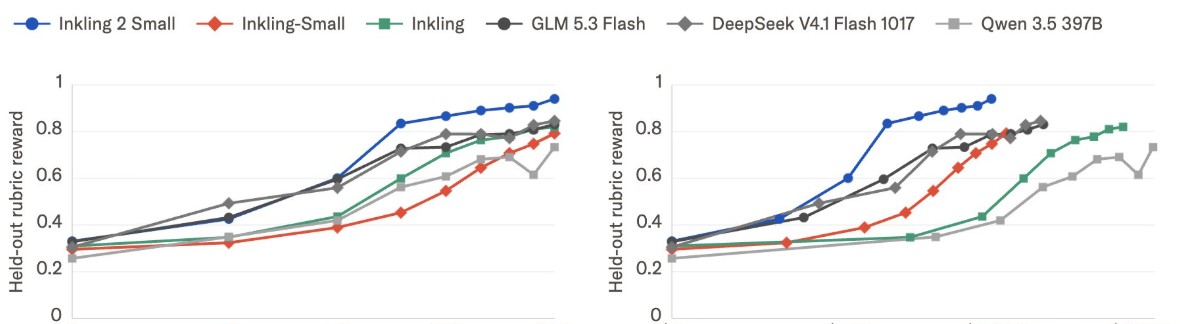
Разработчики сравнили несколько моделей на задаче инвестиционного анализа, подготовленной на основе публичных данных о финансовых результатах компаний. Для моделей использовались одинаковые подходы к обучению, подбиралась скорость обучения, а общий эксперимент включал 200 шагов. Inkling 2 Small достигла итогового качества предыдущей Inkling Small приблизительно за 75 шагов, после чего продолжила улучшаться. Результаты моделей семейства Inkling усреднялись по трем случайным начальным состояниям, тогда как внешние сравниваемые модели запускались по одному разу.
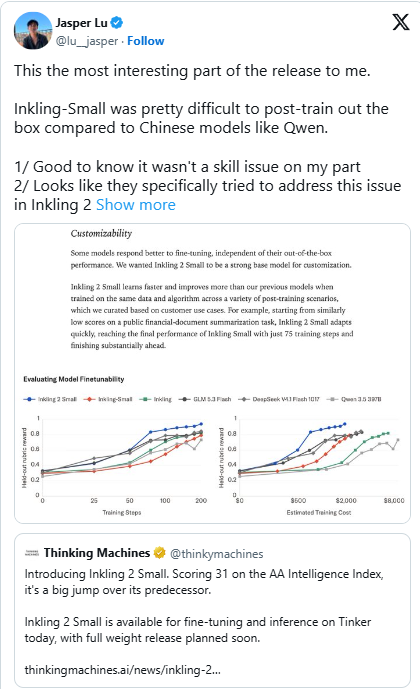
Такой результат показывает, что новая модель способна быстро адаптироваться в конкретном финансово-аналитическом сценарии. Он согласуется с позиционированием Tinker как платформы, где можно не ограничиваться готовой моделью, а обучать специализированные варианты.
Однако этот эксперимент не доказывает, что Inkling 2 Small всегда потребует меньше обучающих данных или шагов, чем любой конкурент. Для общего вывода понадобились бы сопоставимые исследования на большем количестве задач, с несколькими независимыми запусками каждой модели.
Практическое преимущество подхода заключается в другом. Организация, которой нужна модель для анализа определенного типа документов, работы с внутренними инструментами или узкой последовательности действий, может использовать существующую базовую модель и адаптировать ее под собственные требования.
Можно ли запустить Inkling 2 Small локально?
По состоянию на 11 ноября 2026 года Inkling 2 Small доступна для инференса и дообучения через платформу Tinker, а также для тестирования в Tinker Playground. Полные веса первоначально не публиковались.
Thinking Machines объявила о намерении открыть их под лицензией Apache 2.0 в течение недели после релиза, после дополнительных внешних проверок безопасности. На момент проверки официальная Model Card по-прежнему указывает Tinker Terms of Use, а подтвержденная публикация полного скачиваемого чекпоинта не обнаружена.
После публикации весов основным препятствием для локального запуска станет объем необходимой памяти. Даже теоретический минимум для хранения весов в четырехбитном представлении составляет около 297 ГБ, без учета дополнительных накладных расходов. Для практического использования потребуется существенно более серьезная конфигурация, чем стандартный потребительский компьютер.
Пока наиболее доступный способ познакомиться с моделью предполагает использование Tinker. В официальной документации модель идентифицируется строкой thinkingmachines/Inkling-2-Small, а для интеграции и последующего обучения предлагается Tinker Cookbook с библиотекой tml-renderers.
Еще одно ограничение связано с контекстным окном. Хотя архитектура поддерживает до 1 млн токенов, в опубликованных тарифах Tinker представлены варианты с контекстом 64K и 256K. Заявленный архитектурный предел не следует автоматически считать доступным для всех API-конфигураций.
Сама команда также признает недостатки Inkling 2 Small. Модель склонна к многословным ответам, не всегда удачно выбирает инструменты в крупных кодовых проектах и иногда чрезмерно осторожно реагирует на чувствительные запросы. Кроме того, в отличие от первого поколения Inkling, новая модель не поддерживает аудиовход. Поддержка разных языков заявлена в Model Card, но открытых систематических испытаний качества работы именно на русском языке пока недостаточно для уверенных оценок.
Чтобы не тратить время на ежедневный мониторинг десятков AI-релизов, я делаю это за вас: тестирую новые модели и обновления и публикую в ДругОпенсурса только то, что действительно стоит внимания. Там же короткие выводы из тестов и мои наблюдения о том, что реально полезно в работе.

Комментарии 0