Год назад в курилке можно было устроить один и тот же опрос, сколько времени тебе экономит нейронка, и ответы гуляли от «ну процентов двадцать» до «да вдвое, не меньше». Причем чем дальше человек сидел от прода, тем щедрее была цифра (менеджеры вообще называли что-то космическое).
Летом 2025-го METR взял секундомер, посчитал эту экономию на живых людях и получил число со знаком минус. Интернет покипел пару недель, все пообещали себе как-нибудь разобраться, после чего вернулись к своим агентам, которые как раз научились сами гонять тесты.
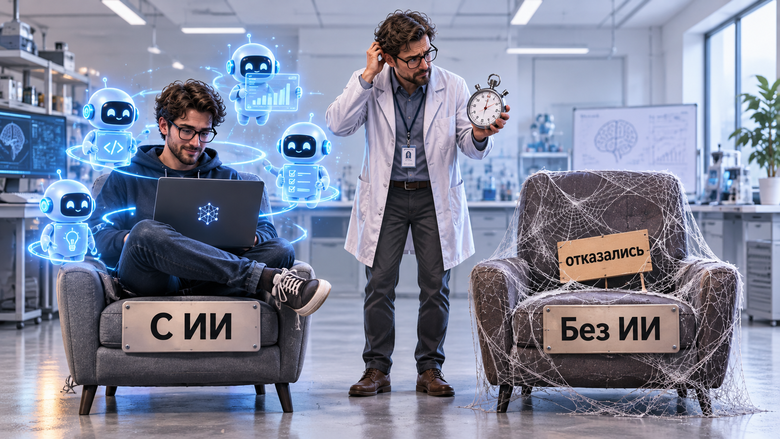
В августе METR запустил повтор, уже на свежих моделях и с выборкой побольше, а в феврале 2026-го выяснилось что повтор уперся в проблему, которую ни одна методичка по экспериментам не предусматривала. Приглашенные разработчики стали отказываться от той половины исследования, где писать код надо руками.
Если переводить на язык медицины, это как испытывать лекарство на добровольцах, которые с радостью идут в основную группу и вежливо уходят домой, как только им выпадает плацебо. И вот этот отказ, как ни странно, получился главным результатом всего эксперимента, по крайней мере о профессии он говорит больше любого процента ускорения.
Минус девятнадцать
Первый раунд шел с февраля по июнь 2025 года и был устроен довольно аккуратно. Шестнадцать опытных разработчиков, которые годами коммитили в крупные open-source проекты, принесли 246 реальных тасок из своих бэклогов, баги, фичи, рефакторинг. Репозитории там неигрушечные, в среднем больше 22 тысяч звезд и больше миллиона строк кода.
Дальше жребий решал, можно на этой задаче пользоваться ИИ или нельзя. Платили по $150 в час, работали в основном в Cursor Pro с Claude 3.5 и 3.7 Sonnet, задача в среднем занимала часа два, экран писался на видео, а время люди отмечали сами.
Перед стартом участники ждали ускорения процентов на 24, после финиша оценили его в 20. Секундомер показал обратное, с ИИ задачи заняли на 19% больше времени, и запомнилась всем как раз эта дыра между ощущением и замером почти в сорок процентных пунктов.
Механика тут по-моему понятная любому, кто хоть раз смотрел, как агент бодро вываливает триста строк за минуту. Минута в памяти остается, сорок минут на разбор этих строк куда-то испаряются, и на выходе ты искренне уверен, что сэкономил полчаса, хотя просидел лишний час.
METR перебрал двадцать возможных причин замедления и нашел пять вероятных, но главную назначать не стал. Самая очевидная валяется на поверхности: человек, который годами живет в своей репе, и так помнит, в каком файлике сидит баг, а помощнику этот контекст приходится каждый раз объяснять заново... как стажеру в первую неделю, только стажер хотя бы запоминает.
Сами авторы честно назвали результат снимком возможностей начала 2025-го и пообещали мерить дальше тем же методом, ибо модели обновляются быстрее, чем про них успевают писать статьи.
Контрольная группа разбежалась
Повтор стартовал в августе 2025-го и на бумаге выглядел солиднее первого раунда: 57 разработчиков с медианным стажем около десяти лет, из них десять ветеранов и сорок семь новеньких, 143 репозитория и больше восьмисот задач.
Ставку правда срезали со $150 до $50 в час, и METR потом сам записал это в причины перекоса выборки, хоть и второстепенные.
Схема осталась прежней, человек заранее описывает задачу и отдает ее на жеребьевку, а та решает, можно ли тут ИИ. Вот на этом шаге все и поехало, потому что приглашенные гораздо чаще стали отказываться от участия совсем, причем объяснение у всех было одно и то же: без ИИ работать они больше не хотят.
Точную долю отказавшихся METR не называет, пишет только что набирать и удерживать участников стало заметно тяжелее. Для людей, которые зарабатывают аккуратными измерениями, это довольно сильная формулировка для официального отчета.
Те, кто все-таки остался, нашли вариант помягче и просто не несли на жеребьевку задачи, которые не хотелось бы делать руками. По опросам самого METR так делали от 30 до 50% разработчиков, и мимо жребия чаще всего проходили как раз задачки, где нейронка выиграла бы больше всего.
Один участник вообще не закрыл ни одной задачи из группы «без ИИ»... по-моему это самый честный ответ на вопрос исследователей, который можно было дать без всякой анкеты.
Вообщем в контрольной группе остались люди и задачи, которым ИИ нужен меньше всех. Сравнивать их с основной группой это примерно как оценивать пользу навигатора по тем поездкам, на которые таксист соглашается без него, т.е. по своему двору и до ближайшей Пятерочки.
Цифры с длинными усами
Цифры METR все равно опубликовал, в феврале 2026-го, и на первый взгляд они выглядят как реванш. У вернувшихся участников оценка развернулась в ускорение примерно на 18%, у новеньких примерно на 4%.
Но доверительные интервалы там такие, что влезает почти любая история: у ветеранов от ускорения на 38% до замедления на 9%, у новеньких от ускорения на 15% до тех же 9% замедления. Авторы сами называют это очень слабым свидетельством реального ускорения.
При этом METR пишет, что реальный эффект скорее всего больше, и считает свою цифру нижней границей, потому что задачи с самым большим выигрышем до жребия просто не дошли. Редкий жанр, когда исследователь показывает число и следующим же абзацем объясняет, почему закладываться на него в расчетах не надо.
Заодно сломался и сам секундомер, потому что за эти месяцы поменялся сам способ работы. Когда у тебя в соседних окнах tmux крутятся два-три агента, ты пока они думают уходишь в свою задачу, иногда вообще никак не связанную с экспериментом, и вечером честно пишешь в отчет время, которое уже непонятно к чему относится.
METR прямо признает, что у таких участников самоотчет по времени перестал быть надежным, и эта деталь легко теряется на фоне процентов. Плюс качество результата в двух группах иногда расходилось, в том числе по тестам и документации, так что одинаковое время на задачу еще ничего не говорит про одинаковую работу.
Анкета вместо секундомера
Когда замер ломается, все по привычке идут к опросам, а там картина знакомая до зевоты. Stack Overflow в опросе за 2025 год собрал больше 49 тысяч ответов, и 84% опрошенных либо уже пользуются ИИ-инструментами, либо собираются начать. Доверяет точности их ответов при этом примерно треть, а открыто недоверяющих уже 46%, хотя годом раньше их было 31%.
Главная жалоба там (ее отметили 66%) про решения «почти правильные, но не совсем», еще 45% пожаловались, что отладка сгенерированного кода съедает больше времени. Боль узнаваемая: приходит сто строк, девяносто восемь из них выглядят как надо, а оставшиеся две ты ищешь полчаса, потому что выглядят они ровно так же и ломаются только на третьем тест-кейсе.
Эти полчаса в анкету обычно не попадают, потому что в голове остается момент, когда сто строк появились за десять секунд, и именно его человек вспоминает, когда его спрашивают про продуктивность.
Конструкция выходит кривоватая: пользуются почти все, доверяет меньшинство, отказаться готовы единицы, и единственный прибор, который мог бы все это рассудить, сломался как раз из-за того, что отказываться никто не хочет. Анкете в такой ситуации верить сложно, и мы это знаем из того же METR, где год назад опытные люди ошиблись в оценке своей скорости почти на сорок пунктов, причем в приятную для себя сторону.
Счет от провайдера
Компании тем временем ждать исследований не стали и начали мерить тем, что есть у бухгалтерии под рукой, т.е. деньгами и токенами, и истории оттуда пока скорее анекдотичные.
Технический директор Uber Правин Неппалли Нага рассказал The Information, что годовой бюджет на ИИ-инструменты для разработки на 2026 год компания выбрала за четыре месяца, в основном на Claude Code. До этого внутри компании еще и висел рейтинг команд по использованию ИИ, так что удивляться особо нечему.
Операционный директор Эндрю Макдональд потом в подкасте Rapid Response признал, что провести линию от растущего расхода токенов к полезным для пользователей фичам пока не получается. В июне Uber ввел лимит в $1500 в месяц на сотрудника.
В Amazon, если верить Financial Times, сотрудники сами сделали неофициальный рейтинг Kirorank по активности на внутренней платформе Kiro. Его прикрыли, когда выяснилось что народ натравливает агентов на бессмысленные таски ради места в таблице, а старший вице-президент Дейв Тредвелл попросил коллег не использовать ИИ ради самого ИИ. Сейчас, как пишут, Amazon смотрит на «нормализованные деплои», т.е. на код, который реально доехал до прода.
Закон Гудхарта придумывали про экономику, но в разработке он работает даже лучше, потому что любую поощряемую цифру тут за пару недель учатся накручивать скриптом, а теперь еще и агентом, который этот скрипт сам и напишет.
Смеяться над этим легко, только другого прибора у финансиста все равно нет. Время на задачу без контрольной группы мало что говорит, закрытые тикеты рисовать научились давно, строки кода обесценились еще до нейронок, и честной остается одна цифра в ежемесячном счете от провайдера, которая растет при любом раскладе.
Платят за разработку при этом как и раньше, просто часть денег переехала из фонда оплаты труда в облачный счет, и что именно компания купила на эту разницу, пока толком не может сказать никто.
Есть попытки посчитать и обратную сторону, например CodeRabbit разобрал 470 open-source пулреквестов и нашел в тех, где соавтором был ИИ, в среднем 10.83 проблемы против 6.45 у чисто человеческих, примерно в 1.7 раза больше. Правда продает CodeRabbit как раз ревью кода нейросетями, так что цифру я бы воспринимал примерно как отзыв о ресторане от владельца ресторана через дорогу.
Где скепсис дает трещину
Самый соблазнительный вывод из всей истории звучит так, что программисты подсели на игрушку, которая их тормозит. В твит он ложится идеально, в факты гораздо хуже, потому что отказ работать без инструмента сам по себе тоже данные, и довольно тяжелые.
Отказываются ведь опытные люди, медианный стаж участников нового раунда около десяти лет. Такие пережили не одну волну модных фреймворков и «революционных» IDE и без сожаления выкидывали все, что мешало работать. Когда такой человек говорит, что за $50 в час руками писать не будет, он по сути отдает исследователю ровно ту оценку, ради которой затевался эксперимент, просто в виде, который в табличку с интервалами не положишь.
Я и сам, если честно, вежливо отказался бы от такого приглашения, и объяснить причину врядли смог бы чем-то кроме того, что руками долго, скучно, да и пальцы уже отвыкли набирать бойлерплейт.
К тому же первый раунд мерил Cursor с моделями начала 2025-го на задачах, где человек и так знал каждый угол. С тех пор агенты научились сами гонять тесты, читать полрепы за раз и тащить длинные задачи почти без присмотра, и мерить их старым способом это как оценивать экскаватор по числу взмахов лопатой. METR это похоже понимает лучше всех, иначе вряд ли назвал бы свои свежие оценки нижней границей.
Зависимость при этом никуда не девается, и цена у нее вполне конкретная. Инструмент может однажды подорожать втрое, лечь на полдня или стать недоступным для вашего региона (привет всем, кто ходит к нейронкам через три VPN), и тогда команда, два года не писавшая руками, быстро выяснит, что часть ее скорости была взята в аренду. Условия аренды при этом в любой момент переписывает арендодатель.
Редкий вид для контрольной группы
От самой идеи измерять METR не отказался и собирается заходить сразу с нескольких сторон. В планах короткие эксперименты с оплатой повыше, заранее заданные задачи вместо выбранных самими участниками, наблюдение за реальным использованием по статистике и транскриптам, ну и опросы, про которые авторы сами предупреждают, что они смещены.
Еще в планах жеребьевка по людям вместо жеребьевки по задачам, когда одни участники весь эксперимент работают с ИИ, а другие весь эксперимент без него. Авторы признают, что перекос по задачам такая схема убирает ценой перекоса по людям, да и статистической мощности у нее меньше.
И вот тут хорошо видно, где мы все оказались. Для такой схемы придется искать опытных разработчиков, готовых просидеть без ИИ целую серию задач, а таких с каждым кварталом все меньше, и сравнение с ними в итоге расскажет скорее про разницу между двумя типами людей, чем про сам инструмент.
Так что на вопрос из заголовка индустрия еще долго будет отвечать косвенно, через бюджеты, сроки релизов и число ночных инцидентов на проде. И все эти цифры будут описывать выбор, который уже сделан, потому что программисты проголосовали раньше, чем исследователи успели посчитать бюллетени, и пересчитывать их теперь придется по счетам за токены.
З.Ы. Если захочется поучаствовать в следующем раунде, имейте в виду, что ставка за час ручного программирования в экспериментах METR за год упала втрое. Скорее всего дело просто в бюджете исследователей, но совпадение с тем, как рынок сейчас оценивает ручной код, вышло довольно красноречивым.
Комментарии 0