Всем привет!
Меня зовут Кирилл, больше десяти лет я разрабатываю облака и инфраструктуру. Но последние пару месяцев в рамках R&D я достаточно много занимаюсь инференсом: платформами для него, конфиденциальными вычислениями и оптимизацией всего, что вокруг. В частности проектом - Serverless GPU с механиками примерно как у Modal или RunPod FlashBoot.
Одна из самых болезненных вещей здесь - холодный старт моделей. Каждый MLOps инженер, кто ждал перезапуск пода с vLLM / SGLang по 30 минут знает о чем я говорю.
Это особенно актуально, если вы делаете инференс на нескольких облачных провайдерах и спотовом GPU рынке, где может случиться прерывание vm или контейнера. Так что способность быстро запускаться - must have в таких условиях, особенно если вы даете своим клиентам опцию Dedicated Inference.
Хорошие новости - чтобы решить эту проблему около месяца назад я начал работу над open-source проектом warmctl, о нём сегодня в посте.
Проблема холодно старта
Если микросервис на Go стартует за 500 мс, то время старта Deepseek 4.1 с TP=8 на 8xB300 может легко занять минут 20-30, причем это будет повторяться всякий раз: на перезапуск самого хоста, случайный рестарт vLLM или SGLang из-за ошибки, добавление новой реплики - все это будет каждый раз съедать кучу времени. Да и простой такого железа даже на 20 минут в час пик под нагрузкой - это очень дорого
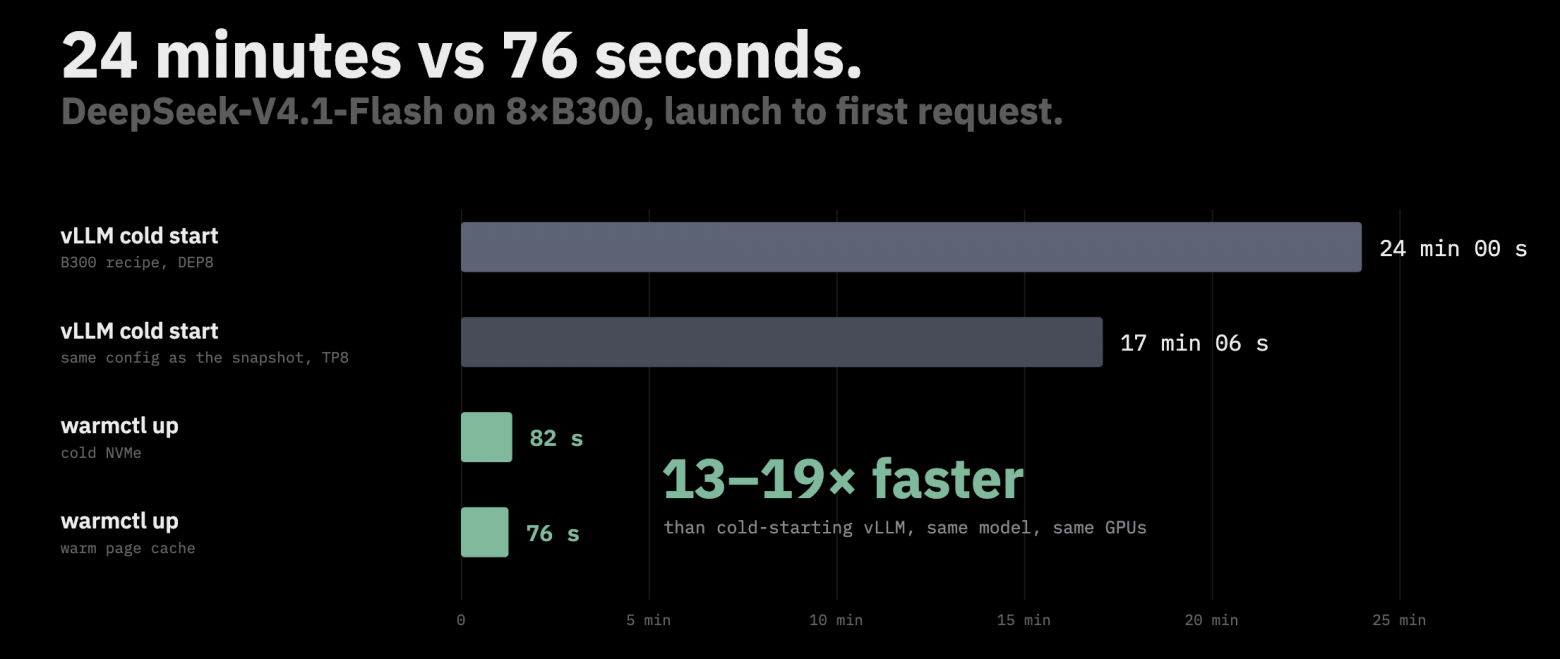
Может показаться, что веса моделей весят 300+ гигабайт, вот они и грузятся минут по 20-30. Но нет, дело не в этом.
В GPU облаках по типу Nebius, CoreWeave или Together AI - везде стоят СХД от VAST / Weka либо собственные HPC решения, которые дают по 15 GB/s на GPU ноду - этого достаточно чтобы загрузить даже GLM 5.3 секунд за 15-20. Загрузка весов моделей до 1 ТБ и data loading на правильной инфраструктуре даже on-prem не является проблемой.
Учитывая, что 8xB300 стоит как крыло от самолета, поставить за пару тысяч долларов хорошую сетевую карту и закрыть этот вопрос - крайне рационально. Если на вашем GPU кластере не стоят хотя бы 200 Gbit/s - что то явно не так.
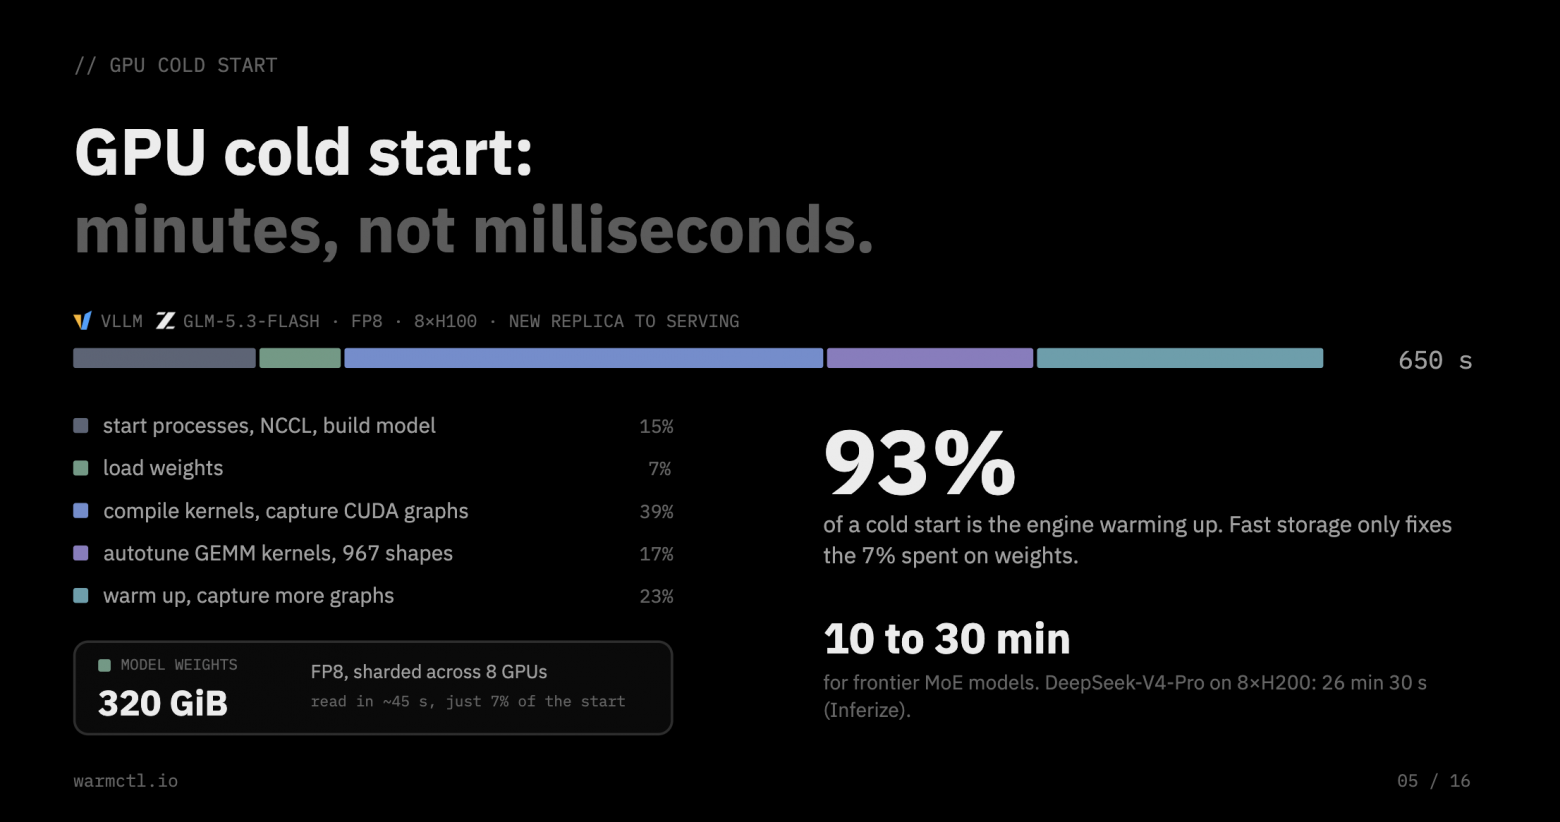
Так что же происходит все эти 10-20 минут ?
На data loading приходится всего около 5-7% времени, все остальное - это компиляции kernels, сборка CUDA графов, автотюнинг GEMM и многое многое другое, включая запуск самого vLLM, который например представляет собой кучу процессов, общающихся по ZMQ в качестве транспорта.
На рынке очень много разного GPU-железа, еще больше различных версий CUDA и драйверов, куча параметров инференса самой модели - при запуске значительная часть времени уходит на оптимизацию и прогрев вычислений под конкретную комбинаторику железа, софта и настроек. Всё это нужно, чтобы потом модель быстро обрабатывала запросы. Это очень хорошо.
Часть этой работы уже умеют кэшировать: например, vLLM сохраняет результаты компиляции kernels и использует их при следующих запусках. Но кэш скомпилированных kernels ещё не сохраняет готовое состояние всего движка. Остаются инициализация процессов и CUDA-контекстов, выделение памяти, захват CUDA-графов и другие этапы подготовки runtime. Все равно много времени тратится впустую.
Идея: GPU Checkpoint & Restore + OCI
Раз прогретое состояние каждый раз одинаковое - не нужно получать его каждый раз на каждой GPU ноде, где вы запускаете инференс. Это бессмысленно - в production скорей всего у вас фиксирована версия драйвера, параметры модели и сама модель, а так же железо и окружение на котором выполняется инференс.
Достаточно один раз запустить vLLM или SGLang с нужными параметрами, дождаться, пока он прогреется и выполнит все необходимые оптимизации, снять с него снимок и дальше тиражировать этот снимок, например в формате OCI.
Основа для этого уже есть:
CRIU умеет сохранять и восстанавливать деревья Linux-процессов. На нём построен checkpoint/restore контейнеров в Kubernetes (KEP-2008).
cuda-checkpoint от NVIDIA делает то же самое для состояния процесса на GPU.
Так и появился warmctl - open-source инструмент для снимка и восстановления инференс движков на базе CRIU и CUDA Checkpoint (на самом деле еще DMTCP, но об этом в следующий раз)
Он дает возможность сделать снепшот прогретого vLLM и SGLang (planned) вместе с состоянием всех GPU, файловой системы, состояния NCCL и тд, а затем восстанавливать его на произвольном числе хостов, добавляя тем самым реплики. Все последующие запуски будут пропускать этап прогрева и при этом не терять ни капли в проихводительности.
Сам снимок warmctl упаковывает в OCI-образ. Его можно версионировать, хранить и распространять через ваш OCI Registry - так же, как обычные Docker-образы. Причем там достаточно много инвестировано в параллельную загрузку и эффективную упаковку этого образа (пропуск zero pages, сжатие, etc), чтобы быть максимально эффективным даже на этом этапе.
Всю цепочку можно уложить в 4 шага: модель с Hugging Face → запуск vLLM и прогрев в Gitlab → OCI-образ снимка → инференс из восстановленной копии. Все очень просто и достаточно компактно, причем работает как на обычных виртуалках, так и в контейнерной среде по типу RunPod или даже в Managed Kubernetes внутри KServe в вашем облачном провайдере.
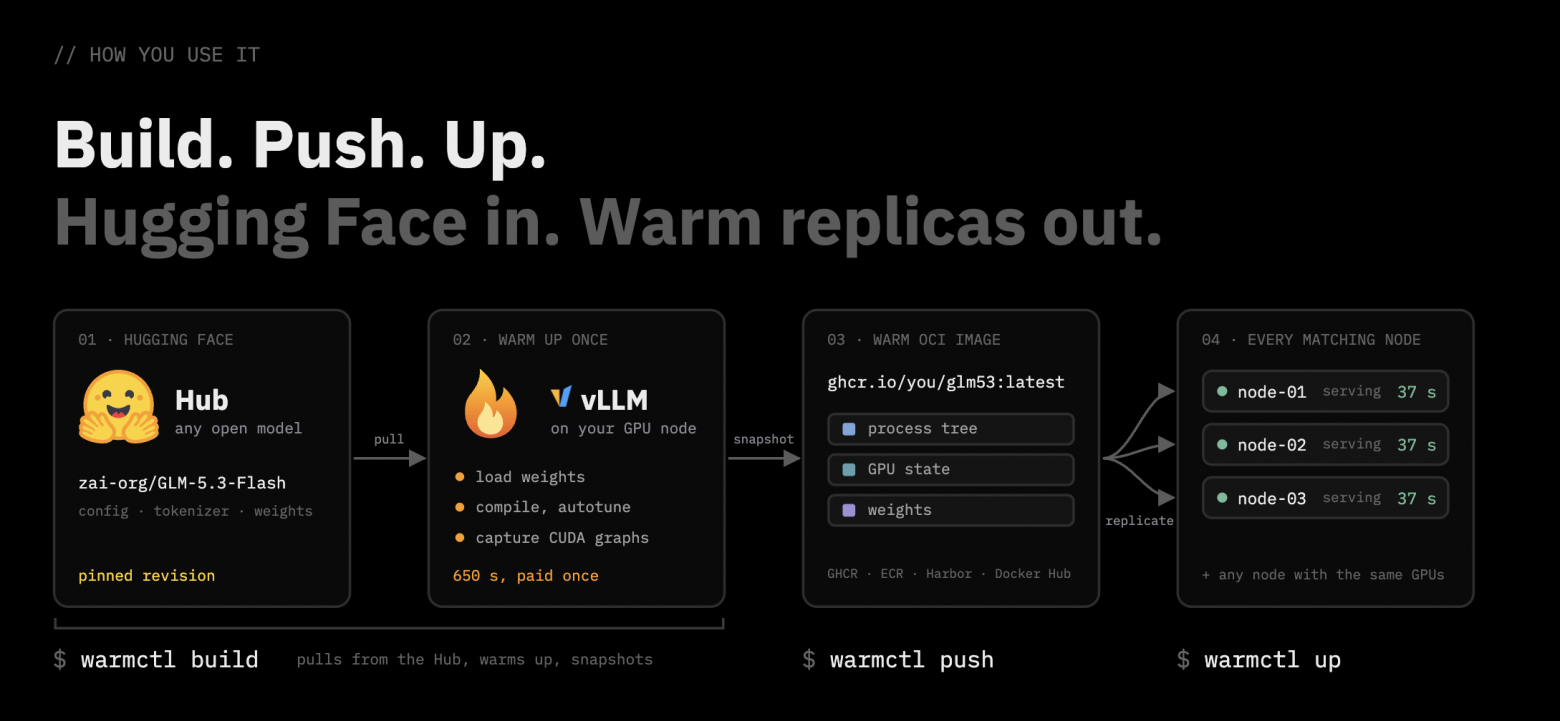
Благодаря OCI - отдельная инфраструктура не нужна, получается самый настоящий cloud-native.
Как этим пользоваться
Все очень просто. Весь warmctl - это CLI, очень похожая на docker.
Как и писал выше - берёте любую модель с Hugging Face и любой CI, хоть GitHub Actions. Выпекаете снимок вашей любимой open-weight модели с нужными вами настройками один раз в OCI формате и отправляете его в ваш registry.
Это буквально три команды:
hf download <model>
warmctl build <...>
warmctl push <...>
Это делается один раз. Дальше на каждом GPU узле для восстановления из снимка выполните:
warmctl up <image>Это всё. Команды похожи на Docker: build, push, pull, up, ps, down.
Если собирать снимок самому не хочется, есть публичный каталог уже прогретых образов, получается что то вроде каталога Hugging Face, только прогретых и готовых к запуску движков вместе с весами. Я постарался собрать популярные конфигурации:
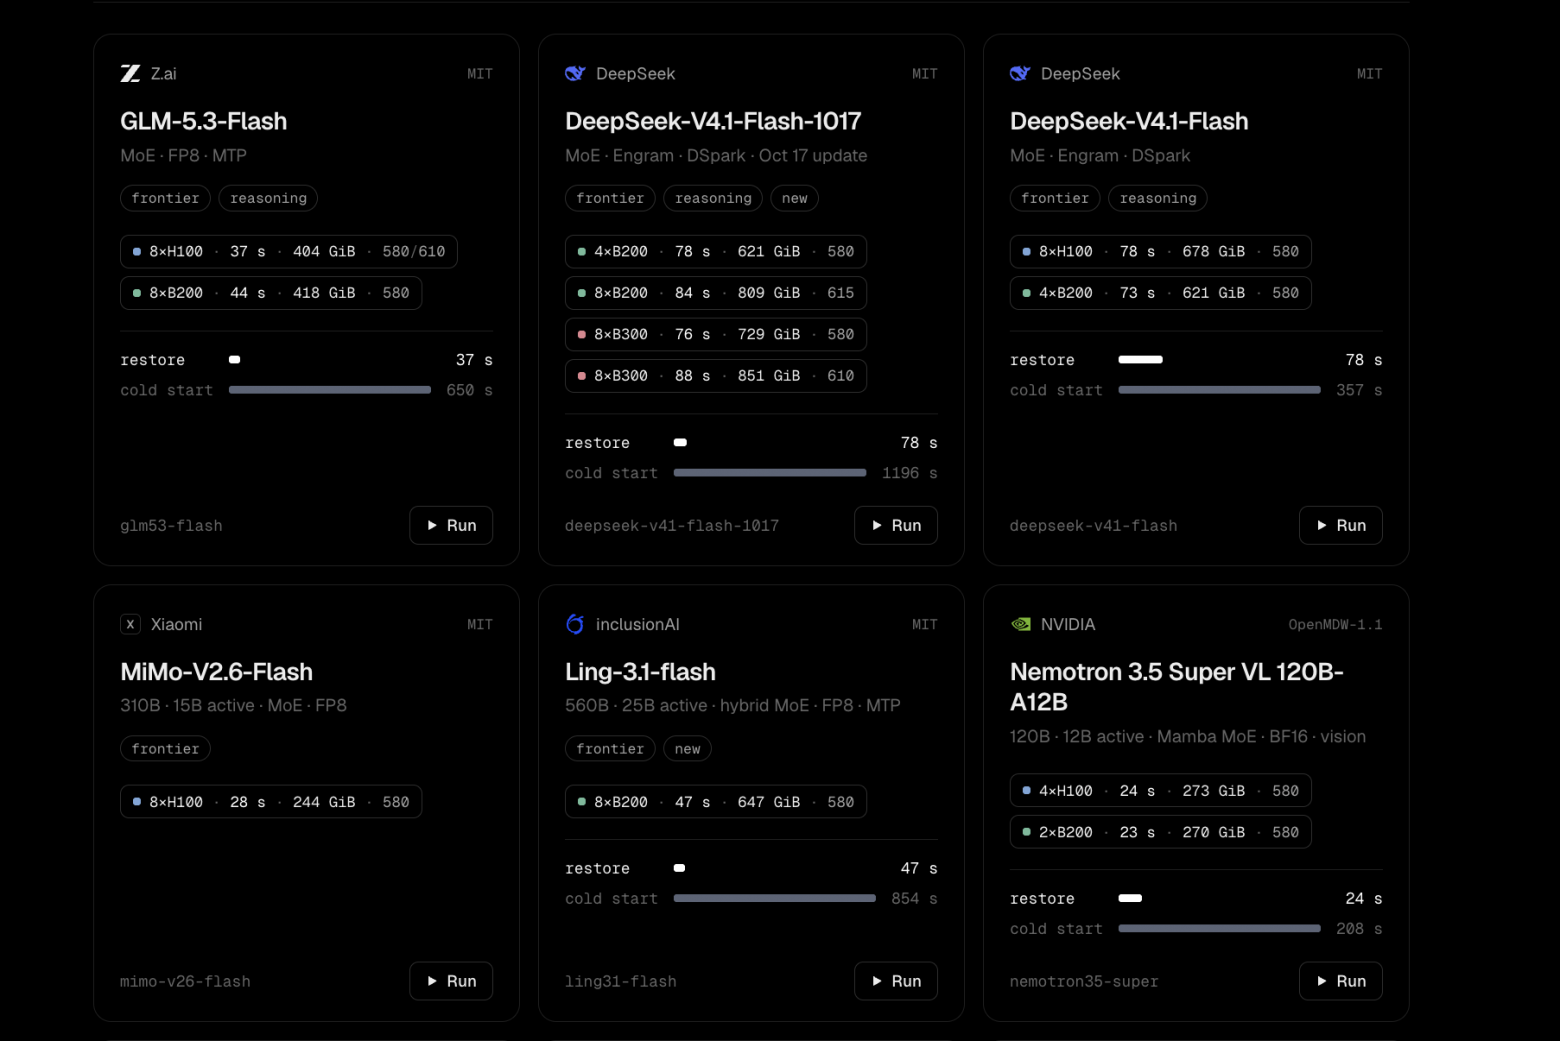
Там примерно 21 открытая модель, прогретая мною на H100, H200, B200, B300, L40S и RTX PRO 6000.
Установка и простой тест на qwen3-8b через публичный каталог выглядит примерно так:
curl -fsSL https://warmctl.io/install.sh | sh
warmctl doctor        # проверит Docker, NVIDIA runtime и драйвер
warmctl catalog       # покажет модели, которые можно поднять на этом узле
warmctl up qwen3-8b   # скачает образ и запустит сервер на :8000
Тесты: Запуск GLM-5.3-Flash на 8×H100
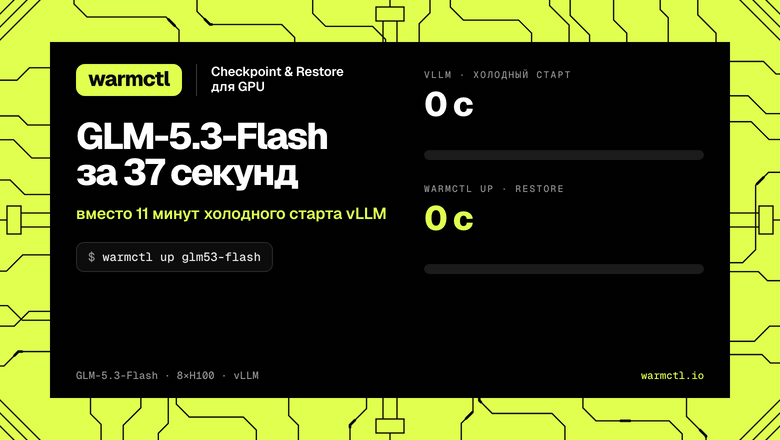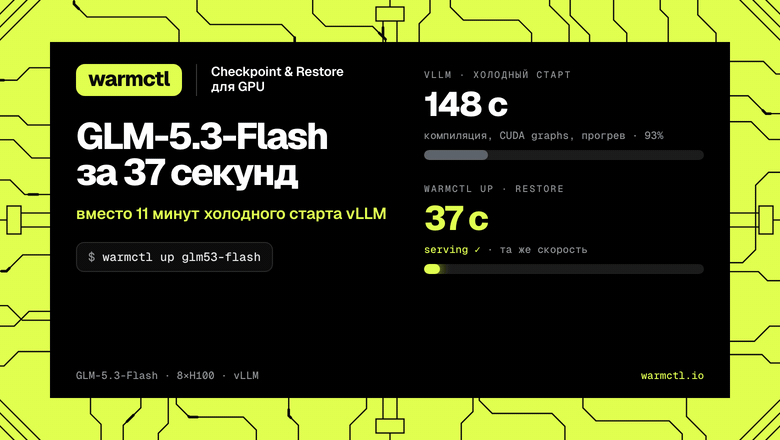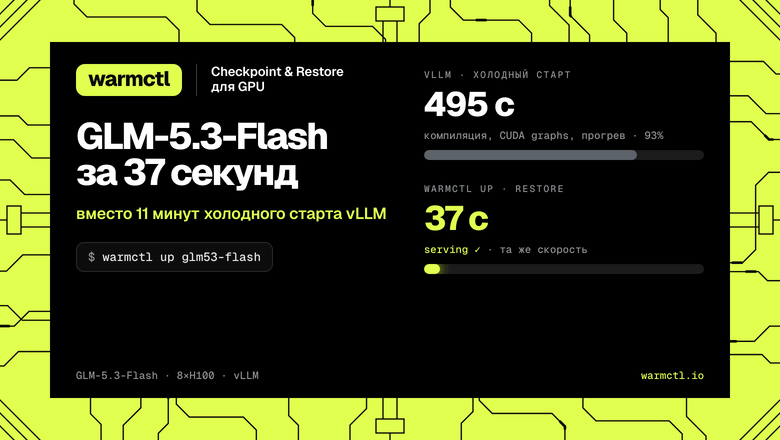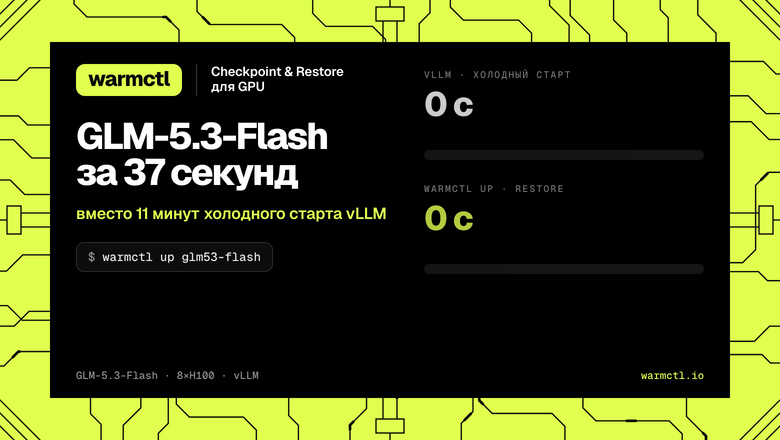
Первую версию warmctl я тестировал на инфраструктуре Nebius и их NFS. Новая реплика GLM-5.3-Flash на 8×H100 запускалась примерно за 37 секунд вместо 650 на их Managed Kubernetes кластере. Полный разбор этого бенчмарка можно найти в блоге:
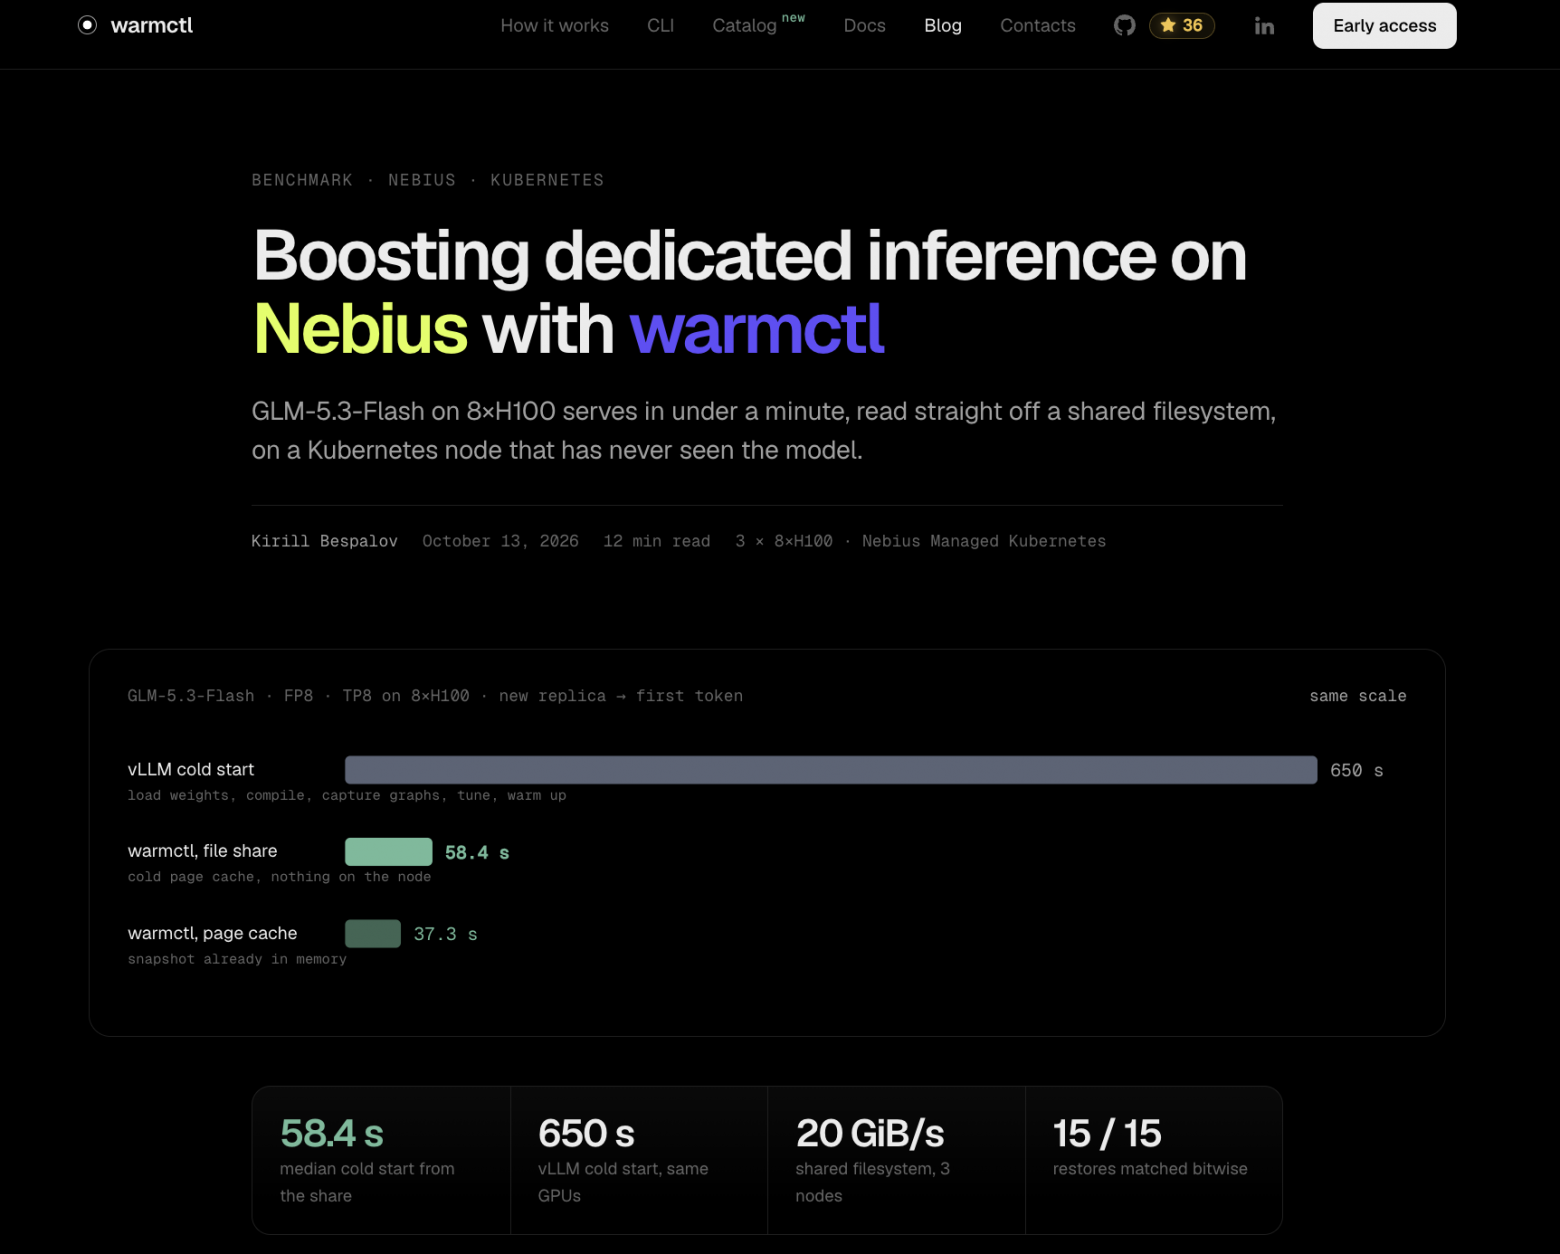
Ещё несколько замеров других моделей. Как можно заметить, восстановление работает даже на TP>1 и больших MoE моделях:
Модель | GPU | Холодный старт | warmctl up |
|---|---|---|---|
GLM-5.3-Flash | 8×H100 | 650 с | 37 с |
Nemotron 3.5 Super | 4×H100 | 208 с | 24 с |
Qwen3.8-27B | 1×RTX PRO 6000 | 215 с | 11 с |
Qwen3-8B | 1×L40S | 134 с | 9 с |
Тесты: Запуск Qwen 3.8 180B на 3 нодах H200
Кроме того я экспериментировал запуская и восстанавливая с сетевого тома три реплики Qwen 3.8 на 180B параметров на RunPod, где в отличие от классических vm - исключительно контейнерная среда без какого либо privileged режима, который обычно требует CRIU.
Поэтому пришлось поддержкать второй бэкенд DMTCP для checkpoint & restore CPU нагрузок, который умеет работать через LD_PRELOAD без каких либо зависимостей на linux kernel механики. В результате получилось запустить с нуля до трех реплик и первого токена за 30 секунд. Демо запуска с сетевого тома RunPod можно посмотреть тут:
Заключение
Проект планирую развивать и дальше, на активной стадии разработки. В планах безусловно поддержка SGLang, как второго по популярности движка, а так же поддержка не только NVIDIA, но и AMD для того, чтобы закрыть инференс на MI300X и тд
Код открыт под Apache-2.0: github.com/TensorRails/warmctl. Если вашей модели или видеокарты нет в каталоге, напишите в комментариях, добавим.

Комментарии 0