Внутри майнинговой карты NVIDIA CMP 170HX стоит тот же кристалл GA100, что и в A100, а на плате распаяно около 80 ГБ HBM, из которых карте разрешено видеть 8. Всё это решают eFuse-фьюзы на самом кристалле. Мне удалось найти в GA100 уязвимость к глитчу напряжения, через которую можно пережигать произвольные фьюзы, и с её помощью превратить свою CMP 170HX 8GB в то, что по сути является A100-80G.
Более того, разблокированные карты работают примерно в 1,2 раза быстрее серийной A100: у них включены все исправные SM (около 120–126, как повезёт с кристаллом), а не 108, которые NVIDIA ради выхода годных оставила во всех серийных A100. Тем же способом открываются функции, отключённые в CMP: NVLink, PCIe Gen4, NVJPG, NVDEC, MIG. Правда, NVJPG, NVDEC и MIG я отдельно не проверяю.
Вот как выглядит и работает моя «A100-80G».
$ nvidia-smi --query-gpu=index,pci.bus_id,pci.device_id,name,memory.total; nvidia-smi topo -m
index, pci.bus_id, pci.device_id, name, memory.total [MiB]
0, 00000000:81:00.0, 0x20C210DE, NVIDIA Graphics Device, 81920 MiB
1, 00000000:C1:00.0, 0x20C210DE, NVIDIA Graphics Device, 81920 MiB
	GPU0	GPU1	CPU Affinity	NUMA Affinity	GPU NUMA ID
GPU0	 X 	NV12	0-127	0		N/A
GPU1	NV12	 X 	0-127	0		N/A
Пропускная способность FP16 FMA:
Карта | TFLOP/s | Относительно серийной A100 |
|---|---|---|
Серийная A100 | 72,488 | 1,00× |
CMP 170HX с аппаратной разблокировкой | 85,858 | 1,18× |
Полный вывод OpenCL-бенчмарка:
.-----------------------------------------------------------------------------.
|----------------.------------------------------------------------------------|
| Device ID    0 | NVIDIA Graphics Device                                     |
| Device ID    1 | NVIDIA Graphics Device                                     |
|----------------'------------------------------------------------------------|
|----------------.------------------------------------------------------------|
| Device ID      | 0                                                          |
| Device Name    | NVIDIA Graphics Device                                     |
| Device Vendor  | NVIDIA Corporation                                         |
| Device Driver  | 610.43.03 (Linux)                                          |
| OpenCL Version | OpenCL C 3.0                                               |
| Compute Units  | 124 at 1410 MHz (7936 cores, 22.380 TFLOPs/s)              |
| Memory, Cache  | 81338 MB VRAM, 3472 KB global / 48 KB local                |
| Buffer Limits  | 20334 MB global, 64 KB constant                            |
| Max Workgroup  | 1024 threads                                               |
|----------------'------------------------------------------------------------|
| Info: OpenCL C code successfully compiled.                                  |
| FP64   Compute   (double, fma  )                     11.287 TFLOPs/s (1/2 ) |
| FP32   Compute   (float , fma  )                     22.781 TFLOPs/s ( 1x ) |
| FP16   Compute   (half2 , fma  )                     85.858 TFLOPs/s ( 4x ) |
| INT64  Compute   (long  , a*b+c)                      2.759  TIOPs/s (1/8 ) |
| INT32  Compute   (int   , a*b+c)                     22.769  TIOPs/s ( 1x ) |
| INT16  Compute   (short2, a*b+c)                     20.273  TIOPs/s ( 1x ) |
| INT8   Compute   (char4 , dp4a )                     81.169  TIOPs/s ( 4x ) |
| Memory Bandwidth ( coalesced read      )                       1883.17 GB/s |
| Memory Bandwidth ( coalesced      write)                       2137.93 GB/s |
| Memory Bandwidth (misaligned read      )                       1460.81 GB/s |
| Memory Bandwidth (misaligned      write)                        250.13 GB/s |
| PCIe   Bandwidth (send                 )                         13.10 GB/s |
| PCIe   Bandwidth (   receive           )                         11.69 GB/s |
| PCIe   Bandwidth (        bidirectional)            (Gen3 x16)   11.58 GB/s |
|-----------------------------------------------------------------------------|
'-----------------------------------------------------------------------------'
NVIDIA применяет фьюзы для сегментации продуктов, функций безопасности и прочего занятного контроля доступа. При этом у ряда функций пережжённый фьюз на кристалле NVIDIA расширяет доступ. В правильно защищённой схеме пережжённый фьюз всегда должен переводить чип в более строгое состояние, потому что восстановить пережжённый фьюз экономически нереально. А в схеме NVIDIA ограничения можно ослабить, пережигая новые фьюзы!
Ниже — про кристалл GA100, его контроллер фьюзов, применение глитча напряжения (voltage fault injection, VFI) и о том, куда двигаться дальше. Часть наработок, на которых держится исследование, я выкладываю здесь.
Благодарности
Работа опирается на предыдущее исследование Джона Прая (Jon Pry) и многих других людей, потративших массу времени на то, чтобы лучше понять GA100. Свои находки я раскрываю после того, как ту же уязвимость независимо обнаружил другой исследователь безопасности: считаю, что в интересах общества сделать эту информацию публичной. До публикации статьи находки переданы команде безопасности продуктов NVIDIA.
Версии GA100
GA100 — кристалл NVIDIA, на котором построено почти 20 разных SKU, самый известный из них — A100. Разбирать все SKU я не буду, остановлюсь на тех воплощениях GA100, которые важны для этой работы: разных версиях CMP 170HX и A100.
С фабрики GA100 выходит со 128 SM, 12 FBP, пятью блоками NVDEC, контроллером PCIe Gen4 x16 и, в зависимости от объёма видеопамяти, с 4–6 стеками HBM в одном корпусе с кристаллом. NVIDIA использует eFuse для управления выходом годных и сегментации: одинаковые GA100 превращаются в более урезанные варианты по результатам тестирования на дефекты и в зависимости от спроса.
Одно из самых крайних проявлений такой сегментации — CMP 170HX, карта для майнинга Ethereum. Номинально приложениям доступно 8 или 10 ГБ видеопамяти, а на плате на самом деле стоит, соответственно, около 80 и около 40 ГБ HBM! Эта работа в основном о том, как полностью разблокировать и использовать этот объём. Предыдущие работы сильно продвинулись в программной разблокировке GA100, а глитч напряжения проходит последнюю милю.
SKU | Параметр | Из коробки | Программно (cmpunlocker) | GA100VFI |
|---|---|---|---|---|
CMP 170HX 8GB | Видеопамять | 8 ГБ | 64 ГБ | 64–80 ГБ¹ |
CMP 170HX 10GB | Видеопамять | 10 ГБ | 40 ГБ² | 40–48 ГБ |
Обе CMP | SM | 70 | 70 | 120–128 |
Обе CMP | Поколение PCIe | 1 | 2 | 4 |
Обе CMP | NVLink | Нет | Нет | Да³ |
Обе CMP | ECC | Нет | Нет | Да⁴ |
Обе CMP | Multi-Instance GPU | Нет | Нет | Да⁴ |
Обе CMP | NVDEC | 0 | 0 | 5⁴ |
Аппаратные ограничения
Как NVIDIA делает из одного кристалла и датацентровую A100, и майнинговую CMP? Чтобы это понять, нужно присмотреться к контроллеру фьюзов в GA100.
Контроллер фьюзов — блок, в котором 16 384 eFuse (512 строк по 32) и много логики вокруг самого массива фьюзов. Его работа — считывать и программировать фьюзы, защищать их и выдавать остальному кристаллу удобные «слова опций» (option words). Эти слова и определяют, как работает кристалл и какие функции включены.
Каждый eFuse бывает в одном из двух состояний (пережжён = 1, цел = 0), а 512 строк делятся на четыре области:
Обычные фьюзы (строки 0–221). Здесь всё прямолинейно: часто одиночные фьюзы (или пары) соответствуют слову опции, например
OPT_ENABLE_FUSE_PROGRAM— слово, которое определяет, разрешено ли дальше программировать фьюзы. У обычных фьюзов есть встроенная избыточность: тот жеOPT_ENABLE_FUSE_PROGRAMсостоит из основного (PRI) и резервного (RED) фьюза, в данном случае основной — фьюз 0 строки 0, резервный — фьюз 0 строки 1. Некоторые слова опций скалярные, напримерOPT_X_COORDINATEшириной 9 бит, где, судя по всему, хранится координата X кристалла на пластине. Важно: если обычный фьюз пережжён, способа надёжно его «восстановить» по сути нет (если не считать RIR, о нём ниже).Бесфьюзовые фьюзы (fuseless fuses, FF; строки 222–487). Это странная штука. Похоже, NVIDIA надоело случайно пережигать обычные фьюзы и губить инженерные образцы, и она придумала систему, которая кодирует итоговые слова опций в формате, похожем на JTAG-цепочку (см. этот патент). FF — это, по сути, скрипт, описывающий, какие значения должны получить какие слова опций. FF-фьюзы (простите за масло масляное) отвечают за большую часть того, что можно разблокировать глитчем. Дело в том, что FF-слова опций тривиально сбрасываются: достаточно записать новые FF-строки! Подробнее об этом дальше. Пока важно знать, что NVIDIA тоже это знает: в обычных условиях пережигать FF-фьюзы строго запрещено.
IFF-фьюзы (строки 487–512). В них инструкции в другом формате, чем у FF. Они за рамками этой статьи и нужны в основном для перепрограммирования слов опций контроллера на лету. На серийной карте они обычно недоступны.
RIR-фьюзы (8 строк по 32 фьюза, формально не входят в 512 строк). Их предоставляет разработчик самого массива фьюзов (даташит TSMC здесь), это штатный механизм «ремонта фьюзов» от производителя. В области RIR на GA100 есть место для 16 инструкций ремонта, каждая переопределяет значение одного указанного фьюза в основных 512 строках. К сожалению, именно в SKU 170HX 8GB 15 из 16 слов RIR — все единицы, а 16-е кодирует бесполезную инструкцию, которую лишь изредка удаётся использовать для чего-то интересного. С 10-гигабайтной версией история другая, но это тема для другого раза…
Для разблокировки глитчем интересны две группы фьюзов:
«Управляющие фьюзы» (control fuses). Термин взят из заголовочных файлов NVIDIA для Tegra, там он обозначает именно строки 0 и 1, где задаются значения слов опций, критичных для безопасности.
Бесфьюзовые фьюзы: в них закодированы все интересные слова опций, которые решают, родится GA100 жалкой майнинговой картой или рабочей лошадкой ИИ-датацентра.
Прежде чем называть FF-слова опций, нужно чуть подробнее разобрать формат FF-записи, а затем поговорить о блоках кристалла, которые отвечают за нужные нам функции.
Бесфьюзовые фьюзы
Каждая FF-строка — 32-битная запись. Биты 0–4 выбирают цепочку, бит 5 отличает FF от IFF (0 для FF), биты 6–15 выбирают 16-битный блок, а биты 16–31 задают новое значение этого блока. Картинка с JTAG-цепочкой из патента здесь буквальна: контроллер собирает данные опций, проигрывая эти записи в цепочки. Фиксированные позиции в каждой цепочке соответствуют отдельным словам опций.
Если две записи адресуют одну и ту же цепочку и блок, побеждает более поздняя. Например, 0x0fe805c1 означает цепочку 1, блок 23, данные 0x0fe8. Дописав такую запись, можно сбросить бит, выставленный более ранней FF-записью. Ни один физический фьюз при этом не восстанавливается: новая строка просто заменяет прежний 16-битный блок. Это работает для опций на FF, но не для обычных управляющих фьюзов в строках 0 и 1.
Теперь, зная, как кодируются FF-слова, вот список интересных слов и их расположение. Их нашёл один очень отзывчивый исследователь: он сравнивал значения FF и итоговые слова опций у разных SKU GA100 и так, дифференциально, восстановил соответствие цепочек и блоков FF словам опций — официальной таблицы соответствия не известно.
Опция | Предполагаемое место в FF | Назначение |
|---|---|---|
| Цепочка 1, биты 83–106; блоки 5–6 | Отключение I/O памяти |
| Цепочка 1, биты 107–130; блоки 6–8 | Отключение подразделов памяти |
| Цепочка 1, биты 131–138; блок 8 | Отключение GPC |
| Цепочка 1, биты с 187+8i по 194+8i для GPC i; блоки 11–15 | Восемь масок TPC |
| Цепочка 1, биты 251–274; блоки 15–17 | Отключение PES |
| Цепочка 1, биты 307–318; блок 19 | Отключение разделов видеопамяти |
| Цепочка 1, биты 319–342; блоки 19–21 | Отключение ROP/L2 |
| Цепочка 1, биты 368–370; блок 23 | Маска отключения NVLink |
| Цепочка 2, блок 39; какой из битов, 1 или 9, не выяснено | Ограничение скорости PCIe Gen3 |
| Цепочка 2, блок 47, бит 3 | Флаг запрета скорости Gen4 |
| Цепочка 2, блок 49, бит 6 | Политика загрузки PCIe |
| Цепочка 2, блок 49, бит 7 | Политика загрузки PCIe |
| Цепочка 2, биты 593–608; блоки 37–38 | Идентификатор устройства |
| Цепочка 2, биты 609–624; блоки 38–39 | Идентификатор устройства |
| Цепочка 1, биты 372–379; блок 23 | Включённые конвейеры Multi-Instance GPU |
Аббревиатуры FBIO/FBPA/FBP/TPC/GPC/PES/ROP обозначают элементы микроархитектуры. Как они связаны друг с другом, лучше посмотреть на схеме из whitepaper по GA100:
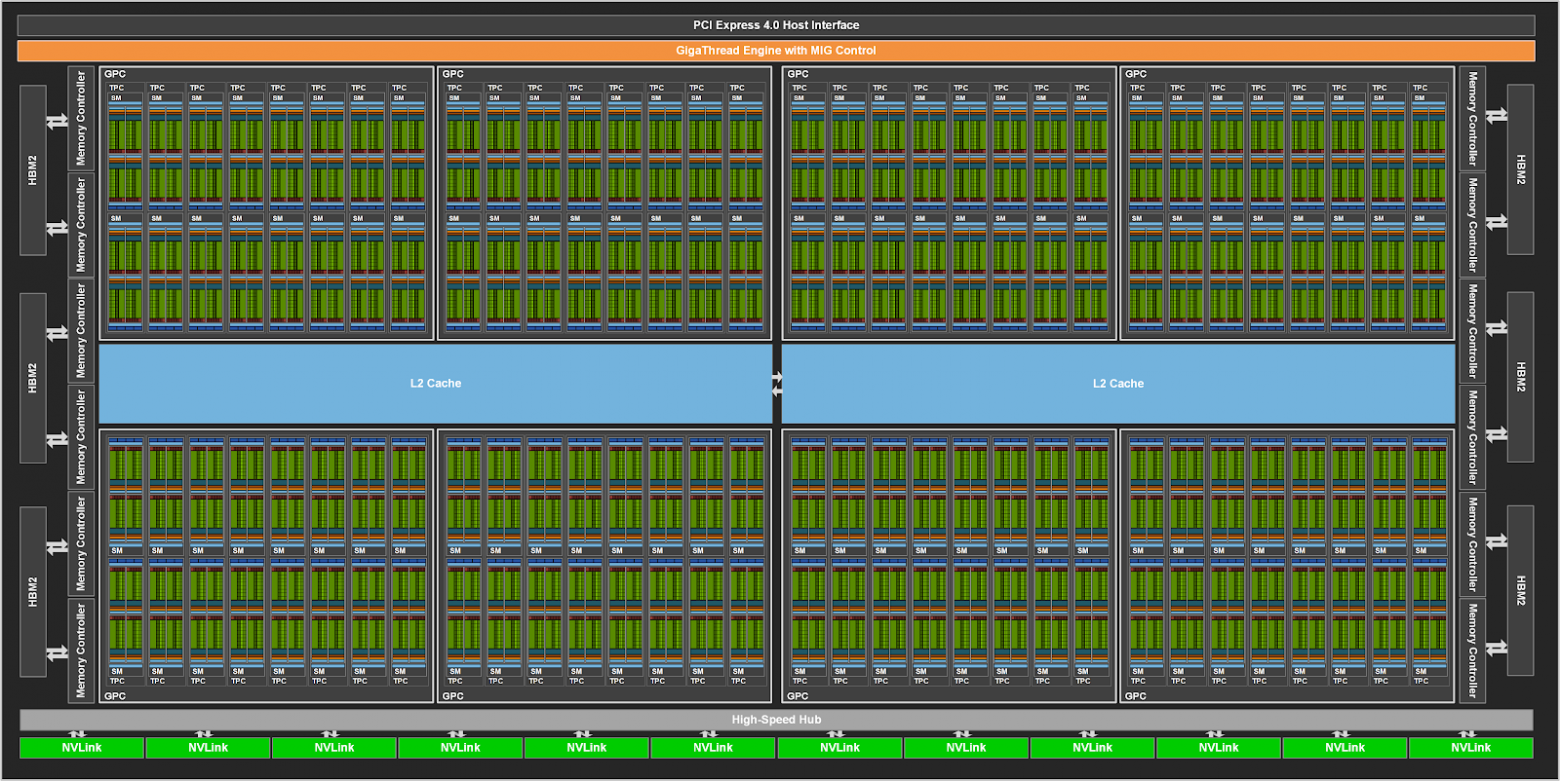
FBP — внутренний термин NVIDIA для «раздела видеопамяти» (framebuffer partition), на один стек HBM приходится два FBP. FBPA — подразделы, по два на FBP. PES и ROP — блоки (судя по всему, связанные с графикой), без которых SM не работает.
С этим знанием возникает вопрос: а что если записать новые FF-строки, которые выставят слова _DISABLE в нули или хотя бы сделают их настолько разрешающими, насколько позволяют дефекты кристалла? Если посмотреть, как слова _DISABLE используются вместе с другими элементами, быстро становится видно, что это главный рычаг, не дающий «отрезать» (floorsweep) части кристалла. Сначала разберу, что это даёт, а потом — как именно применяется глитч и какие защиты контроллера фьюзов он обходит.
Отключение блоков (floorsweeping)
NVIDIA поручает этим опциям выставлять сигналы floorsweep, которые делают элемент кристалла недоступным (и, вероятно, обесточенным). По результатам экспериментов я думаю, что линии floorsweep заданы прямо в RTL: они идут от контроллера фьюзов к отдельным функциональным блокам и управляют неким главным переключателем домена питания или тактирования внутри блока. Отключение блока, по моим наблюдениям, следует за итоговым словом статуса контроллера фьюзов для этого блока почти без задержки.
Возьмём, к примеру, отключение FBP. На одной из моих 8-гигабайтных карт OPT_FBP_DISABLE равнялось 0x852: замаскированы FBP 1, 4, 6 и 11. Отдельная маска OPT_FBP_DEFECTIVE равнялась 0x840 и покрывала 6 и 11. Когда я уменьшаю маску отключения на FF до 0x840 заменяющей FF-строкой, лишние маски на 1 и 4 исчезают, а дефектные 6 и 11 остаются отключены. В итоговой маске остаётся 10 из 12 FBP кристалла. FBP 1 и 4, которые при OPT_FBP_DISABLE = 0x852 отказывались читать и писать регистры, после этой записи фьюзов начинают отвечать.
Хотя функциональные блоки FF-записями можно «вернуть», для конечного приложения этого недостаточно: например, конфигурация видеопамяти по умолчанию использует только часть каждого доступного стека HBM.
Чтобы обойти это, можно применить по сути небольшую модификацию метода cmpunlocker. Обычный патч драйвера для разблокировки 8 → 64 ГБ пишет в определённый набор слов конфигурации функций (FBPA_CFG, SM_SPEED_SELECT и т. д.). Значения по умолчанию подобраны так, чтобы работать на самом распространённом варианте 170HX, где FF-слова _DISABLE не дают пользоваться частью функциональных блоков (любая попытка к ним обратиться возвращает ошибку floorswept). Когда разблокирующие FF-записи прожжены, в конфигурационные регистры можно записать ещё более разрешающие значения, и в итоге получается функционально A100-80G.
Как прожечь FF
Из всего сказанного вроде бы прямо следует: если уметь пережигать произвольные FF-фьюзы, любой GA100 можно полностью разблокировать до максимума, который позволяют выход годных и распаянные стеки памяти. Но как пережечь FF-фьюзы? Посмотрим, как контроллер программирует фьюзы.
Чтобы запросить пережигание, нужно записать регистры контроллера FUSEADDR, FUSEWDATA и FUSECTRL. Хост и непривилегированные агенты к ним формально доступа не имеют, но с ROP-цепочкой из работы «Canary in the Crypto Mine» открыть соответствующие маски уровней привилегий тривиально. Поэтому многие исследователи пытались заставить контроллер пережечь фьюзы в области FF. Вот что мы общими силами заметили:
У контроллера фьюзов есть внутренний конечный автомат, своё текущее состояние он показывает битами
FUSECTRL_STATE.Контроллер переходит в состояние
WRITE_PROGRAMдля каждого «горячего» бита в запрошенном значенииFUSEWDATA. Это совпадает с ожидаемым поведением при программировании фьюзов.Однако пока не сброшено одно определённое слово опции, записи по адресам вне диапазона FPF (строки 96–221) на самом деле не происходят. Фьюзы в этом диапазоне (предположительно фьюзы, программируемые в условиях эксплуатации (field programmable), где отмечено, какие версии микрокода уже запускались, и прочая информация для эксплуатации) прожигаются, и конечный автомат контроллера ведёт себя одинаково в областях FPF и не-FPF.
Слово опции, о котором речь, — OPT_SECURED_BURN_FEATURE_ENABLE (SBFE), на всех серийных картах оно равно 1. Когда оно сброшено, программировать фьюзы можно по любому адресу. Когда выставлено — пережигать можно только фьюзы FPF. До сих пор никто не нашёл способа прожечь FF-фьюзы при SBFE = 1, даже управляя контроллером из HS-контекстов. Не ясно, что на самом деле значит «secured burn». Подозреваю, что есть чисто программный способ прожечь не-FPF-фьюзы даже при SBFE = 1, и мы просто не знаем, что здесь означает прилагательное «secured».
Примечание. PLM, HS, ucode… — по мере углубления объяснения здесь становится много специфичной для NVIDIA терминологии. За действительно подробным объяснением отсылаю к другим источникам, например Je Ne Sais Quoi - Falcons over the Horizon.
Важно, что, как выяснили на более «мягких» картах, при SBFE = 0 прожигать FF можно! И, как оказалось, добиться этого состояния — и есть путь к разблокировке GA100. После долгих проб и ошибок мне пришлось вызывать это состояние глитчем напряжения, и это получилось. Поговорим о глитчинге подробнее.
Глитч напряжения
О VFI сказано много, подробные объяснения оставлю другим источникам. Если коротко: короткие провалы напряжения питания часто вызывают у интегральных схем неожиданное поведение. Плату на STM32G4 по моей просьбе спроектировала модель GPT-6 Astra; плата подключается к сигналу PWMVID на плате CMP. PWMVID — стандарт NVIDIA для регуляторов напряжения. Мой глитчер перехватывает ШИМ-сигнал, который выдаёт кристалл GA100, и подменяет его своим сигналом, подаваемым на контроллер VRM MP2888B. В такой схеме собственный VRM карты сам выдаёт нужные мне по времени глитчи. Это проще, чем схемы на MOSFET, и позволяет глитчить быстрее, чем при попытке управлять напрямую по PMBus.
Глитчеру нужно два подключения к плате, лучше всего тонким эмалированным проводом. Один провод берёт NVVDD для измерения напряжения, другой — сигнал PWMVID. Ещё нужно только выпаять один нулевой резистор 0402, который соединяет ШИМ-выход GA100 с микросхемой VRM. Куда подключаться, легко найти, проследив выводы MP2888B, а именно PWMVID и VOSEN (у MP2888B тот же корпус и разводка, что у его публично документированного собрата MP2888A). Тестовые точки рядом с MP2888B позволяют сравнительно легко подпаять отвод PWMVID.
С этим отводом одна попытка глитча выглядит так:
Снять питание с карты.
Подать питание на карту.
Запустить таймер («таймер глитча»), как только NVVDD пересечёт порог.
Выдать нужную форму напряжения через сигнал PWMVID, привязанную к таймеру глитча.
Посмотреть на поведение карты и при необходимости повторить с шага 1.
Шаги 1 и 2 у меня делаются простым переходом ACPI S0 → S3 → S0, на современной настольной платформе это несколько секунд. Более серьёзные доработки или дорогие стенды, вероятно, дадут больше попыток в единицу времени, но по моему опыту такой установки хватает, чтобы разблокировать карту за срок от 1 до 48 часов глитчинга при подходе, описанном ниже.
Для порога NVVDD прошивка, написанная Astra, использует компаратор STM32: он ловит момент, когда NVVDD пересекает 225 мВ, после чего плотный цикл на DMA выдаёт нужный коэффициент заполнения на вывод PWMVID. После возврата в S0 хост проверяет состояние карты и решает, что делать дальше; если нужен ещё один глитч, плата глитчера получает по USB команду с шаблоном глитча. Затем хост уходит в S3 с будильником RTC, чтобы проснуться примерно через 3 секунды (период подобран опытным путём ради стабильности).
Иногда хост не возвращается в S0. Это решено так: учёт и подготовка серий глитчей вынесены на одноплатник (Radxa Cubie A5E), который при зависании целевого хоста может через GPIO нажимать кнопки питания и сброса на материнской плате.
Подробности — в репозитории GA100VFI. А пока посмотрим, какие интересные состояния можно вызвать глитчем и какое именно нужно, чтобы прожечь FF-строки. Чтобы яснее показать разницу между состояниями, у меня есть эмпирическая модель того, как стартует контроллер фьюзов при подаче питания. Без RTL контроллера это всё лишь догадки. Предполагаемые этапы загрузки:
Считывание RIR, как того требует массив фьюзов.
Считывание (из массива фьюзов в регистр чтения) управляющих строк.
Защёлкивание управляющих строк в производные от них слова опций.
Считывание остальных строк.
Защёлкивание значений обычных фьюзов в их слова опций.
Разбор FF-цепочки.
Защёлкивание значений FF-цепочки в их слова опций.
Эти гипотетические этапы основаны на том, что реально удаётся прочитать с кристалла: состояния контроллера, сырые строки, когда работает CMD_READ, публикуемые слова опций и то, достаёт ли кольцо PRI до остального GPU. По нескольким ключевым значениям можно различать исходы глитча. Важно: шаблоны глитчей и их исходы очень сильно зависят от конкретного кристалла, так что примеры форм сигнала и реакций ниже — именно примеры. Рассмотрим три интересных состояния.
1. Все фьюзы считаны как ноль
Команда PWMVID: коэффициент заполнения 59,58% / 0,8333%, один импульс с 210 по 1010 мс после срабатывания триггера NVVDD ≥ 225 мВ (длительность 800 мс). На графике в оригинале показано смоделированное напряжение NVVDD, в том же прогоне его не измеряли; в этой попытке нулями прочитались 668 из 672 опций, пример 669/672 ниже взят из другого захвата.
Некоторые глитчи заставляют почти все публикуемые слова опций читаться как ноль. В одном захваченном состоянии 669 из 672 именованных опций прочитались нулями, остальные три вернули ошибки. Статус CRC контроллера был 0x00 (ещё не разобрано), PCIe ID читался как 2080 (базовый идентификатор GA100, которому не соответствует ни один реальный серийный продукт). Кольцо PRI в GPU при этом держалось в сбросе.
Это состояние похоже на катастрофический сбой контроллера фьюзов. Карта поднимается практически нерабочей, потому что состояние «всё по нулям» нарушает почти все функции загрузки. Но, что любопытно, карта сама по себе выходит на PCIe Gen4! В слегка изменённых вариантах этого состояния часть фьюзов может защёлкиваться успешно или содержать мусор вместо нулей. Ни одно из таких состояний мне не удалось довести до прожига FF: почти во всех контроллер фьюзов недоступен или не работает.
2. Нарушено чтение RIR
Команда PWMVID: коэффициент заполнения 59,58% / 0,8333%, один импульс с 980 по 1005 мс после триггера (длительность 25 мс). Чтение, при котором менялась только строка 18, повторилось при второй загрузке; участие RIR здесь — гипотеза.
Если прочитать данные RIR на CMP 170HX 8GB, видно, что именно они делают: 15 пустых инструкций ремонта и одна запись, меняющая значение фьюза в строке 18, чьё слово опции можно отслеживать. Кроме того, поскольку считанные RIR потребляет сам массив фьюзов, минуя контроллер, нарушенное защёлкивание RIR видно при попытке прочитать сырую строку: замеченный переворот бита одинаково проявляется и в слове опции, и в сырой строке фьюзов. Это даёт интересную хронологическую отметку для исследования загрузки кристалла (RIR должен считываться раньше остальных фьюзов), но сам по себе такой глитч бесполезен.
3. Глитч «в самый раз»
Команда PWMVID: коэффициент заполнения 59,58% / 0,8333%, три импульса по 2 мс после триггера: 979,94–981,94 мс, 983,94–985,94 мс и 987,94–989,94 мс.
Удачное состояние с тремя импульсами на моей первой карте, судя по всему, нарушало ровно слова опций из строк 0 и 1, оставляя остальные фьюзы и слова опций нетронутыми. В этом состоянии все слова опций, производные от строк 0/1, равны нулю. Начальные значения выглядят так:
Сигнал | Начальное значение |
|---|---|
PCI ID и доступ |
|
|
|
|
|
|
|
|
|
|
|
Маски привилегий FUSECTRL/FUSEOPT |
|
Сырые строки 0 и 1 | Обе по-прежнему |
На этом этапе FF-записи ещё невозможны, потому что ENABLE_FUSE_PROGRAM = 0. Честно говоря, мне не ясно, зачем ENABLE_FUSE_PROGRAM вообще может быть нулём, если на серийных платах это 1, так что это очень похоже на канарейку для обнаружения глитча (по крайней мере, так было бы изящно её сделать).
Фьюзы считываются построчно: все 32 фьюза строки запитываются для чтения одной линией, поэтому атакующему гораздо труднее заставить отдельный фьюз выглядеть сброшенным или пережжённым. Тогда логично добавить фьюз-«канарейку», который при сбросе отключает критичные для безопасности функции (вроде пережигания фьюзов): ведь обычно атакующий может влиять на чтение фьюзов максимум с точностью до строки. Поэтому, когда слова опций строк 0/1 оказываются все сброшены, ENABLE_FUSE_PROGRAM = 0 не даёт пережечь ни одного фьюза.
Но посмотрите, что ещё есть в этом состоянии: DISABLE_SW_OVERRIDE = 0. Обычно это слово равно 1 и не даёт выставить регистр EN_SW_OVERRIDE в 1. Именно этот регистр позволяет «затенять» (shadow) большинство слов опций, которые выдаёт контроллер. Для этого пишется регистр CTRL_OPT_*, соответствующий слову опции OPT_*, и он определяет итоговое значение STATUS_OPT_*. Так можно затенить SBFE в 0. Но даже при DSOV = 0 ENABLE_FUSE_PROGRAM оказывается одним из слов опций, которые затенить нельзя. Похоже, тупик.
По крайней мере, так мне казалось, и мне пришлось довольно долго биться головой о стену в этом состоянии. Потом бросилась в глаза одна команда контроллера фьюзов, которую ещё не пробовали: SENSE_CTRL. Запускать её не хотелось, потому что на первый взгляд после неё все слова опций из строк 0/1 (управляющих фьюзов) вернутся к прожжённым значениям: SBFE снова выставится, программное затенение отключится, и пережигать будет нельзя. К моему удивлению, после этой команды все опции из управляющих фьюзов действительно вернулись к прожжённым значениям, кроме DISABLE_SW_OVERRIDE, которое осталось равным 0!
При DSOV = 0 SBFE тривиально выставляется в 0, ENABLE_FUSE_PROGRAM равно 1, потому что совпадает с прожжённым значением, — и можно начинать! Остаётся одна загвоздка: у FUSEWDATA может быть закрытая PLM, но при DSOV = 0 достаточно записать 0 в OPT_SECURE_FUSE_WDATA_WR_SECURE, чтобы PLM стала из одних единиц и хост получил доступ к прожигу.
Дальше остаётся вычислить слова _DISABLE, совпадающие со значениями _DEFECTIVE для нужных функций, и прожечь FF-записи. Учтите, что занятая область FF и дефектные биты у каждого кристалла свои, так что каждый прожиг нужно рассчитывать под конкретный кристалл.
Итоги
Разблокировка видеопамяти
На 8-гигабайтных картах, где все 80 ГБ исправны (судя по моей небольшой выборке, это около 90% таких карт), разблокировка даёт полные 80 ГБ доступной видеопамяти. Несколько синтетических тестов (запись псевдослучайных слов по всей видеопамяти и чтение их обратно после инвалидации L2) и реальные нагрузки (например, vLLM и SGLang) полностью работают.
Как уже говорилось, на одной из моих карт исправны только 64 ГБ. В этом случае аппаратная разблокировка по памяти ничего не добавляет.
Разблокировка вычислений
Из коробки 170HX ограничена 70 SM из 128. На практике на кристалле почти всегда больше 120 исправных SM, и разблокировка позволяет задействовать их все. Это даёт заметный прирост: примерно в 1,7 раза по сравнению с чисто программной разблокировкой 170HX и даже впечатляющие ~1,2 раза относительно серийной A100!
Карта (ProjectPhysX OpenCL-Benchmark, FP16 half2 FMA) | TFLOP/s | Относительно серийной A100 |
|---|---|---|
CMP 170HX с программной разблокировкой | 50,129 | 0,69× |
Серийная A100 | 72,488 | 1,00× |
CMP 170HX с аппаратной разблокировкой | 85,861 | 1,18× |
Поколение PCIe
Единственное, что не даёт cmpunlocker подняться выше PCIe Gen2, — FF-слова опций. Если сбросить нужные биты, Gen3 и Gen4 поднимаются и подтверждённо полностью работают. Вместе с доработкой развязывающих конденсаторов PCIe достижим PCIe Gen4 x16, как у серийной A100 в исполнении PCIe.
NVLink
Обнуление слова OPT_NVLINK_DISABLE — лишь одна из доработок, нужных для работы NVLink. На плате CMP 170HX не распаяна микросхема U11 (она подключает 3,3 В от PCIe к выводу мостика NVLink), поэтому на стоковой плате генератор опорной частоты подключённых мостиков NVLink не запускается. Достаточно перемкнуть два вывода на посадочном месте U11, хотя при этом пропадает та регулировка или защита, которую давала U11. Будьте осторожны, если соединяете мостиком GPU, запитанные от разных блоков питания: шины +3,3 В окажутся соединены, если не оставить U11 нераспаянной на части карт! Мостик NVLink нормально работает, если доработать U11 только на одной плате из пары.
Со стороны прошивки для включения NVLink есть проверка в ROM, которую нужно обойти дополнительными командами с хоста. Ваша нейронка наверняка разберётся ;)
Разбираясь с NVLink, мне попалось ещё несколько интересных особенностей реализации NVLink в GA100. Про них будет отдельный пост, следите за обновлениями!
Что дальше
Произвольный прожиг фьюзов в основном даёт разблокировку функций. Некоторые чувствительные для безопасности опции поставляются непрожжёнными, и их прожиг может дать интересные точки опоры. Но мне куда интереснее более глубокие состояния глитча, в которых многие прожжённые по умолчанию фьюзы безопасности читаются как непрожжённые: это открывает пути вроде отладочного выполнения в HS-режиме, а оно даёт беспрецедентный доступ к внутренностям кристалла.
Ссылки
Jon Pry, A Canary in the Crypto Mine: Defeating Stack Protection in a GPU Secure Coprocessor (2026).
Amogh Munikote, cmpunlocker (2026).
Otto Bittner et al., The Forgotten Threat of Voltage Glitching: A Case Study on Nvidia Tegra X2 SoCs (2021).
NVIDIA, US9230678B2: Integrated circuit having an enhanced fuseless fuse structure (2016).
TSMC, TEF07F32X32HD18_PHRM_C180518 electrical fuse datasheet, rev. 120A (2018).
hexkyz и SciresM, Je Ne Sais Quoi - Falcons over the Horizon (2021).
TechPowerUp, NVIDIA GA100 GPU specifications.
Примечания
По личным наблюдениям: из 10 экземпляров CMP 170HX 8GB, которые прошли через мои руки, только один пришёл с 64 ГБ рабочей памяти, у остальных рабочий объём видеопамяти — 80 ГБ.
Хотя в статье «Canary in the Crypto Mine» говорится о стабильных 80 ГБ на 10-гигабайтной версии, очень немногим картам «в дикой природе», если вообще каким-то, это удалось, и надёжных доказательств мало. Не исключено, что какая-то часть 10-гигабайтных карт действительно приходит с 80 ГБ на плате, но, по данным сообщества, доля таких карт, похоже, очень мала. Большинство «нестабильных» разблокировок до 80 ГБ объясняются сочетанием кеширования в L2 и алиасинга памяти поверх реальных 40 ГБ.
Для NVLink дополнительно нужна совсем небольшая аппаратная доработка из-за отсутствующего на плате 170HX компонента, о ней ниже в разделе про NVLink.
Не проверялось.


Комментарии 0