Много лет занимаюсь парсингом: каталоги, цены, карточки товаров, объявления. Всё это время из проекта в проект кочевал мой самописный HTML-парсер. Он стабильно работал на миллионах страниц, но показывать его наружу было как-то неловко: тесты покрывали только нужные мне сайты, комментарии были на двух языках вперемешку, документации не было вовсе. Появилась иишка и доделала то что мне было лень и я выложил nuget: z3l.FastHtmlParser
Ниже разбираемся, почему стандартные библиотеки на таких задачах впустую тратят процессорное время, как уйти от аллокаций DOM и где проходят границы применимости легковесного подхода.
Почему DOM избыточен для парсинга
Парсинг — это работа с объёмами. Когда через сервис проходят миллионы страниц в сутки, разбор разметки оказывается самым горячим циклом, а затраты на серверы растут пропорционально.
Лидеры рынка в .NET — HtmlAgilityPack и AngleSharp — отличные библиотеки, но решают более общую задачу браузерного уровня. Они строят полноценный DOM: создают отдельный объект на каждый узел, достраивают неявные <html>, <head>, <tbody>, держат дерево для мутаций и обхода CSS-селекторами.
Для извлечения данных почти ничего из этого не нужно. Задача простая: найти элемент, забрать текст или значение атрибута и перейти к следующей странице. Всё остальное превращается в лишнюю работу процессора и сборщика мусора (GC).
Отсюда простая идея: не строить то, что не будет использовано. Документ можно представить как просто список кусков исходной строки.
Бенчмарки
Тестовый стенд: BenchmarkDotNet 0.15.8, .NET 10, Intel Xeon E-2236, Windows Server 2025. Страницы настоящие, сохранённые с books.toscrape.com, quotes.toscrape.com и webscraper.io/test-sites. Версии библиотек: AngleSharp 1.10.0, HtmlAgilityPack 1.13.1.
1. Только разбор страницы:
Страница | z3l.FastHtmlParser | HtmlAgilityPack | AngleSharp |
quotes, 11 КБ | 19,1 мкс / 10,8 КБ | 173,8 мкс / 243 КБ | 260,4 мкс / 189 КБ |
laptops, 38 КБ | 56,9 мкс / 30,7 КБ | 583,8 мкс / 713 КБ | 1 096,4 мкс / 608 КБ |
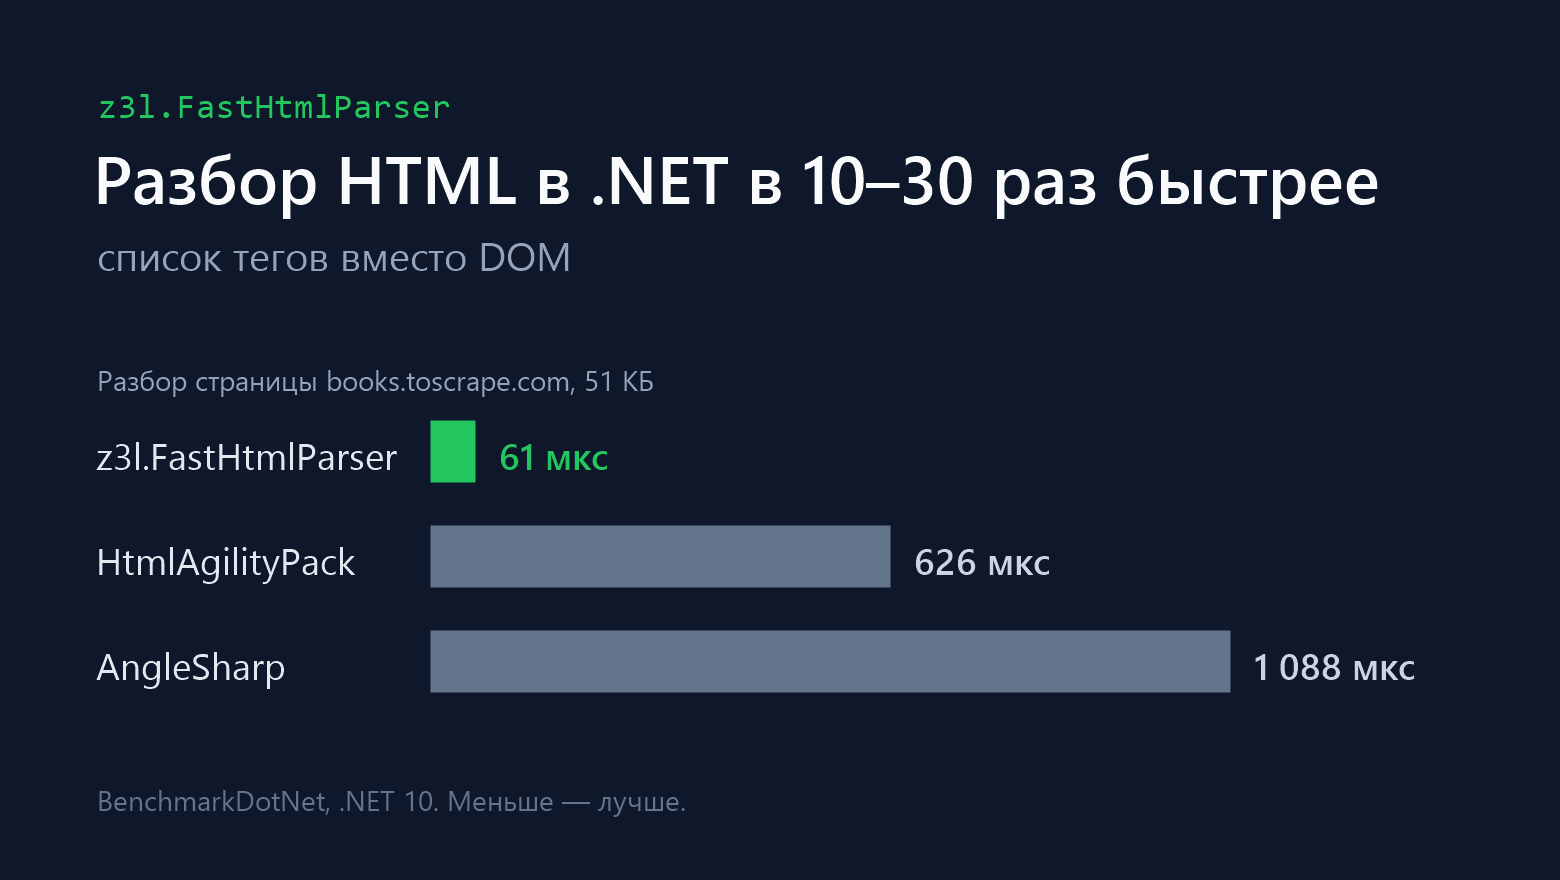
books, 51 КБ | 61,0 мкс / 39,2 КБ | 625,8 мкс / 812 КБ | 1 087,5 мкс / 663 КБ |
books без </li> и </p>, 51 КБ | 63,4 мкс / 39,2 КБ | 728,5 мкс / 756 КБ | 1 044,4 мкс / 644 КБ |
books ×10, 510 КБ | 0,66 мс / 391 КБ | 20,9 мс / 8,1 МБ | 13,8 мс / 6,3 МБ |
2. Полная задача: разобрать страницу и вытащить записи.
Задача | z3l.FastHtmlParser | HtmlAgilityPack | AngleSharp |
20 книг: название, цена, рейтинг | 71 мкс / 45 КБ | 862 мкс / 1 038 КБ | 1 160 мкс / 707 КБ |
10 цитат: текст, автор, теги | 24 мкс / 18 КБ | 257 мкс / 401 КБ | 292 мкс / 228 КБ |
На типичных страницах выигрыш составляет около 10 раз по времени и 12–23 раза по памяти. На больших страницах отрыв от HtmlAgilityPack доходит до 33 раз.
Сложная страница: выдача Amazon
Учебные страницы аккуратные и компактные. Для контраста я взял реальную страницу поисковой выдачи Amazon: 1 МБ веса, больше сотни встроенных <script>, около 4 тысяч тегов. Задача: из 27 товаров достать ASIN, цену, название, рейтинг и признак Prime.
foreach (var row in new HtmlParser(html).FindAll(HtmlTag.Div, cls: "s-result-item"))
{
    var asin = row.AttributeByName("data-asin");
    if (string.IsNullOrEmpty(asin)) continue;

    var price = row.Find(HtmlTag.Span, cls: "a-price");
    var name = row.Find(HtmlTag.H2).Text();
    var whole = price.Find(HtmlTag.Span, cls: "a-price-whole").Text();     // null, если цены нет
    var rating = row.Find(HtmlTag.I, cls: "a-icon-star-mini")
                    .Find(HtmlTag.Span, cls: "a-icon-alt").Text();          // "4.2 out of 5 stars"
    // ...
}
Amazon, 1 МБ | z3l.FastHtmlParser | HtmlAgilityPack | AngleSharp |
Разбор | 0,72 мс | 12,3 мс | 16,3 мс |
Разбор + 27 товаров | 0,90 мс | 18,0 мс | 19,8 мс |
Памяти уходит в 23–29 раз меньше, а результаты работы совпадают во всех трёх библиотеках. Страницы в репозитории нет из-за авторских прав, но сам бенчмарк на месте (LocalScrapeBenchmarks): можно сохранить локальный HTML выдачи в benchmarks/local/amazon*.html и перепроверить.
Архитектура: как это устроено
1. Список тегов вместо DOM
Документ — это исходная строка и List<ParserTag> в порядке появления элементов в тексте. Каждый узел хранит только числовые границы:
public class ParserTag
{
    public int Start { get; }        // позиция '<'
    public int End { get; }          // позиция последнего '>'
    public int InnerStart { get; }   // сразу после открывающего тега
    public int InnerEnd { get; }     // перед закрывающим тегом
    public int Depth { get; }
    // ...
}
Текст, внутренний HTML и атрибуты при разборе не выделяются в отдельные строки. Это срезы исходного буфера, вычисляемые строго по запросу. Иерархия (родители, дети, соседи) выводится из индексов и глубины: потомки тега идут в списке сразу за ним, пока их End не выходит за границы его End.
2. Память выделяется один раз и ровно под размер
Каждый тег начинается со знака <, поэтому векторизованный pagesource.Count('<') даёт надёжную верхнюю границу числа тегов. Разбор идёт во временные массивы из ArrayPool, а итоговый список создаётся один раз нужного объёма:
int maxTags = pagesource.Count('<');
ParserTag[] tags = ArrayPool<ParserTag>.Shared.Rent(maxTags);
TagState[] states = ArrayPool<TagState>.Shared.Rent(maxTags);
// ... разбор ...
var result = new List<ParserTag>(count);
CollectionsMarshal.SetCount(result, count);
tags.AsSpan(0, count).CopyTo(CollectionsMarshal.AsSpan(result));
Никаких удвоений буфера List<T> по мере чтения. Перед возвратом в пул массивы очищаются, чтобы не удерживать ссылки на разобранный документ.
3. Векторизованный проход
Вне тегов информативен только символ <, поэтому переход к нему выполняется через векторизованный IndexOf. Внутри тега важны только <, = и >, под которые задействован IndexOfAny. Значения атрибутов в кавычках пропускаются блоком, поэтому конструкции вроде data-x="<p>...</p>" парсер не ломают.
Содержимое script, style, textarea, title по правилам HTML5 считается сырым текстом, а не разметкой. Парсер сразу сканирует строку до закрывающего </script или аналогичного тега и переходит к нему без посимвольного разбора внутренностей.
4. Закрывающие теги без квадратичного поиска
Попытка на каждый закрывающий тег бежать назад по общему массиву на больших страницах приводит к О(n2). Поэтому служебное состояние хранится отдельно от ParserTag в массиве структур из пула, а открытые теги объединены в двусвязный список:
private struct TagState
{
    public int Key;      // (int)HtmlTag или -1 для нестандартного имени
    public int Depth;
    public bool Open;
    public int PrevOpen; // двусвязный список открытых тегов
    public int NextOpen;
Закрывающий тег проверяет только открытых кандидатов. Закрытый узел удаляется из списка за O(1). Проверки идут по числовым идентификаторам, а не по строкам.
5. Имена тегов без аллокаций строк
Имя тега в потоке парсинга — это ReadOnlySpan<char>. Чтобы не аллоцировать строку под каждый узел, поиск значения в справочнике выполняется через Dictionary<string, HtmlTag>.AlternateLookup<ReadOnlySpan<char>> из .NET 9. Результат — элемент перечисления, с которым дальше работают как с обычным int.
FrozenDictionary, созданный под такие сценарии, на этих замерах уступил:
● тратил около 16 мс на прогрев JIT при первом обращении (обычный Dictionary собирается за ~2 мс);
● под этой нагрузкой выполнял поиск примерно на 30% медленнее.
Остался классический Dictionary со своим компаратором:
// Хеш: длина и три символа в верхнем регистре вместо вычисления хеша по всей строке
private static int Hash(ReadOnlySpan<char> s)
{
    if (s.IsEmpty) return 0;
    return (int)(((uint)s.Length << 16) ^ (Upper(s[0]) << 8) ^ Upper(s[^1]) ^ (Upper(s[s.Length >> 1]) << 21));
Для ASCII есть быстрый путь приведения регистра через | 0x20. Если попадаются другие символы, вызывается стандартный OrdinalIgnoreCase. Для коротких ASCII-имен тегов этого достаточно. Тот же алгоритм используется для таблицы HTML-сущностей.
Нестандартные имена (кастомные теги, SVG) приводятся к нижнему регистру через stackalloc и интернируются один раз на документ.
6. Запросы: цепочки без IEnumerable
Типичный сценарий парсинга — цепочка вызовов:
doc.Find(HtmlTag.Div, id: "contacts")
   .Find(HtmlTag.A, cls: "phone")
   .NextSibling(HtmlTag.Span)
   .Text();
В DOM-библиотеках каждый такой шаг обычно оборачивается в IEnumerable (FirstOrDefault, Descendants, Where), создавая итераторы, замыкания лямбд и промежуточные буферы.
Здесь методы Find, Parent, Next и NextSibling возвращают один ParserTag. Внутри это обычный цикл for по индексам списка:
public static ParserTag? Find(this ITagSearchable? scope, in TagQuery query)
{
    if (scope == null) return null;

    scope.GetScope(out var tags, out int first, out int end);
    for (int i = first, count = tags.Count; i < count; i++)
    {
        var tag = tags[i];
        if (tag.End > end) break;
        if (query.Matches(tag)) return tag;
    }
    return null;
}
TagQuery передаётся по ссылке (in), преобразуясь на стеке. Вся цепочка выше без .Text() выделяет 0 байт в куче (проверяется через GC.GetAllocatedBytesForCurrentThread()). Аллоцируется только сама итоговая строка результата на вызове .Text() (32 байта). Ленивый IEnumerable остаётся только у FindAll и Children, где перебор действительно неизбежен.
Цепочки безопасны к null: если блок не найден, метод в конце возвращает null без выброса NullReferenceException.
Битый HTML и реальные грабли
На аккуратных тестах всё работало идеально, но проверка на реальных фрагментах с ошибками вскрыла проблему:
<ul><li>One<li>Two<li>Three</ul>Text() у всех элементов вернулся пустым, а второй <li> посчитался вложенным внутрь первого. Та же картина повторилась с незакрытыми <p>, <td>, <dt>/<dd>, <option>. По стандарту HTML5 закрывающие теги для них необязательны, и браузер схлопывает их автоматически.
Я опробовал три подхода:
1. Правила HTML5 прямо в основном цикле. Новый <li> закрывает открытый <li>, блочный элемент закрывает <p>. Чтобы не сканировать стек постоянно, на каждый тип завели счётчик. Работает, но скорость упала на 4–9%. Около 4% отнимали счётчики и правила, ещё 1% — проверка на букву после символа <.
2. Быстрый проход и локальный переразбор. Разбираем без проверок. Если на </ul> в стеке остались незакрытые элементы, откатываемся назад и переразбираем кусок. Итог оказался провальным: на странице books без закрывающих тегов разбор замедлился в два раза — с 61 до 119 мкс. Все 20 книг находились в одном общем списке <ol>, из-за чего повторно сканировалось больше 120% объёма документа.
3. Проверка вершины стека при открытии тега. Если открывается <li>, а на вершине стека висит незакрытый <li>, они находятся на одном уровне, и предыдущий закрывается сразу без отката. Это одно целочисленное сравнение и строго для ограниченного пула тегов: li, td, tr, dt, dd, option. Откат назад остался только для редких вложенных патологий вида <li><span>a<li>b.
Вариант | books, 51 КБ | books без </li> и </p> |
1.0: без правил | 56 мкс | быстро, но тексты пустые |
Правила в основном цикле | 63 мкс | 63 мкс |
Быстрый проход + откат | 60 мкс | 119 мкс |
Проверка при открытии тега | 61 мкс | 63 мкс |
Где парсер применять не стоит
Выигрыш по скорости и памяти получен за счёт отказа от браузерной избыточности. Если проект требует перечисленного ниже, лучше взять AngleSharp:
● нет поддержки CSS-селекторов и XPath (только методы Find/FindAll/TagQuery), в принципе ничего не мешает раскатать позже и работать будет достойно
● документ неизменяемый (только чтение);
● нет достраивания фиктивных узлов (<html>, <tbody>);
● платформа ограничена .NET 9 и .NET 10 (из-за AlternateLookup).
Если же задача — выкачивать и разбирать массивы страниц без лишних затрат на серверные мощности, этот подход показывает себя практичнее.
Лицензия
Для обычных людей никаких ограничений нет. Платная лицензия касается только крупных компаний, и платеж разовый. Ну и вдруг кто-нибудь заплатит )
Бесплатно для частных лиц и компаний с годовой выручкой меньше $1 млн и численностью меньше 100 сотрудников, в том числе для коммерческого использования. Крупным компаниям нужна коммерческая лицензия: разовый платёж $1000, бессрочно, на все версии. Исходники открыты на GitHub.
Ссылки
● GitHub: https://github.com/romanti3172/z3l.FastHtmlParser
● NuGet: https://www.nuget.org/packages/z3l.FastHtmlParser


Комментарии 0