Первые программисты в буквальном смысле собирали программу руками: переключали кабели и выставляли тумблеры. Потом они набивали машинный код на перфокартах, а вскоре перешли на ассемблер. Позже появились C и C++ — языки, уже более понятные человеку, но всё еще довольно душные в повседневной работе. За ними пришли Python, JavaScript и Go, на которых писать стало куда приятнее и быстрее. Каждый раз менялся способ, которым разработчик объясняет компьютеру, что от него требуется, и с каждым шагом это общение становилось всё проще и понятнее для человека.
ИИ-агенты стали следующим шагом в этом направлении: теперь рутинную часть задачи можно описать неформальным языком в виде ТЗ, отдать агенту и проконтролировать результат. Необходимости знать языки программирования это, конечно, не отменяет — иначе не получится заглянуть внутрь проекта и разобраться, почему что-то отвалилось. Но сама работа постепенно становится более текстовой и менеджерской.
Как именно при этом меняется повседневная разработка, мы решили разобрать на примере компьютерного зрения. Для этого поговорили с Владом Ломтевым, senior CV-инженером нашей команды. Его работа охватывает весь цикл задач от проектирования систем до оптимизации нейросетей. Вместе мы выделили пять рабочих сценариев, где агенты сильно экономят время, и выяснили, в каких вопросах они пасуют перед опытом живого специалиста.
Сценарий 1. Проектирование: ресерч и оформление идей
Любой проект, будь то заказная разработка, собственный продукт или внутренний инструмент, обычно начинается с неформальной и довольно верхнеуровневой задачи в духе «нужно, чтобы вот это работало». Перевести ее на язык машинного обучения и спроектировать архитектуру будущей системы агенту пока не по силам. На этом этапе решает опыт инженера, обычно уровня сеньора, который держит в голове неочевидные корнер-кейсы и понимает, на каких мелочах система может споткнуться в реальных условиях.
Роль же агента здесь сводится к двум вещам: он помогает быстрее изучить новую область, когда проект заходит на незнакомую территорию, и забирает на себя вспомогательную рутину.
Потребность в ресерче возникает не каждый раз, но если систему нужно спроектировать в малознакомой сфере и жестких ограничений по стеку нет, агент хорошо заменяет собой поисковик. Можно описать ему свои требования и попросить подобрать подходящие библиотеки и инструменты. Информацию для погружения в тему он организует заметно лучше поисковой выдачи, поэтому разобраться в деталях становится проще. Понятное дело, что оценивать предложенное и принимать финальное решение всё равно приходится самостоятельно, но сама база для выбора набирается в разы быстрее.
А вот вспомогательной рутины хватает на каждом проекте. Например, когда решение уже продумано и набросано на бумаге, его нужно оформить для тимлида или заказчика. А значит, черновики после мозгового штурма надо превратить в проектный документ, нарисовать блок-схемы, подготовить текст выступления и собрать презентацию. И как раз эту часть теперь удобно отдать агенту почти целиком.
Инженер обычно фиксирует свои мысли суховато, в виде краткого конспекта. Но если скормить его тому же Claude, он вполне прилично развернет тезисы в связный текст или соберет черновик презентации. А если заранее расписать, из каких разделов документ должен состоять и что в нем обязательно нужно отразить, результат будет еще ближе к нужному. Совсем без правок вряд ли обойдется, но редактировать придется меньше, чем можно ожидать.
Сценарий 2. Постановка и запуск экспериментов
Допустим, архитектуру согласовали и данные для обучения собрали. Дальше начинается этап экспериментов: нужно взять несколько подходящих моделей, будь то детекторы или классификаторы, и проверить гипотезы на практике.
Этот процесс традиционно требовал плотного погружения в чужой код. Чтобы запустить обучение даже уже существующей open-source модели, с которой еще не приходилось работать, нужно было клонировать репозиторий с GitHub, прочитать README, разобраться во внутреннем устройстве проекта, а затем руками переписать обработку данных, добавить аугментации и поправить нужные места в коде. Но даже если углубляться внутрь модели не требовалось, вставала проблема окружения. Поскольку обучение часто завязано на GPU, несовместимость библиотек с актуальной версией CUDA чинится куда сложнее, чем когда код работает без видеокарты. И если что-то всё же отваливалось, приходилось часами копаться на Stack Overflow в поисках спасительного ответа.
Теперь же погружение в чужой код можно свести к минимуму. Инженер по-прежнему сам выбирает подходящие под задачу модели. Но дальше открывает агента и пишет ему задание, примерно как тимлид расписывает таск для джуна.
В текстовом виде фиксируются все вводные: где и в каком формате лежат данные, какую модель нужно обучить, какие гипотезы проверить, в каких местах поменять архитектуру или гиперпараметры и как настроить аугментацию. Если разбить задачу на достаточно мелкие шаги, агент подготовит эксперимент, внесет изменения в модель, запустит прогоны и проследит, чтобы обучение не упало в процессе. А если при развертывании окружения вылезет конфликт библиотек, чинить его через агента будет гораздо проще и быстрее, чем гуглить ошибки вручную.
Когда обучение заканчивается, агент по запросу собирает сводный отчет с метриками и базовым анализом: какие подходы сработали лучше, какие хуже и на чем стоит остановиться.
Разумеется, речь тут идет именно об ускорении работы, а не о полной автономности. Агент сделает ровно то, что ему описали, и вполне справится даже с большим объемом работы, если поручить ему сразу серию экспериментов. Однако специфики конкретного проекта и нужд бизнеса он не знает, и если предоставить его самому себе, легко свернет не туда. Поэтому проверять выводы из отчета, решать, какие эксперименты запускать дальше, и направлять агента по ходу работы всё равно приходится человеку.
Причем направить его — это не просто написать пару фраз в чат. Постановка задач агенту постепенно становится отдельным навыком. Под него уже складываются свои форматы для улучшения точности. Например, в файлах вроде CLAUDE.md и SKILL.md агенту заранее описывают контекст проекта, правила и порядок действий. Сфера молодая, устоявшихся стандартов пока мало, но разница уже заметна: у того, кто этим навыком владеет, и агент работает лучше.
Сценарий 3. Оптимизация и миграция моделей
Если говорить о том, на каком этапе эффект от агентов ощущается сильнее всего, то это как раз оптимизация.
Причина простая: здесь почти нет неопределенности. Архитектура уже придумана, пайплайн кем-то написан, и остается переписать часть проекта с одной библиотеки на другую, конвертировать веса модели в нужный формат, установить зависимости и проследить, чтобы после переезда всё завелось. Придумывать тут почти нечего, зато аккуратной механической работы много, и с такими задачами агент справляется особенно хорошо.
Схема та же, что и с экспериментами: инженер формально описывает задачу, а агент ее выполняет. В инструкции фиксируется, откуда и куда нужно мигрировать, прописываются версии библиотек, характеристики целевого железа и пара базовых требований к стилю кода. Дальше агент берет рутину по переписыванию модулей на себя.
В одном из проектов требовалось сильно ускорить пайплайн. Для этого нужно было перевести веса нескольких моделей из обычного PyTorch в TensorRT и заодно переписать код под новый бэкенд. С агентом вся работа вместе с тестированием заняла около недели, а без него на такую же задачу спокойно могло уйти три-четыре недели.
Выжимать из кода последние проценты скорости при этом всё еще приходится человеку. Если агент написал рабочий код, но по скорости тот не дотягивает, можно сначала попробовать прогнать его через автоматические инструменты оптимизации. А если и после них результат не устраивает, уже нужно править код самому. Но именно править, а не переписывать с нуля.
Сценарий 4. Одноразовые скрипты и отладка пайплайнов
Помимо крупных этапов вроде обучения или миграции моделей, в работе CV-инженера хватает мелких задач, которые сами по себе несложные, но тем не менее отнимают прилично времени. Перевести данные из одного формата в другой, перекинуть их в нужное место, установить какие-то библиотеки, собрать выборку из датасета — под каждую такую мелочь нужен свой скрипт. Писать его приходилось самому, попутно гугля и сверяясь с документацией.
Сейчас достаточно текстом описать агенту, что нужно сделать с данными. Он сам напишет скрипт, выполнит и удалит его, так что о его существовании даже задумываться не придется. Кто-то идет дальше и собирает с агентами полноценные инструменты, которыми пользуется постоянно, но и для разовых задач такой подход экономит немало времени.
Отладка — задача другого масштаба. Когда в большом пайплайне что-то ломается по неочевидной причине, на поиск источника проблемы вручную легко убить целый день. Приходится залезать внутрь кода, прикручивать текстовое или визуальное логирование и строить кучу графиков и диаграмм, которые потом всё равно пойдут под нож. К вечеру от такой работы уже кипит голова, а где именно сломалось, так и непонятно.
С агентом подход к анализу ошибок меняется. Подготовительную часть можно отдать ему: пройтись по пайплайну, настроить логирование в нужных точках и собрать результаты в понятный отчет. Дальше мы изучаем эти данные, уточняем запрос, отправляем агента на новый круг, и так, пока не доберемся до первопричины. В итоге ты тратишь силы на сам анализ ошибок, а не на подготовку к нему. Поиск и фикс бага при этом занимают минут двадцать вместо целого рабочего дня.
Бывает и так, что агент находит баг почти без подсказок. Скажем, обновили версии библиотек, всё поставилось и запустилось, но метрики почему-то просели. Сам баг в таких случаях обычно несложный, только чтобы понять, в какой библиотеке дело и как это починить, нужно внимательно пройтись по всему пайплайну, а вручную это долго и муторно. Для агента такая кропотливая работа хорошо подходит, и причину он часто находит самостоятельно.
Правда, речь о багах, которые сидят в коде или окружении. С проблемами в самих данных всё сложнее, но об этом чуть ниже.
Сценарий 5. Сборка MVP, интерфейсов и дашбордов
Когда рутину забирает агент, меняется и масштаб задач, которые ставятся в спринте. Еще недавно там отдельным пунктом вполне мог висеть фикс какого-нибудь бага на две строчки кода. Сейчас задача может звучать как «собрать дашборд» или «протестировать изменения», и при планировании ее не нужно дробить на мелкие подзадачи: всё нужное уходит в описание для агента. Безграничными задачи от этого не стали, но заметно расширились, и в целом команда успевает больше.
Раздвинулись и границы того, что CV-инженер может сделать сам. Допустим, модель обучена и неплохо работает, и ее пора показать в деле, а для этого нужен хотя бы простой сервис с интерфейсом. Код модели и бэкенд ML-разработчик, скорее всего, напишет сам, а вот фронтенд с его React и Vue для многих темный лес. На этом месте приходилось останавливаться и просить выделить на проект фронтендера.
Сейчас же базовый интерфейс для MVP или внутренних нужд можно собрать и без него, переложив незнакомую часть на агента. Так у нас было, например, при разработке системы непрерывного дообучения модели. На каждой новой порции данных там пересчитывались метрики, и эту динамику нужно было вывести на экран, чтобы вовремя запускать обновление весов. Разбираться во фронтенде для этого не понадобилось. Мы просто объяснили агенту, какие данные собирать с ручек API, а с интерфейсом он в целом справился сам.
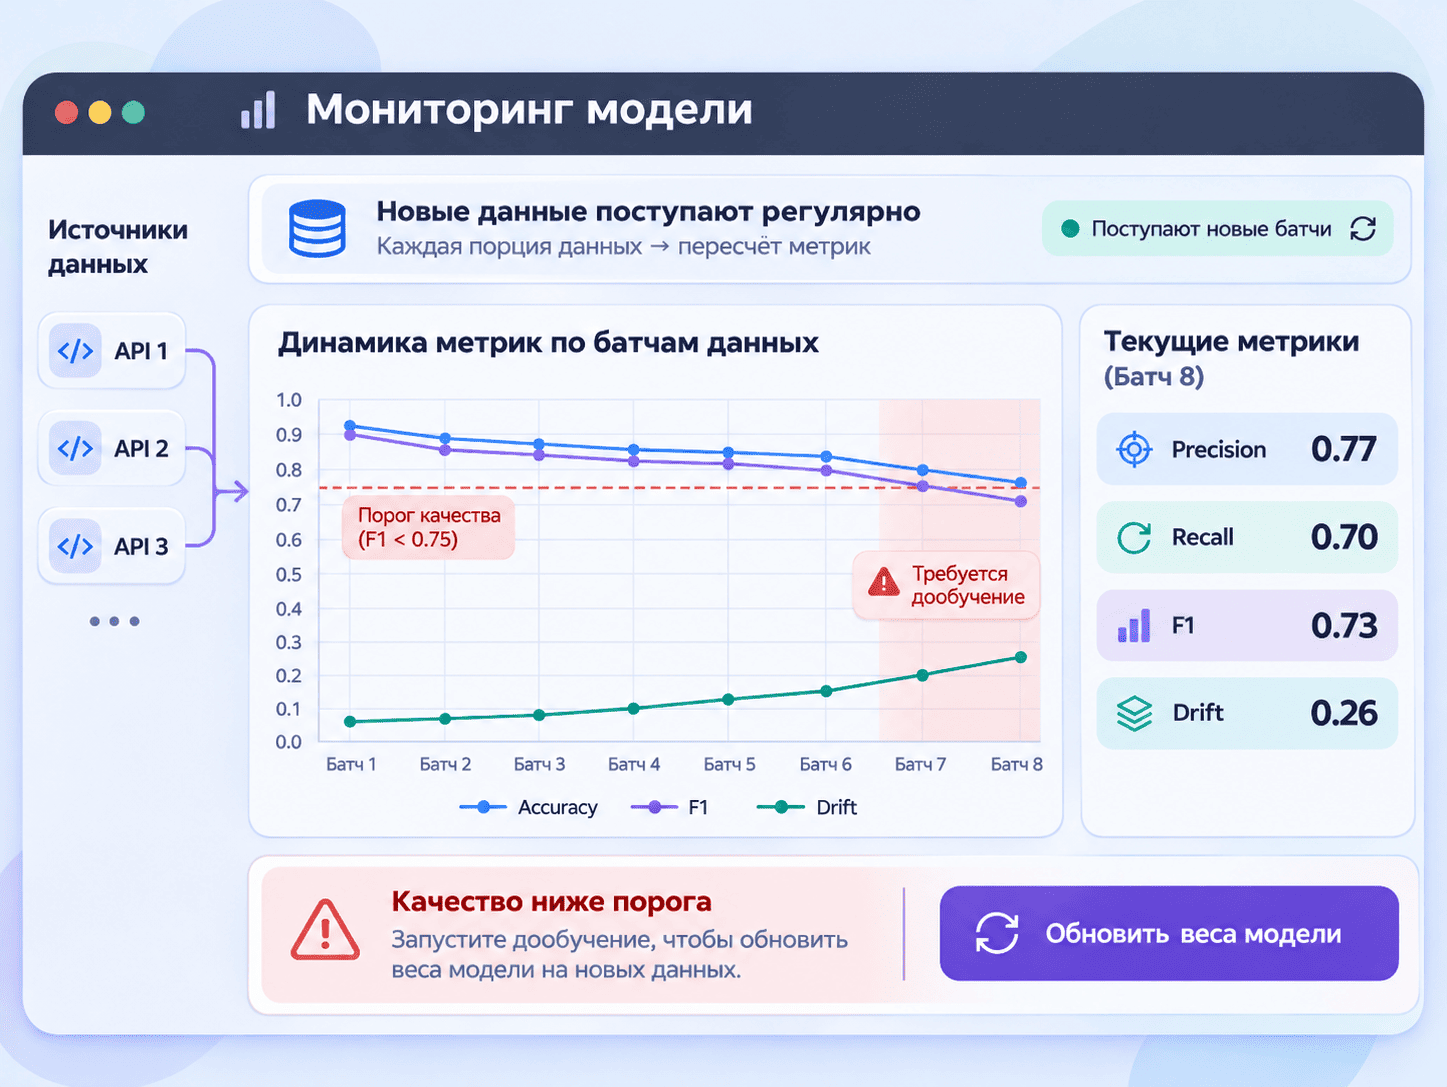
Возможности у такого интерфейса, понятное дело, ограниченные, и до идеала ему далеко. Но он и нужен, чтобы показать, что всё работает, продемонстрировать идею и дать профильному разработчику ориентир, как примерно всё должно выглядеть. Конечный интерфейс, которым заказчик будет пользоваться каждый день, по-прежнему делает фронтендер, и в этом смысле агент его не заменяет.
Где агенту нужен человек
Во всех сценариях выше агент забирал на себя заметную часть работы, но каждый раз с одной и той же оговоркой: его нужно направлять и проверять. У агентов есть «сырой интеллект» и знание теории, но часто не хватает мудрости и насмотренности, которые приходят с опытом разработки. Они не всегда понимают, куда посмотреть в нужный момент, и без направления могут уверенно копать совсем не в ту сторону.
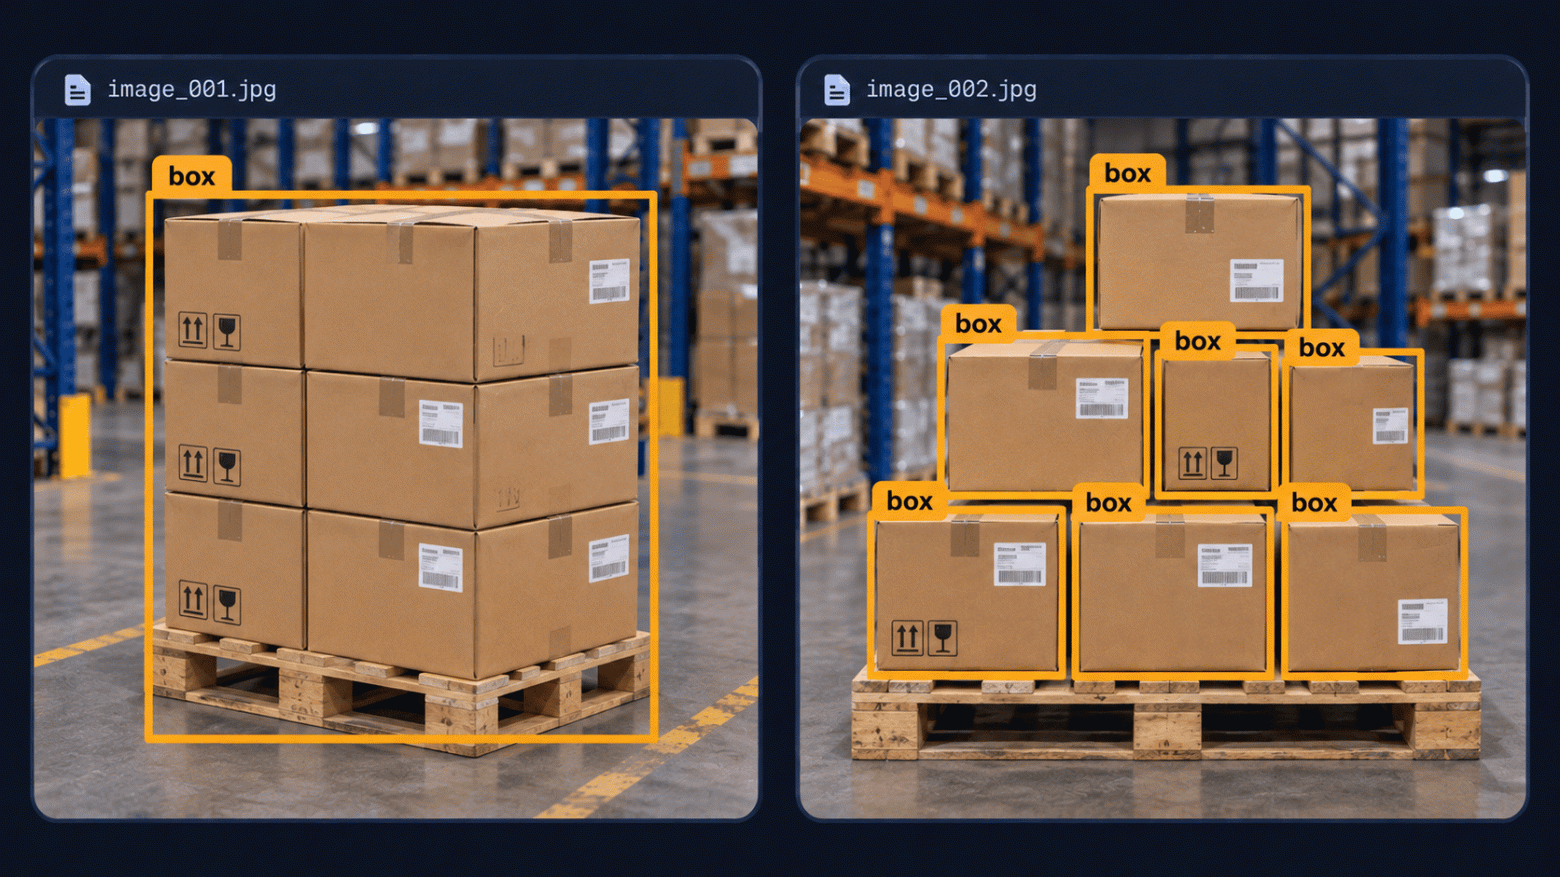
Хорошо это было видно на одном из наших проектов, где требовалось детектировать товары на складских паллетах. С выбором моделей вопросов не возникло, а вот то, как работать с данными и как в итоге должен выглядеть сам пайплайн, было не так очевидно. Начали по обычной схеме: агент собрал данные, помог с аугментациями и поставил эксперимент. Но итоговые метрики вышли посредственными. Когда Влад спросил у нейросети, в чем может быть дело, та начала ходить вокруг да около и выдавать заумные теоретические объяснения, которые не особо соотносились с реальностью.
Причина нашлась, только когда он сам открыл датасет и посмотрел на разметку. Она оказалась нестандартизированной: на одном снимке паллет с товаром был выделен целиком в один бокс, а на другом у похожего паллета разметили каждую отдельную коробку. Метрика сравнивает боксы, которые предсказала модель, с размеченными, и при таком разнобое непонятно, что она вообще считает. Да и сама модель путается на данных, размеченных по двум разным принципам, и начинает ошибаться даже там, где без этого разнобоя справилась бы.
Проверить разметку агент вполне способен, если его об этом попросить. Но сам он вряд ли подумает, что причина может быть в исходных данных и самой постановке задачи. Для него это довольно неочевидная мысль. Зато когда проблема найдена и описана, агент уже может быть полезен и подсказать варианты решения.
Выбирать из этих вариантов, конечно, всё равно предстоит инженеру. Здесь, например, можно было пойти несколькими путями: организовать переразметку с понятной инструкцией, придумать свою метрику, менее чувствительную к такому разбросу, или перестроить обучение так, чтобы функция потерь не штрафовала модель за неопределенность в боксах.
Другое ограничение связано с контекстом. В каждой компании есть свой устоявшийся стек: например, у нас для хранения данных используется ClearML, а для разметки — Label Studio. Разработчик, погруженный в контекст команды, представляет себе весь путь данных от начала до конца и продумывает модули так, чтобы файлы автоматически подгружались в нужное место и не перекидывались по десять раз туда-сюда. Если же отдать организацию такого пайплайна на откуп агенту без четких рамок, он напишет рабочий код, но может выбрать не тот стек или не тот формат, который принят в проекте.
Для одного модуля это поправимо. Но если в большой кодовой базе все начнут бесконтрольно генерировать модули через ИИ, проект постепенно превратится в несвязанную вермишель из разных стилей. Поддерживать ее станет тяжело, и со временем в ней начнет путаться даже сам агент. Он хороший, покладистый исполнитель, готовый писать сколько угодно кода, но системный инженер из него так себе. Сокращать код, находить оптимальные решения и держать архитектуру в порядке у него получается заметно хуже.
Поэтому при работе с агентами важно понимать границы их применимости. По объему знаний и отдельным умениям агент вполне может дать фору даже опытному разработчику. Но если позволить ему вести разработку полностью самостоятельно, продакшн долго не проживет. Да и верить ИИ на слово, что «всё работает, можно коммитить», точно не стоит. Любые его решения нужно как минимум прогонять через тесты.
В конечном счете здесь работает старое правило «фигня на входе — фигня на выходе»: агент делает задачу ровно настолько хорошо, насколько глубоко в ней разбирается человек, который формулирует запрос. До какого-то момента за помощью нейросети можно прятать собственное непонимание, но при первой же нестандартной проблеме всё сломается.
Что в итоге изменилось?
Если посмотреть на то, как поменялся баланс в ежедневной работе, окажется, что сам код никуда не исчез. Да, писать его руками CV-инженеру приходится заметно реже, а вот читать и проверять — по-прежнему много. Бо́льшую часть времени теперь занимают формальные описания задач, проектные документы, чтение диагностических отчетов и правка артефактов, которые приносит агент. Обучать нейросети инженер от этого не разучился. Изменился сам медиум, средство передачи информации от разработчика к системе.
Со стороны может показаться, что такой подход ведет к поверхностному пониманию проекта. Доля правды в этом есть. Особенно когда дело касается одноразовых прототипов, созданных на скорую руку: если агент всё запустил и метрики вышли нормальными, лишний раз копаться в деталях реализации действительно не тянет. Но на длинных проектах, которые живут по полгода-год, расслабиться не выйдет. Ты в любом случае постоянно смотришь на новые модули, вникаешь в код и держишь в голове устройство всего пайплайна.
Скорее, меняется уровень, на котором инженер разбирается в проекте. Влад сравнивает это с работой тимлида:
Есть тимлид, который сам код особо не пишет, но всё организует, и все понимают, что он нужен. В детали кода он погружен меньше, чем мидл, который пишет свой модуль, зато понимает, как работает весь пайплайн. Мне кажется, LLM позволяют каждому, кто дорос хотя бы до мидл+ или сеньора, быть самому себе тимлидом: ты что-то делегировал, смотришь на систему с более высокого уровня и за счет этого лучше ее понимаешь целиком. Какая именно библиотека подвела и что конкретно в ней пофиксили, тебе уже не так интересно — главное один раз посмотреть и убедиться, что агент не сделал какую-то дичь и при запуске на сервере ничего не взорвется.
Как и любому тимлиду, тебе нужно четко ставить задачи агенту, чтобы не вышло как в мультике про двоих из ларца, которые радостно пирожных и конфет понаделали и сами же всё съели.
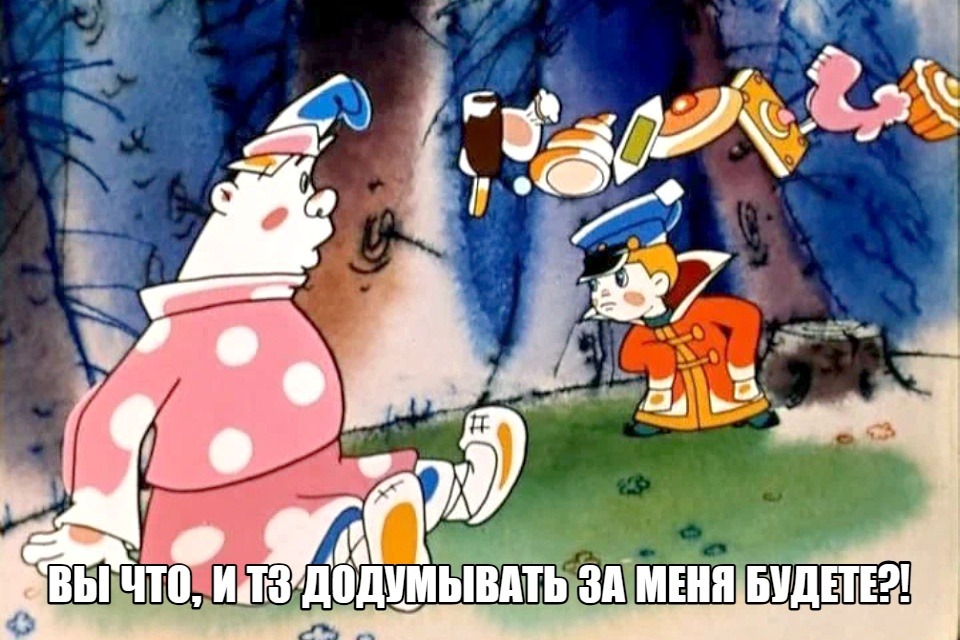
С этим связана и еще одна причина, почему нейросети не могут полностью заменить живых специалистов, на чем уже успели обжечься некоторые крупные компании в США, когда сначала сократили разработчиков в надежде на ИИ, а потом начали нанимать людей обратно. За результат работы ИИ по-прежнему отвечает человек. Каким бы трудолюбивым ни был агент, за ним должен стоять специалист с технической экспертизой, который пойдет разбираться и чинить систему, если что-то сломается.
Правда, вместе с этим появляется новая проблема: как растить тех самых опытных специалистов, если базовые задачи, на которых раньше набивали руку джуны, сегодня за сотню долларов в месяц закрывает агент. Новичкам уже сейчас заметно сложнее найти первую работу, а если со старта привыкнуть делать всё только через промпты, легко остаться с поверхностными знаниями и растеряться там, где твой агент не справился.
По мнению Влада, решать этот вопрос придется самим компаниям, причем осознанно и на перспективу: продолжать нанимать джунов и давать им время побыть неэффективными на проектах, где не горят сроки. Даже с агентом под рукой начинающий разработчик после пары недель бодрой работы неизбежно упрется в затык, который ИИ не возьмет. Ему точно так же придется несколько дней посидеть над неработающим кодом с кипящей головой, попытаться раскопать причину самому, подтянуть знание языка, а потом прийти на ревью к старшему коллеге и разобрать ошибки. По-другому та самая насмотренность, которая отличает инженера от ИИ, всё равно не вырабатывается. И чем больше рутины в будущем будут забирать на себя агенты, тем выше будет цена именно этого человеческого опыта — умения увидеть проблему там, где для нейросети всё выглядит нормально.
На этом у нас всё! А как агенты поменяли вашу работу? Будем рады обсудить в комментариях.


Комментарии 0