Говорят, идут тёмные времена, железячное изобилие подходит к концу, производители процессоров и видеокарт переходят на производство серверного железа, забыв про обычных пользователей. А большие разработчики и поставщики ИИ-мощностей не умеют дебет с кредитом сводить… И всякие интернет-пророки говорят: «Готовьтесь, идёт закат АйТи времён...». Вот как при таких делах оставаться в рассудительном и спокойном состоянии? Никак :) По этой причине я задумался над созданием домашнего ковчега нейро-вычислителя.
Заметка предназначена для тех, кто ещё не погружался в этот удивительный мир домашних нейронок, а посему делюсь с ними набитыми шишками.
Моё железо на тот момент: Xeon E5-2698 v4 на двадцать ядер, 64 гигабайта DDR4 ECC и материнка JGINYUE X99 Titanium D4 (типичная китайская X99-плата на остатках серверных платформ). Дёшево и сердито.
С чего всё началось
Однажды вечером, начитавшись умных (апокалиптических) статей и наслушавшись коллег с сотоварищами, я подумал: а не построить ли мне домашний ИИ-сервер? Ну конечно построить — это же самое актуальное, что может быть на данный момент, особенно во времена обрушения рынков и прочей турбулентности.
Недолго думая, я пришёл к выводу, что мне срочно нужно обновить видеокарту. И обязательно чтобы на ней красовалась гордая надпись — Tesla! Все ведь только о них и пишут. Эти ускорители впервые появились в продаже ещё в 2007 году, поэтому выбор на вторичном рынке огромен. Каждое поколение имеет буквенно-числовое обозначение. На Авито можно встретить: Nvidia Tesla M40 12GB, Nvidia Tesla V100 32GB PCI, Tesla K80 24GB, Tesla M60 16GB, Nvidia Tesla V100 SXM2, Tesla P100 16GB PCI-e...
Много памяти — не значит хорошая память
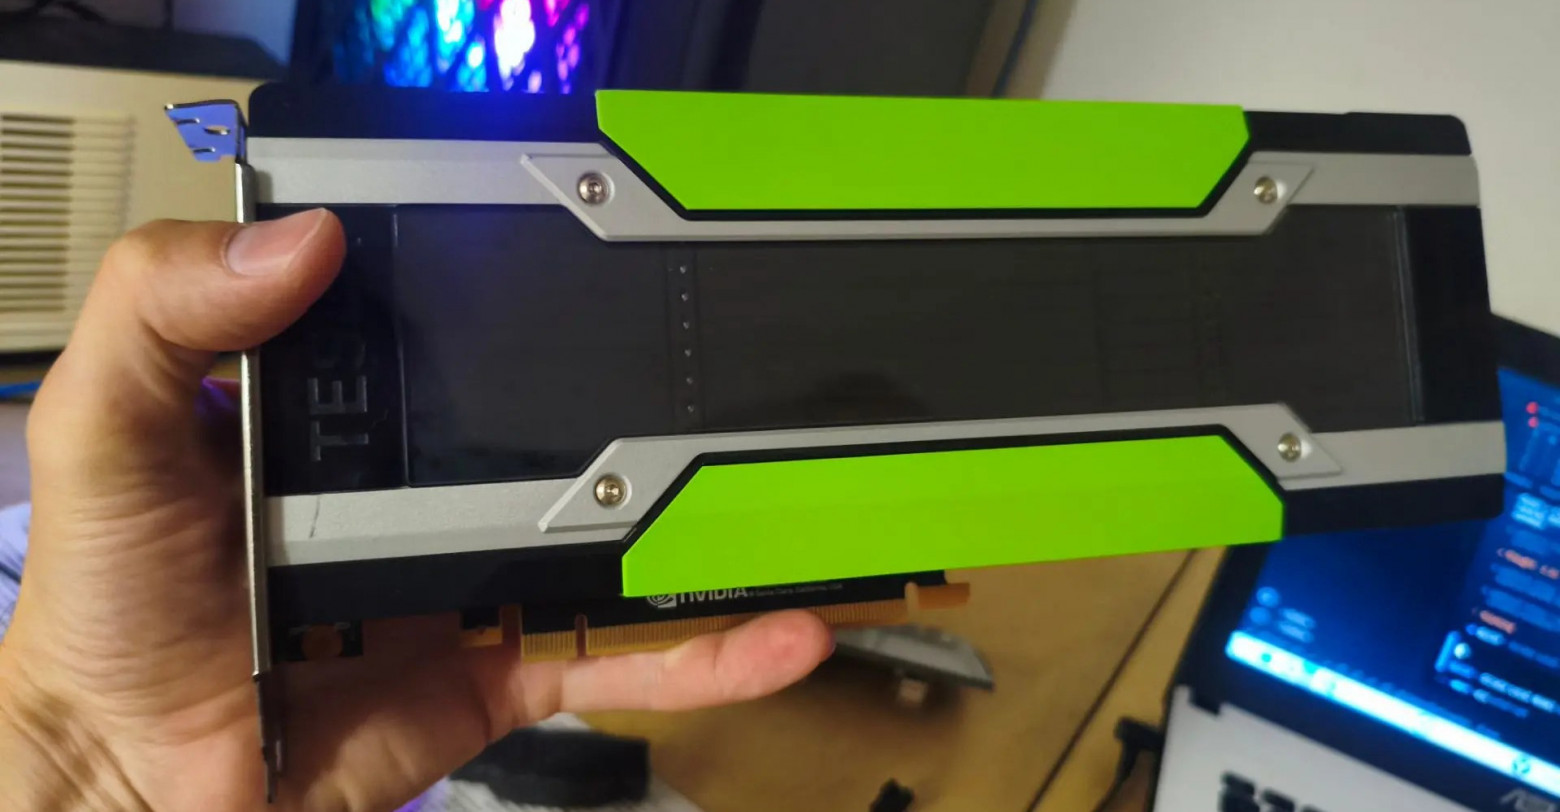
На этом этапе очень просто ошибиться новичку, особенно если денег мало, а амбиций хоть отбавляй. Любая, современная и не очень, рекламная брошюра кричит, что чем больше памяти, тем лучше. Но не всё так просто: память бывает разная. Поэтому условно разделим все ускорители Tesla на две группы — с GDDR и с HBM2/3. Изначально все модели компоновались памятью стандарта GDDR (сначала версии 3, а потом дошли даже до 6-й). В какой-то момент появилась память нового стандарта HBM2, которая показывала на порядок большую пропускную способность (при более низких частотах работы).
Например, если сравнить Nvidia Quadro GP100 16 ГБ HBM2 и Nvidia Quadro P6000 GDDR5X 24 ГБ, то пропускная способность будет 717 ГБ/с против 384 ГБ/с — в пользу HBM2. В нейросетях пропускная способность играет огромную роль.
В идеале домашний ИИ-сервер надо строить на карточках не ниже уровня Tesla V100, а это в наше время штука не копеечная. Карта на 16 гигабайт стоит от 25 т.р.(и цена на них растёт каждый день, буквально). Для современных нейросетей рекомендуют минимум 32 гигабайта, поэтому если брать V100, то две. Есть вариант Tesla V100 и на 32 гигабайта, но это сразу от 65 т.р. Суммы не космические, но мне же только для домашнего использования.
Почитав умные статьи, я решил, что P100 тоже сгодится. На вторичном рынке Tesla P100 16GB можно взять от 10 т.р., а за две отдать всего 20 т.р. Не теряя времени, заказал две в Китае и стал ждать посылку. Также пришлось взять новый блок питания на 1200 ватт — из-за прожорливости карточек: одна карта в максимальном режиме потребляет 250 ватт.
Две P100, или День провала
Через месяц ожиданий я получил заветные карты и сразу вставил их в свой системник. Получилось очень красиво, с общим кожухом обдува. И… ничего не заработало.
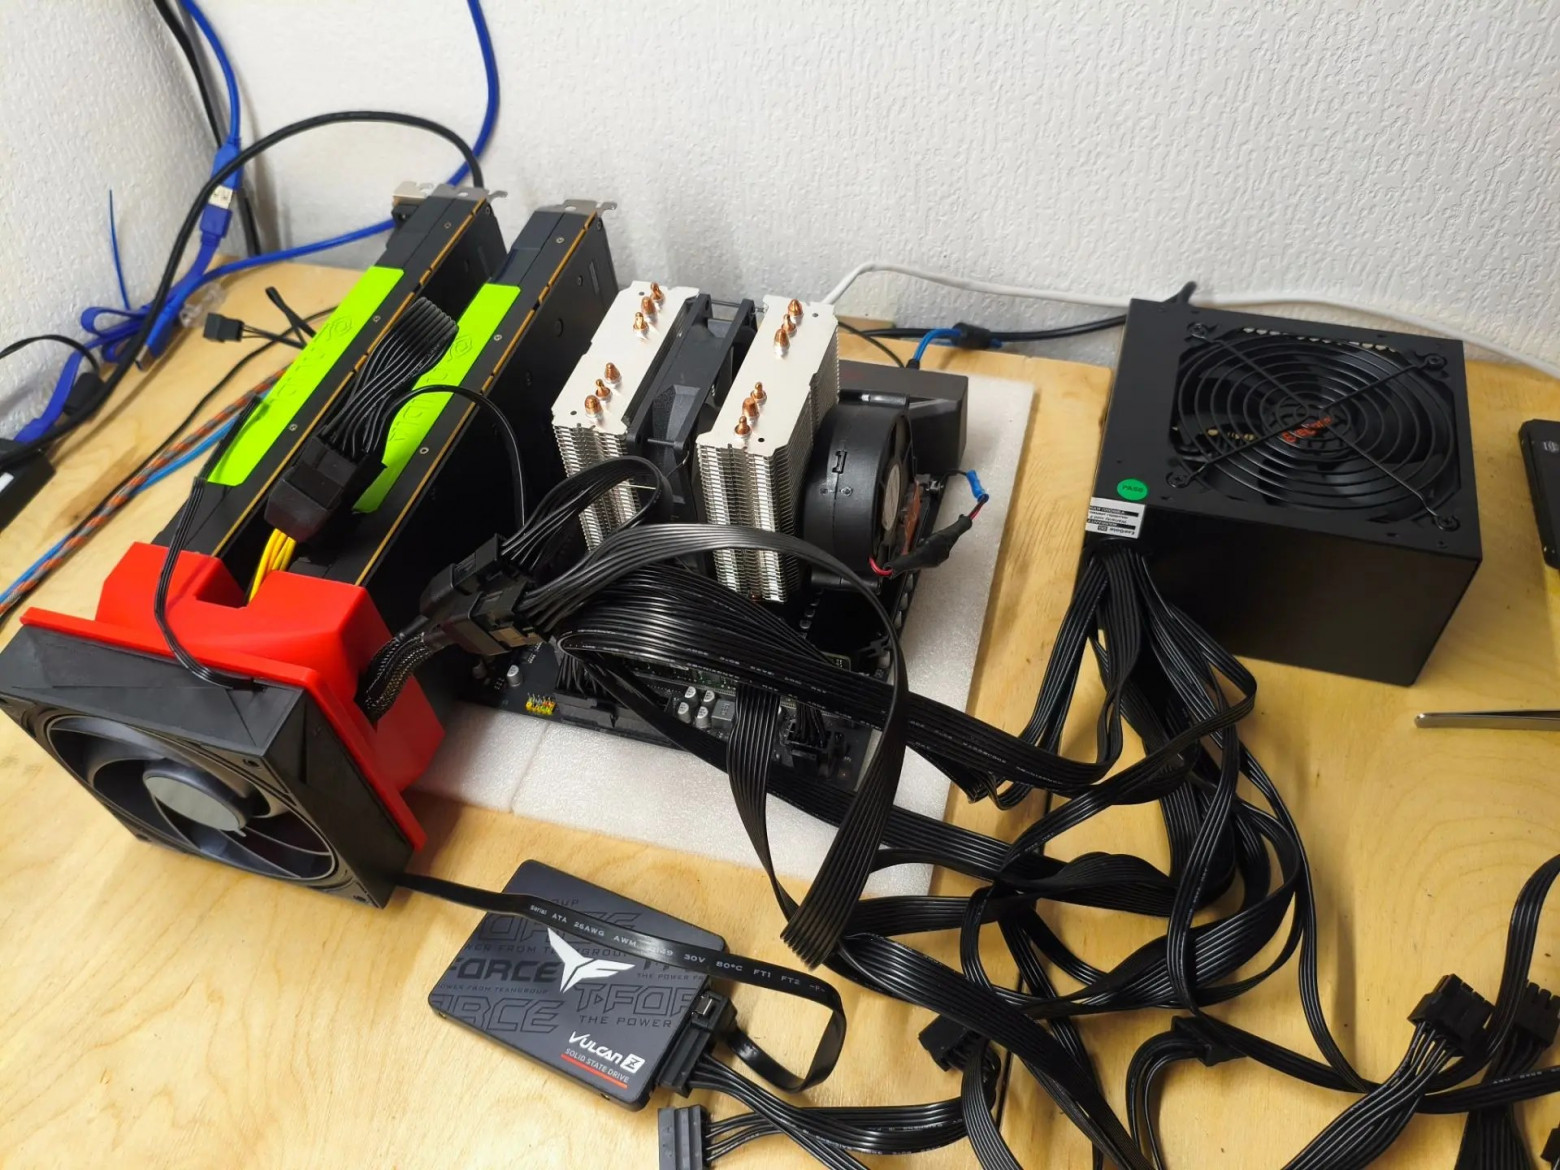
Это был провал. Перестановка карт в слотах PCI ничего не дала. Поставил две Tesla P100 и GT210 — не помогло. Поставил две Tesla P100 без GT210 — тот же результат. Поставил две Tesla P100 и GTX3060 12GB — опять ноль. Переставление карточек показало следующее: одна P100 прекрасно работала в паре с GT210 или GTX3060, две P100 не хотели работать совсем.
Питания хватало, охлаждение было более чем. DeepSeek подсказал, что всё дело в BIOS, который не поддерживает одновременную работу с несколькими картами. Уже потом я не раз натыкался на совет для подобных случаев: для работы нескольких современных карт в BIOS включают опции Above 4G Decoding и Resizable BAR. Но возиться с аскетичным BIOS китайской X99-платы мне не хотелось. Ну, не повезло, так не повезло — оставил одну Tesla P100 16GB в паре с GTX3060 12GB. Также был вариант приобретения новой материнки со списанного сервера, но опять ждать не хотелось, да и места слишком много занимает подобный текстолит.
Первые запуски: llama.cpp, MiniMax, Qwen
Ну хорошо, попробую работать на одной карте — уже можно поставить llama.cpp и запустить какую-нибудь раскрученную модель. Поставил MiniMax и приуныл. Моделька оказалась очень тупой и периодически уходила в цикл. Ради этого не стоило даже браться за создание домашней фермы…
Но потом мне на глаза попалась статья про новый стильный и хороший Qwen3.8 Flash Next. Недолго думая, начал его устанавливать и пробовать. Вот ради этого стоило заниматься созданием домашней нейронки.
Благодаря тому, что у меня 64 гигабайта оперативной памяти, получилось запустить Qwen3.8 Flash Next в кванте IQ3_S (рекомендован как раз для компьютеров с 64 гигами оперативки). Нейронка работает на движке Strata: он автоматически размещает экспертные слои не полностью в видеопамяти, а распределяет их между оперативной и видеопамятью. Такая архитектура позволила получить 30–60 токенов в секунду на моём железе. Это очень достойно для домашних экспериментов.
Запустив модель в OpenCode, я смог по-настоящему разрабатывать код у себя дома, на локальной системе.
Как оказалось, Strata не умеет работать одновременно с картами разных поколений (Tesla P100 — это поколение Pascal, 2016 год; GTX3060 — Ampere, 2021 год). Поэтому использовать суммарные 28 гигабайт видеопамяти не удалось.
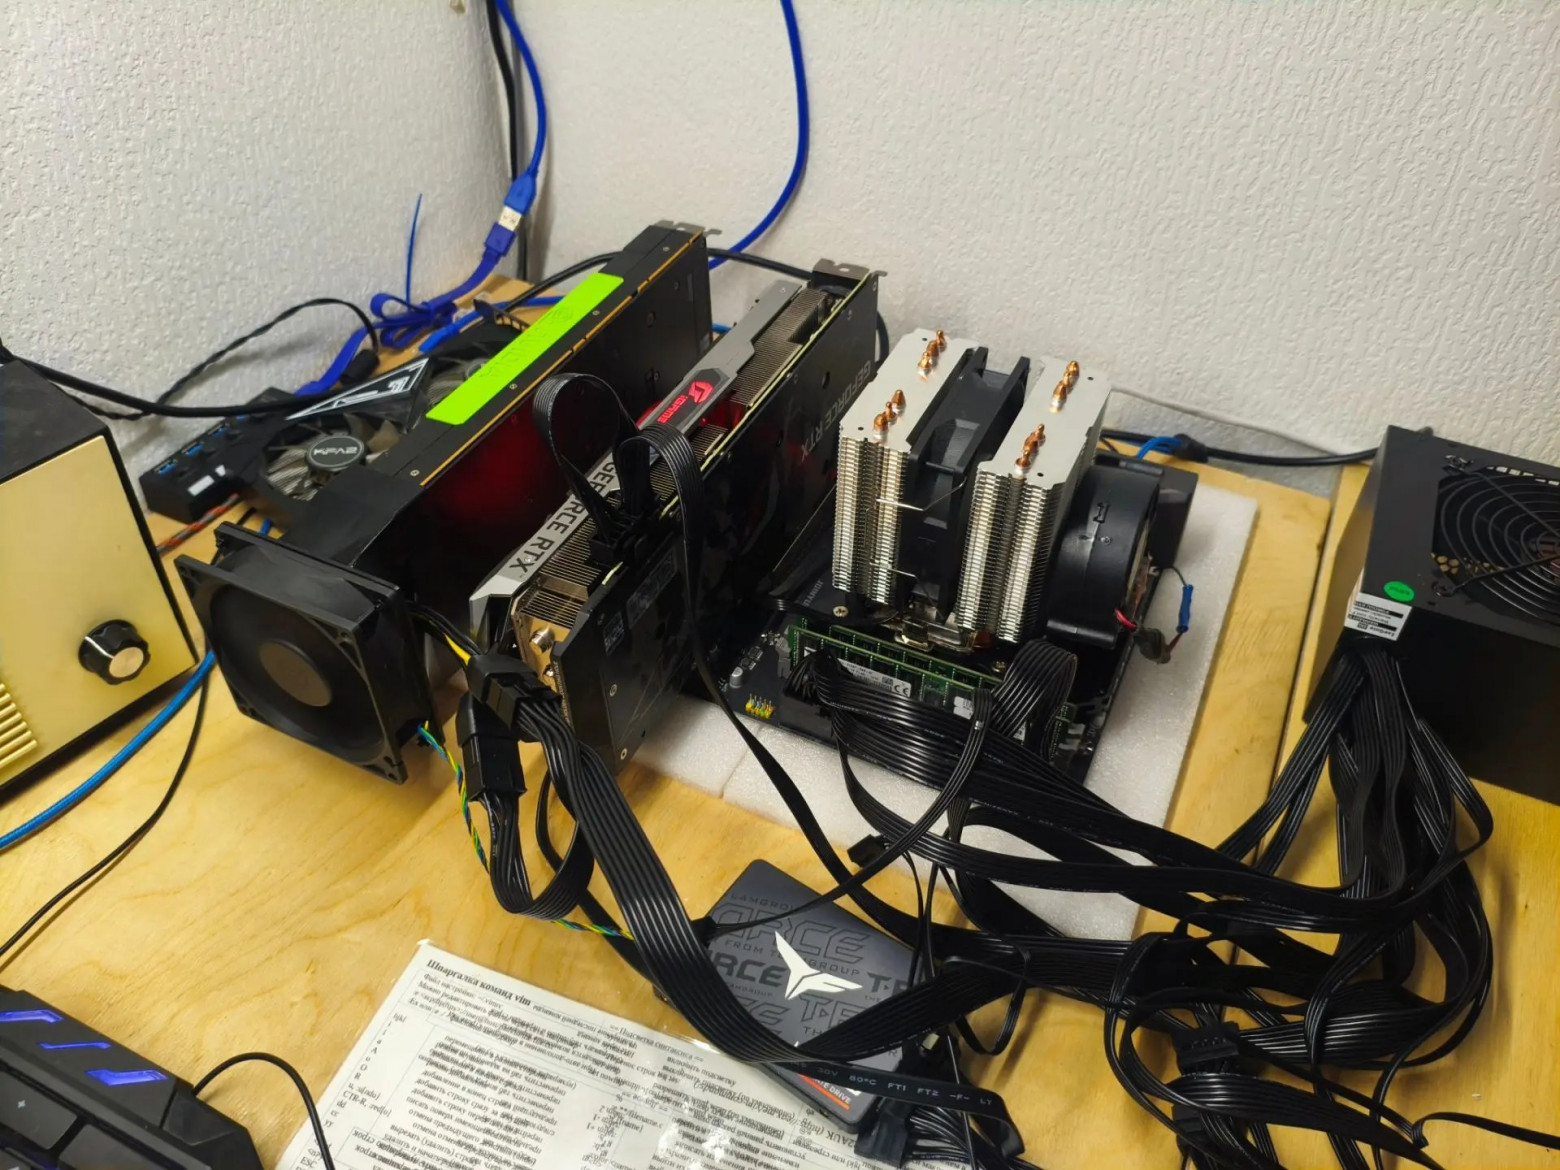
Tesla vs GeForce: сравнение, которого я не ожидал
Далее, ради эксперимента, я решил замерить производительность Strata на GTX3060 12GB. Моему удивлению не было предела: система выдавала 40–60 токенов в секунду! То есть специализированное серверное решение оказалось хуже потребительского. Объясняется это особенностями современных драйверов и отсутствием тензорных ядер у Tesla P100.
Итог: мини-сервер и доступ из любой точки
На следующий день я продал обе Tesla P100 (покупатели нашлись моментально) и приступил к настройке мини-сервера для удалённого доступа. Чтобы максимально упростить себе жизнь, настроил SSH-сервер с авторизацией по ключу. Теперь на всех своих остальных компьютерах я прокидываю SSH-туннель для дальнейшей работы OpenCode.
В итоге мне удалось достичь поставленной задачи: дома крутится ИИ-сервер, который можно использовать для удалённой работы где угодно, не думая о количестве потраченных токенов и о возможности отключения в результате обвалов западных рынков.
Выводы и советы новичкам
Набив шишки, хочу поделиться с вами своим выводами, на что обращать внимание при постройке первого домашнего ИИ сервера:
Сначала — плата и BIOS, потом — карты. Мои Tesla «не смогли» не из-за питания или охлаждения, а BIOS-а, который не осилил несколько-GPU. На дешёвых X99-платах опции вроде Above 4G Decoding и Resizable BAR — лотерея. Иногда разумнее доплатить за нормальную материнку.
Серверная карта — не всегда лучший выбор. Гордая надпись Tesla не гарантирует скорость: GTX 3060 оказалась быстрее Tesla P100. Виноваты отсутствие тензорных ядер у Pascal и особенности современных драйверов. До покупки проверяйте, как ваша будущая связка GPU ведёт себя в нужном движке — особенно если поколения разные: многие движки такое не переваривают.
Пропускная способность важнее объёма. 16 ГБ HBM2 (717 ГБ/с) в нейросетях живее, чем 24 ГБ GDDR5X (384 ГБ/с). Гонка за гигабайтами — типичная ошибка новичка: скорость ответа определяется шириной «конвейера» памяти, а не её объём про запас.
Оперативная память — тоже ресурс, и он дешевле видеопамяти. 64 ГБ DDR4 ECC для Xeon — стандарт для китайских X99-сборок, и именно это спасло всю затею: движок Strata распределяет экспертные слои MoE-моделей между ОЗУ и видеопамятью, поэтому крупные модели становится реальностью, когда не хватает быстрой видеопамяти. Мой вам совет, для начала, увеличьте оперативку, это дешевле.
Начинайте с бесплатного. llama.cpp, открытые модели, кванты — всё это можно установить и настроить за вечер. Пока не поймёте, зачем вам вообще домашняя нейронка, деньги лучше не тратить.
Удалённый доступ — с первого вечера. SSH с авторизацией по ключу, туннель на все рабочие машины — и простой домашний сервер в углу комнаты, становится вычислителем для любого удалённого компьютера, в любой точке мира.
Вот и вся история. Не бойтесь: локальная нейронка дома — уже не магия и не бюджеты дата-центров. Нужны лишь прямые руки и готовность набить пару шишек. Свои-то набиты и разложены по полочкам — берите, пользуйтесь :)


Комментарии 0