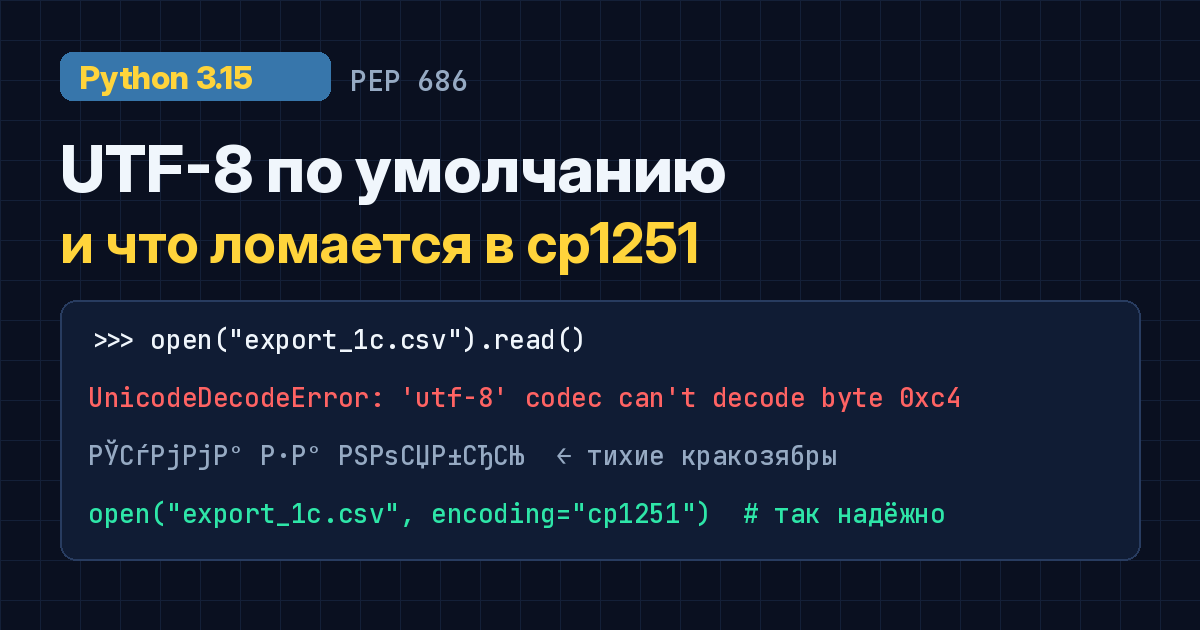
9 октября вышел Python 3.15, 25 октября подтянулся патч 3.15.2, а 1 октября закончилась поддержка 3.10. Самое время обновлять серверы и CI. В списке изменений 3.15 есть пункт, который легко пролистать: PEP 686, UTF-8 теперь кодировка по умолчанию. Это значит, что open("file.txt") без аргумента encoding читает и пишет UTF-8, какая бы локаль ни стояла в системе.
Звучит как чистое улучшение, и в целом так и есть. Но если ваш код работает с файлами в cp1251 (выгрузки из 1С, банковские выписки, CSV для Excel, старые утилиты) и где-то забыто encoding=, после обновления он либо упадёт, либо, что хуже, начнёт тихо писать файлы, которые соседняя система прочитает кракозябрами.
Ниже разбор по схеме «проблема → воспроизведение → исправление → проверка». Все команды и выводы взяты из реального прогона на Python 3.13.5, 3.14.10 и 3.15.2.
Кого это касается
На Linux с UTF-8-локалью (а это почти любой современный сервер и любой официальный Docker-образ Python) ничего не меняется: там кодировка по умолчанию и так была UTF-8. Под локалью C/POSIX Python ещё с 3.7 сам включал UTF-8-режим.
Меняется поведение там, где локаль не UTF-8:
русская Windows, где кодировка ANSI равна cp1251. Это машины бухгалтерии, терминальные серверы, планировщик задач с «маленьким скриптом на Python»;
старые Linux-серверы, у которых исторически стоит
ru_RU.CP1251илиru_RU.KOI8-R, потому что «так было надо для 1С/Samba/чего-то ещё».
Сами файлы на диске при обновлении не меняются. Меняется то, как Python их читает и пишет, если вы не сказали ему явно.
Воспроизведение
Windows у меня под рукой нет, поэтому воспроизводил на Linux с локалью ru_RU.CP1251. Для open(), subprocess и стандартных потоков механизм тот же: Python берёт кодировку из локали, если не включён UTF-8-режим. Локаль собрал в отдельный каталог через localedef и подключил переменной LOCPATH, чтобы не трогать систему.
Сначала проверим, что думает каждая версия:
export LOCPATH=$PWD/locales LC_ALL=ru_RU.CP1251
for v in 3.13 3.14 3.15; do
  uv run --no-project -p $v python -c \
    'import sys,locale; print(sys.version.split()[0], sys.flags.utf8_mode, locale.getpreferredencoding(False))'
done
3.13.5 0 CP1251
3.14.10 0 CP1251
3.15.2 1 utf-8
Вот и всё изменение: sys.flags.utf8_mode стал 1, и locale.getpreferredencoding(False), на который опирается open(), теперь возвращает utf-8.
Сценарий 1. Падение на чтении выгрузки
Выгрузка «из 1С» в cp1251, как её обычно и отдают:
# make_export.py
rows = [
    "Дата;Контрагент;Сумма;Назначение",
    "01.11.2026;ООО «Ромашка»;15000,00;Оплата по счёту №17",
    "05.11.2026;ИП Петров;2300,50;Возврат аванса",
]
with open("export_1c.csv", "w", encoding="cp1251", newline="") as f:
    f.write("\r\n".join(rows) + "\r\n")
И типичный скрипт, который годами работал:
# report.py
import csv

total = 0.0
with open("export_1c.csv", newline="") as f:          # кодировка не указана
    for row in csv.DictReader(f, delimiter=";"):
        total += float(row["Сумма"].replace(",", "."))

with open("report.txt", "w") as out:                  # и здесь тоже
    out.write(f"Итого за ноябрь: {total:.2f} руб.\n")
print("ok", total)
На 3.14 он печатает ok 17300.5. На 3.15.2:
Traceback (most recent call last):
  File "report.py", line 5, in <module>
    for row in csv.DictReader(f, delimiter=";"):
               ~~~~~~~~~~~~~~^^^^^^^^^^^^^^^^^^
  File ".../lib/python3.15/csv.py", line 174, in __next__
    self.fieldnames
  File ".../lib/python3.15/csv.py", line 161, in fieldnames
    self._fieldnames = next(self.reader)
                       ~~~~^^^^^^^^^^^^^
  File "<frozen codecs>", line 325, in decode
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc4 in position 0: invalid continuation byte
0xc4 здесь буква «Д» из слова «Дата» в cp1251. Этот случай ещё хороший: падение заметно сразу.
Сценарий 2. Тихие кракозябры на записи
Хуже, когда скрипт на 3.15 пишет файл, а читает его кто-то, кто по-прежнему ждёт cp1251: другой скрипт на 3.14, загрузка в учётную систему, макрос в Excel.
# writer.py — запускаем на 3.15
with open("report.txt", "w") as out:
    out.write("Сумма за ноябрь: 17300.50 руб.\n")
# reader.py — запускаем на 3.14, как и раньше
print(ascii(open("report.txt").read()))
Ошибки нет ни там, ни там. Но если вывести прочитанное на экран, получится знакомое:
РЎСѓРјРјР° Р·Р° РЅРѕСЏР±СЂСЊ: 17300.50 СЂСѓР±.
Исключений нет, логи чистые, отчёт ушёл. Узнаете вы об этом от бухгалтера.
Есть нюанс: в cp1251 нет символа с кодом 0x98, а это второй байт буквы «И» в UTF-8. Поэтому на части текстов старый читатель всё-таки упадёт, а на части молча покажет мусор. Как повезёт с буквами.
Сценарий 3. Вывод внешней утилиты
subprocess.run(..., text=True) декодирует вывод той же кодировкой по умолчанию. Имитируем старую утилиту, которая печатает в cp1251:
#!/bin/sh
# legacy_tool.sh
printf 'Статус: готово\n' | iconv -f UTF-8 -t CP1251
# call_tool.py
import subprocess, sys
r = subprocess.run(["./legacy_tool.sh"], capture_output=True, text=True)
print(sys.version.split()[0], repr(r.stdout))
На 3.14 получаем 'Статус: готово\n', на 3.15:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd1 in position 0: invalid continuation byte
Сценарий 4. Ваш скрипт как «старая утилита»
Обратная сторона того же: если ваш Python-скрипт кто-то вызывает и читает его stdout через пайп, на 3.15 под cp1251-локалью sys.stdout.encoding стал utf-8 вместо cp1251. Вызывающая сторона, которая ждала cp1251, получит те же кракозябры, что и в сценарии 2.
Как найти все такие места
Есть два инструмента, и они дополняют друг друга.
1. EncodingWarning (PEP 597, есть с Python 3.10). Флаг -X warn_default_encoding заставляет интерпретатор предупреждать о каждом открытии текстового потока без encoding:
$ python3.14 -X warn_default_encoding report.py
report.py:4: EncodingWarning: 'encoding' argument not specified
report.py:8: EncodingWarning: 'encoding' argument not specified
Предупреждение срабатывает и на subprocess.run(..., text=True):
call_tool.py:2: EncodingWarning: 'encoding' argument not specified.
В тестах удобно превратить его в ошибку, тогда CI не пропустит новые такие места:
python -X warn_default_encoding -W error::EncodingWarning -m pytest
Ограничение: ловится только тот код, который реально выполнился. Ветка, которая срабатывает раз в месяц при закрытии периода, может проскочить.
2. Статический анализ. В ruff есть правило PLW1514 (unspecified-encoding). В ruff 0.17.4 оно пока в preview, без флага --preview ruff пишет, что выбор правила ни на что не влияет:
ruff check --preview --select PLW1514 .
На моих файлах оно нашло все четыре open() без кодировки, а вот вызов subprocess.run(text=True) не отметило. Поэтому одного линтера мало, флаг -X warn_default_encoding в тестах всё равно нужен.
Отдельно полезно найти сами данные, которые не являются UTF-8. Самый простой способ: прогнать файл через iconv из UTF-8 в UTF-8. На невалидной последовательности он вернёт ненулевой код:
#!/bin/sh
# find_non_utf8.sh
find "${1:-.}" -type f \( -name '*.csv' -o -name '*.txt' -o -name '*.xml' -o -name '*.ini' \) |
while read -r f; do
  iconv -f UTF-8 -t UTF-8 "$f" >/dev/null 2>&1 || echo "не UTF-8: $f"
done
$ ./find_non_utf8.sh .
не UTF-8: ./export_1c.csv
Исправление
Правило простое: кодировку всегда указывать явно, и выбирать её по тому, откуда данные.
Чужой файл, кодировку которого вы знаете (выгрузка 1С, выписка банка):
encoding="cp1251".Свои файлы, которые вы и пишете, и читаете:
encoding="utf-8"с обеих сторон.Действительно нужна кодировка текущей системы (редко, но бывает):
encoding="locale". Такой вариант есть с Python 3.10 и в 3.15 продолжает возвращать кодировку локали.Вывод внешних программ:
encoding=вsubprocess.run.
# report_fixed.py
import csv
import subprocess

# 1. Чужой файл: кодировку знаем, пишем её явно
total = 0.0
with open("export_1c.csv", encoding="cp1251", newline="") as f:
    for row in csv.DictReader(f, delimiter=";"):
        total += float(row["Сумма"].replace(",", "."))

# 2. Свой файл: фиксируем UTF-8 и на запись, и на чтение
with open("report.txt", "w", encoding="utf-8") as out:
    out.write(f"Сумма за ноябрь: {total:.2f} руб.\n")

# 3. Вывод внешней утилиты: тоже явно
r = subprocess.run(["./legacy_tool.sh"], capture_output=True,
                   text=True, encoding="cp1251")

print(ascii(r.stdout), total)
Если ваш скрипт сам отдаёт текст в пайп, а вызывающая сторона ждёт cp1251, задайте кодировку потока явно через PYTHONIOENCODING=cp1251 в окружении вызова или через sys.stdout.reconfigure(encoding="cp1251") в начале скрипта.
Временный откат
Если обновиться нужно сегодня, а исправить всё сразу нельзя, старое поведение возвращается так:
PYTHONUTF8=0 python report.py
# или
python -X utf8=0 report.py
Проверил: с любым из этих вариантов report.py на 3.15.2 снова отрабатывает и печатает ok 17300.5. Но это костыль, а не решение. Переменную легко потерять при переезде в другой сервис, юнит systemd или задачу планировщика.
Проверка
Прогоняем исправленный скрипт на трёх версиях, превращая любое неявное открытие в ошибку, и сравниваем результат побайтно:
for v in 3.13 3.14 3.15; do
  rm -f report.txt
  uv run --no-project -p $v python -X warn_default_encoding -W error::EncodingWarning report_fixed.py
  sha256sum report.txt
done
'\u0421\u0442\u0430\u0442\u0443\u0441: \u0433\u043e\u0442\u043e\u0432\u043e\n' 17300.5
205bf6ce64db8806e62948be08e34718f7dee508b070a3f095d531d43f4869d5  report.txt
'\u0421\u0442\u0430\u0442\u0443\u0441: \u0433\u043e\u0442\u043e\u0432\u043e\n' 17300.5
205bf6ce64db8806e62948be08e34718f7dee508b070a3f095d531d43f4869d5  report.txt
'\u0421\u0442\u0430\u0442\u0443\u0441: \u0433\u043e\u0442\u043e\u0432\u043e\n' 17300.5
205bf6ce64db8806e62948be08e34718f7dee508b070a3f095d531d43f4869d5  report.txt
Ни одного EncodingWarning, сумма одна и та же, вывод утилиты читается, а report.txt побайтно совпадает на 3.13, 3.14 и 3.15. Линтер тоже молчит:
$ ruff check --preview --select PLW1514 report_fixed.py
All checks passed!
Короткий чек-лист перед переходом на 3.15
Прогнать тесты с
-X warn_default_encoding -W error::EncodingWarning.Включить в ruff
PLW1514(пока через--preview).Найти во входных данных файлы не в UTF-8 и прописать их кодировку явно.
Договориться с соседними системами, в какой кодировке вы отдаёте файлы и stdout, и зафиксировать это в коде, а не в локали сервера.
PYTHONUTF8=0использовать только как временную меру и с задачей в трекере на его удаление.
А у вас что-нибудь сломалось после перехода на 3.15? Или вы давно пишете encoding= везде и для вас это изменение прошло незаметно? Особенно интересно, сколько cp1251 ещё живёт в ваших интеграциях с 1С и банками.

Комментарии 0