Почему это важно именно сейчас
Atlassian закрыл новые регистрации в Opsgenie в первом квартале 2026 года и назначил 5 апреля 2027 года датой окончания поддержки. Функции дежурств переезжают в Jira Service Management, а для многих команд в России переезд туда закрыт. PagerDuty, incident.io и Rootly либо недоступны, либо заточены под Slack, которым у нас почти никто не пользуется.
Что остаётся? Обычно одно из трёх: бот Zabbix, который шлёт всё подряд в общий чат; Karma поверх Alertmanager, на которую кто-то должен смотреть; или договорённость «если ночью упало — звоните Васе». Все три варианта показывают алерт, но ни один не отвечает на главный вопрос: кто сейчас отвечает за инцидент и что будет, если он не проснулся.
Я сделал «Дежурку» — небольшой сервис, который встаёт поверх уже имеющегося мониторинга и закрывает именно эту дыру. В статье расскажу, как он устроен, какие решения пришлось принять и как его попробовать.
Что должна уметь система дежурств
Прежде чем писать код, я сформулировал требования, исходя из того, что у типичной команды уже стоит Prometheus с Alertmanager или Zabbix, а общаются все в Telegram.
Не заменять мониторинг, а встать после него. Алерты уже есть, их не надо собирать заново — нужно решить, кого будить.
Знать график. Ротация на неделю или на сутки, разные часовые пояса, подмены «Петя заболел, сегодня дежурит Маша» без правки конфигов.
Эскалировать. Если дежурный не отреагировал за 5 минут — звать следующего, потом тимлида, и так по кругу.
Фиксировать ответственного. Кнопка «Беру» в Telegram: нажал — эскалация остановилась, а все видят, кто разбирается.
Не спамить. Один и тот же алерт, пришедший 20 раз, — это один инцидент, а не 20 сообщений.
Ставиться в закрытый контур. Без публичного HTTPS, без внешних SaaS, данные остаются у компании.
Конфиг как код. Люди, графики и политики — в YAML рядом с остальной инфраструктурой.
Как устроена «Дежурка»
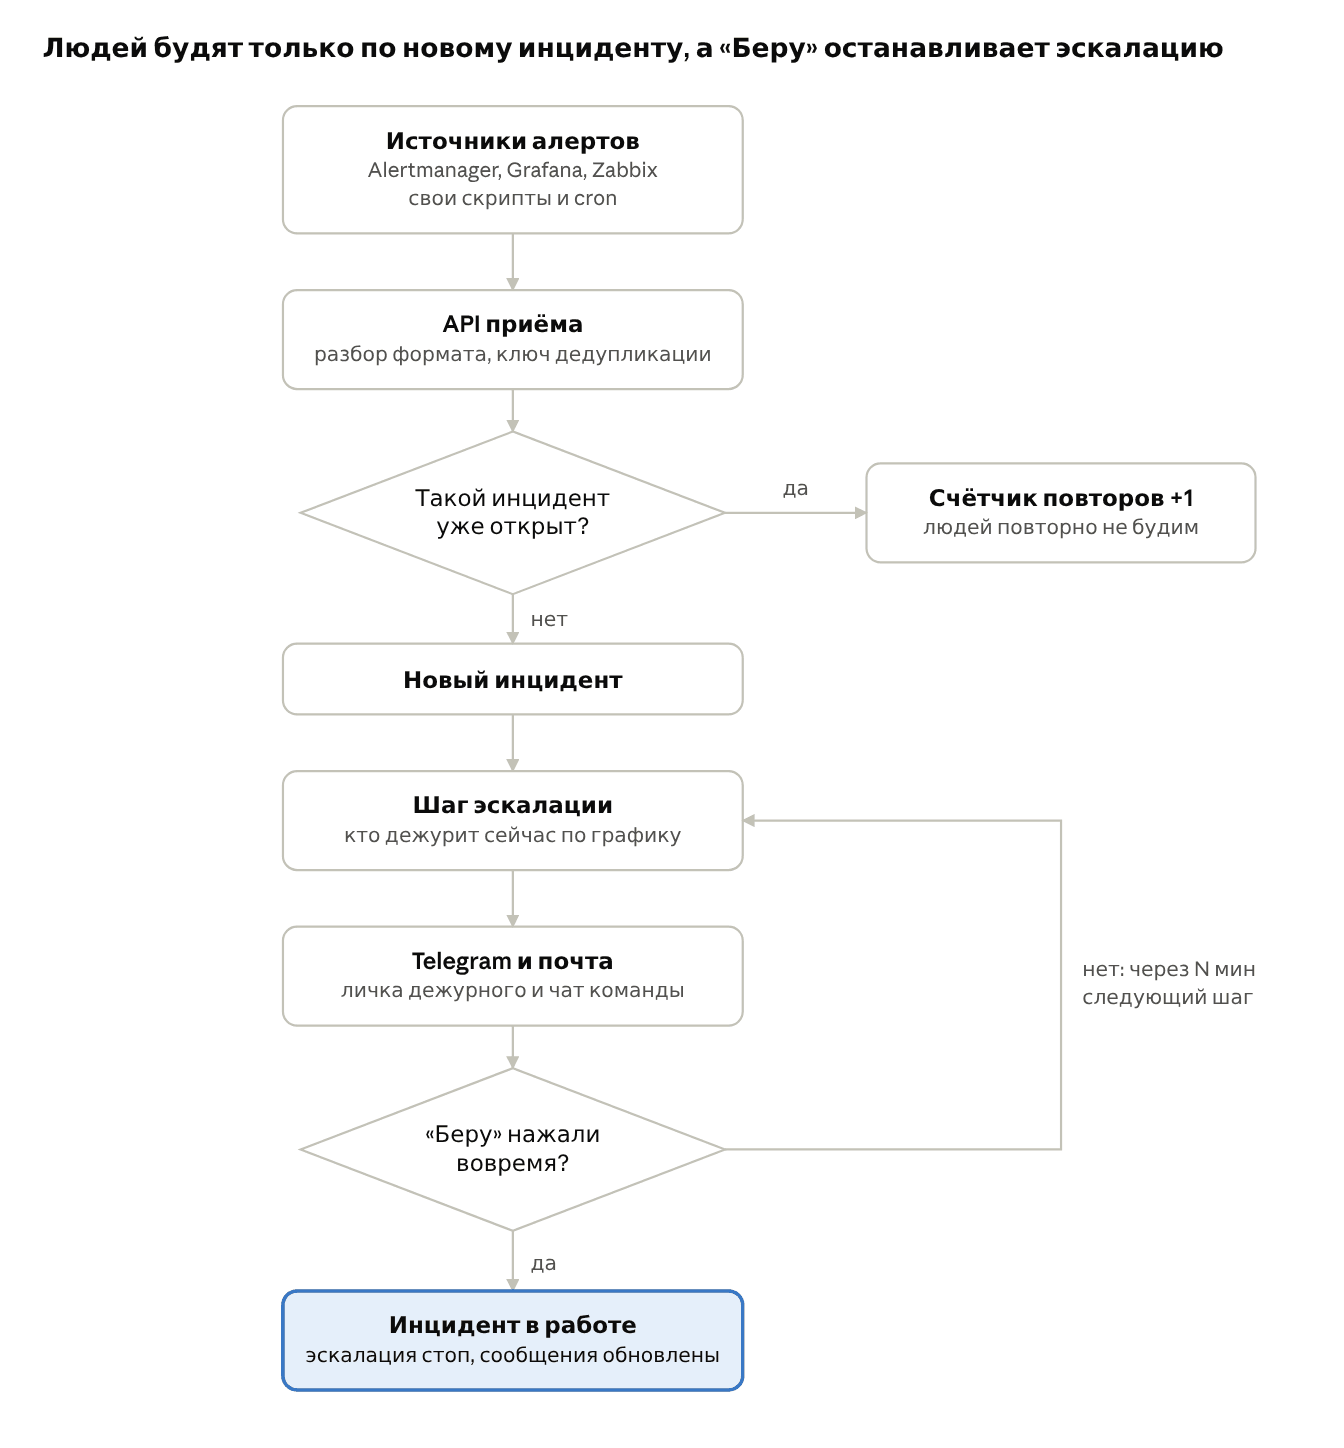
Алерт проходит две развилки. Сначала проверяется, нет ли уже открытого инцидента с тем же ключом: если есть, людей не будят повторно. Затем после уведомления «Дежурка» ждёт «Беру». Нет нажатия за отведённые минуты — переходит к следующему шагу политики и снова смотрит, кто сейчас в смене.
Под капотом это Python 3.12, FastAPI и SQLAlchemy, хранилище — SQLite или Postgres. Весь сервис — около 2000 строк кода и 24 теста, ставится одним Docker-контейнером.
Подключение за 5 минут
У каждого сервиса в конфиге есть секретный integration_key. Он входит в URL вебхука, а последний сегмент URL говорит, в каком формате пришёл алерт.
Prometheus Alertmanager — достаточно добавить ресивер:
receivers:
  - name: dezhurka
    webhook_configs:
      - url: https://dezhurka.example.ru/api/v1/ingest/<integration_key>/alertmanager
        send_resolved: true
С send_resolved: true инцидент закрывается сам, когда алерт уходит. Grafana Alerting шлёт совместимый формат — для неё тот же URL с окончанием /grafana.
Zabbix — медиа-тип Webhook с готовым JS-скриптом из репозитория. Если в действии включить Recovery operations, восстановление тоже закроет инцидент: «Дежурка» склеивает проблему и восстановление по {EVENT.ID}.
Свои скрипты и cron — обычный JSON:
curl -X POST https://dezhurka.example.ru/api/v1/ingest/<integration_key>/generic \
  -H 'Content-Type: application/json' \
  -d '{"title": "Ночной бэкап не прошёл", "dedup_key": "backup-db1", "details": "exit code 2"}'
Это удобно для бэкапов, проверок сертификатов и всего, что не живёт в Prometheus.
Графики и эскалации
Всё статичное описано в одном config.yaml, его удобно держать в git и ревьюить как обычный код:
schedules:
  - id: sre-primary
    timezone: Europe/Moscow
    rotation:
      start: 2026-11-02T10:00:00   # первая смена — понедельник, 10:00
      shift_hours: 168             # неделя; 24 — посуточно, 12 — день/ночь
      users: [ivan, maria, oleg]

escalation_policies:
  - id: sre
    repeat: 2                      # если никто не взял — ещё два круга
    steps:
      - targets: [{schedule: sre-primary}]
        escalate_after_min: 5
      - targets: [{user: lead}]
        escalate_after_min: 10
Когда приходит новый алерт, «Дежурка» смотрит, кто сейчас в смене по графику sre-primary, и зовёт его в личку Telegram и на почту. Параллельно инцидент дублируется в общий чат команды. Если за 5 минут никто не нажал «Беру», зовут тимлида, через 10 минут цикл начинается заново. После двух кругов в хронологии появляется запись, что эскалация исчерпана, — это сигнал пересмотреть график.
Подмены живут отдельно, в базе: их добавляют в панели, не трогая конфиг. Подмена всегда сильнее ротации, а из двух пересекающихся побеждает последняя.
Секреты (токен бота, пароль панели, ключи интеграций) в конфиге не хранятся: они подставляются из переменных окружения через ${VAR}.
Инженерные решения, которые пришлось продумать
Дедупликация по ключу, а не по тексту. У Alertmanager у каждого алерта есть fingerprint — хэш меток. Пока инцидент с таким ключом открыт, повторные алерты только увеличивают счётчик. Для Zabbix ключом служит {EVENT.ID}: Zabbix передаёт один и тот же ID и в проблеме, и в восстановлении, поэтому пара склеивается без эвристик. Если ключа нет, берётся хэш меток.
Long polling вместо вебхука Telegram. Чтобы принимать нажатия кнопок через вебхук, серверу нужен публичный HTTPS-адрес. В закрытом контуре банка его нет и не будет. Поэтому бот сам опрашивает Telegram через getUpdates: наружу нужен только исходящий доступ к api.telegram.org.
Один процесс — осознанно. Цикл эскалаций, бот и HTTP API живут в одном процессе uvicorn, а все изменения состояния инцидентов идут через один asyncio.Lock. Для системы, через которую проходят десятки инцидентов в день, это проще и надёжнее распределённых блокировок: нельзя случайно разбудить человека дважды или потерять «Беру» в гонке. По умолчанию данные лежат в SQLite, для продакшна можно подключить Postgres.
Обновление уже отправленных сообщений. Каждое сообщение об инциденте сохраняется с chat_id и message_id. Когда кто-то нажимает «Беру», все копии — в личках и в общем чате — редактируются: статус меняется на «В работе: Иван», кнопка «Беру» исчезает. В чате не остаётся «висящих» алертов, по которым непонятно, взял ли их кто-то.
Кнопки нажимают только свои. Человек привязывает Telegram по личной ссылке вида t.me/<бот>?start=<код>, где код — HMAC от его id с секретом сервера. Таблица кодов не нужна, подделать код нельзя. Нажатия от непривязанных аккаунтов и команды /open и /oncall от посторонних бот отклоняет — даже если его добавили в чужой чат.
Защита панели. Панель закрыта Basic-авторизацией. Так как браузер сам подставляет Basic-заголовок в любые запросы, POST-формы дополнительно проверяют Origin, иначе любая чужая страница могла бы закрыть ваш инцидент от вашего имени.
Как попробовать
Исходники лежат на GitHub: github.com/wonbix1409/dezhurka. В репозитории есть установщик демо-стенда: на чистой Ubuntu он одной командой поднимает «Дежурку», Prometheus, Alertmanager, Grafana и, по желанию, Zabbix, уже связанные между собой.
sudo bash deploy/setup.sh            # 1 vCPU, 2 ГБ RAM
sudo bash deploy/setup.sh --zabbix   # 2 vCPU, 4 ГБ RAM
Скрипт сам сгенерирует пароли, спросит токен бота от @BotFather и в конце напечатает адреса. Через пару минут можно отправить тестовый алерт и нажать «Беру» в Telegram.
Код открыт для ознакомления, условия использования описаны в LICENSE репозитория.
Что дальше
Звонки и SMS через российских провайдеров — без этого ночное дежурство неполноценно.
Мессенджер MAX как второй канал.
Статус-страница для клиентов и отчёты по нагрузке дежурных.
Для корпоративной установки — SSO через LDAP/Keycloak, роли, аудит и Helm-чарт.
Если вы сейчас сидите на Opsgenie и думаете, куда переезжать до апреля, расскажите в комментариях, как у вас устроены дежурства и чего не хватает. Приоритеты дорожной карты я буду расставлять по вашим ответам.


Комментарии 0