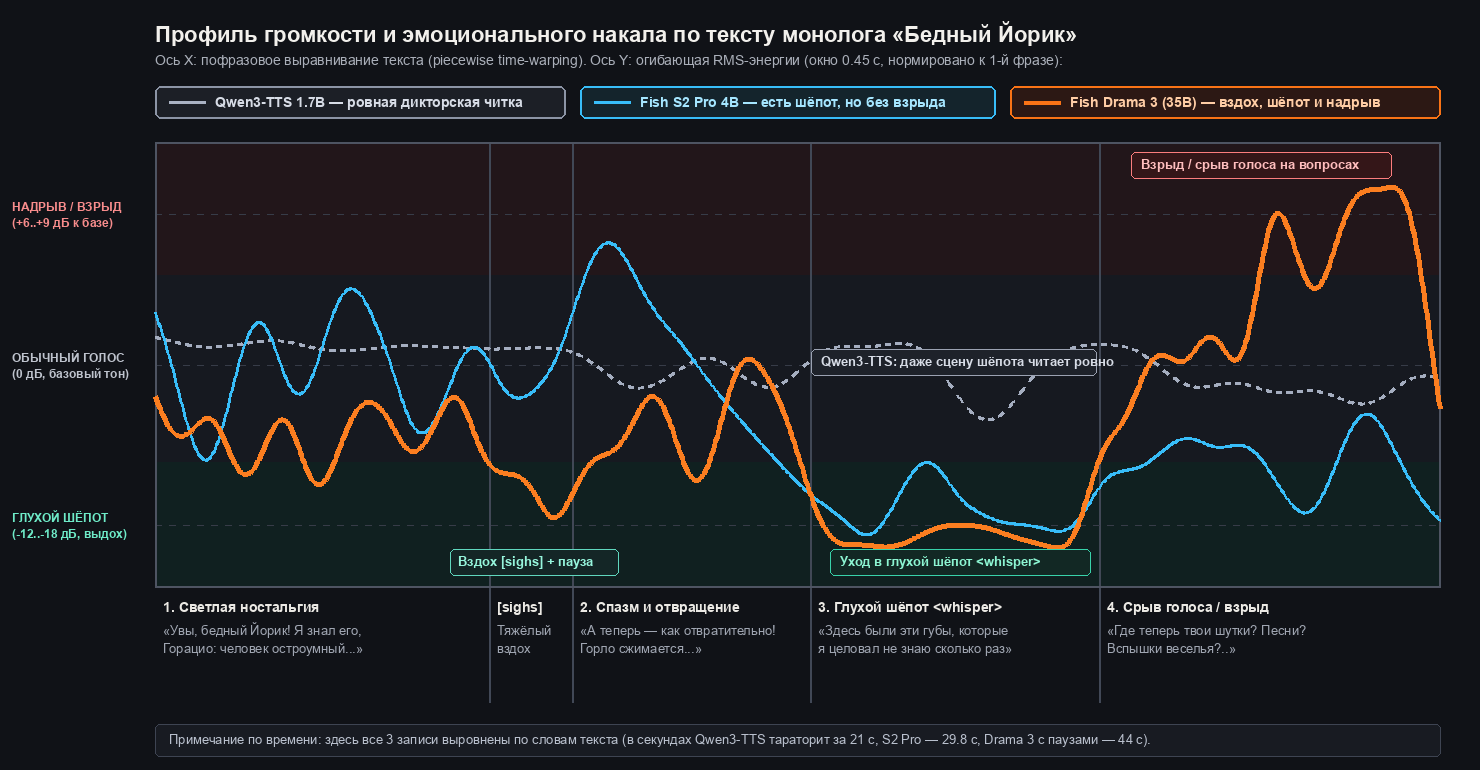
Для ровной дикторской начитки локальных TTS-моделей сегодня хватает с запасом: подаёшь на вход чистый образец голоса, расставляешь ударения — и получаешь разборчивую озвучку для лекции, технической заметки или видеоинструкции.
Сложности начинаются, когда нужна не дикторская читка, а актёрская игра с широким эмоциональным диапазоном — чтобы внутри одного абзаца голос прошёл через горькую иронию, ком в горле, глухой шёпот на выдохе и резкий эмоциональный срыв. Компактные модели на 0,5B–1,7B параметров такие перепады сглаживают: нейросеть держит среднюю интонацию исходного образца и читает драматический монолог с тем же бодрым выражением, что и документацию к API.
Ниже расскажу, через какие грабли я прошёл, пытаясь решить эту задачу локально — от ручной правки высоты голоса в фонетическом пакете Praat до подбора актёрских референсов — и как с этим справляется вышедшая в конце октября 2026 года модель Fish Audio Drama 3 (35B-A3B MoE) в сравнении с младшей версией S2 Pro (4B).
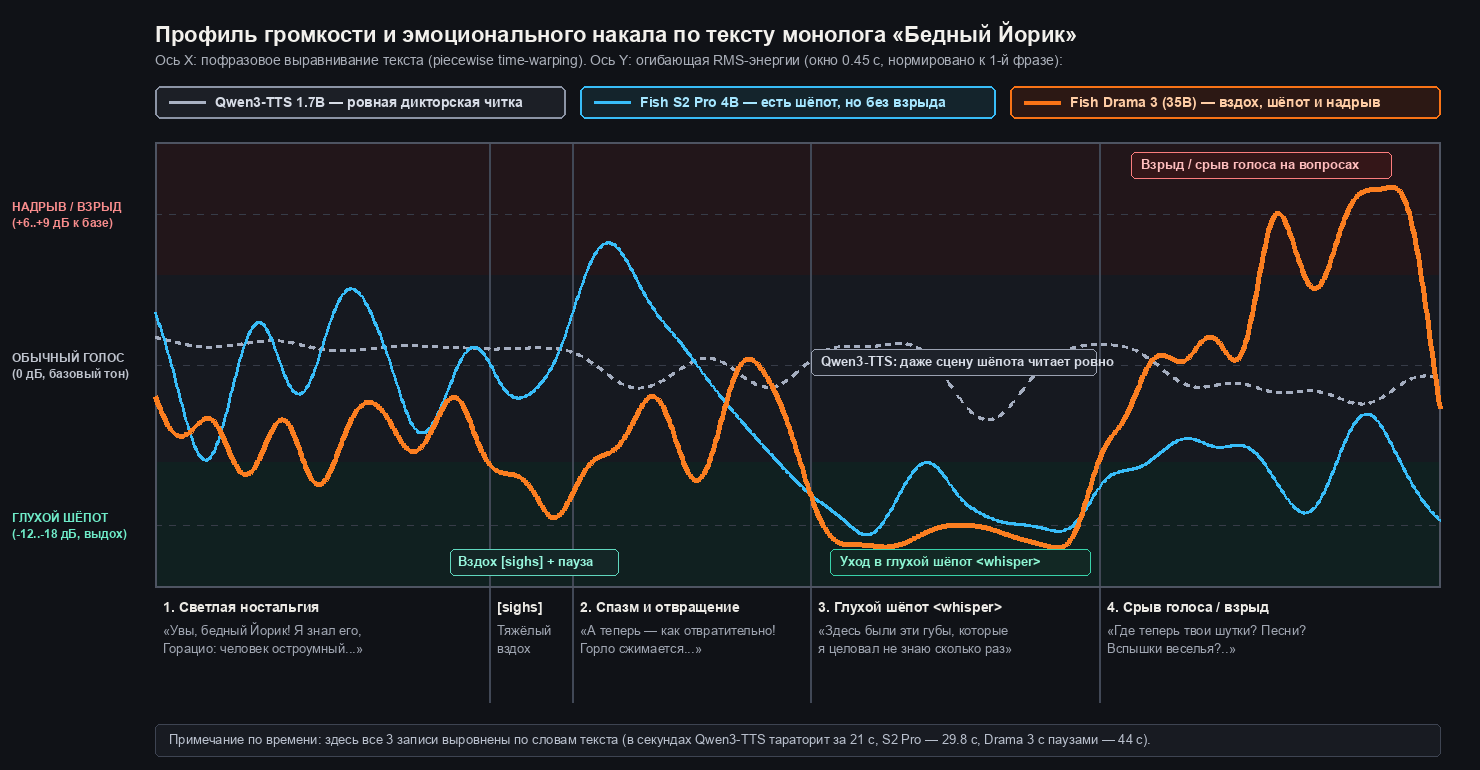
Как читать этот график: по горизонтали все 3 записи выровнены по словам четырёх фраз монолога (чтобы одни и те же слова находились строго друг под другом, хотя в секундах модели читают текст с разной скоростью — от 21 до 44 с). По вертикали отложена огибающая громкости и эмоционального накала: внизу (бирюзовая зона, -12…-18 дБ) — тихий глухой шёпот и выдох, посередине (0 дБ) — обычная дикторская речь, вверху (красная зона, +6…+9 дБ) — громкий эмоциональный срыв и надрыв.
Тестовый стенд: почему именно монолог с черепом Йорика
Чтобы не проверять модели на случайных бытовых фразах, я взял в качестве единого стресс-теста классический фрагмент из V акта «Гамлета». На отрезке в четыре предложения здесь нужно четырежды полностью сменить подачу и работу голосового аппарата. Сначала идёт тёплая ностальгия с мягкой улыбкой («Увы, бедный Йорик! Я знал его, Горацио: человек бесконечно остроумный, чудеснейший выдумщик; он тысячу раз носил меня на спине»). Затем следует резкая смена тона, физическое отвращение и спазм («А теперь — как отвратительно мне это! Горло сжимается, когда я гляжу на него»). После этого голос должен уйти в тихий, глухой сценический шёпот прямо у микрофона («Здесь были эти губы, которые я целовал не знаю сколько раз»). И в финале после тяжёлого выдоха звучит серия трагических вопросов с нарастанием напора («Где теперь твои шутки? Твои выходки? Твои песни? Твои вспышки веселья, от которых вся застолица покатывалась со смеху?»).
Я преподаватель-исследователь, и сама эта задача выросла из подготовки интерактивного обучающего курса — как альтернативы обычной записи лекций на площадке университета. Чтобы удерживать внимание студентов и сохранять погружение в предмет даже на дистанционке, хотелось уйти от монотонной дикторской начитки к живой разговорной и актёрской подаче. Пайплайн для этого собран в два шага: сначала базовая TTS-модель генерирует речь с нужной ритмикой, дыханием и интонационным рисунком, а затем дорожка при необходимости прогоняется через RVC v2 (Retrieval-based Voice Conversion, 40 кГц — нейросеть для замены тембра голоса по аудио-исходнику), чтобы перенести готовую игру на единый целевой голос.
Часть 1. Почему не хватило компактных моделей и ручной доводки звука
Подход 1. Базовая генерация в Qwen3-TTS 1.7B
В качестве отправной точки я взял дообученную под русский язык модель на базе siriusfreak/qwen3-tts-12hz-1.7b-ru-stress-cf, которая понимает знаки ударения U+0301 (остроу́мный, вы́думщик, засто́лица пока́тывалась со́ смеху). На вход подавался чистый студийный референс длительностью 9,1 с.
На выходе получился файл длительностью 21,0 с (24 кГц) с фонетически чистой, разборчивой речью без акцента и цифровых артефактов. Но по эмоциям результат оказался совершенно плоским: фразу «Горло сжимается, когда я гляжу на него» и сцену шёпота модель прочитала с тем же ровным дикторским тоном, что и первую строчку (на графике это серая пунктирная линия, которая идёт почти горизонтальной полкой через весь текст).
Подход 2. Нарезка по фразам и ручная правка высоты голоса в Praat
Следующая идея была такой: раз модель не меняет интонацию внутри длинного куска, можно нарезать монолог на отдельные фразы, сгенерировать каждую со своим референсом (спокойным, мрачным, эмоциональным), а поверх докрутить интонацию скриптом через библиотеку parselmouth. Это Python-обёртка над Praat — классической программой для фонетического анализа и модификации речи. С помощью алгоритма TD-PSOLA (сдвиг высоты голоса без изменения темпа речи) я пробовал принудительно опустить основной тон голоса (F0, базовую частоту высоты голоса в герцах) на мрачной реплике, добавить лёгкое дрожание и поднять тон на финальных вопросах.
На практике этот подход упёрся в две проблемы:
Слышимые склейки между фразами. Когда подаёшь компактной TTS-модели разные сэмплы одного и того же человека от фразы к фразе, она копирует не только интонацию, но и малейшую разницу в расстоянии до микрофона, громкости и акустике помещения. На стыках возникает ощущение, что реплики записаны в разных комнатах.
Шёпот и спазм в горле не сводятся к высоте тона (
F0). Когда живой человек переходит на шёпот или говорит со спазмом, его голосовые связки перестают смыкаться как обычно: пропадает чистый основной тон, в голосе появляется воздух и шум выдоха, а спектр смещается по частотам. Если просто тянуть высоту обычной речи вверх-вниз вPraat, получается механическая модуляция, а не шёпот. При этом для мелких правок — например, поправить ударение или чуть поднять интонацию вопроса в спокойной лекции —Praatостаётся вполне рабочим инструментом.
Подход 3. Записи профессиональных чтецов аудиокниг (ToneBooks)
Третья гипотеза — проверить, изменится ли результат, если взять в качестве референса записи профессиональных дикторов из открытого датасета ToneBooks с выраженной художественной подачей и полушёпотом.
Запись стала звучать как добротная коммерческая аудиокнига, но здесь проявилась жанровая разница: чтец аудиокниги и драматический актёр решают разные задачи. Диктор начитывает многочасовую книгу вдолгую — он бережёт голосовые связки и держит ровную подачу без резких перепадов по громкости и дыханию. Он не отыгрывает спазмы, сбитое дыхание и переход на глухой шёпот.
Часть 2. Как устроены Fish Audio Drama 3 и S2 Pro
В поиске моделей, способных менять регистр голоса и дышать прямо внутри одной генерации, я решил протестировать линейку от команды Fish Audio (разработчиков открытого семейства Fish Speech). В конце октября 2026 года они открыли веса флагманской модели fishaudio/drama-3, а в начале ноября в библиотеке mlx-audio появился её квантованный порт mlx-community/fish-audio-drama-3-4bit.
По своей внутренней архитектуре Drama 3 (model_type: fish_drama3) заметно отличается от привычных легковесных TTS-решений:
Крупная базовая языковая модель 35B-A3B MoE (
FishOmniModel): Вместо небольшой сети на 0,5B–1,7B параметров здесь стоит 40-слойный гибридный трансформер (на каждые три слоя линейного внимания приходится один слой полного внимания) с архитектурой Mixture-of-Experts: 256 маршрутизируемых экспертов в каждом слое, из которых на каждый токен активируются 8 (около 3 млрд активных параметров при общем объёме 35 млрд) и словарём на 252 288 токенов.Временна́я аудио-башня (
Tower) и кодек 44,1 кГц: В отличие от младшей S2 Pro, где используется простая 4-слойнаяDual-ARголова без памяти между соседними кадрами, в Drama 3 стоит 13-блочная аудио-башня (codebook_mtp_shared), сохраняющая собственный KV-кэш во времени. Она предсказывает 10 кодбуков (слоёв дискретных аудио-токенов со словарём 4096, кодирующих тембр и детали звука), которые декодируются нейросетевым аудиокодекомFish S1 DACс частотой 44,1 кГц.Мульти-референсный шаблон (
reference-bracket-v1): Если в обычную zero-shot модель склеить в один референсный файл спокойную речь, шёпот и крик, она либо усреднит их, либо начнёт случайно скакать по тону посреди обычных слов. Системный промпт Drama 3 принимает массив отдельных пар[Reference 1],[Reference 2],[Reference 3](текст + аудиокоды), привязывая каждое состояние голоса к своей расшифровке.Режиссёрские теги в тексте: Модель обучена интерпретировать текстовые ремарки в квадратных скобках (в своих тестах я проверял
[sighs],[sigh],[sad],[whisper],[low voice]) и парные XML-теги<whisper>...</whisper>. Сами эти теги в Drama 3 не являются отдельными спецтокенами словаря и разбиваются по BPE как обычный текст, однако препроцессор нарезки (chunking.py, лимит 300 байт UTF-8 на чанк) специально защищает конструкции<tag>...</tag>и[...]регулярным выражениемUNCUTTABLE, чтобы не разорвать ремарку на границе сегментов. В токенизаторе также заложены 16 спецтокенов для многоголосых диалогов (<|speaker:0|>..<|speaker:15|>), но этот режим я не проверял — тестировал модель только для одного голоса.
Потребление памяти и железо для локального запуска
Даже в смешанном квантовании с group_size=64 (4-bit для маршрутизируемых экспертов MoE и 8-bit для слоёв внимания, общих экспертов и аудио-башни) веса модели занимают на диске 22,15 GiB (23,8 ГБ). На десктопных видеокартах с 24 ГБ VRAM запуск такой модели в связке с SGLang-Omni или vLLM-Omni упирается в потолок видеопамяти.
Параметры локального запуска (M4 Pro, 48 ГБ, бэкенд
mlx-audio): модель загружается в память за 8,3 с, выделяет в пике 28,6–28,8 ГБ и генерирует 44,1 кГц аудио со скоростью около 1:1 к реальному времени (44,0 с монолога считаются за 44,8 с).
Часть 3. Подготовка эмоциональных референсов и код запуска
Чтобы Drama 3 раскрыла возможности мульти-референсного шаблона, ей нужны чистые студийные записи, где один и тот же человек звучит в разных состояниях без фоновой музыки и шумов.
Для лабораторного теста проще всего оказалось взять чистые студийные дорожки из игровой локализации. По-хорошему, для такой задачи стоило бы обратиться к театральным архивам актёрских проб, радиоспектаклям или записям моноспектаклей, где эмоциональные диапазоны одного исполнителя уже разложены по полочкам. Но в моменте мне хватило ума только на распакованные игровые исходники.
Я собрал три тестовых голосовых профиля (низкий драматический баритон, эмоциональный тенор и сдержанный камерный баритон) и отобрал для каждого по 3 фрагмента длительностью от 5,6 до 12,5 секунд в разных состояниях: спокойное повествование, глухой прерывистый шёпот и тяжёлый выдох со спазмом.
Главный приём при разметке референсов
При передаче списка ref_audio=[wav_1, wav_2, wav_3] в их текстовых расшифровках ref_text=[txt_1, txt_2, txt_3] я проставлял те же самые теги [sighs] и <whisper>...</whisper> ровно в тех местах, где актёр вздыхает или переходит на шёпот на самой записи (важно, чтобы сам текст в ref_text дословно совпадал с произнесёнными на записи словами, иначе сбивается выравнивание между текстом и аудиокодами). Так модель напрямую связывает тег в промпте с тем, как именно звучит вдох и шёпот у этого конкретного человека:
# pip install -U "mlx-audio>=0.6.2" soundfile numpy
import numpy as np
import soundfile as sf
from mlx_audio.tts.utils import load_model

# Загрузка 4-битной модели (пик памяти при генерации ~28.8 ГБ)
model = load_model("mlx-community/fish-audio-drama-3-4bit")

hamlet_text = (
    "[sighs] Увы, бедный Йорик! Я знал его, Горацио: человек бесконечно остроумный, "
    "чудеснейший выдумщик; он тысячу раз носил меня на спине. "
    "[sighs] А теперь — как отвратительно мне это! Горло сжимается, когда я гляжу на него. "
    "<whisper>Здесь были эти губы, которые я целовал не знаю сколько раз.</whisper> "
    "[sighs] Где теперь твои шутки? Твои выходки? Твои песни? "
    "Твои вспышки веселья, от которых вся застолица покатывалась со смеху?"
)

# Три эталонных сэмпла одного голоса (спокойная речь, шёпот, тяжёлый выдох)
ref_audio = ["refs/profile_a_calm.wav", "refs/profile_a_whisper.wav", "refs/profile_a_sigh.wav"]
ref_text = [
    "Я об этом ребёнке ж мечтал. Я говорил: вот он родится на свет — и всё изменится к лучшему. А он умер, прежде чем родился.",
    "<whisper>Она лежала там... маленькая... беззащитная... на окровавленных простынях... мёртвая... из-за меня.</whisper>",
    "Выбросила? Боги... Я надеялся, она всё-таки... [sighs] А-ах...",
]

pieces = [
    np.array(res.audio, dtype=np.float32)
    for res in model.generate(
        text=hamlet_text,
        ref_audio=ref_audio,
        ref_text=ref_text,
        temperature=0.8,
        top_p=0.8,
        top_k=30,
    )
]

audio = np.concatenate(pieces)
sf.write("hamlet_drama3_44k.wav", audio / np.max(np.abs(audio)) * 0.89, model.sample_rate)
Часть 4. Результаты синтеза и сравнение с младшей Fish Audio S2 Pro (4B)
На всех трёх голосовых профилях Drama 3 отыграла переходы именно так, как требовалось по сценарию:
На тегах
[sighs]слышен живой вдох и выдох, после которого модель перестраивает темп и высоту голоса, а не просто вставляет тишину (на графике видно, как оранжевая линия ныряет вниз в бирюзовую зону на колонке[sighs]);Фраза внутри
<whisper>...</whisper>(третий столбец на графике) звучит настоящим глухим шёпотом с шумом воздуха у микрофона — и Drama 3 (оранжевая линия), и S2 Pro (голубая линия) здесь уходят на самое дно графика, в отличие от серого пунктира Qwen3-TTS;На финальной серии риторических вопросов (четвёртый столбец) Drama 3 самостоятельно выстраивает интонационную лесенку с выходом в верхнюю красную зону (срыв голоса / взрыд на последних вопросах). Отдельно отмечу стабильность: при
temperature=0.8модель от запуска к запуску немного варьирует длину пауз (40,5–44,0 с), но ни разу не сорвалась в галлюцинации и не проглотила слова.
После генерации я прогнал полученные дорожки через RVC v2 (40 кГц) для адаптации под целевой тембр нашего проекта. Да, ресемплинг через 40 кГц RVC срезает часть верхних частот относительно нативных 44,1 кГц Drama 3, но это осознанный практический компромисс: обучить качественную RVC-модель под нужный голос можно на 10–15 минутах чистой записи, тогда как полноценный файнтюн 35-миллиардной модели под свой голос несоизмеримо сложнее. Чтобы RVC при конвертации не пытался найти основной тон в глухом шёпоте и искусственно «пропеть» его связками, я зафиксировал параметры protect=0.35 (защита глухих согласных и дыхания от замены тембра) и rms_mix_rate=0.25 (сохранение исходной огибающей громкости, чтобы конвертер не вытягивал тихий шёпот до уровня громкой речи).
Сравнение с младшей моделью Fish Audio S2 Pro (8-bit, 6,7 ГБ)
Поскольку речь идёт о разнице между 1,7B и 35B, а выделять почти 29 ГБ памяти под синтез голоса разумно далеко не всегда, я проверил на том же монологе промежуточное звено — младшую модель того же семейства mlx-community/fish-audio-s2-pro-8bit (4B параметров, 6,27 GiB / 6,73 ГБ на диске). Так как S2 Pro в mlx-audio принимает один референсный массив и использует префиксные однословные теги, три эталонных фрагмента подавались склеенными через паузу 0,25 с, а разметка была приведена к её штатному синтаксису ([sigh], [sad], [whisper] [low voice]).
Прямое сравнение S2 Pro (4B) и Drama 3 (35B MoE) показало три главных отличия. Во-первых, по ресурсам S2 Pro инициализируется всего за 2,4 с и потребляет в пике 12,45 ГБ памяти (в 2,3 раза меньше старшей модели), используя тот же 44,1 кГц аудиокодек Fish S1 DAC. Во-вторых, теги [whisper] [low voice] младшая модель отрабатывает достойно — переход на шёпот в середине монолога сохраняется, однако теги вздохов [sigh] она склонна пропускать, прочитывая весь монолог за 29,8 с против 44,0 с у Drama 3. При этом сам расчёт 29,8 с аудио на S2 Pro занял 54,4 с из-за пересчёта Dual-AR головы без межкадрового кэша.
В-третьих, на сыром тексте без проставленных ударений младшая 4B-модель ошиблась в редком имени — произнесла «Го́рацио» вместо «Гора́цио», тогда как 35B-модель Drama 3 прочитала классический текст без единой ошибки с первого прохода. Понятно, что эту проблему на младшей модели легко обойти за счёт более чистого промпта (расстановки ударений и остальных уловок, которые и без меня знают все, кто работает с генерацией голоса), но сам факт хорошо иллюстрирует разницу в объёме языковой модели внутри TTS.
Сводная таблица протестированных моделей
Модель в mlx-audio | Вес на диске | Пик RAM | Частота | Практическая ниша |
|---|---|---|---|---|
Fish Audio Drama 3 (4-bit) | 23,8 ГБ | 28,8 ГБ | 44,1 кГц | Сложная актёрская игра и драма: мульти-референс, живые вздохи |
Fish Audio S2 Pro (8-bit) | 6,7 ГБ | 12,5 ГБ | 44,1 кГц | Компромисс для машин с 16–24 ГБ памяти: чистый звук 44,1 кГц и шёпот |
Qwen3-TTS 1.7B (ru-stress) | 4,6 ГБ | 5,2 ГБ | 24,0 кГц | Лекции и технические тексты: быстрая генерация (в 3 раза быстрее реального времени) и ручные ударения |
Мне бы такой разбор в своё время сэкономил несколько дней экспериментов. Так что буду рад, если он кому-то будет полезен.


Комментарии 0