Все больше наблюдаю за дискуссией об этом всеобъемлющем ИИ и то, как этот вопрос поляризует общество от сторонников и противников. Сейчас, куда ни придешь, первый вопрос — это у тебя Claude или GPT, и потом обсуждение, что всё‑таки лучше, а только потом спрашивают о том, к какому врачу вас записать (да, было такое).
Что касается печатных плат, а особенно после того, как OpenAI показало, как их модель способна разводить печатные платы, волна ИИ просто снесла все сообщество, мне кажется, не проходит и дня, как в каком‑нибудь сообществе не происходит дискуссия (срач) на эту тему. Я вообще не хотел высказываться, но пока другие статьи готовятся, попробуем кратко обсудить эту тему, разберем аргументы сторон, и я поделюсь своей практикой. И сразу скажем, что я не эксперт в области ИИ и не слежу за этим 24/7, но то, что я вижу и слышу, заставило меня сесть и разобраться. Я понятия не имею, какая самая актуальная версия ChatGPT или Claude и какие есть суперкитайские модели. Также я без понятия, что какой‑то эксперт или компания сказали, что нам не нужны больше люди, а потом через день наняли ровно столько же, прикрывая этим снижения ФОТ, за счет найма нового более дешевого персонала. Я самый обычный пользователь, который работает и большую часть времени читает и изучает профессиональную литературу. Я знаю, что тут, скорее всего, куча ошибок в работе ИИ и на самом деле ИИ уже может все, просто большие корпорации специально душат такие проекты. После всех возможных оговорок я начну, а всех, кто будет не согласен, прошу в комментарии, я только рад узнать что‑то новое.
ИИ заменят нас?
Все это началось с того самого злополучной презентации GPT Astra, где показали, как «фантастически» модель справилась и что такие задачи теперь можно делегировать ИИ. Так давайте посмотрим, что и правда там было.
В самой презентации GPT-6 Astra, где OpenAI продемонстрировала возможности модели в разработке печатных плат. В коротком видео показали, как Astra работает непосредственно в KiCad: размещает компоненты, прокладывает дорожки и заливает полигоны. По заявлению OpenAI, модель способна преобразовать электрическую схему в готовую к производству печатную плату.
Но что получилось на практике? Эксперименты сторонних команд показали неоднозначные результаты. Например, в тесте NextPCB Astra получила плату с уже расставленными компонентами и примерно за 12 минут вернула разведённую плату, но саму трассировку выполнил сторонний автотрассировщик Freerouting: Astra лишь организовала процесс (экспорт в DSN, запуск, импорт результата в KiCad). Когда ей запретили внешние инструменты и оставили только мышь и клавиатуру в KiCad, за час она проложила три коротких сегмента, и прогон остановили вручную.
Есть и более серьезные испытания. В эксперименте самой Quilter модель Astra работала в Altium с выключенным автотрассировщиком над SOM из их проекта Speedrun, восьмислойной платой на i.MX 8M Mini. За 62 часа она завершила около 98% соединений.
Наконец, сама OpenAI в ноябре 2026 года опубликовала результаты разработки собственного устройства с помощью Astra. Модель участвовала в выборе компонентов, проектировании платы, корпуса и программного обеспечения. Однако даже в этом случае потребовалось несколько итераций проверки и доработки: Astra не всегда учитывала производственные ограничения, допуски и требования к монтажу.
В целом впечатляюще, но пока не хватает фактуры, много заявлений и мало реально готовых вещей. Теперь перейдем к тому, какие аргументы приводят адепты ИИ с точки зрения именно разработки печатных плат. В каждом пункте я постараюсь сделать упор именно на тех вещах, которые видел в профильных чатах, но без упоминания людей, но с почти дословными тезисами.
ИИ может создавать компоненты для библиотеки
Довольно‑таки хорошая мысль. Уже многие ИИ умеют по документации делать модели разной сложности, и это можно увидеть сейчас повсеместно. Если разделить на составляющие, то у любого компонента библиотеки их три: УГО, посадочное место и 3D‑модель. С тем, как ИИ по документации справляется с 3D‑моделью, заполнен весь интернет и обсуждать тут мало что можно, да и не всегда это нужно, производитель часто сам выкладывает её. УГО, по всей видимости, тоже не является большой проблемой, и некоторые энтузиасты уже заявляют, что сделали что‑то такое. Остается посадочное место и, как мне кажется, вот тут могут возникнуть проблемы. Давайте сразу объяснюсь, я верю, что ИИ сможет это делать и кто‑то, наверное, уже это все настроил, но у меня вопрос, а как вы делаете посадочные места? Есть, как мне кажется, 3 подхода в создании посадочных мест. Первый — скачать готовый из библиотек (Ultra Librarian, SnapEDA) или создать с помощью программ, таких как PCB Library Expert, и других. Это хороший путь, но зачастую такие посадочные места не оптимальны и избыточны: используются достаточно большие запасы по зазорам и размерам. Зато они, как правило, формируются по стандартизированной методологии IPC и подходят для широкого круга производств, в том числе могут быть смонтированы в условном гараже. Второй — следовать рекомендациям производителя, если они есть. Тут, казалось бы, нет никаких проблем, кроме того, что некоторые из этих рекомендаций не очень адекватные. Думаю, тут каждый вспомнит свой пример, но есть и еще кое‑что. Очень часто такие рекомендованные посадочные места не соответствуют IPC или «гаражной» сборки, так что тут уже есть необходимость соотносить, а могут ли это потом смонтировать или произвести. Сразу главный пример — это масочный мостик, который некоторые производители микросхем закладывают 0,1 и меньше, а ваше производство зачастую попросит убрать это. В таком случае приходится самостоятельно как‑то корректировать данное посадочное место, по своей методике или как удобно в моменте. Ну и последний вариант — это вымученные согласования между топологом, технологом собственной монтажной линии и технологом производства. Обычно этот вариант мы рассматриваем, когда у компании есть своя монтажная линия и хорошие договоренности с производством. В таком случае мы можем сделать менее жесткими некоторые требования по зазорам и всему остальному, что иногда критически необходимо, чтобы сделать более компактный дизайн или смоделированная другая геометрия падов. Как правило, это все происходит методом проб и ошибок и долгой, а иногда ужасно долгой коммуникацией. Вы совместно выдвигаете теорию, исходя из своего опыта и оборудования, делаете макет, проверяете ее и потом только внедряете в общую библиотеку. А потом приходит другой технолог и вы делаете все по новой, потому что это не по стандарту… Но результат всегда будет лучше, чем предыдущие подходы.
Как вы понимаете, каждый из этих подходов описывает свой уровень компании и уровень продукта. В первом подходе ИИ, скорее всего, легко справится с задачей, но и уровень этих проектов будет не самый большой, да и уже готовых библиотек, скорее всего, будет достаточно и они есть уже здесь и сейчас. Во втором использование ИИ выглядит на данный момент достаточно перспективно, но вызывает некоторые вопросы. В прошлом я писал подробную инструкцию для сотрудников, как создавать и по каким правилам необходимо формировать библиотеку компании, в ситуации, когда IPC уже не могла полностью покрыть потребности. Вы не поверите, но у меня ушло на это все время, что я работал в компании, с первого дня, что мне это поручили (я сам себе поручил), до последнего, пока не уволился. Каждый раз находилась неточность формулировки или все работает на 90% посадочных мест, но в 10% нет и необходимо заново продумывать эти правила. Да, у меня были ограничения в том, что это выполняли люди, и я понимал, что усложнять десятками путями «если‑то» только убило бы процесс и спутало всех, и приходилось упрощать. Но даже в таком случае это десятки страниц текста, и когда ты уже думаешь, что все хорошо, Texas Instruments снова выдает какие‑то неадекватные компоненты или технические возможности производства меняются. Короче, все переделывать или переписывать код и инструкции для ИИ.
Может ли это упростить задачу? Наверное, да, но это реально нужно, если у вас сотни сложных посадочных мест, которые вы добавляете ежегодно. Предположу, что ни у кого такого нет, только если «сложными» вы называете добавление условного SOIC-8 для каждого part number свой, а не делаете один универсальный (там, где это возможно). В противном случае обучение вашей ИИ и прописывание инструкций к ней займет в разы больше времени, все ради 3 компонентов в год. Что он точно может — это стандартизировать уже готовые посадочные места, что честно занимает кучу времени и то, это только теоретический пока что.
Тут оговорюсь сразу, это внедрение ИИ будет легче и проще, если у вас уже написано инструкции, но я уверен на миллион процентов, что у вас ее нет. Поэтому каждый или делает, как хочет, или у вас есть библиотекарь, при смене которого приходит другой и делает, как хочет. И тут есть ИИ, нет ИИ, ну как бы, вы понимаете, ничего не поменяется, как была у вас фиговая библиотека, так и останется.
Теперь к публичной статистике. Все, что я смог найти, говорит о том, что есть какие‑то стартапы, эффективность которых еще необходимо проверить. Из научных работ мне попался препринт на arXiv: авторы собрали набор из 1000 компонентов и заявляют точность 86% для символов и 80% для посадочных мест. Но в таблицах эти цифры относятся к компонентам с 6–20 выводами, а оценивается доля компонентов с правильным числом выводов. Чем сложнее компонент, тем хуже: для 21–40 выводов это 73% и 47%, а для 41–100 выводов — 0%. Время создания одного компонента — 3–5 минут.
Итого, мне кажется, что было бы круто получить модернизированные программы типа PCB Library Expert, которые умеют это все делать из datasheet для небольших проектов. Но опять же, соревноваться с уже готовыми библиотеками будет сложно. Но мое представление, что компании, предоставляющие уже готовые компоненты, внедрят в каком‑то виде этот инструментарий. В больших компаниях, как мне видится, необходимости в ИИ‑генераторе компонентов нет, так как их библиотеки уже полные, что при добавлении новых компонентов необходимо лишь незначительно изменить старые. Да и разработчики различных САПРов явно присоединятся к этому и в каком‑то смысле упростят работу в создании компонентов. Но! Если вы стартап или любитель, тут дело другое, но не забывайте со всем этим ИИ‑шумом, что есть и готовые компоненты.
Можно сделать DRC или другую проверку BOM, netlist и т.д.
Вот тут очень интересно, кстати, потому что мне кажется, это суперперспективное направление. Но давайте разберемся поподробнее.
DRC (Design Rule Check), по сути, уже набор проверок (мини‑программ), которые встроен уже в тот или иной САПР, для проверки тем правилам, что мы задали. Для всех типовых задач и в 99% случаев эта задача уже решена, но, как вы понимаете, есть тот самый 1%. Давайте опять расскажу свой пример из жизни. Когда‑то я работал в Mentor Xpedition 2.14, и там была одна проблема, что было правило зазоров между via и polygon работало очень странно. Если мне необходимо было убрать гарантийный поясок вокруг via, то зазор via‑polygon был точно таким же, как и зазор между via‑polygon, но где был гарантийный поясок. Эксперты Mentor, простите, наверное, были пути лучше, и это, наверное, так, да и я знаю, что, вроде как, в новых версиях это починили. Как вы понимаете, это была большая проблема, и необходимо было делать или Rule Area, или еще как‑то придумывать велосипед. Сейчас же взял, написал скриптик, который взял да и поправил это в Gerber при выгрузке их, и все. Вопрос, конечно, а точно ли все, так как перед тем, как это переводить в продакшен, необходимо проверить хотя бы на десятках, а лучше сотнях Gerber, что нигде конфликта нет, потому что даже в одном из тысячи проектов, если что‑то случится и партия в тысячи плат поедет в производство, будет грустно.
То же самое касается и компонентов, что в конце разработки выгрузил BOM, написал скрипт/программку, чтобы он пробежался по базам производителей, указал тебе, какие компоненты неожиданно вышли из производства, что перед заказами лучше их заменить. Или устроил проверку наименование цепей и так далее.
Но! Проблема состоит только в том, что здесь не нужен ИИ… Уже миллион лет назад такие программы были написаны программистами внутри крупных компаний, которые ежедневно выгружали информацию с сайтов производителей и стоков. То же самое и с DRC и netlist, написать скрипт мог любой программист вашей компании, которому дали эту задачу. Еще до ИИ у нас писали некоторые проверки прям в Mentor. ИИ изменил только одно: если раньше инженеру, которые не особо умел в программирование, для выполнение этой задачи надо было просить программиста, то сейчас он вроде как может это сделать сам. Тут самое главное вроде как. Потому что сейчас ну почти любой программист уже освоил ИИ в миллион раз лучше, чем вы, так и еще он понимает, где какие уязвимости там есть и как их избежать, чтобы вы не положили всю корпоративную сеть.
Да, придется общаться с программистом, чтобы рассказать, что ты от него хочешь, хоть и создав task в Jira письменно. Да, придется подождать, пока другой человек сделает ту работу, за которую ему платят деньги, но результат будет в разы лучше. Хочешь использовать ИИ в этом деле, да пожалуйста. Он может помочь составить ТЗ или сделать пробную версию, чтобы показать, как тебе надо. Потому что, что бы ты ни написал, в 99% случаев это будет ужасный код, состоящий костылей, и каждая дальнейшая доработка которого будет их только кратно увеличивать, а отладка растягиваться.
Итого, очень круто, что теперь почти каждый может создать себе какие небольшие скрипты или программки, ускоряющие процесс. Но точно ли ИИ решит вашу проблему или вы сделаете костыль, который назовете революцией, и как долго хватит вашего энтузиазма оптимизации, которого скорее всего не было до этого, а когда все начали делать ИИ он появился? В данном случае мне кажется, что мою работу за меня программист не сделает и я за него его тоже, поэтому пусть каждый будет делать то, что умеет лучше. Опять же, оговоримся, что для стартапов и компаний из 3 человек данные костыли обязательны, потому что нехватку ресурсов необходимо чем‑то заменить.
Создание топологии
Профильные паблики уже заполонили разборы по тому, как там плохо или хорошо ИИ трассирует платы или делает их компоновку, я этого делать не буду, ну почти. Я хочу поговорить о том, почему, как мне кажется, в проектах, которые условно среднего уровня (каждый как хочет, так и понимает, что такое средний уровень) ИИ именно в топологию придет не скоро.
Для начала этого разговора давайте вспомним, что в основе любой современной ИИ‑модели лежит огромный массив информации, на котором она обучалась. Это могут быть книги, научные публикации, техническая документация, статьи, исходный код программ, изображения, чертежи и множество других материалов. В зависимости от типа модели и поставленной задачи источники и способы обучения могут существенно различаться.
В процессе обучения модель не просто запоминает отдельные документы или копирует содержащуюся в них информацию. Она анализирует закономерности, взаимосвязи и структуры, которые встречаются в обучающих данных, и на их основе формирует внутреннее представление о предметной области. Например, языковая модель учится понимать технические термины, связывать их между собой, интерпретировать запросы и формировать ответы. Мультимодальные модели дополнительно учатся работать с изображениями, схемами, таблицами и другими визуальными данными.
Именно поэтому ИИ способен не только находить уже известную информацию, но и применять усвоенные закономерности к новым задачам. Например, анализируя техническую документацию электронного компонента, модель может определить его тип корпуса, распознать назначение выводов, извлечь геометрические параметры и использовать их для создания символа или посадочного места.
Однако здесь есть важный нюанс: качество результата напрямую зависит от качества, полноты и достоверности исходных данных, а также от того, насколько хорошо модель обучена решать конкретную задачу. Если в обучающей выборке недостаточно технической документации, чертежей корпусов или примеров корректно выполненных посадочных мест, модель может допускать ошибки даже при внешне убедительном результате.
Поэтому важно понимать, что универсальная ИИ‑модель и специализированный инженерный инструмент — не одно и то же. Первая обладает широкими знаниями и способностью работать с различными задачами, а второй может дополнительно использовать специализированные базы данных, технические стандарты, алгоритмы геометрических расчётов и механизмы проверки результатов. Именно сочетание этих возможностей представляет наибольший интерес для автоматизации проектирования печатных плат.
А теперь вернемся к нашей тематике. Вспомните, как много реально хороших дизайнов, для проектов, которые делают опытные и хорошие команды, вы видели в открытом доступе? Ну десяток, ну может сотню мы найдем, так нам еще нужно понимать, как они приняли те или иные решения, почему именно такой радиатор, почему именно здесь расположили это или то. Что‑то мы можем сами понять, а какие‑то решения окажутся просто косяком, а мы придумаем, что это, наверное, вот для этого, там ведь умные люди это делали. У меня есть идеальный пример для этого.
Я пришел в новую компанию, и мне необходимо было сделать ревизию старого проекта, так как некоторые компоненты вышли из использования, и она почему‑то перестала работать. Я взял проект и смотрю, а там везде медь используется 35 мкм. Хотя, казалось бы, обычная плата, там нет ничего такого, но я смотрю, а там импеданс дифф‑пары не сходится (ну прям сильно). У кого ни спрошу, никто не знает, делал «Василич», который уволился лет 5 назад, но все работало. Я тогда еще молодой специалист, пытаюсь понять, что за дела, смотрю форумы, гайды и так далее, ничего не помогает. Думаю, а дай‑ка найду старую плату, посмотрю вживую. Беру в руки и понимаю, а там нифига не 35 мкм базовая фольга, а классическая 18 мкм. И в ходе всех разбирательств мы выяснили, что в то время с чего‑то китайцы решили взять базовую 35 мкм (то есть финишная 65–75 мкм) и сошлифовать до 45 мкм (базовая 18 мкм), а мы согласовали это. Зачем? Почему? Одним только китайцам известно, но факт в этом, что мы перезаказывали эту плату у них, пока не сменили завод и, отправив те же файлы, получили неработающее устройство. Это я к чему, а к тому, что иногда, анализируя чужие проекты и не имея полноты информации, мы зачастую додумываем то, чего в реальности никогда не было. Тут мы возвращаемся к тому, что ИИ училась на каких‑то дизайнах, не имея никаких подробных разборов и ТЗ на них и поэтапных действий, почему сделали так, а не иначе. Да, она может найти чисто теоретические знания, но никто не знает, будет ли она чаще опираться на научные статьи или на статьи индуса с LinkedIn, особенно в таких общих моделях, представленных сейчас на рынке.
Давайте немного статистики и ее больше, чем я думал. Так как энтузиастов много, я приведу заявление только стартапов и инструментов, и то не всю, я могу что‑то упустить и не досмотреть. Я не открывал каждый проект который делали с помощью ИИ, потому что их уже примерно как ИИ котиков в соцсетях. После этих оговорок таблица:
Инструмент | Уровень плат | Слои | Компоненты / соединения | Время | Самостоятельное размещение | Результат трассировки | Источник |
Koppar | Низкий | 2 | — | 4,7–6,5 с | Нет | 100% Clean Pass | |
ProtoFlow + Claude Opus 5.5 | Низкий | 2 | — | 32–46 с | Нет | 100% Clean Pass | |
DeepPCB | Разный | 2-8 | до 5 208 соединений | медиана 4,6 мин | Нет | Медиана завершения 100%, 86% плат ≥ 95% | |
PCBRouteAgent | Низкий–высокий | — | До 451 Net | — | Нет | 94,9% / 100% / 40% Clean Pass* | |
DreamerV3 + FreeRouting | Средний | До 6 | — | В 50 раз быстрее базового подхода (заявлено) | Нет | 96% Completion Rate | |
Quilter — Project Speedrun | Средний | 8 | 843 компонента, 5141 pin | 27 ч + 38,5 ч доработки | Да | 98% соединений | |
GPT-6 Astra + Altium | Средний | 8 | 228 компонентов, 1109 соединений | 62 ч | Нет | 98,1% соединений | |
OmniRouting — GPT-5.5 | Низкий–средний | Разные | 219,8 тыс. Net в наборе | — | Нет | 27,98% NRR* |
* Результаты заявлены самими разработчиками либо взяты из бенчмарков на небольших платах. Для сравнения: на 2-слойных платах из 4–6 цепей из PCBWorld обычный Freerouting тоже даёт 100% Clean Pass за 2,7 с.
Пока адепты не умерли от восторга, увидев 100% в первых строках, вот вам пример плат, которые выдают 100%.
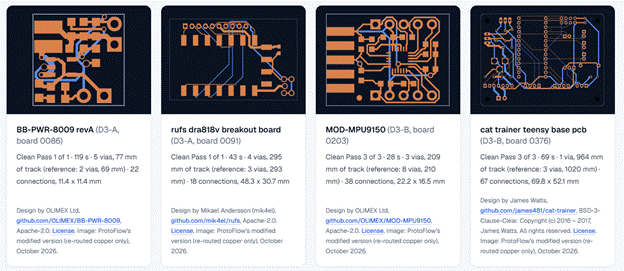
Но давайте остановимся на Quilter, как, мне кажется, более перспективном игроке. Я просмотрел те проекты, которые они делали и результаты, которые получили, и, честно говоря, многие обзоры, которые я читал, вообще не сходятся с тем, что я увидел. Остановился на Speedrun и вот что я вам скажу:
Первое — ну, это правда очень крутой результат.
Второе — это ужасно корявый результат.
Третье — это офигеть как не технологично.
Четвертое — огромное количество «но», и тут поподробнее. Например, для платы SOM они написали «We created a partial human fanout for the BGAs». Читерство ли это, однозначно да, сильное ли, ну вроде да, а вроде нет. Дальше прямо чуть ниже пишут следующие «We also decided to remove the WiFi / Bluetooth module as it was out of stock», что звучит, что у них не получалось и они упростили. Опять же я не считаю это прямо ужас‑ужас, но осадочек есть. Также они очень аккуратно, не говоря об этом прямо, написали, что выбрали проводник/зазор 2 mil вместо 3–3,5, которые мог бы сделать человек. LPDDR4 запустилась на чуть более низкой скорости 3 ГТ/с, а не 4,2 ГТ/с, но как бы тоже отлично. Что самое критичное — это невыдержанный импеданс. Импеданс одиночных линий на внешних слоях SOM вернулся с завода как 62 Ом вместо 50, то есть +24%. Quilter приняла это в допуске ±30%, что, переводя на русский, подгоняли как могли. Кроме того, при передаче в производство инженеры завода (Sierra Circuits) нашли 58 замечаний по двум платам. Почти треть из них (18) — недочёты документации, но среди остальных были и несоответствия посадочных мест и BOM.
Пятое — определение времени работы специалиста просто треш, тут тоже поподробнее. Я отдельно очень сильно выпал со следующего, что у них есть плата SOM, и их инструмент справился с задачей, со всеми «но», за 27 часов для двух плат, ну, допустим, что поровну разделилось время, и это на плату по 13,5 часов. Плюс к этому еще приведение платы в порядок специалисту понадобилось 26,5 часа, что вместе получается 40 часов (рабочая неделя). А теперь смотри, что по их предположению специалист бы ее разводил эту плату 190 часов (23,75 рабочих дня)! Вы меня извините, но, по‑моему, это полная фигня, при условии, что все уже разместили, мы сделали fanout в некоторых местах и большинство соединений — это от разъема довести по прямой дорожку. Вы сами зайдите, гляньте, но по мне так, ну, цифру времени я бы, ну, в два раза порезал, ну вот, честно. Да, 13,5 — это условная автономная история и работает 24/7, даже в этом случае, ну, цифры немного они с потолка взяли и натянули сову, сами знаете куда.
Шестое — это невозможно исправлять. Исходя из пункта два, я вам скажу честно, открыв проект в Altium и попытался внести корректировки, сымитировав, что какой‑то компонент вышел из производства или мы переделали корпус и что‑то надо подвинуть, я чуть в обморок не упал. Человеку править это дизайн очень сложно, особенно с моим желанием убрать всю корявость, которая только там осталась после «чистки» специалистом. Также вызывает вопросы, если этот же инструмент получит этот дизайн для корректировки, сколько у него займет это времени, есть понимание, что это займет в разы больше времени, чем специалист поправит дизайн за другим специалистом (не всегда, конечно).
Седьмое — цена, вот самое интересное. По заявлению CEO (декабрь 2025), они будут брать «примерно столько же, сколько вы заплатили бы человеку за пины», а причина выбрать Quilter — скорость, в 10 раз быстрее. На сайте цена сейчас считается за проект по числу непроложенных выводов на момент загрузки (то, что вы проложили вручную до загрузки, не тарифицируется), итерации без ограничений. Но конкретных цифр они не публикуют.
Итого, очень круто, но для стартапов, которые заказывали трассировку на стороне или небольших компаний, которые не могут держать большой штат. Потому что иначе пока, особенно с непонятной стоимостью, выглядит как странно. Надеюсь, ИИ головного ума не захлебнется до конца всех и разработчики САПР просто доделают автотрассировщик до приемлемого уровня, что реально сильно увеличит скорость разработки. Так что, кто брал фриланс на выходные, теперь, кроме индусов, вы будете соревноваться с ИИ и выиграть тут будет реально непросто.
И еще самое обидно в этом ускорении это то, что люди не знают, как разрабатывается электроника и какой там жизненный цикл. Если мы берем рынок СНГ и разработку среднего уровня и чуть выше, то самое долгое — это поставка комплектующих. Поэтому иногда важные комплектующие, заказанные после разработанной схемы, приходится от полугода до года! В данном случае тополог закончит за неделю или за две — не так критично, готовый макет вы раньше, чем придет комплектация, не получите. Так я еще не говорю, как работают ваши закупщики, которым служебку принесли неделю назад, а они еще не закупили. Да, в освободившееся время можно, например, заняться SI/PI, но тут нужны отдельные навыки и компетенции, я еще промолчу, что и за такой софт нужно отдельно заплатить, ну так‑то. Вы же все купили лицензии, да? В Европе и Америке ситуация, наверное, чуть лучше, но так как я никогда не выстраивал процессы там, скажу аккуратно, очень перспективно, если у вас не NDA.
Помощник в поиске чего-либо
Не в данном случае я вряд ли могу сказать хоть что‑то, что мне кажется плохим в данном использовании. Что я имею в виду под таким помощником — это не только «Найди мне информацию о чем‑то», но и помощник внутри любого интерфейса или программы. Как мне кажется, скоро использование многих программ сильно изменится, а особенно взаимодействие с ними. Уже много где ИИ заменяет документацию по использованию, превращая ее в чат, что иногда в разы удобнее. С таким подходом возможно, скоро некоторые типовые задачи ты должен будешь просто написать в чат, и ИИ сама сделает. Давайте сразу пример, так как в ADS, начиная с 2026, ИИ уже начинает встроен в Help и уже совсем скоро будет встроен в интерфейс, так что ты текстом можешь создавать анализ и корректировать их. Удобно ли это? Все, что связано с Help, очень, прям экономит часы поисков спрятанной в самом нелогичном месте кнопки. Возможно, даже скоро везде интерфейс можно будет с помощью встроенных ИИ переделать под свои процессы и ускорить тем самым работу, и это тоже будет огромным плюсом.
Что касается обычной документации, то это тоже безумно крутая вещь. К сожалению, сам не работал с этим, но у знакомых коллег была сделана внутренняя ИИ со всей документацией проекта, так что ты в любой момент мог спросить ее в чате вопрос, и она быстро бы дала ответ. Это, честно признаюсь, дико удобно, особенно, когда туда запихнули стандарты и тебе не надо перечитывать его полностью, чтобы узнать какую‑нибудь задержку. Как и у всего тут 2,5 большие проблемы. Если документации проекта, скажем мягко, «написаны не очень», то никакая ИИ не поможет, ну хоть убей. А вторая — это необходимо ее обучить, что вопрос совсем другого уровня, и эта задача, которую, ну, очень сложно сделать. Если кратко, то это все потому что любая модель обучалась на огромном массиве данных из разных источников: открытых материалов, лицензированного контента, данных, подготовленных людьми, и синтетических данных. И качество этих данных далеко не всегда одинаковое. Поэтому ее необходимо адаптировать под ваш процесс. Ну, не говоря уже о том, что необходимо инфраструктура, на которой будет расположен данный ИИ, это или облако, или офлайн, вариантов куча и всем этим надо заниматься.
Есть и ложка дегтя во всем этом, и это связано именно с данными, на которых обучался ИИ. Иногда при поиске той или иной информации через ИИ повсеместно натыкаюсь на такой бред, особенно в узконаправленных темах, все из‑за того, какой‑то индус написал лютый треш у себя в LinkedIn. Да, пару раз я натыкался, что ответ строился на моих «самых лучших» статьях, чему я рад, но лучше бы они на более проверенных источниках. И это тот вопрос, который максимально проблемный, потому что я точно знаю, что уже тысячи компаний пишут статьи низкого качества только для того, чтобы ИИ учился на них, а потом рекомендовал эти компании как экспертов из‑за «большой компетенции». Человек, который знает, как обойти фильтры ИИ и сделать так, чтобы на ваших статьях он писал текст, зарабатывает очень много, поверьте, там прям очень хорошо. Баг это или фича, каждый ответит по‑своему, но проблема есть однозначно. Крупные разработчики моделей проделывают большую работу по фильтрации и оценке качества данных, но полностью исключить низкокачественную информацию пока не получается. При этом для специализированных задач важен не столько общий объём информации, сколько наличие качественных, проверенных и профильных материалов. И именно с этим в узких инженерных областях пока есть проблемы.
Если подводить итог, то по мне так, на данный момент это один из лучших способов улучшить и ускорить работу, которым лично я пользуюсь каждый день. Думаю, когда выстроят систему верификации, которая сможет отбраковывать низкокачественный контент, тогда это будет лучшим инструментом с приходом ИИ.
Заполнение настроек проекта
Лучшая идея, которую я только видел, вот реально. Почему бы не обучить ИИ заполнять самостоятельно настройки проекта в зависимости от технологических возможностей тех или иных производств и монтажных ограничений. Круто? Круто, конечно, но опять же при чем тут ИИ?
Вот просто ответьте себе на вопрос, есть ли у вас сейчас своя условная табличка по каждому производству, с которым работаете, по технологическим возможностям, так, чтобы дать новому человеку и он сразу заполнил CES сам или проверил его? Я уверен, что нет и что вы по привычке смотрите на сайте или в проекте, который уже делали. Я уже не говорю о том, что эту табличку надо корректировать, потому что, уже отправив на завод, китайцы резко не могут делать то, что заявили. А по‑хорошему это 2–3 таких таблички, так как у одного поставщика несколько заводов, несколько вариантов производства (подешевле и подороже), по срокам тоже есть варианты. Так вот с чего волшебный ИИ сможет это сделать за вас? Да, он может помочь, и ускорить процесс, но если вы никогда не хотели это оптимизировать, то как ИИ поможет вам обрести это мировоззрение, если так можно сказать? От того, что вы здесь и сейчас что‑то попытались оптимизировать и это помогло, но без контроля, доработок, дальнейшей оптимизации и согласование этого с уже действующими процессами ваши действия могут только сломать текущий процесс, без внедрение нового.
Поймите правильно, я очень за, чтобы автоматизировать и ускорить для себя лично, но никогда это выходит в компанию. Я сам делал уже десятки автоматизаций с помощью ИИ, какими‑то перестал пользоваться после создания, какими‑то пользуюсь и по сей день. Но тут есть большая разница, потому что я сделал еще больше внутри компании сам, используя только свои знания и умения, без всяких ИИ. То, что ИИ почти полностью убрал барьер входа в любую профессию, это почти точно, и спорить здесь однозначно глупо. Но, кроме того, что надо придумать фичу, ее надо внедрить, и тут скажу по своему опыту, если у вас больше 3 человек в отделе/компании, это сложно. Потому что ИИ может и сможет автоматизировать, но выстраивать коммуникацию и уметь договариваться с живым человеком, который все еще работает, он не сможет. Я вам больше скажу, ИИ в данном случае сделает хуже. Вы придумаете оптимизацию, подготовите презентацию, расскажете, как вы его будете внедрять, все это, естественно, с помощью ИИ, которая скажет, что это лучшие, что придумало человечество, а потом другой человек скинет в другой ИИ, и он скажет, что это ужасно, это только затормозит процесс и вы самый гений, что решили не принимать эту оптимизацию. И это уже началось, любое согласование превращается в «мне тут ИИ сказал», и начинается спор между ИИ на недели и месяцы. И тут встает вопрос, решение в итоге принимаешь ты или ИИ, и если ИИ, зачем тогда ты? Считаешь ли он лучше, чем другой живой специалист? Если да, почему ты работаешь в компании, где тебя окружают низкоуровневые специалисты? А ты сам хороший специалист?
Да, понимаю, изначально тезис другой был, и если дать четкий ответ по нему, то пока, как мне видится, заполнение CES и настроек с помощью ИИ достаточно бессмысленно. Эта задача единоразовая, написать настройки в формате, котором необходимо САПР и который можно ему куда‑то как‑то заложить внутрь. Да и тут ИИ поможет вас 100% и написать настройки и поможет понять, как их заложить в проект, но сколько вы всего сломаете перед этим, вопрос отличный.
Итог
Верю ли я в то, что нас всех заменит ИИ? Наверное, да, вопрос — когда. То, что я наблюдаю сейчас, говорит о том, что хоть и рынок будет меняться, но скорость изменений точно не будет таким колоссальным, что те, кто хотят, не смогут приспособиться под рынок. А разница между специалистом, который пользуется ИИ и нет, в ближайшие лет 10, будет все еще менее важной, чем опыт и личные знания.
Единственное, что я могу сказать точно, — мы входим в эру кривых дизайнов. Раньше я и многие мои коллеги смеялись над кривым и корявым рисунком некоторых публичных проектов, сейчас же ИИ вводит это в норму, оно ведь работает. И это же реально так, тут невозможно спорить. Мне все еще интересно, как ИИ сам будет это потом корректировать это, хотя, возможно, для него будет быстрее с нуля все развести, чтобы не разбирать закорючки прошлых моделей. Но, если ИИ не сможет забрать сложные задачи и его потолком будет только средние проекты, мы можем столкнуться с тем, что сейчас переживает рынок программистов. ИИ забирает простые задачи, на которые обычно сажали молодых специалистов и развивали вверх, и получается, что новых специалистов не появляется, потому что ИИ может сделать это лучше и дешевле чем джун. Ну и как мы понимаем, что без джунов не появится мидлов и так далее, хотя, наверное, это временная проблема. Но в любом случае мы только в начале интересного пути.
В завершении лишь еще раз скажу, что я за ИИ и подобные штуки. Я сам пользуюсь им почти каждый день в работе, но отнюдь не самыми популярными вещами. Но меня немного пугают люди, которые пытаются компенсировать отсутствие знания и опыт, мимолетным ИИ, а особенно которые заявляют, что с помощью ИИ могут выполнить все и заменить всех. Но меня также пугают люди, которые в целом могли внедрить некоторые инструменты к себе в работу, но так этого и не сделали, потому что это «пузырь» или что‑то такое. Как и всегда, новые технологии — это хорошо, но не надо забывать, что знания в ИИ не заменят вам знаний в вашей области, и каким бы он ни был крутым, если вы суперкрутой специалист, он вас никогда не заменит, ну, как минимум, в перспективе ближайших лет. И чем круче вы будете, тем дольше вы будете нужны это миру. Поэтому желаю всем стать самыми востребованными и не прекращайте развиваться, а себе желаю не огрести кучу хейта за все написанное.

Комментарии 0