Независимые как понятия, зависимые как операции: параметры семплирования в LLM-инференсе
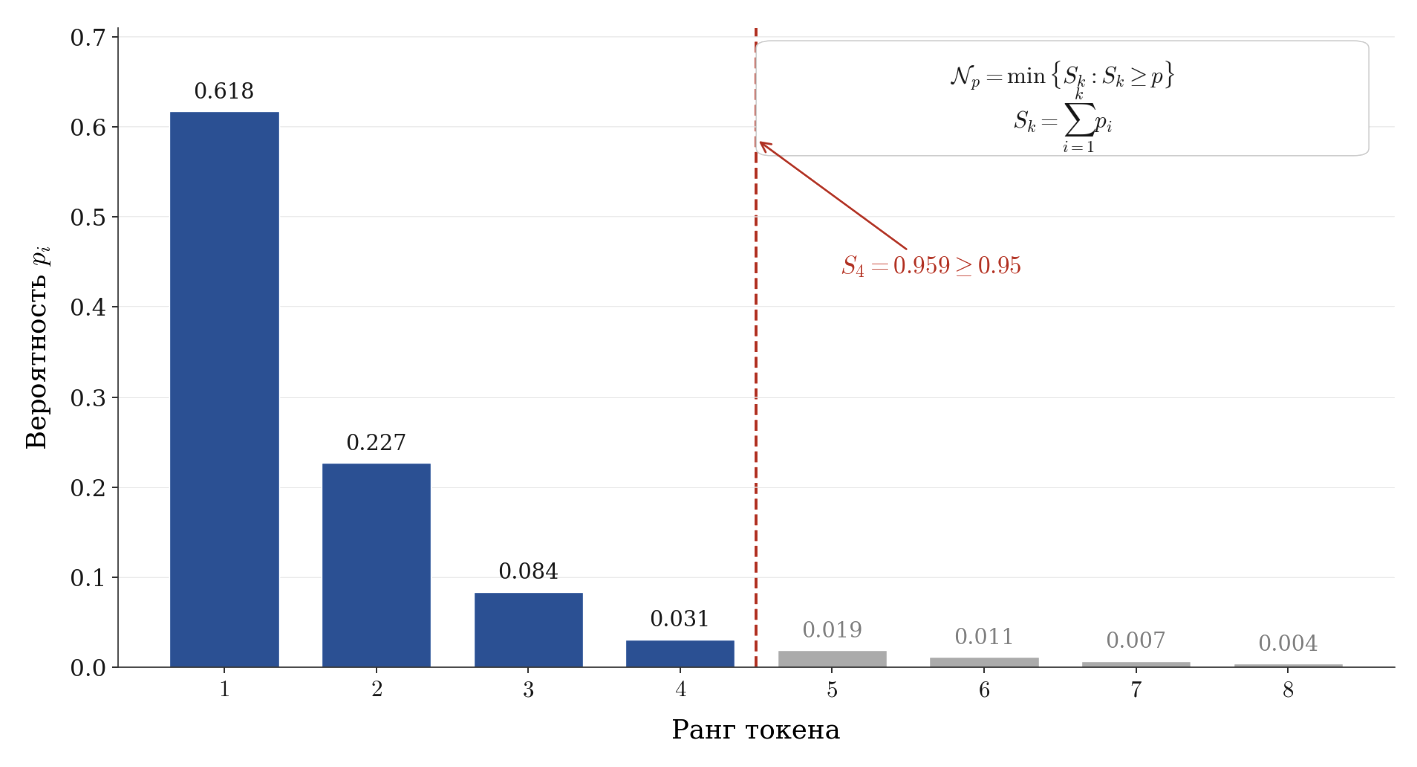
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг…
Найдено: 3 материала
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг…
Читаю очередную волну возмущения. Владельцы сайтов, художники, музыканты, фотографы — все те, кого объединяет емкое слово «криэйторы», — требуют…
Сейсмографы зарегистрировали десятки подземных толчков