Контекст
Проект “Гусь” обречён на холивар. Шутка ли: ИИ написал язык программирования, который быстрее C++ и Rust. Холивар – это в основном про зрелища, и так ясно, who is whoosh. Однако на полях сражений в виде “хлеба” остаются поучительные артефакты, парочку из которых предлагаю рассмотреть.
Узнав про Гуся, я заинтересовался, как эта штука работает. Интересовала именно архитектура, т.е. ключевые компоненты, лежащие в основе системы, и их взаимосвязи. Свой взгляд на гусиную архитектуру я довольно нудно изложил в статье "Ты не бойся, это Goose". В комментариях коллега по цеху @nin-jin оставил “артефакт”, сопроводив его лаконичным “я просто оставлю это здесь”. Т.е. как бы, а вот, тут пишут… автор, разберись.
Разбираю.
Артефакт
В двух роликах MrTeamlead последовательно и эффектно рвёт этого самого Гуся. Во втором, сказав “смотрите за руками”, он берёт бенчмарк records_fixed.goose, в котором Goose выигрывает у records.rs по памяти в 1,8 раза, по скорости в 1,9 раза, и показывает, как заблейзить Rust-версию в 6,7 раза (с распараллеливанием). Исходные (Goose repository) бенчи по records.
Невероятно? Невероятно.
Допустим, всё так и есть, как утверждает ув. MrTeamlead. Т.е. ИИ написал для бенчмарка говнокод на Rust, который а) проигрывает Гусю и б) поддаётся оптимизации до невероятных результатов. Чтобы прокачать свои способности для создания таких оптимизаций, можно записаться на курсы.
Что из этого следует? Что для AI-driven development, особенно в изводе “vibe coding”, Goose подходит лучше, чем Rust. Ибо код получается быстрым, безопасным, легко читаемым (тут на любителя) и курсы не надо заканчивать. А на review в большинстве случаев времени не будет особо.
Есть, однако, кейсы, где надо быстро и экономно по памяти, и при этом “за ценой не постоим”. Здесь we need to go deeper и need посмотреть, как работает Гусь. Три картинки.
Гусь в разрезе
Картинка номер раз. Для работы с памятью Гусь использует структуры, которые называются data stacks. Их количество вычисляется на этапе компиляции.
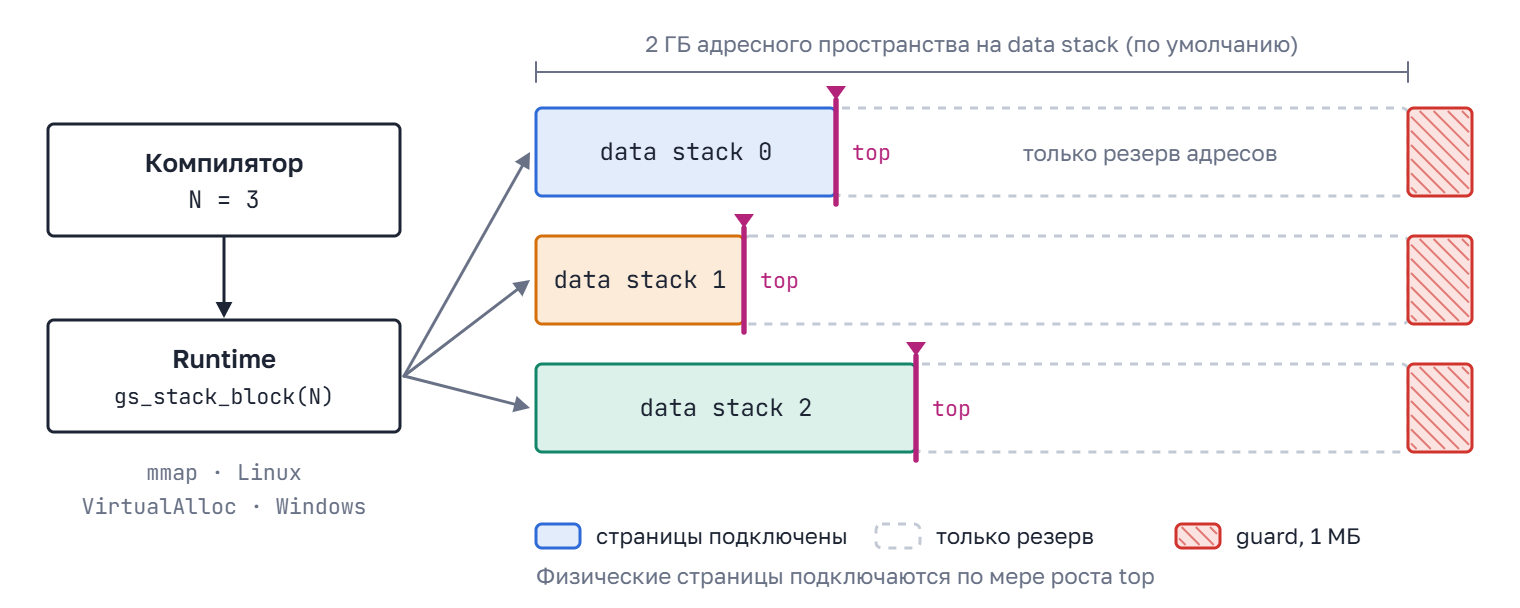
Тут надо обратить внимание, что:
Это НЕ стеки вызовов: в них нет кадров функций, только данные. Но освобождаются они как стек – при выходе из области видимости вершина просто сдвигается назад.
Память резервируется, но не подключается сразу к процессу (ленивая аллокация).
Картинка номер два. Структуры data stacks распределяются между функциями на этапе компиляции.
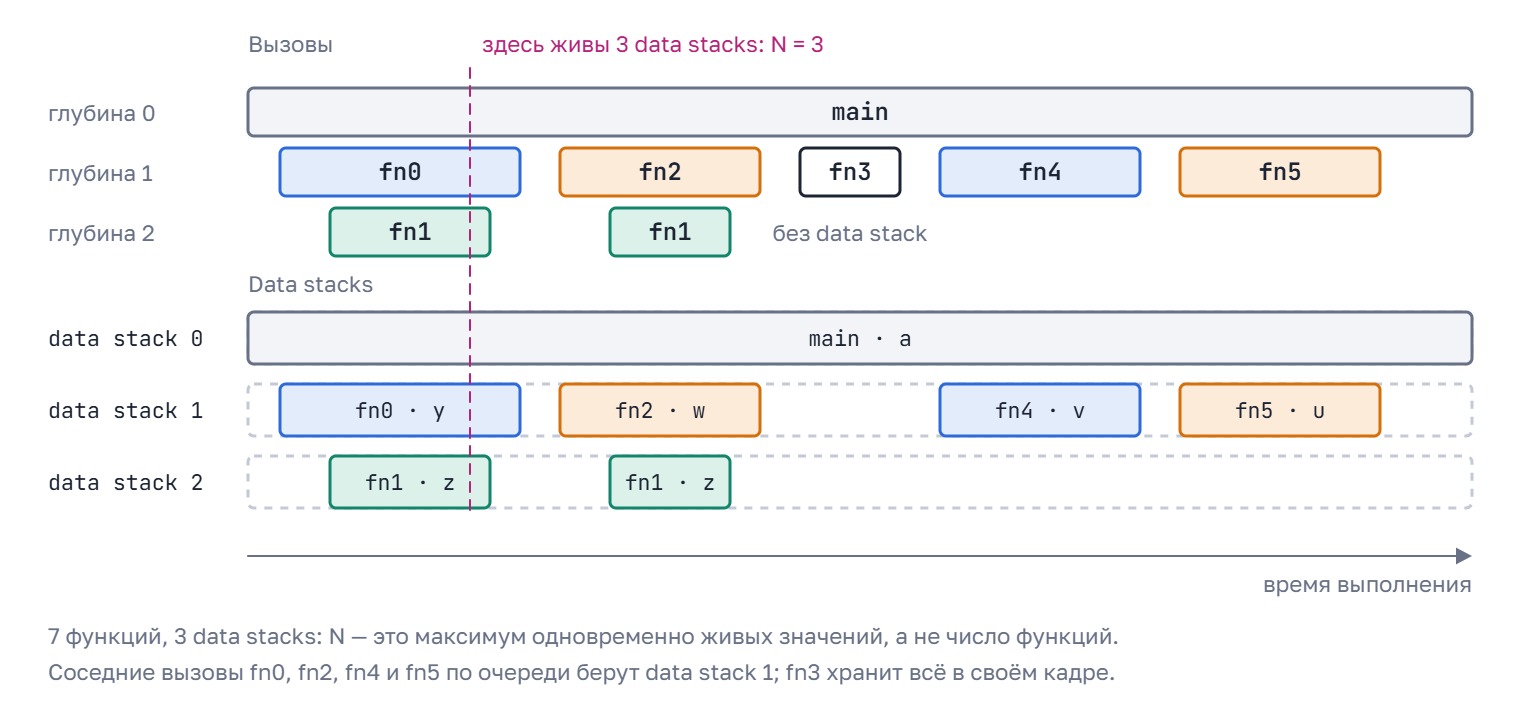
Семь функций, три data stacks. Количество data stacks компилятор считает по самой глубокой цепочке вызовов в программе, причём учитываются только функции, которые держат растущие массивы: N – это максимум таких массивов, живых одновременно. Во время работы новые data stacks не появляются. Отдельный data stack нужен каждому растущему массиву, пока он жив, т.е. если функция создаёт несколько растущих массивов, у каждого из них будет свой data stack. Когда функция завершается, её data stacks достаются следующим вызовам: на картинке fn0, fn2, fn4 и fn5 по очереди берут data stack 1.
Такой подход, конечно, накладывает ограничения на рекурсивные функции: в момент рекурсивного вызова у функции не должно быть живых растущих массивов, иначе каждому уровню рекурсии понадобился бы свой data stack. Всё, что должно пережить вызов, создаётся снаружи и передаётся внутрь по ссылке.
Картинка номер три. Упаковка данных.
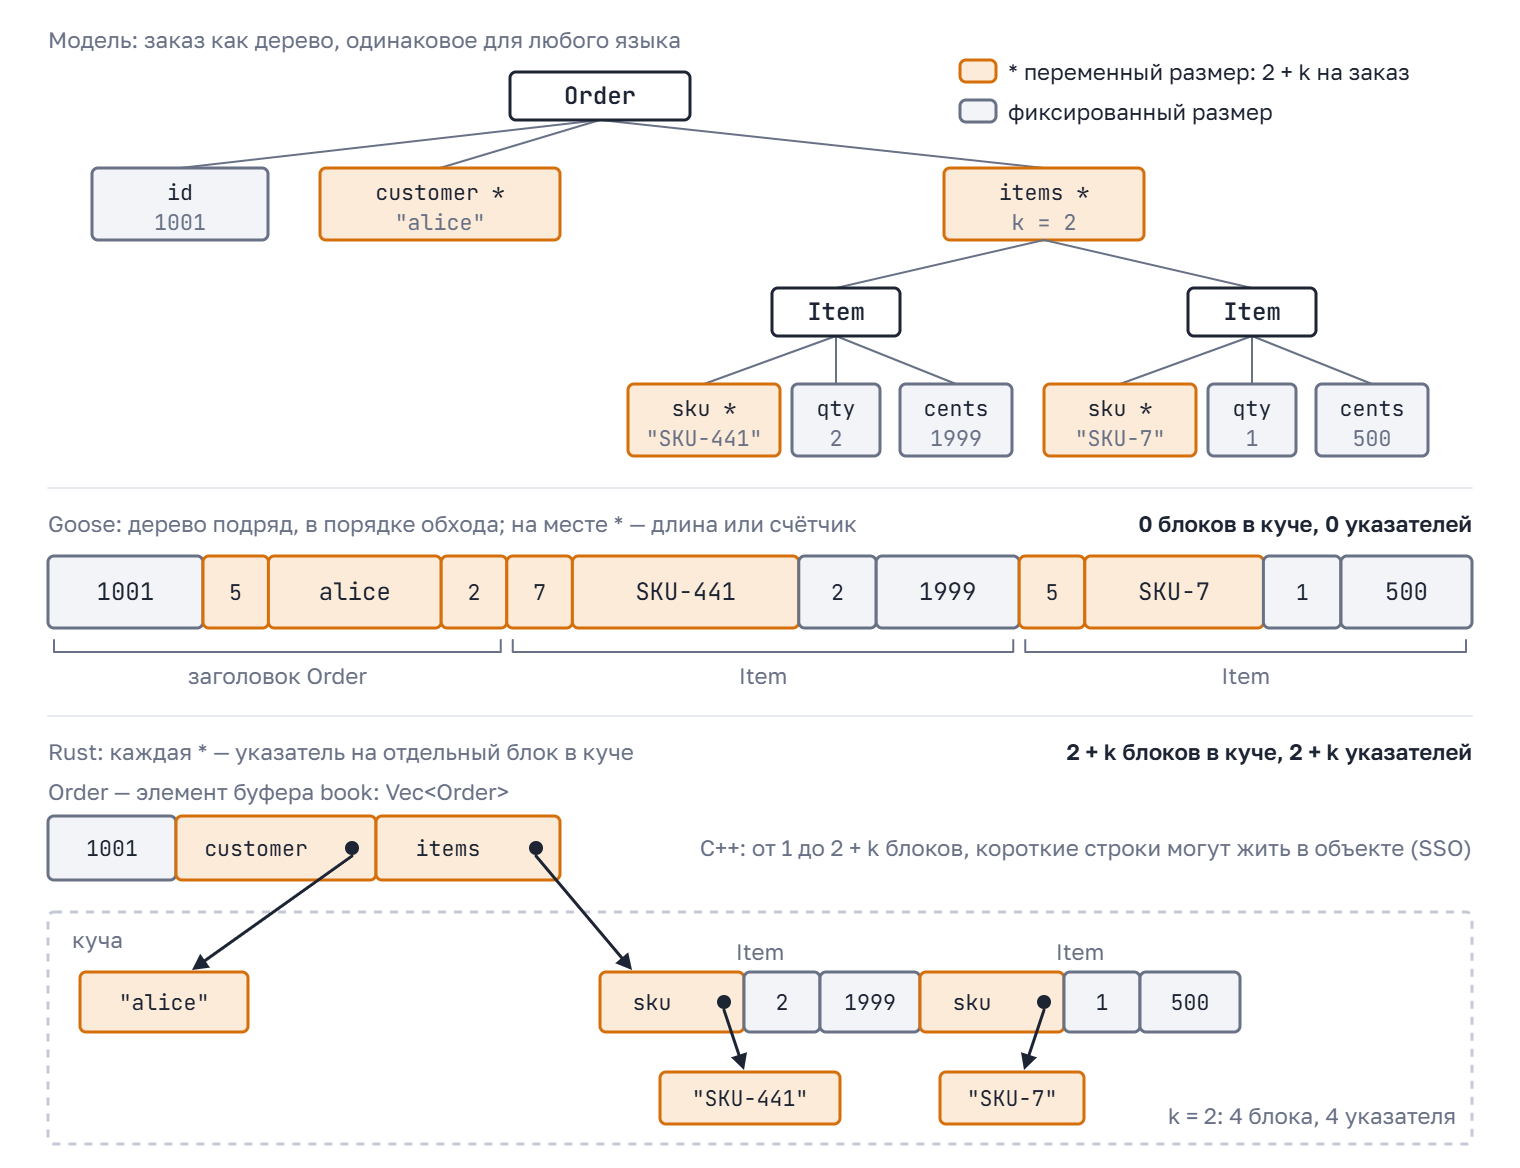
Вот такая структура:
struct Item  { sku: u8[varint], qty: varint, cents: varint }
struct Order { id: varint, customer: u8[varint], items: Item[varint] }
Заполняется такими данными:
{
  "id": 1001,
  "customer": "alice",
  "items": [
    { "sku": "SKU-441", "qty": 2, "cents": 1999 },
    { "sku": "SKU-7", "qty": 1, "cents": 500 }
  ]
}
Результат (в моём форке на GitHub):
Язык | Байт на заказ | Выделений в куче |
|---|---|---|
Goose | 29 | 0 |
C++ | 160 | 1 |
Rust | 233 / 153 | 4 |
Для Rust 233 байта получается, если собрать товары через collect (вектор с запасом на 4 элемента), 153 – если подогнать ёмкость точно под 2 элемента (shrink_to_fit()), как в таблице туториала.
Who is whoosh?
Итак, значения в Гусе не живут в куче и сложные структуры укладываются по возможности последовательно.
Можно ли в C сделать так же? Конечно. У Гуся же транспайлер, вот исходник на Goose (сделано order.goose.rs, чтобы GitHub подсвечивал синтаксис), вот его аналог на C. Смотреть можно, менять опасно.
Поскольку значения не живут в куче, Гусь уже сейчас быстрее языков с “кучей” там, где много выделений памяти и работа производится в одном потоке.
Полное “доминирование” пока частично потенция, а не кинетика. Чтобы сравняться с другими языками по способностям именно к вычислениям, нужно реализовать ряд фич, например параллельные циклы по потокам (par for) и векторизацию циклов (simd for):
The question […] is how a Goose program can split work over a large array across cores without copying the array […]. The second question is how such threads combine with the SIMD-level
par for[…]Child threads: fork-join over shared memory inside one program, and how it meets par for
Для масштаба: Гусю меньше трёх месяцев (репозиторий появился в августе 2026-го), а Rust шёл до rayon пять с половиной лет, с июня 2010-го до декабря 2015-го.
Смотрим за руками
Я совершенно согласен с MrTeamlead, что бенчи у Гуся заточены именно на то, чтобы продемонстрировать преимущество Гуся в сценариях с интенсивным использованием памяти и минимальными вычислениями. С этой точки зрения никакого смысла оптимизировать измеряемый код в бенчмарках нет.
Но посмотрим. Опять в моём форке Goose.
Изменение 1. Было Vec::new(), стало Vec::with_capacity(N as usize).
Ну, такое. Бенч моделирует ситуацию – на нас валится поток событий, мы их собираем и обрабатываем. Сколько событий – мы не знаем заранее. N – это параметр бенчмарка (500 000 у автора, 2 000 000 в видео), и для кода, который тестируется, это число, по идее, неизвестно.
Изменение 2. Был String, стал MyString. В данном случае, кстати, сравнительная оптимизация оправдана, ибо аналог в Гусе, records_fixed.goose тоже использует фиксированный размер.
Комментарий к records_fixed.goose гласит:
// The same event log in fixed mode, which is the only mode Rust and C++ can
// express.
То есть это якобы то, как те же события хранил бы Rust. Но в records.rs текст лежит в куче (String), а в records_fixed.goose – прямо внутри события (до 15 символов). Раскладки разные, и сравнивать их напрямую нечестно. Когда MrTeamlead кладёт текст в Rust так же, внутрь события, разница исчезает: 46,7 против 46,5 мс в видео. По сути, он и написал недостающий records_fixed.rs.
Однако у Гуся есть ещё один бенч, records_var.goose, и вот тут уже нет смысла (в рамках бенчмарка) делать фиксированный размер. A word of 4…15 letters – это параметр генерации данных для бенчмарка, а не заранее известный для обрабатывающего кода размер строки. И records.rs – нормальная пара для него, которая иллюстрирует тип кейсов, в которых Goose хорош.
К слову, пока писал статью, обнаружил, что автору Гуся рассказали про критический разбор. Автор ответил, что records_fixed.goose был лишь иллюстрацией, а настоящий бенчмарк – records_var.goose, и убрал records_fixed.goose из репозитория…
Заключение
Рассмотренные артефакты неплохо показывают возможности по оптимизации программ на Rust, но никак не умаляют преимущества (частично потенциального) Goose в ситуациях, которые моделируют бенчмарки Goose.
Несколько лет назад Goose был бы просто прикольным пет-проектом, для развития которого потребовались бы годы. Сейчас ситуация иная. Наш CEO мне как-то сказал: вот, мол, пользуюсь Orca для трекинга документов по бизнесу. Посмотрел я на эту Орку… Старт в марте 2026, почти 17 тысяч коммитов, более шести миллионов строк кода (с тестами)… Так что чёрные гуси-лебеди возможны как никогда. Фундаментальные проблемы Гуся, впрочем, остаются, и их никто не отменял.


Комментарии 0