Вайб-кодинг хорош для прототипов, но кодом, за работу которого в проде кто-то отвечает, нужно владеть — а для этого его, как минимум, необходимо прочитать и понять.
Проблема в том, что читать сгенерированный код заметно тяжелее, чем код коллег. А ещё — его больше. Намного больше. Поэтому я сейчас пробую комбинированный подход из двух частей:
Часть кода явно объявить непроверенной и изолировать, как сторонние зависимости.
От остального кода требовать, чтобы ИИ писал его так, как написал бы я сам, и ревьювить его в определённом порядке.
Этот подход снижает сложность ревью сгенерированного кода до привычной сложности ревью собственного кода перед коммитом.
Я уже использую его на своих проектах, хотя часть идей проверена всего на одном, а в конце статьи есть список пока нерешённых проблем.
Вайб-кодинг работает, пока ошибка дешёвая
Под вайб-кодингом я понимаю генерацию, при которой код принимают не читая.
Этого достаточно, когда цена ошибки невелика или ошибку легко заметить и исправить, а долго поддерживать и развивать код никто не собирается. Прототипы и одноразовые скрипты обычно попадают в эту категорию, но не всегда: прототип частенько становится продом; одноразовый скрипт, который чистит ненужные данные в базе прода…
Если за код нужно отвечать, то кто-то должен его понимать: объяснить причину сбоя, быстро его починить и сделать так, чтобы он не повторился. Без полноценного ревью такого человека в проекте нет.
За сгенерированным кодом нет ментальной модели решения
Большинство претензий к ИИ-коду относится и к коду людей: они тоже правят код за пределами задачи, обкладывают его защитными проверками и добавляют фичи, о которых никто не просил. Но код человека отражает ментальную модель автора, и ревьювер сверяет её с задачей. Сгенерированный код правдоподобен фрагмент за фрагментом, но цельной модели решения за ним может не оказаться, и тогда ревьювер мучительно пытается понять то, чего нет. Отсюда и раздутый объём: без цельной идеи агент не находит минимальное решение. По той же причине ИИ-ревью не заменяет ревью человеком: оно находит баги в реализации функциональных требований, но модели решения и понимания компромиссов по нефункциональным требованиям у него тоже нет.
Зато у ИИ есть свойство, которого нет у коллег: переделка почти ничего не стоит. Сказать коллеге “перепиши целиком” дорого, и социально это не всегда приемлемо. Агент в той же сессии переделает код за несколько минут и не обидится. На этом свойстве держится половина подхода.
Подход для тех, кто сам генерирует и сам ревьювит
Всё, что ниже, относится к ситуации, когда код генерирует и ревьювит один и тот же человек.
Цель ревью — вернуть себе владение сгенерированным кодом. После такого ревью коллеги в PR читают уже мой код. Если же я открою PR, не прочитав или не поняв код, то я просто переложу ревью нейрослопа на коллегу, и его раздражение будет вполне оправдано, а в худшем случае он поставит LGTM не читая.
Часть кода можно не ревьювить, если явно это обозначить
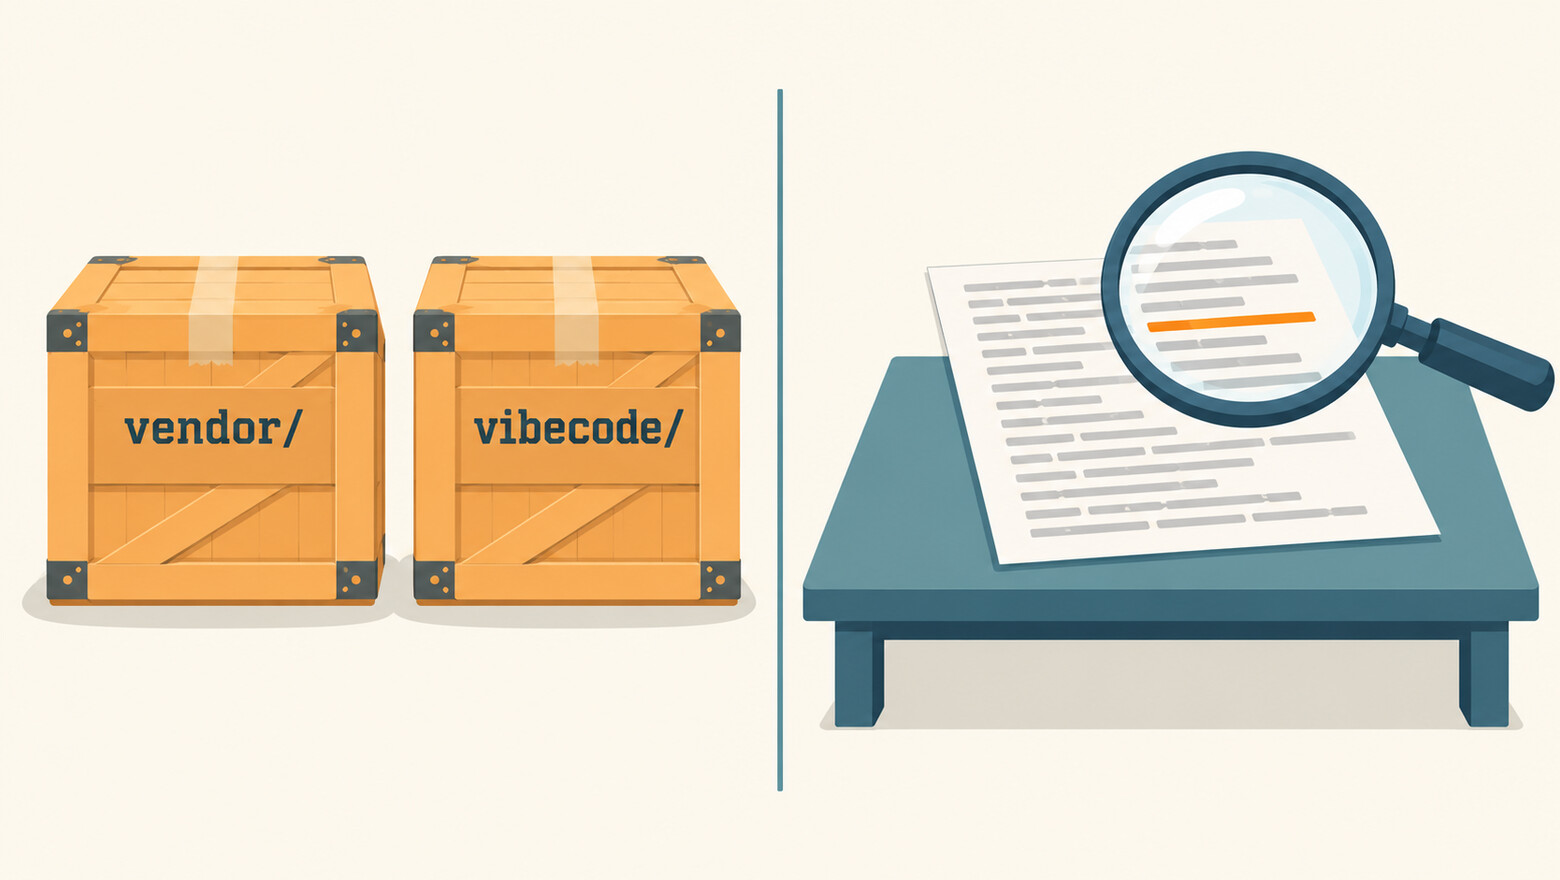
В любом проекте всегда был код, который никто из команды не читал: сторонние зависимости, vendor/, 3rd-party/. Никто не делает вид, что их отревьювили, а практика работы с ними давно отработана: от багрепорта автору до замены зависимости.
Сгенерированный код можно поделить на две зоны похожим образом. Код вне каталога vibecode/ проходит полноценное ревью (тесты — поверхностное), а код внутри vibecode/ никто не ревьювит и не должен. vibecode/ ближе по смыслу к vendor/: это сторонний код, просто сторонний автор — ИИ. У такой “сторонней” зависимости нет других пользователей, проверки временем и репутации автора. Зато её можно покрыть тестами под свои сценарии, а автор чинит баги за минуты.
Кандидатов в vibecode/ я ищу ещё при постановке задачи. Каждая часть функционала, ушедшая туда, — это код, который не придётся читать, поэтому чем больше таких частей, тем дешевле ревью.
Для этой зоны у меня следующие правила:
Туда попадает код, который некритичен для проекта, не имеет нефункциональных требований и баги которого можно исправлять без ревью — промптом “поправь баг” или полной перегенерацией.
Код изолирован за интерфейсом. Это главное условие: по интерфейсу видно, что код получает и что отдаёт, а значит, можно оценить, насколько он действительно некритичен.
Интерфейс должен быть как можно проще. Код снаружи зоны проходит ревью, и пользоваться интерфейсом он должен правильно. Если семантика интерфейса понятна из сигнатур и имён, то это можно проверить, не заглядывая в реализацию. Сложный интерфейс с состояниями и неочевидным порядком вызовов требует знать реализацию, и проверенный код начинает опираться на непроверенный.
Все правила проекта действуют как обычно: линтеры, тесты, конвенции. Отличие только одно — нет ревью человеком.
Правила зоны записаны в
AGENTS.md, в том числе то, что код изvibecode/не служит образцом. Агенты охотно копируют существующие паттерны, и без такой оговорки непроверенные решения расползутся по проекту.Собственным тестам зоны я не доверяю: их писал тот же агент, и никто их не смотрел. Поэтому снаружи зоны лежит минимум тестов на основные сценарии использования, и вот они проходят ревью.
Код попадает в зону и покидает её перемещением каталога, поэтому статус ревью всегда виден по пути. Покидает он её, когда задача меняется так, что код становится критичным или у него появляются нефункциональные требования. Тогда я делаю ему ревью и выношу наружу, как забирают к себе код сторонней зависимости.
Многие нефункциональные требования приходят вместе с вводом-выводом: работой с файлами, сетью, базой, процессами. Поэтому я стараюсь, чтобы у кода зоны не было собственного ввода-вывода: с внешним миром он если и работает, то только через интерфейсы, которые ему передаёт проверенный код снаружи. Тайм-ауты, повторы, транзакции и обработка ошибок настоящего ресурса остаются в реализациях этих интерфейсов, а они проходят ревью. Это пока гипотеза: насколько она выдерживает реальные задачи, я ещё проверяю.
Первым кандидатом у меня стал пакет tomlmerge в репозитории моих шаблонов Copier. Он делает трёхстороннее слияние TOML-файлов по таблицам и ключам: когда шаблон меняется, проекты получают его правки в mise.toml без конфликтов там, где git видит только сдвинутые строки. Это около 1800 строк кода и 1400 строк собственных тестов. Под критерии он подходит:
Основная задача репозитория — обновлять проекты из шаблонов, а слияние TOML в ней лишь вспомогательный шаг.
Если tomlmerge падает (в том числе на собственных самопроверках: невалидный TOML, потерянные строки), то в файле остаются конфликты от Copier, и я разрешаю их руками, как до появления tomlmerge.
Синтаксически верный, но неправильный результат с высокой вероятностью уронит тесты/CI.
Интерфейс — конструктор с конфигом, метод
Merge(ours, base, theirs)и несколько ошибок.
Пакет появился раньше этого подхода, поэтому в зону я перенёс его уже готовым: переместил каталог, поправил пути импорта, добавил снаружи четыре сценария и правила линтера для импортов. И, скажу честно, мне — полегчало. Потому что несколько дней до этого я собирался с духом, чтобы сделать ему ревью, и так и не собрался.
Правила зоны в AGENTS.md репозитория выглядят так:
### Unreviewed code

`**/vibecode/` holds code which no human reviews, like a vendored dependency.

- All rules of the project (linters, tests, conventions) apply to it.
- Don't use its code as an example for code outside it.
- Prefer code without I/O of its own where the task allows:
  it reaches files, network and processes only through interfaces passed by reviewed code,
  because I/O brings non-functional requirements, which need a review.
  Rules `vibecode*` of depguard in `.golangci.yml` show how well it works in practice;
  ask the owner before allowing a denied import by an exclusion.
- Tests in `**/vibecodetest/` check it from outside: main scenarios.
  The owner reviews them like any code outside `vibecode/`.
Существующая маркировка ИИ-кода отвечает на вопрос “кто написал”
Прежде чем придумывать свою маркировку, я поискал готовую. Общепринятого способа пометить каталог как непроверенный нет. Зато есть другое:
трейлеры коммитов вроде
Assisted-by:илиCo-authored-by:, который агенты ставят сами;бейджи для проекта целиком вроде vibecoded.fyi;
построчное происхождение кода в git-ai.
Всё это маркирует авторство, а для ответственности важен статус ревью. Сгенерированный код, который я прочитал, понял и принял, принципиально не отличается от моего собственного. Непрочитанный код рискован, кто бы его ни написал (напр. давно уволенный сотрудник).
Проект, целиком написанный вайб-кодингом, можно целиком положить в vibecode/: в отличие от бейджа, путь импорта предупредит и тех, кто будет его сопровождать, и тех, кто захочет его использовать.
Немного ближе к моей идее подход Monadical: человек пишет пакеты с интерфейсами, типами и ключевыми тестами, а реализацию генерирует ИИ. Предполагается, что намерение автора хранится в контрактах, поэтому реализацию можно смело перегенерировать. Но, на мой взгляд, это аналог/продолжение spec-driven development, с теми же недостатками: нефункциональные требования интерфейсом не выразишь, и код всё равно приходится читать.
В Go граница зоны — это пакет
Для маркировки зоны я рассматриваю только каталоги, а не суффиксы в именах файлов или комментарии, потому что граница должна быть настоящей.
В Go каталог — это пакет, и экспортированный API пакета естественным образом становится интерфейсом зоны. Путь импорта содержит vibecode/, поэтому статус кода виден в каждом импорте. Скрипты репозитория с шаблонами — отдельный Go-модуль, и после переноса он устроен так:
scripts/
├── go.mod
├── internal/
│   ├── vibecode/
│   │   └── tomlmerge/    ← не ревьювится
│   └── vibecodetest/     ← внешние тесты зоны, проходят ревью
└── tomlmerge/            ← программа, которая использует пакет, проходит ревью
Правило 8 частично проверяет линтер
Граница функционала вайб-кода отчасти видна по его импортам. Собственный ввод-вывод в Go почти всегда требует импорта: os для файлов и процессов, net для сети, database/sql для базы, syscall и unsafe для всего остального. Сторонние зависимости тоже стоит держать под контролем: новый модуль виден в diff go.mod, а пакет из модуля, который проект уже использует, — нет. Следить за этим помогают два правила линтера depguard в .golangci.yml:
vibecode:
  list-mode: strict
  files:
    - '**/vibecode/**'
    - '!$test'
  allow:
    - $gostd
    - github.com/OWNER/REPO/internal/vibecode/
    - github.com/pelletier/go-toml/v2
vibecode-no-io:
  list-mode: lax # A longer allowed entry wins over a denied one.
  files:
    - '**/vibecode/**'
    - '!$test'
  deny:
    - pkg: database
    - pkg: log/syslog
    - pkg: net
    - pkg: os
    - pkg: plugin
    - pkg: runtime
    - pkg: syscall
    - pkg: unsafe
  allow:
    - net/netip$
    - net/url$
Записи в списках — префиксы, $ на конце означает точное совпадение. Правила проверяются независимо, и импорт должен пройти оба. Первое разрешает стандартную библиотеку и только перечисленные сторонние пакеты. Второе вычёркивает из стандартной библиотеки пакеты с прямым доступом к внешнему миру, кроме net/url и net/netip (это просто разбор строк). Тесты зоны ни одно правило не проверяет. io/fs, context, sync, time и log/slog я не запрещаю: их значения приходят в код зоны снаружи, а синхронизация и логирование нужны многим алгоритмам. А вот database/sql запрещён: вместо *sql.DB зона объявляет свой узкий интерфейс вроде “найти пользователя”, и его реализует проверенный код снаружи.
Если агент добавит в зону импорт net/http или драйвера базы данных, то линтер упадёт. Запрет при этом не жёсткий. Неожиданный импорт значит, что код сам полез во внешний мир: скорее всего, он решает не ту задачу или не тем способом, и к нему появились нефункциональные требования. Тогда я смотрю, нельзя ли вынести ввод-вывод в проверенный код снаружи. Если нельзя, то либо разрешаю импорт исключением в конфиге, либо забираю код из зоны. Исключение мимо меня не пройдёт: правка конфига попадёт в diff, который я прочитаю.
Часть нефункциональных требований протекает и через интерфейс: код зоны может, например, делать N+1 запросов к базе. Импорты этого не покажут, как и расход CPU и памяти.
Остальной код я открываю, только когда знаю, каким он должен быть
Ревью кода вне vibecode/ начинается до того, как я открою diff. Сначала я представляю, что код должен делать и как примерно выглядеть. Моя модель приблизительная и строится быстро: это набор опорных точек, которые решение обязано учесть, — от примерного алгоритма до вероятных багов и компромиссов по нефункциональным требованиям. Сюда же входит всё то, что “и так все (кроме ИИ) знают”.
А дальше я требую, чтобы код совпадал с этой моделью, то есть был написан так, как написал бы его я в этом проекте с этой командой.
Код, устроенный так, как написал бы его сам ревьювер, проверяется сверкой с ожиданием: знакомые решения узнаются сразу, и внимание уходит только на отклонения. Код, устроенный иначе, приходится понимать с нуля, даже если он верен. В первом случае усилие растёт с числом идей в решении, во втором — с объёмом кода. От коллеги писать “как написал бы я” не потребуешь, а от агента можно, потому что переделка дешёвая. Мой вариант не обязательно лучший, но задача ревью здесь — не найти лучшее решение, а вернуть себе владение кодом.
Конечно, граница между тем, что действительно мешает ревью, и вкусовыми придирками тонкая, а перегиб в сторону придирок легко превратит ревью в бесконечное переписывание. Поэтому критерий у меня один: мешает ли это комфортно читать код. Если мешает, то я прошу переделать или правлю сам, когда так быстрее (например при переименовании переменной).
Читаю я сверху вниз: сначала интерфейсы, потом реализацию. Правка интерфейса переделывает всё, что под ним, а правка деталей внизу обычно не трогает код выше. Поэтому после очередной переделки перечитывать уже проверенное почти не приходится, а те изменения, что всё же появляются, обычно тривиальны.
На первом расхождении с моделью, которое мешает ревью, я останавливаюсь. Исправление обычно перестраивает код ниже, и читать его дальше бессмысленно. Расхождение снимается одним из трёх способов: либо агент объясняет, почему код верен, и я корректирую своё представление о решении; либо агент переделывает эту часть под моё описание того, что я тут ожидал увидеть; либо я правлю сам, если так быстрее. Объяснение агента может оказаться ошибочным, но так же может ошибаться и автор PR, а принять его объяснение или нет — решение ревьювера. Мелкие расхождения, которые читать не мешают, я собираю пачкой или игнорирую.
Пример: BootstrapHandler на 500 строкСвежий пример — BootstrapHandler в моей библиотеке slogx для log/slog. Задача у него скромная: придержать несколько записей лога, пока CLI разбирает os.Args и ещё не знает, куда и с каким уровнем писать, а потом передать их настоящему обработчику.
Агент написал файл на ~500 строк, что с ходу вызвало подозрения, потому что самый большой из остальных обработчиков в библиотеке занимал ~300 строк, а текущая задача настолько сложной не выглядела. На первом же экране стояли две константы, minStartupCompactAt и startupCompactFactor, — хороший пример того, что я совершенно не ожидал увидеть в этом коде. Оказалось, что агент завёл реестр производных обработчиков на weak-указателях и адаптивную компактификацию этого реестра. Обработчику, который живёт, пока стартует программа, такой алгоритм в моей модели решения был не нужен, и дальше констант я читать не стал.
Вместо изучения чужого алгоритма я описал агенту, что ожидал увидеть, и он переписал всё, используя мой подход. Кода в итоге стало меньше, хотя функционала к этому моменту прибавилось. Но гораздо важнее то, что он стал намного ближе к тому, что я представлял себе с самого начала, и сейчас я воспринимаю этот код как свой.
Большой набор изменений я прошу разбить на логически цельные части, а механические изменения (переименования, перемещения) отделить от смысловых. Каждую часть можно проверить целиком, а механическую обычно достаточно бегло просмотреть. Человека о таком разбиении просить не всегда удобно, агента — легко.
Если что-то в коде меня удивило, но разъяснилось в пользу подхода агента, то я сразу прошу добавить комментарий. Свой код автора не удивляет, поэтому обычно такие комментарии просит коллега на ревью. Здесь же сам “автор” видит код впервые и может добавить их сразу.
Тесты я обычно детально не смотрю, да их и раньше редко ревьювили. Код тестов часто запутаннее тестируемого кода, у каждого теста своя логика того, что и почему он проверяет, а пользы от чтения в разы меньше, чем от чтения основного кода. Если код совпал с моделью и агент покрыл его своими обычными тестами, то для меня этого достаточно. Максимум вреда от слабого теста — пропущенный баг, а баги есть в любом коде, и в моём тоже: это просто будущие багфиксы. Проблема не в них, а в потере владения кодом. Внимательно я смотрю только удалённые и изменённые тесты в тех случаях, когда по моей модели поведение меняться не должно было: так ловятся изменения, которые иначе прошли бы незаметно.
Нерешённые проблемы: параллельность, поток и состояние ревью
Ревью требует держать в голове модель решения, а переключать её между задачами дорого, даже в пределах одного проекта. Поэтому параллельно у меня работают два агента, изредка три, и обычно над одной задачей. Популярная картинка с десятком агентов, работающих одновременно, совместима только с вайб-кодингом.
Главная проблема, которую я пока не решил, — ожидание. Описать агенту расхождение и дождаться переделки — несколько минут, но читать код дальше в это время смысла нет: код ниже первого замечания всё равно перестроится. Этого хватает, чтобы выпасть из потока и потом заново въезжать в ревью. Это похоже на медленный CI: если прогон дольше пары минут, то поток сбивается. Впрочем, CI ускорять мы научились, так что, возможно, проблему снимут более быстрые нейросети.
Ещё один открытый вопрос — как фиксировать состояние ревью между итерациями: после каждой переделки нужно понимать, что уже проверено, а что изменилось. Сейчас я делаю для этого WIP-коммиты, но устоявшейся практики за ними пока нет.
И я пока не пробовал формировать в голове модель решения и обсуждать её с агентом до генерации. Постановка задачи агенту у меня похожа на issue в трекере: требования в ней есть, а модель решения строят уже при реализации и ревью. Согласовать подход с агентом заранее можно, просто непривычно, и какой это даст эффект, я не знаю.
Порядок ревью одной задачи
При постановке задачи выделить функционал, который можно отдать в
vibecode/, и описать для него простой интерфейс.До того как открыть diff, сформировать модель решения.
Читать сверху вниз: интерфейсы, затем реализацию.
На первом расхождении, которое мешает читать, остановиться и снять его объяснением, переделкой или своей правкой.
Если код удивил, но оказался верным, то попросить добавить комментарий.
Просить разбивать большие изменения на цельные части, а механические изменения отделять от смысловых.
Из тестов смотреть только удалённые и изменённые, если поведение меняться не должно.
Сам по себе ИИ не сделал ревью дешевле, но изменил то, что можно требовать от автора кода.
Если вы ревьювите сгенерированный код иначе, то расскажите в комментариях. Особенно интересно, нашёл ли кто-нибудь способ не выпадать из потока, пока агент переделывает код.
Комментарии 0