18 ноября на деловом саммите АТЭС в Шэньчжэне Владимир Путин заявил: «Россия находится в авангарде цифровой трансформации. Наши две флагманские языковые модели входят в число лучших в мире» (по сообщению агентства «Прайм»). Фраза мгновенно разошлась по новостям, но самое интересное в ней не пафос, а проверяемость: в России четыре больших семейства языковых моделей, и почти все они участвуют в открытых рейтингах, где место определяется голосами живых пользователей, а не пресс‑релизом.
Я не ML‑инженер и не претендую на роль судьи: мой максимум — навайбкодить лабораторные в вузе, а от нейросети мне важно, чтобы она отвечала на русском и не требовала VPN. Поэтому вместо споров о «лучших в мире» я заглянул в открытый краудсорсинговый рейтинг llmarena.ru, собрал данные по всем четырём семействам и сверил их характеристики с заявлениями разработчиков. Спойлер: одна российская модель действительно сидит в мировом топ-10 — но общая картина сложнее, чем заголовок новости.
Что значит «в числе лучших»: как устроен открытый рейтинг
LLM Arena (llmarena.ru) — краудсорсинговая площадка для сравнения больших языковых моделей на русском языке. Механика простая: пользователь задаёт вопрос, на него анонимно отвечают две случайные модели, человек голосует за лучший ответ и только после голосования видит название модели. Из миллионов таких парных дуэлей по модели Брэдли‑Терри — той же математике, что стоит за шахматным рейтингом Эло, — считается итоговый балл: чем чаще модель выигрывает, тем выше её Elo.
На момент подготовки материала в рейтинге 112 моделей, а голоса собираются непрерывно; в моём срезе учтены данные вплоть до 9 ноября 2026 года. Важно понимать ограничение метода: Elo здесь измеряет «чей ответ людям понравился чаще», а не «какая модель решит олимпиадную задачу». Зато это единственная метрика, где сравнение идёт вслепую и без участия разработчиков.
Кто эти «две флагманские»: четыре российских семейства
В России четыре больших семейства LLM: GigaChat у Сбера, Alice AI LLM у Яндекса, T‑Pro и T‑Lite у Т‑Технологий и Cotype у MWS (экосистема МТС). Развиваются они быстро, поэтому начну с коротких справок в актуальном состоянии.
GigaChat — флагман с открытыми весами
GigaChat Сбера развивается с апреля 2023 года и вырос из экспериментального чата в мультимодальную платформу: помимо текста, семейство работает с документами, аудио и изображениями — в стеке собственные ruGPT-3.5 и FRED‑T5, ruCLIP для связи текста с картинкой и Kandinsky для генерации изображений. Текущий флагман — GigaChat 3.5 Ultra, выпущенный в июле 2026 года: архитектура MoE, 432 млрд общих параметров (28 млрд активных), контекст 262 тысячи токенов, а генерация длинных текстов, по данным Сбера, ускорилась до четырёх раз по сравнению с прошлым поколением. Главная особенность — открытые веса: модель выложена на Hugging Face под лицензией MIT, то есть её можно скачать, дообучить и крутить на своём железе. Подробности — в разборе на Хабре.
Alice AI LLM — ассистент, вросший в экосистему
Яндекс в октябре 2025 года перевёл «Алису» с YandexGPT на новое семейство Alice AI LLM: флагман построен на архитектуре MoE, включает 235 млрд параметров и обучен с нуля на русскоязычных текстах и данных экосистемы. Модель закрытая, но её сила — не в весах, а в интеграции: она отвечает в поиске, браузере и колонках, а через API в Yandex AI Studio и агентные сценарии доводит дела до конца — бронирует столик, собирает корзину, оформляет заказ в «Яндекс Такси» и «Еде». 21 сентября 2026 года Яндекс выложил в открытый доступ претрейн‑версию Alice AI Foundation на 80 млрд параметров (3 млрд активных), разрешив коммерческое использование; технические детали — в публикации на Хабре.
T‑Pro и T‑Lite — банковский путь через дообучение
Т‑Технологии (Т‑Банк) представили семейство Gen‑T в декабре 2024 года. Первые модели строились на базе Qwen 2.5 и проходили глубокое дообучение на русскоязычном корпусе — по словам разработчика, такой подход сократил расходы примерно на 90% по сравнению с обучением с нуля. Актуальные версии T‑pro‑it-2.0 и 2.1 переехали уже на Qwen 3: 32 млрд параметров, упор на следование инструкциям и вызов инструментов. Веса открыты под Apache 2.0 (карточка модели на Hugging Face), лёгкая T‑Lite на 7 млрд параметров рассчитана на быстрых чат‑ботов и стандартное железо.
Cotype — не ассистент, а офисный инструмент
MWS из экосистемы МТС пошла другим путём: вместо универсального чата — модели для бизнеса, обученные на деловой переписке и корпоративных документах. Линейка разложена по задачам: Pro 3 на 27 млрд параметров держит контекст в 262 тысячи токенов — примерно годовой отчёт целиком; Light 3 на 9 млрд — для типовых процессов; мультимодальная VL на 32 млрд читает рукописный текст со сканов; открытая Nano на 1,5 млрд годится для черновиков. В независимом бенчмарке MERA Pro 3 заняла третье место, уступив только моделям в несколько раз большего размера (обзор MWS AI на Хабре).
Таблица 1. Четыре российских семейства LLM (по данным разработчиков)
Семейство | Параметры | Контекст | Веса | Фокус |
GigaChat 3.5 Ultra (Сбер) | 432 млрд, MoE (28 млрд активных) | 262 тыс. токенов | Открытые, MIT лицензия | Универсальная модель: текст, код, документы |
Alice AI LLM 1.0 (Яндекс) | 235 млрд, MoE | н/д | Закрытые; открыта претрейн‑версия Foundation 80B | Ассистент и агенты в экосистеме Яндекса |
T‑pro‑it-2.1, T‑Lite (Т‑Технологии) | 32/ 7 млрд | н/д | Открытые, Apache 2.0 | Русский язык, tool calling, агенты |
Cotype Pro 3, Light 3, VL, Nano (MWS) | 27/ 9 / 32 / 1,5 млрд | до 262 тыс. (Pro 3) | Открыта Nano | B2B: договоры, документы, сканы |
н/д — не раскрыто в открытых источниках. Характеристики меняются от версии к версии;
Место в мировом рейтинге: сверяем заявление с цифрами
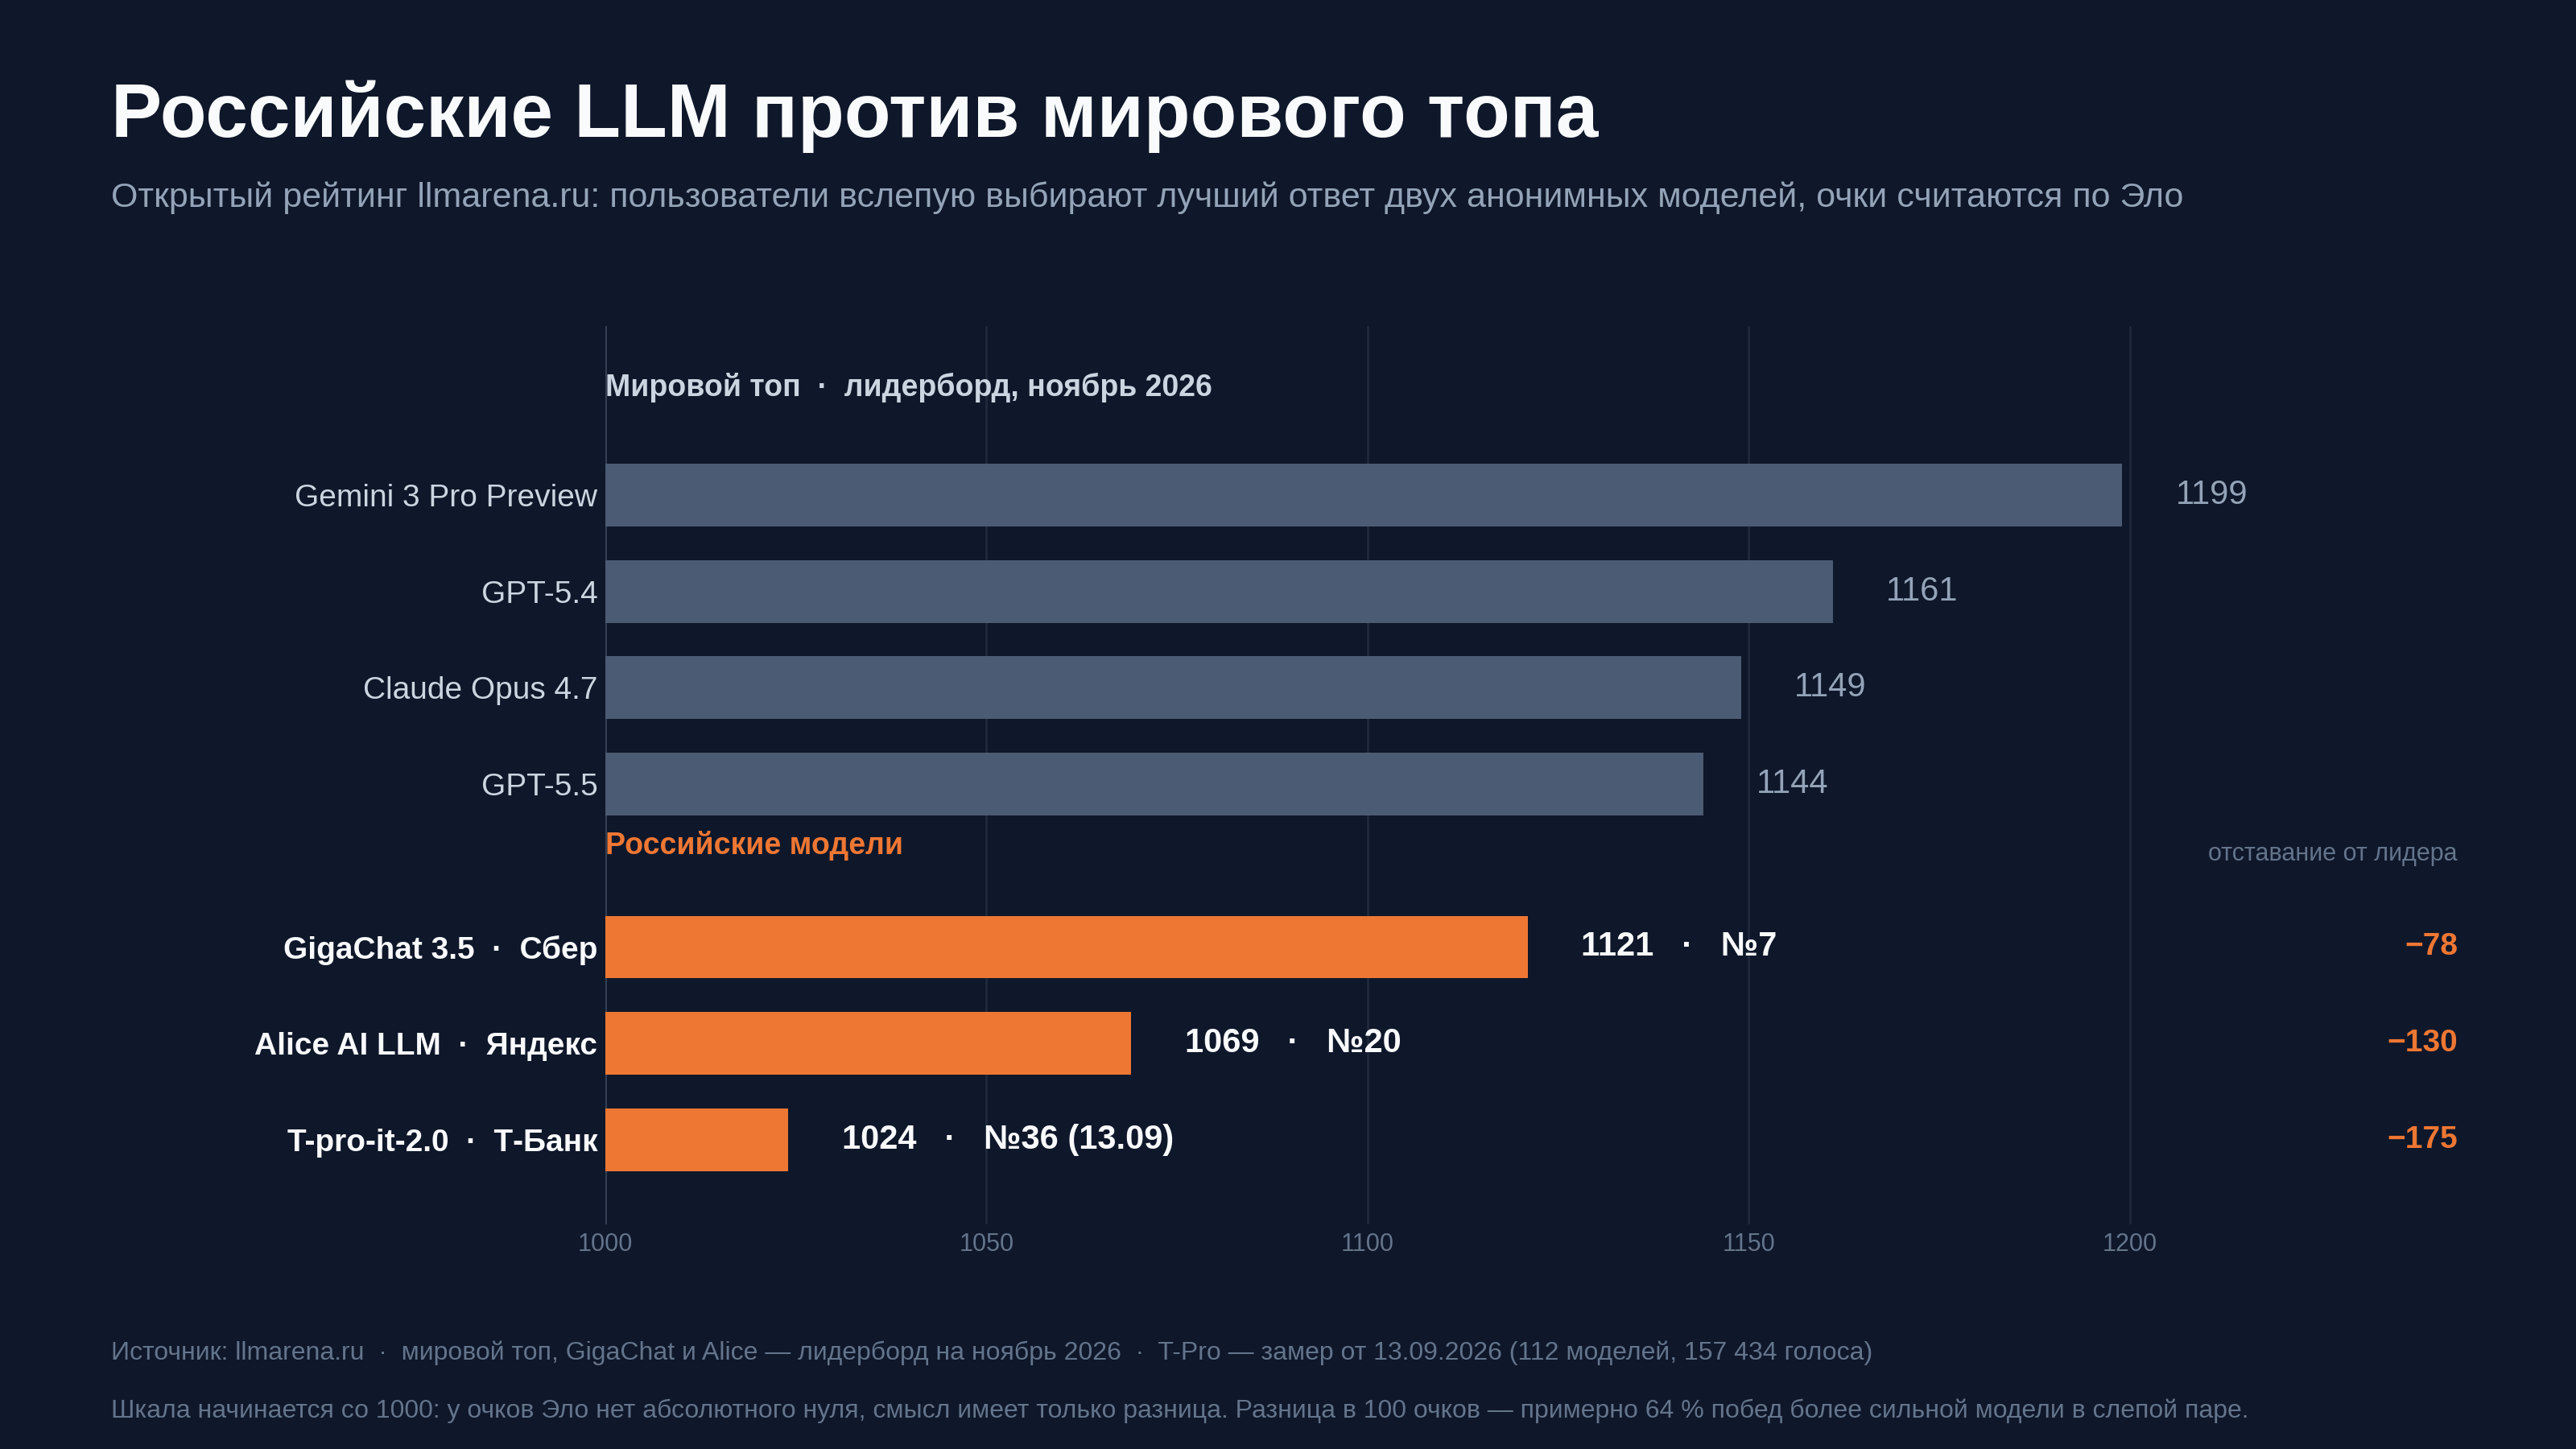
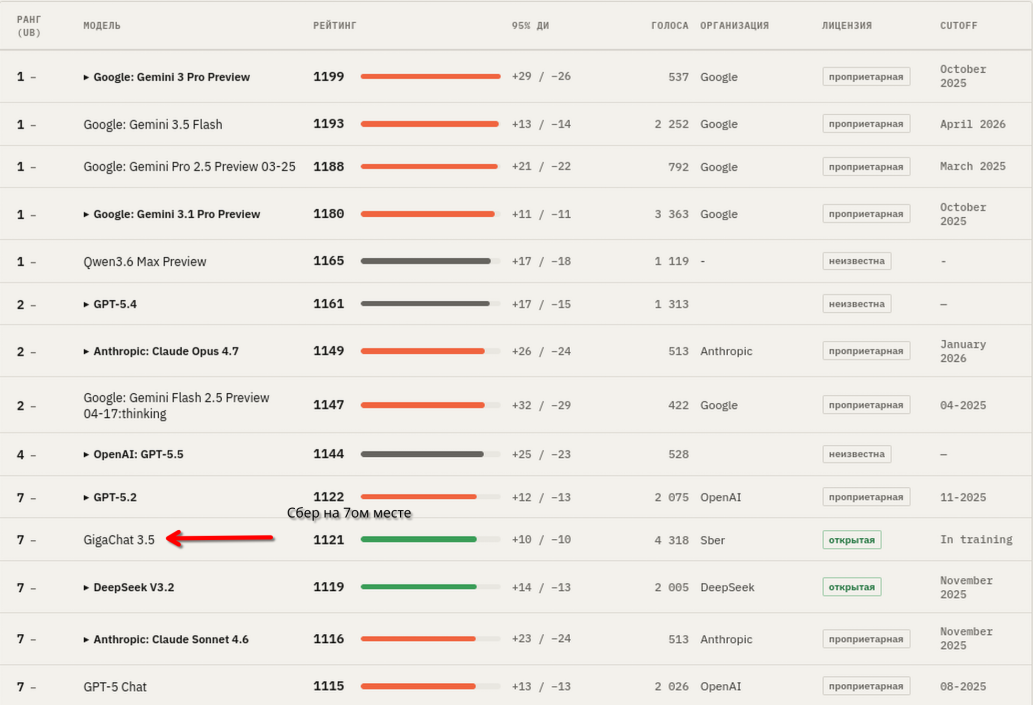
Президент сказал «две». Если мерить открытым рейтингом, две сильнейшие российские модели очевидны. На срезе llmarena.ru середины ноября 2026 года GigaChat 3.5 занимает седьмое место в мире с Elo 1121 — рядом GPT-5.2 (1122) и DeepSeek V3.2 (1119), а лицензия у него в таблице помечена как открытая. Alice AI LLM — двадцатое место и 1069 очков, по соседству с Gemma 3 27B и Claude Sonnet 4.
С преследователями честнее быть осторожным: T‑pro‑it-2.0 по срезу сентября 2026 года — 36-е место с Elo 1024, а модели Cotype в публичном лидерборде не представлены вовсе — MWS пока позиционирует их как B2B‑продукт.
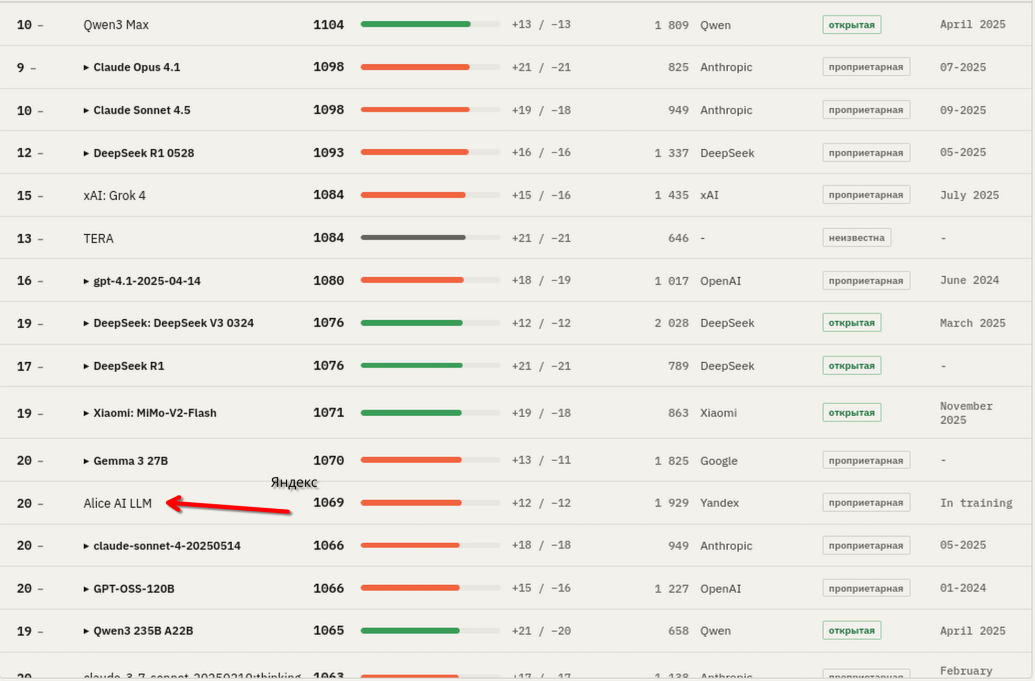
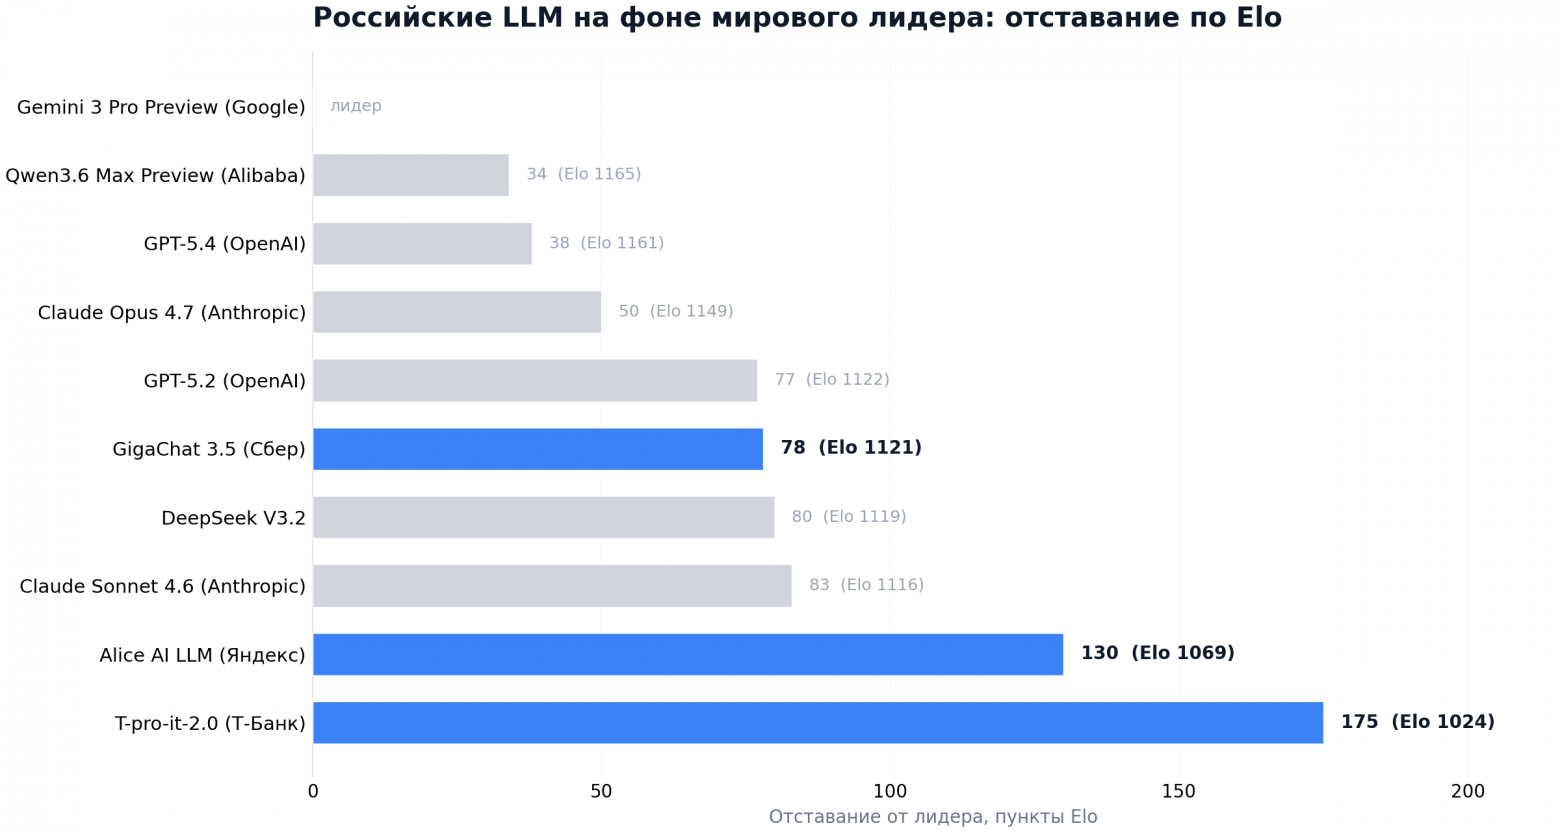
Для масштаба — мировая шеренга того же среза: Gemini 3 Pro Preview — 1199, Qwen3.6 Max — 1165, GPT-5.4 — 1161, Claude Opus 4.7 — 1149. Отставание GigaChat от лидера — 78 пунктов Elo, у Alice — 130, у T‑pro — 175 (диаграмма в начале статьи показывает этот разрыв наглядно). Поскольку рейтинг живой, места меняются: в сентябрьском срезе Alice, например, была девятнадцатой при тех же 1069 очках — поэтому рядом с любой цифрой из этой статьи стоит держать дату среза.
Второй эшелон: где наши сильны, а где нет
Честный ответ на вопрос заголовка: обе модели относятся ко второму эшелону мирового рейтинга, и стыдиться этого не нужно. Проигрыш мировым лидерам концентрируется там, где нужны длинные агентные цепочки, сложный многоступенчатый код и строгая многошаговая логика: в этих дисциплинах голоса пользователей стабильно уходят Gemini, GPT и Claude, а китайские открытые DeepSeek и Qwen тоже стоят выше.
Зато на своём поле наши модели выглядят убедительно. Рейтинг собирается на русскоязычных запросах — и GigaChat в общем зачёте обгоняет GPT-5.2, то есть для задач на русском языке он в мировом топ-10. Добавьте сюда цену и доступность, открытые веса GigaChat, T‑Pro и Alice Foundation (западные флагманы такого не дают в принципе) и интеграцию в реальные сервисы — банк, поиск, такси, маркетплейсы. Для типовых офисных задач — письмо, перевод, резюме документа — разрыв с мировыми лидерами на практике малозаметен.
Что в итоге
В мире наши обе модели относятся ко второму эшелону, они проигрывают мировым лидерам (Gemini 4, Claude 5.5, GPT-6 и ряду китайских моделей) в сложном программировании, многошаговых агентных сценариях и логических задачах. Но мы должны понимать, что регионально и на русском языке эти модели действительно могут показать достойный уровень качества ответов, входя в топ-20 рейтинга на русском языке.

Комментарии 0