Недавно мы попробовали обобщать результаты семантического поиска с помощью малых языковых моделей, работающих прямо в браузере. Получалось не очень: модели часто галлюцинировали. Но ведь модели с 0,6 млрд параметров необязательно знать всё на свете. Ей достаточно прочитать четыре фрагмента текста и либо обобщить их содержимое, либо признать, что ответа на вопрос там нет. «Похоже, тут поможет дообучение. Заодно будет повод написать продолжение».
И вот оно. Чтобы добиться результата, пришлось четыре раза перерабатывать обучающие данные, причём неудачные попытки оказались не менее интересными. Если коротко: теперь на странице поиска по моему блогу по умолчанию работает дообученная Qwen3-0.6B. Она отвечает правильно примерно так же часто, как исходная модель, но ошибается втрое реже. И ни разу не попыталась ответить на вопрос, который не раскрывается в блоге. К тому же теперь для её загрузки нужно скачивать меньше данных. Модель, набор данных и код находятся в открытом доступе, так что вы можете развернуть всё это на собственном сайте и проверить сами.
Задача и план действий
Модель получает системный промпт («Ответь не более чем двумя предложениями, используя только эти фрагменты. Если ответа в них нет, скажи, что блог, похоже, не затрагивает эту тему»), четыре пронумерованных фрагмента, найденных семантическим поиском, и вопрос. Больше ничего. Хороший ответ должен либо передавать информацию из найденных фрагментов, либо, если ответа в них нет, сообщать: «Похоже, эта тема в блоге не освещается».
Чтобы дообучить модель справляться с такой задачей, понадобится несколько тысяч примеров правильного поведения. У меня нет нескольких тысяч постов в блоге, поэтому план такой:
1. Взять обучающие данные из технических текстов с открытыми лицензиями. Вопросы из предыдущей статьи – все 45, которые использовались для оценки качества (eval), – станут тестовым набором. Поэтому обучать модель на собственных публикациях было бы практически жульничеством (тем более что их у меня всего 16). Вместо этого я взял блог Go, блог Rust, Rust RFC и Python PEP. Всего получилось 2193 технических документа с лицензиями, которые допускают такое использование.
2. Использовать тот же механизм поиска и извлечения. Каждый документ разбивается на чанки, для которых создаются эмбеддинги, – точно так же, как в семантическом поиске по моему блогу. Для каждого обучающего вопроса поиск возвращает четыре наиболее релевантных фрагмента. Так модель учится работать с такими же зашумлёнными результатами, какие встретит в реальных условиях: иногда ответ находится в первом фрагменте, иногда в четвёртом, а иногда рядом оказывается почти идентичный фрагмент из другой публикации.
3. Поручить Claude подготовить примеры. Claude Sonnet 5.5 составила вопросы к отдельным фрагментам текста. Для части вопросов ответ содержится среди четырёх найденных чанков. В других случаях я исключил документ, на основе которого был составлен вопрос, чтобы модель училась отказываться от ответа. Были и почти подходящие примеры (near-miss): вопросы по близкой теме, на которые найденные фрагменты на самом деле не отвечают. Затем Claude Opus 5.5 ответила на каждый вопрос, опираясь на соответствующие чанки и используя тот же системный промпт, что и на моём сайте. Формально это разновидность дистилляции знаний (distillation): большая модель показывает, как выполнять задачу, а малая учится воспроизводить её поведение.
4. Обучить модель на своём Mac. Для этого я использовал низкоранговую адаптацию (LoRA) с библиотекой mlx-lm на Mac mini с чипом M4 и 24 ГБ памяти. Этот же компьютер служит мне домашней лабораторией и медиасервером. Каждую версию модели я обучал в течение одной эпохи – одного полного прохода по 4500 обучающим примерам. Это 2265 итераций по два примера, с обновлением весов на каждой второй итерации и сохранением контрольной точки обучения (checkpoint) после каждой четверти эпохи. Весь процесс занимает примерно 1 час 20 минут.
5. Экспортировать модель для браузера в тот же 4-битный формат, который уже загружает страница, и провести такую же оценку качества, как в прошлый раз. Для этого использовались 30 вопросов, ответы на которые есть в блоге, и ещё 15, на которые блог не отвечает. Opus оценивала ответы модели, сверяя их с предоставленными фрагментами текста.
Ещё один нюанс последнего этапа: каждую дообученную версию я сравниваю с базовой моделью, экспортированной точно таким же способом. Так что единственное различие между ними – само дообучение. Эта версия базовой модели дала 17 ответов, соответствующих источнику, из 30, а не 18, как в предыдущей статье.
v1: стало только хуже
Первый набор данных содержал около 4500 вопросов с ответами, написанными Opus. Обычно это были два предложения, насыщенных деталями. После дообучения Qwen3-0.6B правильно опиралась на источник лишь в 8 случаях из 30, хотя до вмешательства таких ответов было 17. Зато модель научилась отказываться от ответа: она ни разу не выдумала ответ ни на один из 15 вопросов, не освещённых в блоге. Базовая модель ошиблась в двух таких случаях. Но с вопросами, ответы на которые в блоге всё-таки были, дела стали значительно хуже.
Модель обзавелась двумя привычками. Первую она переняла напрямую из обучающих данных. Если Opus могла ответить лишь на часть вопроса, то отвечала на неё и добавляла что-нибудь вроде «в блоге нет более подробного объяснения причин». Для большой модели, которая способна понять, какой информации не хватает, это вполне нормальный ответ. Примерно 10% обучающих ответов содержали такие оговорки. Дообученная модель переняла эту манеру и стала добавлять их даже там, где они не нужны, – фактически в каждом третьем ответе. Причём обычно она заявляла об отсутствии информации, которая на самом деле была в предоставленных фрагментах.
Вторая привычка оказалась ещё хуже: модель старалась включить в ответ побольше подробностей, а если их не хватало, просто выдумывала. Вот как базовая модель и v1 ответили на вопрос «Что в блоге говорится об эмбеддингах и косинусном сходстве?»:
«В блоге эмбеддинги рассматриваются как способ представления семантических связей между словами, а косинусное сходство используется для измерения близости между векторами». (Qwen3-0.6B)
«В блоге говорится, что эмбеддинги отражают семантические, а не только лексические связи. При этом „King“ и „bicycle“ находятся близко друг к другу, „King“ и „bicycle“ – далеко друг от друга, а „Beer“ и „alcoholic beverage“ – по соседству». (v1)
Ответ базовой модели расплывчатый, зато правильный. Ответ v1 звучит так, будто модель действительно прочитала статью, но на деле он ошибочный. В статье о семантическом поиске близко друг к другу находятся «king» и «queen», а «bicycle» далеко от них. Модель переняла форму ответов Opus: несколько конкретных фактов, термины в кавычках, второе предложение. Но при этом не научилась так же внимательно читать исходный текст.
v2: потери снижались, а ответы становились хуже
От оговорок избавиться было проще всего. Я написал небольшой скрипт, который удалял из обучающих ответов фразы вроде «в блоге не объясняется X» (а примеры, начинавшиеся с таких фраз, исключал целиком), и запустил обучение заново. Оговорки исчезли. Но качество ответов почти не улучшилось: 9 из 30.
На этот раз я также решил проверить контрольные точки обучения (checkpoints), сохранённые после четверти, половины и полной эпохи. И вот тут началось самое интересное:
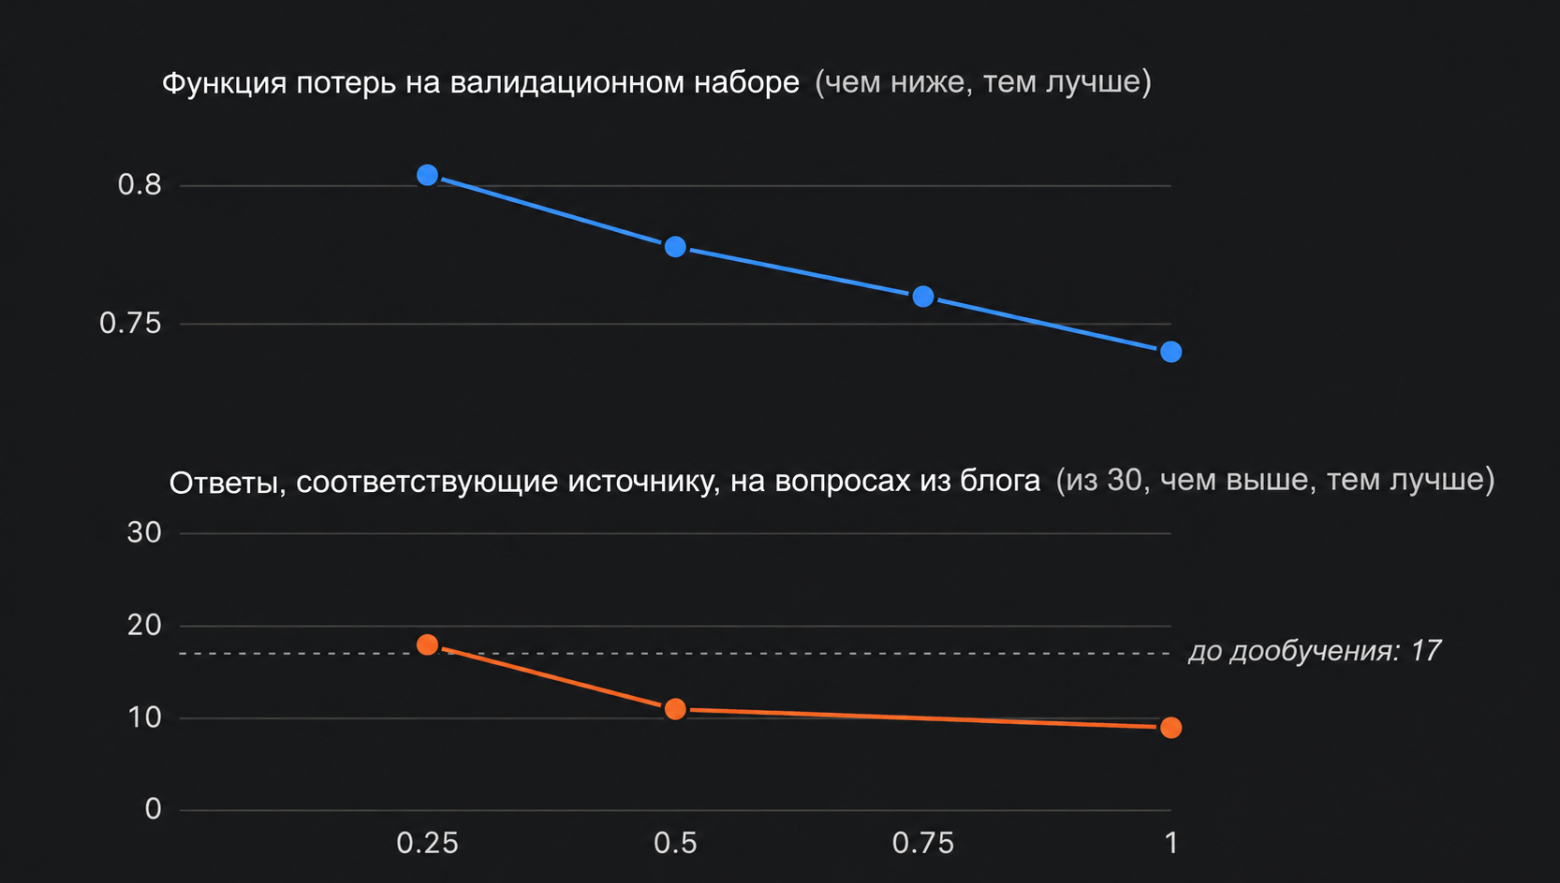
Функция потерь на валидационном наборе (validation loss) – показатель, за которым обычно следят при дообучении, – улучшалась на каждой контрольной точке. Но на вопросах из блога модель с каждой контрольной точкой отвечала всё хуже: 18, 11 и 9 ответов, соответствующих источнику. Получается, функция потерь измеряет совсем не то, что мне нужно. Она показывает, насколько точно модель воспроизводит ответы Opus, буквально слово в слово, на отложенных примерах из документации Go, Rust и Python.
Но такие насыщенные деталями ответы, объединяющие несколько фактов, – как раз то, что модель с 0,6 млрд параметров способна воспроизвести по форме, но не по содержанию. Чем лучше она их имитировала, тем больше конкретных подробностей приводила и тем чаще в них ошибалась.
Отсюда два вывода. Во-первых, если модель не способна по-настоящему делать то, что демонстрируют обучающие ответы, дополнительное обучение лишь ухудшит результат. Во-вторых, проверяйте контрольные точки: внимательно смотрите, как модель справляется именно с вашей задачей, а не ориентируйтесь слепо на значение функции потерь. В конечном счёте модель просто воспроизводит закономерности из обучающего набора. И если данные подготовлены небрежно (например, вы сгенерировали кучу примеров через Opus с расплывчатым промптом), результат окажется совсем не таким, на какой вы рассчитывали.
v3: меньше слов
Для v3 я оставил те же вопросы и фрагменты текста, изменив только ответы. Opus заново сгенерировала их по гораздо более строгим инструкциям: одно короткое предложение с конкретным фактом, о котором спрашивают, максимально близкое к формулировке в исходном фрагменте. Не объединять факты из разных фрагментов, не комментировать отсутствие информации. Второе предложение разрешалось только в том случае, если в вопросе спрашивали о двух вещах. Средняя длина ответа сократилась со 180 до 123 символов. Теперь на вопрос об эмбеддингах модель отвечает так:
«Главное здесь то, что эти векторы отражают семантические связи, а не только лексические». (v3)
Не сказать, что это отличное обобщение, зато каждое слово взято из статьи. И такого же компромисса v3 придерживается во всех остальных ответах:
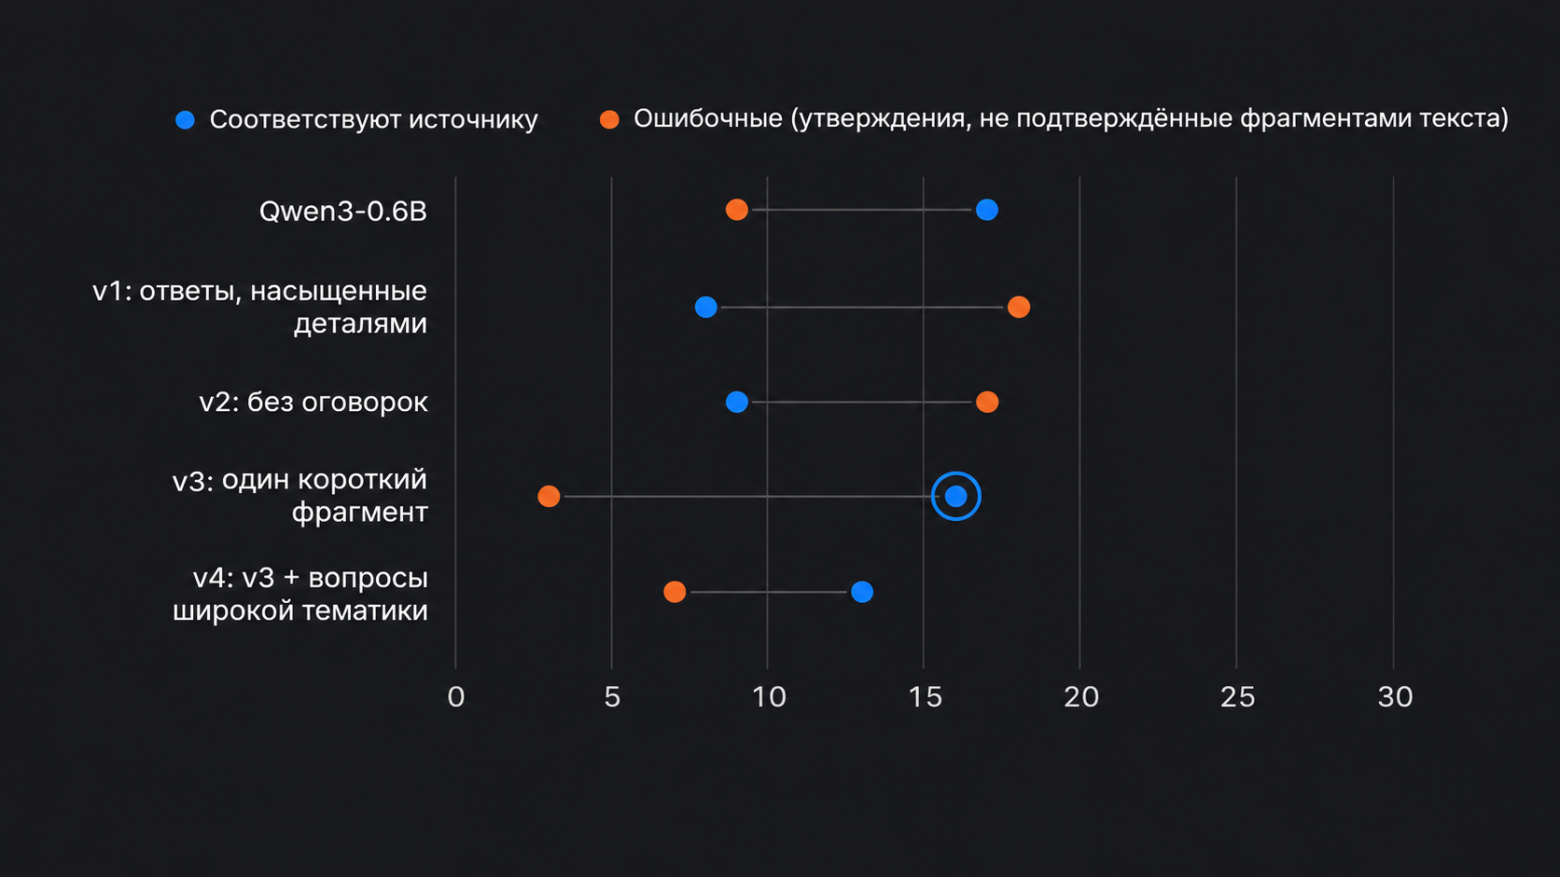
У v3 16 ответов из 30 соответствуют источнику – практически столько же, сколько у базовой модели (16 против 17; на выборке из 30 вопросов и с такими крошечными моделями разница в один ответ вполне укладывается в статистический шум). Зато ошибочных ответов стало всего 3 вместо 9, а на все 15 вопросов, не освещённых в блоге, модель ответила: «Похоже, эта тема в блоге не освещается».
Например, на вопрос о том, какую видеокарту купить для запуска Llama 70B, базовая модель выдала целый абзац с советами по выбору GPU, опираясь на фрагменты об эмбеддингах и ИИ-агенте для программирования. Видимо, ей показалось, что темы хоть как-то связаны. А v3 просто отказалась отвечать. Победа!
Но за такую осторожность приходится платить. На 11 из 30 вопросов, ответы на которые есть в блоге, v3 заявляет, что тема не освещается (или приводит фрагмент, который не отвечает на вопрос). У базовой модели таких случаев всего четыре. Но для страницы «Спроси мой блог» это, на мой взгляд, правильный компромисс. Найденные фрагменты отображаются прямо под кратким ответом, так что при отказе модели читатель просто потратит несколько лишних секунд на их изучение. А вот уверенный, но ошибочный пересказ создаст у него неверное представление о том, что я написал. Да и выглядеть это будет глупо.
v4: добавили примеров сложных задач и сделали только хуже
Большинство необоснованных отказов v3 приходилось на вопросы широкой тематики: «Что в блоге написано о хешировании и битовых массивах?», «Как превратить мои статьи в аудиоформат, чтобы читатели могли их слушать?». До этого мы специально учили модель находить один факт в одном фрагменте. Поэтому для v4 я попросил Opus добавить 1200 навигационных и концептуальных вопросов, ведь такие вопросы тоже встречаются в тестовом наборе (и кто после этого скажет, что мы подгоняем модель под тест?). Для каждого документа я добавил по два вопроса: «Что в блоге написано о X?» и «Как сделать Y?». Opus подготовила для них ответы из одного-двух коротких предложений.
Результат стал хуже: 13 правильных ответов из 30. v4 перестала отказываться от ответов на широкие вопросы, зато начала путать факты и выдумывать подробности, точь-в-точь как v1:
«В блоге объясняется, что эмбеддинги отражают семантические связи, а не только лексические. Поэтому такие слова, как „king“ и „bicycle“, находятся близко друг к другу, а не только слова, похожие по написанию». (v4)
Чтобы ответить на вопрос широкой тематики, нужно объединить информацию из нескольких фрагментов. А именно с этим модель на 0,6 млрд параметров справляется плохо, какой бы короткий ответ мы от неё ни требовали (а возможно, как раз из-за требования краткости). Зато она вполне способна научиться находить предложение с ответом на вопрос и воспроизводить его. Или вообще ничего не отвечать. На этом я решил, что потратил уже достаточно токенов по тарифам API и пока оставлю на странице поиска по блогу версию v3.
Основные выводы
Подготовка обучающих данных очень важна. Повторяю, ОЧЕНЬ. v1, v3 и v4 обучались с одинаковыми настройками. Менялось только содержание и форма ответов. Малая модель гораздо легче перенимает стиль обучающих примеров, чем умение, которое за ним стоит. Поэтому примеры должны быть такими, чтобы модель действительно могла воспроизвести не только их форму, но и содержание.
Не полагайтесь на функцию потерь. Проверяйте контрольные точки на реальной задаче, в том числе вручную (да, знаю, удовольствие сомнительное), используя отложенный набор данных из документов, которых модель не видела при обучении. А настоящий тестовый набор (в моём случае это 45 вопросов из предыдущих экспериментов) приберегите для самого конца и проведите итоговую оценку только один раз.
Малые модели умеют извлекать информацию, но плохо справляются с её обобщением. Просите модель найти предложение, содержащее ответ на вопрос, а не объединять информацию из нескольких источников или делать выводы, пусть даже для этого требуется совсем немного рассуждений.
На таких маленьких моделях неудачные эксперименты обходятся дёшево. Каждая попытка требовала около полутора часов обучения на моём Mac mini и нескольких долларов на оценку результатов. Поэтому можно было без особых затрат проверить очередную очевидную идею и убедиться, что она не работает. До чего же мы дожили!
Но давайте всё-таки оценивать результаты трезво. Тридцать вопросов – очень маленький тестовый набор. Разница между 16 правильными ответами у v3 и 17 у базовой модели практически ничего не значит. Да и сокращение числа ошибок с 9 до 3 едва ли достаточно статистически убедительно, чтобы называть это полноценным научным результатом. К тому же Claude и писала обучающие ответы, и оценивала результаты, поэтому вполне возможно, что модель-оценщик предпочитала ответы, похожие по стилю на собственные. Отложенный набор из 260 примеров и вопросы из моего блога немного снижают риск такого смещения (ни те ни другие не использовались при обучении), но не устраняют его полностью.
Попробуйте сами
В этом дообучении нет ничего специфичного для моего блога: модель не видела ни одной моей публикации во время обучения. Поэтому, если захотите повторить эксперимент, есть три варианта:
1. Использовать готовую модель. bartdegoede/qwen3-0.6b-small-rag доступна на Hugging Face в формате q4f16, который transformers.js загружает через WebGPU или WebAssembly, а также в виде обычных весов для Python. Есть и пример для браузера. Это одна статическая страница: одной командой создаёте поисковый индекс из папки с публикациями в Markdown, запускаете веб-сервер для этой папки и можете задавать вопросы.
2. Проверить модель на собственных публикациях или данных. Составьте (или сгенерируйте) 30–50 вопросов по материалам своего блога. Желательно, чтобы на часть из них в публикациях были ответы, а на остальные – нет. Затем запустите оценку качества. Скрипт будет извлекать фрагменты ваших публикаций точно так же, как это делает моя страница, передавать их модели и отправлять ответы на оценку Opus (понадобится ваш API-ключ). При текущих тарифах проверка 45 вопросов обойдётся примерно в 20 центов. На моих публикациях в их нынешнем виде модель правильно отвечает на 18 из 30 вопросов и обоснованно отказывается отвечать на 13 из 15.
3. Дообучить собственную модель. Набор данных и код открыты для изучения. Самая вероятная причина, по которой вам захочется переобучить модель под свои задачи, – в системном промпте и формулировках отказов постоянно упоминается «блог». Если у вас, например, сайт с документацией библиотеки, логичнее, чтобы модель говорила «в документации». Для этого придётся переписать или заново сгенерировать обучающие ответы и потратить ещё час-два на обучение на относительно современном Mac с Apple Silicon.
Есть и ещё один небольшой бонус. Официальные файлы Qwen3-0.6B занимают 579 МБ, а дообученная модель – всего 358 МБ. Дело в том, что при экспорте используется одна 4-битная матрица весов для входных эмбеддингов и выходного слоя: в самой модели эти веса и так общие. Получилось почти уложиться в лимит 350 МБ, который я установил для страницы ещё в предыдущей статье.
Как показали эксперименты из статьи, качество ответов RAG-системы зависит не только от дообучения модели, но и от того, какой контекст она получает и как его использует. Разобраться в подходах к поиску и извлечению данных можно на двух бесплатных вебинарах OTUS: поговорим об ограничениях классического RAG, возможностях GraphRAG и реализации векторного поиска в ClickHouse.
25 ноября, 20:00. «Продвинутые техники RAG и введение в GraphRAG». Записаться
2 декабря, 20:00. «Векторный поиск и RAG на базе ClickHouse». Записаться
Больше открытых уроков по искусственному интеллекту, разработке и не только смотрите в календаре.


Комментарии 0