Эта статья перевод оригинальной статьи «Introducing Gemini 4 Neon».
Также я веду телеграм канал «Frontend по‑флотски», где рассказываю про интересные вещи из мира разработки интерфейсов и AI.
Вступление
Сегодня мы представляем Gemini 4 Neon. Модель решает сложные задачи разработки, работы с информацией и научных исследований от начала до конца, сочетая скорость с возможностями ведущих моделей.
На уровне рассуждения xhigh Neon набирает 61 балл в Artificial Analysis Intelligence Index. Среди сопоставимых моделей это лучший результат, а в общем зачёте Neon занимает третье место с небольшим отставанием от более крупных и медленных моделей. В Vals Index она занимает второе место и выходит на границу Парето.
В новом Agent Arena Index Neon занимает второе место по способности учитывать поправки пользователя прямо по ходу работы. Модель хорошо следует многошаговым инструкциям, а во внутренних тестах Google Antigravity показала самый низкий для наших моделей показатель выдуманных сведений.
Контекстное окно составляет 1 млн токенов. Миллион входных токенов стоит 3 доллара, миллион кешированных входных токенов стоит 0,15 доллара со скидкой 95%, а миллион выходных токенов стоит 15 долларов.
Gemini 4 Neon с сегодняшнего дня постепенно появляется в Gemini API через Google AI Studio, в Gemini for business через API и меню выбора модели, а также в Google Antigravity и приложении Gemini для подписчиков Google AI Pro и Ultra.
Работа с корпоративными данными, аналитика и наука
В компаниях данные хранятся в электронных таблицах, PDF, диаграммах, аудио и видео. Neon может обработать материалы всех этих типов в одном контекстном окне на 1 млн токенов и подготовить структурированный результат. В независимых оценках модель входит в число лидеров. В Vals Index она занимает второе место с результатом 70,9%, а в Legal Research Bench и Tax Agent Bench заняла первые места.
В тестах Surge AI Neon занимает первое место в большинстве заданий по финансам, бухгалтерскому учёту, моделированию в электронных таблицах и соблюдению сложных ограничений. В Chartography, где нужно читать насыщенные данными профессиональные диаграммы, модель набрала 73,5%, а в Agents’ Last Exam v1.1 показала результат на уровне лидеров, 75,8%. Neon заняла первое место и в AutomationBench от Zapier с результатом 56,3%, и в Vending-Bench 2 от Andon Labs с результатом 16 843 доллара. Последний тест моделирует управление бизнесом на протяжении длительного времени. В новом Agent Arena Index от Arena модель дебютировала на втором месте в мире, набрав 1336 баллов по итогам более 4200 сеансов работы агентов над реальными задачами.
В научных и математических задачах, от количественного анализа до технических исследовательских задач, Neon показывает лучшие в своём классе результаты в Terminal-Bench Science (70,5%), RiemannBench (84,0%) и HLE-Diamond (71,3%).
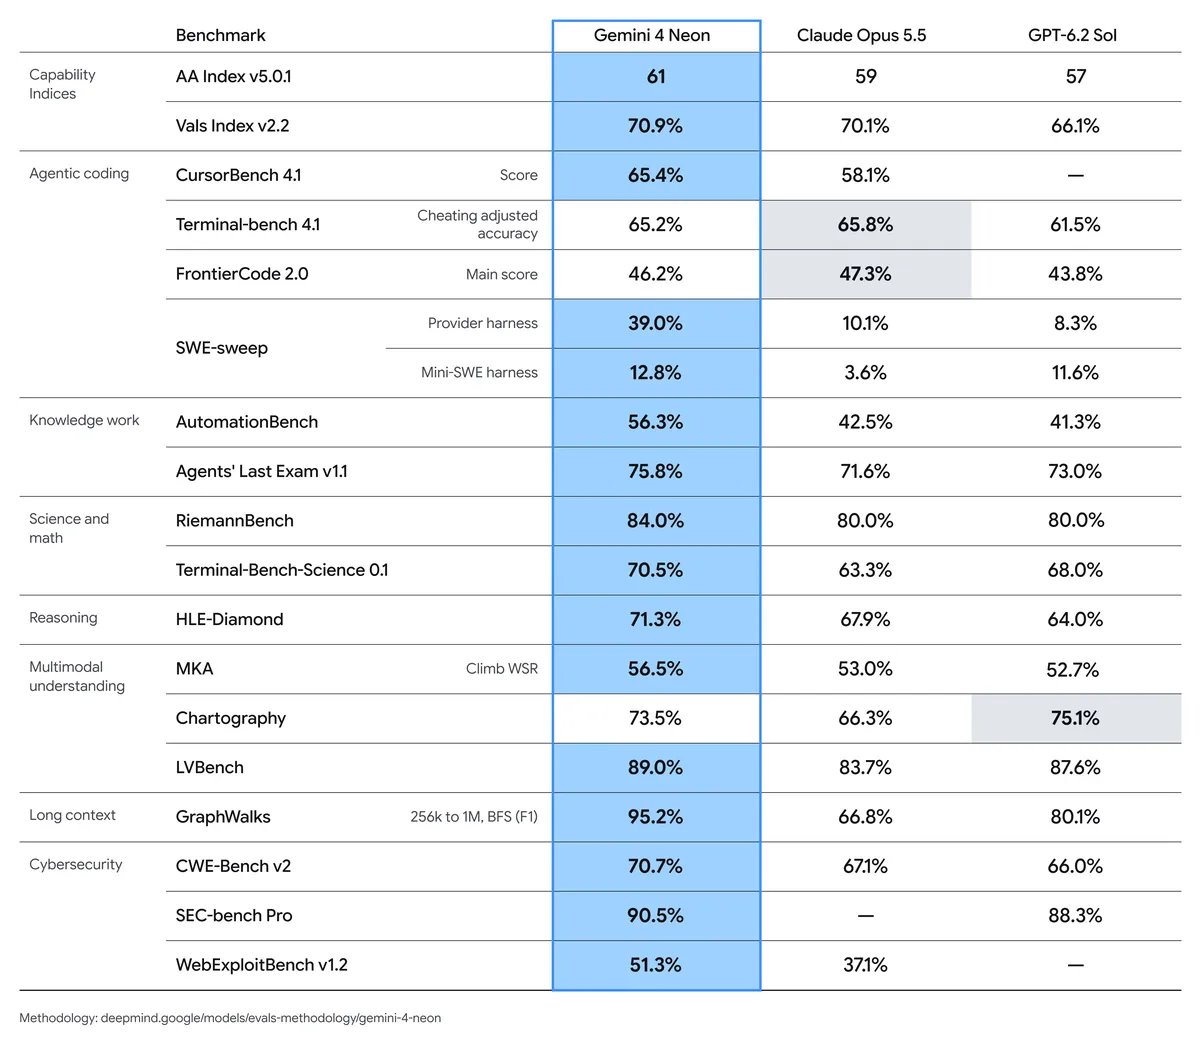
Сравнение Gemini 4 Neon, Claude Opus 5.5 и GPT-6.2 Sol. В таблице приведены общие индексы и результаты тестов по агентному программированию, работе с информацией, науке и математике, рассуждению, пониманию разных типов данных, работе с длинным контекстом и кибербезопасности. Для Terminal-Bench 4.1 указана точность с поправкой на обход правил теста. В SWE-sweep сравниваются результаты в среде каждого поставщика и в общей среде mini-SWE.
Gemini 4 Neon собирает разрозненные сведения в понятные ответы, которые опираются на исходные данные. Для повседневных рабочих задач модель сочетает качество, скорость и приемлемую стоимость. В первых оценках Neon показала качество на уровне Gemini 4 Carbon или выше, работала в три раза быстрее, а обходилась в 60% от её стоимости. Мы хотим дать эти возможности клиентам Glean, которым нужно быстро и точно выполнять многошаговые задачи с вниманием к деталям.
Тай Тран, руководитель AI-продуктов Glean
В наших оценках Gemini 4 Neon возглавила рейтинг Medical Index и внутреннего теста по наукам о жизни, сохранив хорошую скорость при умеренной стоимости.
Брэндон Валафар, руководитель AI-стратегии Micro1
Neon работает заметно тщательнее и аккуратнее других моделей Gemini, которые мы тестировали. Она хорошо ориентируется в больших кодовых базах и быстро разбирается в сложной архитектуре. В наших тестах по кибербезопасности Neon нашла несколько неочевидных уязвимостей, которые пропустили другие модели, и потратила лишь малую долю их токенов. Мы считаем Neon удачным выбором, когда нужно изучить систему или провести исследование с небольшими затратами.
Карина Нгуен, основательница Thoughtful Lab
Начинающий исследователь проведёт любой эксперимент, который ему поручили. Сильный исследователь продолжит спрашивать «почему?». Gemini 4 Neon стала первой моделью, которая напоминает мне такого исследователя. Она продолжает искать новые данные и придумывает, какие ещё сигналы из них извлечь для обучения более качественных моделей. Это первая модель из тех, что мы видели, которая старается улучшить результат без присмотра человека. Если результат плохой, Neon пересматривает подход к моделированию и добивается лучшего.
Трентон Чанг, главный научный сотрудник Quadrillion
Gemini 4 Neon здорово помогает в ML-инженерии, подготовке данных, управлении экспериментами и проектировании архитектуры. Она учитывает обратную связь, работает тщательно, проверяет гипотезы, понимает, какие решения уже существуют, и в целом упрощает разработку AI-моделей.
Эндрю Карр, главный научный сотрудник и сооснователь Cartwheel
Код для продакшена
Neon рассчитана на продолжительные задачи, в которых агент много раз обращается к инструментам. Модель сохраняет качество на протяжении всей работы. Она может выполнять задачу самостоятельно или координировать параллельную работу субагентов Hydrogen в режиме Orchestrator в Google Antigravity, быстро принимая решения о дальнейших шагах. Neon реже перечитывает одни и те же файлы, сообщает о ходе работы и надёжно сжимает контекст в длинных сеансах.
В основных задачах разработчиков и исследователей Neon показывает результаты на уровне ведущих моделей своего класса. Она занимает первое место в Artificial Analysis Coding Agent Index с результатом 58,6 балла. В Terminal-Bench 4.1 модель набирает 65,2%, а в FrontierCode 2.0 на уровне рассуждения high, заданном по умолчанию, достигает 46,2%. В работе с кодом для продакшена Neon отлаживает и рефакторит несколько файлов и репозиториев, внося точечные изменения. В SWE-sweep модель лидирует и в среде mini-SWE с результатом 12,8%, а в Google Antigravity показатель вырастает более чем втрое, до рекордных 39,0%.
В Google Antigravity Gemini 4 Neon использовала /swarm и управляла Blender через MCP, чтобы собрать фотореалистичный 3D-лабораторный стенд. Названия моделей воссоздали с учётом свойств элементов. Для Gemini 4 Carbon и Gemini 4 Hydrogen использовали пламя горелок Бунзена, а для Gemini 4 Argon и Neon установили высоковольтные газоразрядные трубки.
В Google Antigravity Neon с нуля написала лыжный симулятор фрирайда от первого лица на WebGL2, используя реальные данные о высотах Монблана и Шамони. В симуляторе 10 200 строк авторских шейдеров, физика лыж с частотой 120 Гц на шести горных маршрутах, динамические следы на снегу, лавины из снежных досок и пространственный звук через Web Audio. Готовые ассеты не использовались.
С помощью /swarm в Google Antigravity Neon нашла архивные фотографии и воссоздала в интерактивном 3D кабинет Алана Тьюринга в Королевском колледже Кембриджа по состоянию на 1936 год. В сцене можно увидеть часовню снаружи и комнату X.8 изнутри, включая действующую универсальную машину Тьюринга на столе.
В Google Antigravity группа агентов Gemini 4 Neon превратила одно изображение в Google-таблицу на 100 000 ячеек. Для этого не понадобились ни встроенные изображения, ни Apps Script. Более 500 000 действующих формул находят границы объектов, строят карту глубины и меняют освещение сцены в шести интерактивных режимах.
Уровни рассуждения и стоимость задачи
С каждым выпуском мы уточняем настройки рассуждения, чтобы команды могли точнее управлять моделью, а переходы между уровнями были плавнее. У Neon четыре уровня. Они последовательно увеличивают глубину рассуждений и расход токенов, поэтому для каждой задачи можно выбрать подходящее соотношение.
В сторонних тестах Neon сохраняет высокое качество при меньших затратах на задачу. На уровне high, который используется по умолчанию, модель набирает высокий балл в Artificial Analysis Intelligence Index и обходится на 32% дешевле Carbon в расчёте на задачу. На этом же уровне Neon выходит на границу Парето в Vals Index и Agent Arena, а стоимость задачи примерно на 50–80% ниже, чем у ведущих моделей-конкурентов. Уровень xhigh даёт более глубокие рассуждения в несколько шагов для самых трудных инженерных, аналитических и научных задач. На нём Neon набирает свой максимальный балл, а стоимость задачи как минимум на 36% ниже, чем у конкурентов на их максимальном уровне.
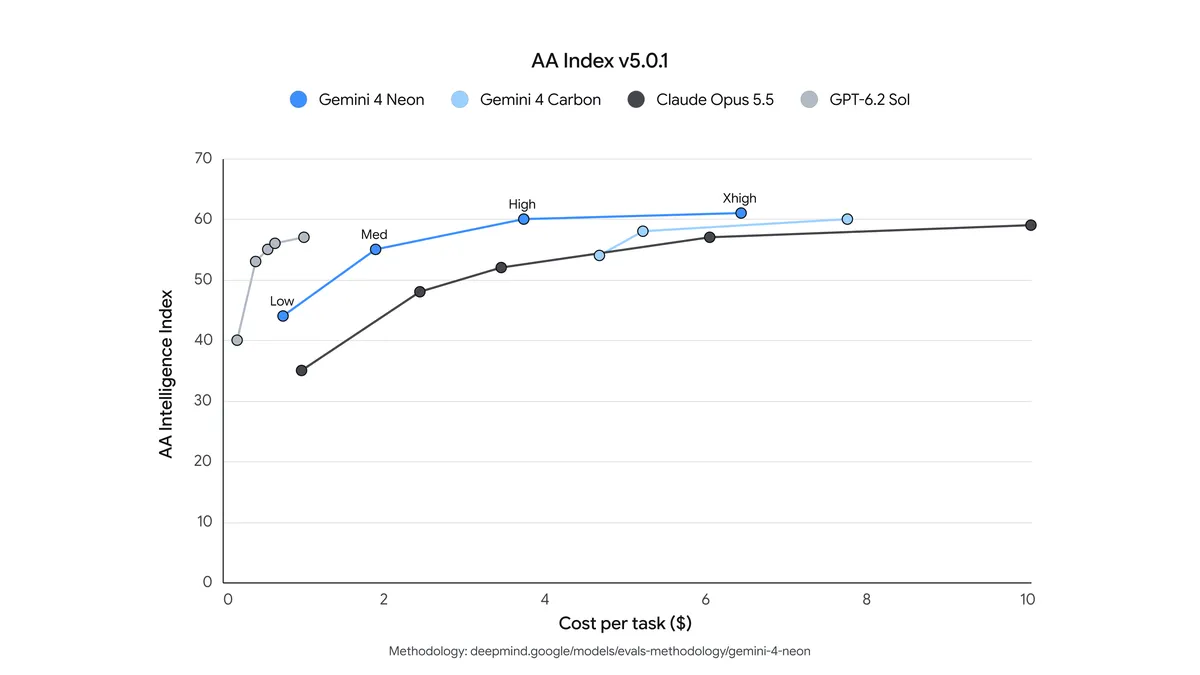
По горизонтали показана стоимость одной задачи в долларах, по вертикали указан балл Artificial Analysis Intelligence Index v5.01. На линии Neon отмечены четыре уровня рассуждения, от low до xhigh.
Скорость и стоимость задач киберзащиты
По мере распространения агентов для программирования важно писать безопасный код с самого начала. Во всех категориях сложности AutoBaxBench Gemini 4 Neon пишет более защищённый код, чем Carbon. На сложных заданиях она показывает лучший результат, 76%.
Защита систем также требует находить уязвимости раньше злоумышленников. Для этого компании давно используют тестирование на проникновение. В WebExploitBench v1.2 Neon показывает лучший результат, 51,26%, при вдвое меньшей стоимости по сравнению с крупными моделями-конкурентами.
Neon for cyber помогает на всех этапах защиты существующего кода, от поиска уязвимостей и проверки риска до исправления. Модель справляется с этими задачами быстрее и дешевле крупных моделей того же уровня.
При поиске уязвимостей в коде Neon показывает лучший результат в SEC-bench Pro, 90,5%, при примерно вдвое меньшей стоимости задания.
Чтобы решить, какие уязвимости исправлять в первую очередь, специалисты проверяют, можно ли их использовать на практике. В ExploitGym Neon показывает результат на уровне ведущих моделей и расходует вдвое меньше токенов, чем Carbon.
При исправлении важно устранять первопричину уязвимости. В CWE-bench v2 от Collinear Neon достигает 70,7%. Google указывает прирост на 3,4% по сравнению с Carbon.
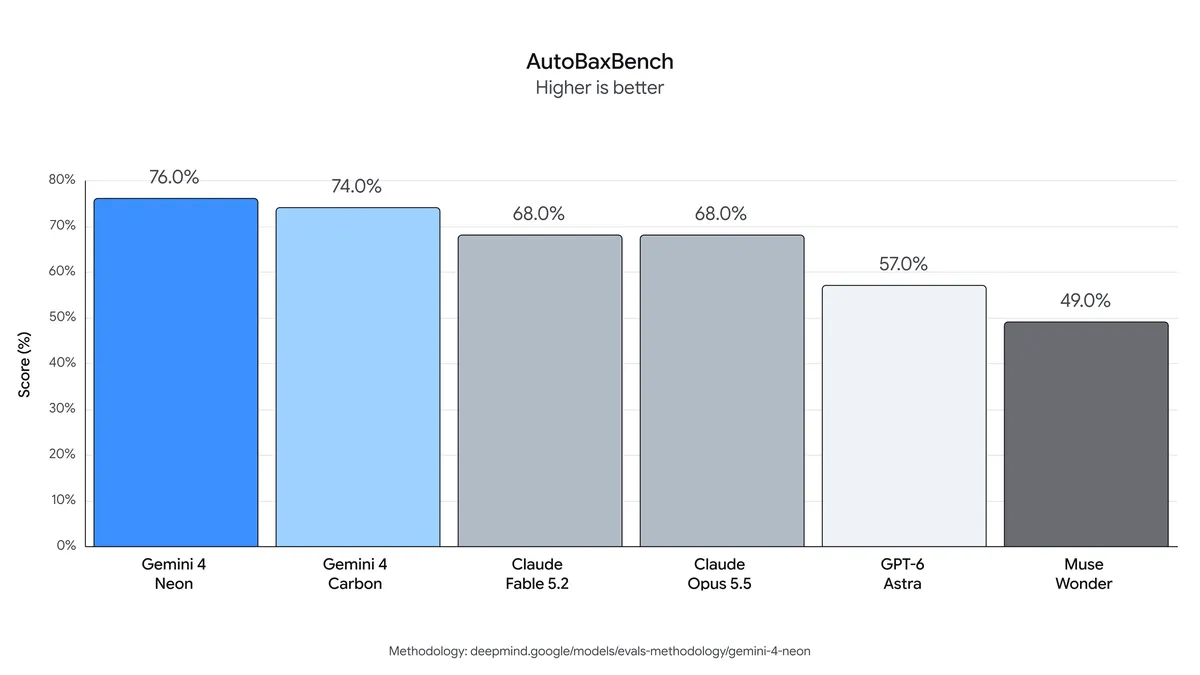
AutoBaxBench. Результат в процентах, большее значение лучше.
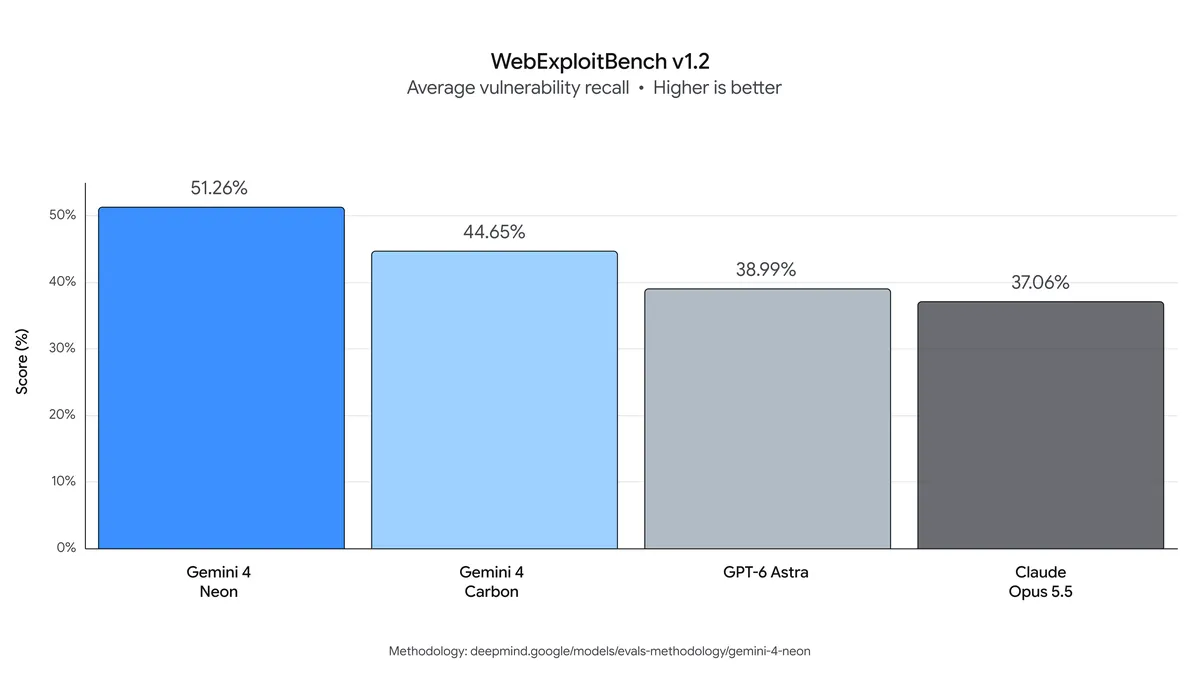
WebExploitBench v1.2. Средняя доля найденных уязвимостей, большее значение лучше.
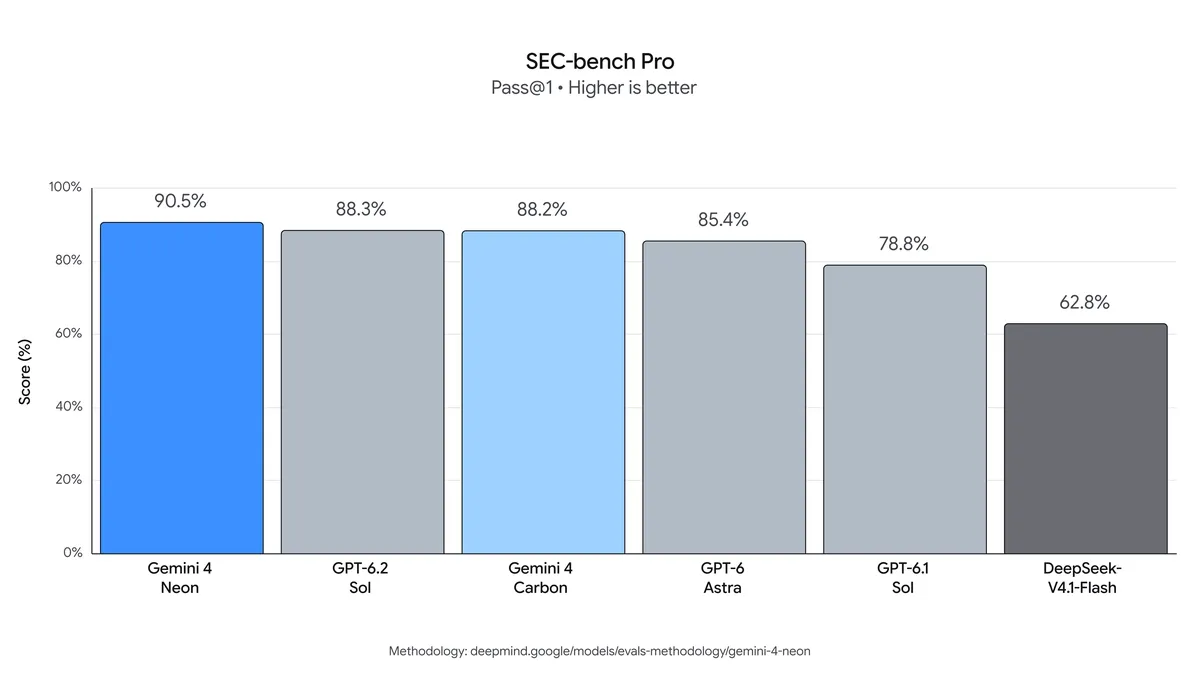
SEC-bench Pro. Доля успешных решений с первой попытки (Pass@1), большее значение лучше.
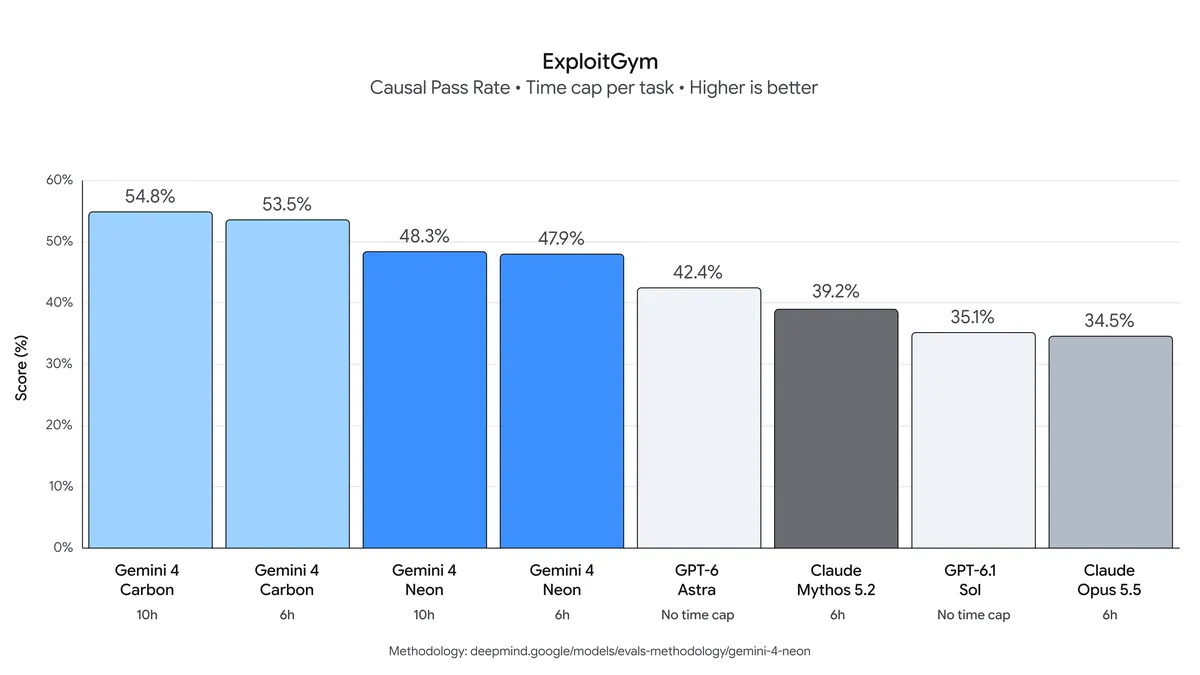
ExploitGym. Доля случаев, в которых модель подтвердила возможность эксплуатации именно целевой уязвимости (Causal Pass Rate). Под названиями моделей указан лимит времени на задачу.
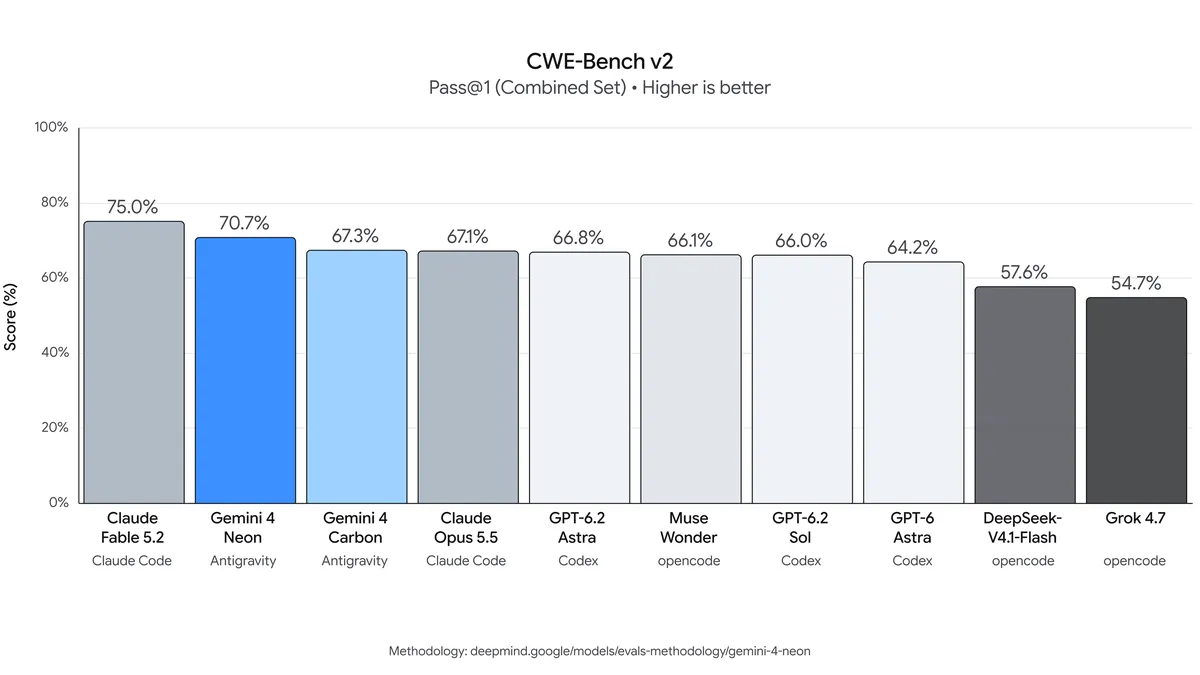
CWE-bench v2. Доля успешных решений с первой попытки на объединённом наборе заданий (Pass@1). Под моделями указаны среды, в которых они выполняли задачи.
В ближайшие дни доступ к Gemini 4 Neon for cyber начнут получать проверенные специалисты по киберзащите из Fairwind Program.
Безопасность и надёжность работы
В Gemini 4 Neon мы развили механизмы защиты Gemini 4. Мы сохранили уровень защиты Gemini 4 Carbon от серьёзных злоупотреблений и промпт-инъекций, а также улучшили способность модели действовать в рамках намерений пользователя. Для продолжительных задач в продакшене мы сосредоточились на трёх направлениях.
Защита от злоупотреблений
Neon делает возможности передовых моделей доступнее за счёт скорости и меньшей стоимости. Поэтому мы предусмотрели защиту в реальном времени от злоупотреблений в области кибер- и биобезопасности на уровне Carbon. При этом Neon гораздо реже отказывается от законных заданий в этих областях. Например, модель отказалась от 1,98% задач в Terminal-Bench 4.0 и от 0% задач в Terminal-Bench-Science.
Соблюдение инструкций и границ задачи
При внутреннем использовании для программирования система мониторинга рассуждений и действий отмечала у Neon меньше отклонений от намерений пользователя, чем у Carbon, у которой этот показатель и так был низким. Это указывает на то, что Neon может точнее соблюдать намерения пользователя. Тот же мониторинг защищает пользователей во внешних сервисах.
Мы обучили Neon справляться с многошаговой работой, выполнять положенные шаги, опираться на реальные результаты и соблюдать заданные пользователем границы. В Terminal-Bench 4.0 модель повторила результат Carbon, 0,0% случаев обхода правил теста. Во внутренней оценке поведения при программировании Neon пропускала положенные шаги лишь в 2,45% задач. Это самый низкий показатель среди моделей Gemini 4. В наших тестах безопасности агентов 0,09% действий расходились с намерениями пользователя, а проверку честности агента модель прошла в 99,2% случаев.
В тестах поведения агентов на разных уровнях усилий Neon на 43–56% реже оставляла часть работы невыполненной и на 15–35% реже выходила за рамки поручения по сравнению с Carbon.
Защита от косвенных промпт-инъекций
В тесте Gray Swan IPI Neon лучше других моделей своего класса противостоит вредоносным инструкциям, спрятанным в веб-страницах, письмах, документах или коде, которые читает модель. С защитой в реальном времени и на максимальном уровне рассуждения Neon отразила все атаки в этом тесте. Раньше результат 0,0% успешных атак в нём показывали только другие модели Gemini.
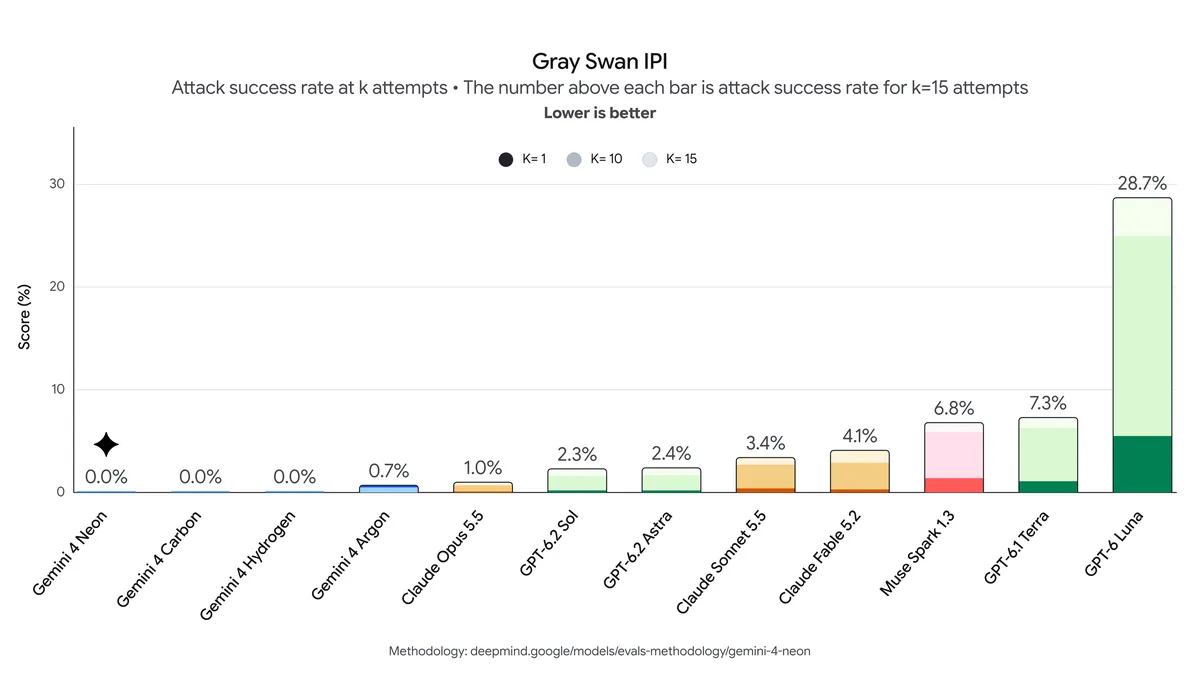
Gray Swan IPI. Доля успешных атак с косвенной промпт-инъекцией при одной, десяти и пятнадцати попытках. Над каждым столбцом приведён результат для пятнадцати попыток. Меньшее значение лучше.
Подробности приведены в карточке модели Gemini 4 Neon.
Анализ и исследования в приложении Gemini
В приложении Gemini модель Neon подходит для задач, где нужны и глубокие рассуждения, и быстрый ответ.
Neon даёт ясные, структурированные ответы простым языком и точнее обрабатывает загруженные таблицы, PDF и фотографии. Модель составляет отчёты и краткие сводки по объёмным материалам и находит нужные сведения в приложениях Google, в том числе Gmail и Google Документах.
Модель часто использует сведения из разных веб-источников, чтобы ответы по быстро меняющимся темам оставались актуальными. Например, она может сравнить цены нескольких поставщиков перед крупной покупкой или подготовить подробную справку по свежим данным рынка.
Функция «Задачи» в Gemini теперь может работать на Neon. Модель быстрее и с меньшими затратами, чем более крупные модели, справляется со сложными многошаговыми поручениями, поэтому в рамках тех же лимитов можно выполнить больше работы. Например, Neon может разобрать счета и выяснить, почему выросла плата за коммунальную услугу, или сверить чеки и документы, чтобы помочь договориться о возврате денег.
Место Neon в семействе Gemini 4
Neon предназначена для сложного программирования, аналитики и корпоративных задач в продакшене. Carbon берёт на себя самые трудные и продолжительные проекты, а Hydrogen быстро выполняет повседневные задачи. Neon рассчитана на сложную работу, которая регулярно повторяется и требует глубоких рассуждений. Такие задачи модель выполняет быстрее и дешевле.
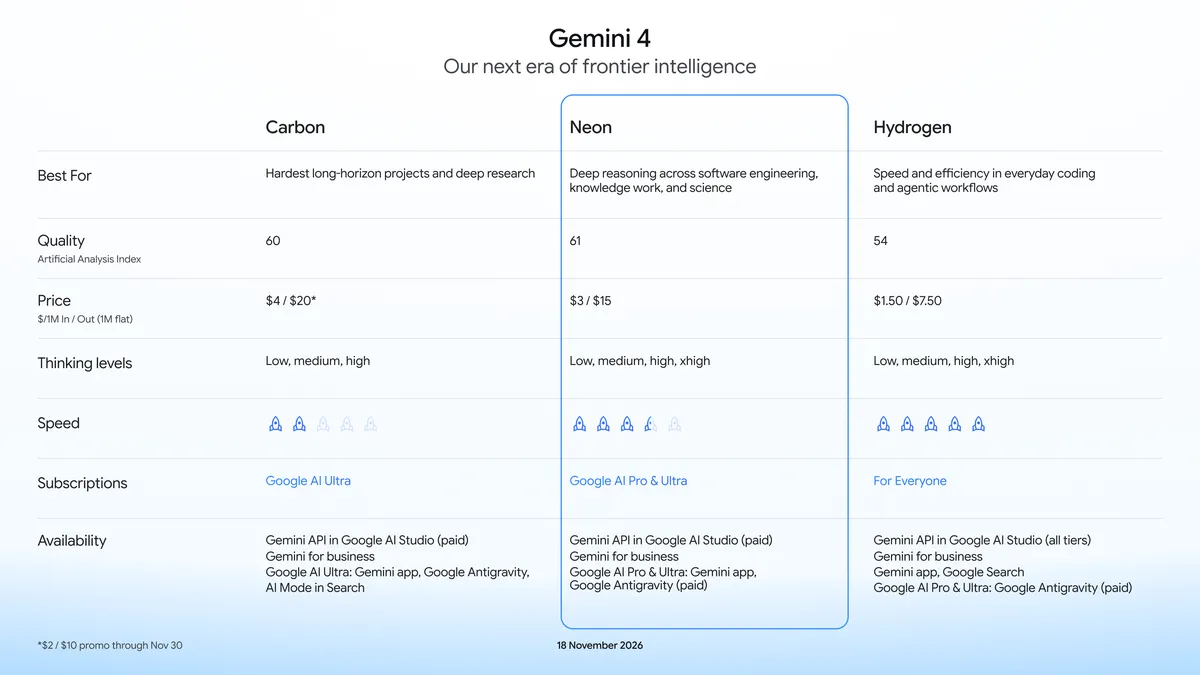
Сравнение Carbon, Neon и Hydrogen на 18 ноября 2026 года. В таблице указаны подходящие задачи, баллы Artificial Analysis Index, цены за миллион входных и выходных токенов, уровни рассуждения, относительная скорость, подписки и доступные сервисы. Акционные цены Carbon действуют до 30 ноября. Миллион входных токенов стоит 2 доллара, миллион выходных токенов стоит 10 долларов.
Как получить доступ к Gemini 4 Neon
Мы начинаем открывать доступ к Gemini 4 Neon с сегодняшнего дня.
Разработчикам модель доступна на платном уровне Gemini API в Google AI Studio и Android Studio. Подписчики Google AI Pro и Ultra могут попробовать Neon в Google Antigravity и AI Studio.
Компании могут использовать Gemini 4 Neon в Gemini for business через API или меню выбора модели, а также в Google Antigravity.
Пользователи с подпиской Google AI Pro или Ultra могут выбрать Neon в меню моделей приложения Gemini.
Специалисты по киберзащите из Fairwind Program, которые соответствуют требованиям программы, начнут получать доступ в ближайшие дни. Чтобы подать заявку на участие в программе, свяжитесь с командой Google Cloud, которая работает с вашим аккаунтом.


Комментарии 0