Цикл "Docs-as-code на максималках":
Фундамент: Архитектура и видение проекта ← вы здесь
Это первая статья из цикла "Docs-as-code на максималках". В цикле я по шагам разбираю, как мы за два года перевели работу системных аналитиков с классического Confluence на "гибкий docs-as-code" и собрали вокруг этого целый конвейер с AI-агентом.
С чего все началось
У нас, как и у большинства, документация жила в Confluence. Confluence все знают, в нем легко начать. Но в какой-то момент именно поддерживать документацию и управлять изменениями стало тяжело и мы захотели внедрить docs-as-code.
Идея не новая, и в интернете полно материалов про best practices.
Интереснее выглядит сам процесс трансформации: мало кто разбирает проблемы, связанные с переходом. Это то, что меня всегда удивляло, потому что все обычно начинается не с нуля, компания должна дозреть до этого момента и накопить тонну-другую документации в базе знаний. И миграция на docs-as-code в таком случае может быть довольно болезненной.
Проблемы миграции
Когда мы начали прикидывать "классический" вариант, вылезло несколько проблем.
Первая: обратная совместимость.
В Confluence уже лежат тысячи страниц, и их нельзя просто выкинуть. Надо как-то переносить. А еще есть сотни потребителей, в первую очередь бизнес-читателей, от которых стоит ждать честного "мы никуда переезжать не хотим, оставьте как есть". И чем больше система, тем она инертнее.
Плюс в классическом виде docs-as-code это обычно просто markdown/asciidoc/rst/etc-файлы в репозитории, которые в лучшем случае рендерятся в HTML, а в худшем читаются прямо в интерфейсе Bitbucket. После вылизанной Wiki это шаг назад по удобству.
Вторая: порог входа и просадка производительности.
а) Если в команде много джунов, порог входа ощущается особенно остро. Организовать процесс обучения и наставничества, чтобы не потерять в производительности, это нетривиальная задача. Как правило, в подходе docs-as-code аналитики в лучшем случае пишут спеки в одной из IDE для разработки, обвешанной плагинами, в худшем - в текстовом редакторе. Для этого нужно как минимум знать и помнить язык разметки. В целом это не прям чтобы блокирующая проблема, но чем больше барьеров, тем сложнее людям начать пользоваться новым инструментом.
б) И даже для синьоров смена подхода это новые шаблоны, новая структура, новые привычки. Даже если ты сто раз работал с docs-as-code раньше, нужно заново ко всему привыкать. В моменте это неизбежная просадка производительности, пока команда не адаптируется.
Третья: отсутствие стандартизации подходов и централизованного управления конфигурацией
Чаще всего аналитики работают в обычных IDE типа JetBrains или VSCode. Каждый конфигурирует эту среду под себя: кто-то обвешивается плагинами, кто-то пишет на голом языке разметки. Настройка локального редактора обычно никак не регламентирована, а если и регламентирована, то любые самые мелкие изменения в регламенте приводят к необходимости приходить к каждому аналитику и просить обновить конфигурацию вручную. В итоге получается, что каждый строчит, как он хочет, и различия в подходах порой могут быть значительные. И именно в этом wiki-системы бесконечно выигрывают у docs-as-code: любое обновление это простой советский F5 в браузере.
Вывод, к которому мы пришли: проблемы нужно решать плавностью перехода и автоматизацией. Отсюда родилась наша версия подхода - мы внедряем модифицированный вариант, призванный сохранить все преимущества и данные минусы устранить. Назовем его гибким docs-as-code. Строится он на базе следующих идей.
Идея 1: Разделяй и властвуй
Идея в том, чтобы для всех потребителей сохранить Confluence, как существующую систему по работе с документацией. Однако в нашем случае она уже будет выступать в качестве View (витрины), а не мастер-системы по хранению данных. Мастер-системой для хранения документации становится Bitbucket-репозиторий. В нем хранятся Markdown-файлы, которые являются документацией к системе. В Bitbucket настроены pipelines, которые отслеживают изменения в репозитории и публикуют их в виде страниц в Confluence, в то же пространство, где лежит старая документация, но уже как read-only страницы.
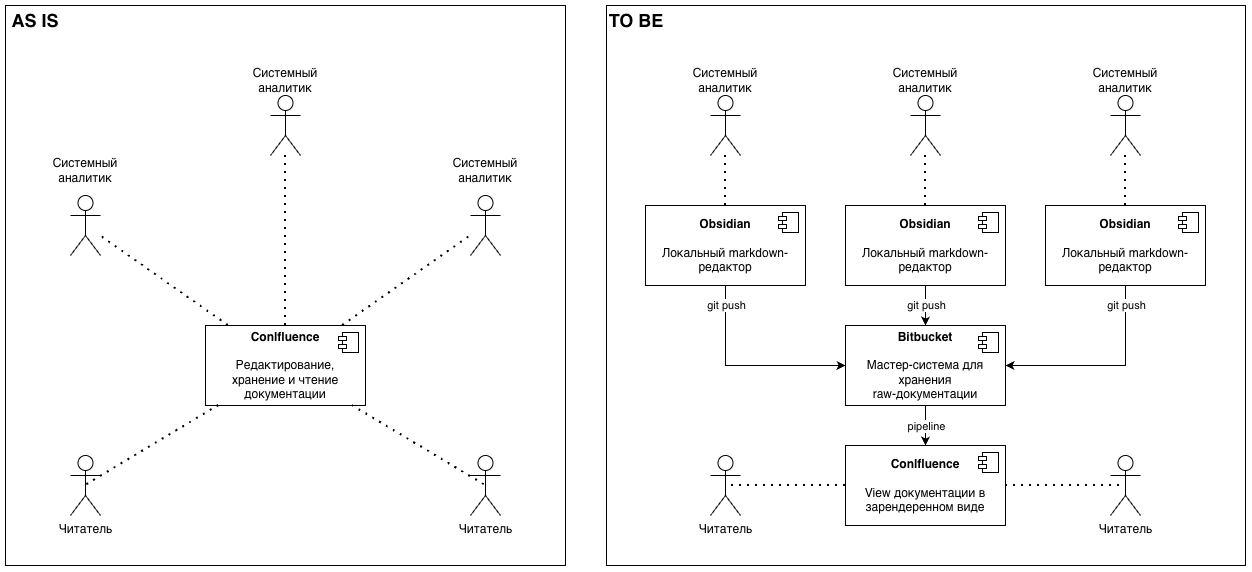
Ключевые отличия от классики:
Обратный рендеринг в Confluence. Мы не заставляем читателей переезжать в новый источник. Документы из репозитория публикуются рядом со старыми страницами, и получается единое представление в привычном интерфейсе.
Полная обратная совместимость. Ничего не нужно переносить разом. Старое и новое живут параллельно сколько угодно долго, а переезд можно размазать во времени и брать как техдолг.
Мгновенный rollback. Если что-то пойдет не так, в любой момент можно откатиться на предыдущий подход в один клик, сняв read-only ограничения на опубликованные пайплайнами страницы.
Идея 2: IAE
Решить проблемы с локальным редактором, которым пользуются аналитики, хотелось централизованно. Для этого необходимо было внедрить один общий редактор, который можно было бы использовать для всех одинаковым образом. Мы тоже начали с JetBrains, но быстро поняли, что для повышения эффективности работы здесь нужно что-то большее и начали искать подходящее решение.
Базовый минимум для нас:
Это markdown – родной формат для нейронок, а в наше время это важно. Поэтому другие форматы не рассматривали
Это GUI – то чего не было в JetBrains, там ты по большей части работаешь с сырой разметкой и нужно помнить синтаксис.
Это кроссплатформенный редактор
Это расширяемый и кастомизируемый редактор – чтобы была возможность допилить его под себя
Это бесплатное решение
После анализа того, что есть на рынке, остановились на Obsidian.
Вообще он позиционируется как редактор личных заметок, но если взглянуть под капот, то это навороченный markdown-редактор, по удобству сравнимый с Confluence, а по возможностям автоматизации и расширения - бесконечно выигрывающий. Он имеет расширяемую архитектуру, поэтому к базовому обвесу можно добавлять функциональные плагины и видоизменить его до неузнаваемости. Есть как готовые решения на маркетплейсах, так и можно относительно быстро реализовать свое.
Мы встроили туда много всего необходимого: git клиент, swagger, редакторы plantUML и Mermaid, Draw.io, AI-агента, кучку расширений самого редактора, скрипты для автоматизации и проверки целостности перед выполнением push в репозиторий.
В общем мы взяли Obsidian и превратили его, по сути, в полноценную "IDE для аналитика" или в IAE - Integrated Analysis Environment (как бы пафосно это ни звучало)
Главный итог здесь: аналитик работает в удобном GUI-редакторе, а на выходе получается markdown, который дальше едет по пайплайну.
Идея 3: Shared-конфигурация
С внедрением Obsidian мы автоматически получаем одну очень ценную фичу - общую конфигурацию.
Идея очень простая - все настройки, все шаблоны документов, все плагины (вместе с их исходным кодом) в Obsidian хранятся в отдельном каталоге. Никто не мешает сделать этот каталог частью репозитория. Или если строить более качественную архитектуру - отдельным репозиторием, подключенным к основному как submodule.
В итоге каждый аналитик, просто склонировав себе репозиторий, получает абсолютно такой же редактор, как и у всей остальной команды.
Это особенно ценно для быстрой поставки изменений - поправил я что-нибудь в общих шаблонах или конфигурации, запушил в репозиторий и все – я могу быть уверен что у всех остальных будет абсолютно идентичное окружение.
В один момент нас посетила еще более безумная идея - развернуть Obsidian прямо в браузере. Вот этот проект https://github.com/Nystik-gh/ignis позволяет это сделать. Пока до имплементации этого не добрались, но возможно в будущем вернемся.
Сам Obsidian написан на Electron, поэтому в такой конфигурации один браузер будет запускаться внутри другого браузера, чтобы.. ну вы поняли.
Целевая архитектура
Итого, к чему мы будем стремиться:
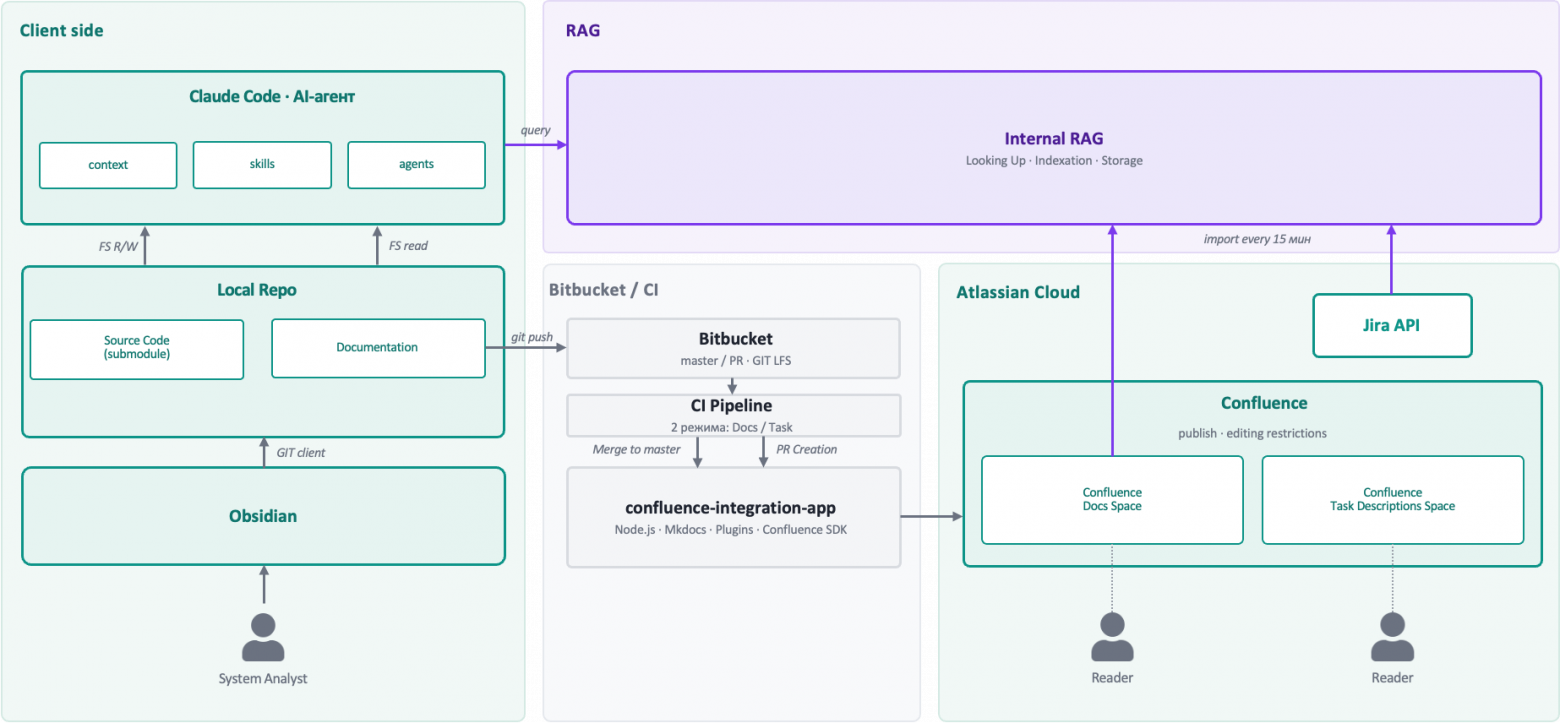
Коротко по компонентам:
Obsidian. Локальный редактор IAE. Этому будет посвящена отдельная часть
Local Repo. Локальная копия репозитория с документацией
Bitbucket. Удаленный репозиторий это мастер-система для хранения документации. Состояние ветки
masterсоответствует состоянию системы в productionGit LFS. Хранилище для бинарников (картинки, схемы). В самом репозитории лежат только ссылки. Так он остается легким
CI Pipeline + Node.js container. Пайплайн в Bitbucket, который на старте поднимает контейнер с Node.js и запускает приложение-интегратор
confluence-integration-app. Приложение на Node.js, которое конвертирует
.mdв формат Confluence и публикует страницы. Под капотом движок на базе MkDocs и markdown-it, +Confluence SDKConfluence Spaces. Конечные пространства, куда публикуется документация
Claude Code. Какой же проект без AI-агентов
RAG. Система для индексации содержимого Confluence и Jira
Потенциальные преимущества
Сохраняем все плюшки docs-as-code (контроль версий, совместная работа над задачами, автоматизация, управление процессом ревью, etc)
Отсутствие необходимости разом переносить всю существующую документацию в Markdown. Все потребители продолжают работать с Confluence (и могут даже не знать, что что-либо поменялось под капотом)
Полная обратная совместимость. В любой момент можно вернуться к прямой работе в Confluence, если вдруг что-то пойдет не так
Не такой высокий порог входа, как в классический docs-as-code. Obsidian интуитивно понятен + для него мы написали очень простой git-клиент, который не требует особых знаний (до того момента, пока не столкнемся с более сложными задачами типа мержа веток, но 80% бытовых активностей этот плагин закрывает)
Скорость работы (в первую очередь время отклика) в Obsidian выше, чем в Confluence
Расширяемость Obsidian выше, чем в Confluence. Кто пробовал писать плагины для Atlassian, поймет какая это болезненная история. В Obsidian с этим дела обстоят сильно проще. Дополнительно есть открытый marketplace с кучей готовых бесплатных решений.
Сохранение кроссплатформенности (в теории можно работать даже с телефонов и планшетов)
Стандартизация спек и стилей их написания, удобная работа с шаблонами
Большое пространство для внедрения AI-агентов (архитектура позволяет)
Автоподсветка цветом изменений в рамках задачи (аналог git diff, только не на сырой разметке, а на зарендеренной странице)
+100500 к автоматизации (возможность быстро писать новые скрипты на базе nodejs или Shell-файлов)
Очевидные недостатки
Необходимость ждать несколько минут, пока отработает pipeline и документация будет зарендерена в Confluence
Поддерживать Pipeline придется самим. Т.е. могут возникать сбои и неожиданные проблемы (особенно на первых стадиях внедрения)
Нет локального рендеринга в ADF, и как следствие возможности на 100% убедиться, что пайплайн не сломается, а верстка точно не поедет после публикации
Необходимость сопровождения большего количества систем и инфраструктуры
Опубликованные таким образом страницы в Confluence будут иметь некоторые ограничения по функциональности, например работа с inline-комментариями станет весьма своеобразной
Каждому аналитику требуется освоить новую технологию и привыкнуть к ней. В моменте все еще ожидается просадка по производительности, от этого решение не спасает полностью
Для меня этот баланс плюсов/минусов показался интересным и мы попробовали реализовать эти идеи на практике.
Что дальше
В следующей части займемся самым интересным: соберем движок публикации: пайплайн, который превращает Markdown из репозитория в страницы Confluence.


Комментарии 0