Привет, Хабр!
Меня зовут Андрей Бирюков. Я — независимый эксперт в области ИТ и ИБ, преподаю в учебных центрах и пишу статьи и книги.
Сегодня мы поговорим об одной проблемной ситуации, которая наверняка знакома многим администраторам высоконагруженных систем. Представьте, как в одно прекрасное утро у сервиса под нагрузкой начинают отваливаться соединения. Администратор вполне логично идет смотреть логи и видит большое количество сообщений Too many open files. Команда ulimit -n показывает значение 65536, а то и 1048576. «Лимит же огромный, при чём тут дескрипторы?» - восклицаем мы и начинаем, что называется копать в другую сторону. То есть, бросаемся проверять сеть, нагрузку, само приложение. А проблема тем временем остается всё там же, просто мы смотрим не туда.
В этой статье мы рассмотрим три независимые сущности: сам ulimit в вашей интерактивной сессии, лимит процесса-демона и глобальные потолки ядра. И ошибка EMFILE (Too many open files`) может прийти с любого из этих уровней, и путать их значит погрязнуть в ненужном разборе.
Почему ulimit -n в шелле ничего не говорит о демоне
Параметр ulimit является атрибутом процесса и его потомков, и когда вы открываете SSH-сессию и выполняете ulimit -n, вы видите лимит вашей оболочки, унаследованный от sshd и PAM. Демон, запущенный systemd, к вашей сессии не имеет никакого отношения, так как его родитель PID 1, и лимиты он наследует от systemd, а не от вашего логина.
Именно поэтому ulimit -n в шелле может показывать потолок хоть миллион, а сервис при этом упрётся в 1024 потому что это дефолт LimitNOFILE для многих юнитов, если он не переопределён.
Для проверки этого предположения давайте проведем простой эксперимент. Запустите sleep из шелла и посмотрите его лимиты:
sleep 1000 &
cat /proc/$!/limits | grep 'open files'

Теперь запустите sleep как transient-юнит и сравните:
systemd-run --unit=test-sleep sleep 1000
cat /proc/$(systemctl show -p MainPID --value test-sleep)/limits | grep 'open files'

Если цифры различаются, то вы только что увидели проблему своими глазами. То есть лимит является свойством процесса, а не системы или пользователя.
Анатомия лимитов: три уровня, которые надо различать
Прежде чем начинать бездумно править конфиги, полезно разобраться в уровнях независимых ограничений.
Начнем с первого уровня (per-process RLIMIT_NOFILE). По сути, это то, что видно в /proc/<pid>/limits. Значение задаётся через LimitNOFILE= в юните systemd, через ulimit -n при ручном запуске или наследуется от родителя. Именно этот лимит чаще всего и подразумевается, когда говорят «лимит дескрипторов».
Второй уровень это глобальные потолки ядра. Параметр fs.file-max задаёт максимальное число открытых файлов в системе в целом, а fs.nr_open определяет максимальное значение, которое вообще можно выставить через ulimit/RLIMIT_NOFILE для одного процесса. Текущее потребление видно в fs.file-nr. Здесь важно понимать, что если упереться в nr_open, то никакой LimitNOFILE выше этого значения не сработает, даже если вы его пропишете.
Ну и третий уровень это собственно cgroup-лимиты. Здесь pids.max ограничивает число процессов и потоков в cgroup, но косвенно влияет и на сокеты. В результате, приложение, не способное создать поток для обработки соединения, будет вести себя так, будто упёрлось в дескрипторы. Кроме того, в cgroup v2 есть свои механизмы учёта, и ошибки могут приходить из разных мест.
Таким образом, ошибка EMFILE может прийти с любого из трёх уровней, и проверять надо все, а не только тот, который первым пришёл в голову.
Диагностика шаг за шагом
Наш алгоритм решения проблемы будет построен таким образом, чтобы мы могли двигаться от конкретного процесса к глобальным потолкам, а не наоборот.
Шаг 1. Разбираемся с реальным лимитом процесса. Найдите PID проблемного сервиса и посмотрите:
cat /proc/<pid>/limits | grep 'open files'

Вывод покажет и soft, и hard limit, и если soft меньше ожидаемого, то это уже ответ.
Шаг 2. Смотрим, что выставил systemd. Даже если процесс показывает одно значение, полезно понять, откуда оно взялось:
systemctl show <service> | grep LimitNOFILE
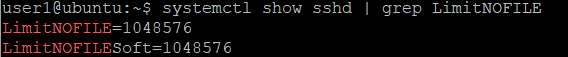
Если вывод пустой или равен 1024, а вы ждали 65536 значит правка была применена не туда или не перечитана.
Шаг 3. Теперь смотрим глобальные потолки ядра.
cat /proc/sys/fs/file-max
cat /proc/sys/fs/nr_open
cat /proc/sys/fs/file-nr
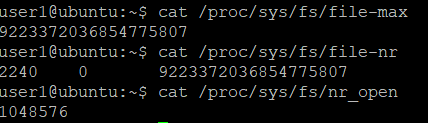
Здесь первое число означает общий потолок, второе - максимум на процесс, а третье это текущее потребление (три значения: выделено, неиспользованных, максимум). Если file-nr близко к file-max то проблема системная, и поднимать лимит конкретному сервису бессмысленно.
Шаг 4. А сколько дескрипторов реально открыто.
lsof -p <pid> | wc -l
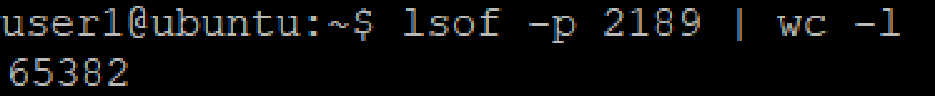
Сравните с soft-лимитом из шага 1 и если открыто близко к лимиту, то это подтверждение причины проблемы. Если же далеко, то возможно, ошибка приходит от pids.max или от нехватки памяти под структуры ядра, а не от RLIMIT_NOFILE.
Шаг 5. Самый информативный шаг, который при этом часто пропускают, это разбор по типам.
lsof -p <pid> | awk '{print $5}' | sort | uniq -c | sort -rn | head

Здесь мы отфильтровываем пятую колонку 'тип дескриптора' в выводе команды lsof. В ней могут быть значения: REG (регулярный файл), IPv4/IPv6 (сокет), FIFO (pipe), CHR (символьное устройство). Что доминирует — то и подсказывает причину. Например, много значенийREG означает утечку файлов, часто логов или временных файлов. А если много IPv4 в состоянии CLOSE_WAIT, то это означает, что приложение не закрывает сокеты после обрыва соединения. Наличие большого количества FIFO говорит о проблеме с пайпами между процессами или потоками.
Шаг 6. Если картина все еще неясна, то нам может помочь strace. С помощью этой утилиты мы на коротком отрезке времени смотрим, что приложение делает с дескрипторами:
strace -f -e trace=open,openat,close,socket,accept -p <pid>
Если видно много openat без парных close, а socket и accept идут, но close на них не приходит, то утечка подтверждена на уровне системных вызовов, и дальше уже вопрос к разработчикам.
Почему limits.conf не работает для systemd-сервисов
А теперь давайте обсудим одно из самых живучих заблуждений: «я поправил /etc/security/limits.conf, значит лимит применился». На самом деле limits.conf читается модулем pam_limits при открытии PAM-сессии, то есть при логине, su, sshd. Юнит systemd запускается не через PAM, а напрямую от PID 1, и limits.conf к нему не применяется вообще.
Важно понимать, что Systemd использует собственные настройки DefaultLimitNOFILE в /etc/systemd/system.conf (глобальный дефолт) и LimitNOFILE= в конкретном юните. При этом, drop-in файл юнита переопределяет основной юнит, который в свою очередь переопределяет DefaultLimitNOFILE, а тот встроенный дефолт в systemd.
И здесь появляется подводный камень, который заключается в том, что после правки юнита или drop-in нужно выполнить systemctl daemon-reload. Без него systemctl restart подхватит старый конфиг из памяти systemd, и вы будете искренне недоумевать, почему изменения не применились. Это, пожалуй, самая частая причина ситуаций в стиле «я всё поправил, а не работает».
Правильное исправление для systemd
Мы довольно много времени уделили диагностике проблемы и теперь давайте посмотрим, как собственно правильно ее лечить. Лучше всего не редактировать основной юнит, а создать drop-in файл. Такое изменение позволит пережить перезапись /usr/lib/systemd/system/<service>.service при обновлении пакета.
Создать свой drop-in можно командой:
sudo systemctl edit <service>
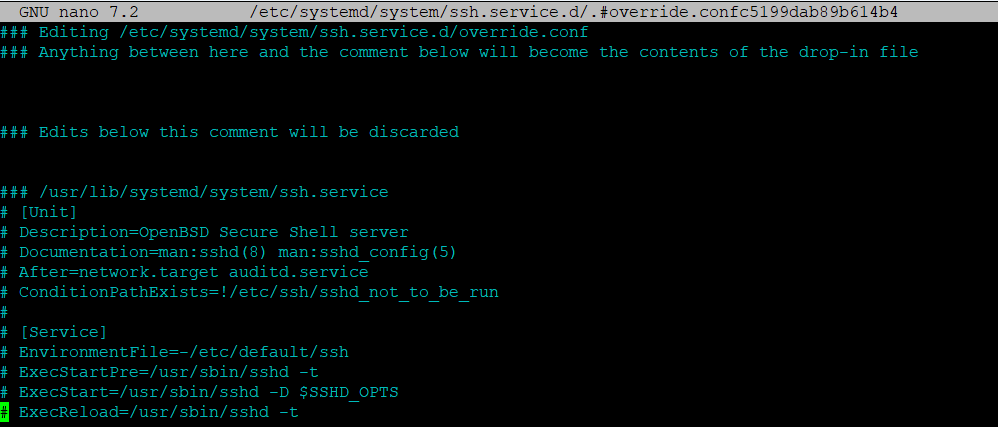
Откроется редактор, куда нужно вписать:
[Service]
LimitNOFILE=65536:65536
Формат soft:hard задаёт оба лимита. Если указать одно число, оно применится к обоим. После сохранения выполним перезапуск:
sudo systemctl daemon-reload
sudo systemctl restart <service>
А для проверки посмотрим вывод:
systemctl show <service> | grep LimitNOFILE
cat /proc/$(systemctl show -p MainPID --value <service>)/limits | grep 'open files'
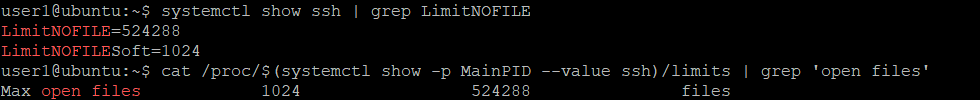
Оба вывода должны показать ожидаемое значение.
Здесь важно сделать отдельную оговорку про fs.nr_open. Если вы хотите выставить лимит выше дефолтного потолка (обычно это 1048576), придётся поднять и fs.nr_open через /etc/sysctl.d/:
fs.nr_open = 2097152
Затем выполним sysctl --system, так как без этого LimitNOFILE= со значением выше nr_open молча обрежется до потолка, и вы снова будете смотреть на «не то» число.
Когда поднимать лимит
Мы разобрались с тем, как менять лимит, но у нас остался не менее важный вопрос: а когда его нужно поднимать? Можно выставить хоть миллион, но прежде чем это делать, стоит честно ответить на вопрос является ли это легитимной нагрузкой или утечкой?
А для этого давайте сначала разберемся с каждым из этих понятий. Легитимная нагрузка это когда сервис действительно держит много соединений (reverse proxy, балансировщик, сервер баз данных с большим пулом, мессенджер с тысячами активных клиентов). Здесь поднятие лимита является правильным решением, но его нужно сопроводить расчётом того, сколько соединений ожидается в пике, сколько дескрипторов на соединение и какой запас. Иначе через месяц вы вернётесь к той же ошибке на новом потолке.
А утечкой мы назовем ситуацию, когда число дескрипторов растёт монотонно и не спадает после снятия нагрузки. Поднятие лимита здесь лишь откладывает падение, так как сервис продолжит течь и рано или поздно упрётся в новый потолок, заодно исчерпав память ядра под структуры файлов.
Отличить одно от другого помогает динамика:
watch -n 5 'lsof -p <pid> | wc -l'
Если под нагрузкой число растёт и после её снятия возвращается, то это нормально. Если растёт и не возвращается, то это скорее всего утечка. Дополнительно стоит посмотреть состояния сокетов:
ss -tanp | grep <pid> | awk '{print $1}' | sort | uniq -c
Большое количество CLOSE-WAIT является верным признаком того, что приложение не закрывает сокеты после разрыва соединения противоположной стороной. Это баг в приложении, и лимит тут не поможет.
Выводы
Итак, в сегодняшней статье мы рассмотрели ошибку Too many open files и пришли к выводу, что это не сигнал «поднять ulimit», а приглашение разобраться в трёх уровнях лимитов: per-process, глобальном и cgroup. Смотреть надо на процесс, а не на свою оболочку, то есть на вывод systemctl show и /proc/<pid>/limits, а не на ulimit -n. Также, большое значение имеет динамика и типы дескрипторов, а не только абсолютное число.
И главное это научиться отличать легитимную нагрузку от утечки. В первом случае поднятие лимита с расчётом запаса является правильным инженерным решением. А в случае утечки мы получим просто отсрочку, которая замаскирует баг и перенесет падение на более неудобный момент.
Помните, что хороший администратор тем и отличается от плохого, что чинит причину, а не симптом, даже когда симптом выглядит как «просто добавь цифру в конфиг».
С ошибкой Too many open files мы разобрались, но принцип диагностики пригодится и в других ситуациях: сначала найти причину сбоя, а уже потом менять настройки. Например, когда сайт перестал открываться или Docker-контейнер запущен, но приложение недоступно.
На двух бесплатных уроках разберём, как последовательно проверять Linux-сервер, сетевые настройки и логи, чтобы локализовать проблему.
24 ноября в 19:00. «Сайт не открывается: находим причину на Linux-сервере шаг за шагом». Записаться
8 декабря в 19:00. «Контейнер запущен, а сайт недоступен: разбираемся с Docker, портами и логами». Записаться



Комментарии 0