Локальные модели с открытыми весами всё чаще предлагают как замену облачным в агентной разработке, поскольку код не уходит наружу, а цена не зависит от чужих тарифов. Мне нужен был ответ на практический вопрос о том, можно ли дать такой модели настоящую бэкенд‑задачу — полноценный сервис с базой, очередью и правилами проекта — и получить код, который работает и эти правила соблюдает.
Я проверил четыре модели, два харнесса, по три прогона на каждую пару. Короткий ответ — почти. Лучшие пары набирают 0,80 и 0,79 по шкале от нуля до единицы, без единого замечания задачу не прошёл никто, но лучшие прогоны были в шаге от этого. Главное, что я вынес из своих экспериментов, это то, что результат определяет пара «модель + харнесс», а не одна модель, и правила проекта надёжнее отдавать инструментам, чем тексту. Остальное — описание моей методологии и результаты, а также множество историй о том, на чём агенты ломаются: часть из них вообще не про модель.
Что сравнивал
Проект и правила
Задача одна — с нуля написать сервис на FastAPI с PostgreSQL и RabbitMQ. Человека нет, спросить некого.
Задача разбита на пять шагов, как разбил бы тимлид: каркас, API, доменные правила, база, воркер очереди. Каждый шаг агент делает в новой сессии и продолжает свой же код с прошлого шага. Ошибки копятся, и если на втором шаге сервис сломан, третий начинается со сломанного. Как в жизни.
Домен нарочно синтетический, чтобы модель не узнала его по обучающим данным. Он представляет собой «дорожку» из N единиц, на которой бронируют непересекающиеся отрезки. Такую дорожку можно запечатать, а её ёмкость меняет воркер по сообщениям из очереди. Правила проекта лежат в AGENTS.md — по сути чистая архитектура с элементами DDD. От агента требовалось не просто написать рабочий код, а сделать это по соглашениям, определенным в проекте.
Сложность здесь в том, что часть решений можно проверить каким‑нибудь автоматизированным инструментом, и это, к сожалению, не самая большая часть. Если разобрать, какое правило как можно проверить, получится вот такая таблица:
Правило | Чем проверяется |
Слои domain → application → infrastructure → api; домен и use case не импортируют FastAPI, SQLAlchemy, драйверы | import‑linter |
Зависимость от абстракций: use case работает с хранилищем через интерфейс из внутреннего слоя, реализация в infrastructure; зависимости приходят снаружи | судья |
Инварианты живут в домене, ровно в одном месте; сначала проверить, потом менять состояние | тесты поведения + судья |
Транзакцией владеет use case через unit of work; репозитории и обработчики не делают commit | судья |
Домен не смешан с ORM; ошибки драйвера не выходят за infrastructure; ошибки в HTTP переводятся в одном месте | тесты + судья |
Строгие типы, линтер, docstring у публичного API | mypy ‑strict, ruff |
Не строить абстракции «на будущее»; не удалять и не ослаблять тесты ради зелёного прогона | судья |
Половину правил инструментом не проверить — для этого и нужен судья, которого нужно также правильно собрать.
Модели и харнессы
Моделей четыре, все с открытыми весами: Qwen3.8–27B, Gemma 4 31B, Nemotron 3 Super и Devstral 2. Все запускались локально через vLLM с одинаковым окном контекста и лимитами.
Почему эти модели. Я брал открытые модели, которые хвалили для агентного программирования и которые помещаются в мои ресурсы. Хотелось сравнить разные семейства и архитектуры. Qwen3.8–27B и Gemma 4 31B — модели среднего размера, 27 и 31 млрд параметров. Nemotron 3 Super — MoE‑модель с гибридной архитектурой (Mamba + трансформер): из 120 млрд параметров активны 12 млрд. Devstral 2 — 123 млрд параметров, модель Mistral для агентной разработки.
Харнесса взял два: opencode 1.18.34 и OpenHands 1.6.0. Итого восемь пар, по три прогона: 24 прогона по пять шагов. Лимит — 2 часа на шаг.
Почему эти харнессы. Оба реально используют в разработке. Оба не привязаны к модели: работают через OpenAI‑совместимый API. А ещё они устроены по‑разному. Если opencode — это терминальный агент, то OpenHands представляет собой платформу потяжелее со своими инструментами, своим Python, детектором зацикливания. Оба харнесса работали у меня в одном и том же контейнере.
Фирменные харнессы разработчиков моделей (Qwen Code, Mistral Vibe и подобные) я не брал, так как они заточены каждый под свою модель.
Как оценивал
Кратенько мой метод оценивания суммаризирует таблица ниже:
Слой | Что проверяет | Чем |
Поведение | Сервис делает то, что требует задание | 68 скрытых тестов чёрным ящиком, через HTTP и RabbitMQ. Агент их не видит. |
Правила проекта | Код написан так, как принято в проекте | 8 общих проверок: линтер, типы, границы слоёв, свои тесты зелёные, конфиги не тронуты. Теми же инструментами, что в самом проекте. |
Архитектура | То, что тестом не поймать: кто владеет транзакцией, нет ли лишних абстракций | LLM‑судья, 22 критерия с оценкой 0–2. Отдельный балл, с основным не смешивается. |
Прежде чем мерить модели, я проверил сами тесты. Важно было убедиться, что правильное решение их проходит, а неправильное — нет.
Правильное — эталон. Для каждого шага его написал Claude Code в отдельной сессии, не видя тестов, а тесты писались отдельно и эталона не видели. Я прочитал эталон и принял его. Бенч считался готовым, только когда эталон проходил все проверки на 1,0.
Неправильные — 23 испорченные версии эталона с правдоподобными ошибками, в основном их придумал Codex. Это проверка, что тесты вообще ловят ошибки, и поначалу они ловили не всё. Так, на первом шаге 3 из 6 испорченных версий проходили, а одна, у которой /ready отвечал за 62 секунды вместо 5, получала полный балл. Я дописал тесты, и теперь каждую испорченную версию ловят тесты её шага.
Архитектуру оценивал LLM‑судья Claude Fable. Поскольку эталон тоже писал Claude, первого судью я сверил со вторым судьёй другой семьи — GPT-5.6-Sol от OpenAI — и получил точное совпадение в 27 случаях из 30, остальные же остались в пределах одного уровня. Спорные случаи я разобрал сам.
Каждую пару «модель × харнесс» я прогнал три раза. За шаг агент получает балл от 0 до 1 — долю пройденных проверок поведения и правил. Если не пройдена обязательная проверка (например, миграции не применяются к пустой базе) или агент не уложился вовремя, шаг получает ноль, сколько бы остального ни прошло. Балл прогона — среднее по пяти шагам. В таблицах для каждой пары — медиана трёх прогонов, в скобках худший и лучший. Оценку судьи показываю отдельным числом и в основной балл не подмешиваю.
Справился ли кто‑то
Без единого замечания — никто, но близко. Лучший прогон, Qwen на opencode, прошёл все проверки поведения, включая самую трудную, и споткнулся только о линтер — 0,96. С pre‑commit хуком, который запускает линтер сам, один прогон дошёл до 0,99.
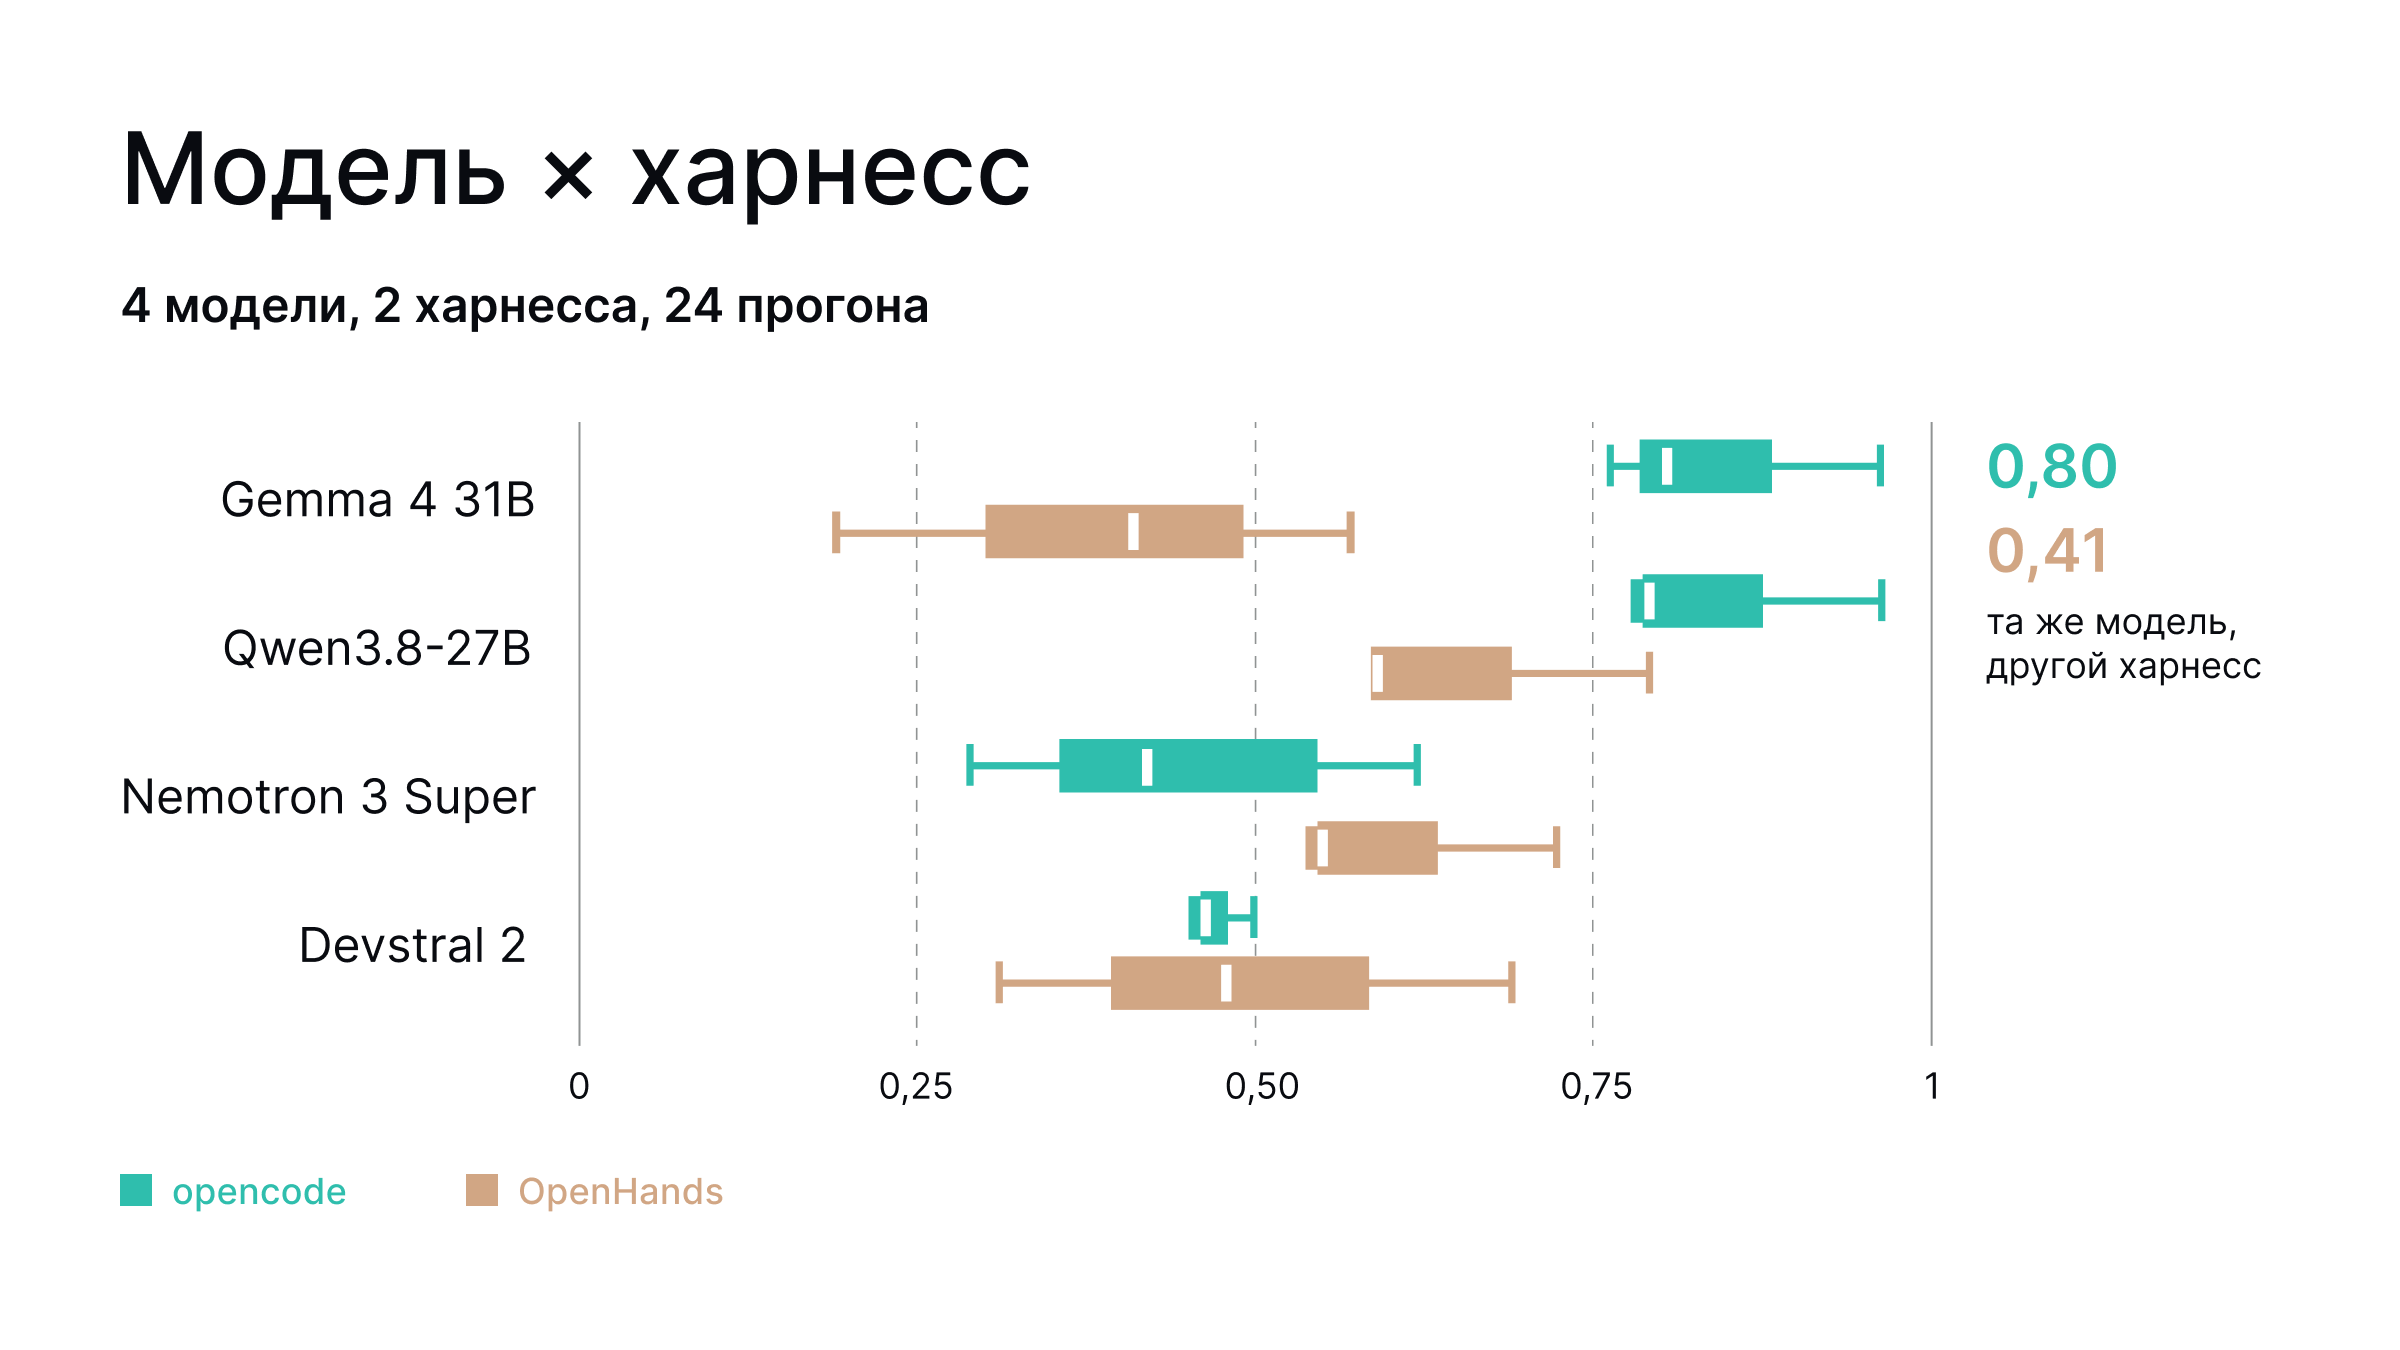
Впереди две пары, обе на opencode: Gemma — 0,80 [0,76–0,96], Qwen — 0,79 [0,78–0,96]. Разницу в сотую при таком разбросе я различием не считаю: это ничья. Третья — Qwen на OpenHands, 0,59. Медианы остальных пяти пар — от 0,41 до 0,55, и между собой они не упорядочиваются: диапазоны перекрываются.
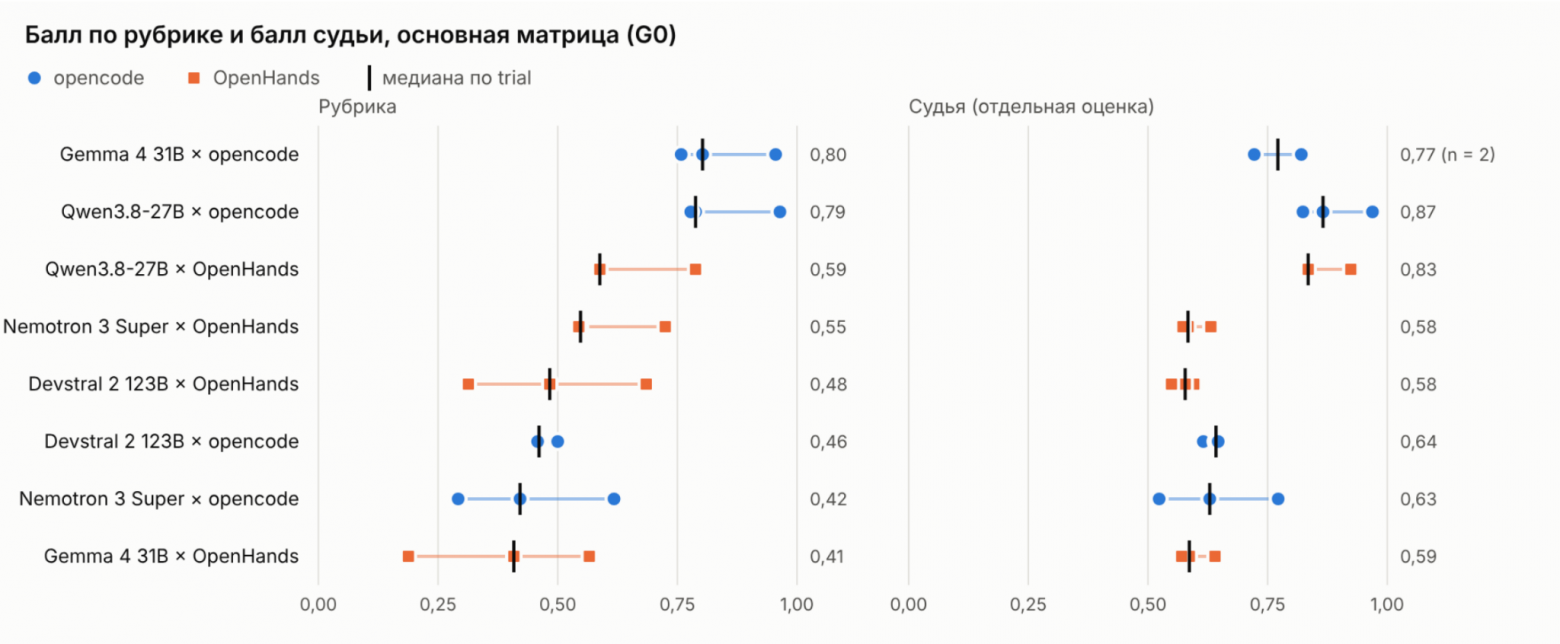
Ничья по качеству — не то же самое, что ничья по цене. Прогон Gemma на opencode — это 72 минуты и 145 тыс. сгенерированных токенов. Прогон Qwen — 227 минут и 596 тыс. Втрое дольше и вчетверо больше токенов за тот же балл.
Судья, правда, ставит Qwen выше: 0,87 против 0,77 у Gemma. Я читаю это как наблюдение, нежели признание, что Qwen пишет чище: по тестам и проверкам пары равны. У Gemma судья оценил два прогона из трёх: в третьем агент сам повредил git‑историю, и снимков кода для судьи не осталось — об этом ниже, в истории про sed. Тесты и проверки правил шли во время прогона, поэтому по ним у всех пар по три прогона.
Медиана прячет ещё одно различие — надёжность. Если смотреть на 68 проверок шагов по трём прогонам, Gemma стабильнее: 81% проверок она проходит все три раза (pass^3), Qwen — 69%. Зато Qwen чаще проходит редкие проверки, почти все — из пятого шага.
Теперь главное. Та же Gemma, те же задания, тот же сервер, но харнесс OpenHands — и балл 0,41 вместо 0,80. Диапазоны прогонов не пересекаются. У Qwen они едва перекрываются, у Nemotron и Devstral разница внутри разброса. Так что вопрос «какая модель лучше» поставлен неточно: сравнивать приходится пары «модель + харнесс».
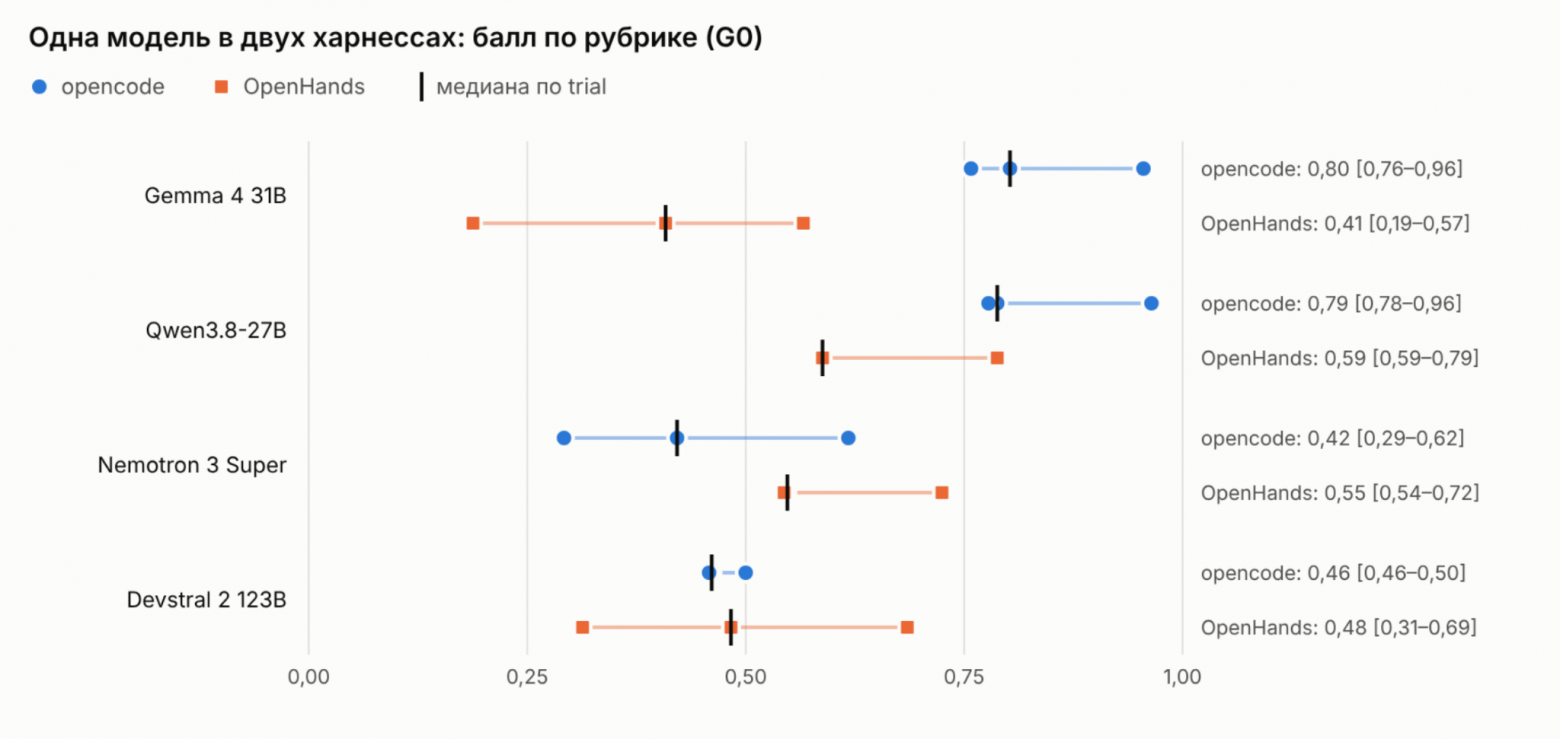
Ещё два наблюдения. У Qwen на OpenHands все четыре обнулённых шага — из‑за лимита времени. А дёшево не значит годно: Devstral на opencode тратит всего 114–188 тыс. токенов на прогон, но на шагах 4–5 сервис у него нерабочий во всех трёх прогонах.
Где же чаще всего теряются баллы? Крупнейшие разрывы между парами — в основном на пятом шаге, где потребители очереди — это повторы, идемпотентность, переподключение. А самая трудная отдельная проверка сидит в первом шаге — с неё, пожалуй, и начну.
На чём ломаются
Кто проверил — тот и сделал
Самая трудная проверка выглядит безобидно. Сервис работает, база на ходу перестаёт отвечать, соединения остаются открытыми. /ready должен за 10 секунд вернуть 503. Прошли 2 прогона из 24.
Из 22 провалов 17 — зависание: ответа нет вовсе. У 15 из этих 17 код по сути одинаковый — таймер asyncio вокруг соединения из пула:
async with asyncio.timeout(READY_TIMEOUT_SECONDS):
    async with engine.connect() as conn:
    await conn.execute(text("SELECT 1"))
Выглядит правильно. Один агент — Qwen на opencode — не поверил и проверил: поднял поддельный сервер PostgreSQL, который принимает соединение и замолкает. На это ушло около 130 ходов из 169. Его вывод:
"Even a fully‑established connection with an in‑flight query hangs in
asyncpg close (timeout=2)past 6s against a silent server… I must use raw asyncpg withterminate()."«Даже полностью установленное соединение с запросом в полёте висит в
asyncpg close (timeout=2)дольше 6 с на молчащем сервере… Нужен чистый asyncpg сterminate().»
То есть таймер срабатывает, но выход из блока ждёт ответа сервера. Это наблюдение агента, сам я механизм не воспроизводил. В 24 прогонах сценарий проверил он один — и он же прошёл. Второй прошедший создавал новый engine на каждый запрос, то есть нарушил правило проекта «один engine на процесс». Тест, тем временем, этого не видит.
Файл портится при записи
Gemma на OpenHands перезаписывает файл обычной командой:
cat <<EOF > /app/src/tracksvc/api/app.pyКоманда корректна, но в файле текст оказывается дважды, а посередине — строка EOF > /app/…. Синтаксическая ошибка, и сервис в итоге сломан. Так испорчены 5 файлов в 2 прогонах из трёх.
Задвоение было только без кавычек. У Gemma heredoc без кавычек, <<EOF, задвоился в 17 вызовах из 24, а с кавычками, <<'EOF', — ни разу из 9. Qwen и Nemotron на том же харнессе пишут только с кавычками: 0 из 97. Почему терминал OpenHands 1.6.0 так себя ведёт, я не выяснял; это корреляция, а не найденная ошибка.
Агент порчу заметил:
"The output showed it was writing the EOF block twice or something."
«Вывод показал, что блок EOF записался дважды или вроде того.»
И повторил ту же команду — 4 раза. У OpenHands есть детектор зацикливания: четыре одинаковых действия подряд, и сессия оборвана. Как следствие, следующий шаг начался со сломанным файлом.
Правило харнесса сильнее правила проекта
В одном из вариантов эксперимента задание требовало закончить шаг коммитом. На длинных шагах история перестаёт помещаться в окно, и харнесс сжимает её в пересказ. После сжатия коммиты пропали: на 13 таких шагах без финального коммита агент ни разу даже не вызвал git commit.
Qwen объяснил причину сам, в рассуждении:
"Per the system prompt: 'NEVER commit changes unless the user explicitly asks you to…' This is not an explicit request to commit."
«По системному промпту: „НИКОГДА не коммить, пока пользователь явно не попросит…“ Явной просьбы о коммите нет.»
Это фраза из системного промпта opencode. Она есть в каждом запросе, а требование из задания после сжатия осталось только в пересказе. Шаг закончился вопросом “Want me to create the git commit?”— человеку, которого нет.
Я перенёс правило в AGENTS.md, который попадает в системное сообщение каждого запроса. Не помогло: на шагах со сжатием коммит появился в 1 случае из 6. У Qwen причина названа в двух шагах. У Gemma её не видно, о коммите она просто не упоминает.
Думает, но не делает
Qwen на opencode на 2 шагах из 15 прочитал несколько файлов и начал планировать. В рассуждении! План вышел на 125 000 символов в одном случае и на 136 682 в другом: сущности, тесты, проверка гонок — весь шаг, только не в файлах. После чтения файлов инструментов больше не вызывал. Ответ упёрся в лимит 32 000 токенов и оборвался, а opencode счёл шаг законченным.
Последняя целая фраза одного из планов:
"Now, before writing, let me check the environment: python version, uv availability, DB reachable."
«Теперь, прежде чем писать, проверю окружение: версию python, наличие uv, доступность базы.»
До «писать» дело не дошло.
Ради одного пробела
Gemma на opencode, первый шаг. Линтер ругается на пробел в конце одной строки миграции. Правка не помогла, и агент решил вопрос радикально:
"Actually, I’ll just use
bashto remove trailing whitespace from all files."«Проще через
bashубрать пробелы в конце строк во всех файлах.»
find . -type f -exec sed -i 's/[[:space:]]*$//' {} +
«Все файлы» — это весь каталог проекта вместе с .git и .venv. Дальше segfault при импорте pydantic_core. Агент трижды переустановил библиотеки и решил: "The installation was corrupted" — установка была повреждена. С sed он сбой не связал. История git повреждена, снимки шагов потеряны — поэтому у этого прогона и нет оценки судьи. Один прогон из трёх, но запоминается.
Что помогает
Проделанный эксперимент показался мне весьма поучительным и навёл на некоторые выводы.
Проверять инструментом, а не текстом. Я добавил pre‑commit‑хук, который запускает проверки проекта. У Qwen на opencode линтер без хука проходил на 10 шагах из 15, с хуком — на 15 из 15. На общий балл эффект по трём прогонам не установлен, но конкретное правило стало выполняться всегда. Модели при этом пользуются проверкой по‑разному: Qwen запускал её сам, Gemma — ни разу, у неё проверки шли только через хук. Оборотная сторона — в истории про коммит: хук срабатывает, только когда агент коммитит, а текстовое правило не обеспечило коммит даже в системном сообщении. Обязательное действие надёжнее вынести туда, где воля агента не нужна, — в CI.
Сначала проверить задание, потом менять модель. Когда агент раз за разом ошибается в одном месте, виновата может быть не модель, а формулировка. Я проверил это на двух таких местах.
Первое — порядок проверок в воркере: повторное сообщение надо распознать как дубликат раньше, чем проверять его тело. Требование в задании было, но стояло в конце абзаца цепочкой стрелок, и Gemma в 2 прогонах из 3 делала наоборот. То же требование переписали нумерованным списком, ничего не добавив, — и ошибка пропала.
Второе — проверка с замолчавшей базой. Там переформулировка не помогла: 0 из 3 до и после. Так что приём срабатывает не всегда, но проверить его дешевле, чем менять модель. Ещё лучше — не ждать провалов и отдавать задание на ревью другому агенту до работы.
Не верить зелёным тестам агента. В 19 прогонах с зелёными тестами я проверил мутационным тестированием, насколько тесты покрывают код: в код вносятся мелкие ошибки, и смотрится, ловят ли их тесты агента. Треть таких ошибок не задевает ни один тест — этот код тесты даже не вызывают. Совет: смотреть не только на зелёные тесты, но и на покрытие и CRAP (сложность × непокрытость) по функциям.
Запускать агента там, где ничего не жалко. В истории про пробел один sed испортил .git и .venv: агенту хватило прав на всё, что он видел. У меня агент работал в одноразовом контейнере, и это стоило одного прогона. В рабочем репозитории это стоило бы истории.
Проверить настройки харнесса. Nemotron на OpenHands с лимитом 300 ходов на шаг набрал 0,20: лимит оборвал 9 шагов из 15. С лимитом 600 — 0,55. Модель та же, харнесс тот же, изменён один параметр, который я считал аварийным. На графиках выше — вариант с 600.
Итог
Ответ на вопрос из заголовка — почти. Лучшие пары пишут сервис по правилам проекта на 0,80 из 1, отдельные прогоны — до 0,96. Начинать я бы стал с Gemma на opencode, так как у неё тот же балл, что у Qwen, но втрое быстрее и вчетверо меньше токенов.
Что я взял себе:
выбирать пару «модель + харнесс», а не модель: одна и та же Gemma — это 0,80 и 0,41;
обязательные правила выносить в инструмент — хук, CI, — а не в текст;
запускать агента в одноразовом контейнере с копией репозитория: одна команда способна испортить
.git;если агент стабильно ошибается в одном месте, сначала проверить задание, а лучше заранее отдать его на ревью другому агенту;
зелёные тесты агента — не доказательство: проверять их мутационными тестами, смотреть на покрытие и CRAP;
настройки харнесса тоже влияют на результат: проверять лимиты и детектор зацикливания.
Ну и про ограничения сказать тоже надо. Каждую пару я прогнал всего три раза, на одной задаче и одном стеке, поэтому, если результаты двух пар перекрываются, как у Gemma и Qwen, я не говорю, что одна лучше. Причины провалов я восстанавливал по коду и логам, а не проверял отдельными опытами. На другой задаче, другом стеке или с другой версией харнесса картина может быть иной.
Методика, все таблицы и ограничения — в репозитории: https://github.com/SergeyArc/dev-agent-bench.

Комментарии 0