Привет, Хабр! На связи Даниэль из InfoWatch, разработчик решений класса информационной безопасности. В предыдущей статье мы рассматривали задачу контроля целостности в среде Linux с помощью системного интерфейса fanotify. Поговорили о том, решает ли fanotify проблемы более старого инструмента — inotify.
Часть существенных недостатков менее совершенного механизма inotify была закрыта более продвинутым fanotify, однако и он, в свою очередь, не является «серебряной пулей» в теме решения задач мониторинга файлов. Заключительная часть статьи указывала на ряд недочётов, которые злоумышленник может использовать в ходе запутывания следов.
В рамках этой статьи хотелось бы поговорить о ещё более сложном инструменте ядра Linux — eBPF.
Введение
Начнём с краткой сводки. eBPF представляет собой технологию ядра Linux, позволяющую выполнять пользовательский безопасный код внутри пространства ядра ОС без изменения исходного кода ядра и без перезагрузки системы. Почему «безопасный»? Откуда такая уверенность в том, что горе-программист не загрузит в ядро косячный код? Перед загрузкой программ идёт стадия верификации. Верификатор eBPF — это встроенный в ядро Linux защитный модуль, который проверяет каждый байткод перед его запуском. Он гарантирует, что программа безопасна, не уронит систему, не зависнет в бесконечном цикле и не получит доступ к чужой памяти; более подробно с информацией по этой теме можно ознакомиться тут.
Область применения eBPF гораздо шире, чем у inotify и fanotify, потому что разработчик вправе сам написать почти любую бизнес-логику, которая будет выполняться в ядре. Если рассматривать механизм только с позиции задачи мониторинга файлов, то здесь eBPF ближе к fanotify, так как он тоже позволяет из-под user space управлять событиями kernel-характера. Правда, делается это гораздо сложнее.
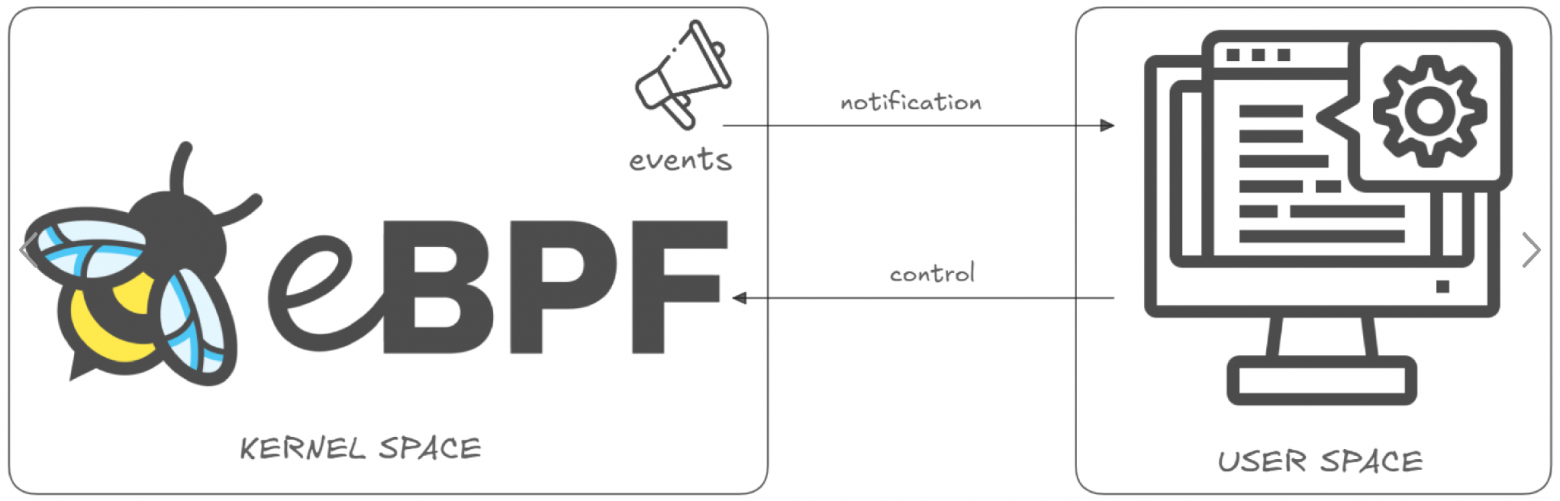
Интерфейс ранее рассмотренных inotify и fanotify очень прост, с eBPF всё сложнее. В статье про fanotify API ядра рассматривался вкупе с языком программирования Go, в этой статье поступим точно так же.
Механизм следующий.
Условно задачу отслеживания файловых событий можно разбить на два уровня:
низкий уровень (так называемый data plane); собственно, уровень самого eBPF и языка C
высокий уровень (так называемый control plane); собственно, уровень работы с eBPF-событиями и языка Go
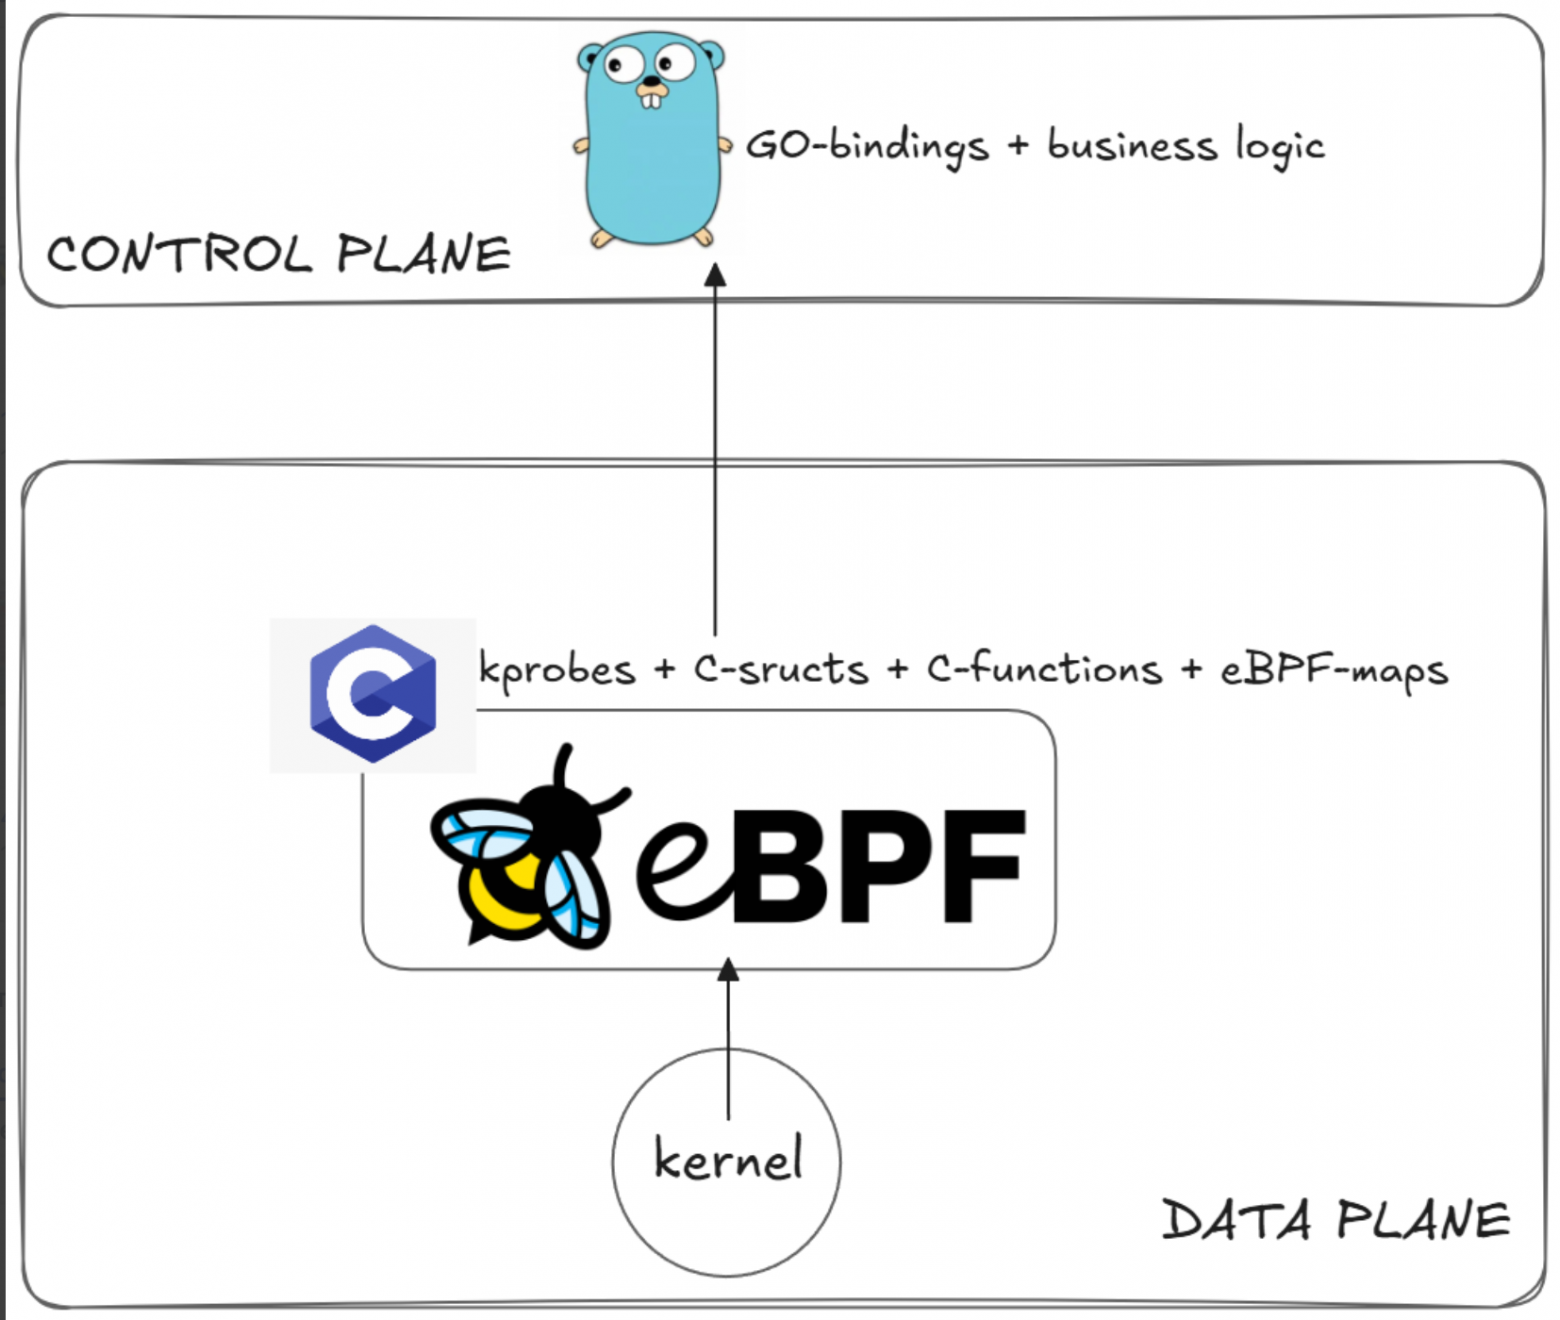
Все eBPF-функции и структуры данных (map-ы) пишутся на С. eBPF-логика с точки зрения кода представляет собой набор kprobe-секций, внутри которых описан ряд инструкций, необходимых для исполнения в kernel space. Механизм kprobe в Linux позволяет внедрять пользовательскую логику в начало функции ядра: когда ядро доходит до этой функции, оно сохраняет состояние регистров, выполняет описанную eBPF-логику, восстанавливает регистры и продолжает выполнение.
Далее C-шную логику следует обвязать так, чтобы с ней можно было взаимодействовать из-под языка Go. Для этого используется LLVM и специальные утилиты (например, bpf2go). Пример команды генерации может выглядеть вот так:
go run github.com/cilium/ebpf/cmd/bpf2go -target bpfel -cc clang fim fim.bpf.c -- -I. -O2 -g -target bpf -D__TARGET_ARCH_x86Команда запускает кодогенератор из пакета cilium/ebpf. Ключик -target bpfel указывает на то, для какой архитектуры генерировать Go-обвязку (в данном случае bpfel, то есть BPF, little-endian, а может быть ещё bpfeb, то есть BPF, big-endian). Эта часть команды сгенерирует файл fim_bpfel.go, содержащий Go-шные обвязки структур и функций. Далее идёт ключик -cc clang, указывающий утилите, какой C-компилятор использовать для преобразования C-шного файла fim.bpf.c в eBPF байт-код (-cc clang fim fim.bpf.c, fim — это префикс генерируемого Go-файла). Дальше идут флаги компиляции clang-а (-- -I. -O2 -g -target bpf -D__TARGET_ARCH_x86). Флаг -I. указывает на то, что поиск важных для компиляции заголовочных файлов "vmlinux.h" и "bpf_tracing.h" будет происходить локально в текущей директории. Флажок -O2 — это оптимизация уровня 2, -g указывает на необходимость генерировать отладочную информацию, а -target bpf говорит clang-у, что компилировать надо не для x86, а для виртуальной машины eBPF.
Тестовое ПО
Необходимый минимум информации у нас есть, но, к сожалению, его недостаточно для полного понимания всех примеров, которые будут использоваться в статье для исследования и анализа отличий от fanotify в плане функциональности.
Чтобы облегчить понимание материала, на каждую рассматриваемую ситуацию, описанную в предыдущей статье, будем создавать свою программу. Так у нас выйдет набор маленьких и простых для чтения утилит. Но каждую из них мы будем разбирать досконально.
Говорим о проблемах
Достаточно ли метаданных предоставляет eBPF с точки зрения ИБ?
Здесь всё зависит от разработчика. Если он «попотеет» и напишет такой код, который покрывает весь спектр необходимых для security observability событий, то да, достаточно.
Давайте же «попотеем» вместе.
В качестве эталонного возьмем событие fanotify, а точнее C-шную структуру данных, которая описывает его:
struct fanotify_event_metadata {
    __u32 event_len;
    u8 vers;
    u8 reserved;
    __u16 metadata_len;
    __aligned_u64 mask;
    s32 fd;
    s32 pid;
};
Выделим самые важные поля:
mask— маска, по которой можно определить тип события (модификация, изменение дискреционных атрибутов и так далее)fd— файловый дескриптор, указывающий на то, с каким файлом связано событиеpid— идентификатор процесса, послужившего причиной возникновения события
А в чем именно мы заинтересованы с точки зрения бизнес-логики? Нас, как офицера безопасности, интересует:
тип события (что конкретно случилось)
с каким файлом оно связано
кто послужил триггером события (какой пользователь)
какая программа была триггером
Отлично, наша собственная структура, описывающая событие, может выглядеть как-то так:
struct event {
    __u32 event_type;
    char filename[256];
    u32 uid;
    u32 pid;
};
Поле event_type мы определяем самостоятельно, поэтому тип события классифицируем с помощью констант:
#define FIM_MODIFY      (1 << 0) // модификация файла
#define FIM_ATTRIB      (1 << 1) // изменение дискреционных атрибутов
#define FIM_DELETE      (1 << 2) // удаление файла
#define FIM_MOVE        (1 << 3) // перемещение файла
Что дальше? Событие мы описали, его виды с помощью констант кластеризовали. Теперь нам нужно сказать нашей eBPF-программе, куда мы будем их складывать. В eBPF основным инструментом для хранения и обмена информацией между программами ядра и пользовательским пространством служат специальные структуры данных eBPF-maps. Они представляют собой хранилища типа «ключ — значение» разных типов. Опишем map-у для хранения событий (именно «опишем», а не «объявим» или «определим», так как по факту мы пишем что-то вроде конфигурации, но на языке C, используя специальные макросы):
struct {
    // Типом будет являться BPF_MAP_TYPE_PERF_EVENT_ARRAY
    // Отлично подходит для нашего случая (очередь событий)
    __uint(type, BPF_MAP_TYPE_PERF_EVENT_ARRAY);

    // Размер ключа будет 4 байта (тип unsigned int)
    __uint(key_size, sizeof(__u32));

    // Размер значения тоже будет 4 байта
    __uint(value_size, sizeof(__u32));

  // с помощью этой директивы мы поместили нашу map-у "events" в специальную секцию .maps
  // при загрузке libbpf ее там найдет, все будет работать
} events SEC(".maps");
Супер. Двигаемся постепенно: от простого к сложному. Пока что нас интересует работа с регулярными файлами. Вспомним, каким образом можно идентифицировать файл в системе. По специальной структуре file_handle, как это делает fanotify, как альтернатива — по inode, как (предположительно) это делает inotify. Возьмем второй вариант, так как он более простой.
Мы пишем собственную программу, поэтому и API нам приходится продумывать самостоятельно. Чтобы не тратить много времени, будем исходить из принципа единообразия, так как интерфейсы механизмов inotify и fanotify очень похожи друг на друга:
/* Интерфейс inotify /
int inotify_init (void);         // инициализация подписки
int inotify_init1 (int __flags); // (версия с флагами)

int inotify_add_watch (int fd, const char name, uint32_t __mask); // добавить путь ФС в подписку

int inotify_rm_watch (int fd, int wd); // убрать путь ФС из подписки


/*Интерфейс fanotify*/
// Создать и инициализировать fanotify группу.
extern int fanotify_init (unsigned int flags, unsigned int event_f_flags)
  __THROW;

// Добавить/удалить или модифицировать объект файловой системы.
extern int fanotify_mark (int __fanotify_fd, unsigned int __flags,
  uint64_t mask, int dfd, const char pathname)
     THROW;
Создание eBPF-группы мы опустим (по факту нам нужна только одна группа, так как наша демо-программа делает одно действие — следит). Итак, нам нужно придумать API-функцию, которая будет добавлять в отслеживание / убирать из отслеживания файловый путь.
Как мы уже с вами договорились, идентифицировать объект файловой системы будем не путём, а с помощью inode. Пускай преобразованием path --> inode занимается Go-шная часть программы (более высокий уровень), а C-шная часть будет заниматься хранением интересующих пользователя inodes.
Где их хранить? В eBPF-maps:
struct {
    // В качестве типа возьмем хэш-таблицу
    __uint(type, BPF_MAP_TYPE_HASH);

    // Ограничиваем макс. кол-во значений (увы, так надо)
    __uint(max_entries, 1024);

    // Ключ — это inode, в ядре описывается как unsigned long
    type(key, u64);

    // Фиктивное значение очень маленького размера
    // Оно нам не нужно, по факту нужна не хэш-таблица, а хэш-сет
    // Но такого среди eBPF-maps нет
    type(value, u8);

  // Тоже регистрируем нашу "watched_inodes" в секции maps
} watched_inodes SEC(".maps");
С контейнерами для хранения данных разобрались, теперь нужно рассмотреть механизм kprobe, с помощью которого мы внедрим свою пользовательскую логику в ядро.
Технически это делается следующим образом:
Используется директива SEC(
kprobe/<имя функции ядра>)Под ней пишется функция-обработчик
Пример:
SEC("kprobe/vfs_read")
int trace_vfs_read(struct pt_regs ctx) {
    /your custom logic here*/
}
В примере в качестве <имени функции ядра> используется vfs_read. Она нужна для отслеживания системного вызова read().
Давайте вспомним, какие маски событий мы использовали в статье с fanotify:
FAN_MODIFY (модификация): соответствует
vfs_writeFAN_ATTRIB (смена атрибутов): соответствует
notify_changeFAN_DELETE_SELF (удаление файла): соответствует
vfs_unlinkFAN_MOVE_SELF (перемещение файла): соответствует
vfs_rename
Важный нюанс: на самом деле, флаги fanotify не маппятся на kprobe секции один к одному. Например, к FAN_MODIFY можно отнести ещё vfs_truncate и vfs_fallocate. В рамках данной статьи усложнять не будем.
Итак, нам осталось только написать собственные функции-обработчики на все интересующие нас события.
Чтобы не раздувать статью, рассматривать каждую по отдельности не будем, детально разберем лишь одну. С оставшимися вы сможете самостоятельно ознакомиться на GitHub.
Разбор:
SEC("kprobe/vfs_write")
int trace_vfs_write(struct pt_regs ctx)
{
    // 1.Объявляем объект события, пока он пустой
    struct event e = {};

    // 2.Из контекста берем объект file
    // Он нам нужен, так как хранит в себе много полезной метаинформации
    struct file filp = (struct file )PT_REGS_PARM1(ctx);

    // 3.По объекту file получаем inode
    // Используем макрос BPF_CORE_READ
    // Важно использовать именно его, так как он специально создан для поддержки CO-RE
    // CO-RE = compile once, run everywhere
    struct inode inode = BPF_CORE_READ(filp, f_inode);

    // 4.Если inode нам не интересна, то выходим из функции и ничего не делаем
    // Функция is_watched_inode отвечает на вопрос, интересна inode или нет
    // Она проверяет наличие inode в watched_inodes
    if (!is_watched_inode(inode))
        return 0;

    // 5.Заполняем поля события
    // Используем хелпер-функцию fill_meta
    // Внутри:
    // e->pid = bpf_get_current_pid_tgid() >> 32; побитовый сдвиг для того, чтобы взять только pid без tgid
    // e->uid = bpf_get_current_uid_gid();
    fill_meta(&e, FIM_MODIFY);

    // 6.Читаем filename
    // Важно: снова используем CO-RE макрос (BPF_CORE_READ_INTO)
    const unsigned char *name;
    BPF_CORE_READ_INTO(&name, filp, f_path.dentry, d_name.name);
    bpf_probe_read_kernel_str(e.filename, sizeof(e.filename), name);

    // 7.Кладем событие в нашу map-у
    bpf_perf_event_output(ctx, &events, BPF_F_CURRENT_CPU, &e, sizeof(e));
    return 0;
}
Придирчивый читатель мог заметить: почему в структуре event поле называется filename, а не filepath? Причина кроется в ограниченности eBPF и kprobe. Чтобы получить полный путь к файлу, можно либо перейти с механизма kprobe на fentry/fexit (это сложно), либо идти вверх по d_parent и склеивать имена вместо одиночного вызова BPF_CORE_READ_INTO(&name, filp, f_path.dentry, d_name.name); (это хрупко, лимиты verifier-а на циклы и прочее).
С C-шной частью закончили, триггер на каждое событие готов. Теперь переходим к Go-шной части, в которой концентрируем бизнес-логику и обвязку.
Первое, что нам нужно описать, — это Go-шные аналоги C-шной структуры, описывающей событие контроля целостности, а также константы, кластеризующие вид события:
// Аналог C-шной структуры, описывающей событие
type FimEvent struct {
EventType uint32    // тип события
Uid       uint32    // идентификатор пользователя
Pid       uint32    // идентификатор процесса
Filename  [256]byte // имя файла, по которому пришло событие
}

const (
FIM_MODIFY = 1 << 0 // модификация
FIM_ATTRIB = 1 << 1 // смена атрибутов
FIM_DELETE = 1 << 2 // удаление файла
FIM_MOVE   = 1 << 3 // перемещение файла
)
Далее пользуемся пакетом os, чтобы наша программа умела принимать аргументы командной строки (а именно путь к регулярному файлу, события которого мониторим). И при помощи того же пакета определяем inode, который необходим нам для передачи в C-шную часть.
Оставшаяся часть программы будет состоять из пяти шагов:
Загрузка BPF (C-шной части)
objs := fimObjects{} // внутренняя структура, полученная с помощью утилиты bpf2go
if err := loadFimObjects(&objs, nil); err != nil { // загружаем BPF
    log.Fatal("Loading eBPF objects:", err)
}
defer objs.Close()

var one uint8 = 1
if err := objs.WatchedInodes.Put(ino, one); err != nil { // начинаем отслеживать inode
    log.Fatal("Adding watched inode:", err)
}
Здесь ключевое — это вызов функции loadFimObjects, которая была автоматически сгенерирована на основе базового C-шного файла.
2. Связывание C-шных функций-обработчиков с kprobes
kpWrite, err := link.Kprobe("vfs_write", objs.TraceVfsWrite, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_write:", err)
}
defer kpWrite.Close()

kpAttr, err := link.Kprobe("notify_change", objs.TraceSetattr, nil)
if err != nil {
    log.Fatal("Attaching kprobe notify_change:", err)
}
defer kpAttr.Close()

kpDelete, err := link.Kprobe("vfs_unlink", objs.TraceDelete, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_unlink:", err)
}
defer kpDelete.Close()

kpMove, err := link.Kprobe("vfs_rename", objs.TraceMove, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_rename:", err)
}
defer kpMove.Close()
Обратите внимание: для связывания используется пакет "github.com/cilium/ebpf/link", публичная функция Kprobe, которая прикрепляет указанную kprobe к конкретному обработчику. Например, в строке kpWrite, err := link.Kprobe("vfs_write", objs.TraceVfsWrite, nil) мы накладываем на kprobe vfs_write обработчик objs.TraceVfsWrite, то есть при каждом срабатывании vfs_write будет вызываться тот код, который мы написали в C-шной функции trace_vfs_write (в Go-шной обвязке это objs.TraceVfsWrite).
3. Чтение eBPF-событий
events, err := perf.NewReader(objs.Events, os.Getpagesize()*64)
if err != nil {
    log.Fatal("Creating perf reader:", err)
}
defer events.Close()
Здесь используется пакет "github.com/cilium/ebpf/perf" для инициализации reader-а событий.
4. Задание обработчика сигнала остановки
sig := make(chan os.Signal, 1)
signal.Notify(sig, os.Interrupt)
5. Непосредственно сам мониторинг и реакция на событие (просто логирование)
fmt.Printf("FIM eBPF monitor started on %s (inode=%d). Press Ctrl+C to stop.\n",
    watchPath, ino)

go func() {
    var event FimEvent
    for {
        record, err := events.Read()
        if err != nil {
            log.Println("Reading from perf buffer:", err)
            continue
        }

        if err := binary.Read(bytes.NewBuffer(record.RawSample),
            binary.LittleEndian, &event); err != nil {
            log.Println("Parsing event:", err)
            continue
        }

        // 6.Handle event (analog of your handler for fanotify)
        handleEvent(event)
    }
}()
Самое приятное: запускаем программу и проверяем работоспособность на каждом событии:
make all -C 1.security_metadata_reg_file/
sudo 1.security_metadata_reg_file/security_metadata_reg_file test.txt
Смотрим вывод:
sudo 1.security_metadata_reg_file/security_metadata_reg_file test.txt
FIM eBPF monitor started on test.txt (inode=71802). Press Ctrl+C to stop.
[ATTRIB] PID=1898 UID=1000 FILE=test.txt
[MODIFY] PID=1898 UID=1000 FILE=test.txt
[ATTRIB] PID=20240 UID=1000 FILE=test.txt
[MOVE] PID=20287 UID=1000 FILE=test.txt
[DELETE] PID=20381 UID=1000 FILE=new_name.txt
Первые два события относятся к модификации через VS Code, третье — изменение атрибутов через chmod, далее идёт переименование через mv, наконец — удаление через rm.
Код рассмотренного тестового ПО.
Не слишком ли много событий генерирует eBPF?
Всё равно слишком много.
Во время использования как inotify, так и fanotify возникает проблема, которая сказывается именно на обрабатывающей события стороне. Дело в том, что вместо одного ожидаемого события можно получить сразу несколько. Этот недостаток не так очевиден, если рассматривать само EDR-приложение (endpoint detection and response). Но если подойти со стороны SIEM-системы, у которой сотни (или даже тысячи) EDR-агентов в качестве источников, то последствия очевидны: резкое увеличение нагрузки на модули корреляции и агрегации.
Мы уже знаем, что это обусловлено механизмами работы с файлами различных редакторов. Так, чтобы перехватить все происходящие под капотом события, нужно доработать тестовое ПО так, чтобы оно умело работать с директориями.
Дорабатываем тестовое ПО.
Во-первых, у нас появляется два дополнительных вида событий:
#define FIM_MODIFY      (1 << 0)
#define FIM_ATTRIB      (1 << 1)
#define FIM_DELETE      (1 << 2)
#define FIM_MOVE        (1 << 3)
#define FIM_CREATE_IN   (1 << 4) // новый вид события для работы с директориями
#define FIM_DELETE_IN   (1 << 5) // новый вид события для работы с директориями
Во-вторых, появляются новые обработчики событий, связанных с директориями. Приводить здесь код каждого не станем, чтобы не раздувать статью, но перечислим каждый:
функция
trace_create_inна "kprobe/security_inode_create": создание файла внутри директориифункция
trace_mkdir_inна "kprobe/vfs_mkdir": создание папки внутри директориифункция
trace_delete_inна "kprobe/vfs_unlink": удаление файла внутри директориифункция
trace_rmdir_inна "kprobe/vfs_rmdir": удаление папки внутри директориифункция
trace_rmdir_selfна "kprobe/vfs_rmdir": удаление самой директориифункция
trace_modify_inна "kprobe/vfs_write": модификация файла внутри директориифункция
trace_attrib_inна "kprobe/notify_change": изменение атрибутов объекта внутри директории
В-третьих, в Go-шной части добавляются дополнительные связки:
kpCreateIn, err := link.Kprobe("security_inode_create", objs.TraceCreateIn, nil)
if err != nil {
    log.Fatal("Attaching kprobe security_inode_create:", err)
}
defer kpCreateIn.Close()

kpModifyIn, err := link.Kprobe("vfs_write", objs.TraceModifyIn, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_write (modify in):", err)
}
defer kpModifyIn.Close()

kpAttribIn, err := link.Kprobe("notify_change", objs.TraceAttribIn, nil)
if err != nil {
    log.Fatal("Attaching kprobe notify_change (attrib in):", err)
}
defer kpAttribIn.Close()

kpMkdirIn, err := link.Kprobe("vfs_mkdir", objs.TraceMkdirIn, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_mkdir:", err)
}
defer kpMkdirIn.Close()

kpDeleteIn, err := link.Kprobe("vfs_unlink", objs.TraceDeleteIn, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_unlink (delete in):", err)
}
defer kpDeleteIn.Close()

kpRmdirIn, err := link.Kprobe("vfs_rmdir", objs.TraceRmdirIn, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_rmdir (delete in):", err)
}
defer kpRmdirIn.Close()

kpRmdirSelf, err := link.Kprobe("vfs_rmdir", objs.TraceRmdirSelf, nil)
if err != nil {
    log.Fatal("Attaching kprobe vfs_rmdir (self):", err)
}
defer kpRmdirSelf.Close()
Смотрим результат работы:
# Запуск
sudo 2.security_metadata_directory/security_metadata_directory test_folder/

# Вывод
FIM eBPF monitor started on directory test_folder/ (inode=184288). Press Ctrl+C to stop.

# Создание файла с помощью VS Code
[CREATE_IN] PID=1898 UID=1000 FILE=NEW.txt
[MODIFY] PID=1898 UID=1000 FILE=NEW.txt

# Его модификация через редактор nano
[CREATE_IN] PID=7999 UID=1000 FILE=.NEW.txt.swp
[MODIFY] PID=7999 UID=1000 FILE=.NEW.txt.swp
[DELETE_IN] PID=7999 UID=1000 FILE=.NEW.txt.swp
[CREATE_IN] PID=7999 UID=1000 FILE=.NEW.txt.swp
[MODIFY] PID=7999 UID=1000 FILE=.NEW.txt.swp
[ATTRIB] PID=7999 UID=1000 FILE=NEW.txt
[MODIFY] PID=7999 UID=1000 FILE=NEW.txt
[DELETE_IN] PID=7999 UID=1000 FILE=.NEW.txt.swp

# Смена атрибутов через chmod
[ATTRIB] PID=8627 UID=1000 FILE=NEW.txt

# Удаление через rm
[DELETE_IN] PID=8898 UID=1000 FILE=NEW.txt

# Создание через mkdir
[CREATE_IN] PID=9395 UID=1000 FILE=INNER_DIR

# Удаление через rmdir
[DELETE_IN] PID=9532 UID=1000 FILE=INNER_DIR
Обратите внимание на модификацию: nano использует swp-файлы во время изменения содержимого файла. Логика редактора понятна: создать временную копию файла, вносить изменения в неё, после чего подменить изменяемый файл копией.
Как и в случае с inotify/fanotify, eBPF не избавляет разработчика от задачи агрегации событий на стороне endpoint-а. Однако здесь у программиста значительно больше пространства для маневра.
Код рассмотренного тестового ПО.
Если пользователь удалит контролируемый файл, продолжится ли его мониторинг?
Продолжится, но при определенных условиях.
Посмотреть устройство inotify и fanotify под капотом можно в коде ядра Linux, а в случае с eBPF разработчик сам придумывает тот параметр, которым будет характеризовать объект файловой системы. Для стороннего пользователя этим параметром является путь в файловой системе, в то время как для рассматриваемой в данной статье eBPF-программы — inode.
Так, во время передачи аргумента (пути к файлу) тестовому ПО происходит определение inode подконтрольного объекта, поэтому все перехватываемые с помощью eBPF события будут связаны с конкретным inode. Чтобы убедиться в этом, зафиксируем inode подконтрольного файла до удаления и после нового создания, а для эксперимента возьмем тестовое ПО, работающее с регулярными файлами.
# inode объекта ДО удаления:
stat test.txt

# Вывод:
  File: test.txt
  Size: 6               Blocks: 8          IO Block: 4096   regular file
Device: 8,48    Inode: 20320       Links: 1
Access: (0644/-rw-r--r--)  Uid: ( 1000/  agirre)   Gid: ( 1000/  agirre)
Access: 2026-09-30 10:41:12.730827234 +0300
Modify: 2026-09-30 10:41:12.707131539 +0300
Change: 2026-09-30 10:41:12.707131539 +0300
 Birth: 2026-09-30 10:41:11.061484426 +0300
Видим строку Inode: 20320, отлично, теперь запускаем демо-программу:
sudo ./1.security_metadata_reg_file/security_metadata_reg_file test.txt

# Первичный вывод программы:
FIM eBPF monitor started on test.txt (inode=20320). Press Ctrl+C to stop.
Демо-программа «зацепилась» за inode, равный 20320. Теперь мы удаляем файл и тут же его создаем. «Тут же» ограничивается скоростью человеческих действий, то есть на ручное создание файла вновь порядка 5-10 секунд.
удаление:
# Удаление файла через rm
rm test.txt

# Лог демо-программы в этот момент:
[DELETE] PID=4940 UID=1000 FILE=test.txt
создание вновь в том же месте:
# Создание через touch
touch test.txt

# Лог демо-программы в этот момент:
[ATTRIB] PID=4968 UID=1000 FILE=test.txt
Обратите внимание, что создание файла вновь регистрируется как событие смены дискреционных атрибутов, для полноты картины можно было бы добавить в C-шную часть логику перехвата событий создания.
повторная проверка inode заново созданного файла:
# inode объекта ПОСЛЕ удаления:
stat test.txt

# Вывод:
  File: test.txt
  Size: 0               Blocks: 0          IO Block: 4096   regular empty file
Device: 8,48    Inode: 20320       Links: 1
Access: (0644/-rw-r--r--)  Uid: ( 1000/  agirre)   Gid: ( 1000/  agirre)
Access: 2026-09-30 10:50:12.652211852 +0300
Modify: 2026-09-30 10:50:12.652211852 +0300
Change: 2026-09-30 10:50:12.652211852 +0300
 Birth: 2026-09-30 10:50:12.646984165 +0300
Это точно по-новому созданный объект, так как значение после Birth обновилось. До удаления значение было 2026-09-30 10:41:11.061484426 +0300, а после — 2026-09-30 10:50:12.646984165 +0300.
модификация заново созданного файла:
# Модификация через echo
echo "HELLO!" >> test.txt

# Лог демо-программы в этот момент:
[MODIFY] PID=3080 UID=1000 FILE=test.txt

# Проверка через stat самого файла (stat test.txt):
  File: test.txt
  Size: 7               Blocks: 8          IO Block: 4096   regular file
Device: 8,48    Inode: 20320       Links: 1
Access: (0644/-rw-r--r--)  Uid: ( 1000/  agirre)   Gid: ( 1000/  agirre)
Access: 2026-09-30 10:54:15.546730034 +0300
Modify: 2026-09-30 10:54:15.468585579 +0300
Change: 2026-09-30 10:54:15.468585579 +0300
 Birth: 2026-09-30 10:50:12.646984165 +0300
Вызов stat на файл после его модификации показывает ровно такое же значение Birth, как после повторного создания, а вот Modify отличается, значит задетектированные демо-программой изменения относятся к тому же самому объекту файловой системы.
Это здорово, ведь с точки зрения бизнес-логики объект файловой системы характеризуется просто его путём, а не inode или же file_handle. Так, рядовой пользователь даже после удаления и повторного создания увидит события. Но полагаться на это поведение всё же не стоит, ведь не зря в начале данного параграфа есть оговорка «при определенных условиях». В данном конкретном тестовом случае нам повезло, inode 20320 не был занят, поэтому ОС присвоила новому test.txt прежний inode.
Будут ли отображаться изменения у вновь созданного объекта, если inode уже будет занят? Нет. Более того, всё гораздо запутаннее. Рассмотрим сложный сценарий:
Возьмем test.txt с его inode 20320
# stat test.txt:
  File: test.txt
  Size: 0               Blocks: 0          IO Block: 4096   regular empty file
Device: 8,48    Inode: 20320       Links: 1
Access: (0644/-rw-r--r--)  Uid: ( 1000/  agirre)   Gid: ( 1000/  agirre)
Access: 2026-09-30 11:46:15.752579463 +0300
Modify: 2026-09-30 11:46:14.712575533 +0300
Change: 2026-09-30 11:46:14.712575533 +0300
 Birth: 2026-09-30 11:46:14.712575533 +0300
2. Запустим eBPF-программу, она «зацепится» за inode = 20320
# sudo ./1.security_metadata_reg_file/security_metadata_reg_file test.txt:
FIM eBPF monitor started on test.txt (inode=20320). Press Ctrl+C to stop.
3. Внесем какие-либо изменения в test.txt, убедимся, что они логируются программой
4. Удалим test.txt и тут же создадим в этой же папке несколько новых файлов
# rm test.txt:
[DELETE] PID=17230 UID=1000 FILE=test.txt # отображается в логе!


# touch new1.txt new2.txt new3.txt:
[ATTRIB] PID=17298 UID=1000 FILE=new1.txt # по логу программы видно, что inode 20320 получил файл new1.txt

# stat new1.txt:
  File: new1.txt
  Size: 0               Blocks: 0          IO Block: 4096   regular empty file
Device: 8,48    Inode: 20320       Links: 1 # Убеждаемся в том, что теперь inode 20320 указывает на new1.txt, а не test.txt
Access: (0644/-rw-r--r--)  Uid: ( 1000/  agirre)   Gid: ( 1000/  agirre)
Access: 2026-09-30 11:46:54.026146885 +0300
Modify: 2026-09-30 11:46:52.771504136 +0300
Change: 2026-09-30 11:46:52.771504136 +0300
 Birth: 2026-09-30 11:46:52.765543039 +0300
5. Только теперь создадим test.txt, его inode уже не равен 20320
# touch test.txt && stat test.txt:
  File: test.txt
  Size: 0               Blocks: 0          IO Block: 4096   regular empty file
Device: 8,48    Inode: 63490       Links: 1 # Другой inode!
Access: (0644/-rw-r--r--)  Uid: ( 1000/  agirre)   Gid: ( 1000/  agirre)
Access: 2026-09-30 11:50:26.552139491 +0300
Modify: 2026-09-30 11:50:26.552139491 +0300
Change: 2026-09-30 11:50:26.552139491 +0300
 Birth: 2026-09-30 11:50:26.552139491 +0300
6. Внесем изменения в заново созданный test.txt — программа их не заметит, в логе тишина
7. Внесем изменения в new1.txt — программа нам о них сообщает!
# после изменений new1.txt:
[ATTRIB] PID=6782 UID=1000 FILE=new1.txt
[MODIFY] PID=6782 UID=1000 FILE=new1.txt
Вот и сломался стандартный пользовательский сценарий бизнес-логики. Нам был интересен test.txt, его мы подали программе в качестве параметра запуска, а изменения теперь приходят вообще по new1.txt, который нам вовсе не нужен. При этом сам test.txt, с точки зрения пользователя всё ещё существующий "по тому же пути", больше не наблюдаем.
Вывод: всё-таки лучше привести логику в соответствие с inotify/fanotify, то есть при удалении файла полностью прекращать его мониторинг, так как это более детерминированное поведение. Добиться этого можно путём доработки Go-шной части, достаточно доработать функцию handleEvent так, чтобы в момент возникновения события DELETE убирать из мониторинга inode (этого можно добиться путём вызова метода Delete у объекта, описывающего eBPF-map).
Что с рекурсивностью при работе с директориями?
Её нужно реализовывать самостоятельно.
За основу возьмем демо-программу, работающую с директориями. Доработаем её так, чтобы при возникновении события CREATE_IN новое значение inode попадало в eBPF-map, а в случае с DELETE_IN — удалялось. Здесь доработка является довольно сложной архитектурной задачей, так как есть некоторые довольно ощутимые препятствия:
В самом событии нет inode, то есть нет возможности легко и просто добавить новый объект в отслеживание
В случае с
CREATE_INможно было бы воспользоваться join-ами по родительской директории, в которой событие возникло, чтобы получить полный путь к новому объекту (он нам нужен для получения недостающего inode). Так, в Go-шной части нужно вести реестр соответствия "inode --> путь". Но одного только лишь реестра тут недостаточно; событие несёт только имя, причём лишь последний компонент пути без указания директории, где произошел инцидент; допустим, мы контролируем папку top, внутри неё — наблюдаемые поддиректории A и B, обе в реестре; прилетаетCREATE_IN FILE=f. Где это случилось — в A или в B — однозначного понимания нет. Реестр умеет резолвить связку "inode --> путь", но не умеет определять, какой именно inode нужно искать. Можно перебирать кандидатов и проверять существованиеtop/A/f,top/B/f, но еслиfесть в обеих папках, мы молча возьмем inode не того файла и начнем наблюдать за ним, а если созданный объект к моменту обработки события уже удален (временные файлы редакторов живут миллисекунды),statпо всем кандидатам вернет ошибку, и мы не добавим ничего, хотя событие было. Выход — обогатить событие полемparent_ino:inode директории, внутри которой событие возникло. Тогда цепочка в Go-шной части сходится:parent_ino--> по реестру получаем путь родителя --> склеиваем с именем из события -->stat--> inode нового объекта --> пополняем eBPF-map.В случае с
DELETE_INситуация иная, так как после удаления файла нет и резолвить join-ами нечего, поэтому здесь в C-шной части надо обогащать само событие полем inode, чтобы знать, что из map-ы удалять.
Вывод: обогащать событие двумя полями (parent_ino и ino).
Массовое дублирование событий
Конечно же, событие дочернего объекта по цепочке рождает и событие родительского, в итоге пачка event-ов на один фактический результат. Кстати, ровно эту проблему мы наблюдаем в inotify и fanotify, поэтому для статьи усложнять ничего не будем, просто проигнорируем этот факт и будем с ним жить.
2. Начальное состояние
В Go-шной части обязательно нужно будет рекурсивно пройтись по всем узлам дерева указанной директории, чтобы реестр "inode --> путь" был заполнен полностью.
3. Перемещение — отдельная головная боль.
Представьте, что мы из контролируемой директории переместим какой-либо объект наружу, что тогда? С позиции пользователя мониторинг должен прекратиться, ведь объект более не в дереве, однако программе на это наплевать, ведь она смотрит на inode. Он не поменяется, значит события продолжат приходить.
А если переместить что-либо снаружи внутрь дерева? Опять-таки, нужно анализировать и тестировать, проявится ли это событие в eBPF-программе так, чтобы можно было зарегистрировать в map новый inode.
В общем, данный пункт мы тоже оставим и делать с ним ничего не будем, иначе демо-программа рискует превратиться в open source мини-проект.
Итог: огромное количество нюансов, которые нам нужно учитывать полностью самостоятельно, в то время как fanotify в принципе сделал это всё за нас, причём довольно неплохо.
Тем не менее, мы попытаемся и напишем собственную реализацию. Я не буду в деталях объяснять то, как именно реализованы пункты 1-4, но подчеркнуть некоторые детали стоит. Ключевая проблема в реализации рекурсии связана с тем, что в Go-слой события из C-части прилетают слишком рано.
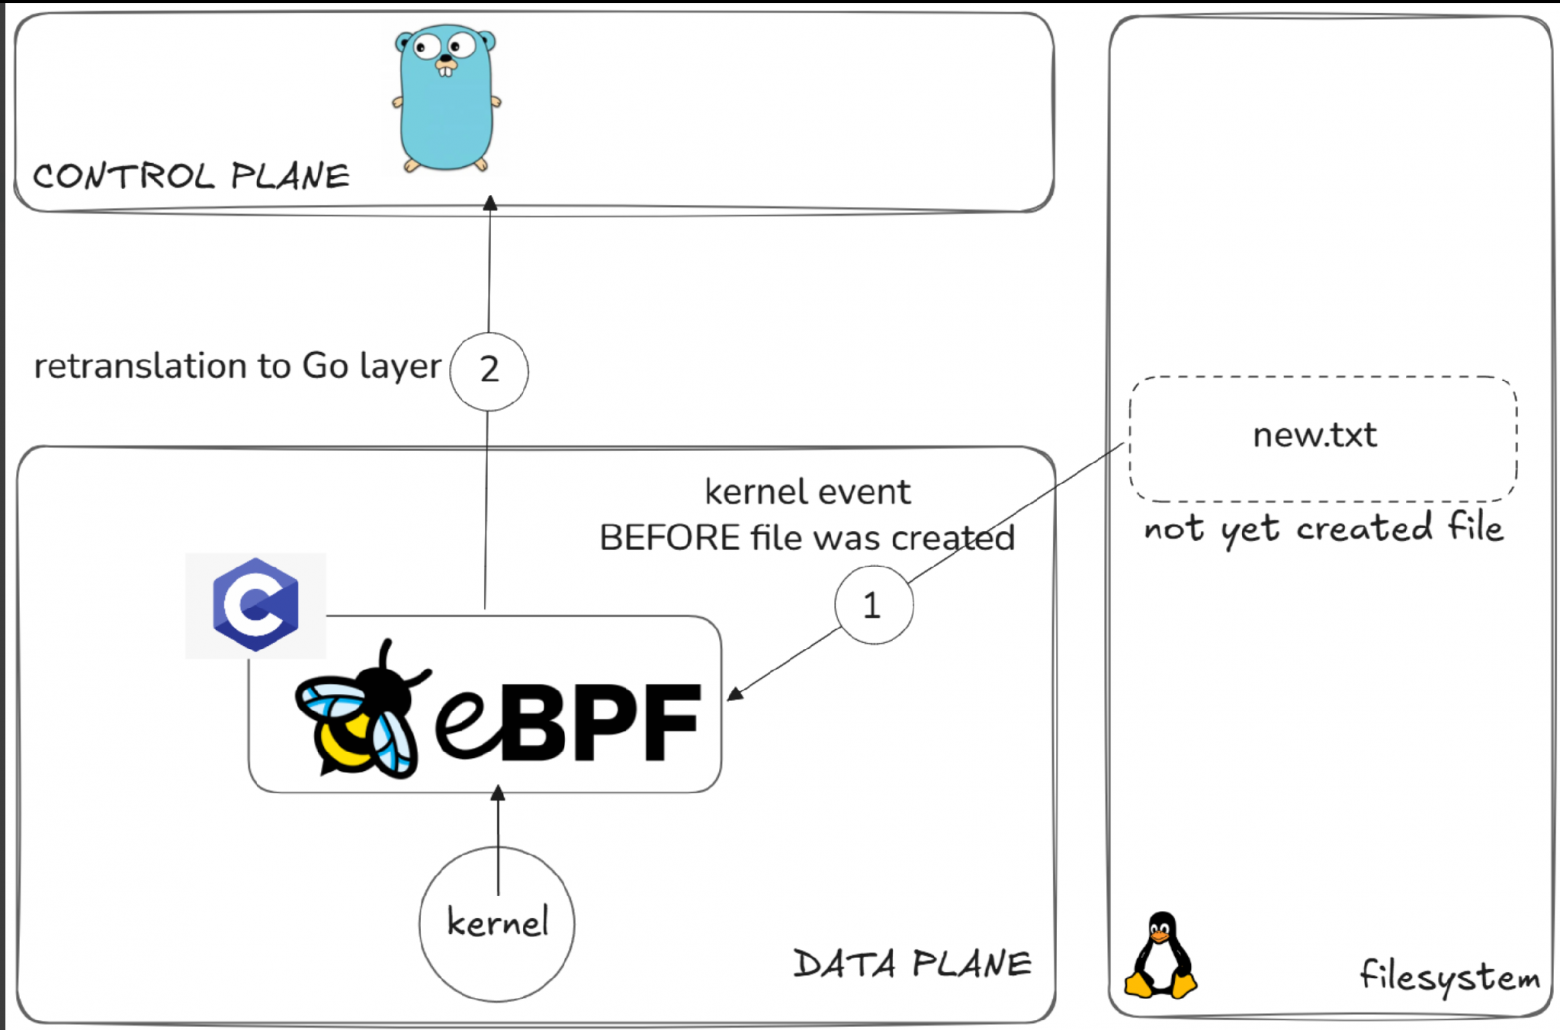
Рассмотрим проблему на примере (схема выше). Как только пользователь начинает создавать файл new.txt, в eBPF-слой уже приходит событие. Почему? Все дело в том, что логика, описанная в С-части и базирующаяся на kprobes, срабатывает на входе в секцию. Шаг 2 на схеме сообщает демо-программе о создании объекта, хотя фактически он ещё пока не был создан. Событие прилетает в Go раньше, чем объект физически появится на диске. Поэтому, если в Go-шной части писать логику определения inode через полный путь, то можно запросто напороться на ошибку ENOENT, то есть новый созданный в подконтрольном дереве файл под мониторинг не попадет. В C-шном слое тоже проблематично реализовать определение inode, чтобы обогатить им событие, ведь файл ещё не создан, ОС пока не присвоила ему никакого inode.
Для статьи я выбрал максимально простую идею — N повторных попыток определения inode через полный путь:
for attempt := 0; attempt < 5; attempt++ {
    info, err = os.Lstat(path) // Lstat: do not follow symlinks
    if err == nil {
        break
    }
    time.Sleep(time.Duration(1<<attempt) * time.Millisecond)
}
Полная версия самостоятельно реализованной и написанной «на коленке» рекурсии.
А если написать логику рекурсивности самостоятельно, то будут ли ограничения на количество отслеживаемых объектов?
Будут.
Простой эксперимент: написанной в предыдущем шаге программе подадим в качестве параметра запуска домашнюю директорию /home, в ней у меня примерно 230 тысяч элементов:
# find /home | wc -l:
229789
Запуск программы:
# sudo ./3.security_metadata_dir_recursive/security_metadata_dir_recursive /home/:
2026/10/01 14:41:23 Walking watch tree:update: key too big for map: argument list too long
Жаль, ведь с точки зрения бизнеса пользователь с очень высокой вероятностью захочет мониторить довольно большую директорию, а не тестовый экземпляр. В ситуациях с inotify/fanotify мы поднимали лимиты, здесь поступим точно таким же образом:
// файл fim.bpf.c
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 262144); // значение было 1024
    type(key, u64);
    type(value, u8);
} watched_inodes SEC(".maps");
После повышения лимитов и пересборки события пошли:
# sudo ./3.security_metadata_dir_recursive/security_metadata_dir_recursive /home/:
FIM eBPF monitor started on directory /home/ (inode=24577, watching 229789 inodes). Press Ctrl+C to stop.
[ATTRIB] PID=1004 UID=1000 INO=0 FILE=rus.md
[ATTRIB] PID=1004 UID=1000 INO=42385 FILE=rus.md
[MODIFY] PID=1004 UID=1000 INO=0 FILE=rus.md
[MODIFY] PID=1004 UID=1000 INO=42385 FILE=rus.md
[CREATE_IN] PID=1004 UID=1000 INO=0 FILE=eVmL.md
[ATTRIB] PID=1004 UID=1000 INO=0 FILE=eVmL.md
[ATTRIB] PID=1004 UID=1000 INO=0 FILE=eVmL.md
[ATTRIB] PID=1004 UID=1000 INO=0 FILE=eVmL.md
[ATTRIB] PID=1004 UID=1000 INO=0 FILE=eVmL.md
[DELETE_IN] PID=1004 UID=1000 INO=186635 FILE=ikQL.md
[DELETE] PID=1004 UID=1000 INO=186635 FILE=ikQL.md
[MODIFY] PID=26122 UID=1000 INO=0 FILE=GitLens.log
[MODIFY] PID=26122 UID=1000 INO=71771 FILE=GitLens.log
[MODIFY] PID=26122 UID=1000 INO=0 FILE=GitLens (Git).log
[MODIFY] PID=26122 UID=1000 INO=71772 FILE=GitLens (Git).log
[ATTRIB] PID=1004 UID=1000 INO=0 FILE=entries.json
[ATTRIB] PID=1004 UID=1000 INO=44518 FILE=entries.json
# .................................................................
Круто! Можем ли мы завышать лимиты до бесконечности? Нет. В конце концов мы упрёмся в ограничение по памяти, причём той, что используется в ядре.
С версии ядра 5.11 память eBPF учитывается в memory control groups (memcg) . То есть до версии 5.11 ядро само вело учёт, сколько памяти за собой закрепил конкретный пользователь через BPF (внутри ядра за это отвечали функции bpf_map_charge_init() и __bpf_prog_charge(...)), а зарезервированный объём вычитался из пользовательского лимита RLIMIT_MEMLOCK, который перед загрузкой программы приходилось поднимать вручную (ulimit -l). Если лимит был превышен, загрузка завершалась ошибкой EPERM.
После версии 5.11 менеджмент памяти был переведён на рельсы memcg (memory control groups). Это подсистема ядра, на которой базируются все аллокаторы по вопросам docker-контейнеров, лимитов в Kubernetes и так далее. Проще говоря, учёт памяти стал автоматическим.
Так что как только памяти в ядре будет не хватать, возникнет ошибка ENOMEM.
Посмотрим, хватит ли памяти в краевом случае отслеживания всего корня файловой системы (путь /).
У меня порядка 900 тысяч элементов:
# sudo find / -type f | wc -l
908531
Выставим в наш max_entries ближайшую степень двойки, превышающую это значение (это 2 в 20-й степени, то есть 1 048 576), немного скорректируем Go-шный слой так, чтобы при рекурсивном обходе дерева фатальные ошибки не приводили к падению программы, после чего запустим на тестовой директории.
Стоп! Почему на тестовой?!
Очень важный нюанс: память выделяется под max_entries при загрузке eBPF map-ы, ещё до обхода дерева. Файлов может быть хоть один, память всё равно будет выделена так, чтобы хватило max_entries.
Имея это в виду, можно нащупать потолок памяти, в который программа в конце концов упрётся. Будем постепенно наращивать max_entries и снимать значение потребляемой программой памяти. Но так как память используется в ядре ОС (через memcg), то и фиксировать её потребление будем особым образом:
# запускаем программу как transient-unit
# она получает собственный cgroup, файл "memory.current" показывает ровно её потребление с учетом "ядерного" пула
sudo systemd-run --unit=fimdemo --collect \
    "$PWD/4.security_metadata_dir_recursive_limits/security_metadata_dir_recursive_limits" \
    "$PWD/test_dir"

# производим замер
cat /sys/fs/cgroup/system.slice/fimdemo.service/memory.current

# даём программе поработать некоторое время и завершаем
sudo systemctl stop fimdemo.service
Приведённые выше команды снятия замеров очень важны. Программа будет занимать память из ядра ОС, а использование рядовых утилит по типу ps или htop будет отображать RSS процесса (Resident Set Size), в нём нет «ядерной» памяти.
Итак, постепенно наращиваем max_entries и заполняем таблицу:
max_entries | Потребляемая память |
|---|---|
1024 | ~12.43Mb |
1048576 | ~92.95Mb |
16777216 | ~1.26Gb |
67108864 | ~5.01Gb |
134217728 | ~9.3Gb |
134217729 | - |
На моём WSL граница — это 134217728, так как уже при 134217729 программа не запускается:
# sudo ./4.security_metadata_dir_recursive_limits/security_metadata_dir_recursive_limits test_dir/:
2026/10/04 18:25:33 Loading eBPF objects:assign values: field TraceAttribIn: program trace_attrib_in: map watched_inodes: map create: argument list too long
Вернемся к бизнес-требованиям. Зачастую заказчик желает мониторить всю файловую систему машины целиком, на моей WSL всего порядка миллиона элементов. Путем интерполяции значений в таблице вычисляем потребляемую память: 90–95 Мб. Если говорить про EDR-приложение, которое инсталлируется на конечную одиночную машину, являющуюся объектом АСУ ТП, то это слишком много.
Осталось ещё посмотреть на потребление CPU. В программу добавим небольшой фрагмент кода, который будет снимать CPU-нагрузку и выводить её в файл, после чего при помощи утилиты языка Go проанализируем результат.
# 1.Проверяем размер директории для теста
find /home/ | wc -l # вывод: 247154

# 2.Запускаем
sudo ./4.security_metadata_dir_recursive_limits/security_metadata_dir_recursive_limits /home/

# 3.Некоторое время даём поработать и вносим изменения в test_dir/
FIM eBPF monitor started on directory /home/ (inode=24577, watching 247161 inodes, skipped 0 entries). Press Ctrl+C to stop.
[ATTRIB] PID=1527 UID=1000 INO=0 FILE=vscode.lock
[ATTRIB] PID=1527 UID=1000 INO=151857 FILE=vscode.lock

# 4.Останавливаем и смотрим результаты профилирования программы
go tool pprof -http=:8080 cpu.out
Посмотрим на flame graph:
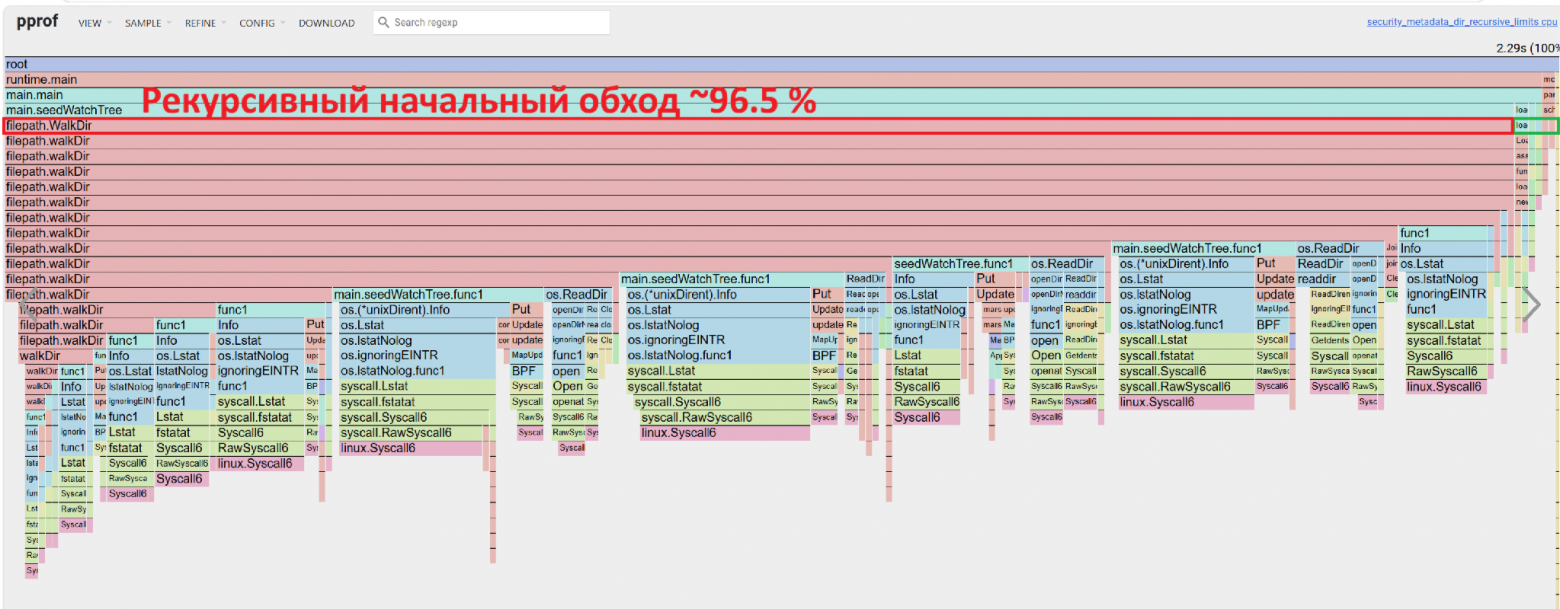
Чем шире полоска, соответствующая функции, тем больше % CPU потребляет функция относительно других. На начальный рекурсивный обход всего дерева потребовалось 96.5 %, на всё остальное — 3.5 %, то есть самая полезная работа по отслеживанию довольно слабо грузит CPU.
Полная версия рассматриваемой в параграфе программы.
Будут ли проскальзывать события?
Да, но в случае с eBPF «проскальзыванием» это назвать нельзя.
Здесь для разработчика всё прозрачно, так как именно он пишет логику. В C-шной части программы одна запись в eBPF-map — это один отслеживаемый inode. Переполнение во время работы приведет к молчаливому упущению событий, так как под новые объекты места уже не хватает.
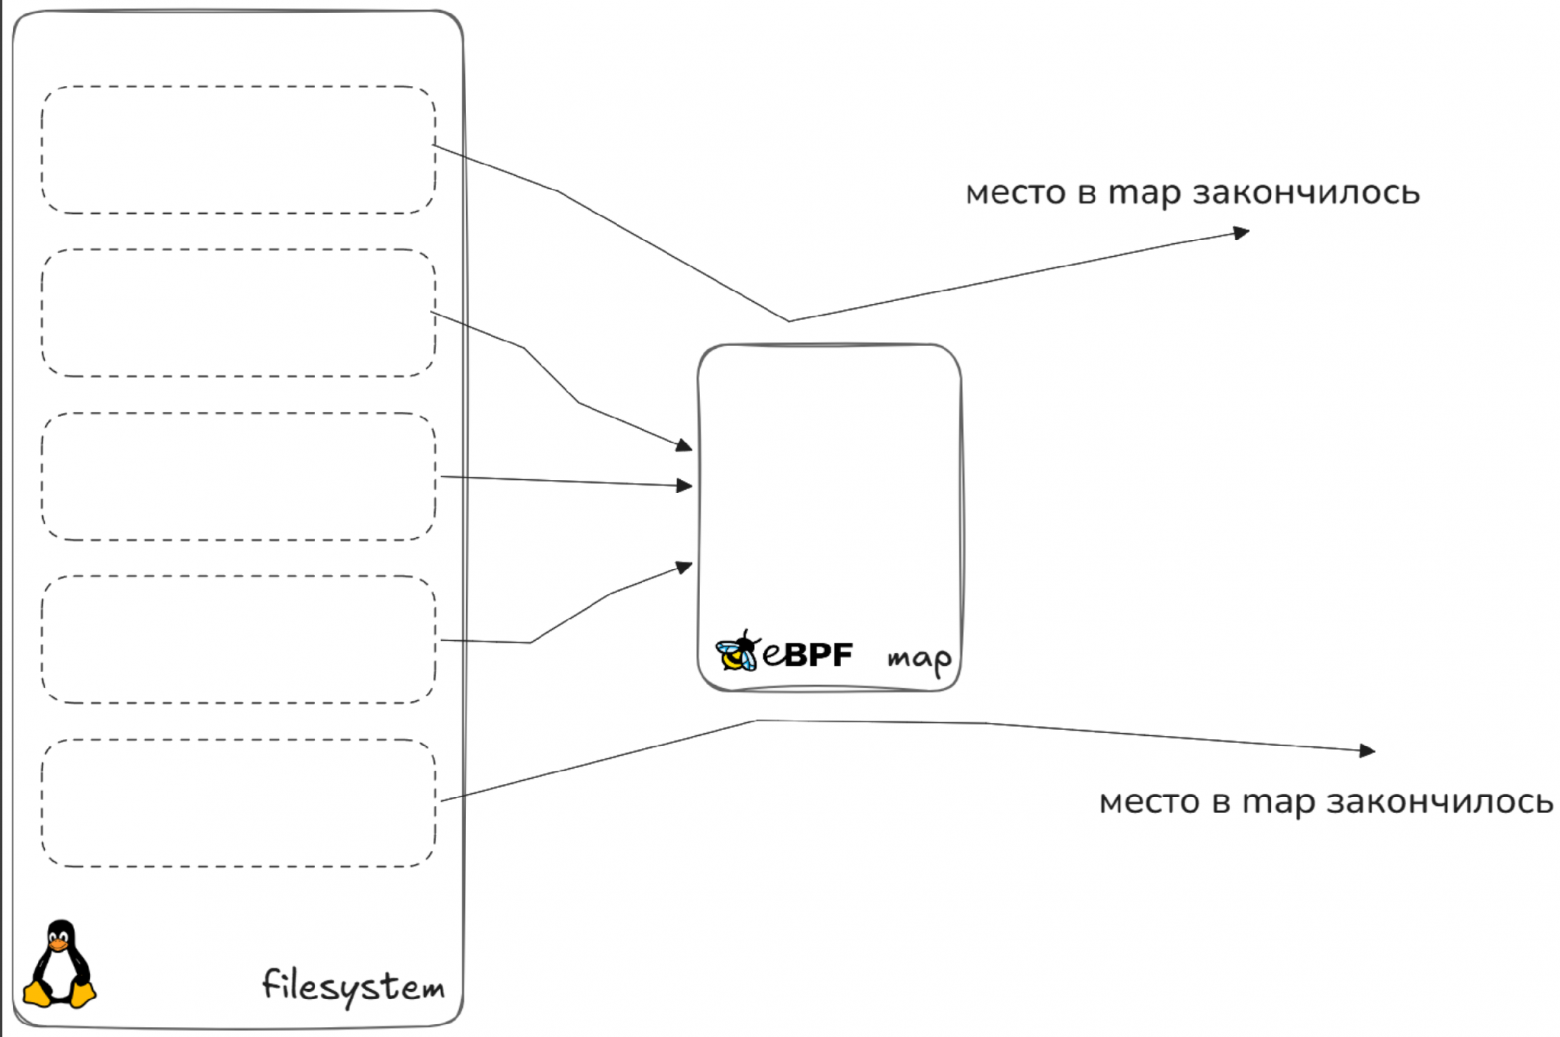
Докажем это экспериментально. Значение max_entries выставим равным 50 и подадим программе тестовую директорию, после чего планомерно будем увеличивать число файлов в ней. В конце внесем изменения в самый последний файл:
# 1.Запуск
# sudo ./5.security_metadata_event_loss/security_metadata_event_loss test_dir/
2026/10/11 12:01:13 watched_inodes capacity: 50 entries
FIM eBPF monitor started on directory test_dir/ (inode=261036, watching 1 inodes, skipped 0 entries). Press Ctrl+C to stop.

# 2.Запускаем скрипт создания файлов
# Ждём, пока скрипт создаст более 50 файлов
2026/10/11 12:01:40 watching test_dir/file.001 (ino=12924)
[CREATE_IN] PID=2717 UID=1000 INO=0 FILE=file.001
[MODIFY] PID=2717 UID=1000 INO=0 FILE=file.001
[MODIFY] PID=2717 UID=1000 INO=12924 FILE=file.001
#.......................................................#
# После 50-го файла уже видим косвенный сигнал о переполнении
2026/10/11 12:01:53 NOT watching test_dir/file.051 (ino=160835): update: key too big for map: argument list too long
[CREATE_IN] PID=2955 UID=1000 INO=0 FILE=file.051
[MODIFY] PID=2955 UID=1000 INO=0 FILE=file.051

# 3.Вносим изменения в 1-й файл
[ATTRIB] PID=1548 UID=1000 INO=0 FILE=file.001
[ATTRIB] PID=1548 UID=1000 INO=12924 FILE=file.001
[MODIFY] PID=1548 UID=1000 INO=0 FILE=file.001
[MODIFY] PID=1548 UID=1000 INO=12924 FILE=file.001

# 4.Вносим изменения в последний файл:
[ATTRIB] PID=1548 UID=1000 INO=0 FILE=file.060
[MODIFY] PID=1548 UID=1000 INO=0 FILE=file.060
На первый взгляд может показаться, что события не ускользнули, так как изменения по файлу file.060 тоже отображены. Но если более детально посмотреть на различия между событиями по file.001 и file.060, то можно заметить, что в первом случае их в два раза больше, а также там есть строки с INO=12924, то есть две записи в логе связаны с самим файлом непосредственно, а не его родительским объектом, в то время как у file.060 такого нет. Файл file.060 был задетектирован только благодаря тому, что его родительская папка попала под мониторинг.
Если же исчерпать все элементы eBPF-map, после чего внести изменения в файл, находящийся на несколько уровней глубже (то есть не в самой подконтрольной папке напрямую), то в логе уже ничего не отобразится:
# 1.Пересборка программы с уменьшенным числом max_entries (равен 2)
make all -C 5.security_metadata_event_loss/

# 2.Запуск
# sudo ./5.security_metadata_event_loss/security_metadata_event_loss test_dir/
2026/10/11 12:19:48 watched_inodes capacity: 2 entries
FIM eBPF monitor started on directory test_dir/ (inode=2165, watching 1 inodes, skipped 0 entries). Press Ctrl+C to stop.

# 3.Создание внутренней директории
# mkdir test_dir/inner_dir/
2026/10/11 12:20:00 watching test_dir/inner_dir (ino=44310)
[CREATE_IN] PID=7273 UID=1000 INO=0 FILE=inner_dir

# 4.Создание папки во внутренней директории
# mkdir test_dir/inner_dir/innerest_dir/
2026/10/11 12:20:22 NOT watching test_dir/inner_dir/innerest_dir (ino=6789): update: key too big for map: argument list too long
[CREATE_IN] PID=7383 UID=1000 INO=0 FILE=innerest_dir
# Примечание: она под мониторинг не попадает, лимит max_entries исчерпан

# 5.Внесение изменений в innerest_dir/
# touch test_dir/inner_dir/innerest_dir/innerest_file.txt
Тишина в логе
Переполнение eBPF-map — не единственный канал потери событий. Из kernel space в user space события попадают через perf-буфер ограниченного размера, и если читающая сторона не успевает за потоком, часть записей молча отбрасывается ядром (в cilium/ebpf количество отброшенных событий доступно в поле LostSamples прочитанной записи, которое наша демо-программа для простоты не обрабатывает). Последствия: пропущенный DELETE оставит в map-е «протухший» inode, который занимает слот, а после того как ядро переиспользует этот номер для нового файла, — начнёт ложно срабатывать. В боевом решении потери нужно считать и мониторить.
Полная версия рассматриваемой в параграфе программы.
Выводы
В данной статье мы рассмотрели все проблемы использования eBPF в контексте сравнения с fanotify. Чтобы подвести итог, давайте взглянем на таблицу:
Проблема | fanotify | eBPF |
|---|---|---|
Неполнота метаданных | Есть возможность по pid узнать путь к программе-инициатору события и имя пользователя | тоже есть возможность по pid получить программу и пользователя, но логику надо писать самостоятельно |
Избыточность событий | Присутствует, не решается автоматически на стороне инструмента | присутствует, также требует самостоятельного решения разработчиком |
Проблема идентификации | Создание нового объекта на месте старого по такому же пути также не учитывается инструментом | определяется разработчиком и той логикой, которую он реализует в программе, так, например, картина может быть ухудшена, если ориентироваться на inode, но при удалении файла пользователем не убирать его inode из группы мониторинга |
Вопрос рекурсивности | Возможно использование флагов | необходима полностью самостоятельная реализация |
Ограничения по числу отслеживаемых объектов | (предположительно) есть возможность увеличивать лимиты | зависит от объёма памяти: она выделяется в ядре заранее, под |
Проскальзывание событий | (предположительно) все события учитываются без потерь | заранее предсказуемый факт, определяемый, опять-таки, размером занимаемой памяти в ядре |
Если мы посмотрим на резюме, подведённое в таблице, то увидим слишком много слов типа «требует самостоятельной реализации на стороне разработчика». В принципе так оно и есть:
определение структуры события и, как следствие, механизма «распутывания следов» — ответственность разработчика
вопрос фильтрации событий на стороне EDR-приложения — ответственность разработчика
ситуация удаления файла и его создания вновь (как это обыграть) — ответственность разработчика
рекурсивность — ответственность разработчика
анализ числа контролируемых объектов с позиции памяти — ответственность разработчика
Здесь слишком много нюансов, решать которые приходится разработчику, в то время как в fanotify они в той или иной мере закрыты. Если рассмотреть линейку inotify, fanotify, eBPF, то оптимальным инструментом решения задач контроля целостности выступает fanotify, являясь золотой серединой. Лично я бы не стал брать eBPF как фундамент для своего приложения мониторинга, так как чересчур много нетривиальных архитектурных проблем, решать которые нужно полностью самостоятельно. Рациональнее взять fanotify и подкрутить слабые места. Если, конечно, вы располагаете временем и энтузиазмом к самостоятельной реализации и решению всех проблем, то eBPF — ваш выбор. Ведь это невероятно сильный инструмент.
Напоследок: так ли всё серо?
Сравнительный анализ eBPF с fanotify показал поражение первого (на мой взгляд), но нельзя убирать из рассмотрения ряд скользких моментов, приведённых в конце предыдущей статьи. Предположительно, eBPF эти моменты закрывает, однако на это посмотрим уже в следующей статье.


Комментарии 0