Как AI меняет экономику Software Development Lifecycle, почему ограничения перемещаются между этапами разработки и какой может стать архитектура Software Delivery к 2030 году.
Введение. Мы ускоряем не ту часть системы?
Последние пятнадцать лет индустрия последовательно оптимизировала разработку: Agile, автотесты, Continuous Integration и Continuous Delivery, DevOps, маленькие релизы, выкатки по несколько раз в день. За всем этим стояла одна задача — сократить путь от идеи до её реализации в production.
Потом появились AI-инструменты. GitHub Copilot, Cursor, Claude Code и другие изменили стоимость самого первого шага: разработчик теперь может делегировать модели функцию, тест, документацию, рефакторинг, а иногда и целую задачу.
И здесь возникает вопрос, который, на мой взгляд, заслуживает большего внимания, чем получает. Что произойдёт, если мы существенно ускорим создание изменений, а их проверку, интеграцию и доставку оставим практически неизменными? На первый взгляд ответ очевиден: будем быстрее выпускать функциональность. С точки зрения системной инженерии всё сложнее. Ускорение отдельного этапа не гарантирует роста пропускной способности всей системы — иногда оно просто увеличивает нагрузку на следующий этап.
Поэтому я предлагаю смотреть на AI не только как на инструмент продуктивности разработчика, но и как на фактор, который заставляет переосмыслить архитектуру всего SDLC. Это не значит, что существующий CI/CD устарел. Наоборот, его принципы становятся важнее. Но способы организации проверок, управления рисками и доставки изменений, похоже, придётся менять.
1. AI действительно ускоряет разработку?
Вокруг AI-assisted development много маркетинга, а эмпирика заметно менее однозначна.
В 2023 году исследователи GitHub и Microsoft провели контролируемый эксперимент с Copilot: участникам нужно было реализовать HTTP-сервер на JavaScript. Группа с Copilot справилась в среднем на 55,8% быстрее контрольной. Но стоит помнить детали: участвовали 95 разработчиков, набранных на Upwork, задание завершили 35, а сравнивали время среди завершивших. Это результат конкретного эксперимента с задачей с нуля, а не оценка любой инженерной работы.
В 2025 году METR пошла другим путём: 16 опытных open-source разработчиков, 246 реальных задач в проектах, которые они хорошо знали. Результат оказался противоположным — с разрешённым AI задачи занимали в среднем на 19% больше времени. Самое интересное, что участники до эксперимента ожидали ускорения, а после него продолжали считать, что AI помог им работать быстрее.
В феврале 2026 года METR опубликовала продолжение на выборке побольше. Новые наблюдения указывали на возможное ускорение, но из-за смещения выборки — часть разработчиков отказывалась делать задачи без AI — и изменившегося поведения участников авторы не смогли надёжно оценить величину эффекта и переделали дизайн эксперимента.
Картина неоднозначная, и это закономерно: написать изолированную функцию, разобраться в legacy-системе, спроектировать распределённую транзакцию и диагностировать инцидент — совершенно разные задачи. На одних AI заметно помогает, на других эффект мал или отрицателен.
Для дальнейшего рассуждения, впрочем, не нужно доказывать, что AI ускоряет всех. Достаточно более узкого предположения: если AI снижает стоимость создания определённого класса изменений, это меняет распределение нагрузки внутри инженерной организации. Дальше начинается самое интересное.
2. Эффект мигрирующего bottleneck
Представим команду из десяти разработчиков. Каждый делает в среднем два Pull Request в неделю, команда — около двадцати. Под этот поток выстроены Code Review, тестирование и доставка. Теперь предположим, что на части задач AI позволил удвоить выход: команда способна создавать сорок PR в неделю.
Пропускная способность Code Review осталась прежней — возникает очередь, разработчики ждут проверки. Компания внедряет автоматизированное ревью: статический анализ, AI Code Review, дополнительные проверки в CI. Этап ускоряется, но теперь больше изменений поступает на тестирование, и ограничением становится QA. Автоматизируют и его — генерация тест-кейсов, умный выбор регрессии, автоматические интеграционные проверки. Поток снова растёт, и теперь изменения ждут интеграции и релизного окна. Ограничение переезжает в Release Management.
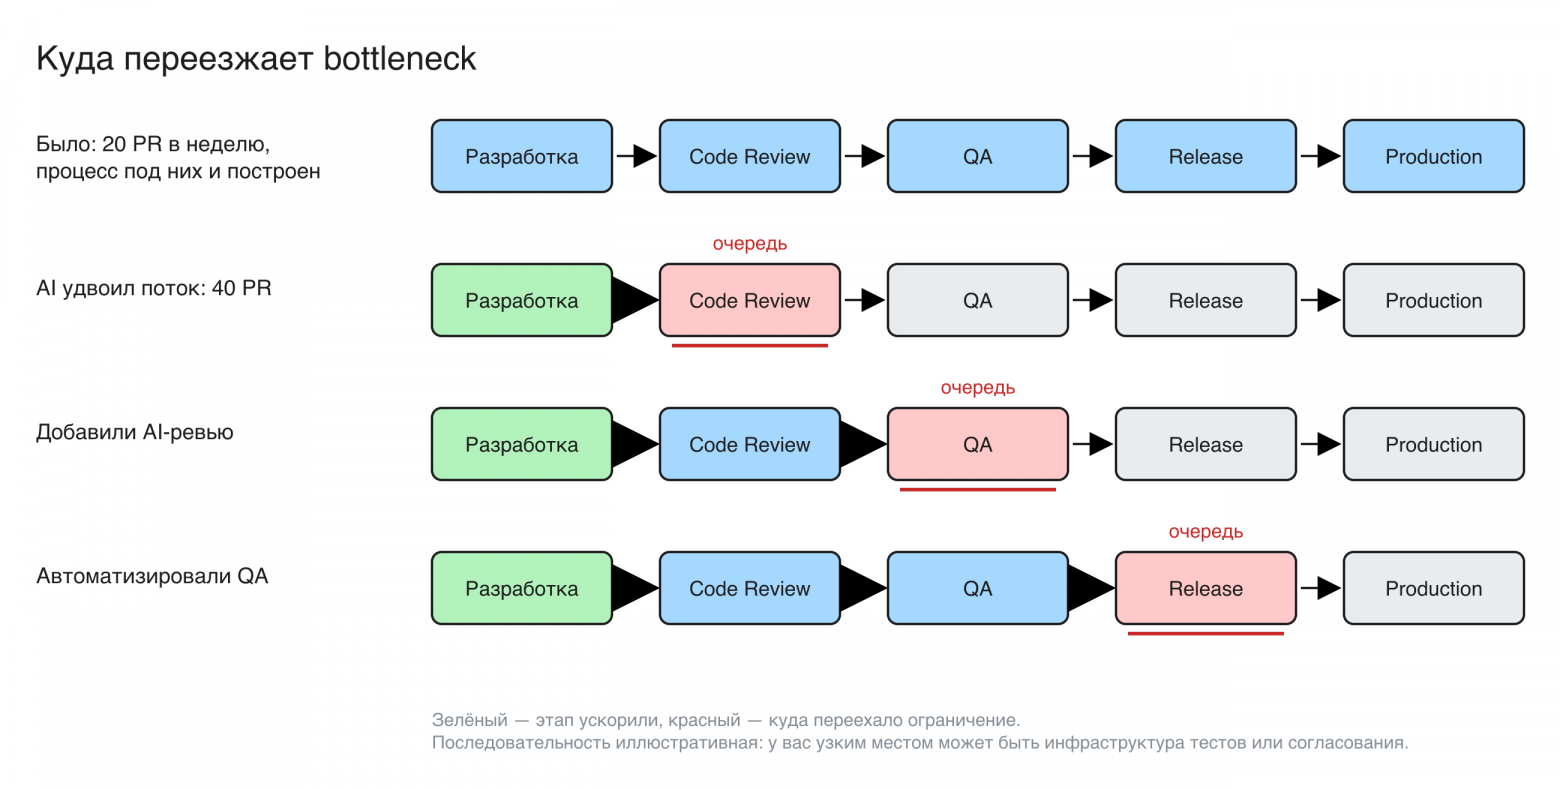
Мы ускоряем отдельные этапы, но bottleneck не исчезает. Он перемещается туда, где пропускная способность осталась недостаточной.
Конечно, это иллюстрация. В зрелых организациях многие проверки давно идут параллельно, а ручной QA не обязателен для каждого изменения. Количество PR — грубая метрика: один PR правит конфигурацию, другой переписывает бизнес-логику. AI может увеличивать не число изменений, а их размер, сложность или количество итераций проверки, так что корректнее говорить об изменении интенсивности и структуры инженерной работы. Но принцип от этого не меняется: локальный рост производительности не гарантирует роста пропускной способности системы.
3. Почему очереди растут нелинейно
Чтобы показать масштаб эффекта, возьмём команду покрупнее и представим один логический канал Code Review, который обрабатывает в среднем 18 PR за восьмичасовой день. Для иллюстрации достаточно модели M/M/1: пуассоновский поток задач, экспоненциальное время обработки, один канал, очередь без ограничения длины.
Среднее время нахождения задачи на этапе, включая ожидание и саму обработку:
W = 1 / (μ − λ)
где λ — интенсивность поступления, μ — интенсивность обработки; модель устойчива только при λ < μ.
PR в день | Загрузка | Среднее время на этапе |
|---|---|---|
9 | 50% | 53 минуты |
12 | 67% | 1 час 20 минут |
14 | 78% | 2 часа |
16 | 89% | 4 часа |
17 | 94% | 8 часов |
Значения модельные, не измеренные. Рабочий день — восемь часов; при μ = 18 сама обработка одного PR занимает около 27 минут, остальное — ожидание.
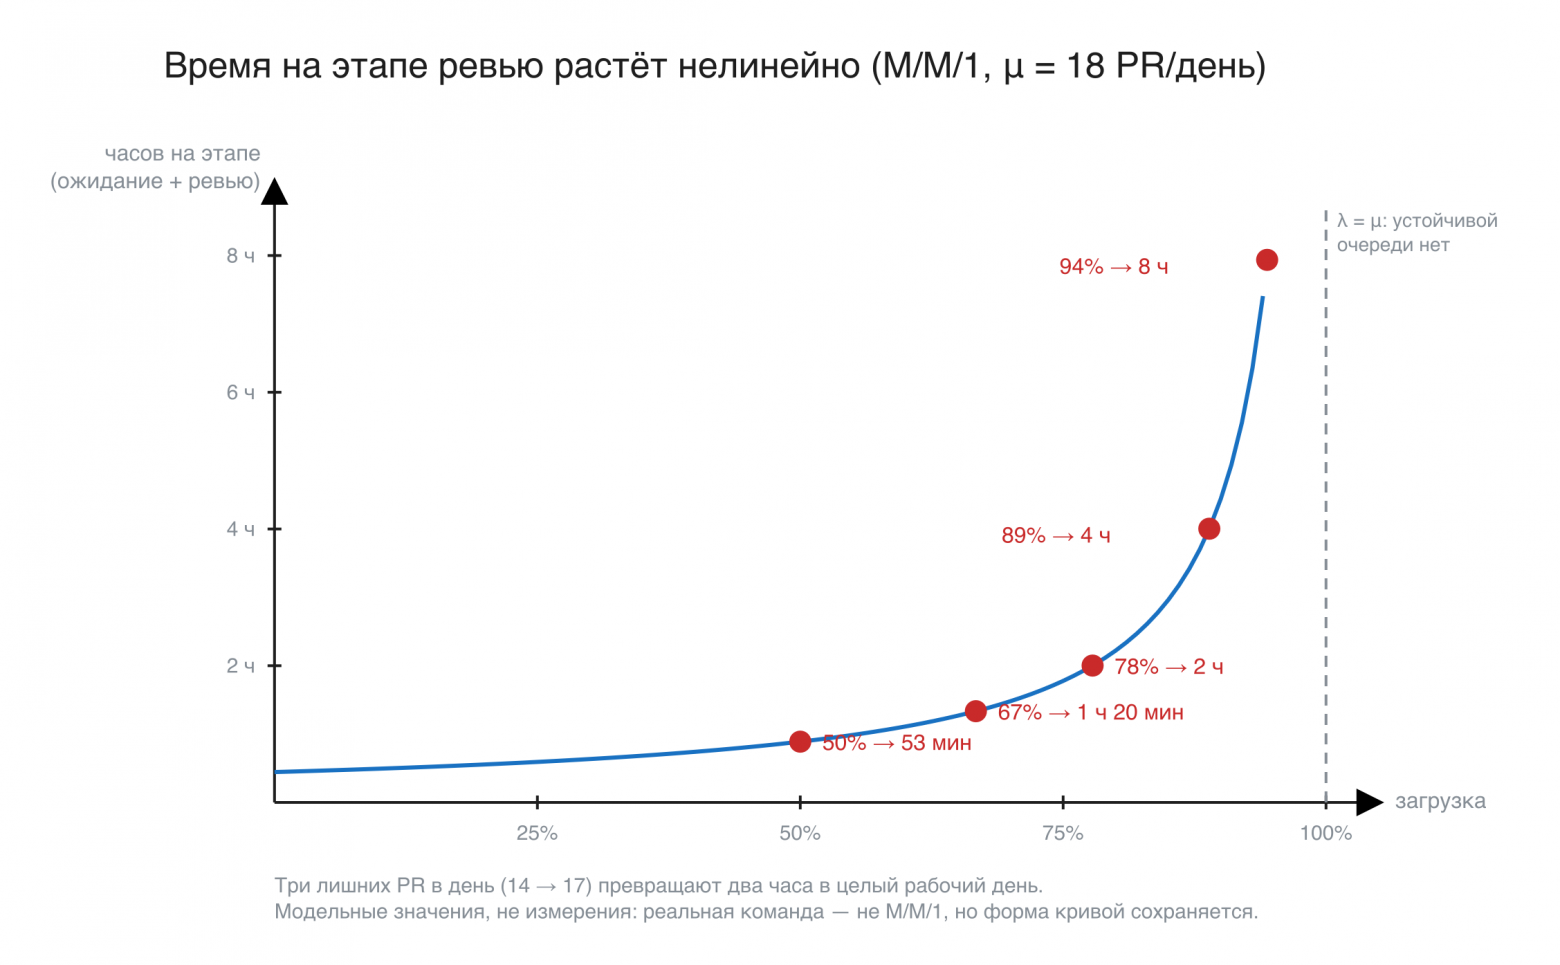
Входящий поток вырос с 14 до 17 PR в день — примерно на 21%. Время прохождения этапа выросло с двух часов до восьми — в четыре раза. При λ ≥ μ устойчивой очереди в этой модели нет вообще.
Реальная команда, разумеется, не M/M/1: ревьюеров несколько, задачи разной сложности, есть приоритеты, переключения контекста, повторные проверки и зависимости между изменениями. Для прогноза реального Lead Time нужны фактические данные и модель посложнее — многоканальная очередь или имитация. Но качественный вывод сохраняется: когда этап работает близко к пределу, дополнительная нагрузка и вариативность резко увеличивают время ожидания.
Именно поэтому разработчик может закончить реализацию за два часа вместо восьми, а изменение всё равно проведёт несколько дней в ожидании ревью, тестов и доставки. Индивидуальная производительность выросла. Lead Time организации — нет.
4. Что об этом говорят исследования DORA
В отчёте за 2024 год DORA обнаружила, что рост использования AI положительно связан с показателями индивидуальной работы, но отрицательно — с частью показателей Software Delivery Performance. В модели отчёта увеличение AI adoption на 25% (в терминах шкалы DORA) было связано с оценочным снижением delivery throughput на 1,5% и delivery stability на 7,2%.
В отчёте 2025 года картина сдвинулась: связь с throughput стала положительной, но проблемы со стабильностью доставки сохранились. Главный вывод отчёта — AI работает как усилитель существующих организационных возможностей и ограничений.
Важно не путать корреляцию с причинностью. DORA не доказывает, что AI вызывает ухудшение стабильности: на результаты влияют зрелость процессов, архитектура, размер изменений и многое другое. Но исследования показывают, что улучшение индивидуальных показателей не обязательно сопровождается сопоставимым улучшением доставки, и это согласуется с системной гипотезой. AI не исправляет слабый Software Delivery автоматически. Он делает существующие ограничения заметнее. Если организация умеет работать небольшими изменениями и быстро получать обратную связь, AI усилит это. Если процесс построен на больших очередях, ручных согласованиях и редких релизах, рост потока усугубит проблемы.
Оговорюсь сразу: ни DORA, ни METR не доказывают необходимость той архитектуры delivery, которую я предложу ниже. Исследования дают основания изучать проблему, теория очередей объясняет один из механизмов, а предлагаемая архитектура — инженерная гипотеза о том, как с этими ограничениями работать.
5. Почему недостаточно автоматизировать существующий SDLC
Типичный SDLC описывают цепочкой Requirements → Development → Code Review → QA → Release → Production. Это упрощение: CI, shift-left testing, trunk-based development и Continuous Delivery давно позволяют делать многое параллельно, и говорить, что AI впервые заставляет отказаться от последовательной разработки, было бы неправильно. Но AI меняет экономику отдельных операций, и возникает вопрос: стоит ли и дальше оптимизировать каждую стадию по отдельности?
Допустим, мы автоматизировали Code Review — но результат несколько часов ждёт ручного согласования. Или внедрили AI-генерацию тестов — но каждый PR по-прежнему гоняет двухчасовой регресс, и проблема просто переехала в вычислительную инфраструктуру. Автоматизировать существующий процесс и изменить его архитектуру — разные задачи. Следующая эволюция Software Delivery, на мой взгляд, связана не столько с ускорением стадий, сколько с устранением ненужных ожиданий и адаптацией проверок к характеру изменения.
6. От фиксированных pipeline к Risk-Adaptive Delivery
Типичный CI/CD pipeline — заранее определённая последовательность: сборка, линтеры, unit-тесты, интеграционные тесты, security scanning, deployment. Это надёжная и хорошо изученная модель с одним ограничением: проверки выполняются одинаково для принципиально разных изменений. Правка текста сообщения об ошибке и новый алгоритм расчёта комиссии в финансовой системе технически проходят один и тот же pipeline, хотя последствия ошибок несопоставимы.
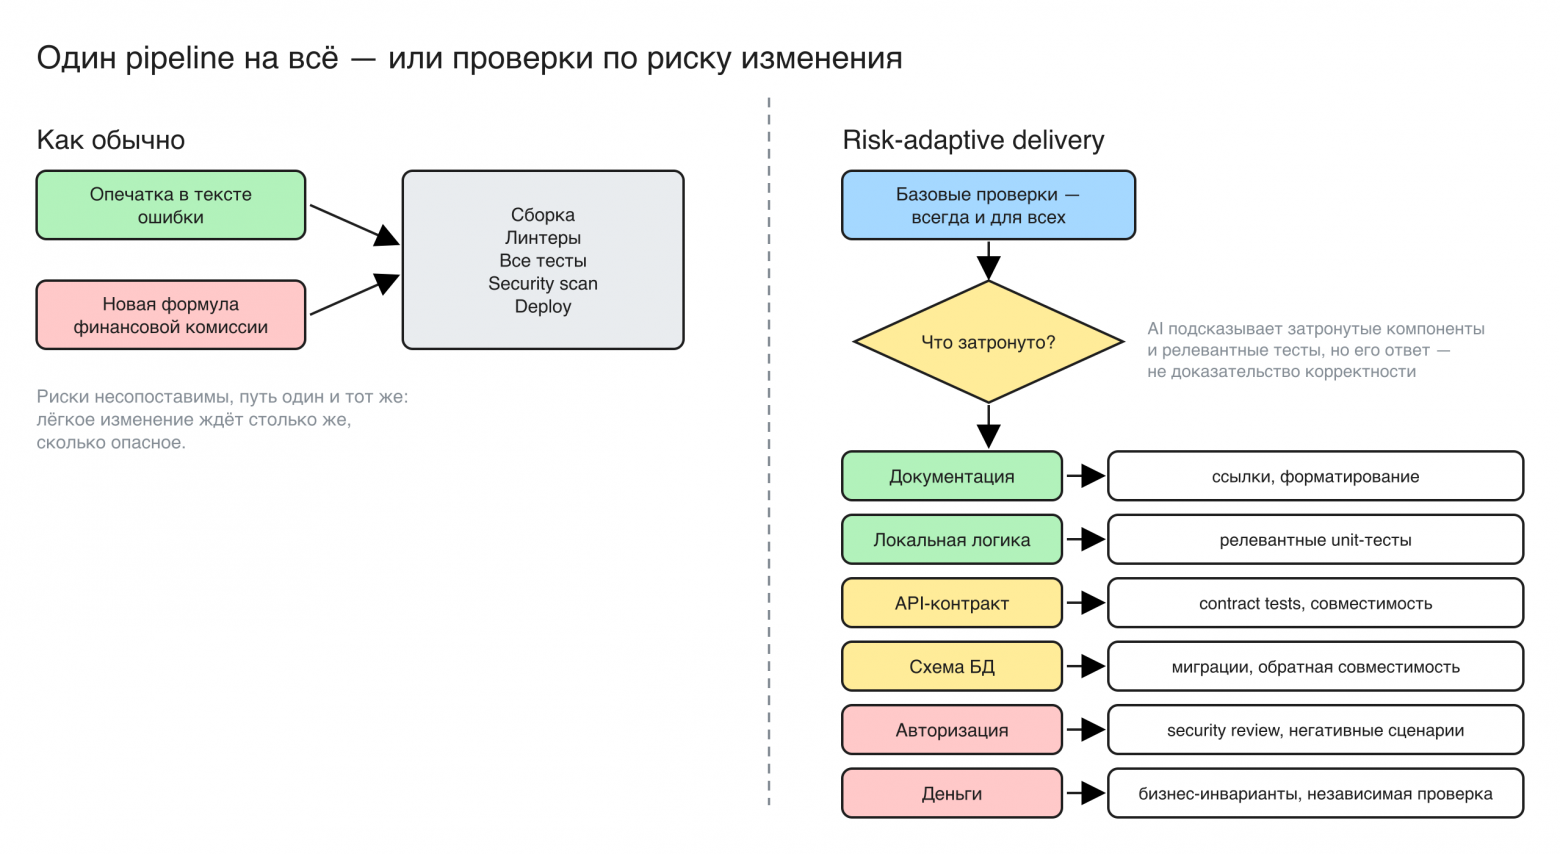
Отсюда направление, которое можно назвать Risk-Adaptive Software Delivery: обязательный базовый набор проверок для всех изменений плюс дополнительные — в зависимости от того, что затронуто.
Изменение | Дополнительные проверки |
|---|---|
Документация | Форматирование, ссылки |
Локальная бизнес-логика | Релевантные unit-тесты |
API-контракт | Contract tests, совместимость |
Схема БД | Миграции, обратная совместимость |
Авторизация | Security review, негативные сценарии |
Финансовые расчёты | Бизнес-инварианты, независимая проверка |
Низкая оценка риска не должна позволять обойти критические security-политики или требования аудита. AI здесь полезен: определить затронутые компоненты, проанализировать зависимости, выбрать релевантные тесты. Но есть два принципиальных ограничения.
Первое: классификация изменения сама может быть ошибочной. Если система сочла правку «безопасной документацией», а она затронула исполняемую конфигурацию, облегчённый pipeline пропустит опасное изменение. Поэтому у классификатора риска должны быть собственные проверки, мониторинг ошибок и консервативное поведение при неопределённости. Второе: ответ языковой модели не является доказательством корректности. Критические ограничения определяются формальными политиками и проверяемыми критериями, а не вероятностной оценкой.
7. Continuous Validation вместо отдельного QA-gate
Следующий шаг — пересмотреть, где именно происходит проверка качества. В традиционной модели тестирование — отдельная стадия после разработки, но значительная часть проверок может идти непрерывно: статический анализ и unit-тесты во время реализации, проверки совместимости при изменении контрактов, анализ diff и зависимостей на PR, интеграционные и сценарные тесты в изолированном окружении, контроль технических и бизнес-метрик во время deployment, наблюдение за отложенными последствиями после доставки.
Continuous Validation не означает, что AI сам решает, какие проверки пропустить. Надёжной системе нужны несколько уровней контроля: обязательный минимум; дополнительные проверки по риску; периодические широкие регрессионные прогоны; независимая оценка качества самой системы тестирования. Последний пункт важнее, чем кажется: если один AI генерирует код, а другой проверяет его по тем же неверным предположениям, автоматизация создаёт иллюзию безопасности. К этому я вернусь в разделе про агентов.
8. Production — не конец pipeline
Успешный deployment не равен успешной доставке. Приложение собралось, тесты прошли, контейнер запустился, health checks зелёные — а изменение всё равно может быть некорректным: ошибка проявляется под определённой нагрузкой, при взаимодействии нескольких сервисов или во время ночной финансовой сверки. Поэтому уже существующие практики Progressive Delivery — canary, feature flags, shadow traffic, автоматические откаты, анализ production-метрик — приобретают особое значение.
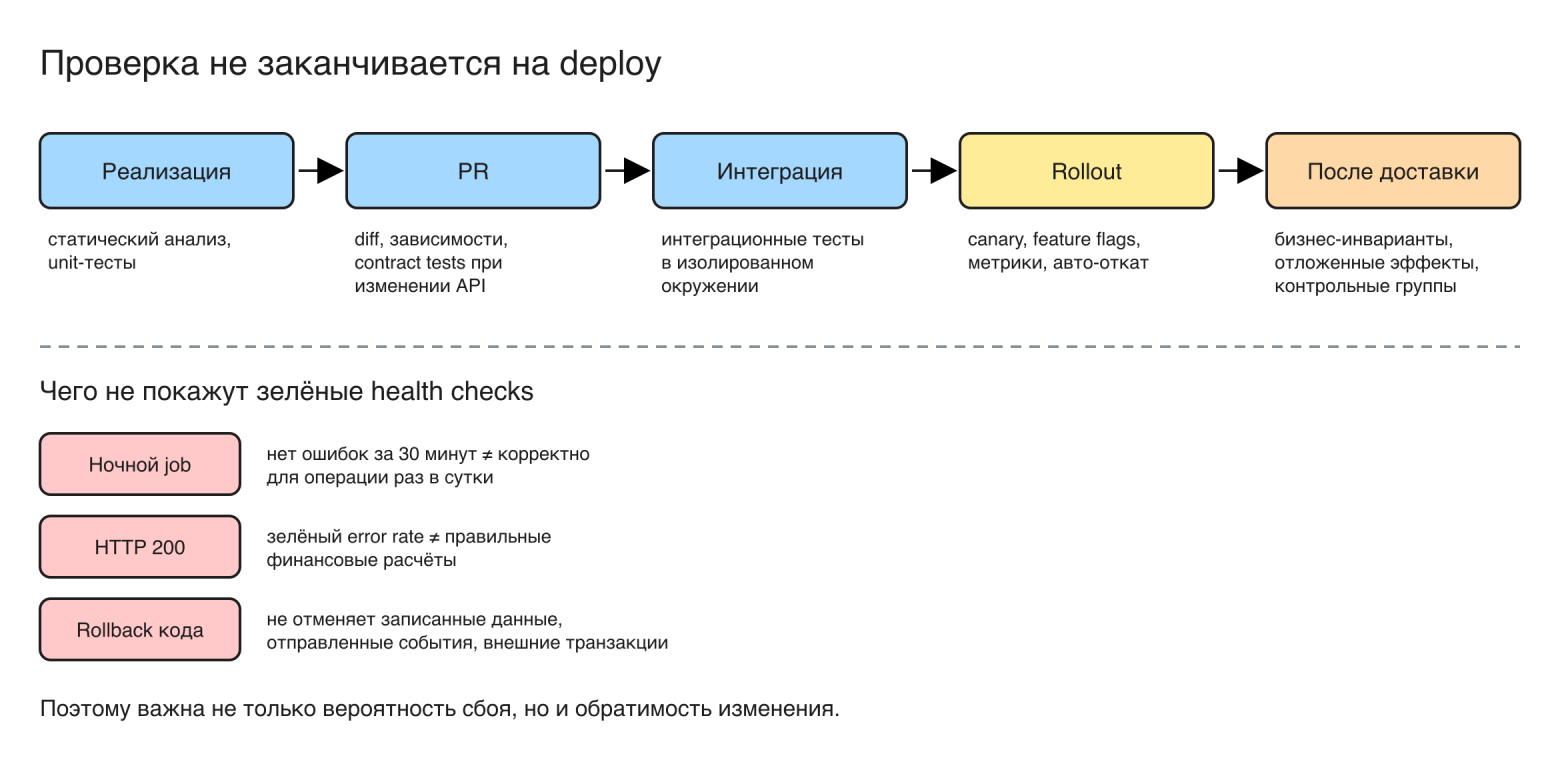
AI может помогать выбирать стратегию rollout, находить аномалии и объяснять отклонения. Но есть вопрос, на который модель не ответит: как понять, что данных достаточно для решения? Отсутствие ошибок за 30 минут ничего не гарантирует, если операция выполняется раз в сутки — за полчаса мы могли не получить ни одного релевантного наблюдения. Если изменение затрагивает редкий сценарий, агрегированные метрики ничего не покажут. Если проблема в бизнес-логике, HTTP error rate останется идеальным. Поэтому автоматизация delivery требует не только технической observability, но и явных критериев корректности: бизнес-инвариантов, контрольных групп, достаточного объёма наблюдений, понимания отложенных эффектов.
И ещё одно: rollback — не всегда безопасная обратная операция. Код можно вернуть, но изменённые данные, отправленные сообщения и выполненные внешние транзакции не обязательно можно отменить. Будущие delivery-платформы должны учитывать не только вероятность ошибки, но и обратимость изменения.
9. Автономные агенты и проблема доверия
Мы переходим от инструментов, которые подсказывают фрагменты кода, к системам, которые сами выполняют многошаговые задачи: агент изучает репозиторий, вносит изменения, запускает тесты, исправляет ошибки и готовит Pull Request. Следующий логичный шаг — дать ему управлять проверками и доставкой. И здесь возникает вопрос доверия: если агент сам меняет код, тесты и интерпретирует результаты проверок, кто гарантирует, что он не подогнал критерии успеха под собственную реализацию?
Злой умысел здесь не нужен — достаточно ошибки в исходных предположениях. Агент неверно понял бизнес-требование, реализовал неправильную логику и написал тесты, подтверждающие именно её. Все проверки зелёные, система работает неправильно.
Поэтому AI-native delivery требует архитектурного разделения полномочий. Агент-исполнитель не должен иметь возможности менять обязательные политики безопасности и критерии приёмки. Критические проверки выполняются в доверенной среде, результаты воспроизводимы, артефакты идентифицируемы и неизменяемы после проверки, действия агентов аудируются.
При этом недостаточно просто назначить верификатором другого AI-агента: если исполнитель и верификатор используют одну и ту же неполную спецификацию, они совершат одинаковую ошибку. Независимость проверки обеспечивается не только разделением ролей, но и независимыми критериями корректности — заранее зафиксированными acceptance criteria, формальными бизнес-инвариантами, независимыми тестовыми данными, детерминированными проверками и человеческим контролем для критических изменений.
Важна и среда выполнения. Агенту нужны зависимости, компилятор, package registry, тестовые сервисы, документация, так что полная изоляция «от всего, кроме кода» нереалистична. Практичнее sandbox с минимально необходимыми правами, контролируемым сетевым доступом, временными credentials и запретом на изменение доверенных политик. Это не отменяет практики Software Supply Chain Security — наоборот, делает их обязательными.
10. Экономика автоматизации: когда AI становится дороже человека
До сих пор речь шла о скорости, но у доставки есть и второе измерение — стоимость. AI-ревью, агентные тесты, изолированные окружения, дополнительные проверки, observability и orchestration-платформы требуют ресурсов, и максимальная автоматизация не обязательно означает максимальную эффективность. Условно полную стоимость изменения можно записать так:
Total Change Cost = Implementation + Validation + Delivery + Expected Failure & Rework Cost
— стоимость реализации, стоимость проверки, стоимость сборки и deployment, плюс ожидаемые затраты на исправления, инциденты и повторную работу. Последний член самый важный: дешёвая проверка, пропускающая критические ошибки, обходится дороже тщательной валидации. И наоборот, полный набор дорогих проверок для каждого изменения не даёт соразмерного снижения риска.
Поэтому цель — не минимизировать время CI любой ценой и не максимизировать число тестов, а минимизировать полную стоимость безопасной доставки при заданных требованиях к надёжности. Именно здесь Risk-Adaptive Delivery получает экономическое обоснование: лёгким изменениям — лёгкие проверки, критическим — дорогая валидация. С одной оговоркой: классификацию риска нужно регулярно проверять, иначе экономия на тестах обернётся ростом стоимости инцидентов.
11. Что станет следующим bottleneck
Допустим, мы существенно автоматизировали создание кода, ревью, тестирование и deployment. Что останется самым сложным? Моя гипотеза — понимание последствий изменений.
Современная система редко ограничивается одним репозиторием: микросервисы, базы, очереди, внешние интеграции, фоновые задачи, кэши, неявные зависимости. Изменение одной функции может повлиять на компоненты, формально не связанные с изменёнными файлами, и по одному Git diff этого не увидеть. Нужна информация об архитектуре, контрактах, потоках данных, бизнес-инвариантах и фактическом поведении production.
Отсюда направление, которое мне кажется одним из следующих для Platform Engineering: машинно-читаемая модель системы как основа автоматизированной проверки изменений. Платформа, объединяющая структуру кода и граф зависимостей, контракты API и событий, архитектурные ограничения, историю изменений и инцидентов, каталог тестов, production telemetry, бизнес-инварианты и политики доставки. Такая система сможет не просто анализировать код, а строить гипотезы о последствиях изменений и выбирать способы их проверки. Абсолютно точной модели сложной распределённой системы не будет никогда, но даже частичное улучшение понимания зависимостей повышает качество автоматизированных решений.
12. От Pull Request к Change Intent
Должен ли Pull Request оставаться центральным объектом процесса? Исторически PR — удобный механизм совместной работы людей над кодом: один предлагает, другой проверяет, после согласования изменение интегрируется. Но если значительная часть реализации и технических проверок автоматизируется, центральным объектом может стать не набор изменённых файлов, а описание желаемого поведения системы — условно, Change Intent.
Например: «Добавить новый способ оплаты, сохранив обратную совместимость API, существующие ограничения безопасности и корректность финансовой сверки». Намерение содержит цель, ограничения, критерии приёмки, допустимый риск, требования к совместимости и критерии успешной доставки. Агенты занимаются реализацией, автоматизированные системы — проверкой, delivery-платформа — rollout, а инженер — архитектурой, ограничениями и решениями, которые нельзя безопасно делегировать.
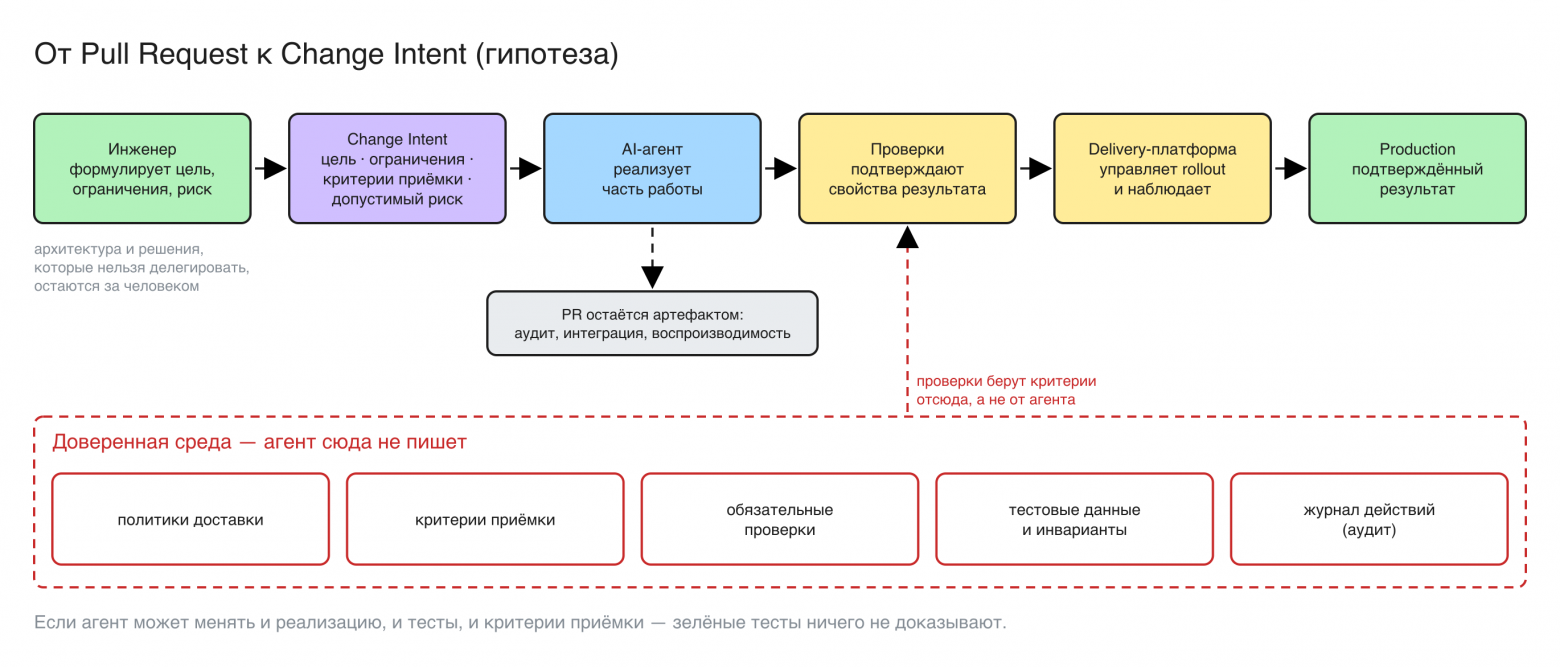
PR при этом не исчезает: он остаётся техническим артефактом для аудита, воспроизводимости и интеграции. Но управление разработкой смещается от контроля отдельных изменений файлов к контролю намерений и результатов. Пока это гипотеза — хотя и логичное продолжение Infrastructure as Code, Policy as Code, Continuous Delivery и агентной автоматизации.
13. Как измерять эффективность в новой модели
Если AI увеличивает число изменений, возникает соблазн измерять эффективность количеством PR, коммитов или строк. Эти показатели легко становятся ложными целями: много PR не значит полезных изменений, высокая Deployment Frequency не гарантирует стабильности, а низкий Lead Time может сопровождаться ростом инцидентов.
DORA использует пять показателей: Change Lead Time, Deployment Frequency и Failed Deployment Recovery Time характеризуют throughput, Change Fail Rate и Deployment Rework Rate — instability. Для анализа AI-assisted development я бы дополнительно отслеживал структуру Lead Time: сколько изменение в активной разработке, сколько ждёт ревью, сколько занимают проверки, сколько оно ждёт deployment и сколько нужно на подтверждение корректности после выкладки. Плюс стоимость валидации и долю изменений, требующих повторной работы.
И одну метрику сверху — Time to Verified Value: время от принятия задачи в работу до подтверждённого полезного результата в production. Это не стандарт и не замена существующим показателям, а попытка связать доставку с фактическим результатом. Оптимизировать её изолированно нельзя — иначе организация начнёт принимать чрезмерные риски ради скорости; она работает только вместе с показателями надёжности, качества и стоимости. Потому что цель разработки — не производство кода и не количество релизов, а работающие изменения, которые приносят пользу.
14. Моё видение: как может измениться Software Delivery к 2030 году
Дальше — не прогноз отрасли, а предлагаемая последовательность развития инженерной организации. Годы условны: компании будут двигаться с разной скоростью, а некоторые этапы для кого-то окажутся нецелесообразными. Но сам порядок кажется мне логичным: каждый этап опирается на предыдущий и полезен сам по себе.
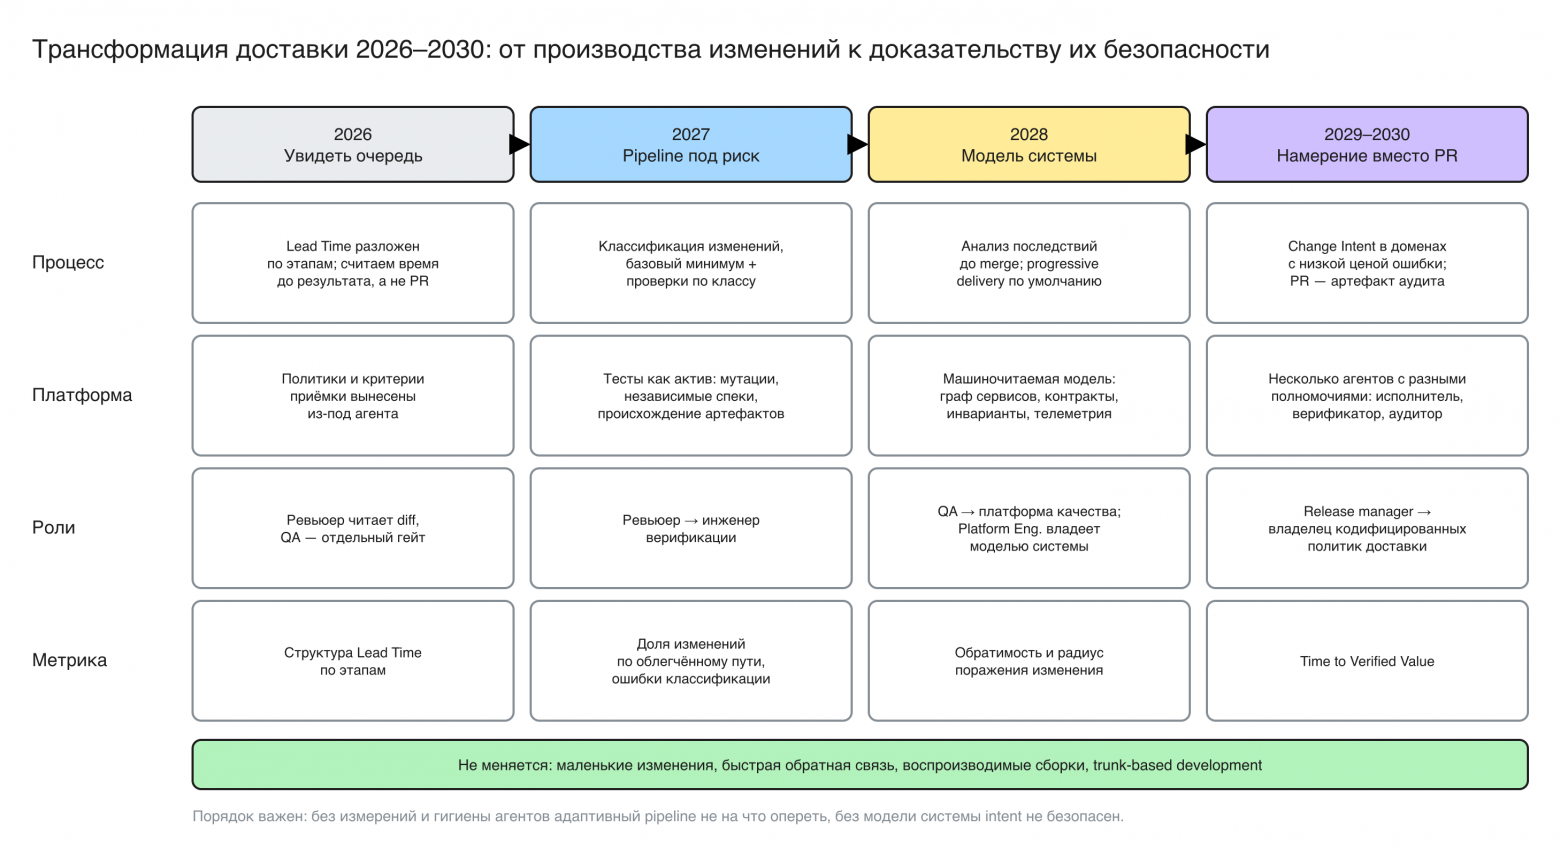
Этап 1. Измерить реальный поток изменений. Первый шаг не связан с AI. Команда должна понять, где изменение проводит время: активная разработка, ожидание ревью, тестирование, ожидание deployment, подтверждение в production. Пока организация измеряет только число PR и Deployment Frequency, она видит часть картины. Здесь же стоит формализовать обязательные политики и критерии приёмки, чтобы агенты не могли менять их вместе с кодом.
Этап 2. Перейти к Risk-Adaptive Pipelines. Система определяет затронутые компоненты, зависимости и класс риска и по ним выбирает дополнительные проверки; базовые остаются обязательными. Классификатор риска становится объектом контроля качества, его ошибки измеряются. Роль ревьюера меняется: вместо чтения diff построчно — владение проверками и их качеством, инженер верификации.
Этап 3. Построить модель системы. Platform Engineering объединяет данные об архитектуре, зависимостях, контрактах, тестах и telemetry, и последствия изменений оцениваются до deployment. Обратимость и радиус воздействия становятся свойствами изменения. Progressive Delivery — способ доставки по умолчанию, а не практика для особо рискованных релизов. QA из отдельного гейта превращается в платформу качества: инварианты, тестовые данные, модель системы.
Этап 4. Перейти к Intent-Driven Engineering. Центральным объектом становится Change Intent. Агенты выполняют реализацию и часть технической валидации, платформа управляет проверками и доставкой, инженеры определяют архитектуру, ограничения и допустимый риск. Release manager — владелец кодифицированных политик доставки, а не человек, который «знает, когда можно катить». Степень автономности зависит от цены ошибки: для низкорисковых изменений — высокая автоматизация, для финансовых операций, безопасности и необратимых действий решение человека остаётся обязательным.
15. Целевая архитектура на сквозном примере
Чтобы не оставаться на уровне абстракций, пройдём целевой процесс на конкретном сценарии. Команда разрабатывает платёжный сервис; нужно добавить новый алгоритм расчёта комиссии. Изменение затрагивает бизнес-логику, API и финансовую сверку.
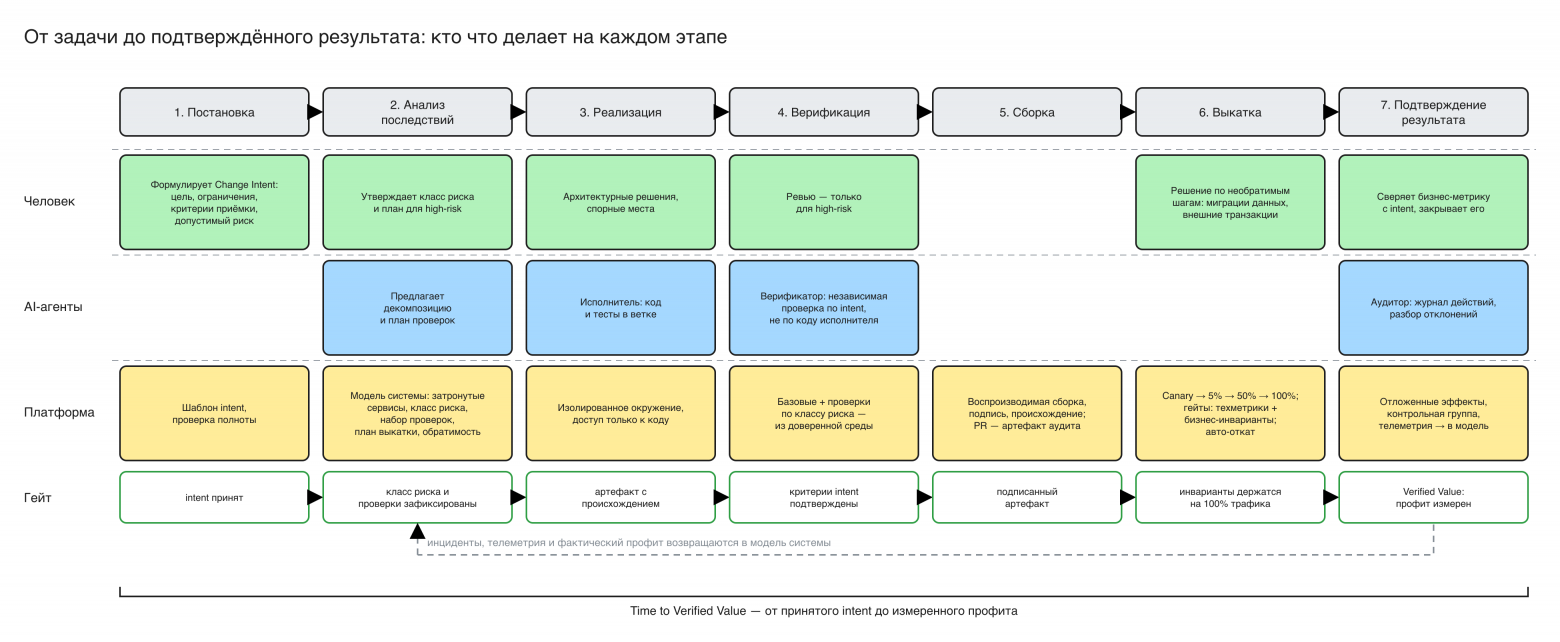
1. Постановка. Инженер или продуктовая команда формулирует Change Intent: что изменить, какие ограничения соблюсти, как проверять результат, какой риск допустим. Платформа проверяет полноту намерения. В нашем примере: «Добавить новый алгоритм расчёта комиссии, сохранив обратную совместимость API и корректность финансовой сверки» плюс критерии приёмки. Результат: зафиксированные критерии и ограничения.
2. Анализ последствий. Платформа анализирует затронутые компоненты, зависимости, контракты и риски, формирует набор проверок и стратегию доставки. Для критических изменений план утверждает ответственный инженер. В примере изменение получает высокий класс риска, а набор проверок включает unit-тесты расчёта, contract tests для API, проверки обратной совместимости, финансовые инварианты, сравнение старого и нового алгоритмов на контрольных данных и проверку миграций, если они нужны. Результат: согласованный план валидации и доставки.
3. Реализация. Агент или разработчик реализует изменение в контролируемой среде с минимально необходимыми правами. Агент может написать и код, и тесты, но критические критерии приёмки и политики проверки находятся вне его полномочий. Результат: изменение с зафиксированным происхождением.
4. Независимая верификация. Проверки выполняются в доверенной среде по заранее определённым критериям, независимым тестовым данным и формальным инвариантам. AI-верификатор помогает анализировать результаты, но его выводы не заменяют детерминированные проверки; для критических изменений сохраняется человеческое ревью. Результат: подтверждение критериев приёмки.
5. Сборка и идентификация артефакта. Создаётся воспроизводимый артефакт, его происхождение связывается с конкретным commit или tree hash, набором зависимостей и результатами проверок. Артефакт подписывается и получает неизменяемый идентификатор — digest. Между окружениями продвигается один и тот же проверенный артефакт, а не выполняется новая сборка. Результат: идентифицируемый артефакт с проверяемым происхождением.
6. Progressive Delivery. Изменение доставляется постепенно, например через canary rollout. На каждом шаге анализируются технические и бизнес-метрики — в примере не только latency и error rate, но и расхождения финансовых расчётов. При отклонениях rollout останавливается. Для необратимых операций предусмотрена отдельная процедура принятия решения. Результат: изменение доставлено с контролируемым риском.
7. Подтверждение результата. После deployment система продолжает наблюдать: отложенные эффекты, бизнес-инварианты, критерии успеха. Только после подтверждения инвариантов изменение считается завершённым. Результат: Verified Value — подтверждённый полезный результат.
Процесс не линеен: инциденты, telemetry и результаты проверок возвращаются в модель системы, а данные о времени и стоимости доставки — в оптимизацию самого процесса.
Для сравнения — как то же изменение прошло бы через три модели доставки.
Классический CI/CD | AI-augmented | AI-orchestrated | |
|---|---|---|---|
Реализация | Разработчик | Разработчик + AI | Агент под контролем инженера |
Оценка риска | Человек | Человек + AI | Политики + анализ контекста |
Проверки | Фиксированный набор | Фиксированный + AI | Базовые + риск-адаптивные |
Deployment | По процедуре | Частично автоматический | Progressive, по политике |
Подтверждение | Технические метрики | Метрики + AI-анализ | Технические и бизнес-инварианты |
Ответственность | Инженерная команда | Инженерная команда | Инженерная команда |
В классическом CI/CD основной риск в том, что тесты подтверждают корректность реализации, но не покрывают финансовые инварианты. В AI-augmented варианте отдельные этапы проходят быстрее, но если критерии корректности прежние, ошибка в бизнес-логике проходит так же. Предлагаемую модель тоже не стоит переоценивать: она не гарантирует отсутствия ошибок, дороже в реализации и сопровождении, а для небольших команд может вообще не окупиться. Её смысл — для систем с высокой ценой ошибки и большим потоком изменений лучше соотносить стоимость проверки с риском.
16. Что может пойти не так
Любая архитектурная концепция выглядит убедительно, пока не сталкивается с реальностью, поэтому риски стоит назвать отдельно.
Стоимость. AI-ревью, дополнительные тесты, изолированные окружения и orchestration-платформа могут стоить дороже, чем экономят — особенно для небольших команд.
Качество модели системы. Неполный или устаревший граф зависимостей даёт ложное ощущение безопасности.
Ошибочная классификация. Неправильно выбранный облегчённый pipeline пропустит критическую ошибку.
Общие ошибки агентов. Разделение ролей не гарантирует независимости, если исполнитель и верификатор исходят из одинаковых неверных предположений.
Регуляторные ограничения. В ряде доменов человеческое согласование останется обязательным независимо от зрелости автоматизации.
Сложность самой платформы. Если система проверки становится настолько сложной, что инженеры перестают понимать её поведение, она превращается в новый источник операционных рисков.
Поэтому развитие должно быть постепенным: каждый этап приносит измеримую пользу сам по себе, а если стоимость следующего уровня автоматизации превышает ожидаемый эффект, внедрять его не нужно.
17. С чего начать уже сейчас
Несмотря на футуристичность части идей, первые шаги практичны — и полезны даже без AI.
Разложить Lead Time по этапам хотя бы для десяти последних изменений: сколько занимает активная работа и сколько — ожидание.
Формализовать критерии приёмки, особенно для изменений, которые реализуют агенты. Критические критерии — вне полномочий агента-исполнителя.
Выбрать один низкорисковый класс изменений — документацию или изолированную бизнес-логику — и построить для него облегчённый pipeline, сохранив обязательные проверки. Измерить выигрыш и частоту ошибок классификации.
Добавить бизнес-инварианты в production validation, начав с одного критического сценария: проверять не только технические метрики, но и корректность результата.
Измерять полную стоимость доставки: не только время разработки, но и стоимость проверки, инфраструктуры, повторной работы и инцидентов.
Вместо заключения
Последние десятилетия мы последовательно снижали стоимость создания программного обеспечения. AI продолжает эту линию, но заодно меняет баланс между этапами. Когда создание изменений ускоряется, существующие ограничения становятся заметнее: сначала Code Review, потом тестирование, интеграция, Release Management, Production Validation. В какой-то момент становится ясно, что оптимизировать отдельные этапы недостаточно — Software Delivery нужно рассматривать как единую систему.
Это не значит, что существующий SDLC устарел или что от проверенных практик CI/CD нужно отказываться. Наоборот: небольшие изменения, быстрая обратная связь, автоматизированное тестирование, воспроизводимые сборки и безопасная доставка становятся ещё важнее — без них не работают ни адаптивные проверки, ни агенты с разделёнными полномочиями.
Мы переходим от мира, в котором дорого создавать изменения, к миру, в котором всё большую часть стоимости составляет доказательство того, что эти изменения безопасны и корректны. И следующая большая задача Software Engineering, возможно, не в том, чтобы писать код ещё быстрее, а в том, чтобы безопасно изменять сложные системы с той скоростью, которую инструменты теперь позволяют.
А как устроен процесс у вас? Куда переехал bottleneck после того, как код стал писаться быстрее — в ревью, в QA, в релизы — и как вы с ним справляетесь: добавляете людей, автоматизируете этап или перестраиваете pipeline целиком? Особенно интересен опыт команд, которые измеряли эффект на всём цикле доставки, а не только на этапе написания кода.

Комментарии 0