1. Введение
В вакансиях и туториалах вокруг RAG и AI-агентов чаще всего фигурирует Python. На JVM экосистема тоже есть — LangChain4j, Spring AI и другие, — но живых разборов «как это выглядит в продукте» заметно меньше.
Я создал B2B-систему Смысл.ИИ (smysl.ai): сотрудник задаёт вопрос по внутренним документам компании и получает ответ с опорой на корпоративные материалы — с указанием источников.
Ниже — обзор архитектуры. Исходники закрыты; в серии статей — схемы и код. Публичный логин к демо не раздаётся; по тексту — скриншоты и при необходимости короткое видео. Документы в библиотеке — из вымышленной демо-компании, не данные реального заказчика.
В этой серии упор на AI-часть: обработка документов, индекс, поиск по корпусу, агент и ответ с указанием, из каких материалов взяты факты. Бэкенд-обвязка — PostgreSQL, структура таблиц, авторизация и аутентификация, REST API, задачи по расписанию, ретраи и прочее — почти не разбирается.
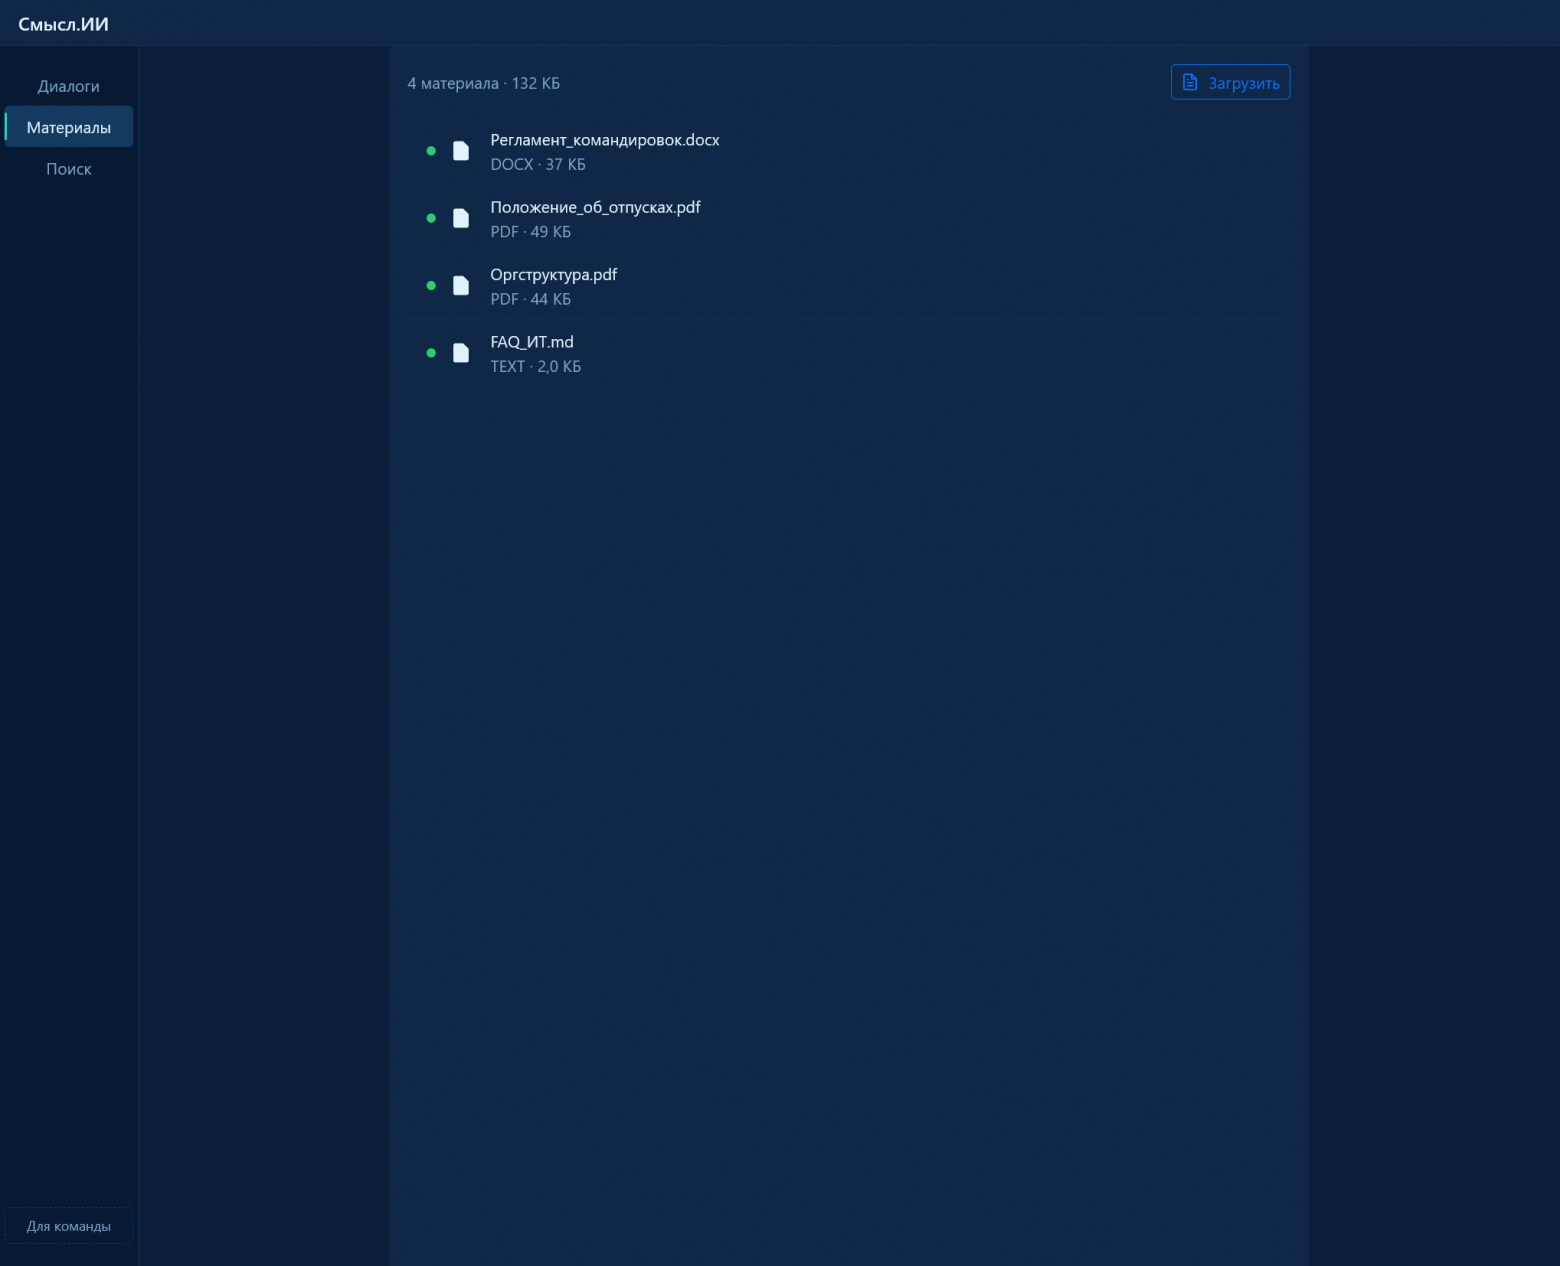
Библиотека материалов — загруженный корпус, по которому идёт поиск:
Вопрос в чате:
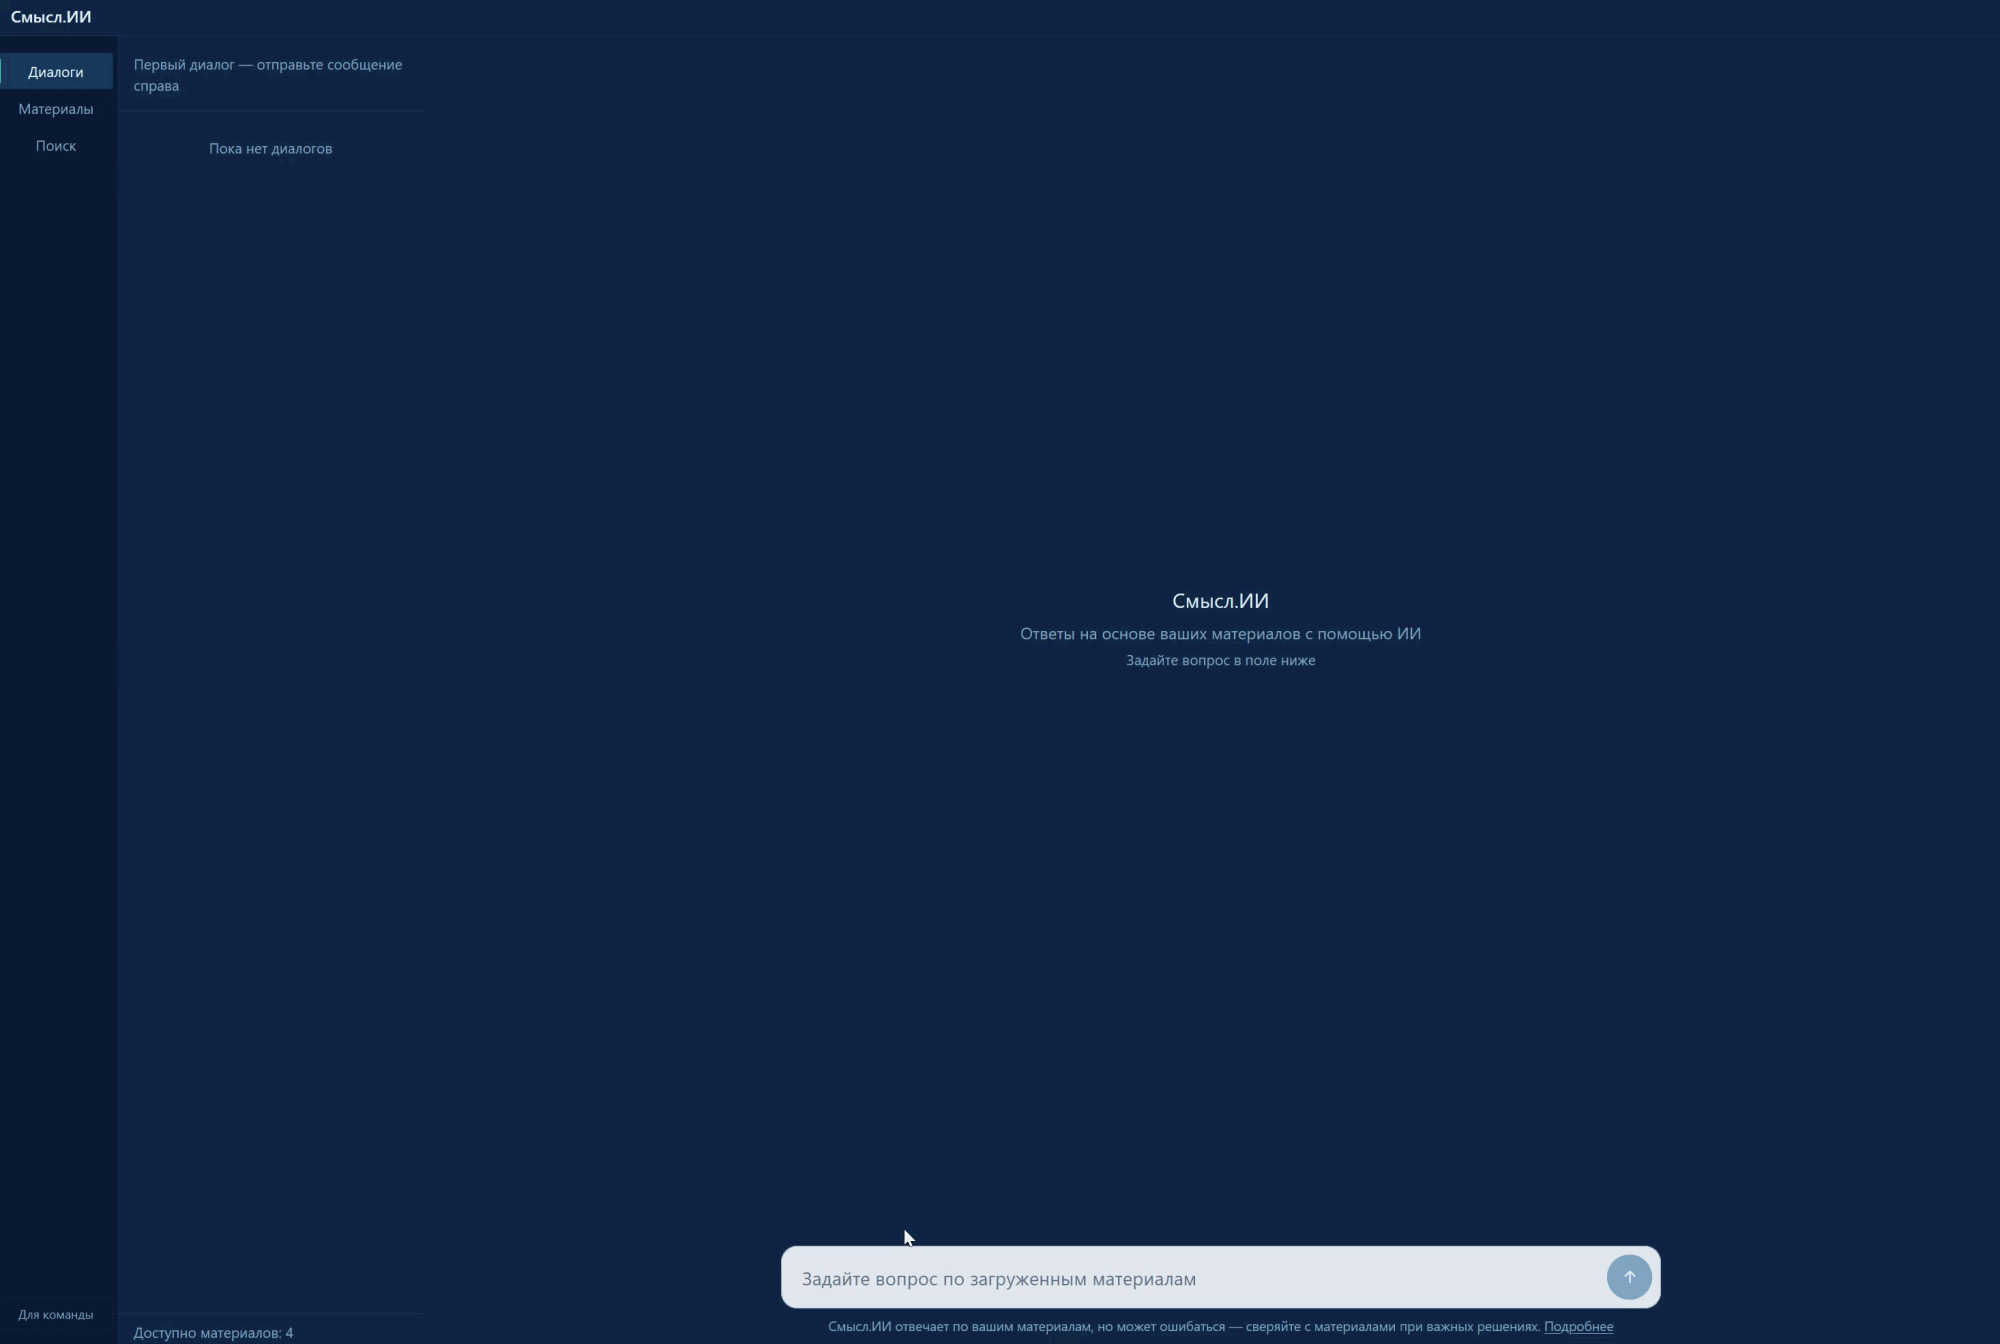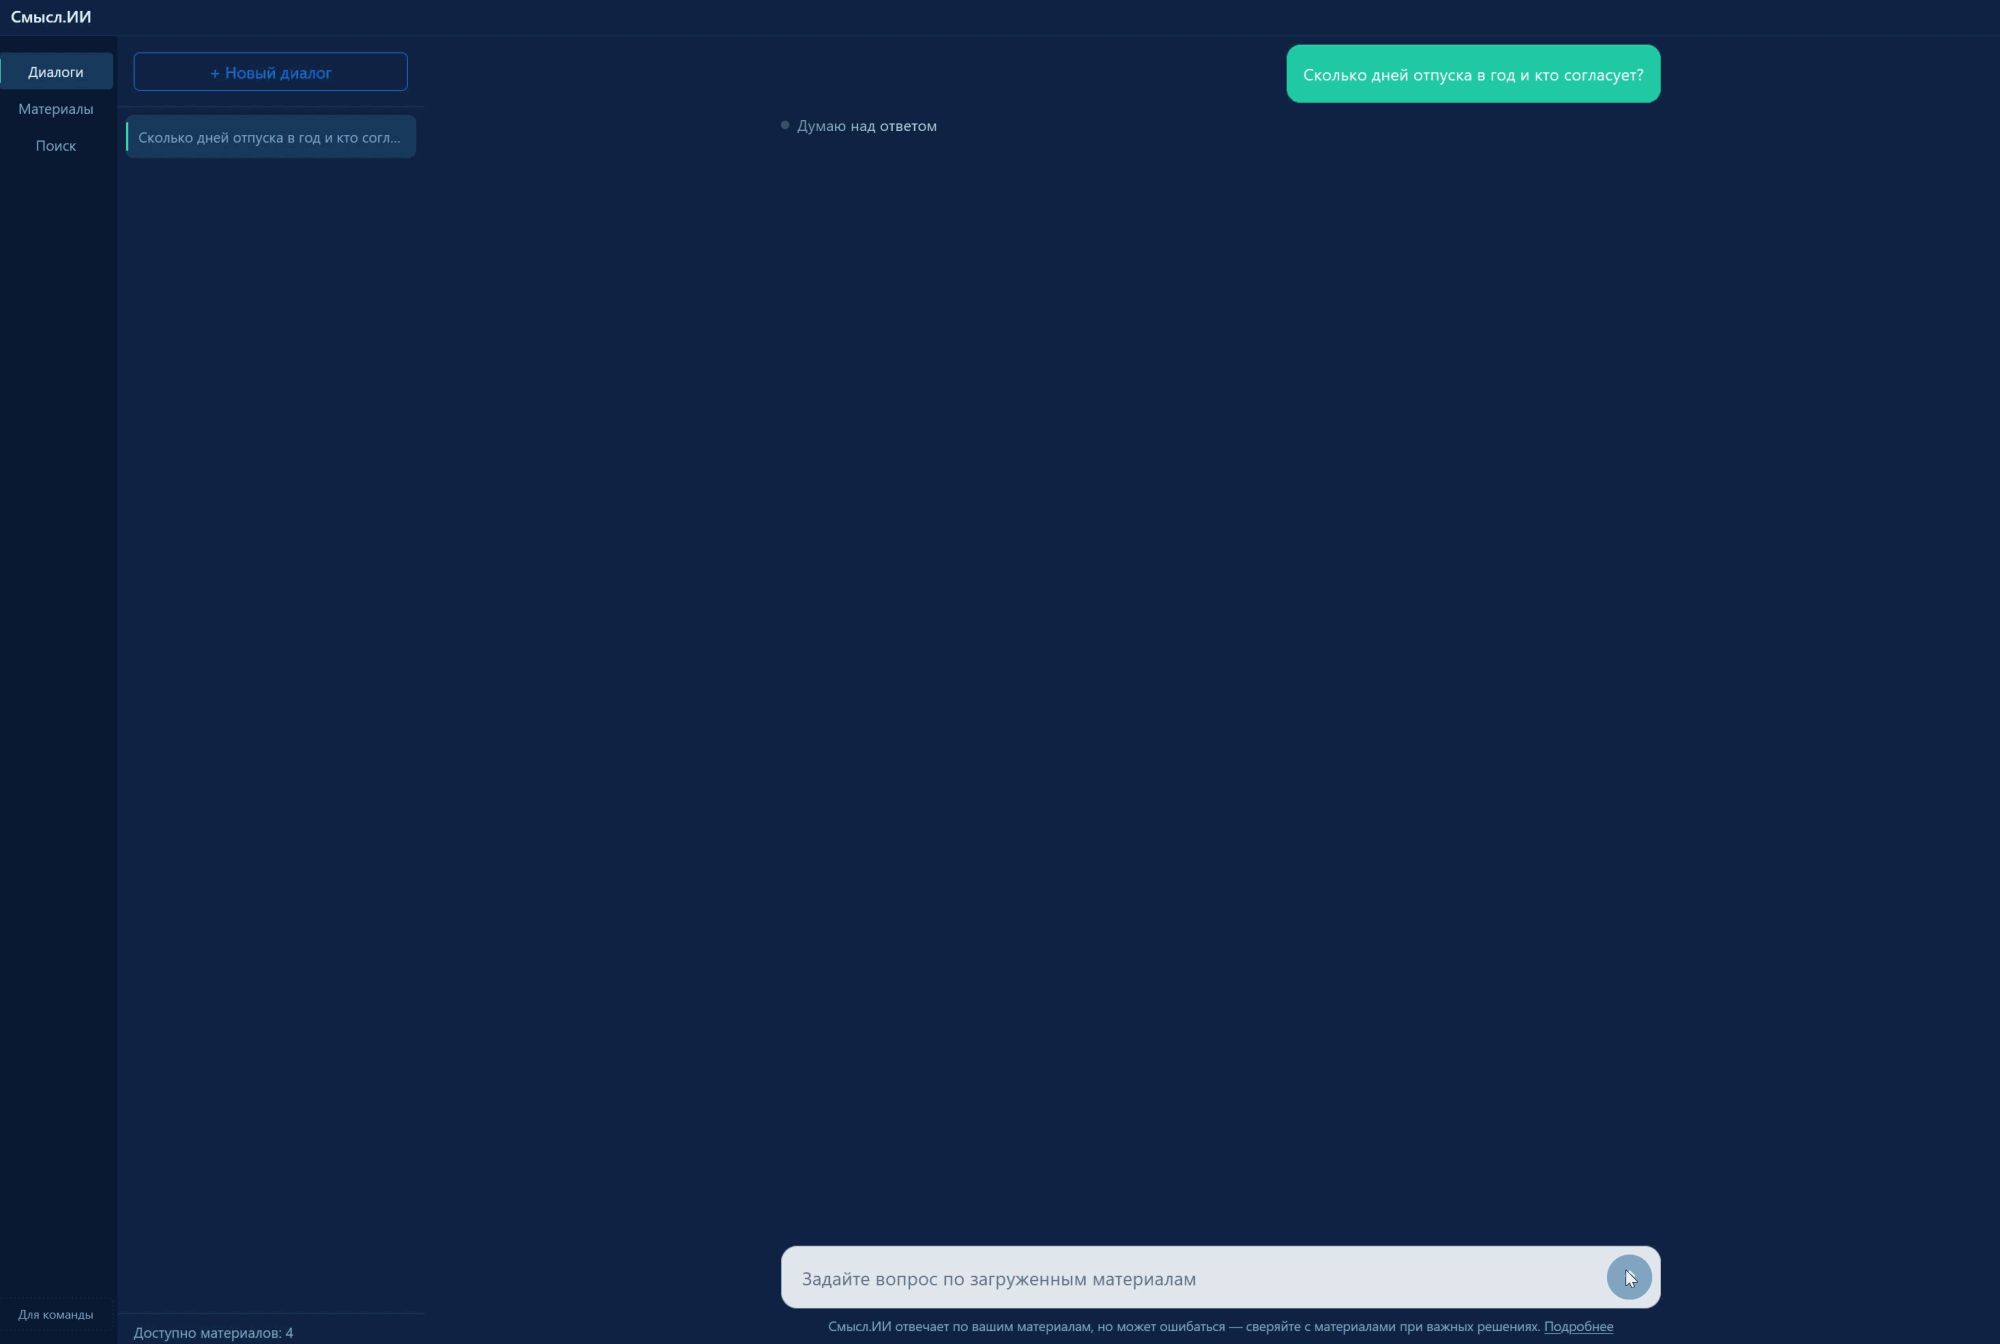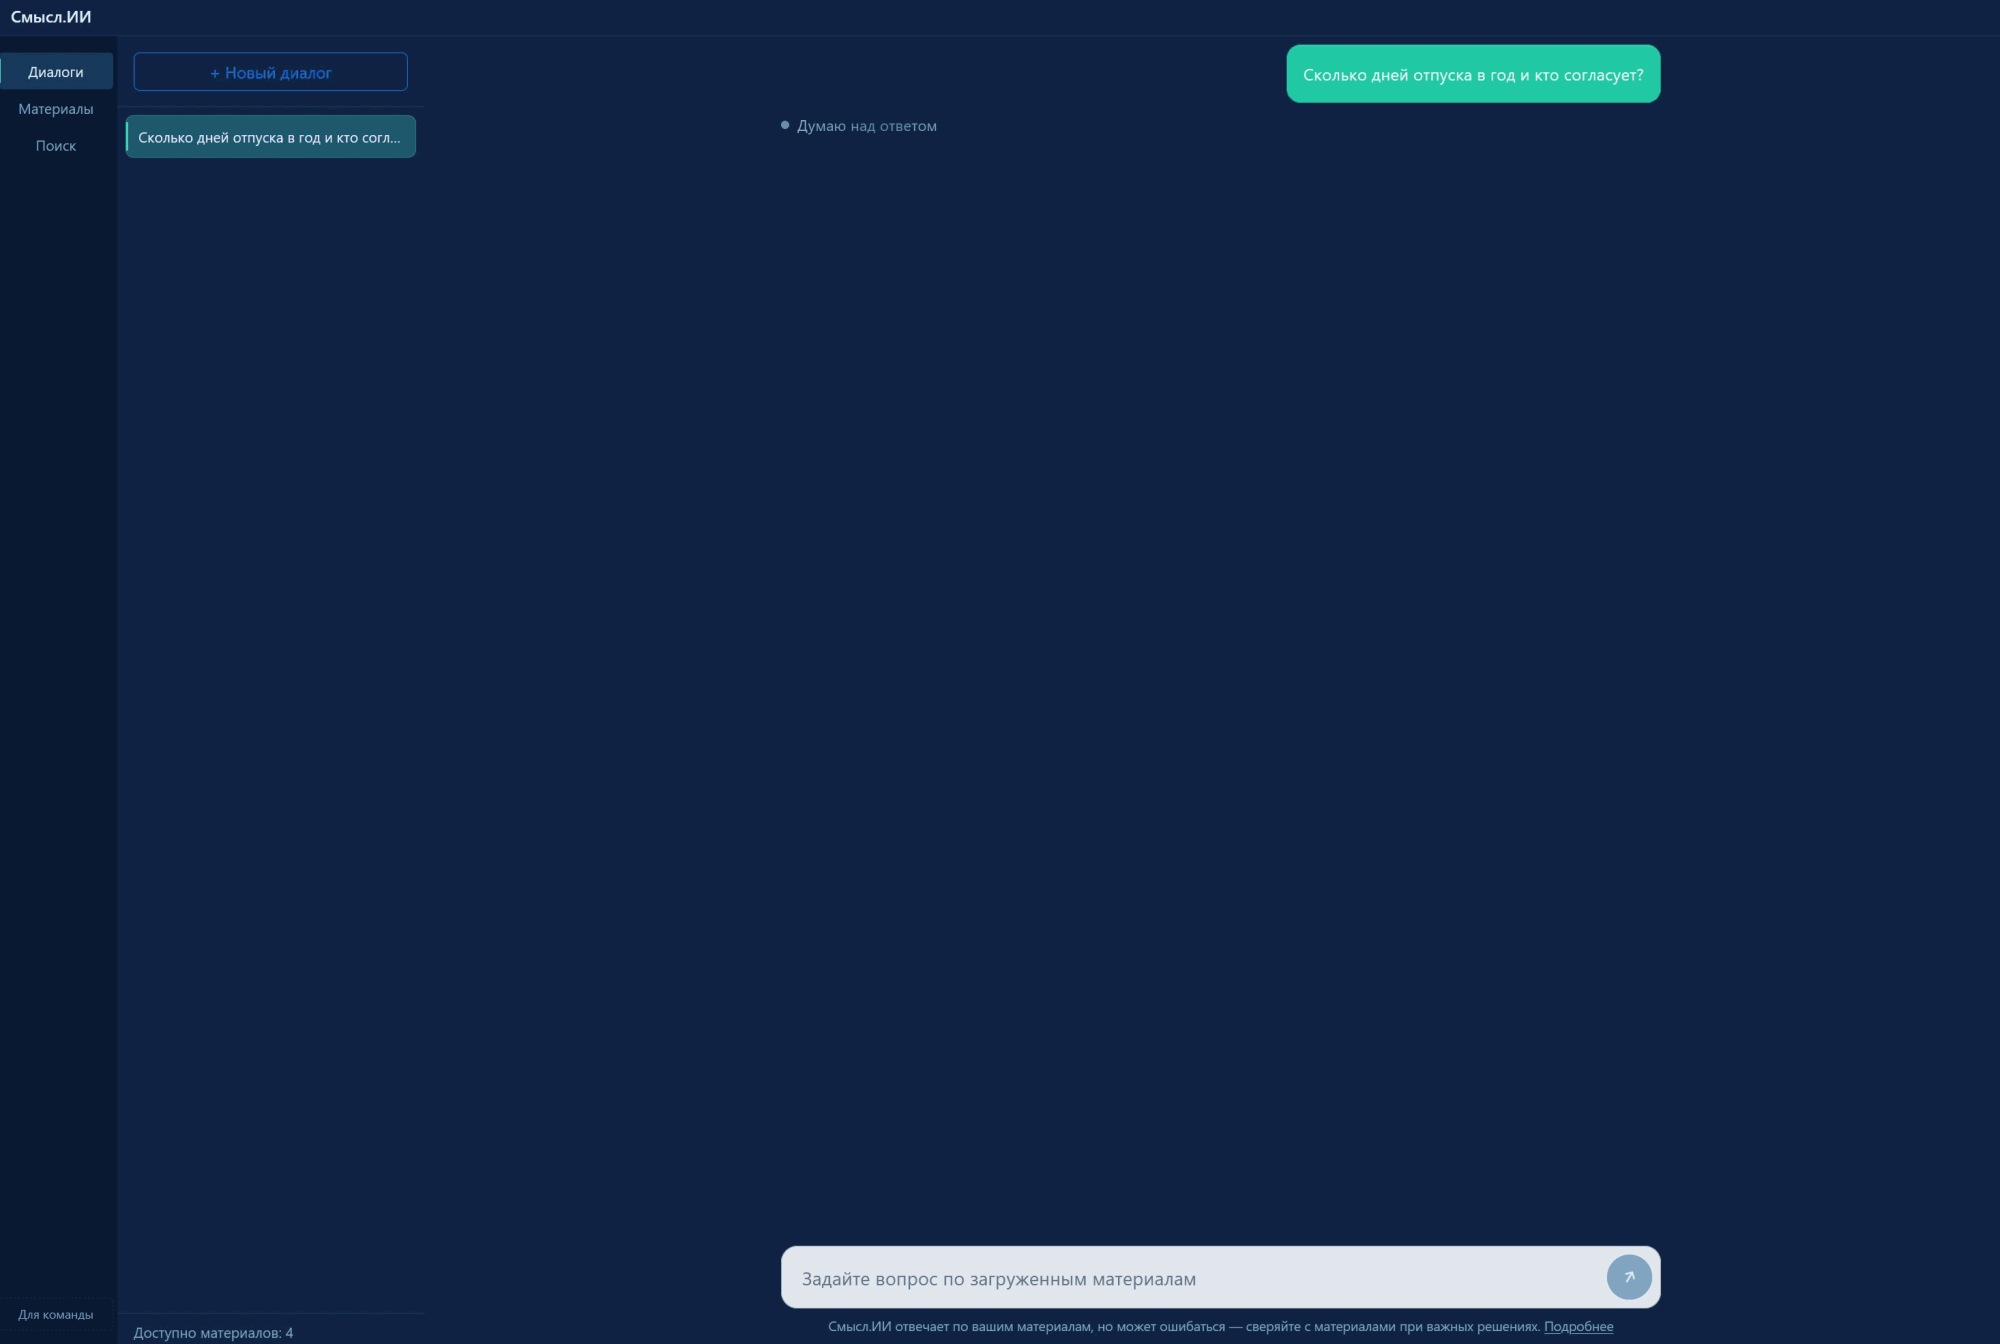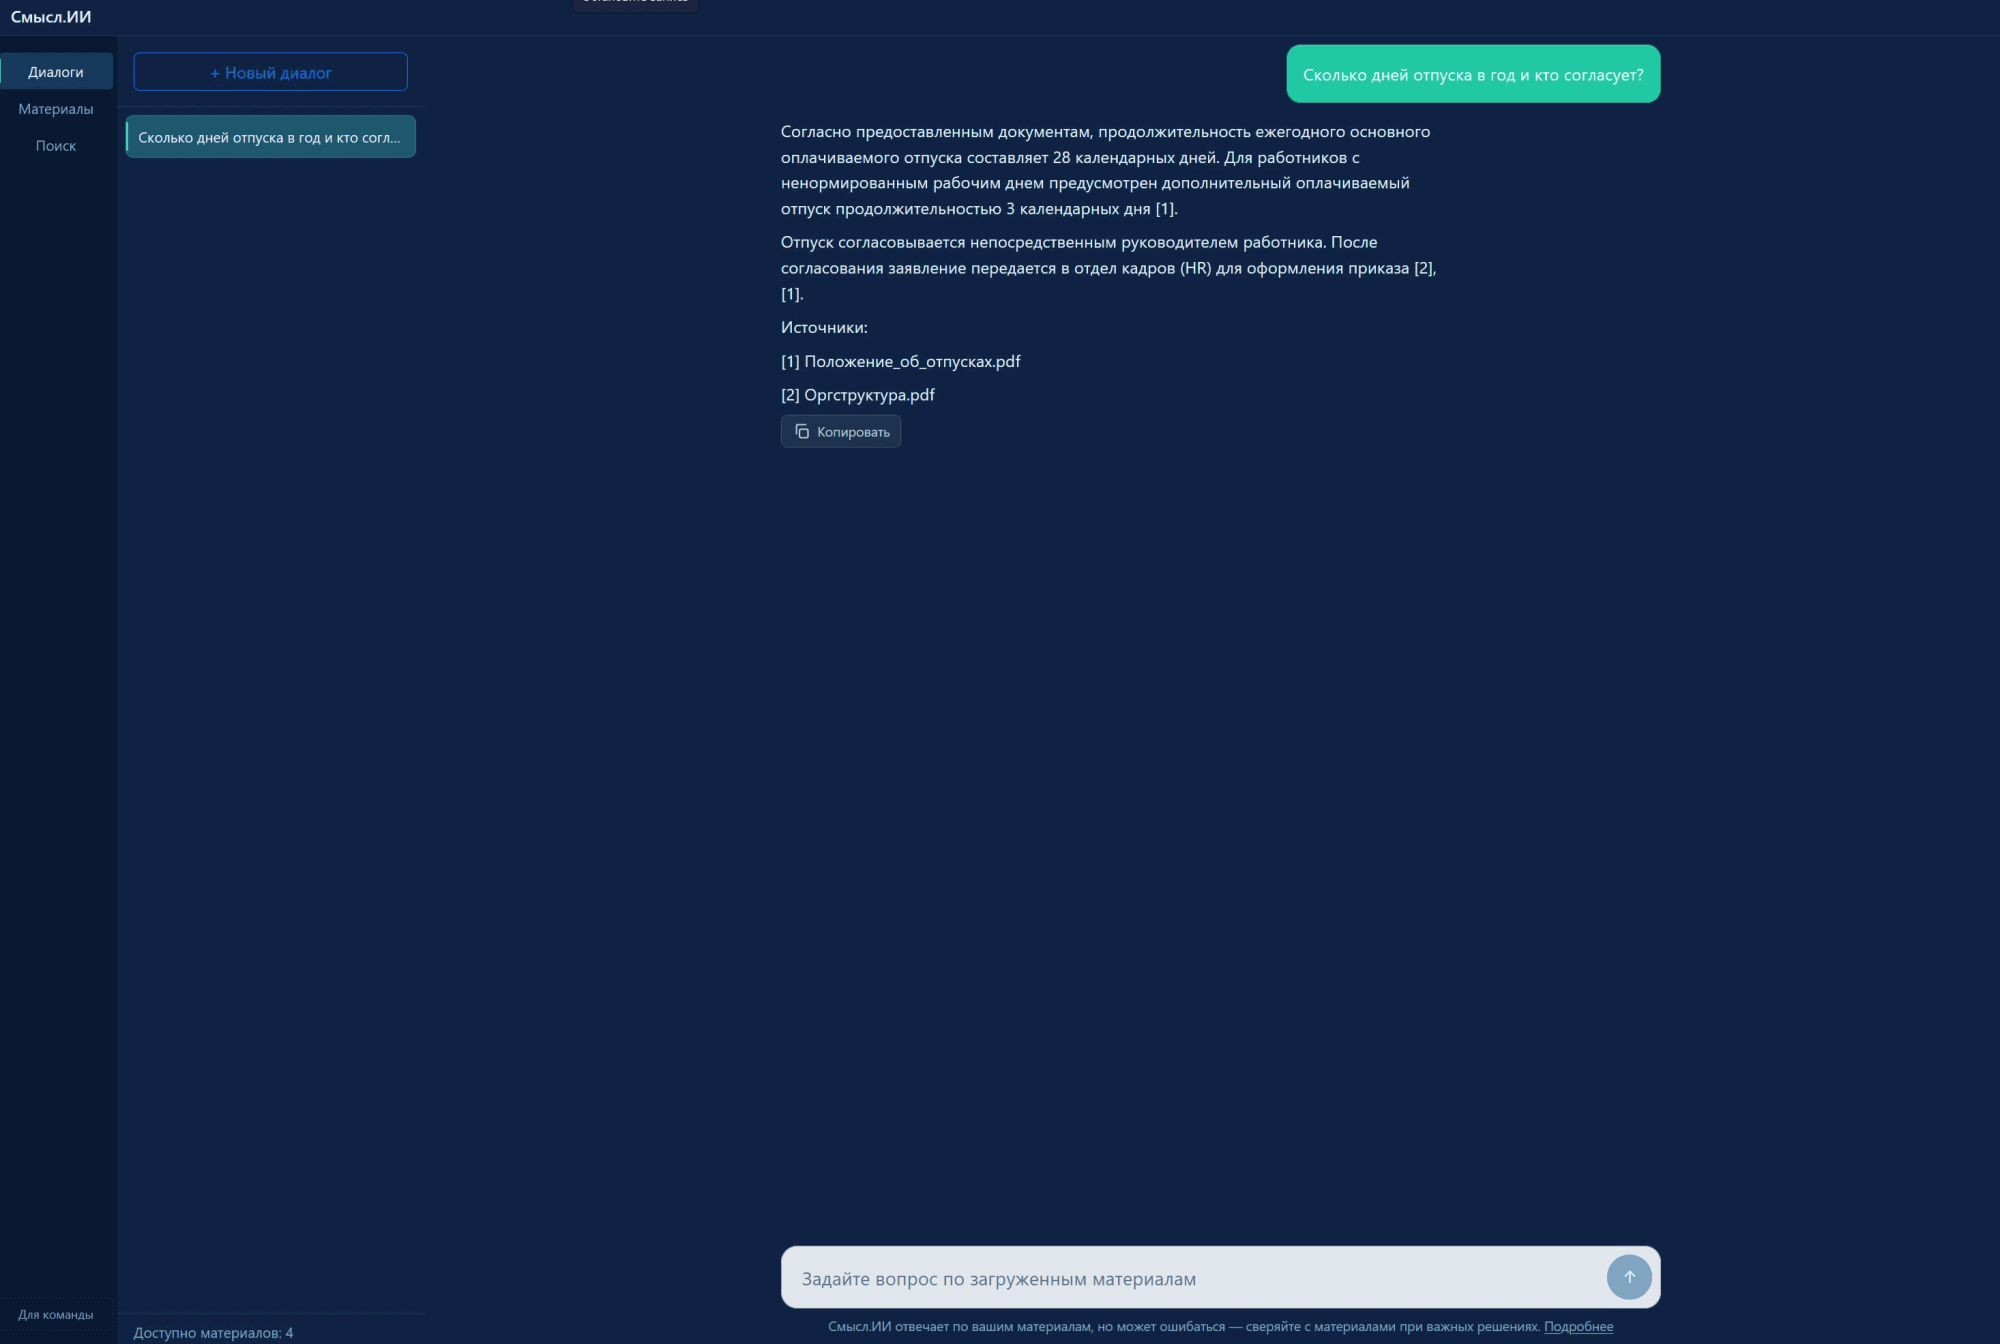
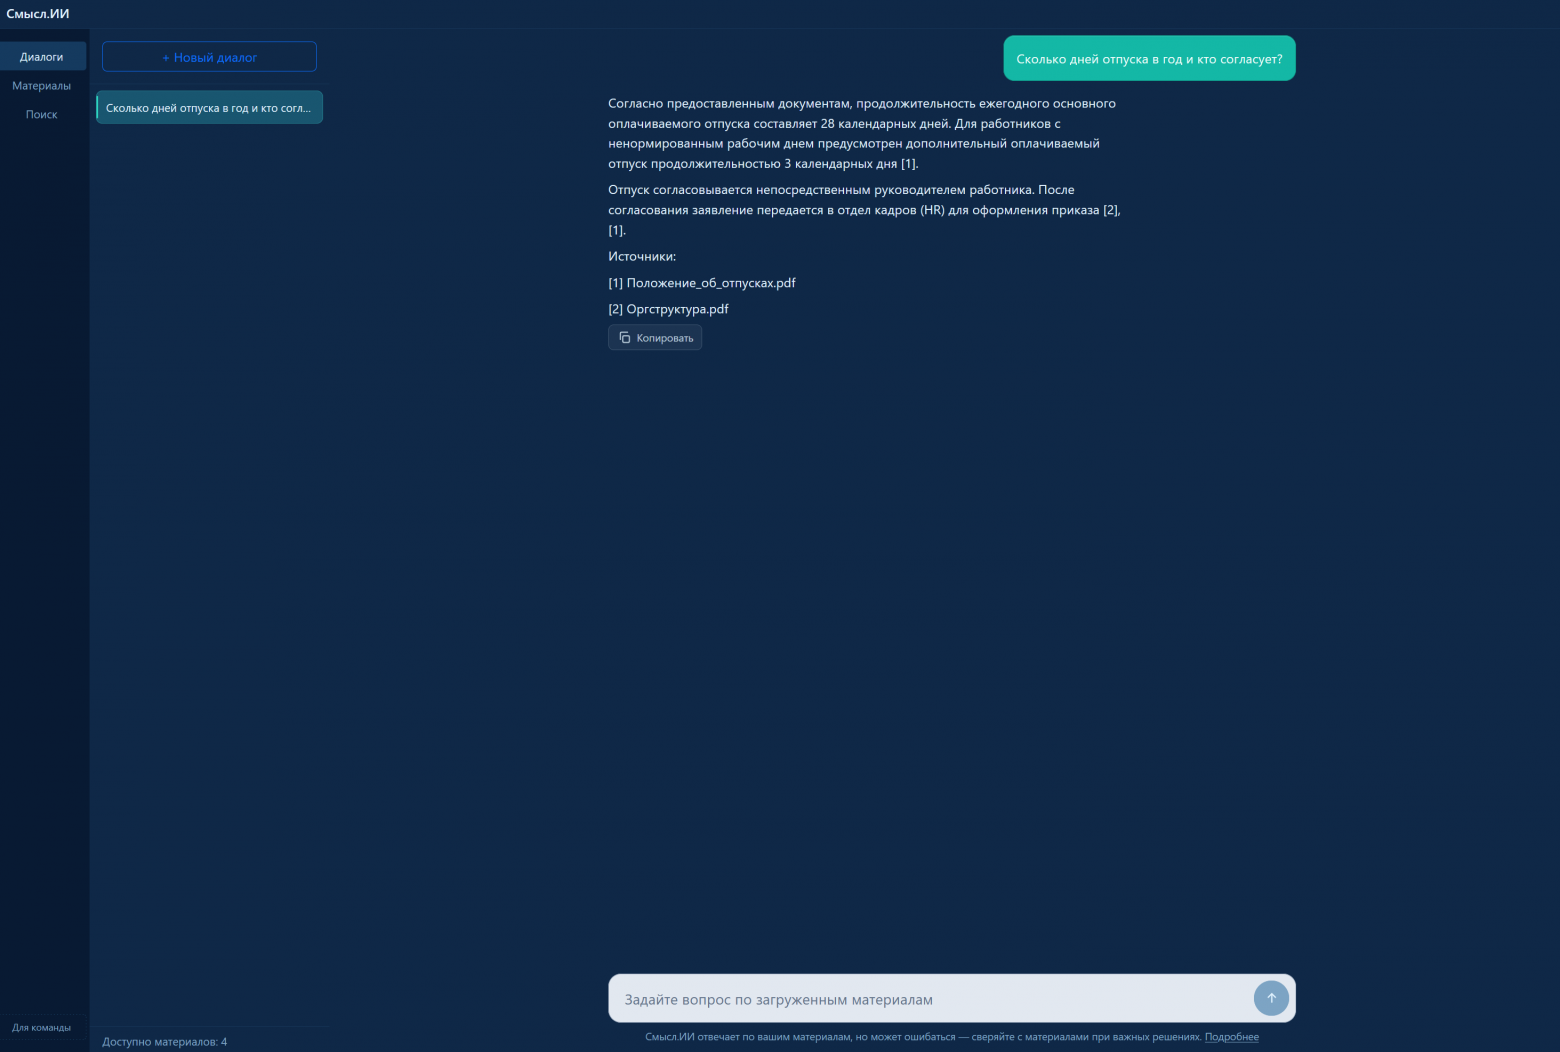
Финальный вид ответа:
2. Задача продукта и границы
В средних и крупных компаниях обычно накапливается большой объём внутренних документов и других материалов. Но когда нужно получить из них ответ на конкретный вопрос, это часто занимает много времени: обход папок и различных файловых хранилищ, уточнения у коллег.
Отдельная проблема — изоляция: фрагменты или целые файлы уходят во внешний чат вроде ChatGPT «просто проанализировать», корпус оказывается вне контура компании. В Смысл.ИИ библиотека хранится в инфраструктуре системы; для ответа в LLM уходят найденные фрагменты (чанки или страницы), а не весь корпус. LLM подключается по API: в текущем демо — внешний провайдер; тот же контур можно нацелить на модель в своём облаке или on-prem, если развёрнута совместимая точка доступа.
Узкая задача продукта: вопрос по корпоративному корпусу → ответ с опорой на ваши файлы (не «знания модели из интернета»), с источниками. За рамками — LMS, замена всей базы знаний и платформа агентов.
Под капотом: поиск → при необходимости уточняющие раунды агента → в контекст LLM уходят найденные фрагменты документов — чанки или целые страницы — и уже по ним формулируется ответ.
Обычный RAG часто = один проход retrieval → всё в контекст → ответ. Здесь у LLM есть tools: поиск по материалам может идти в несколько раундов (уточнил запрос / добрал фрагменты), потом ответ.
Ниже — как устроена эта система: документы → индекс → агент с инструментами → ответ и источники. Это разбор работающего продукта, а не чеклист enterprise-внедрения «под ключ».
3. Загрузка и чат
Загрузка / индексация
Сейчас система умеет обрабатывать: PDF, DOCX, TXT, MD, HTML.
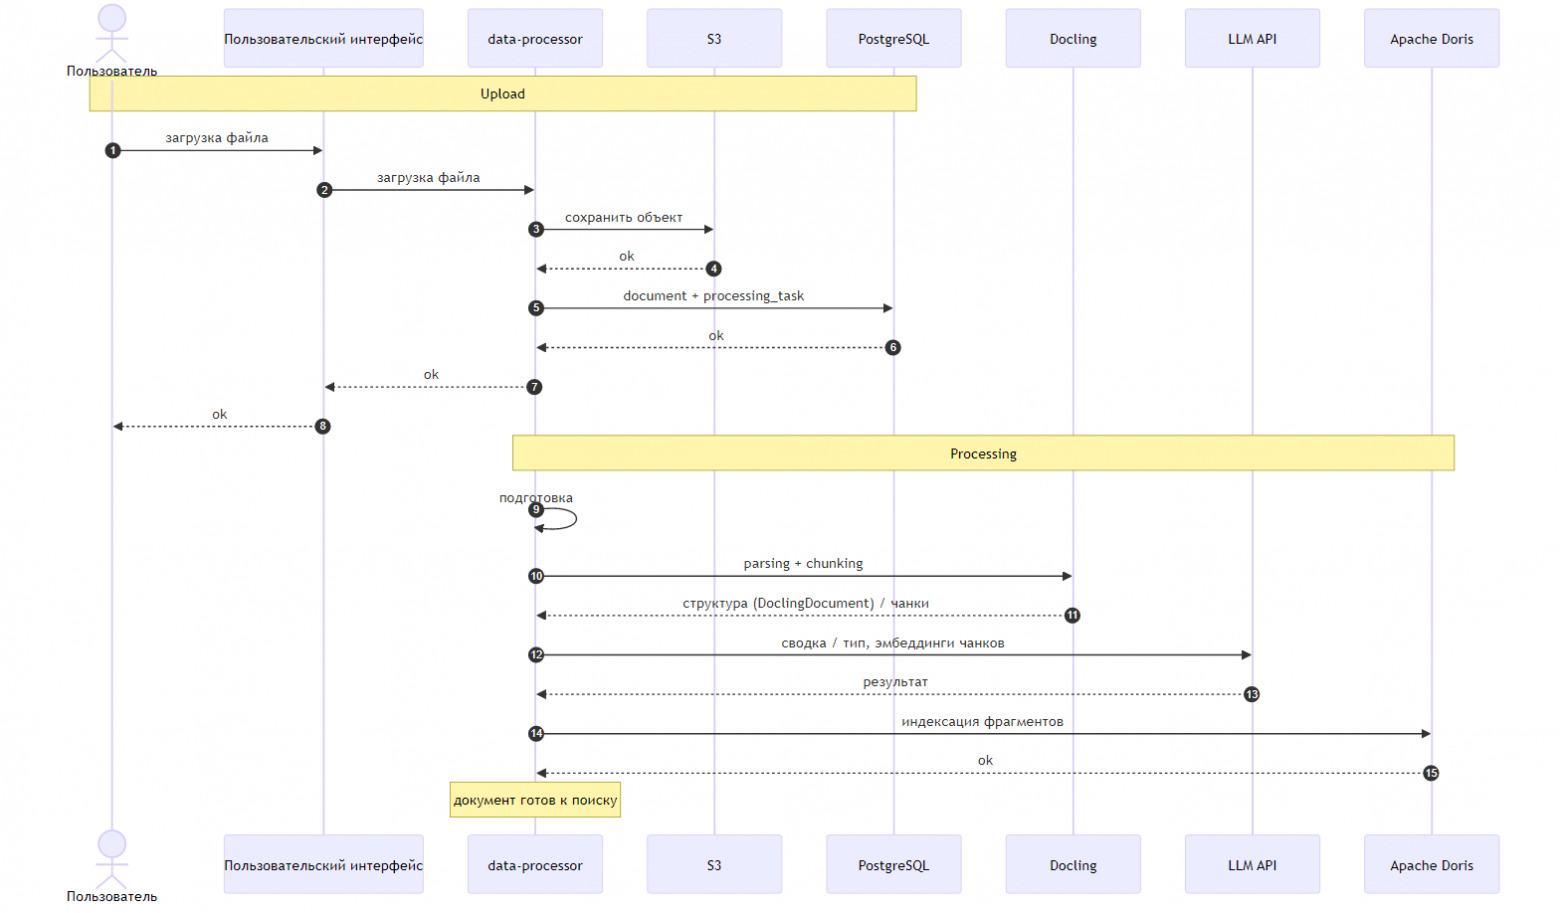
На схеме — путь файла от загрузки до индекса: парсинг, нарезка, запись фрагментов.
Чат
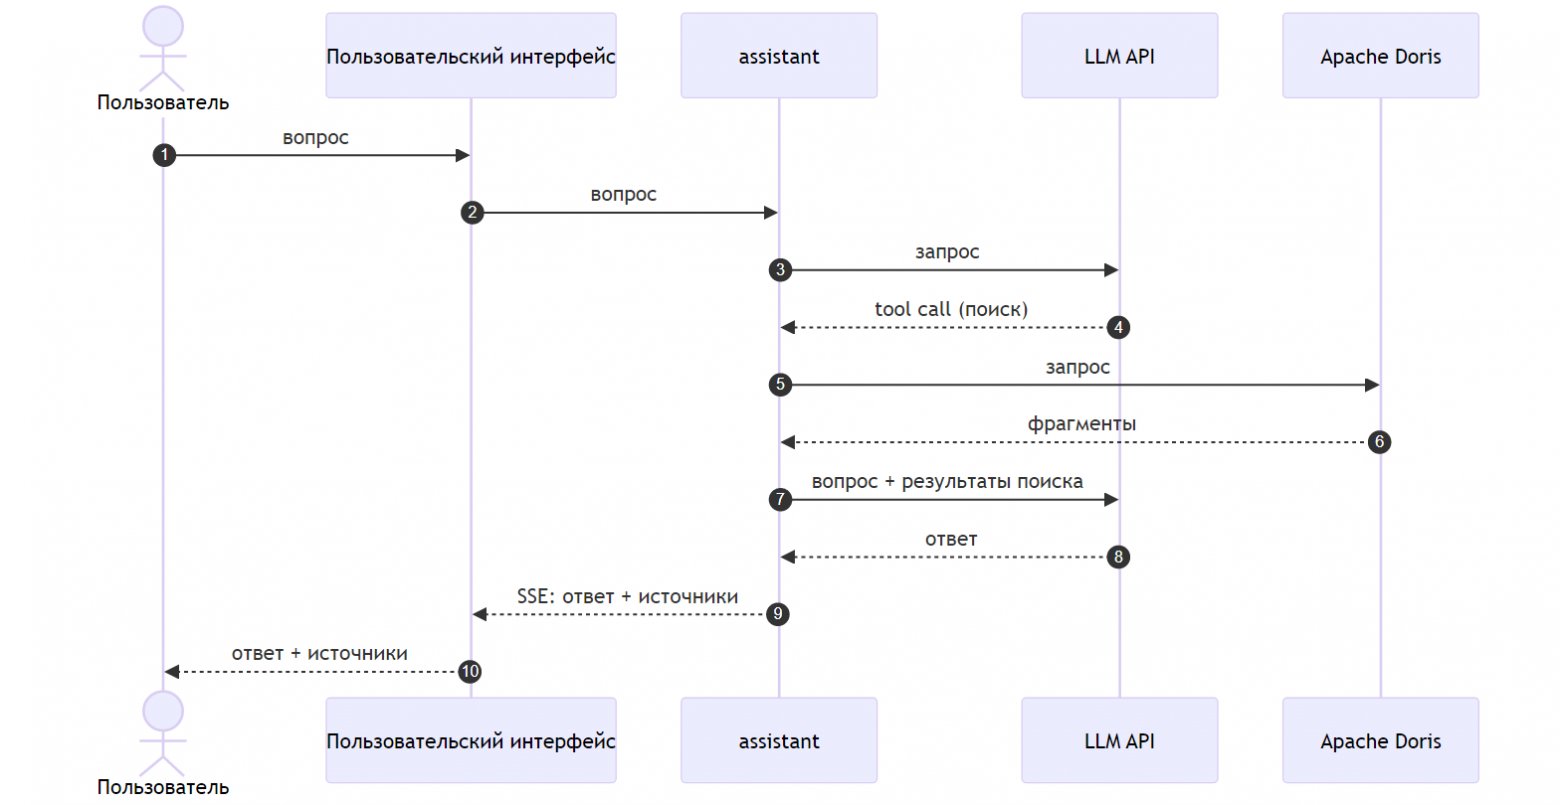
В чате вопрос уходит в агент; при необходимости вызывается tool (поиск по материалам), затем ответ со ссылкой на найденное. Это цикл с инструментами, а не один вызов LLM «в лоб».
4. Архитектура системы
Система состоит из:
Бэкенд — два сервиса с крупным разграничением: обработка документов и чат / ответы LLM
data-processor(Kotlin / Spring Boot) — загрузка и обработка документовassistant(Kotlin / Spring Boot, LangChain4j) — чат, агент, поиск
Фронтенд — пользовательский интерфейс (React)
Инфраструктура
Docling — парсинг и нарезка на чанки в конвейере обработки документов (
data-processor)Apache Doris, PostgreSQL
Auth (Keycloak)
Прокси (Caddy)
Внешние зависимости
LLM API
Объектное хранилище файлов (S3-совместимое)
VK Cloud — хостинг демо-контура
Два сервиса — не ради «микросервисов как моды», а из‑за разной ответственности и характера нагрузки: data-processor тянет загрузку и тяжёлую обработку файлов, assistant — диалог, tool calls и генерацию ответа. Так проще независимо развивать и выкатывать AI-контур и конвейер документов. Сотню сервисов с нуля не делал — граница одна: документы отдельно, диалог отдельно.
Ниже — упрощённая схема контейнеров.
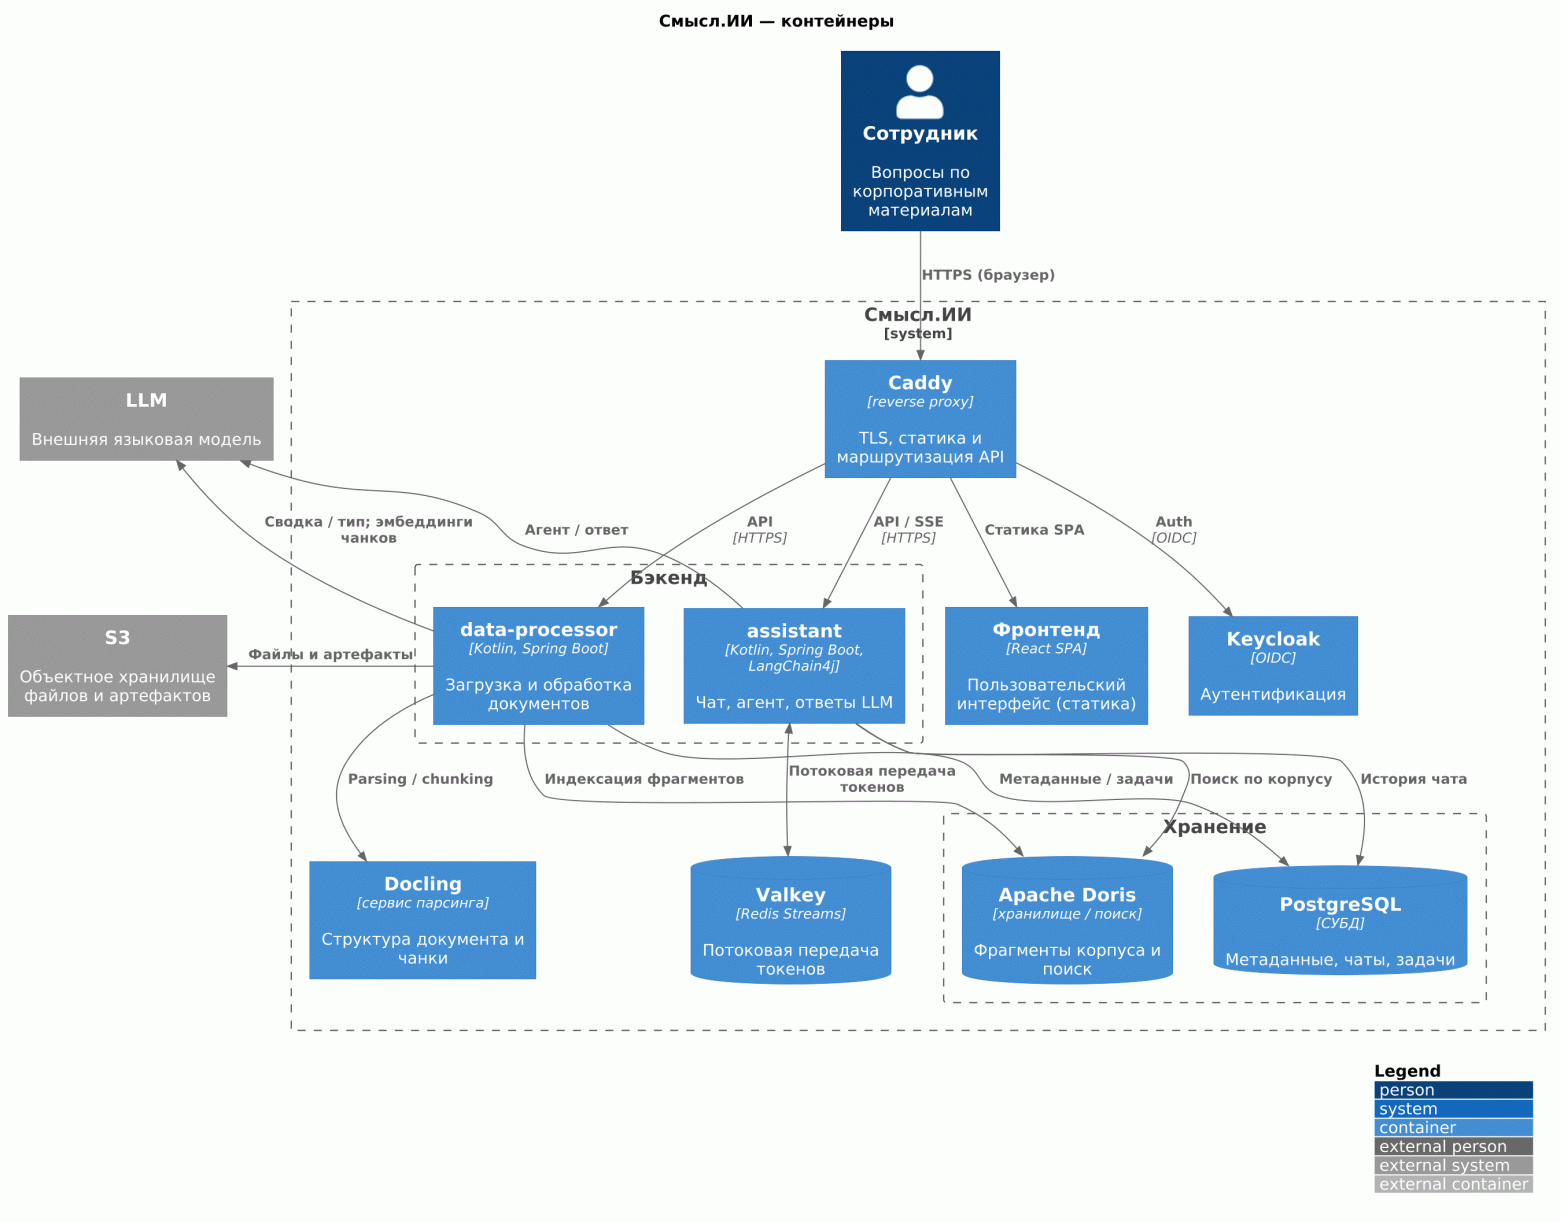
Ключевые решения по стеку
Apache Doris — full-text и semantic-поиск в одном хранилище, без связки «отдельный поисковик + vector DB». У Qdrant тоже есть оба режима; для продукта важнее единый контур под гибридный поиск и запас по нагрузке, а не чемпионство на чистом ANN (там специализированные vector DB часто сильнее).
Valkey Streams — генерацию ответа LLM крутит один инстанс
assistant, а SSE-подключение клиента может прийти на другой. Токены уходят в Valkey и читаются с инстанса, который держит соединение, а не только «вживую» с процесса, где крутится модель.GraalVM Native Image — сервисы в native: быстрее старт и ниже overhead относительно обычного JVM на том же контуре; плата — дольше сборка.
5. Стек технологий
Технология | Назначение |
|---|---|
Бэкенд | |
Язык программирования | |
Фреймворк | |
Создание native-образа | |
AI и агент | |
Вызов LLM, tools и цикл агента | |
Конвейер обработки документов | |
Парсинг загружаемых файлов и нарезка на чанки | |
Хранение и поиск | |
Хранение фрагментов документов и поиск по корпусу | |
Реляционная БД сущностей системы (метаданные файлов, чаты и др.) | |
S3-совместимое хранилище | Объектное хранилище файлов |
Фронтенд | |
Веб-интерфейс | |
Инфраструктура | |
Аутентификация (OIDC) | |
Valkey (Redis Streams) | Потоковая передача ответа LLM в чат |
Обратный прокси | |
Контейнеризация и локальный/демо-контур |
6. Вклад в open source
По ходу реализации находил ограничения и баги зависимостей. Это вылилось в issues и PR:
7. Что будет дальше
Серия из трёх статей:
Обзор (эта статья)
Конвейер обработки документов: Docling → стадии → индекс в Doris
Агент: tools, поиск по корпусу, ответ с указанием источников в материалах; потоковая передача токенов
Комментарии 0