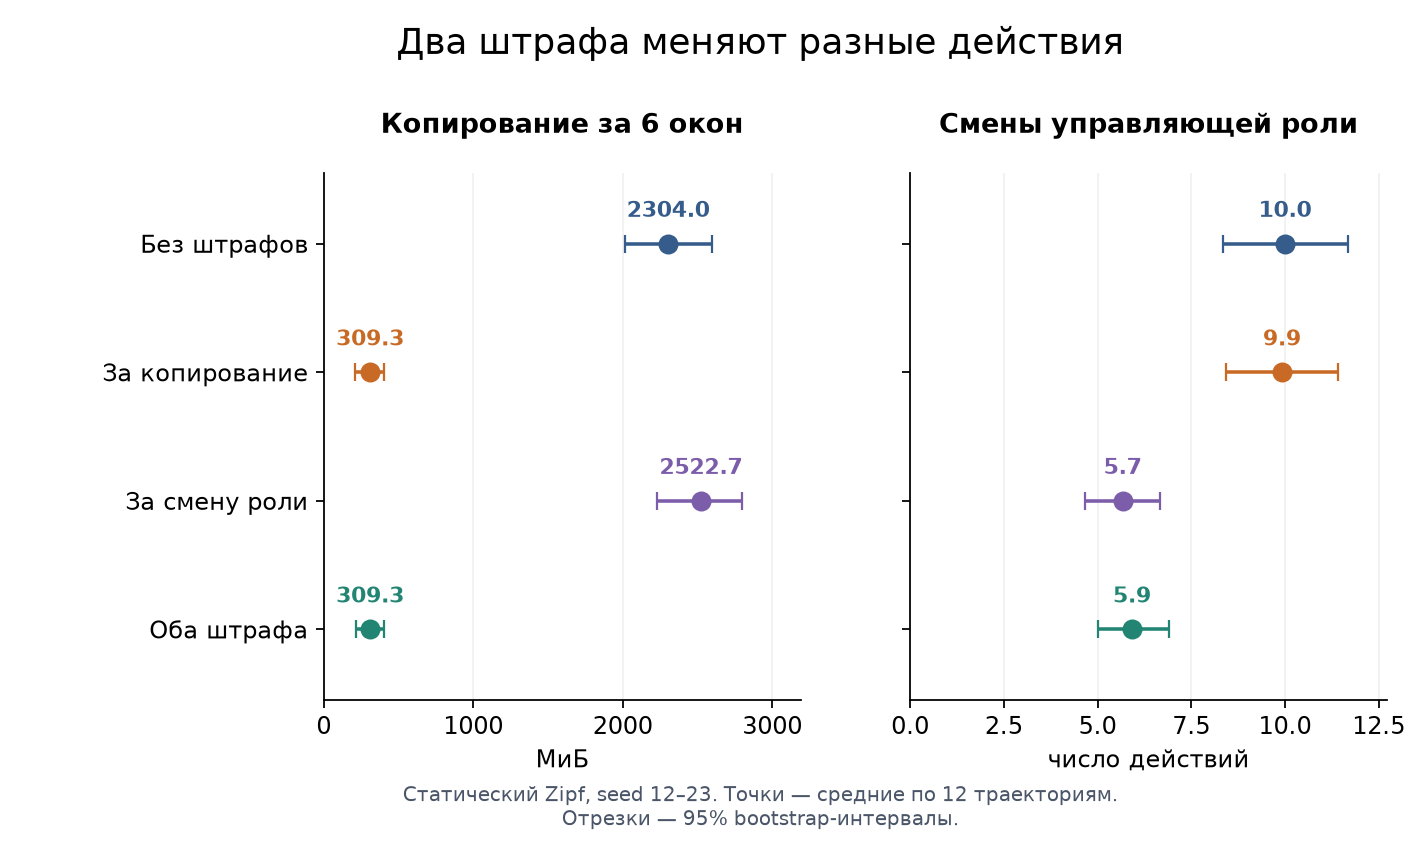
У балансировщика было два способа разгрузить узел: передать управляющую роль существующей копии или перенести реплику. Я добавил штраф за смену роли и при статической нагрузке Zipf получил больше копирования.
За шесть окон число смен роли уменьшилось с 10 до 5,67, а копирование выросло с 2304 до 2522,7 МиБ. Это на 43,3% меньше смен и на 9,5% больше данных. Результат получен в модели кластера из восьми узлов, где я сравнил четыре стратегии балансировки и отдельно проверил штрафы за копирование и смену роли.
Данные синтетические. Задержка в эксперименте складывается из ожидания в очереди узла и обслуживания одной операции.
Почему одинакового QPS недостаточно
Пусть на каждом узле лежит одинаковое число сегментов. Один сегмент читают раз в минуту, другой тысячи раз в секунду. Равное число копий в таком размещении не означает равную загрузку. Балансировка по QPS учитывает частоту операций, но стоимость их обработки может различаться.
Сто операций в секунду по 4 мс требуют 0,4 секунды работы узла за секунду. Те же сто операций по 12 мс требуют уже 1,2 секунды. Одноканальный узел с таким потоком не справится, хотя его QPS совпадает с соседним. Для сравнения узлов разной скорости нужно также учитывать их производительность.
В стенде стратегии используют разные сигналы нагрузки: число копий, число узловых операций или ожидаемую вычислительную занятость. Объём копирования и число смен роли я считаю отдельно.
Что именно переносит балансировщик
Каждый сегмент хранится на трёх разных узлах. Одна копия назначена управляющей: ей направляются чтения, а запись создаёт операцию на каждой из трёх копий. У этой схемы два действия с разной стоимостью.
При смене роли обслуживающим становится узел, на котором уже есть копия сегмента. Полный сегмент копировать не требуется. При переносе реплики данные отправляются на узел, где их ещё нет. Если переносится управляющая копия, роль следует за ней.
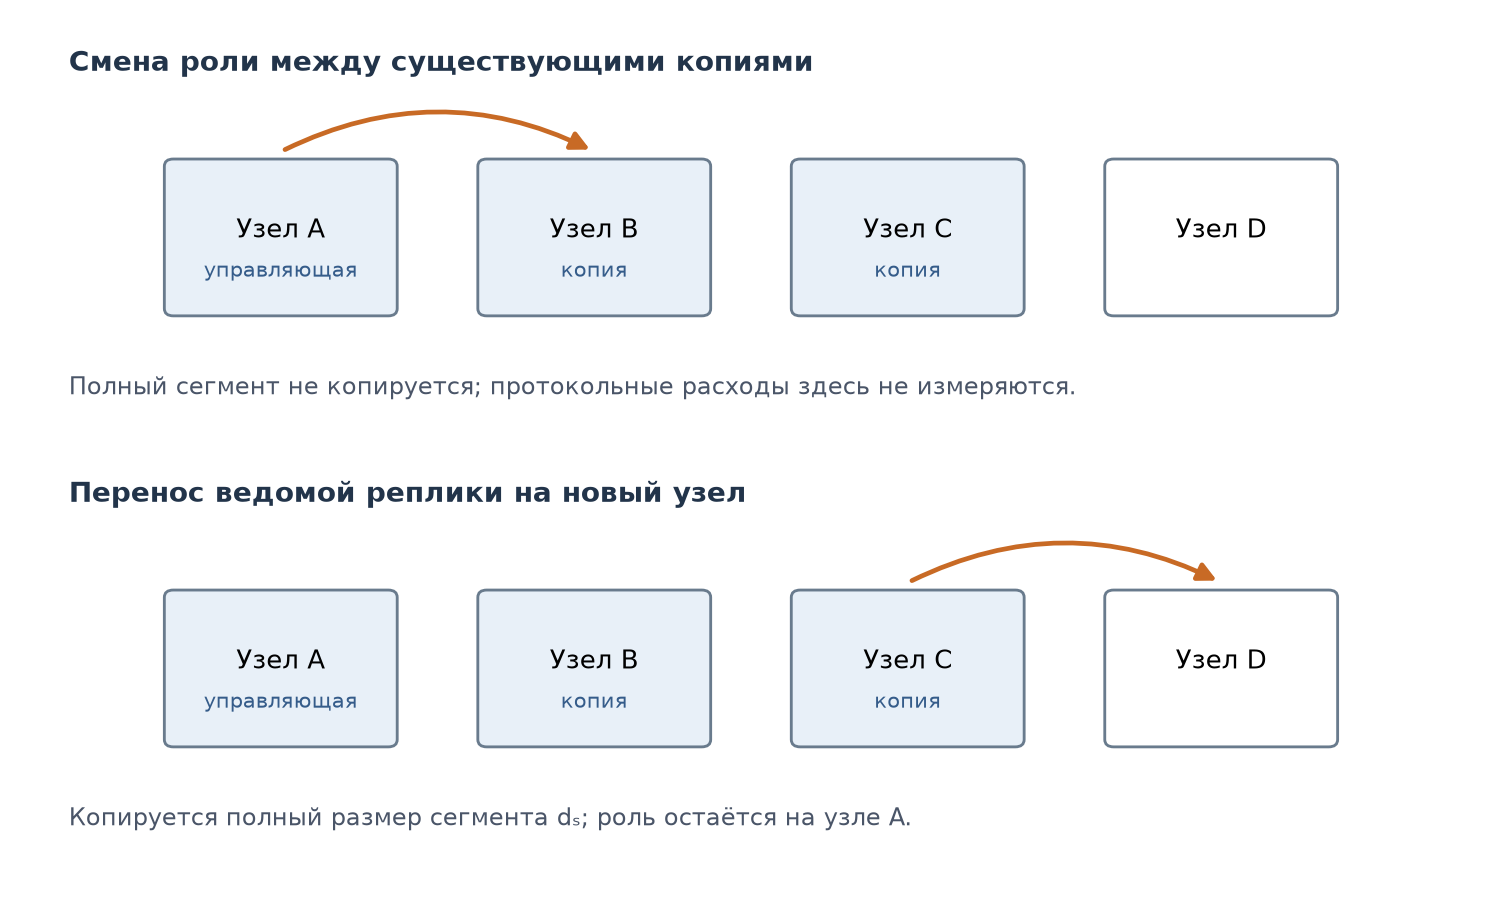
Нулевой объём при смене роли относится только к копированию полного сегмента. Сетевые сообщения и прогрев в этой модели не добавляют времени к операции.
В CockroachDB Raft-лидер и держатель lease выполняют разные функции. В стенде они объединены в управляющую реплику. Консенсус Raft, кворумное ожидание и транзакционный commit не моделируются.
Четыре способа выбрать перемещение
У всех вариантов одинаковые допустимые действия. За окно разрешены не более 12 шагов и 512 МиБ копирования. После каждого шага должны сохраняться три разнесённые копии, единственная управляющая роль и ограничение ёмкости узлов. Повторный перенос снова расходует бюджет.
Стратегия | По чему выбирает действие |
|---|---|
Count | Число копий и управляющих ролей на узлах |
QPS | Число узловых операций, включая записи на ведомых копиях |
Work | Стоимость операций, скорость узлов и ожидаемая занятость |
Cost | Тот же критерий Work и штрафы за копирование и смену роли |
Work уменьшает максимальную занятость и её разброс, дополнительно штрафуя приближение к насыщению. Cost принимает действие, если улучшение этого критерия превышает штрафы за изменение и общий порог поиска. Коэффициент β задаёт цену копирования, γ задаёт цену смены роли. В эксперименте β = 0,1, γ = 0,002.
Поиск жадный: на каждом шаге перебираются допустимые кандидаты и выбирается лучший. При недостаточном улучшении поиск останавливается. Общий порог равен 0,001, порядок разрешения равенств фиксирован. Поиск может пропустить полезную комбинацию из нескольких шагов и остановиться до глобального оптимума.
Формальная модель и точные критерии стратегийДля сегмента s заданы интенсивность λₛ, доля записей wₛ и размер dₛ. Для узла i — относительная производительность vᵢ и ёмкость Dᵢ. Двоичные xₛᵢ и yₛᵢ обозначают наличие копии и управляющей роли. Ограничения размещения:
Σᵢ xₛᵢ = 3
Σᵢ yₛᵢ = 1
yₛᵢ ≤ xₛᵢ
Σₛ dₛ xₛᵢ ≤ Dᵢ
Двоичность x исключает две копии сегмента на одном узле. Географические домены отказа не задаются. Пусть cᵣ — обслуживание чтения, cₗ — записи на управляющей копии, c_f — записи на ведомой. Тогда узловые QPS и занятость:
qᵢ = Σₛ λₛ [(1 − wₛ)yₛᵢ + wₛxₛᵢ]

ρᵢ = Σₛ λₛ [(1 − wₛ)cᵣyₛᵢ
             + wₛ(c_f xₛᵢ + (cₗ − c_f)yₛᵢ)] / vᵢ
q измеряется в операциях в секунду, ρ безразмерна. При ρ = 0,8 поток требует 80% ресурса одноканального узла; при ρ ≥ 1 устойчивого стационарного обслуживания в модели нет.
Узел обрабатывает операции в порядке поступления, FCFS. Для поступления a, предыдущего завершения f_prev и обслуживания c/vᵢ:
f = max(a, f_prev) + c / vᵢ
R = f − a
R — ожидание и обслуживание одной узловой операции. Копии записи учитываются отдельно; их среднее не является задержкой клиентской транзакции.
Count минимизирует сумму нормированных стандартных отклонений числа копий и числа управляющих ролей с весами 1 и 0,25. QPS минимизирует сумму максимума и стандартного отклонения q, делённую на среднее q. Эта конкретная эвристика не различает стоимость операций и скорость узлов; она не представляет все реализации балансировки по QPS.
Критерий Work:
F = max(ρᵢ) + std(ρᵢ) + 0,05 · mean(φ(ρᵢ))

φ(u) = u / (1 − u),         если u ≤ 0,95
       19 + 400(u − 0,95),   если u > 0,95
В std дисперсия делится на число узлов. Продолжение касательной после 0,95 оставляет штраф конечным при перегрузке. Это критерий выбора размещения; измеряемая задержка R рассчитывается отдельно по FCFS.
Для Cost при бюджете B и последовательности действий A:
J = F_после + β · Σ m(a) / B + γ · Σ h(a)
m(a) равна размеру сегмента при переносе реплики и нулю при смене роли между готовыми копиями. h(a) отмечает изменение узла с управляющей ролью, включая перенос управляющей копии. Все слагаемые J безразмерны. На шаге улучшение F должно превышать штрафы действия и порог 0,001. Ограничение объёма за окно не моделирует передачу данных во времени: перемещения завершены до измерения очередей.
Как устроен стенд
Расчёт написан на Python со стандартной библиотекой. В репозитории исследования закреплена версия 8ccb2a4 с исходным кодом и первой серией результатов. Параметры выбраны для модельного сравнения, под конкретную СУБД они не калибровались.
Параметр | Значение |
|---|---|
Кластер | 8 узлов, 24 сегмента, 3 реплики |
Поток | 300 внешних запросов в секунду, пуассоновские поступления |
Обслуживание | Чтение 4 мс, управляющая запись 12 мс, ведомая запись 8 мс |
Доля записей | Для каждого сегмента из интервала 0,05–0,6 |
Размер сегмента | 64, 128, 256 или 512 МиБ |
Ёмкость узла | Удвоенный средний объём реплик, округлённый вверх до 64 МиБ |
Траектория | 6 окон: 5 с разогрева и 15 с измерения в каждом |
Проверены четыре профиля. В первом интенсивности сегментов равны. Во втором обращения распределены по Zipf с показателем 1,1: небольшая часть сегментов получает основную нагрузку. В третьем ранги горячих сегментов сдвигаются каждые два окна. В четвёртом используется тот же статический Zipf, но скорости узлов различаются от 0,65 до 1,35 при среднем 1.
В первой серии я сравнил Count, QPS, Work и Cost на seed 0–11. Получилось 192 траектории стратегий, или 1152 окна. Во второй серии оставил одну модель Work и по отдельности включал штрафы: без них, только β, только γ, оба вместе. Для неё использованы новые seed 12–23 — ещё 192 траектории и 1152 окна. Настройки перед этой серией сохранил и по её результатам не подбирал.
При одинаковых сценарии, seed и окне все варианты получают один и тот же список поступлений. Разница в результатах возникает при обработке общего потока, а случайные колебания между потоками не смешиваются с различиями стратегий.
Как считались задержки и доверительные интервалыНачальное размещение содержит по девять копий и три управляющие роли на узел. С seed меняются размеры сегментов, доли записей, порядок узлов и сопоставление горячих рангов сегментам. Count уже находится в минимуме своего критерия и поэтому ничего не переносит. Это контроль равенства количества; основной контроль для штрафов — Work с той же нагрузочной моделью, что у Cost.
SHA-256 входной трассы сохраняется. Размещение наследуется между окнами, очередь каждого окна начинается заново с разогревом. Поступления в измеряемом интервале учитываются и при завершении после его границы. При ρ ≥ 1 задержка характеризует конечное окно, а не стационарный режим. Для статического Zipf и разных скоростей узлов входные запросы совпадают при том же seed.
Среднее R траектории взвешено по числу узловых операций. Объём копирования и число смен роли суммируются за шесть окон, затем усредняются по seed. Показатели p95 и p99 считаются ближайшим рангом внутри окна и усредняются по окнам; это не перцентили объединённой выборки.
Для 95%-х percentile-bootstrap-интервалов выполнены 10 000 повторных выборок по 12 seed. Разности считаются попарно внутри seed. Окна и запросы не объявляются независимыми повторами, две серии ради сужения интервалов не объединяются. Интервалы описательные, без поправки на множество сравнений; их покрытие при таком малом числе seed отдельно не калибровалось.
Меньше смен роли, больше копирования
Во второй серии у четырёх вариантов одинаковы критерий нагрузки F, алгоритм поиска и входные запросы. Меняются только β и γ. В таблице приведены средние по 12 новым seed для статического Zipf; копирование и смены роли суммированы за шесть окон.
Штрафы | Среднее R, мс | Копирование, МиБ | Смены роли |
|---|---|---|---|
Нет | 11,250 | 2304,0 | 10,00 |
Только копирование | 11,796 | 309,3 | 9,92 |
Только смена роли | 11,279 | 2522,7 | 5,67 |
Оба | 11,876 | 309,3 | 5,92 |
По сравнению с вариантом без штрафов один γ увеличил средний объём копирования на 218,7 МиБ. Парный 95%-й интервал этой разности составил [64,0; 389,3] МиБ. Число смен роли уменьшилось в среднем на 4,33 с интервалом [−5,25; −3,42].
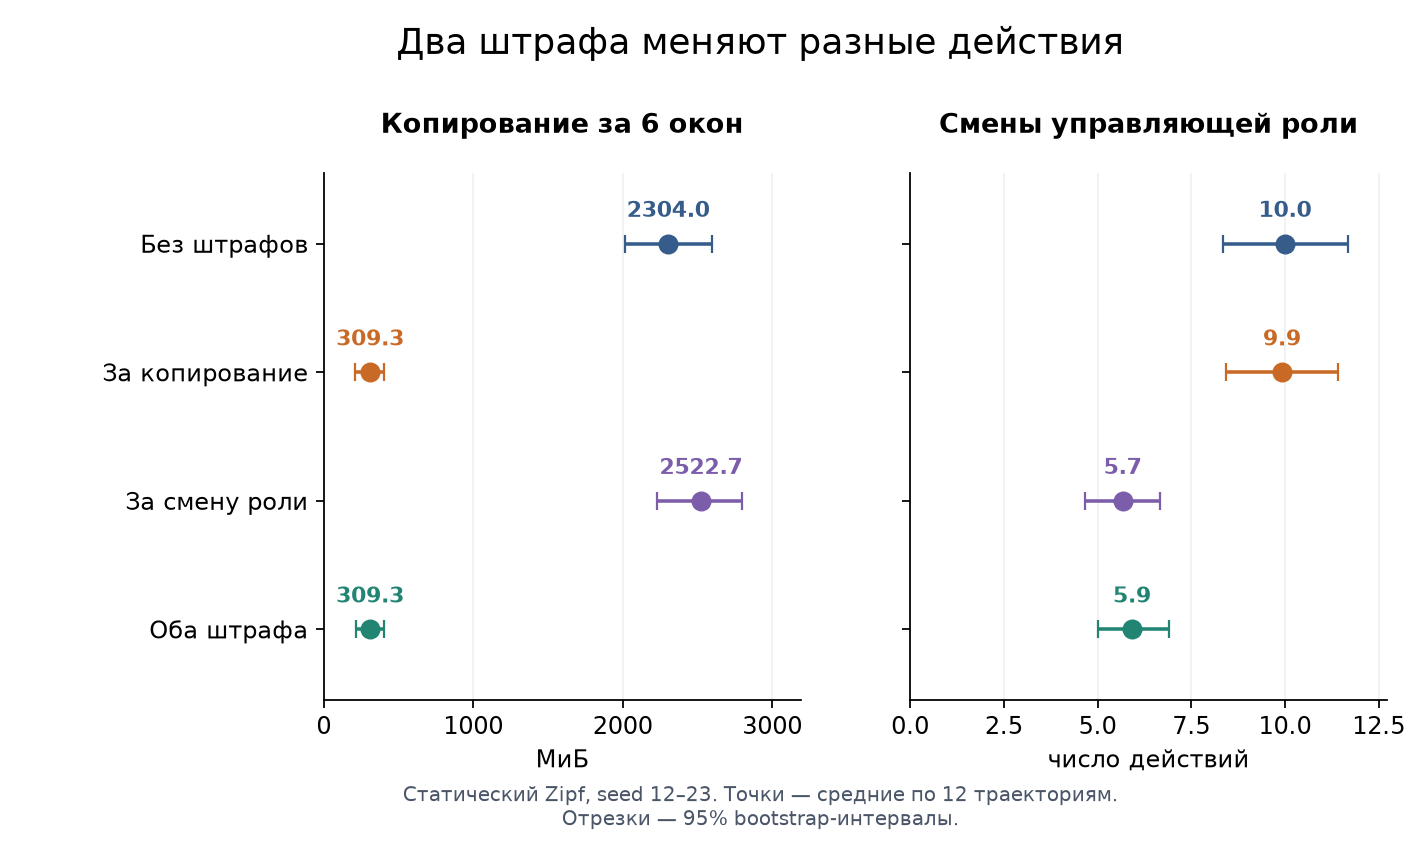
В критерии контроллера смена роли получает штраф γ. Перенос ведомой реплики этого штрафа не получает: управляющий узел остаётся прежним. При β = 0 копирование тоже не штрафуется, и жадный поиск может предпочесть такой перенос. Механизм допускает замещение действий, однако по агрегированным показателям нельзя установить причину каждого выбора.
При одном β объём уменьшился до 309,3 МиБ, а среднее время операции выросло с 11,25 до 11,80 мс. После добавления γ копирование осталось тем же на каждом из 12 seed, а число смен роли сократилось с 9,92 до 5,92. Среднее время увеличилось ещё на 0,079 мс; парный 95%-й интервал разности составил [0,047; 0,119] мс.
Равенство объёмов относится к статическому Zipf. При смене горячих сегментов оба штрафа дали 1045,3 МиБ против 1002,7 МиБ у одного β, причём интервал разности копирования пересёк ноль.
Сколько задержки стоит экономия копирования
Во второй серии оба штрафа уменьшили копирование относительно варианта без штрафов во всех четырёх профилях. Масштаб экономии и изменение задержки оказались разными:
Профиль | Меньше копирования | ΔR, мс | 95% ДИ для ΔR, мс |
|---|---|---|---|
Равномерный | 91,5% | +0,012 | [-0,002; 0,025] |
Статический Zipf | 86,6% | +0,626 | [0,373; 0,934] |
Смена профиля | 64,1% | +0,354 | [0,268; 0,454] |
Разные узлы | 84,7% | +0,059 | [-0,046; 0,184] |
Положительная ΔR означает увеличение среднего времени узловой операции. Процент экономии рассчитан как отношение разности средних объёмов к среднему объёму без штрафов. Максимальная экономия в новой серии — 91,5% — получена при равномерном профиле; при смене профиля она составила 64,1%.
На рисунке сопоставлены две серии. В первой добавление обоих штрафов сократило копирование на 66,1–93,0%, увеличив среднее время на 0,029–0,405 мс. На новых seed изменилась величина эффекта, а интервалы ΔR для равномерного профиля и разных скоростей узлов стали пересекать ноль.
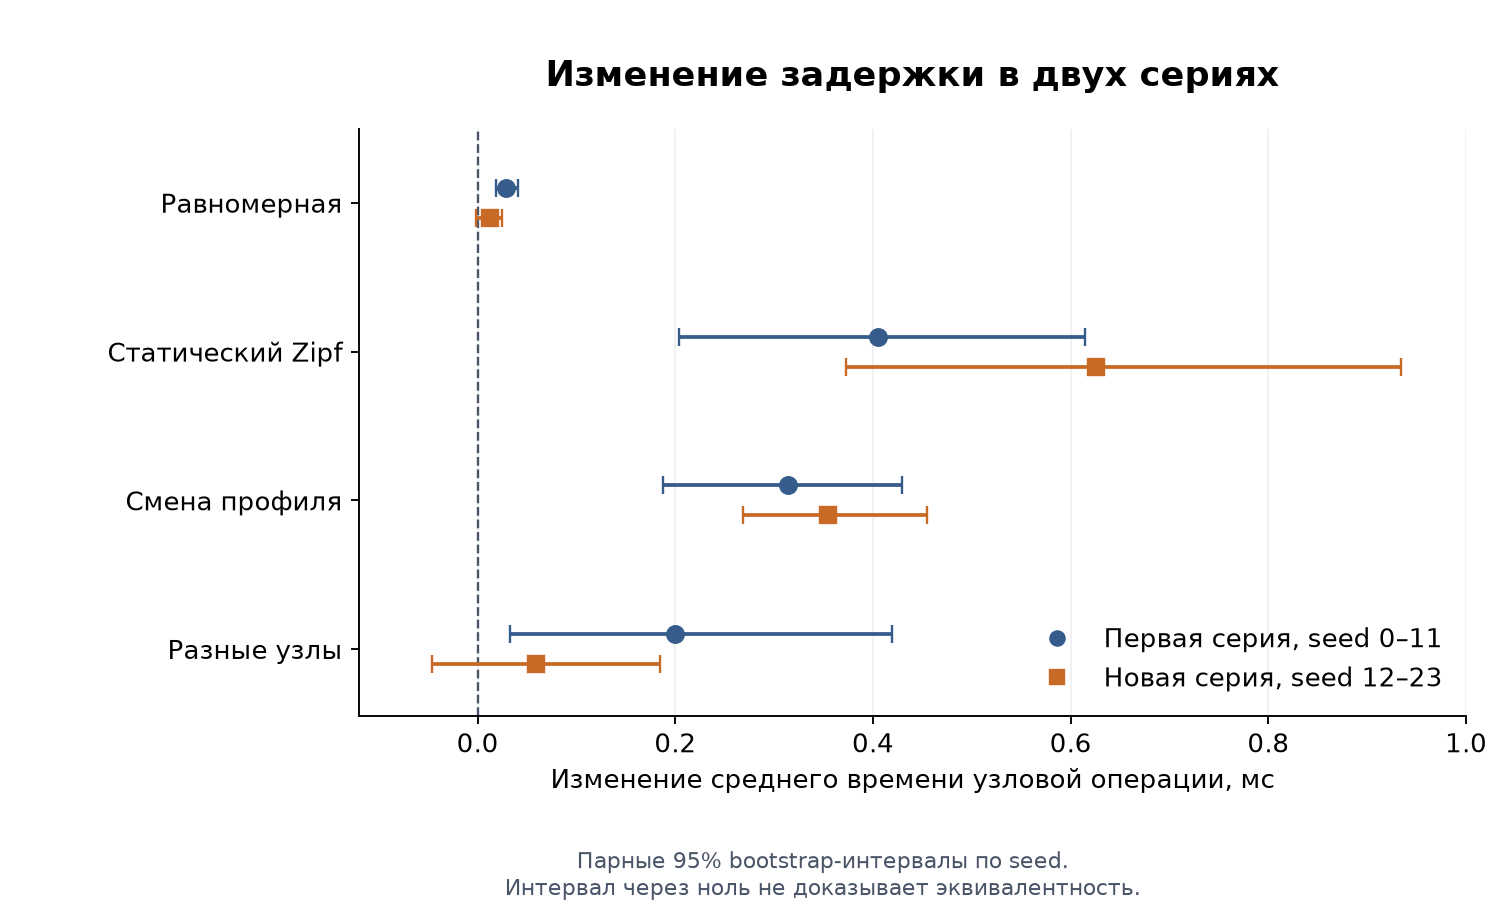
Интервалы, пересекающие ноль, допускают оба направления изменения задержки и не подтверждают эквивалентность вариантов. При статическом Zipf и смене профиля интервалы ΔR целиком положительны.
Что меняется, если учитывать стоимость запросов
В первой серии при статическом Zipf Count получил среднее время 81,36 мс, QPS 11,18 мс, Work 11,15 мс. При равномерном профиле результаты сблизились: 10,49, 10,46 и 10,41 мс соответственно. Исходное равномерное размещение подходит этому потоку лучше, чем неравномерному.
При разных скоростях узлов QPS получил 39,34 мс и девять перегруженных окон из 72; Work получил 10,56 мс без перегруженных окон. Оба варианта не штрафуют копирование. Их критерии нагрузки различаются: QPS использует число операций, Work рассчитывает занятость с учётом стоимости операций и скорости узла.
Все стратегии и профили первой серииПрофиль | Стратегия | Среднее R, мс | Копирование, МиБ |
|---|---|---|---|
Равномерный | Count | 10,49 | 0,0 |
Равномерный | QPS | 10,46 | 848,0 |
Равномерный | Work | 10,41 | 1141,3 |
Равномерный | Cost | 10,44 | 80,0 |
Статический Zipf | Count | 81,36 | 0,0 |
Статический Zipf | QPS | 11,18 | 2378,7 |
Статический Zipf | Work | 11,15 | 2410,7 |
Статический Zipf | Cost | 11,56 | 378,7 |
Смена профиля | Count | 85,99 | 0,0 |
Смена профиля | QPS | 11,96 | 2949,3 |
Смена профиля | Work | 11,82 | 2986,7 |
Смена профиля | Cost | 12,14 | 1013,3 |
Разные узлы | Count | 157,02 | 0,0 |
Разные узлы | QPS | 39,34 | 2378,7 |
Разные узлы | Work | 10,56 | 2357,3 |
Разные узлы | Cost | 10,76 | 192,0 |
Время указано в мс, объём копирования суммирован за шесть окон и усреднён по seed. Count во всех профилях копирует ноль: начальное размещение уже минимизирует его критерий количества. Горячие сегменты этот критерий не учитывает. Полные таблицы p95, p99, занятости и парных разностей опубликованы вместе с журналами первой серии.
Как это связано с существующими моделями
В Schism размещение связывается с профилем транзакций: графовое разбиение и частичная репликация уменьшают число распределённых транзакций. Shard Manager рассматривает управление шардами, ограничения размещения и доступность при изменениях. В статье о CockroachDB описана распределённая SQL-система с репликацией диапазонов и Raft. Это разные задачи, поэтому опубликованные результаты трёх систем не складываются в общий рейтинг.
На Хабре уже разбирались балансировка stateful-сервиса Fanout и ограничение частоты переносов. Штрафные функции, метрики разброса и жадный поиск применяются в существующих балансировщиках. Здесь я проверяю взаимодействие двух штрафов: отдельно меняю цену копирования и цену смены роли, сравнивая варианты на общих трассах. Вторая серия использует новые seed при тех же коэффициентах.
Шесть признаков для классификации моделей балансировкиПризнак | Что различаем |
|---|---|
Объект управления | Запрос, сегмент, реплика, управляющая роль |
Сигнал нагрузки | Число копий, QPS, стоимость операций, занятость |
Архитектура управления | Локальное решение, координируемый выбор, общий решатель размещения |
Целевая функция | Равномерность, задержка, локальность транзакций, стоимость изменений |
Ограничения | Число и разнесение реплик, ёмкость, география, допустимые назначения |
Изменения во времени | Объём переноса, частота смен роли, лимит действий, период управления |
По этой классификации Schism и перенос реплики различаются уже объектом управления: переразбиение меняет состав сегментов, перенос меняет место хранения готовой копии. Автоматическая балансировка диапазонов CockroachDB включает больше механизмов, чем критерий QPS в стенде. Эксперимент сравнивает заданные эвристики; Schism, Shard Manager и CockroachDB в нём не запускаются.
В методической части списка литературы приведены классификация атак и сравнение методов обнаружения вторжений в IoT у Антонова и Исаченко [4], анализ аудитории и рекомендации для Telegram у Соседки и Ибрагимова [5]. Оба источника относятся к другим предметным областям. Работа Tarkhanov и соавторов [6] рассматривает эффективность распределённых систем вместе с надёжностью.
Как повторить расчёт
Первая серия воспроизводится из закреплённой версии репозитория. Нужны Python 3.9 или новее и стандартная библиотека:
git clone https://github.com/NemoFlip/distributed-db-load-balancing-article.git
cd distributed-db-load-balancing-article
git checkout 8ccb2a47695f996c3c0de70c10f97aecf871ec6a
python3 -m unittest discover -s experiment -p 'test_*.py' -v
python3 experiment/run.py --out experiment/reproduced
python3 experiment/analyze.py experiment/reproduced
Для ключевой таблицы второй серии сохраните следующий скрипт как reproduce_zipf.py рядом с experiment/run.py, experiment/analyze.py и experiment/config.json. Из корня репозитория выполните python3 experiment/reproduce_zipf.py. Он выводит четыре строки и сохраняет zipf_ablation.csv в текущем каталоге. Для остальных профилей доступны параметры --scenario uniform, --scenario shift и --scenario heterogeneous; имя выходного CSV меняется вместе с профилем.
"""Reproduce the Zipf ablation table using the published simulation core."""

import argparse
import csv
import json
from pathlib import Path
import statistics

from analyze import bootstrap_mean
from run import (apply_action, make_case, rates_for_epoch, rebalance,
                 request_trace, simulate)

config = json.loads(Path(__file__).with_name('config.json').read_text())
parser = argparse.ArgumentParser(description=__doc__)
parser.add_argument('--scenario', default='zipf', choices=config['scenarios'])
scenario = parser.parse_args().scenario
variants = {'none': (0.0, 0.0), 'copy': (0.1, 0.0),
            'role': (0.0, 0.002), 'both': (0.1, 0.002)}
samples = {name: [] for name in variants}

for seed in range(12, 24):
    case = make_case(config, seed, scenario)
    states = {name: case.initial for name in variants}
    totals = {name: [0.0, 0, 0, 0] for name in variants}
    for epoch in range(config['epochs']):
        rates = rates_for_epoch(config, case, scenario, epoch)
        trace, _, _ = request_trace(config, case, rates, seed, scenario, epoch)
        for name, (beta, gamma) in variants.items():
            active = dict(config, migration_weight=beta,
                          leader_change_weight=gamma)
            current = states[name]
            after, moves = rebalance(current, case, rates, 'cost', active)
            roles = 0
            for move in moves:
                roles += int(move['kind'] == 'leader' or
                             current.leaders[move['segment']] == move['source'])
                current = apply_action(current, (move['kind'], move['segment'],
                                                move['source'], move['target'], move['mib']))
            result = simulate(trace, after, case, active)
            total = totals[name]
            total[0] += result['mean_ms'] * result['operations']
            total[1] += result['operations']
            total[2] += sum(move['mib'] for move in moves)
            total[3] += roles
            states[name] = after
    for name, (weighted, count, copied, roles) in totals.items():
        samples[name].append((weighted / count, copied, roles))

rows = []
for name, values in samples.items():
    row = {'variant': name, 'mean_ms': statistics.mean(v[0] for v in values),
           'migration_mib': statistics.mean(v[1] for v in values),
           'role_changes': statistics.mean(v[2] for v in values)}
    rows.append(row)
    print(name, *(f'{row[key]:.6f}' for key in
                  ['mean_ms', 'migration_mib', 'role_changes']))
with Path(f'{scenario}_ablation.csv').open('w', newline='') as stream:
    writer = csv.DictWriter(stream, fieldnames=list(rows[0]))
    writer.writeheader()
    writer.writerows(rows)
differences = [role[1] - none[1] for role, none in
               zip(samples['role'], samples['none'])]
print('role minus none, MiB, mean / 95% CI:',
      bootstrap_mean(differences,
                     seed=510041 + 1000 * sorted(config['scenarios']).index(scenario)))
Контрольные варианты воспроизвели опубликованные Work и Cost на seed 0. Тесты сопоставляют приращения нагрузки с полным пересчётом и расчёт FCFS с ручными примерами. По журналам действий проверены ограничения размещения и бюджета: в обеих сериях, суммарно в 2304 окнах, нарушений не обнаружено.
Когда перестановка реплик уже не поможет
У неделимого горячего сегмента есть простой предел: его собственная работа на управляющей реплике должна помещаться на узле. Если даже самый быстрый узел не справляется с потоком этого сегмента без фоновой нагрузки, смена размещения не решит проблему.
Например, 200 запросов в секунду при половине записей и временах обслуживания 4/12 мс требуют 1,6 секунды работы за секунду. У узла со скоростью 1,35 занятость составит 1,6 / 1,35 ≈ 1,19. Перемещениями снизить её до значения меньше единицы не получится. Изменение гранулярности сегмента или обработки потока выходит за набор действий стенда.
В общем виде необходимое условие получается из величины λₛ[(1 − wₛ)cᵣ + wₛcₗ], делённой на скорость самого быстрого узла: она должна быть меньше единицы. Выполнение этого условия ещё не гарантирует устойчивость кластера, поскольку остаются работа других сегментов и совместимость размещений.
Границы эксперимента
В этой модели интенсивности и стоимости операций известны точно. Нет сети, дискового ввода-вывода, ошибок измерения и накопленной очереди между окнами. Миграция завершена до измерения, поэтому меньший объём копирования нельзя напрямую переводить в деньги, длительность переноса или улучшение клиентской задержки.
Отказы узлов, потеря кворума и восстановление репликации требуют отдельного эксперимента. Ноль нарушений в текущих журналах относится к ограничениям размещения, ёмкости и бюджета. Он не подтверждает доступность реальной системы при отказе.
Проверены один набор коэффициентов, один размер кластера и четыре профиля одного генератора. Новые seed проверяют повторяемость в этих условиях. Чувствительность к интенсивности потока, коэффициентам штрафов, частоте сдвига и ошибкам оценок здесь не измерялась. Для проверки на промышленной СУБД потребуется отдельно учитывать время миграции и клиентский путь запроса.
Классификационные коды и ключевые словаГРНТИ: 20.23.17, 28.29.07, 28.17.19; ASJC: 1710, 1708, 2611; OECD: 1.2, 1.1
Ключевые слова: балансировка нагрузки; распределённые СУБД; NewSQL; шардирование; консенсус Raft; горячие сегменты.
Литература
Curino C., Jones E. P. C., Zhang Y., Madden S. Schism: A Workload-Driven Approach to Database Replication and Partitioning // PVLDB. 2010. Vol. 3, No. 1–2. P. 48–57. https://doi.org/10.14778/1920841.1920853.
Lee S., Guo Z., Sunercan O. et al. Shard Manager: A Generic Shard Management Framework for Geo-distributed Applications // SOSP 2021. P. 553–569. https://doi.org/10.1145/3477132.3483546.
Taft R., Sharif I., Matei A. et al. CockroachDB: The Resilient Geo-Distributed SQL Database // SIGMOD 2020. P. 1493–1509. https://doi.org/10.1145/3318464.3386134.
Антонов И. А., Исаченко М. К. Методы машинного обучения для обнаружения вторжений в сетях интернета вещей // Искусственный интеллект в промышленных, коммерческих, медицинских и финансовых приложениях: сборник статей научно-технического семинара студентов. Вып. 1. М.: НИТУ МИСИС, 2023. С. 9–15. https://sadekov.su/Articles/kik_2023.pdf#page=11.
Соседка А. В., Ибрагимов П. И. Количественный и качественный анализ аудитории Telegram в разрезе рекомендаций с использованием больших языковых моделей // Искусственный интеллект в промышленных, коммерческих, медицинских и финансовых приложениях. М.: НИТУ МИСИС, 2024. С. 116–120. https://sadekov.su/Articles/kik_2024_1.pdf#page=117.
Tarkhanov I. A., Akimova G. P., Pashkin M. A., Solovyev A. V. Modelling the Methodology to Assess the Effectiveness of Distributed Information Systems // ASTESJ. 2020. Vol. 5, No. 1. P. 86–92. https://astesj.com/v05/i01/p11.


Комментарии 0