Известный факт, что для достижения максимальной производительности кода для Nvidia и AMD приходится использовать ассемблер. Но, когда изучаешь и пишешь такой код, бросается в глаза насколько по разному реализован ассемблер у этих компаний. На уровне CUDA и HIP платформы выглядят близнецами: поменял префикс cuda на hip и пересобрал. Но ниже, где идёт борьба за каждый такт и каждый регистр, открываются две разные инженерные культуры.
Nvidia-AMD разговорник
Сначала договоримся о терминах. Компании называют одни и те же вещи по-разному, и без словаря сложно читать чужую документацию:
NVIDIA (CUDA) | AMD (HIP / ROCm) | Что это |
|---|---|---|
SM (Streaming Multiprocessor) | CU (Compute Unit); на RDNA два CU образуют WGP | аппаратный узел, на котором исполняются варпы или волны |
CUDA core | stream processor | один вычислительный элемент |
warp, 32 потока | wavefront (волна), 64 или 32 потока | группа потоков, исполняющих одну инструкцию одновременно |
thread | work-item | отдельный поток. Его позицию в варпе или волне называют лейном ( |
thread block (в PTX — CTA, Cooperative Thread Array) | workgroup | блок или группа потоков с общей разделяемой памятью. У NVIDIA блок состоит из одного или нескольких варпов, у AMD рабочая группа — из одной или нескольких волн |
grid | grid (в OpenCL — NDRange) | все блоки одного запуска ядра |
shared memory | LDS (Local Data Share) | память на кристалле, доступная потокам одной группы |
local memory | scratch, private memory | память потока, куда вытесняются регистры, находится в L2/VRAM |
регистры | VGPR | векторные регистры, свои у каждого потока |
uniform-регистры | SGPR | скалярные регистры, общие на варп / волну |
предикаты |
| флаги условий и переноса |
|
| барьер внутри блока |
Tensor Core | Matrix Core (инструкции MFMA, WMMA) | матричные блоки |
PTX → SASS | нет промежуточного уровня → AMDGCN ISA | виртуальный и машинный ассемблер |
|
| компиляторы |
| code object ( | бинарник с кодом для GPU |
|
| обозначение архитектуры |
RT Core | Ray Accelerator | блок трассировки лучей |
В HIP у AMD знакомые по CUDA имена — warpSize и __shfl, потому что его создавали, чтобы упростить перенос кода с CUDA и дать разработчику возможность собирать ядра из одного исходника для GPU обеих компаний.
По моему опыту, ИИ-ассистенты прекрасно понимают по контексту, что имеется в виду, под какую бы архитектуру я ни писал. Можно сказать «варп», разбирая ассемблер AMD, или «LDS», обсуждая ядро CUDA. А если для кода важно, сколько потоков в волне, я указываю размер явно — 32 или 64.
В тексте ниже для NVIDIA я пишу «варп», для AMD — «волна».
Две противоположные истории
Сегодняшние различия проще понять, если начать с середины 2000-х. Тогда обе компании искали способ продать видеокарту ещё и учёным, и выбрали противоположные ставки.
NVIDIA: совместимость программ важнее совместимости инструкций. CUDA 1.0 вышла в июне 2007 года и сразу принесла с собой PTX — виртуальную систему команд, в которой число объявленных регистров не привязано к размеру регистрового файла видеокарты. Программа, скомпилированная в PTX, может быть перекомпилирована драйвером под видеокарту, которой на момент выпуска программы ещё не существовало. PTX, собранный под Turing (2018), драйвер JIT-компилирует под Blackwell (2025). Цена этой гибкости — настоящий машинный код SASS NVIDIA не документирует и меняет его кодировку почти в каждом поколении: Fermi (2010), Kepler (2012), Maxwell (2014), Volta (2017), Turing (2018), Ampere (2020), Ada Lovelace (2022), Blackwell (2024–2025).
AMD: открытая нативная ISA. 14 ноября 2006 года, за полгода до CUDA, AMD анонсировала Close to Metal (CTM) — интерфейс прямого доступа к нативным инструкциям и памяти карт Radeon X1900 (R580). В мае 2007-го вышла документация на ISA R600 с форматами машинных слов, а в сентябре того же года AMD объявила о поддержке открытых драйверов Linux и начала публиковать аппаратные спецификации. С тех пор у AMD есть традиция: справочник по системе команд на несколько сотен страниц для каждого поколения.
У AMD три родственных семейства ISA — GCN (2011), игровая RDNA (2019) и серверная CDNA (2020). Ассемблерный исходник часто удаётся перенести с небольшими правками. Например, в цепочке сложений с переносом при переходе с Vega на RDNA в режиме волны 32 меняются мнемоники и имя регистра переноса, а порядок сложений остаётся прежним. Бинарник собирается под конкретную архитектуру (gfx803, gfx90a, gfx1100…), поэтому для карты другого поколения может понадобиться пересборка.
В 2012–2015 годах AMD вместе с ARM, Qualcomm, Samsung и другими участниками HSA Foundation разрабатывала виртуальную систему команд HSAIL (Heterogeneous System Architecture Intermediate Language). Устроена она была как PTX: аппаратно-независимый промежуточный код, который программа-финализатор превращала в машинные инструкции конкретного устройства. В 2015 году AMD использовала HSAIL в своём компиляторе OpenCL 2.0.
Со временем AMD перешла на генерацию машинного кода через LLVM, и HSAIL вышел из употребления. От HSA осталась вполне живая библиотека, которой я пользуюсь под Linux, — libhsa-runtime64.so из среды исполнения ROCr. Через неё программа находит видеокарту, выделяет память и создаёт очередь команд. Готовое ядро, собранное Clang в файл .co, загружается вызовом hsa_executable_load_agent_code_object. Для запуска остаётся положить в очередь пакет с аргументами ядра и размерами сетки и уведомить GPU. Разговаривать с драйвером напрямую программисту уже не приходится. Документация AMD по ROCr и HSA API
У HSA-библиотеки список карт, с которыми она умеет работать на практике, шире официального списка для всего стека ROCm с HIP. Это особенно выручает со старыми Radeon под Linux. Если карта уже выпала из списка ROCm, а в бэкенде LLVM её архитектура ещё есть, ядро можно собрать современным Clang. Для запуска я беру самую свежую версию HSA-библиотеки, которая ещё работает с этой картой и понимает формат собранного ядра.
Кто следит за задержками и прибытием данных из RAM?
Когда я тестировал программы для поиска ключей на кривой secp256k1 и разбирал турбо-ядра от RetiredCoder после взятия 135-й головоломки, я увидел, что они написаны на чистом SASS (машинный код NVIDIA специфичный для каждой архитектуры). Этот код отличается от обычного ассемблера, как поле от тёмного леса: перед каждой ассемблерной командой нужно выставлять разные флаги и указывать конкретные задержки. У AMD ассемблер выглядит намного проще.
Конечно, к программированию на SASS прибегают редко, только тогда, когда нужно использовать аппаратные возможности GPU до последней капли. А в обычных случаях хватает ускорения от переписывания тяжёлых участков на ptx-ассемблере.
У каждой инструкции есть задержка: нельзя читать регистр, пока предыдущая команда не дописала туда результат. Кто-то обязан следить за этим — компилятор или аппаратура. Можно сказать, что NVIDIA экономит транзисторы, чтобы как можно больше вычислительной мощности разместить на кристалле, а AMD тратит их на автоматическое отслеживание зависимостей и задержек, чтобы упростить жизнь программистам.
Парадокс первый: AMD ушла от компиляторной архитектуры, NVIDIA к ней пришла — в одни и те же годы. До конца 2011 года карты Radeon HD 2000–6000 были VLIW-машинами (TeraScale): компилятор должен был найти пять, а позже четыре независимые операции и упаковать их в одно длинное командное слово. Если независимых операций нашлось только две, остальные слоты простаивали. В вычислительных задачах с ветвлениями и зависимостями компилятор с этим справлялся плохо, и в декабре 2011 года с Radeon HD 7970 (Tahiti) AMD перешла на GCN: простые SIMD-инструкции и много независимо планируемых волн, между которыми переключаются SIMD-процессоры, пока некоторые волны ждут данных.
А NVIDIA ровно в 2012 году с Kepler сделала обратный шаг: убрала из кристалла часть логики динамического планирования и переложила расчёт задержек фиксированных инструкций на компилятор. Независимые исследователи связывают это с экономией площади и энергии. При этом механизмы разные: AMD уходила от упаковки параллелизма в одно слово, NVIDIA — от аппаратного отслеживания зависимостей между соседними командами одного варпа.
Как управляющие коды NVIDIA прирастали к инструкциямFermi (2010) планированием в основном занимается аппаратура
Kepler (2012) одно 64-битное управляющее слово на 7 инструкций
Maxwell (2014) одно управляющее слово на 3 инструкции, больше полей
Pascal (2016) то же, что Maxwell
Volta (2017) 128-битные инструкции, управляющие биты внутри каждой
Turing … Blackwell — тот же 128-битный формат
PTX появился в 2007 году, на пять лет раньше Kepler, и позволил переносить код между поколениями GPU. Две идеи просто хорошо сочетаются: если программист всё равно пишет на виртуальном ассемблере, ему не надо видеть, сколько тактов компилятор вписал перед каждой командой.
NVIDIA сегодня. В SASS перед каждой инструкцией зашито управляющее поле: сколько тактов ждать до выдачи следующей команды, какой счётчик-барьер взвести и каких дождаться. Для команд с фиксированной задержкой (сложение, умножение, логика) компилятор просто вписывает паузу в тактах. Для команд с непредсказуемой задержкой (чтение памяти может занять и 30, и 600 тактов в зависимости от попадания в кэш) он не угадывает число, а ставит аппаратный барьер, и железо ждёт фактической готовности данных. Планировщик варпов при этом остаётся аппаратным и, пока один варп ждёт, выдаёт команды другому.
AMD сегодня. Корректность зависимостей между обычными векторными инструкциями обеспечивает аппаратура: паузы в тактах программист не пишет.
У AMD есть программно управляемые ожидания в виде отдельных командs_waitcnt— ждать, пока число незавершённых обращений к памяти (vmcnt) или к LDS, скалярной памяти и константам (lgkmcnt) не опустится до заданного;s_nop— на GCN документирован список аппаратных конфликтов, для которых программа обязана сама вставить такты ожидания, например когда векторная инструкция пишет скалярный регистр, а следующая читает его как адрес;s_barrier— синхронизация волн внутри рабочей группы;s_delay_alu— с RDNA3 (2022) компилятор подсказывает аппаратуре, что следующая инструкция зависит от векторной команды N шагов назад. Без неё код останется правильным, но конвейер будет простаивать.
В итоге компилятор для GPU от NVIDIA кодирует подробные управляющие поля в каждой инструкции SASS, а в GPU от AMD это делает кремний.
AMD: мнемоники команд стабильны, но это не означает, что код не нужно переписывать
Стабильность мнемоник AMD не означает одинаковое число тактов на разных архитектурах для одной команды. Одна и та же инструкция v_mad_u64_u32 (умножение 32×32 с прибавлением 64-битного слагаемого) на старых GCN исполняется с четвертью скорости обычных команд, а в свежих она полноскоростная.
Код, вылизанный под Fiji, на RDNA3 соберётся почти без правок, но оптимальным быть перестанет: на одном поколении узкое место — умножитель, на другом узким местом может стать что-то другое.
Конвейер компиляции: Clang, LLVM и ROCm
Событие | NVIDIA | AMD |
|---|---|---|
Бэкенд в LLVM | Декабрь 2012, LLVM 3.2 ( | Июнь 2013, LLVM 3.3 ( |
Язык ядер в апстримном Clang | Сентябрь 2016, Clang 3.9: CUDA (проект Google gpucc) | 2018, Clang 7: начальная поддержка HIP; с ROCm 3.5 (2020) HIP-Clang заменил HCC в поставке AMD |
Что выдаёт LLVM | Текстовый PTX | Готовый машинный код (ELF |
Кто собирает машинный код | Закрытый | LLVM и |
Открытый бэкенд NVPTX NVIDIA передала в LLVM в декабре 2012 года. В 2015–2016 годах инженеры Google под руководством Цзинъюэ У (Jingyue Wu) сделали открытый компилятор CUDA на базе Clang — gpucc (статья на CGO 2016), и с Clang 3.9 обычный clang++ компилирует .cu-файлы.
Парадокс второй: закрытый компилятор nvcc тоже построен на LLVM. В обычной сборке CUDA-программы nvcc управляет всей цепочкой компиляции. Код для CPU он передаёт системному C+±компилятору. Код для GPU проходит другой путь: сначала фронтенд CUDA C++ переводит его в NVVM IR — разновидность LLVM IR с правилами и встроенными функциями для GPU NVIDIA. Затем компилятор NVVM, построенный на LLVM, оптимизирует этот код и генерирует PTX — инструкции виртуальной машины NVIDIA. Архитектура конкретной видеокарты вступает в дело на последнем этапе: ptxas превращает PTX в машинные инструкции SASS для выбранной архитектуры, распределяет физические регистры и записывает результат в файл .cubin.
LLVM появился в этой цепочке ещё в CUDA 4.1: в 2011 году команда NVIDIA сообщила, что использует его для оптимизации и генерации PTX.
Открытая часть конвейера заканчивается на генерации PTX: чтобы получить cubin с нативным SASS, Clang вызывает тот же закрытый ptxas, как и nvcc. Обе дороги сходятся в ptxas.
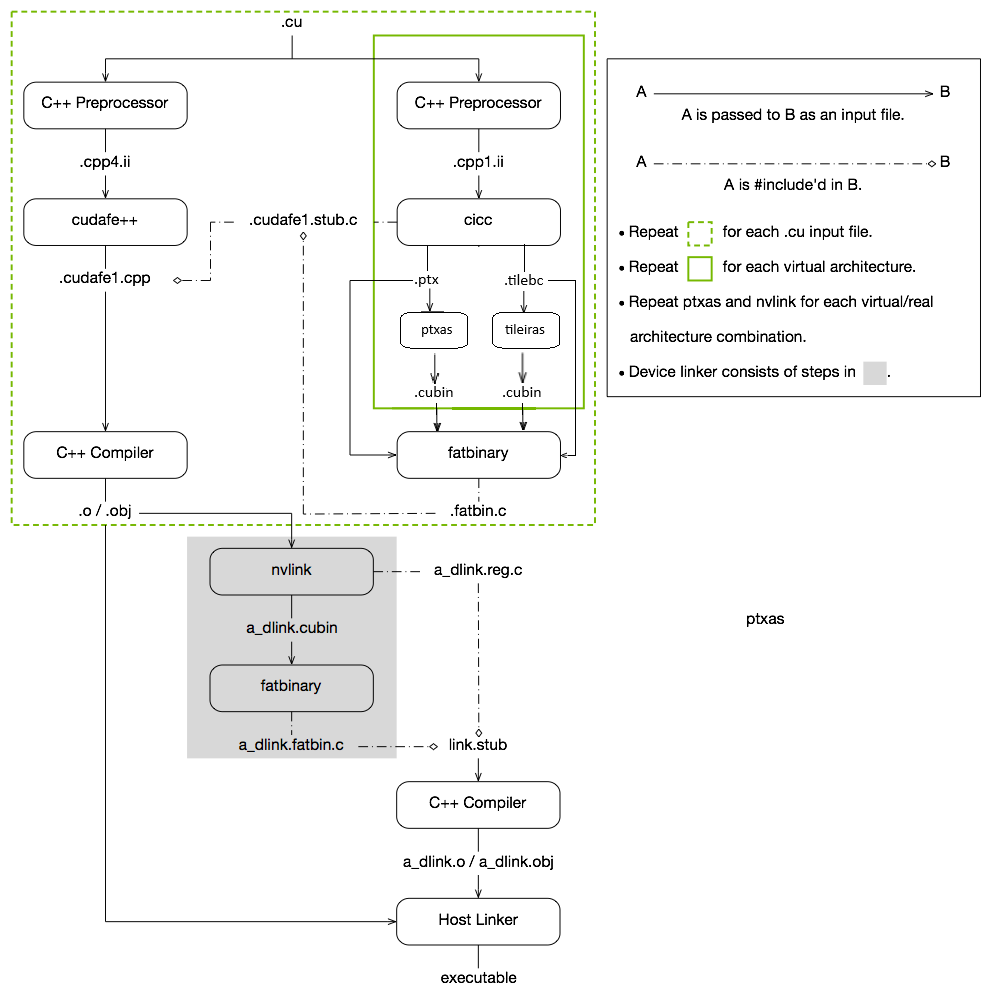
Различие в том, что у AMD открыт последний шаг, генерация машинного кода, у NVIDIA — нет.
Открытый бэкенд для видеокарт AMD (сначала под именем R600) написал инженер AMD Том Стеллард (Tom Stellard). На нём стоит ROCm, в который входят HIP-рантайм, низкоуровневый рантайм ROCr/HSA, библиотеки rocBLAS, rocFFT, MIOpen, профилировщики и отладчик. Clang с бэкендом AMDGPU — компилятор этой экосистемы.
В своих экспериментах со старыми Radeon в итоге я стал собирать ядра напрямую через Clang. Список карт, на которых AMD поддерживает HIP (С+±диалект, совместимый с CUDA) в составе ROCm, сильно редеет от выпуска к выпуску, старые модели из него убирают. А Clang с бэкендом AMDGPU до сих пор умеет собирать код для старых карт, например, для Radeon R9 Fury достаточно указать -target amdgcn-amd-amdhsa -mcpu=gfx803. Для запуска, конечно, нужен драйвер и рантайм, которые ещё работают с этой картой.
Фреймворк HIP с компилятором hipcc позволяет держать один исходник для AMD и NVIDIA. Но я для более полного использования возможностей железа предпочитаю писать два варианта ядра. Под AMD собираю код напрямую через clang и использую вставки на родном ассемблере. Под NVIDIA пишу на CUDA C++ со вставками PTX и собираю через nvcc (в редких случаях полностью на SASS).
Открытая ISA позволила появиться даже конкурирующему компилятору для GPU от AMD. В Mesa есть ACO — компилятор шейдеров, который переводит промежуточное представление NIR прямо в машинные инструкции GCN/RDNA собственным бэкендом, без LLVM. Его делали при поддержке Valve ради быстрой компиляции шейдеров и меньших подтормаживаний в играх; в Mesa он появился в 2019 году, а в 2020-м стал компилятором по умолчанию для драйвера RADV.
Это хороший пример того, что даёт опубликованная система команд.
Для NVIDIA разработчики Mesa тоже написали собственный компилятор шейдеров — NAK. Но его сделать было существенно сложнее, так как полную спецификацию машинных инструкций NVIDIA не публикует.
Вызов GPU-ассемблера из C++
Целиком на ассемблере ядра пишут редко. По моему опыту, Clang для AMD генерирует очень хороший машинный код. Поэтому я обычно оставляю ядро компилятору и толко самые горячие участки переписываю на ассемблере.
Рассмотрим небольшой пример ассемблера для NVIDIA и AMD. Это 64-битное сложение двумя 32-битными половинами с переносом на обеих платформах. В PTX есть готовая команда add.u64 (правда до Blackwell она всё равно транслировалась в 32-битные команды). Здесь я намеренно использую 32-битные команды, чтобы показать, как передаётся перенос.
CUDA C++, внутри asm(...) — PTX:
// NVIDIA CUDA: встроенный PTX
__device__ __forceinline__ void add64_ptx(uint32_t &lo, uint32_t &hi,
                                          uint32_t a, uint32_t b) {
    asm("add.cc.u32  %0, %0, %2;\n\t"
        "addc.u32    %1, %1, %3;"
        : "+r"(lo), "+r"(hi)
        : "r"(a), "r"(b));
}
Ограничение "r" означает виртуальный 32-битный регистр PTX. Физические номера регистров и паузы назначит ptxas после того, как развернёт все встроенные функции. Флаг переноса между двумя отдельными asm(...) не сохраняется: всю цепочку add.cc/addc нужно держать в одной ассемблерной вставке.
HIP или Clang с целью amdgcn-amd-amdhsa, внутри asm(...) — нативный ассемблер AMD:
// AMD HIP / Clang: нативный ассемблер GCN/CDNA (волна 64)
__device__ __inline__ void add64_amd(uint32_t &lo, uint32_t &hi,
                                     uint32_t a, uint32_t b) {
    asm volatile(
        "v_add_co_u32    %0, vcc, %0, %2\n\t"
        "v_addc_co_u32   %1, vcc, %1, %3, vcc"
        : "+v"(lo), "+v"(hi)
        : "v"(a), "v"(b)
        : "vcc");
}
Буквы ограничений здесь соответствуют физическим банкам регистров: "v" — векторный регистр VGPR, свой у каждого потока, "s" — скалярный SGPR, общий на волну. В списке разрушаемых регистров явно указан аппаратный регистр переноса vcc. На RDNA в режиме волны 32 вместо vcc пишется vcc_lo, а v_addc_co_u32 превращается в v_add_co_ci_u32 — поэтому такие вставки обычно генерируют препроцессором из одного исходника под каждую архитектуру.
Буквы ограничений здесь соответствуют физическим банкам регистров: "v" — векторный регистр VGPR, свой у каждого потока, "s" — скалярный SGPR, общий на волну. Регистр векторных условий vcc у AMD 64-битный ещё со времён GCN, где волна состояла из 64 потоков. В RDNA при wave32 достаточно его младшей половины vcc_lo: по одному биту переноса на поток. В списке разрушаемых регистров указываем vcc_lo.
А если надо посчитать две независимые 64-битные суммы? На AMD можно явно дать каждой цепочке свою маску переноса. Вот четыре команды для RDNA в режиме wave32. Каждый поток складывает две пары чисел: v[0:1] += v[2:3] и v[4:5] += v[6:7]. В каждой паре младшее слово лежит в регистре с меньшим номером.
v_add_co_u32        v0, vcc_lo, v0, v2          // A: младшие слова, перенос в vcc_lo
v_add_co_u32        v4, s8,        v4, v6          // B: младшие слова, перенос в s8
v_add_co_ci_u32    v1, vcc_lo, v1, v3, vcc_lo  // A: старшие слова + перенос A
v_add_co_ci_u32    v5, s8,       v5, v7, s8      // B: старшие слова + перенос B
В режиме wave32 для каждой цепочки сложения можно явно выбрать свой свободный скалярный регистр под маску переносов. Здесь первая сумма оставляет переносы в vcc_lo, а вторая — в s8. Третья команда ждёт результат первой, четвёртая — второй. Порядок команд и место для каждого переноса видны прямо в коде.
В asm(...) ни nvcc, ни Clang не пустят нативный SASS. Чтобы исполнить собственный SASS, его собирают сторонним ассемблером в модуль .cubin и загружают через Driver API:
// Загрузка и запуск собранного SASS-модуля (.cubin) через CUDA Driver API
CUmodule module;
CUfunction kernel;
cuModuleLoadData(&module, cubin_image);
cuModuleGetFunction(&kernel, module, "KernelA");

void *args[] = { &d_points, &d_table, &iterations };
cuLaunchKernel(kernel, gridBlocks, 1, 1, 256, 1, 1,
               sharedMemBytes, stream, args, nullptr);
Что скрывает PTX по сравнению с SASS
В PTX предикат — это логическая переменная типа .pred. В примере ниже сравнение записывает в %p истину или ложь, а от этого значения зависит, выполнится ли сложение. Имя %p существует на уровне PTX. При сборке ptxas может выделить под него предикатный регистр SASS, а если условие известно заранее — вообще убрать проверку.
.reg .pred %p;
setp.lt.s32 %p, %r1, %r2;
@%p add.s32 %r3, %r3, 1;
В PTX можно объявить хоть шестнадцать предикатов одной строкой .reg .pred %p<16>;. От Fermi (2010) до Blackwell (2025) у потока всё те же семь предикатов, в которые можно записать результат, — от P0 до P6. В трёхбитном поле инструкции код 7 означает PT — константу 1. Предикаты UP считаются отдельно, у них одно значение на весь варп. Какие из шестнадцати виртуальных предикатов соответствуют физическим предикатам в конкретный момент времени решает ptxas. Коды SASS Blackwell sm_120.
У переноса в PTX серьёзные ограничения. В PTX инструкция add.cc.u32 оставляет перенос в единственном неявном флаге CC.CF, а addc.u32 его читает. Сколько бы имён .pred я ни объявил, у add.cc нет операнда, куда можно вписать одно из них. Если нужны два независимых переноса, первый можно сохранить как число командой addc.u32 %r, 0, 0;. В SASS на Ampere я могу сразу указать у IADD3.X, в какой предикат записать перенос и из какого взять входной. В примере RCAsm ниже для этого служат Pt0 и Pt1.
При сборке ptxas может назначить независимым цепочкам разные предикаты и чередовать их инструкции, заполняя паузы. А может и не назначить и производительность упадёт. Внутри одной цепочки следующее сложение по-прежнему ждёт перенос предыдущего. Если цепочка написана вручную на PTX, её стоит держать в одной вставке asm, поскольку сохранность CC.CF между вставками не гарантирована.
Поэтому, чтобы ускорить код за счёт независимых переносов в Nvidia может потребоваться мозговыносящий SASS, в ассемблере AMD такой проблемы нет.
Нельзя положить значение в скалярный регистр UR — их в PTX нет вовсе. Точную паузу в тактах, номера барьеров зависимостей и флаг .reuse у исходного регистра выбирает ptxas. Напрямую задать эти поля в PTX нельзя.
На ядрах с высоким давлением на регистры, когда поток держит по 200–255 32-битных слов, ptxas начинает массово перекладывать операнды на границах ассемблерных блоков, и пересылки MOV занимают заметную долю ядра, что снижает производительность.
Официального ассемблера SASS NVIDIA не выпускает, поэтому их пишут реверс-инженеры:
MaxAs (2014). Скотт Грей (Scott Gray), тогда инженер стартапа Nervana Systems, написал MaxAs для Maxwell и вручную расписал матричное умножение с учётом банков регистрового файла. Его SGEMM на Maxwell, по данным автора, достигал 98% теоретической производительности GPU и обгонял тогдашний cuBLAS до 4,8%. Позднее Грей разработал в OpenAI ядра для архитектуры GPU NVIDIA Pascal, выполняющие GEMM (матричное умножение с накоплением) с небольшими тайлами — прямоугольными кусочками результирующей матрицы. Эти ядра вошли в cuBLAS начиная с версии 8.0.61.2.
turingas и CuAssembler (2019–2020). После перехода на 128-битные инструкции в Volta и Turing появились turingas и более универсальный CuAssembler, поддержавший поколения от Pascal до Ampere. CuAssembler учится кодировке по дизассемблеру
cuobjdump: ему показывают эталонные инструкции, и он восстанавливает битовые поля.
Из более свежих инструментов мне попались три:
RCAsm. 28 июля 2026 года RetiredCoder, забрав 135-ю головоломку, выложил в RCKangaroo v4.0 турбо-ядра для Ada (
sm_89) и Blackwell (sm_120) и макроассемблер RCAsm поверх CuAssembler. По данным автора, на RTX 5090 турбо-ядра дают 19,5 млрд ключей/с против ~10 млрд у публичной сборки, на 4090 — 14,5 против ~8,2. Существенная часть выигрыша пришлась на переход PTX → SASS.cubit. Открытый ассемблер для Blackwell
sm_120, который не только кодирует и декодирует инструкции и собираетcubin, но и сам рассчитывает управляющие поля: паузы и барьеры. Авторы сообщают, что на проверочном наборе из более чем 1,8 млн инструкций обратная сборка восстанавливает 128-битные слова точно. Рабочий ассемблер был доступен в августе 2026 года. История cubitCuAsmRL. Гоулян Хэ (Guoliang He) и Эйко Ёнэки (Eiko Yoneki) из Кембриджа выложили исходники своего оптимизатора в ноябре 2024 года, а в марте 2025-го показали результаты на CGO. На входе у программы готовый SASS после
ptxas -O3. Агент с обучением с подкреплением выбирает, какие инструкции поменять местами, CuAssembler собирает очередной вариант, затем программа проверяет его на GPU. Чем выше пропускная способность ядра, тем выше награда. На шести ядрах для языковых моделей авторы получили (первая публикация от 2024 года) на A100 в среднем 9% выигрыша, в лучшем случае — 26%. Исходники и скрипты.
Чтобы ручной SASS дал выигрыш, придётся обогнать машинный код, который из того же алгоритма на PTX собирает ptxas. ptxas — это чёрный ящик, в который NVIDIA вбухала миллиарды долларов. Он очень хорошо умеет распределять регистры и заполнять паузы независимыми командами. Вручную можно выиграть несколько тактов в одной цепочке и тут же потерять их на конфликте банков регистров. А на топовых картах, упирающихся в лимит мощности, решает уже энергия на операцию, и тут ручное написание SASS уместно.
Как читается SASS: разбираем [B------:R-:W-:-:S04]
Фрагмент из RCAsm (mod_sub.asm, код RetiredCoder) — вычитание 256-битных чисел по модулю простого числа кривой secp256k1, 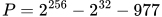 . Каждое число лежит в восьми 32-битных регистрах:
FUNCTION SubMod256()
{ // Ri_cnt=8+8, Ro_cnt=8, Pt=[0..1]
    [B------:R-:W-:-:S04]       IADD3.X Ro0, Pt0, PT, RFirst0, ~RSecond0, RZ, !PT, PT
    [B------:R-:W-:-:S04]       IADD3.X Ro1, Pt0, PT, RFirst1, ~RSecond1, RZ, Pt0, !PT
    [B------:R-:W-:-:S04]       IADD3.X Ro2, Pt0, PT, RFirst2, ~RSecond2, RZ, Pt0, !PT
    ...
    [B------:R-:W-:-:S04]       IADD3.X Ro6, Pt0, PT, RFirst6, ~RSecond6, RZ, Pt0, !PT
    [B------:R-:W-:Y:S13]       IADD3.X Ro7, Pt0, PT, RFirst7, ~RSecond7, RZ, Pt0, !PT
// результат отрицательный (нет переноса в Pt0) — прибавляем P
    [B------:R-:W-:-:S04] @!Pt0 IADD3.X Ro0, Pt1, PT, Ro0, 0xFFFFFC2F, RZ, !PT, !PT
    [B------:R-:W-:-:S04] @!Pt0 IADD3.X Ro1, Pt1, PT, Ro1, 0xFFFFFFFE, RZ, Pt1, !PT
    ...
    [B------:R-:W-:-:S05] @!Pt0 IADD3.X Ro7, PT,  PT, Ro7, 0xFFFFFFFF, RZ, Pt1, !PT
}
Вычитание сделано сложением с инверсией: 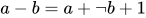 , отсюда тильда перед
RSecond и PT (истина) как входной перенос первого звена.
И четыре строки из основного ядра, где таблица прыжков копируется из видеопамяти в разделяемую. Здесь в ход идут барьеры:
    [B------:R4:W0:-:S02]    LDG.E.NA.EFL2.256.STRONG_GPU jPntX4, jPntX0, [xOfs.U32 + j12Base], 0xFF
    [B----4-:R-:W-:-:S02]    IADD3 xOfs, xOfs, 0x2000, RZ
    [B0-----:R5:W-:-:S02]    STS.128 [dOfs.X16 + {LDS_BASE}], jPntX0
    [B-----5:R-:W-:-:S02]    IADD3 dOfs, dOfs, 0x200, RZ
Управляющее поле [B012345:R#:W#:Y:S##] хранится в старших битах 128-битной инструкции:
B------— маска ожидания барьеров. Шесть позиций соответствуют шести аппаратным счётчикам на варп. Прочерк: этот счётчик не проверять. Цифра на позиции (B0-----,B----4-): перед выдачей инструкции дождаться, пока барьер освободится. Ждать можно сразу несколько, напримерB01----.R4— барьер чтения. Блок памяти забирает операнды из регистров не мгновенно, и регистр-источник нельзя перезаписывать, пока он их не забрал.LDGчитает адрес изxOfsи взводит барьерR4. СледующаяIADD3хочет прибавить кxOfsсмещение, поэтому ждёт его:B----4-. Так жеSTS.128взводитR5на свои аргументы, а инкрементdOfsждётB-----5.W0— барьер записи. Ставится на инструкции с непредсказуемой задержкой (LDG,LDS,S2R,SHFL,MUFU), когда неизвестно, через 30 или через 600 тактов придут данные.LDGгрузит 256 бит вjPntX0..jPntX7и взводитW0;STS.128, которой эти данные нужны, ждётB0-----.Y(Yield) — уступка. Y подсказывает планировщику предпочесть другой готовый варп при выдаче следующей инструкции. Прочерк означает предпочтение продолжить текущий варп. Решение принимает планировщик. На Blackwell (sm_120) у флага нашлось неприятное свойство: паузыS12иS13выдерживаются только сY. Без него тест показал порчу регистров-приёмников, как будто паузы нет вовсе.S04— пауза в тактах (0–15). После выдачи этой инструкции должно пройти хотя бы четыре такта до выдачи следующей инструкции того же варпа. Арифметика (IADD3,IMAD,LOP3,SEL,ISETP) имеет фиксированную задержку, зависимости регистров-потребителей закрывают паузами. У IADD3 можно поставить и S00. Если результат нужен через четыре такта, эти такты можно занять другими независимыми командами. Главное, чтобы к моменту первого чтения результата нужное значение уже было готово.
Вот ещё интересный момент:
    [B------:R-:W-:Y:S13]       IADD3.X Ro7, Pt0, PT, RFirst7, ~RSecond7, RZ, Pt0, !PT
    [B------:R-:W-:-:S04] @!Pt0 IADD3.X Ro0, Pt1, PT, Ro0, 0xFFFFFC2F, RZ, !PT, !PT
Внутри цепочки следующий IADD3.X использует Pt0 как входной перенос, и здесь хватает S04. После последнего слова Pt0 управляет условным исполнением следующей команды. Перед таким чтением в ядре RetiredCoder выставлено Y:S13. Если поставить S05, карта не упадёт и не зависнет: она проверит @!Pt0 по старому значению и испортит результат. Ассемблер такую ошибку не заметит, а глазами её не видно. Ловят её тестами: пару «производитель → потребитель» прогоняют с паузами от 1 до 14 тактов на сотнях тысяч проверок, и добиваются, чтобы ошибок стало ноль.
Производитель → потребитель                         мин. S
IADD3 / IADD3.X / LOP3 / SHF / LEA → IADD3/LOP3/SHF   4
SEL, MOV → любая ALU; любая ALU → SEL, MOV            5
IADD3 / LOP3 → IMAD                                   5
IMAD → IMAD                                           4
IMAD.WIDE мл. слово → IADD3 / LOP3                    3
IMAD.WIDE ст. слово → IADD3                           5
перенос P: IADD3(.X) → IADD3.X                        4
ISETP → SEL                                           5
ISETP / LOP3 / IADD3.X → страж @P                    13 (только с Y)
Задержка зависит не только от инструкции-производителя, но и от того, кто читает результат: тот же предикат как данные для IADD3.X готов через 4–5 тактов, а как страж инструкции — через 13.
Та же задача на ассемблере AMD
Перепишем ту же функцию 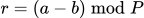 на нативном ассемблере AMD (вариант GCN/CDNA, волна 64):
// 1. a - b с цепочкой заёма через vcc
v_sub_co_u32     r0, vcc, a0, b0
v_subb_co_u32    r1, vcc, a1, b1, vcc
v_subb_co_u32    r2, vcc, a2, b2, vcc
v_subb_co_u32    r3, vcc, a3, b3, vcc
v_subb_co_u32    r4, vcc, a4, b4, vcc
v_subb_co_u32    r5, vcc, a5, b5, vcc
v_subb_co_u32    r6, vcc, a6, b6, vcc
v_subb_co_u32    r7, vcc, a7, b7, vcc
v_subb_co_u32    bor, vcc, 0, 0, vcc          // bor = 0xFFFFFFFF при заёме, иначе 0

// 2. кандидат t = r + P
v_add_co_u32     t0, vcc, 0xFFFFFC2F, r0      // младшее слово P — 32-битный литерал
v_addc_co_u32    t1, vcc, r1, -2, vcc         // 0xFFFFFFFE — встроенная константа -2
v_addc_co_u32    t2, vcc, r2, -1, vcc         // 0xFFFFFFFF — встроенная константа -1
v_addc_co_u32    t3, vcc, r3, -1, vcc
v_addc_co_u32    t4, vcc, r4, -1, vcc
v_addc_co_u32    t5, vcc, r5, -1, vcc
v_addc_co_u32    t6, vcc, r6, -1, vcc
v_addc_co_u32    t7, vcc, r7, -1, vcc

// 3. выбор без ветвления: был заём — берём t, иначе r
v_cmp_ne_u32     vcc, 0, bor
v_cndmask_b32    r0, r0, t0, vcc
v_cndmask_b32    r1, r1, t1, vcc
...
v_cndmask_b32    r7, r7, t7, vcc
Квадратных скобок с задержками нет: готовность r0..r7 и vcc отслеживает аппаратура. Целые числа от −16 до 64 закодированы в 9 бит прямо в поле операнда внутри команды и 0 дополнительных бит в потоке команд. Второе слово  — это
0xFFFFFFFE, то есть −2, а слова с третьего по восьмое — 0xFFFFFFFF, то есть −1. Полноценный литерал понадобился один раз, для 0xFFFFFC2F.
Ещё одно отличие от NVIDIA видно в команде v_cndmask_b32. vcc — 64-битная маска, по биту на поток волны, и v_cndmask_b32 для каждого потока выбирает своё значение. Рядом живёт маска активных потоков exec, которую нативный код может читать и менять напрямую: так компилятор AMD сам реализует расходящиеся ветвления. У NVIDIA текущую маску варпа можно узнать через activemask.b32 в PTX. Прямого аналога записи в exec у SASS нет.
Если ассемблерная вставка использует s8 как временный регистр, его нужно указать в списке разрушаемых регистров (clobber list). Иначе Clang вправе считать, что после вставки в s8 осталось прежнее значение. Если там лежала сохранённая маска exec, при её восстановлении могут включиться или выключиться не те потоки. Ошибки сборки при этом не будет, а результаты работы программы станут неверными.
Кто у кого подсмотрел
По датам видно, у кого из двух производителей каждая идея раньше появилась в железе.
Идея | Первым | Вторым |
|---|---|---|
Отдельный скалярный тракт и регистры | AMD GCN, 2011–2012 (SGPR, скалярное АЛУ) | NVIDIA Turing, 2018 (Uniform Datapath, |
Матричные инструкции | NVIDIA Volta (Tesla V100), 2017 — тензорные ядра | AMD CDNA (Instinct MI100), 2020 — инструкции MFMA |
Аппаратная трассировка лучей | NVIDIA Turing, 2018 — RT-ядра | AMD RDNA2, 2020 — Ray Accelerators |
Волна 32 потока | NVIDIA, всегда | AMD RDNA, 2019 (волна 64 сохранена) |
Огромный кэш на кристалле | AMD RDNA2, 2020 — 128 МБ Infinity Cache в RX 6900 XT | NVIDIA Ada, 2022 — 96 МБ L2 в AD102 против 6 МБ в GA102 |
Программные подсказки задержек | NVIDIA Kepler, 2012 | AMD RDNA3, 2022 — |
Скалярные регистры
Внутри варпа все потоки часто работают с одинаковыми величинами: базовым адресом массива, счётчиком цикла, константой. В векторных регистрах такое число дублируется 32 или 64 раза. У AMD с первого GCN рядом с векторными регистрами есть скалярные (SGPR, больше сотни на волну) и отдельное скалярное АЛУ, и нативный ассемблер даёт ими распоряжаться напрямую.
NVIDIA добавила аналогичный тракт в Turing в 2018 году: 64 регистра UR0..UR63 (UR63 — аппаратный ноль URZ), предикаты UP0..UP3 и отдельные инструкции UIADD3, UIMAD, ULDC, UMOV. Но в PTX их до сих пор нет: разработчик на CUDA надеется, что ptxas сам распознает одинаковые для всего варпа значения и поместит их в скалярные регистры. Явно положить число в UR можно только в SASS, и в турбо-ядрах RetiredCoder так хранятся все базовые адреса и счётчики циклов.
Размер волны/варпа
В первом GCN (2011) AMD выбрала волну из 64 потоков. Одну векторную инструкцию SIMD16 выполнял за четыре такта, по 16 потоков за такт. На всю волну хватало одной выборки и одного декодирования инструкции. Так на каждый поток приходится меньше управляющей логики и при том же бюджете транзисторов больше места можно отдать самим вычислителям. В RDNA (2019) основной стала волна из 32 потоков на 32-линейном SIMD. Волна 64 осталась вторым поддерживаемым режимом — исполняется двумя порциями по 32 — и это не эмуляция для старого кода: на некоторых вычислительных задачах она эффективнее. Серверные CDNA (gfx908–gfx942) сохранили волну из 64 потоков.
У короткой волны есть свой плюс. Допустим, первые 32 потока попали в одну ветку условия, а следующие 32 — в другую. Волна из 64 пройдёт обе ветки по очереди, каждый раз с половиной выключенных потоков. Две волны по 32 в этом примере пройдут каждая свою ветку с полной загрузкой. Для ассемблерщика переход меняет разрядность всех масок: в волне 64 exec, vcc и выход переноса v_mad_u64_u32 занимают пары скалярных регистров s[N:N+1], в волне 32 — одиночные exec_lo, vcc_lo, sN. А на CDNA2/CDNA3 (gfx90a, gfx942) 64-битные пары векторных регистров обязаны начинаться с чётного номера: v[10:11] можно, v[11:12] нельзя. При ручном распределении регистров я проверяю начало каждой такой пары. Если ассемблер пишет LLM, ей тоже нужно явно задать это ограничение для выбранной архитектуры.
Память для констант
У NVIDIA под __constant__ отведено 64 КБ. Если весь варп читает один адрес и значение уже в константном кэше, одной рассылки хватает на 32 потока. По оценке NVIDIA, такое чтение может быть таким же быстрым, как обращение к регистру. Если таблица больше 64 КБ, её можно разместить в обычной глобальной памяти. L1 у каждого SM невелик, и если нужной строки там нет, даже при попадании в L2 ждать придётся дольше, чем при рассылке из константного кэша. Руководство NVIDIA по оптимизации CUDA
Оригинальный GCN имел 16 КБ скалярного кэша, и AMD описывала его как замену выделенного константного кэша прежних архитектур. Одинаковые для волны данные читаются скалярными инструкциями s_load_dword… и обслуживаются этим кэшем, откуда бы они ни лежали в памяти. Принципиальная разница не в объёме таблиц, а в способе организации: у NVIDIA отдельное адресное пространство, у AMD — отдельный тракт чтения поверх обычной памяти.
Что помещается в WGP и в кластер Hopper
В RDNA (2019) AMD объединила два CU в один WGP. В режиме WGP волны одной рабочей группы можно распределить по всем четырём SIMD32 этой пары. Когда каждая волна требует много векторных регистров, такое размещение позволяет задействовать регистры обоих CU. Каждая волна получает регистры на своём SIMD, а для обмена между волнами у группы есть общая LDS. На RDNA 2 её объём составляет 128 КБ на WGP, отдельная группа может занять до 64 КБ. Описание ISA RDNA 2
В Hopper (2022), а затем и в потребительском Blackwell (2025) NVIDIA пошла в похожем направлении. В CUDA все варпы одного блока исполняются на одном SM. Кластер объединяет несколько таких блоков, которые могут работать на разных SM. Допустим, алгоритму нужны 16 варпов по 32 потока, а ядро использует 255 регистров на поток. В сумме выходит 130 560 регистров. На одном SM у H100 их всего 65 536, поэтому запустить такое ядро блоком из 512 потоков не получится. Объявим кластер из двух блоков и зададим при запуске по 256 потоков на блок. Получим те же 16 варпов, по восемь на каждом из двух SM. Блоку требуется 65 280 регистров до округления при выделении. Регистров каждого SM теперь хватает для своего блока, а все 512 потоков могут синхронизироваться на барьере кластера. Руководство NVIDIA по Hopper
С разделяемой памятью выигрыш виден на примере таблицы. Если каждому из двух блоков выделить по 64 КБ, можно распределить между ними таблицу на 128 КБ. Блок обращается к своей половине как обычно, а для доступа к соседней указывает блок-владелец и смещение. Кэш L1 у каждого SM остаётся своим. У RDNA 2 граница проходит в другом месте — один L1 обслуживает несколько WGP одного шейдерного массива. Распределённая разделяемая память Hopper · Иерархия памяти AMDGPU
Что в итоге
Критерий | NVIDIA (PTX + SASS) | AMD (GCN / RDNA / CDNA) |
|---|---|---|
Уровень, доступный официально | Виртуальный PTX, SASS закрыт | Нативная ISA с документацией |
Переносимость кода | PTX JIT-компилируется под будущие карты | Бинарник привязан к |
Зависимости фиксированных инструкций | Паузы и барьеры в каждой инструкции | Аппаратно; |
Открытость генерации машинного кода | Закрытый | LLVM AMDGPU (с 2013) и ACO в Mesa |
Скалярные регистры | С 2018 года, только из SASS | С 2011 года, из ISA и вставок в C++ |
Маска активных потоков | Скрыта |
|
Стабильность производительности между поколениями | Меняется | Меняется, хотя мнемоники почти те же |
По железу AMD и NVIDIA с годами становятся всё больше похожи друг на друга. У AMD скалярные регистры были ещё в GCN, а в Turing такой же инструмент появился у NVIDIA. С размером волны вышло наоборот. NVIDIA с самого начала собирала потоки в варпы по 32, а AMD пришла к этому размеру в RDNA. Сейчас в новых поколениях AMD наращивает векторный регистровый файл, а NVIDIA — разделяемую память. У Radeon RX 6900 XT на один WGP приходилось 512 КБ векторных регистров, у RX 7900 XTX — уже 768 КБ. У NVIDIA на один SM в A100 приходилось 164 КБ разделяемой памяти, а в H100 — 228 КБ.
Хотелось бы, чтобы удачные решения быстрее становились общими для обеих архитектур. Чем меньше у каждой своих особых правил, тем проще писать ассемблерные ядра под обе.
По части ассемблера мне ближе подход AMD, который позволяет использовать все позможности железа без возни с самодельными ассемблерами и реверсного инженеринга. С SASS на RTX 5090 приходится выяснять самому выяснять коды и задержки для многих команд, которые невключены в ассемблеры, написанные энтузиастами. Это уже шаманство. И даже когда всё отладил, NVIDIA не обещает, что собранный вручную cubin заработает со следующим драйвером.
Впрочем, не так страшен чёрт, как его малюют. Кто писал на ассемблере для CPU, тот половину GPU-ассемблера уже знает.
© 2026 ООО «МТ ФИНАНС»


Комментарии 0