Хабр, привет! Меня зовут Владимир Гурьянов, я технический директор направления наблюдаемости в компании «Флант». Мы делаем несколько разных продуктов, в том числе Prom++ и Deckhouse Observability, а ещё помогаем другим командам строить наблюдаемость в рамках их продуктов Deckhouse, включая и Deckhouse Platform. Платформу мы развиваем достаточно давно — более восьми лет. Сейчас под её управлением находится более 1300 кластеров.
Знаете, какой вопрос нам чаще всего задают? Вот этот — «Какой SLA у вашей платформы?».
На первый взгляд, ответ простой — «три девятки», классика жанра для любого уважающего себя SLA. Но если копнуть чуть глубже, начинается самое интересное: что именно должен включать SLA Kubernetes-кластера или Kubernetes-платформы? И как сделать так, чтобы этот показатель действительно отвечал на вопрос — работает ли наш кластер или нет?
На эту тему я выступал на Kuber Conf от АОТ (вот видео), для вас же — текстовая версия доклада.
Итак…
SLA в публичных облаках — и почему его недостаточно
Самый первый вопрос, которым стоит задаться: какой SLA у вашего кластера и что именно он гарантирует?
Мы — инженеры, и вместо безостановочного придумывания новых велосипедов сначала смотрим по сторонам, вдруг кто-то уже решил проблему. В нашем случае это вопрос, как правильно посчитать SLO или SLA для Kubernetes-кластера.
Давайте сразу определимся с терминами — как эти аббревиатуры связаны и почему дальше я использую SLO.
SLI (Service Level Indicator) — фактический измеряемый показатель работы сервиса. Ответ на «Что именно мы измеряем?».
SLO (Service Level Objective) — внутренняя цель, задающая порог допустимого состояния системы на основе SLI. Ответ на «Какой уровень показателей мы хотим и готовы обеспечить?».
SLA (Service Level Agreement) — юридическое или формализованное соглашение между поставщиком сервиса и его клиентом. В нём закрепляется SLO, а также прописываются ответственность и компенсации при нарушении условий.
Начали смотреть на китов отрасли — AWS, Google, Yandex Cloud, VK Cloud. У всех них есть managed Kubernetes, и для всех managed-кластеров есть SLA. Значит, эти ребята точно знают, как считать SLA кластеров.
Но как они это делают?
Да в целом просто. SLA в публичных облаках для Kubernetes-кластера — это доступность Kubernetes API. Фактически показатель рассчитывается исходя из того, сколько времени API-сервер был доступен.
Подходит ли нам такое решение? Давайте проверим на практике.
Итак, мы хотим, чтобы SLA учитывал реальную работоспособность кластера. Возьмём простой манифест — Deployment, который запускает nginx. Применим его в кластере и посмотрим, что произойдёт.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: minimal-deployment
spec:
  replicas: 1
  selector:
    matchLabels:
      app: minimal
  template:
    metadata:
      labels:
        app: minimal
    spec:
      containers:
      - name: nginx
        image: nginx:1.25.3
Манифест отправляется в Kubernetes API. API проверяет его, сохраняет в etcd и возвращает подтверждение, что запрос принят. На этом всё.
Именно эту часть покрывает SLA публичных облаков.
Но мы все знаем, что после этого происходит ещё большой объём работы: controller-manager, scheduler, kubelet и другие компоненты кластера, которые отвечают за запуск подов на узлах кластера. Получается, что SLA в облаках включает только маленький кусочек.
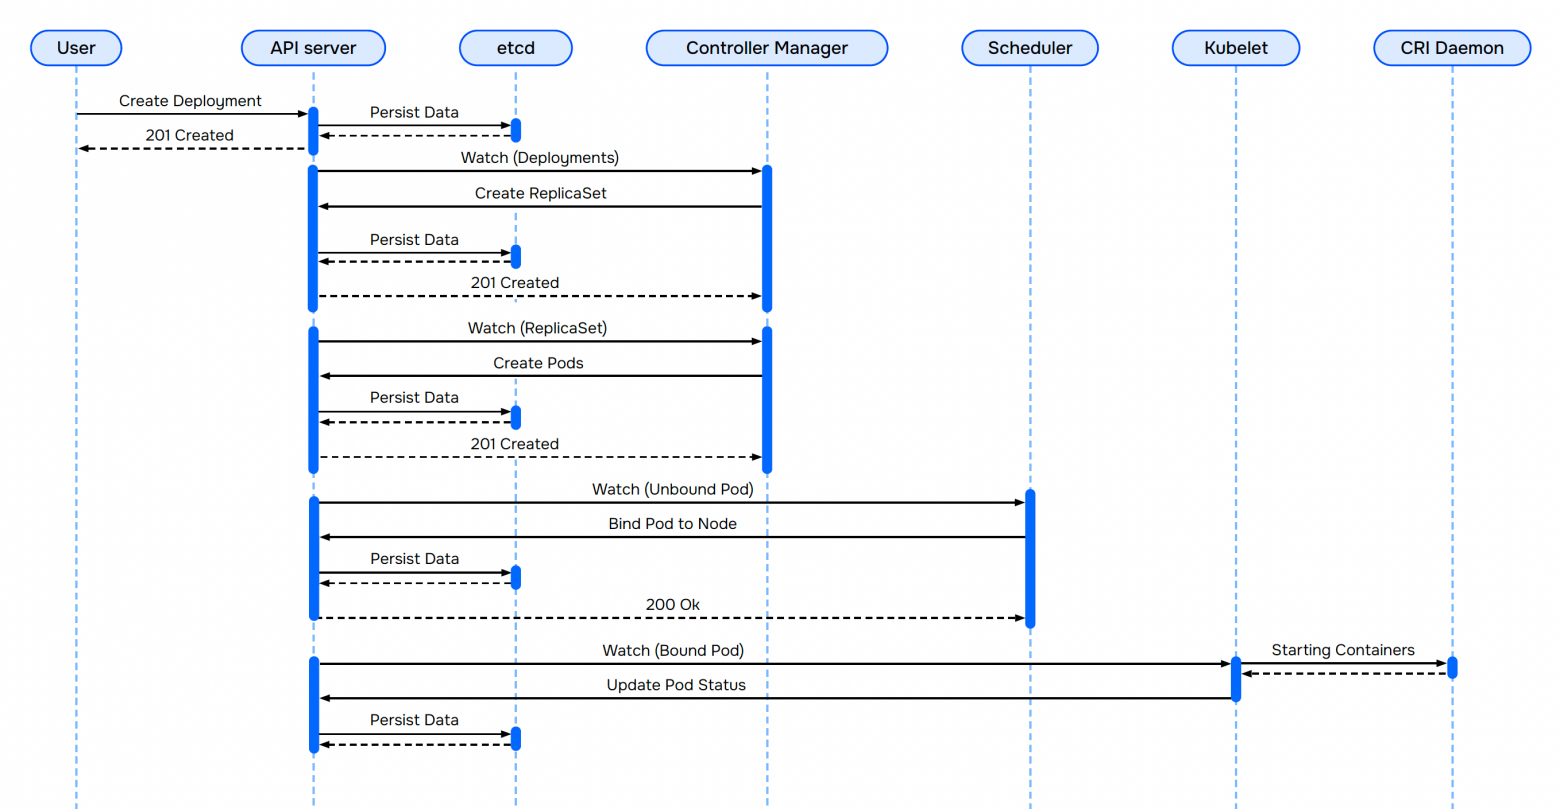
Но нам-то интересно всё, потому что именно в этой «скрытой» части чаще всего и кроются ошибки.
И да, есть ещё кое-что. На первый взгляд кажется, что можно просто отслеживать наличие ошибок в том или ином компоненте и на основании этого строить SLA. Логично? Логично.
Но в Kubernetes операции асинхронные. Компоненты реально начинают работать только тогда, когда к ним приходят запросы, когда происходит взаимодействие или что-то меняется внутри кластера. Соответственно, чтобы построить действительно честный SLA, всё это нужно проверять активно.
Задача выглядит примерно так же, как попытка чисто по приборам понять, заведётся ли автомобиль, который неделю простоял на морозе -40.
Все лампочки-то горят, предупреждений нет. Заведётся ли он? Кто знает.
Может, да. А может, нет. Единственный способ узнать наверняка — попробовать его завести.
Вот и с Kubernetes-кластером примерно то же самое. Чтобы понять, что кластер работает, нужно взаимодействовать с его компонентами и убеждаться, что они действительно выполняют свою работу.
Что важно со стороны кластера Kubernetes
Разберёмся, какие компоненты нам важны и что мы вообще хотим от кластера. Пойдём сразу от потребностей.
1. Запуск приложений
Мы хотим запускать приложения в кластере. Но это слишком абстрактно. Конкретизируем, чего же именно нам хочется:
создавать Deployment и StatefulSet (это взаимодействие с Kubernetes API);
чтобы из Deployment создавались поды — потому что приложение работает не в Deployment, а в поде;
чтобы для подов заказывались и работали PersistentVolume (некоторые запускают stateful-приложения, например базы данных, в Kubernetes);
чтобы сами поды запускались.
Как это проверить? Создадим небольшой контроллер (назовём его AppMeter), который будет выполнять следующие операции:
создавать namespace;
в этом namespace создавать Deployment с несуществующим nodeSelector (чтобы не нагружать лишние ресурсы);
из Deployment создаётся ReplicaSet, из него — под (под повиснет в Pending, но нас это устраивает);
замерять время, за которое появился под, и проверять сам факт появления;
удалять Deployment;
и сохранять результат проверки в виде метрики.
Но мы всё ещё не знаем, действительно ли поды запускаются, и помним про stateful-приложения — нам нужны Persistent Volumes. Поэтому следующий шаг: создать StatefulSet с PV, дождаться, пока под запустится и к нему подключится том.
Что делаем? Правильно, снова замеряем время появления пода. Факта появления недостаточно — важно, за сколько он появился. Если под появился через 30 минут, такой кластер скорее не работает, чем работает. Если через 3 секунды — с кластером всё хорошо.
После успешного появления пода удаляем StatefulSet, namespace и всё созданное, а результаты сохраняем в виде метрик.
cluster_slo {group="control-plane", component="deployment-controller"} 1
cluster_slo {group="control-plane", component="statefull-controller"} 1
cluster_slo {group="control-plane", component="replicaset-controller"} 1
cluster_slo {group="control-plane", component="pod-controller"} 1
cluster_slo {group="control-plane", component="scheduler"} 1

cluster_slo {group="csi", component="localpath-provisioner"} 1
На выходе получаем метрики примерно такого вида: cluster_slo с лейблами группы компонентов (например, control-plane, куда входят deployment-controller, statefulset-controller, pod-controller, scheduler и т.д.) и конкретного компонента. Значение — 1, если проба прошла успешно, и 0, если нет (под не создался или создался дольше допустимого времени).
2. Сеть
Под запустился — вроде бы хорошо. Но он пока «одинокий». Может ли он взаимодействовать с другими подами? В Kubernetes поды взаимодействуют через сеть. Причём сеть здесь не одна: есть сеть подов, сеть сервисов и внутренний DNS для резолвинга имён. Всё это нужно проверять.
Самый очевидный вариант — взять сеть между узлами, пинговать узлы друг с другом.
Даст ли это ответ, работает ли сеть в кластере? Скорее нет, чем да: сеть подов, сервисов и DNS ведь остаются за скобками.
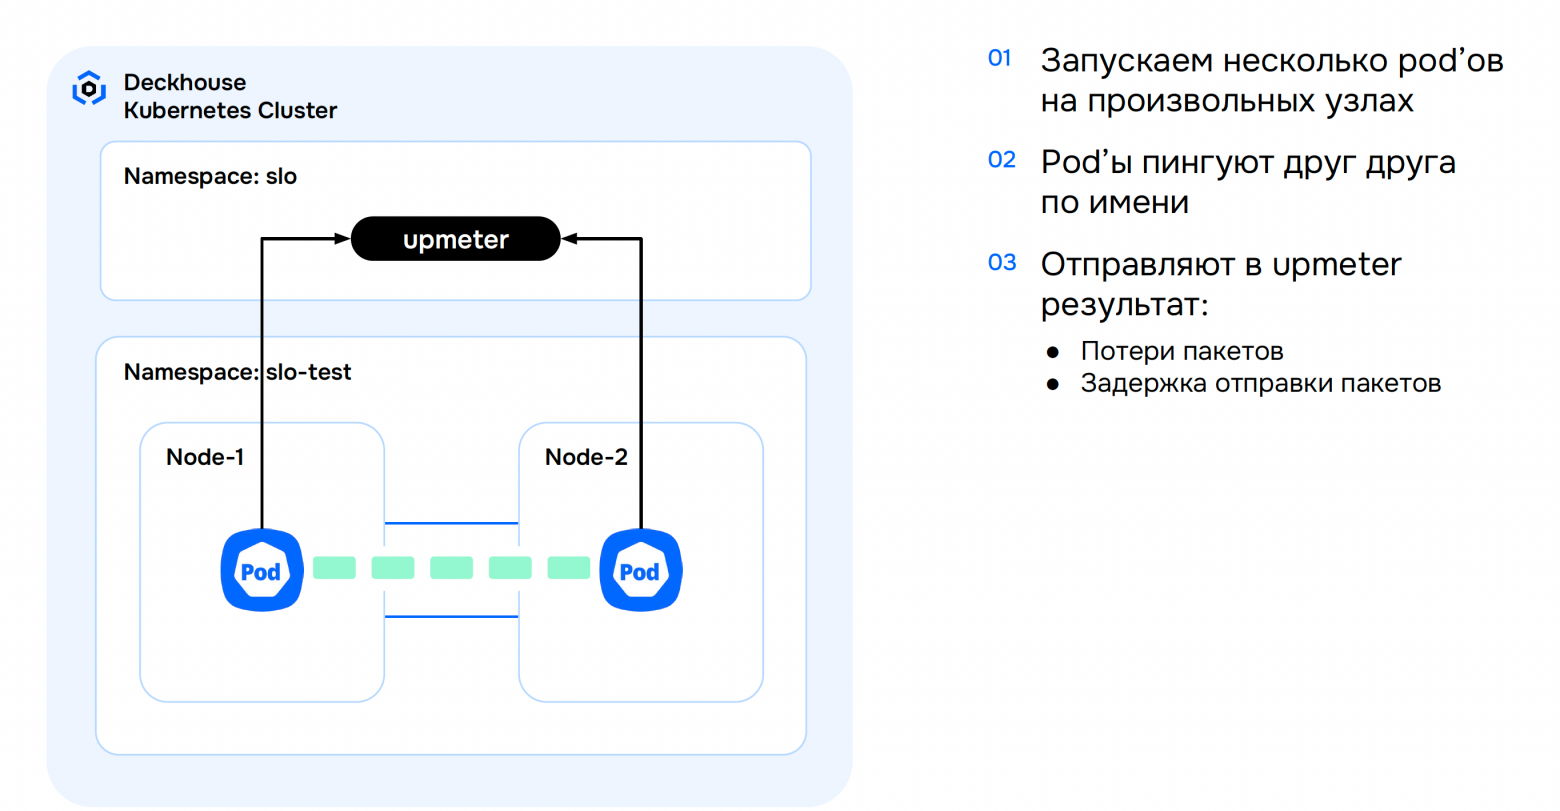
Поэтому upmeter создаёт поды на разных узлах (через nodeSelector или pod anti-affinity). Поды пингуют друг друга, а результаты (время, потери) отправляют в контроллер. Дополнительно контроллер обращается к подам через Service — так мы проверяем сеть сервисов и DNS.
В итоге:
поды пингуют друг друга → сеть подов работает;
обращение через Service → сеть сервисов и DNS работают.
Результаты снова сохраняются в метриках. Базовая потребность в запуске приложений внутри кластера протестирована.
3. Доставка внешнего трафика (Ingress)
Приложения внутри кластера могут взаимодействовать друг с другом, но обычно этого недостаточно: приложения делают для пользователей, которые находятся за пределами кластера.
Нам нужно доставлять запросы от пользователей к приложениям. Самый простой способ — Ingress (возьмём, например, Ingress NGINX). На первый взгляд это просто nginx, который проксирует запросы. Казалось бы, может ли что-то пойти не так?
Разумеется.
Мы создаём ресурс Ingress (набор правил, куда и как проксировать). Применяем его в кластер куба, API-сервер принимает его, валидирует, сохраняет в etcd, возвращает нам, что всё хорошо, запрос сохранен.
Дальше в работу вступает Ingress-контроллер: он подписан на все Ingress, и как только появляется новый, он его разбирает, достаёт из него сервисы, подписывается на endpoints этих сервисов, на основании endpoints генерирует конфигурационный файл, валидирует его и только после этого применяет.
Как показывает практика, процесс перезагрузки конфига может занимать очень длительное время — не секунды, а 30–50 минут. Если изменения начинают работать через 40 минут, как я уже писал выше, то такой кластер скорее не работает, чем работает. Мест, где в этой цепочке может что-то пойти не так, очень много. Поэтому важно тестировать всю цепочку целиком.
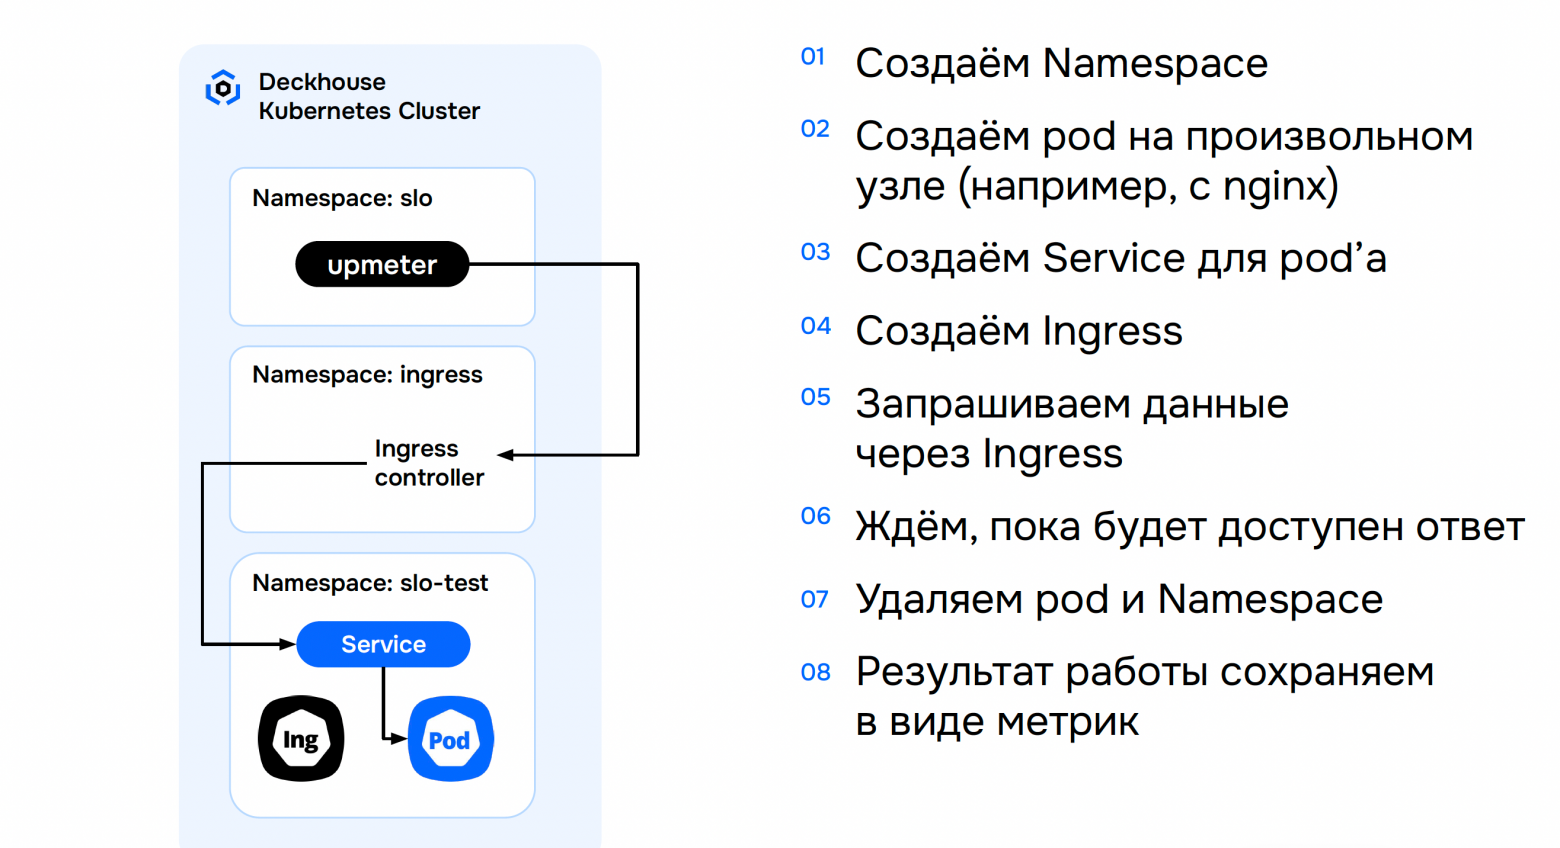
Сделать это всё ещё можно с помощью нашего контроллера, но схема с upmeter становится чуть сложнее:
контроллер создаёт namespace;
в нём запускает под;
для пода создаёт Service;
создаёт Ingress;
Ingress-контроллер видит Ingress и применяет правило.
Мы начинаем запрашивать данные из пода не напрямую и не через Service, а через Ingress, а затем ждём, пока он получит ответ.
За это время Ingress-контроллер получает список endpoints, генерирует и валидирует конфигурацию, применяет её. Как только мы получаем первый ответ из пода через Ingress — считаем, что вся цепочка прошла успешно. Засекаем время и результат, сохраняем в метриках, удаляем созданные ресурсы. И отправляем метрики, тем самым проверяя работоспособность ингресса.
Таким же образом можно тестировать дополнительные компоненты в кластере — например, менеджер сертификатов и другие.
На данном этапе мы убедились, что можем запускать приложения внутри кластера, что они взаимодействуют друг с другом и что можем доставлять к ним внешние запросы.
4. Поддержание работоспособности приложений
Но и это ещё не всё (с). Остаётся ещё одна важная задача — поддержание работоспособности приложений. Здесь целая группа компонентов: мониторинг, логирование и другие.
Кажется, что всё просто
Возьмём мониторинг. В целом, это простое приложение с довольно бинарным поведение: либо работает, либо нет. Но если заглянуть глубже, система мониторинга:
собирает метрики с приложений и сохраняет их в базу;
на основании метрик проверяет триггеры;
выполняет recording rules (сохраняет результат запроса в виде новой метрики);
позволяет читать собранные метрики.
Фактически внутри есть три подсистемы: сбор метрик, алертинг/recording rules и чтение метрик. Всё это нужно тестировать.
Upmeter предоставляет в систему мониторинга заранее известную метрику. Мониторинг её собирает. На основании этой метрики создаётся recording rule, порождающий новую метрику. На основании новой метрики создаётся алерт. В конце проверяем: метрика появилась, recording rule отработал, алерт создался, данные можно прочитать. Совокупность этих проверок позволяет гарантировать, что система мониторинга действительно работает.
Аналогичным образом можно тестировать логирование, скейлинг приложений, веб-интерфейс управления кластером и другие компоненты.
В результате у нас появляются группы компонентов, и для каждой группы — набор тестов. По сути мы выполняем end-to-end-тесты в реальном времени с определённой периодичностью. Это позволяет убедиться, что компоненты работают, и сгенерировать набор метрик для каждой группы.
Как теперь из этих метрик получить SLO
Набор метрик сам по себе ещё не отвечает на вопрос, какой SLO у кластера. Нужно на основании этих метрик посчитать показатель.
Самое простое решение «в лоб»: если хотя бы по одному из компонентов проверка провалена — весь SLO за это время обнуляется. В каждый момент времени находим минимальное значение. Если минимум равен 1 — SLO выполняется, если 0 — нет. Дальше суммируем количество успешных проверок, делим на общее количество, умножаем на 100 и получаем SLO кластера.
SLO = min(slo_clusterf))
0 — если есть хотя бы одна проваленная проба в данный момент
1 — если все пробы в данный момент прошли успешноLO_30d = 100 × (успешные проверки за 30 дней) / (количество проверок за 30 дней)
Как это оформить в виде promQL? Выглядит просто: функция min, находим в каждый момент времени минимальное значение, затем суммирование за 30 дней, потом деление на количество проверок и, наконец, умножение на 100.
100 *
  sum_over_time (
    min(slo_cluster{})
  ) [30d]
/
count_over_time (
  min(
    slo_cluster{}
  ) [30d]
Но насколько это справедливо?
Представим: не работает CNI — сеть в кластере. Можно ли пользоваться таким кластером? Очевидно, нет. Поды запускаются, но не могут взаимодействовать друг с другом.
С другой стороны, если недоступен UI — можем ли мы пользоваться кластером и выполняет ли он основные задачи? Скорее да. Поды запускаются, взаимодействуют, трафик доставляется. Базовые функции кластера работают. Но текущая формула говорит, что недоступный UI обнуляет весь SLO. Это не очень честно: формула не позволяет отличить критичные проблемы от минорных.
Для этого разделим наши компоненты на две самостоятельные группы.
Две группы компонентов: critical и optional
1. Critical — без них кластер Kubernetes не работает совсем.
2. Optional — без них менее комфортно взаимодействовать с кластером, но приложения работают, базовые функции выполняются.
Вот только теперь нам нужно считать два отдельных SLO. Для этого в метриках добавляем лейбл (например, tier) со значениями critical или optional.
Для critical-компонентов формула остаётся прежней: нам не важно, что именно не работает (control plane, CNI или что-то ещё) — без этих компонентов кластер не работает.
cluster_slo {group="control-plane", component="deployment-controller"} 1
cluster_slo {group="control-plane", component="statefull-controller"} 1
cluster_slo {group="control-plane", component="replicaset-controller"} 1
cluster_slo {group="control-plane", component="pod-controller"} 1
cluster_slo {group="control-plane", component="scheduler"} 1

cluster_slo {group="csi", component="localpath-provisioner"} 1
Просто фильтруем проверки по лейблу.
100 *
  sum_over_time(
    min(slo_cluster{tier="critical"})
  ) [30d]
/
count_over_time (
  min (
    slo_cluster{tier="critical"}
  ) [30d]
)
Для optional-компонентов всё интереснее. Если не работает UI и мы считаем по старой формуле, получается, что UI влияет на все компоненты. Но это не так: мониторинг и логирование продолжают работать. Каждый компонент должен вносить свой вклад в SLO, но не обнулять его.
100 *
sum (
  sum_over_time (
    min by (group)
(slo_cluster{tier="optional"}) [30d]
  )
  /
  count (
    min by (group) (slo_cluster{tier="optional"})
  )
)
/
count_over_time (
  min by (group)
(slo_cluster{tier="optional"}) [30d]
)
Сначала считаем SLO для каждого компонента (поскольку на один компонент может быть несколько проверок — как в случае с мониторингом). Находим минимальное значение по проверкам компонента: если оно 1 — группа работает, если хотя бы одна проверка провалена — не работает. Дальше суммируем значения по всем компонентам и делим на количество компонентов. Так каждый компонент вносит равный вклад. Умножаем на 100 — получаем SLO в конкретный момент времени. Затем суммируем успешные проверки за 30 дней, делим на общее количество и снова умножаем на 100.
SLO_group_X = min by (group="X") (slo_cluster{})
0 — если в группе есть хотя бы одна проваленная проба
1 — если все пробы в группе прошли успешно
SLO_optional = (SLO_group_1 + SLO_group_2 + …. + SLO_group_N) / N
Каждая группа вносит равный вклад в итоговый SLO_optional
SLO_optional_30d = 100 x (сумма за 30 дней SLO_optional) / (количество проверок за 30 дней)
Что в итоге
SLO кластера можно посчитать, только проводя постоянное тестирование. Если мы не тестируем — мы не можем гарантировать, что тот или иной компонент работает.
Это не отменяет необходимости смотреть и на «классические» метрики компонентов: 500-е и 400-е ошибки API-сервера, время создания подов и прочего. По какому-то стечению обстоятельств наш тестовый под может создаваться быстро, а другие поды — медленно. Поэтому нужно смотреть и на остальные метрики (в том числе scheduler).
По-хорошему нужно считать не один SLO, а два:
для critical-компонентов (без которых кластер не работает);
для optional-компонентов (по другой формуле).
Состав проб в группах зависит от потребностей. Скажем, менеджер сертификатов для кого-то критичен, а для кого-то — нет. Скейлинг приложений для кого-то — основа бизнес-логики и должен быть в critical, для кого-то — optional. Распределение зависит только от ваших задач.
По сути SLO представляет собой «матрёшку»:
на верхнем уровне — SLO critical;
внутри — SLO групп;
внутри групп — SLO по каждой пробе.
То же самое и для optional. За счёт этой структуры можно анализировать не только «работает / не работает кластер», но и в какой группе произошёл сбой, какая конкретно проба была провалена и почему. Это позволяет быстрее диагностировать проблемы, находить тенденции (какие компоненты страдают чаще) и целенаправленно их исправлять.
А если хочется готовое решение?
То у меня для вас есть две новости — плохая и хорошая.
Плохая: готового ничего нет. Вообще.
Хорошая: можно сделать своё, и это достаточно несложно. Тот контроллер, о котором шла речь весь доклад, — очень простая штука. Он через API кластера создаёт те или иные манифесты, через тот же API проверяет, когда они были созданы, и отдаёт результат проверок в виде метрик.
Совсем немного времени осталось до новой конференции Kuber Conf от АОТ, отмечайте в календарях 23 ноября.
Главная тема — инженерные задачи без привязки к конкретным облакам: практика эксплуатации Kubernetes, разбор инцидентов и обмен опытом.
Участники будут говорить о построении инфраструктуры вокруг K8s и о способах удержания падающего SLO. Программа и регистрация — по ссылке.


Комментарии 0