В начале 2025 года мы попросили Claude добавить в проект API-эндпоинт. Код он написал быстро, аккуратно и даже с документацией. На ревью в нём нашли три проблемы:
Бизнес-логика лежит прямо в контроллере, у нас так не делают.
Функция авторизации написана заново, хотя такая же в проекте уже была.
Имя
getUserвместоget_user.
На следующий день всё повторилось, уже на другой задаче. Лечится это подробной постановкой: в промпте можно расписать, где у нас лежит логика, какая авторизация уже есть и как мы называем функции. Но расписывать всё это придётся перед каждой задачей, одно и то же раз за разом.
Новый разработчик первые недели больше читает, чем пишет. Он разбирается в коде, ходит к коллегам с вопросами и постепенно понимает, почему всё устроено так, а не иначе. У ИИ-агента этот период не кончается: вчерашнего разговора он не помнит и каждый день выходит на работу впервые. Читает файлы, ищет по проекту grep’ом, тратит на это время и токены и всё равно может не найти нужного, потому что решения, принятого полгода назад, в коде нет.
Мы — команда «Куб три». Нас 35 человек, и больше 15 лет мы занимаемся заказной разработкой: внедряем и дорабатываем под клиентов SuiteCRM и Odoo, ведём проекты с многолетней кодовой базой. Обычно на таком работают от двух до пяти разработчиков, плюс аналитики, тестировщики и руководитель, так что знания размазаны по людям, и агент узнаёт из них только то, что ему перескажут. Эту проблему мы решаем полтора года. Сначала пробовали другие способы (о них ниже), потом сделали AI Council — платформу, которая даёт ИИ-агентам память о проекте: граф кода, решения команды и её правила. Теперь используем его и в своих разработках, и в клиентских.
Главное, что мы за это время поняли: агенту не хватает не ума, а того, чего нет в коде. Он не знает, что и почему решила команда, какие у неё правила и что из этого ещё верно. Причём приносить ему это знание надо без просьбы, потому что за правилами он сам ходит редко.
Ниже расскажем, чего агенту не хватает, какие инструменты для этого уже есть, что сделали мы и во что это обходится. А главный результат скажем сразу: в прямом сравнении агент с AI Council написал код, который проще принять на ревью, но работа модели обошлась почти на треть дороже.
Это не только у нас
Сначала мы проверили, одни ли мы такие. Оказалось, не одни: вот шесть публикаций с замерами, которые вышли к осени 2026 года. У каждой свои оговорки, мы вынесли их в последнюю колонку.
Что измерили | Результат | Источник и оговорка |
|---|---|---|
Главная претензия к ИИ-инструментам | 66% разработчиков называют ответы ИИ «почти правильными, но не совсем», а 45% говорят, что отладка такого кода занимает больше времени | Stack Overflow Developer Survey 2025, 49 тыс. ответов, самооценка |
Ощущение против замера | Опытные разработчики считали, что ИИ ускорил их примерно на 20%, а по замеру работали на 19% медленнее | METR, 2025, контролируемый эксперимент, 16 человек на знакомых им репозиториях |
Код против задач | После внедрения ИИ-агентов более чем в 700 компаниях кода стало на 30% больше, закрытых задач статистически столько же, а время от открытия PR до слияния выросло на 49% | Гарвард, октябрь 2026, рабочая статья без рецензирования |
Ожидание ревью | PR от агента ждёт начала ревью 17,6 часа против 3,4 часа у обычного | LinearB Benchmarks 2026, 75-й перцентиль, 8,1 млн PR |
Замечания в PR | 10,83 замечания на PR с ИИ против 6,45 у написанных людьми | CodeRabbit, декабрь 2025, 470 PR; данные вендора ИИ-ревью |
Повторное использование кода | Доля рефакторинга упала с 25% до менее чем 10%, доля скопированного кода выросла с 8,3% до 12,3% | GitClear 2025, 211 млн изменённых строк |
Исследования разные, а картина получается одна. По ощущениям ИИ ускоряет сильнее, чем по замеру. Код пишется быстро, но в проект вписывается плохо, и расплачиваются за это на ревью и переделках, так что узкое место переехало из написания кода в проверку. Google в отчёте DORA 2025 называет ИИ усилителем, но с условием, что у агентов есть доступ к внутренней документации и коду компании.
Чего не хватает агенту: три вида знания и время
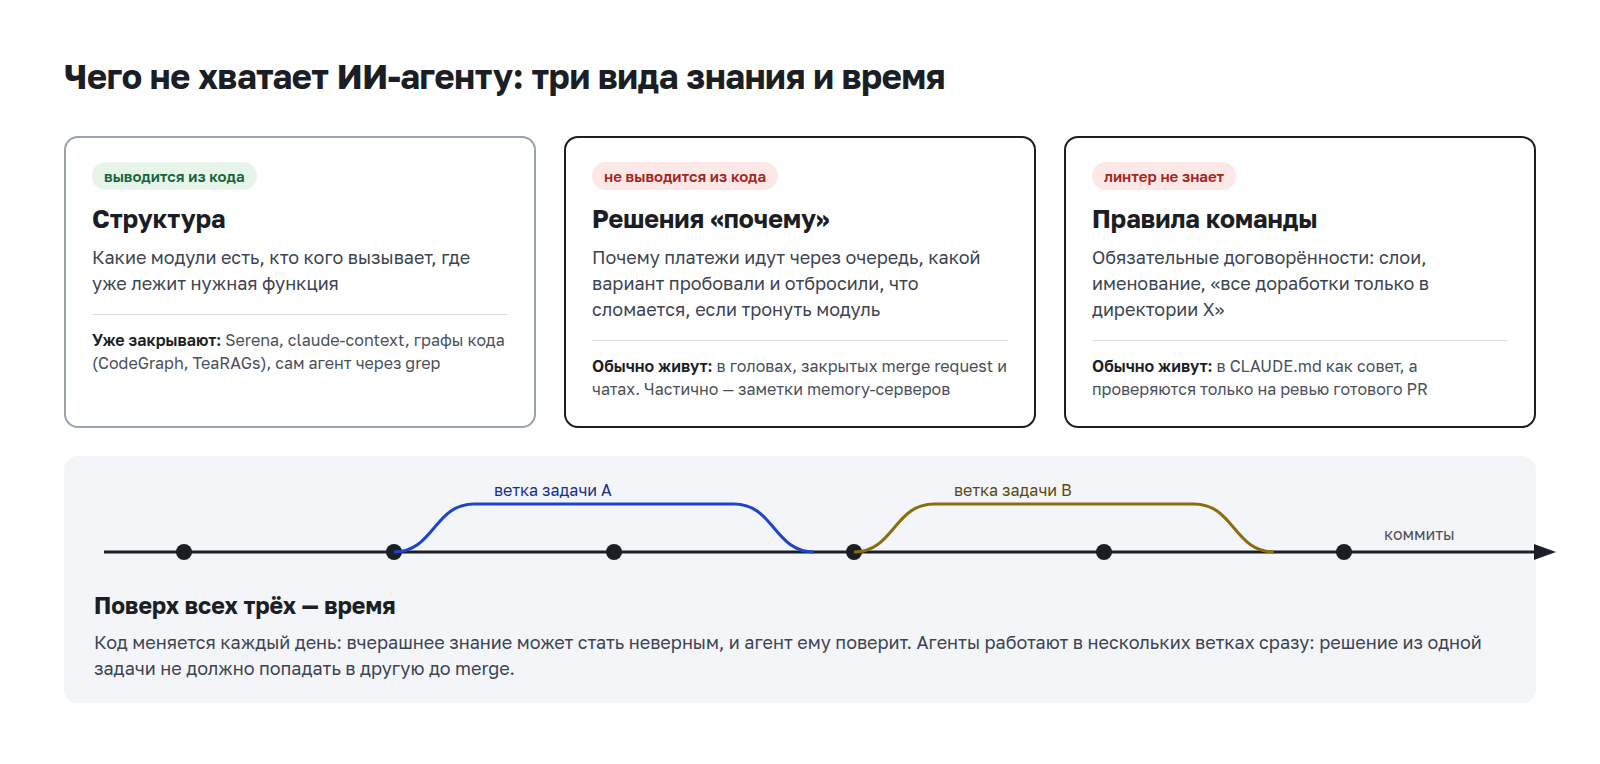
Мы разобрали замечания, которые код агентов получал на ревью в наших проектах. Почти все они упираются в то, что агент чего-то не знал, и это «что-то» бывает трёх видов.
Структура. Какие есть модули, кто кого вызывает, где лежит нужная функция. Всё это можно вывести из кода парсером, графом или поиском. Агент добывает это и сам, grep’ом, но медленно и дорого.
Решения. Почему платежи идут через очередь, почему этот модуль не трогаем, от какого варианта уже отказались. Из кода этого не вывести, в нём остаётся только итог решения. Причины живут в головах, в закрытых merge request и в чатах, а если процессы выстроены хорошо, то ещё в ADR, протоколах встреч и материалах системной аналитики. Но агенту от этого не легче: документы лежат отдельно от кода, и он не знает, что перед правкой файла их стоило бы прочитать.
Правила команды. Договорённости, обязательные для всех: слои, именование, запреты. Часть из них проверяет линтер, но большинство из коробки ему не по зубам. Под правило «все доработки только в директории X, остальные не трогаем» проверку придётся писать самим, да и сработает она, когда код уже написан.
В истории с эндпоинтом встретились два вида из трёх. Вторую функцию авторизации агент написал, потому что не знал структуры, а логика в контроллере и getUser появились, потому что он не знал правил.
И на всё это накладывается время. Код меняется каждый день, и то, что было верно вчера, сегодня может оказаться неправдой. Документация, которая отстала от кода, становится вредной, потому что агент ей верит. А когда пять агентов работают в пяти ветках, решение из одной не должно влиять на другую, пока её не влили в main.
По этой схеме мы дальше сравниваем инструменты: смотрим, какие из трёх видов знания они покрывают и как справляются со временем. Сравниваем и по тому, чего на схеме нет: кто приносит знание, сам агент по своему запросу или система без запроса. Этот вопрос оказался важнее, чем мы думали, и ниже мы покажем это на цифрах.
Что уже есть и где этого хватает
Памятью для агентов занимаются многие, и часть решений бесплатна. AI Council — наш коммерческий продукт, так что отдельно скажем, где без него можно обойтись. Основные подходы такие.
Файлы с правилами. CLAUDE.md, AGENTS.md, cursor rules и автопамять Claude Code, которая сама сохраняет заметки между сессиями. По сути это тот же подробный промпт, только записанный один раз. Начать можно за пять минут, а сам файл лежит в git и версионируется вместе с веткой (кроме автопамяти, она хранится на машине разработчика). Минусы тоже понятны. Текст никак не связан с кодом и устаревает незаметно, агент читает его целиком, нужное вперемешку с ненужным, а правила в нём остаются советом, потому что заставить модель их выполнять файл не может.
Навигация по символам. Serena даёт агенту инструменты как в IDE, поверх language server: найти символ и всех, кто на него ссылается, вставить код после функции. Это точнее и дешевле, чем grep. Но знает Serena один код: решений команды и её правил в ней нет, если не считать простых заметок. И пользоваться ею агент должен по своей инициативе. В документации Serena описаны необязательные хуки, которые напоминают агенту о её инструментах, когда он скатывается обратно в grep, потому что сам он о них забывает. К этому мы ещё вернёмся.
Семантический поиск. claude-context от Zilliz индексирует код в Milvus или Zilliz Cloud. Поиск гибридный, BM25 плюс векторы, код делится на фрагменты по AST, а индекс обновляется инкрементально. К лету 2026 года у проекта было около 12 тыс. звёзд на GitHub. Он выручает, когда не знаешь, как называется то, что ищешь. Ограничение то же, что у Serena: кроме кода, в нём ничего нет.
Графы кода. На Хабре уже разбирали CodeGraph и TeaRAGs. Оба строят индекс кодовой базы в виде графа символов и связей и отдают его агенту через MCP. По графу агент быстро выясняет, кто кого вызывает и что заденет его правка. Про решения и правила граф, как и поиск, молчит.
Memory-серверы. Mem0, skillmem, agent-memory-mcp — это долговременная память агента в виде заметок и фактов. skillmem, кстати, тоже пришёл к хукам Claude Code. В такую память уже можно записать решение вместе с причиной. Слабое место в другом: заметка живёт отдельно от кода, и когда он меняется, она остаётся прежней.
Коммерческие движки контекста. Augment в феврале 2026 года открыл свой Context Engine как MCP-сервер для любого агента, с локальным и удалённым режимами. По их собственному замеру качество работы агентов с ним выросло больше чем на 70%. Unblocked собирает контекст из кода, документации, тикетов и переписки, то есть дотягивается и до решений команды. Правила в обоих продуктах, судя по документации, не основная функция. О работе с ветками там ничего не сказано.
ИИ-ревью. CodeRabbit, Greptile и Qodo заходят с другого конца. Раз проверка стала узким местом, они берут часть её на себя: читают готовый PR и оставляют замечания. Но код к этому моменту уже написан, и всё, что агент сделал не так, как принято в проекте, приходится переделывать.
Подход | Структура кода | Решения «почему» | Правила команды | Кто инициирует | Ветки и устаревание |
|---|---|---|---|---|---|
CLAUDE.md и автопамять | Нет | Если записать вручную | Как совет в тексте | Загружается в начале сессии целиком | CLAUDE.md версионируется в git, автопамять нет; актуальность не проверяется |
Serena | Да, через LSP | Простые заметки | Нет | Агент вызывает сам | Рабочая копия |
claude-context | Чанки и векторы | Нет | Нет | Агент вызывает сам | Инкрементальный индекс |
CodeGraph, TeaRAGs | Граф символов | Нет | Нет | Агент вызывает сам | Переиндексация кода |
Memory-серверы | Нет | Заметки агента | Как заметки | По запросу; у skillmem хуки | Без привязки к коду |
Augment, Unblocked | Семантический индекс | У Unblocked из переписки и документов | Не основная функция, судя по документации | Агент вызывает сам | Локальный или удалённый индекс; работа с ветками в документации не описана |
ИИ-ревью | Да | Частично | Свои правила ревью | После открытия PR | По PR |
AI Council | Граф кода и статический анализ | Записи, привязанные к коду | Правила MUST и SHOULD, доставляются целиком | Система доставляет сама, плюс MCP | Знания живут на ветках git, проверка актуальности |
Если над небольшим проектом работают один-два человека, им хватит CLAUDE.md и Serena или claude-context. Остальные случаи, когда AI Council не нужен, мы собрали в конце статьи.
Три попытки: две неудачные и одна рабочая
Попытка первая: пусть модель сама опишет проект. Нажимаешь кнопку, модель читает репозиторий и пишет описание архитектуры. Получается дорого и медленно. Вдобавок модель не знает, что в проекте важно, и хелпер для форматирования даты описывает так же подробно, как биллинговый движок. А через неделю описание уже расходится с кодом. От этого подхода мы отказались.
Попытка вторая: RAG поверх кода. Режем файлы на чанки, векторизуем, ищем похожее по запросу. Семантический поиск работает, и небольшому проекту этого может хватить. Но теряется структура: функция оторвана от класса, класс от модуля, а модуль от остального проекта. Ну и решений «почему» в коде как не было, так и нет.
Попытка третья, рабочая: граф, векторы и знания. Граф кода строит статический анализ, без модели. Векторы отвечают за поиск по смыслу. В отдельном слое лежит то, что из кода не выводится: решения, причины, ограничения, правила. Слои связаны между собой, например запись о решении указывает на функции и модули, к которым она относится.
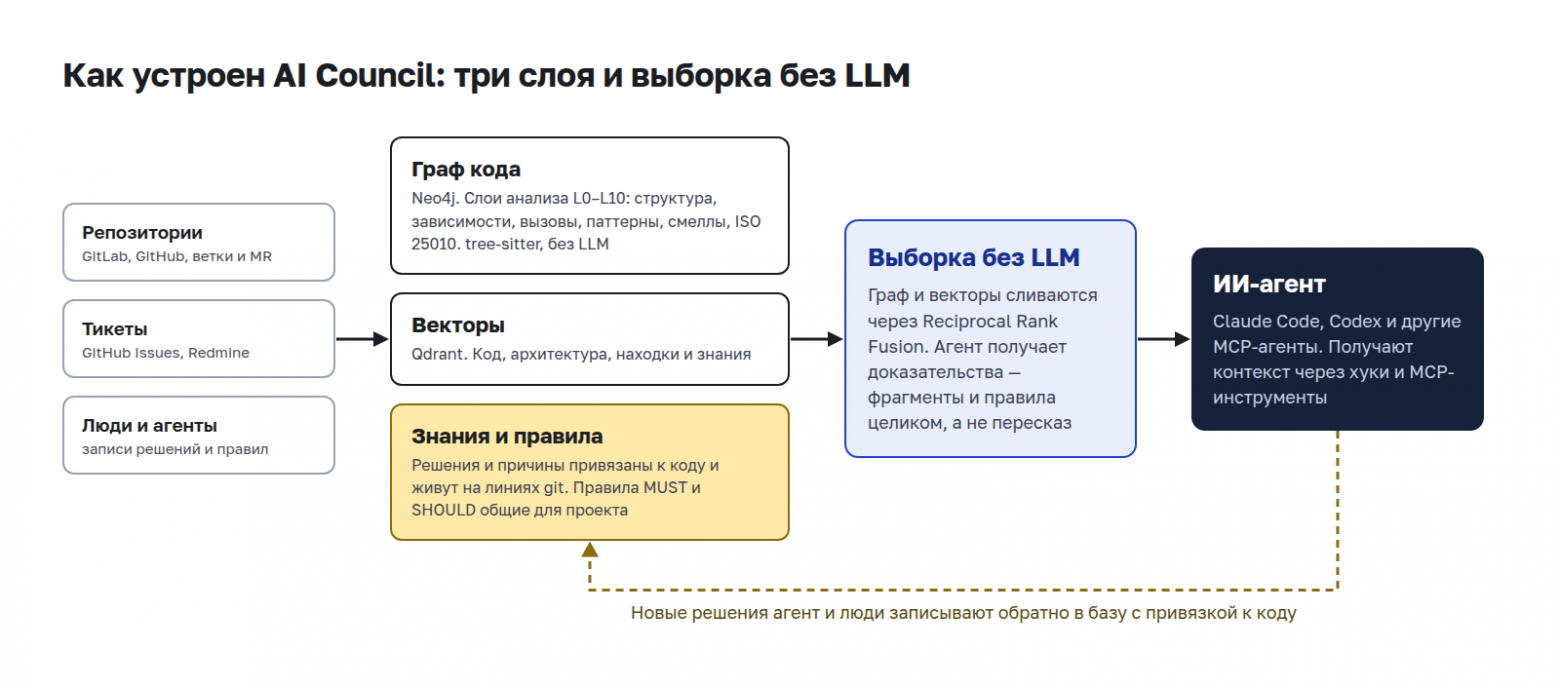
На вопрос агент получает подборку доказательств: несколько десятков фрагментов из графа и векторного поиска, слитых в один список. По нашим замерам это от 9 до 18 тысяч символов. В токенах это несколько тысяч: первые проценты контекстного окна, если оно на 200 тысяч. Примерно столько же занимает один файл с кодом строк на триста-пятьсот.
Четыре решения, которые нас отличают
Три слоя можно собрать и из открытых частей. Свой продукт мы делаем ради четырёх решений. Первые два о том, как знания и правила доходят до агента, вторые два о том, как знание переживает время.
А доставляем мы две разные вещи: записи и правила.
Запись знания рассказывает, как и почему что-то устроено. Это может быть решение с его причиной, разбор дефекта или тикета, схема потока. У записи есть привязки — имена классов, модулей или файлов, при работе с которыми она должна всплыть. Пока агент этот код не трогает, запись ему не нужна. Вот как она выглядит в контексте агента, если целиком не поместилась:
[Knowledge/decision] ADR-124: серверный сбой шлюз отдаёт как 500 (не 502), UI сам повторяет
502/503 только для чтений … — not shown here (4 KB);
read it with get_knowledge("knowledge/decision/dfda410b…")
Правило (в продукте оно называется конвенцией) — это договорённость команды, обязательная для всех. У правила есть сила, MUST или SHOULD, и область действия: либо весь проект, либо конкретные файлы, классы и функции. Разница простая. Запись агент читает и принимает к сведению, а правило обязан выполнять. Ниже одно из нашего свода, целиком, в том виде, в каком оно приходит агенту:
[MUST] Each service must own its database exclusively. No service may directly access
another service data store (Neo4j, PostgreSQL, Qdrant, Redis). Cross-service data access
must go through gRPC APIs. This ensures independent deployability, schema evolution,
and failure isolation. (convention/database-per-service)
Это правило короткое. Обычно правило занимает около страницы: что требуется, почему, как применять и чего оно само проверить не может.
1. Знание приходит само, а не только по запросу
Здесь мы возвращаемся к вопросу, кто приносит знание: сам агент или система. У AI Council есть MCP-инструменты, например поиск по коду или правила для файла, и агент вызывает их сам, когда решит, что ему это нужно. А есть хуки. Это команды, которые Claude Code запускает в заданные моменты, скажем перед чтением файла или в конце ответа. Модель их не вызывает и пропустить не может, а хук умеет дописать ей в контекст текст или отклонить вызов инструмента.
Одного MCP мало, потому что инструмент надо вызвать, а значит, можно и не вызвать. Мы посмотрели, как это выглядит на нашем проде, на 12 тысячах сессий: проверку правил агент запускал в 16% из них, а до первой правки — в 13% сессий с правками. То есть в семи таких случаях из восьми он взялся за код, не запросив правил. Хуки при этом работали, и возражение «потому и не запрашивал» мы разберём ниже, в разделе с цифрами.
Поэтому основным каналом мы сделали хуки. В Claude Code они есть с 2025 года, в Codex появились весной 2026-го как экспериментальная функция. Не мы одни так решили: тем же путём пошли Serena и skillmem. MCP при этом остался. Когда агенту что-то нужно, он ищет через него сам, а агентам без хуков достаётся только этот путь.
Через хуки AI Council дотягивается до агента, даже если тот его не звал:
Событие | Что происходит |
|---|---|
Старт работы и каждый промпт | В начале работы приходит свод правил уровня проекта, каждое правило целиком. Перед каждым следующим промптом правила повторяются по кругу; объём на один промпт разработчик ограничивает в своих настройках |
Агент собирается читать или править файл | Приходят правила, привязанные к этому файлу, его классам и функциям, записи знаний по этому коду и известные смеллы файла |
Агент закончил отвечать | Чек-лист завершения: проверки, записанные для этого проекта, и известные проблемы в изменённых файлах |
Пример из проекта клиента. В CRM нужно было объединять «неизвестные» контакты, созданные из входящих писем, с известными. Стандартный merge для этого не годился: поля известного контакта он бы затёр. Разработчик потратил день и выяснил, как надо: связи переносить на известный контакт, а неизвестный удалять. Это он записал в базу и привязал запись к модели контакта. Когда агент в следующий раз открыл файл этой модели, запись сама попала к нему в контекст, и задачу он сделал по этой схеме, не изобретая merge заново.
Если записей для файла набралось много, они встают в очередь и приходят одним блоком при следующем вызове инструмента. То, что агент в этой сессии уже получал, второй раз целиком мы не присылаем.
Когда запись приедет, зависит от её привязок, поэтому AI Council их проверяет. Если под привязку попадает больше 30 функций или классов, она считается слишком общей и отбрасывается. Мы сами на этом попались: привязали одну из записей к graph_service, это имя совпало с 357 сущностями, и AI Council его отбросил, посоветовав назвать модуль, класс или файл вместо целой подсистемы.
Хук на открытии файла привозит только то, что привязано к этому файлу. Но бывает, что агент рассуждает о вещи, про которую в базе есть запись, а нужный файл так и не открыл. На этот случай есть подсказка по словам самого агента. Отдельный хук считает идентификаторы, которые тот упоминает в рассуждениях, и про те, что встретились пять раз и больше, спрашивает базу, нет ли о них записи. Если она есть и агент её в этой сессии ещё не видел, в контекст приходит одна строка: заголовок и команда, которой запись можно прочитать. Слабое место у подсказки понятное: если агент называет ту же вещь другими словами, хук промолчит.
Дальше в примерах будет Keycloak. Это открытый сервер авторизации на Java, с большой кодовой базой и многолетней историей тикетов. Мы подключили его к AI Council как стенд, чтобы показывать на нём то, что на проектах клиентов закрыто договорами. Подсказка по словам там сработала, например, так: агент семь раз упомянул класс OIDCLoginProtocol и получил строку о записи по тикету #51712, про logout URL в OIDC.
Записи по тикетам, как в этом примере, для Keycloak никто не писал руками. Обычно на этом базы знаний и спотыкаются: их кто-то должен написать, а потом следить, чтобы они не разошлись с кодом, и времени на это, по нашему опыту, не находится. Здесь AI Council сам разобрал историю тикетов GitHub. По каждому он записал, что просили и что сделали, и привязал разбор к коду, которого тикет касался. Так набралась почти вся база, в ней больше трёх тысяч записей.
Бесплатным это не было. Тикеты разбирала модель, и вместо времени людей мы платили её работой. Перепроверять такие записи не приходится: каждая помечена как история, с номером тикета и датой, и за нынешний код не ручается. За остальными следит проверка актуальности, о ней раздел 4.
Что такая база даёт, видно на примере, который можно проверить по открытым тикетам. Вопрос мы придумали сами, такой, с каким мог бы прийти разработчик, которому поручили этот класс: «почему GzipResourceEncodingProvider никогда не сбрасывает кэш на диске?»
Ещё до чтения кода у агента оказались правило SHOULD о публикации производных копий, разборы тикетов #52802 и #53238 и схема пути запроса через слои кэша тем оформления. Что-то он запросил у базы сам, что-то пришло хуком, когда он открыл файл. Потом он сверился с кодом и развёл два тикета. Первый, #52802, про кэш, который не сбрасывается, на момент проверки оставался открытым. А гонку из #53238 закрыли атомарным переносом файла, и в коде это видно.
Есть у доставки и жёсткий вариант, мы называем его KB-first gate: сначала база знаний, потом код. Пока сессия ни разу не обратилась к базе знаний, читать и править код ей не дают, причём чтение через cat и sed в bash тоже отклоняется. Гейт открывается после запроса к базе через list_knowledge, get_knowledge или brief_me_on. Его можно отключить.
2. Правило приходит целиком или не приходит
Привезти агенту сразу всё, что есть в базе, нельзя. Контекст у модели ограничен, и чем больше в нём лишнего, тем меньше места остаётся самой задаче и тем дороже каждый запрос. Приходится выбирать, что везти и в каком виде. На знаниях место можно экономить: запись, которая не поместилась, приходит в виде заголовка и команды для чтения, как в примере с ADR-124. С правилами этот номер не проходит, и поняли мы это не сразу.
Первая идея была сокращать, то есть обрезать текст каждого правила до пары строк, чтобы свод помещался в контекст. От неё мы отказались. Если вместо «все доработки только в директории X, остальные не трогаем» агент получит пересказ «не трогать legacy», он поймёт его по-своему. Сокращённое правило — это уже другое правило под тем же именем.
Вторая идея выглядела безобиднее. Правила, которым не хватило места, мы стали присылать списком названий, вот так (формат настоящий, сами правила взяты для примера):
  [MUST] Each service must own its database exclusively. … (convention/database-per-service)
    - [MUST] Fix every error you encounter
В первой строке правило с текстом, во второй одно название. Пометка MUST та же, вид тот же, отличается только отступ. В августе 2026 года мы попросили четыре сессии проверить самих себя, и выяснилось, что все четыре ссылались на правило, которого не читали. Одна прочитала его и обнаружила, что её случай оно не покрывает, другая — что оно вообще о другом. Ещё три сессии по нескольку часов заново выводили принцип, который дословно был записан в правиле, просто до них оно не доехало. Причём одни названия съедали две трети места, отведённого на правила в одном промпте.
Теперь правило приходит только целиком. Экономить можно лишь на отборе, на том, какие правила везти сейчас. А если какие-то не поместились, вместо них агент получает одну строку, и названий в ней нет:
!! 15 more project rules exist and were NOT delivered (7 of them MUST). Their names are
deliberately not listed: a name is not a rule, and acting on one is acting on nothing.
If anything outside the rules above could bear on what you are doing, read the rulebook
with list_conventions().
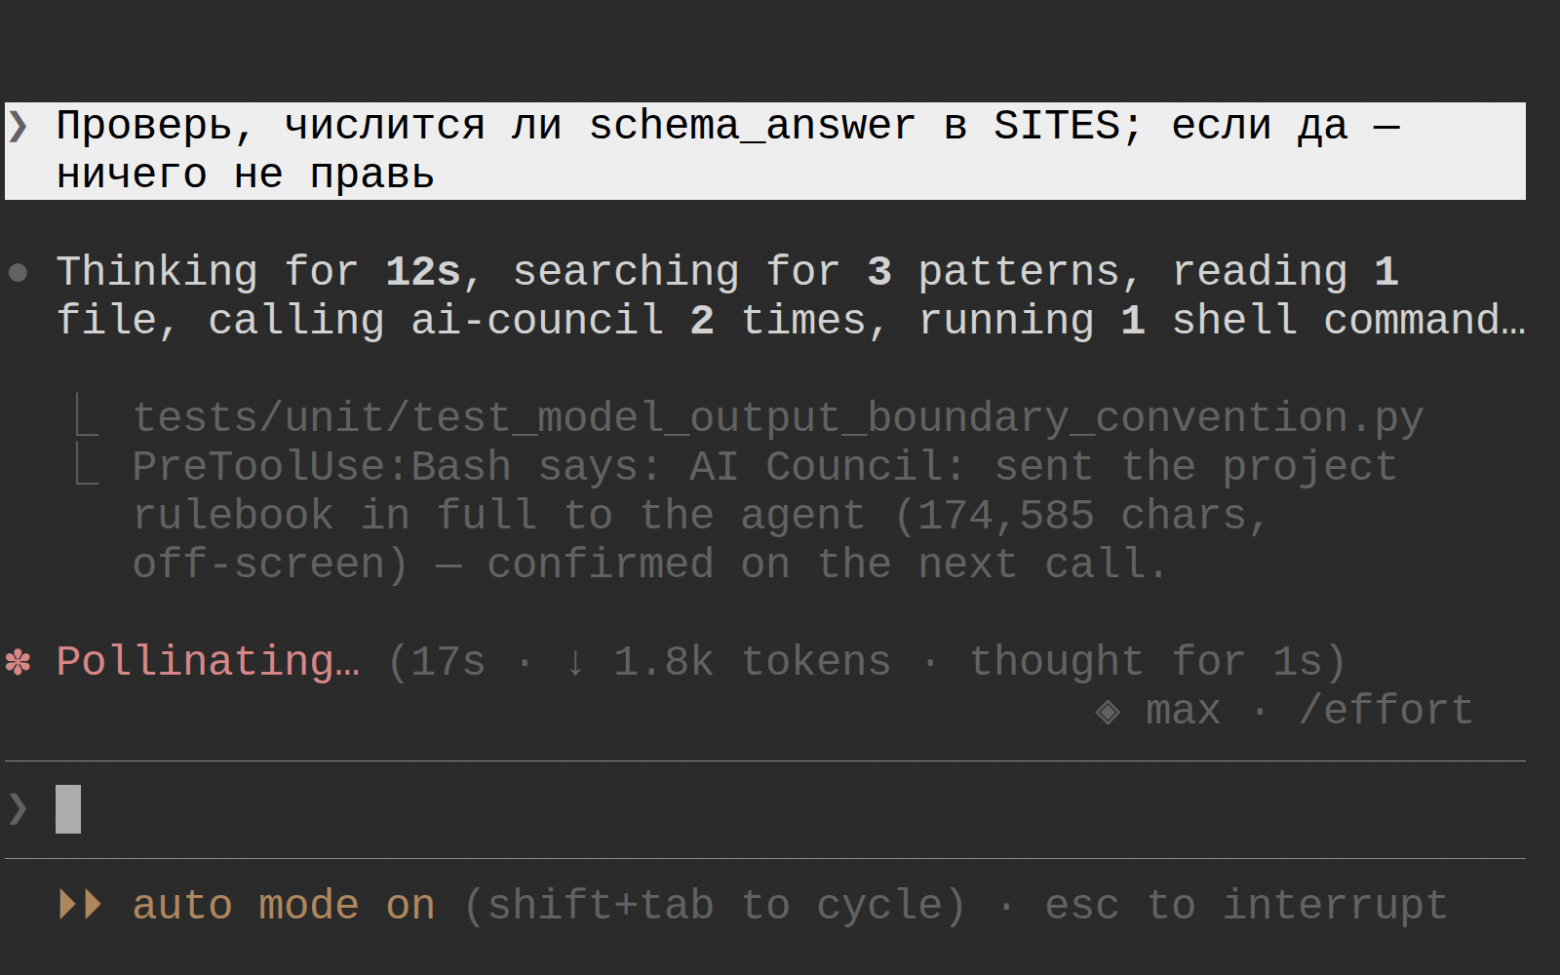
Свод правил уровня проекта агент получает перед первым же действием. Выглядит это так: первый вызов инструмента отклоняется, текст приходит вместе с отказом, и агент повторяет попытку. Свод у нас занимает около 175 тысяч символов. Дальше правила идут по кругу, по нескольку штук за раз, и полный оборот растягивается на десятки промптов, так что нужное сейчас правило может прийти не сразу. Поэтому правила для конкретного файла идут отдельным путём, по привязкам: они приходят, когда агент этот файл открывает.
3. Знание живёт на ветках git
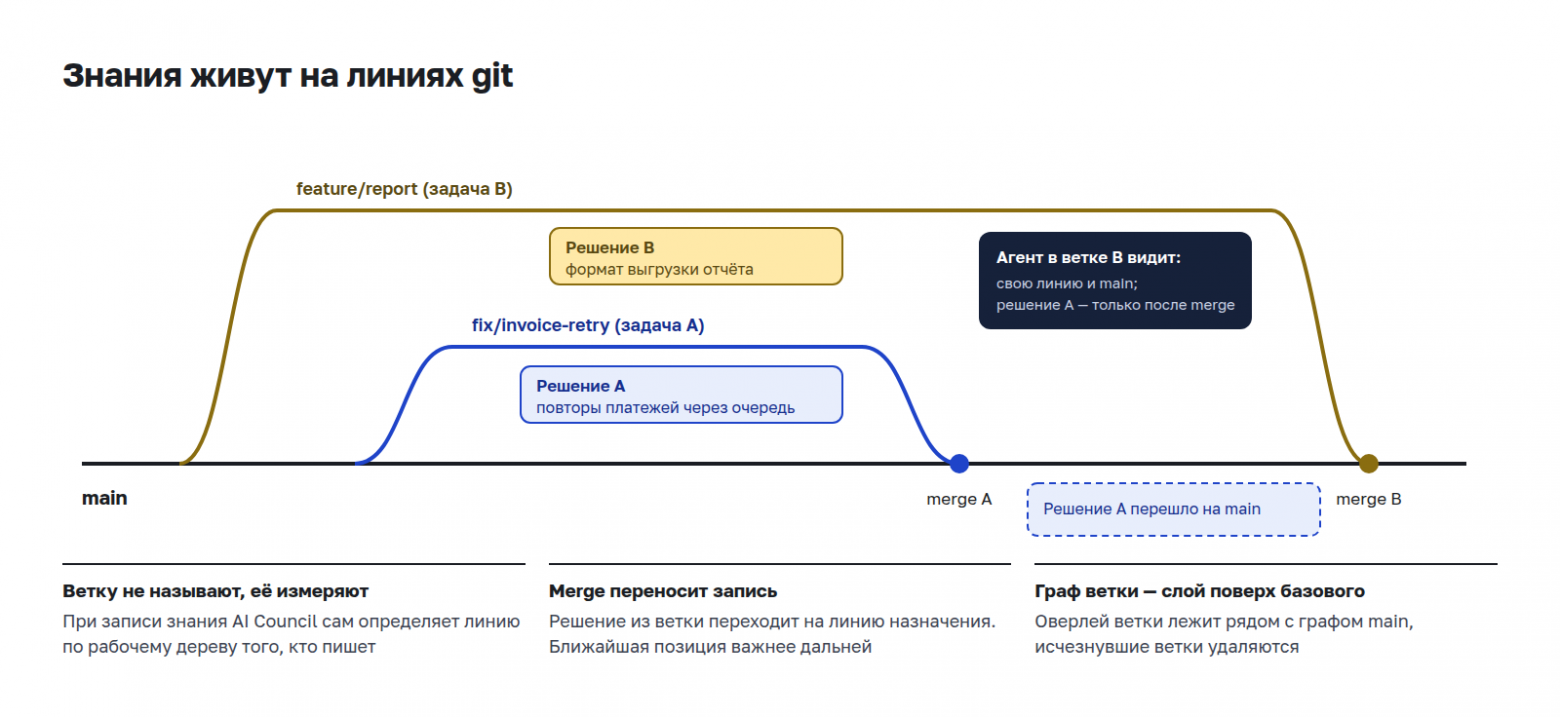
Запись, написанная на ветке, может быть неверна для main, и наоборот, ведь она описывает код, которого в другой ветке ещё нет. Поэтому каждая запись живёт там, где её написали, а граф кода для каждой ветки дополняется своим слоем поверх базового.
Называть ветку агенту не нужно ни при записи, ни при чтении. AI Council определяет её сам, по рабочей копии, из которой пришёл запрос. Почему так, он объясняет агенту прямо в ответе на сохранение записи:
<branch_derived branch="stable" … source="git in your working tree — you were not asked,
  and cannot be: a branch stated from memory was wrong nine times in ten"/>
Агент видит записи своей линии, то есть своей ветки, той, от которой она ответвилась, и всего, что в них успели слить. Записи соседних веток ему не видны, так что пять агентов в пяти ветках не натыкаются на недоделанные решения друг друга. Бывает, что одну и ту же запись в одной ветке уже пометили устаревшей, а в другой ещё нет (о метках речь в следующем разделе). Тогда агент получает её такой, какой она выглядит в ближайшей к нему ветке. Ближайшей по истории, а не по времени: сначала своя, потом родительская. На время мы смотрим, только если расстояние одинаковое.
Когда ветку сливают, её записи сами становятся видны в целевой, потому что видимость считается по истории git и отдельного шага «перенести знания» нет. Если ветку удалили, так и не слив, её записи не пропадают, а уходят в архив.
А вот правила по веткам не делятся, они общие для всего проекта. Правило ведь говорит о том, каким код должен быть, а не о том, каков он сейчас.
4. Знание проверяется на актуальность
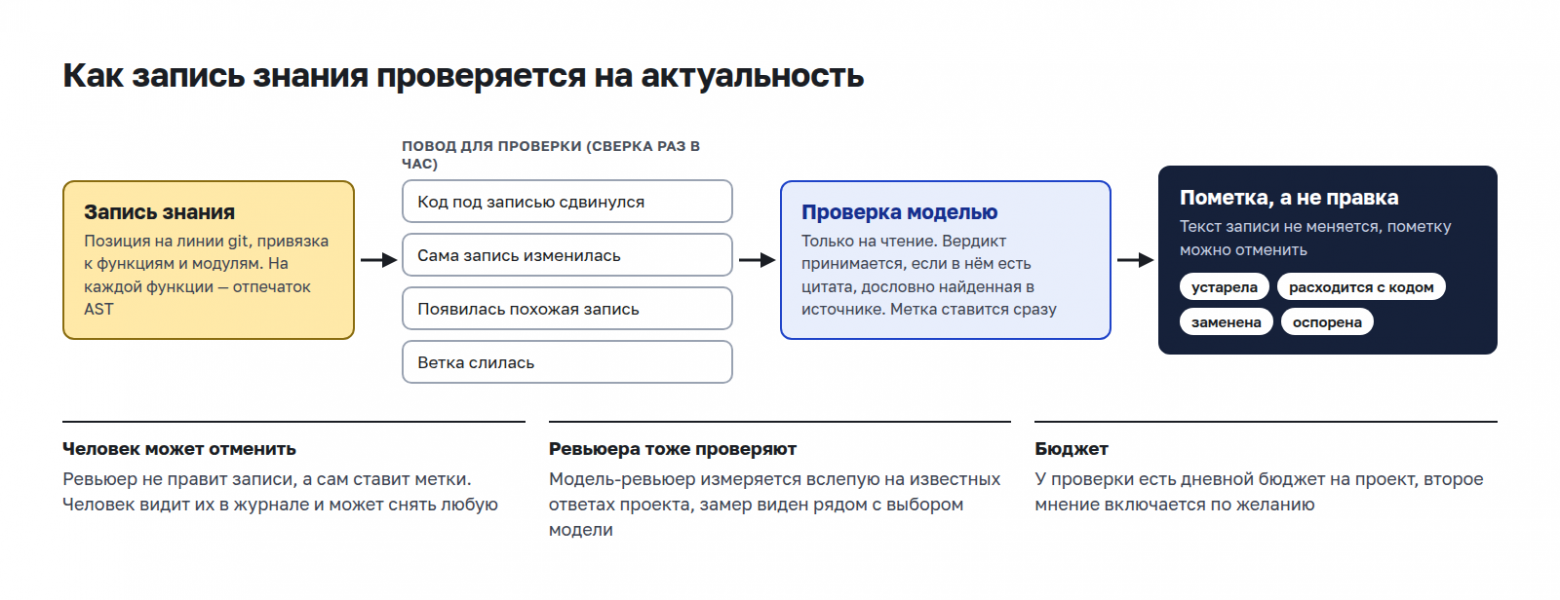
Такого мы у других баз знаний не нашли. Каждая запись помнит, на каком коммите её написали. Раз в час AI Council ставит запись в очередь на перепроверку, если под ней изменился код (для этого у каждой функции и класса есть отпечаток AST), если изменилась она сама, если появилась похожая запись или если слили ветку.
Отпечатки сравниваются без модели, поэтому предупреждение «код под записью изменился» агент получает сразу, вместе с записью:
[Knowledge/decision] ADR-201 (self-update.sh, …): самообновление хуков сверяет версию
при каждом старте сессии … — not shown here (4 KB); read it with get_knowledge("…")
    ⚠ This is a decision; the code under it has moved since it was checked (314d7be0):
    1 symbol(s) changed on yours — it is not re-reviewed against code, read the code yourself.
Одного предупреждения оказалось мало. Мы проверили это на стенде, правда, всего на одном кейсе и только там, где агент отвечал, не заглядывая в код. Он получал устаревшую запись с предупреждением «код изменился, проверь» и всё равно отвечал по ней, в 10 прогонах из 11, и это не лучше, чем совсем без него. С исправленной записью из 10 прогонов не было ни одного такого ответа. Столько же, ноль из 10, дала метка, где написано, что код делает сейчас. Написать такую метку сравнение отпечатков не может, поэтому записи у нас перепроверяет модель.
Занимается этим ревьюер знаний. Несмотря на название, это фоновый механизм внутри AI Council: человека за ним нет, отдельного продукта тоже. Он берёт запись из очереди, отдаёт модели её текст вместе с текущим кодом, на который она ссылается, и превращает ответ в метку. Модель при этом работает на чтение: ни в базе, ни в коде она ничего не меняет. Вердикт мы принимаем, только если в нём есть дословная цитата из источника.
Но и с цитатой модель может ошибиться, поэтому текст записи ревьюер не трогает. Он ставит метку («устарела», «расходится с кодом с такого-то коммита», «заменена», «оспорена»), и дальше агент получает запись уже с ней. Вот как выглядит метка «заменяет» у записи о маршруте тикета в нашем интерфейсе:
[Knowledge/decision] ADR-203, поправка 2026-10-20 (TicketsPage, …): тикет — это путь
/tickets/<external-id>, старый ?ticket= перенаправляется …
    Supersedes ADR-203 (…) since 52d56538: Old entry lists the ticket deep-link as
    `?ticket=N` (UI useTicketPages); new entry replaces that with the path route
    /projects/<project-id>/tickets/<external-id>, redirecting old ?ticket= links, while
    explicitly leaving the rest of ADR-203 (e.g. the :Ticket scan) unchanged.
В метке назван коммит, с которого старая запись заменена, и перечислено, что именно в ней изменилось, а что осталось верным.
Метки ставятся и начинают действовать сами, подтверждать или перечитывать их никто не обязан. Все они попадают в журнал, и там любую можно отменить. Для проекта можно включить второе мнение: тогда вердикт перепроверяется ещё раз, и если два ответа разошлись, метка не ставится, а в журнале остаётся строка с причиной. Модель-ревьюера мы тоже проверяем: вслепую, на вопросах с известными ответами, и результат показываем рядом с выбором модели.
Базу поддерживают и сами агенты. На Keycloak, например, агент заметил, что запись по тикету расходится с кодом, и дописал в неё поправку.
Ревью и модель: ещё два решения
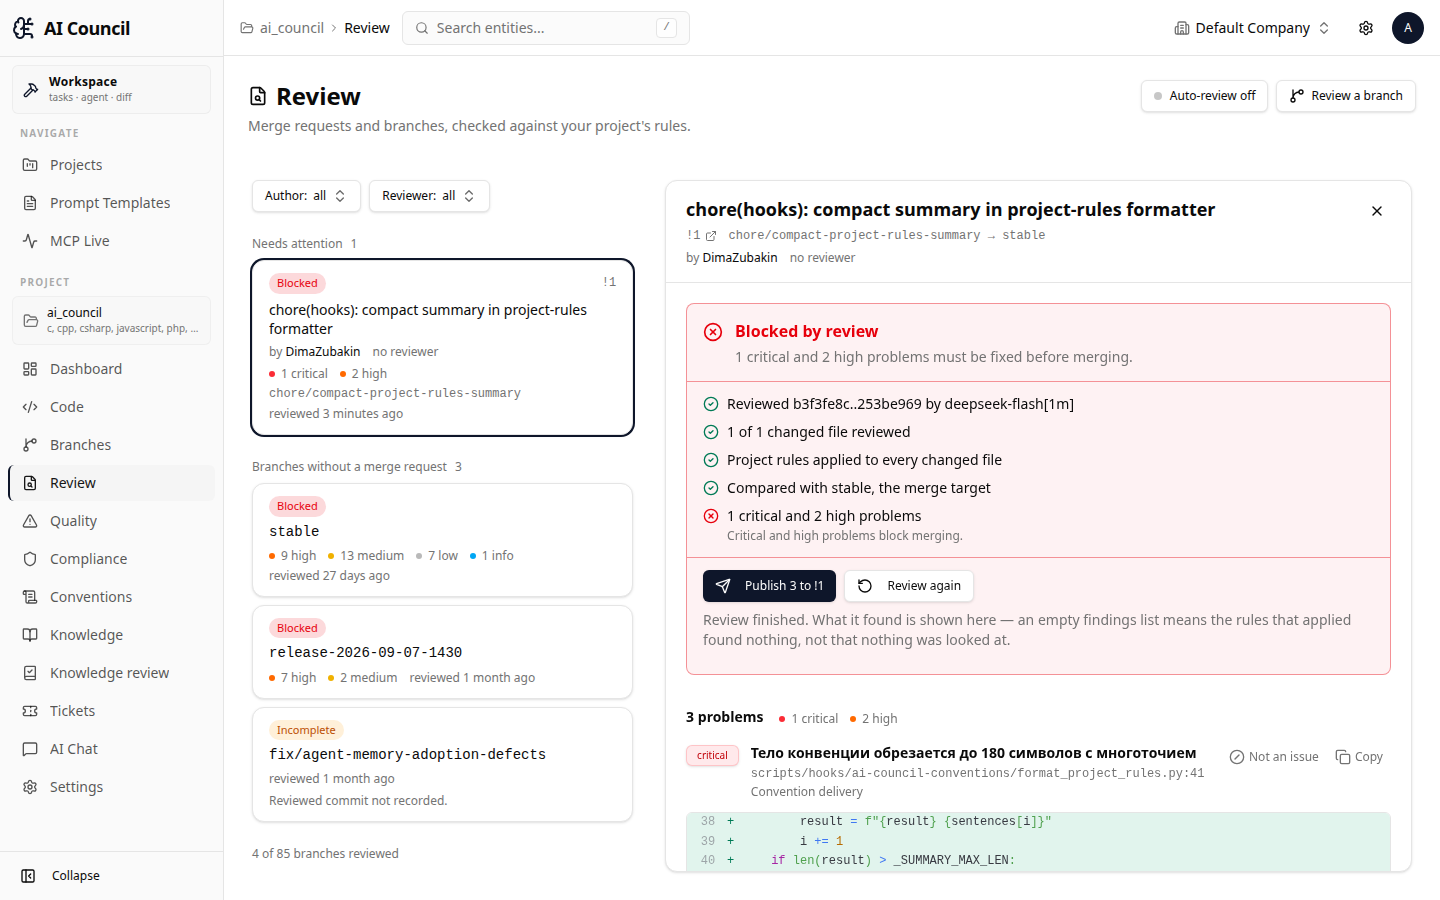
Ревью по правилам команды. Агент мог получить правило и всё равно его нарушить, поэтому готовый MR проходит машинное ревью. Оно идёт до человеческого и сверяет дифф с правилами разработки, которые агент получил перед правкой, и с правилами, написанными специально для ревью. Если какое-то нарушено, MR получает статус Blocked, с указанием правила и места. Сам статус ничего не запрещает: слить такой MR всё равно можно, а кому нужен жёсткий запрет, тот настраивает его в CI.
Чтобы статусу можно было верить, модель ограничена в двух вещах. Номеров строк она не называет, вместо этого цитирует код, и строку по цитате AI Council находит сам: в номере модель может ошибиться, и проверить его нечем, а цитату можно сверить с диффом. От ревьюера знаний из раздела 4 мы требуем того же, дословной цитаты. И по каждому файлу модель обязана сказать «проверил» или «не смог, потому что». Файл, о котором она промолчала, чистым не считается, иначе ревью, в котором модель ничего не прочитала, выглядело бы как ревью без замечаний.
На скриншоте MR из нашего репозитория: дифф обрезает текст правила до 180 символов, и ревью блокирует его по правилу из раздела 2.
Модель приносит клиент. Контекст подбирается без LLM: AI Council ничего не сочиняет, а возвращает найденные фрагменты с указанием файла, и сверяет их с кодом уже сам агент. Модель нужна в чате проекта, в ревью, при разборе тикетов и в перепроверке знаний. Во всех этих случаях это модель клиента — внешний CLI-агент под его учётной записью. Сейчас это Claude Code CLI, но через шлюз можно подключить и другую модель, в том числе open source на своих серверах. Так у нас работали Qwen и DeepSeek.
Цифры, в том числе неудобные
Наш проект: откуда берутся знания и правила
AI Council мы разрабатываем с помощью самого AI Council, поэтому полнее всего у нас данные по собственному репозиторию. В нём больше пяти тысяч файлов и около 50 тысяч функций, а поверх этого кода лежит около трёх тысяч записей знаний и больше сотни правил.
Вид записи | Доля | Откуда берётся |
|---|---|---|
Решения с причинами | чуть больше 40% | Записываются, когда решение принято: что выбрали, от чего отказались и почему |
Заметки | чуть больше 40% | Разборы подсистем, дефектов и замеров, появляются по ходу задач |
Журналы изменений | около 10% | Что сделано в задаче и зачем |
Схемы | около 5% | Диаграммы потоков и структуры в Mermaid |
Записи пишут и люди, и агенты. Агент делает это в конце задачи, так требует одно из наших правил: работа с кодом должна оставлять след в базе. Сколько записей приходится на тех и на других, мы не считали.
Почти у каждого правила есть случай, после которого оно появилось. Правило о доставке целиком, например, выросло из истории с четырьмя сессиями, которую мы рассказали в разделе 2. Поэтому начинать с сотни правил не нужно. Общие правила, которые годятся любому коду, AI Council заводит в новом проекте сам, а своих команда на старте обычно пишет от 5 до 10: те, что нарушают чаще всего. Остальные добавляются по ходу работы. Предложить новое правило может и агент, но вводится оно только с согласия человека.
Всё, что AI Council приносит агенту, занимает место в его контексте. По замеру за 30 дней на одной машине это 46% контекста на нашем проекте и от 20 до 30% на других. Чистой надбавкой эту долю считать нельзя: часть агент и так прочитал бы в коде сам. Во что доставка обходится в деньгах, показывает прямое сравнение ниже.
Что делают агенты на самом деле
Это телеметрия нашего прода за всё время наблюдений, снимок от 20 октября 2026 года, всего 12 241 сессия агентов. Сессией мы здесь называем строку телеметрии, а один разговор иногда даёт две такие строки, поэтому смотреть лучше на доли. Действия считаются независимо друг от друга: в каждой строке таблицы — доля сессий, где агент сделал это хотя бы раз.
Что агент сделал в сессии | Что считаем | Сессий | Доля |
|---|---|---|---|
Сам собрал контекст проекта | Вызвал поиск по коду, обзор архитектуры или зависимостей, сводку по файлу, чтение записи знаний или вопрос к базе | 6 938 | 57% |
Правил код | Хук зафиксировал хотя бы одну правку файла | 4 436 | 36% |
Сам вызвал проверку правил | Вызвал инструмент, который отдаёт правила для файла, или поиск похожих реализаций | 1 919 | 16% |
Вызвал проверку правил до первой правки | То же, но раньше первой правки; считаем от сессий с правками | 584 из 4 436 | 13% |
Сам записал знание в базу | Вызвал запись в базу знаний | 2 731 | 22% |
Подвёл итоги | Вызвал инструменты «обдумать последствия изменения» или «подвести итог и сохранить» | 23 | 0,2% |
Код агент правит примерно в трети сессий, в остальных он отвечает на вопросы, что-то исследует или проверяет. За контекстом он сам ходит больше чем в половине, то есть искать не ленится, а вот правила запрашивает редко. Для нас это главный довод в пользу доставки системой: чего агент не ищет, того он без неё не получит.
Тут напрашивается возражение. Замер сделан при работающих хуках, так что агент, возможно, потому и не вызывал проверку, что правила пришли к нему сами. Периода без хуков у нас в телеметрии нет, они стоят с первого дня, поэтому мы сравнили между собой сессии с правками. В тех, где хук при открытии файлов ничего не принёс, агент сам вызвал проверку правил в 46% сессий, а до первой правки в 20%. В тех, где хук правила принёс, получилось 55% и 22%. Выходит, доставка правил не отучает агента спрашивать, а скорее напоминает ему, что правила есть.
Доли тут выше, чем в таблице, потому что группа другая: в неё вошли сессии с правками и с хуками, причём начиная с 18 августа, когда событие доставки появилось в телеметрии. Поэтому сравнивать эти числа стоит только друг с другом. И одного мы отделить не можем: свод правил в начале работы и повтор по кругу приходят во все сессии.
Записывает знания агент чаще, чем запрашивает правила: в 22% сессий против 16%. Мы думаем, дело в напоминании, потому что о записи ему при каждом промпте говорит хук. Про инструменты подведения итогов ему не напоминает никто, вот там и остаётся 0,2%. За 30 дней агенты сделали 12 600 вызовов инструментов AI Council, но 15 инструментов из 61 не вызвали ни разу. Какие-то из них мы сделали зря, какие-то плохо описали.
Прямое сравнение: с AI Council и без
Всё, что было выше, — это наблюдения за агентами, у которых AI Council уже есть. Напрямую варианты «с ним» и «без него» мы сравнили в конце октября и начале ноября 2026 года, на Keycloak.
Один и тот же агент (Claude Code, одна модель, одни настройки, одна виртуальная машина) дважды выполнил подряд семь задач, один раз без AI Council и один раз с ним. Задачи такие: три небольшие по реальным тикетам GitHub, одна сразу на девять тикетов и три большие, где надо было с нуля реализовать спецификацию. Работу принимали скрытые тесты, которых агент не видел, и регрессионный набор самого Keycloak. Скрытые тесты приёмочные, они обращаются к работающему серверу как обычный клиент и сверяют его ответы с тикетом или со спецификацией. Три большие задачи мы прогнали по три раза в каждом варианте.
Что сравнили | Без AI Council | С AI Council |
|---|---|---|
Скрытые тесты и регрессия, первый прогон | Пройдены во всех семи задачах | Пройдены во всех семи задачах |
Объём продакшн-кода за семь задач | 10 410 строк | 8 584 строки, на 18% меньше |
Свои тесты агента: сколько из 14 намеренно внесённых багов они ловят (три прогона одной задачи) | 7, 9 и 13 | 14, 13 и 14 |
Слепое ревью: чей дифф взял бы ревьюер, не зная, где чей (три пары) | 0 из 3 | 3 из 3 |
Работа модели | около 495 млн токенов | около 675 млн токенов; по тарифам API в 1,3 раза дороже |
Время работы агента | 6 ч 25 мин | 7 ч 24 мин, в 1,15 раза дольше |
По скрытым тестам AI Council перевеса не дал. В первых прогонах оба варианта прошли всё. Из четырёх повторов три нарушили одно и то же требование (не менять прежнее поведение сервера), а оба повтора с AI Council к тому же пропустили от одного до трёх пунктов спецификации из 155 проверяемых. Разница нашлась там, куда обычно смотрит ревью, и вся в пользу AI Council: объём кода, собственные тесты агента и слепое сравнение диффов. Свой выбор ревьюер объяснял тестами, написанными так, как принято в Keycloak, и тем, что в документации перечислены ограничения.
Платить за это пришлось работой модели: на семь задач ушло около 675 млн токенов против 495 млн, на 36% больше. Но прибавка почти вся в чтении кэша, самом дешёвом виде токенов, потому что с каждым запросом модель заново читает накопленный контекст. Выходных токенов, самых дорогих, в обоих вариантах примерно поровну: 1,7 и 1,6 млн. Поэтому в деньгах, по тарифам API, выходит не 36%, а 30%. Чем меньше задача, тем надбавка заметнее: небольшие вышли в 2,4–3 раза дороже, а остальные четыре — от «на 20% дешевле» до «в 1,7 раза дороже».
Откуда берётся надбавка, понятно. Материал, который AI Council привёз агенту, — это 41% цены варианта с ним, и половина его — разборы тикетов. В прогонах больших задач агент получил 894 таких разбора, а сослался в работе на 11. То есть возим мы слишком много. Пригодились записи, которые совпадали с тем, чем агент был занят в конкретный момент, а совпадения с темой задачи оказалось мало. Точностью доставки мы сейчас и занимаемся.
Замер небольшой: один проект, одна модель и всего семь задач. Большие задачи написаны по спецификации, а в таких история проекта помогает меньше всего. Задачи, где без неё решение не принять, мы ещё не меряли.
Стоимость мы оценивали по тарифам API, и это только оценка: на деле всё зависит от того, как вы платите за модель. Поэтому сумм мы не приводим, только отношения. Слепой ревьюер — та же модель, которая писала оба варианта, и скрытые тесты больших задач тоже писала она, по тексту спецификаций и без эталонного решения. По безопасности перевеса нет ни у кого, пробы нашли дефекты в обоих вариантах. И наконец, замер не разделяет, что в AI Council даёт разницу: правила, записи знаний или сам порядок работы.
Почему повторы с AI Council пропустили требования спецификации, замер тоже не объясняет. У нас есть только наблюдения. О новом протоколе в базе не было ни одной записи, так что AI Council приносил агенту обычаи Keycloak, но не спецификацию. Контекст в самой крупной задаче переполнялся и сжимался только у варианта с AI Council. Отдельного ревьюера для своего кода агент без AI Council запускал в восьми прогонах больших задач из девяти, а с ним — в одном. И ещё чек-лист завершения, который хук присылает в конце ответа, в этом замере до агента не доходил, это был наш дефект. Подробный разбор замера выйдет отдельной статьёй.
Чего мы не измеряли совсем, так это влияния AI Council на людей. По своим проектам мы видим, что новому разработчику легче войти в проект, когда на вопрос «почему так» ему отвечает база и не приходится дёргать старшего коллегу.
Когда без AI Council можно обойтись
Проект небольшой, правила помещаются на пару экранов CLAUDE.md, над кодом работают один-два человека.
Задачи идут одна за другой, параллельных веток у агентов нет.
Задачи мелкие и самодостаточные, всё нужное для правки видно в самом коде. В нашем сравнении на таких задачах оба варианта прошли тесты, а надбавка к цене оказалась самой большой.
Вам нужен только быстрый поиск по коду. С этим справятся Serena или claude-context.
Вам нужна только проверка готовых PR. Для этого есть сервисы ИИ-ревью.
Смысл в AI Council появляется, когда сходятся три условия: команда, legacy и несколько агентов одновременно. Вот тогда непонимание проекта начинает стоить дорого. Это недели, которые компания оплачивает новому разработчику, пока он вникает, часы старших коллег, которые ему всё объясняют, постановки задач, в которых агенту раз за разом пересказывают одно и то же, и ревью, где ловят то, что агент мог знать заранее. На таком фоне лишние 30% к цене работы модели выглядят небольшими, но платить их придётся: экономии на самой модели наш замер не показал.
Итог
Структуру кода агенту сегодня дают многие инструменты, и часть из них бесплатна. Сложнее с тем, чего в коде нет: с решениями «почему», с правилами команды и со временем. Такое знание должно доходить до агента без его просьбы, потому что сам он до первой правки сверяется с правилами в одной сессии из восьми. Ещё оно должно оставаться верным после очередного коммита и не смешиваться между ветками.
В прямом сравнении на приёмочных тестах AI Council выигрыша не дал. Но код с ним проще принять на ревью: его меньше, он лучше защищён собственными тестами и ближе к обычаям проекта. Работа модели при этом обошлась на 30% дороже, причём половина цены доставки ушла на разборы тикетов, а из 894, полученных в больших задачах, агент сослался на 11.
Агент по-прежнему каждый день выходит на работу впервые, этого мы не изменили. Зато теперь на рабочем месте его ждёт не голый код, а решения и правила команды. Осталось научиться выдавать ему ровно то, что нужно для сегодняшней задачи, и ничего лишнего.
Если захотите проверить подход на своём проекте, у нас есть пилот на 60 дней, бесплатный и на вашем репозитории.
А как вы передаёте агенту решения команды, которых нет в коде? Особенно интересно послушать тех, у кого несколько агентов работают в разных ветках.

Комментарии 0