❯ Контекст
В предыдущих статьях я уже рассказывал о своей домашней инфраструктуре ServeHub-2. Это проект, который позволяет развернуть окружение из двух серверов: VPS и домашнего сервера, объединённых в общую закрытую сеть.
У каждого узла своя роль. Edge (VPS) отвечает за сетевую инфраструктуру, DNS-фильтрацию, мониторинг и служебные компоненты. Workload (домашний сервер) используется для размещения пользовательских приложений, баз данных и личных файлов. Далее я буду использовать названия Edge и Workload для обозначения этих серверов.
Когда инфраструктура состоит из нескольких серверов и множества контейнеров, проверять каждый узел вручную становится неудобно. Для диагностики приходится подключаться по SSH, проверять состояние контейнеров и просматривать журналы. Кроме того, ручная диагностика ненадёжна: можно легко пропустить кратковременные сбои.
Поэтому я решил собрать единую систему наблюдения, которая собирает метрики с обоих серверов, централизованно хранит Docker-логи, проверяет доступность основных сервисов и отправляет уведомления о проблемах.
В этой статье разберу архитектуру своего решения, роль каждого компонента, конфигурацию Prometheus и Grafana Alloy, сбор логов в Loki, правила алертинга и доставку уведомлений в Telegram.
❯ Что входит в систему
Prometheus — собирает и хранит метрики, а также вычисляет правила алертинга.
Node Exporter — отдаёт метрики операционной системы.
cAdvisor — собирает метрики Docker-контейнеров.
Blackbox Exporter — проверяет доступность HTTP(S)-адресов и срок действия TLS-сертификата.
Grafana Alloy — обнаруживает Docker-контейнеры и отправляет их журналы в Loki.
Loki — централизованно хранит логи.
Grafana — предоставляет интерфейс для просмотра метрик и логов.
Alertmanager — группирует уведомления Prometheus и отправляет их в Telegram.
Дополнительно в мониторинг включены экспортёры Nginx и AdGuard Home, а также метрики wg-easy.
❯ Архитектура
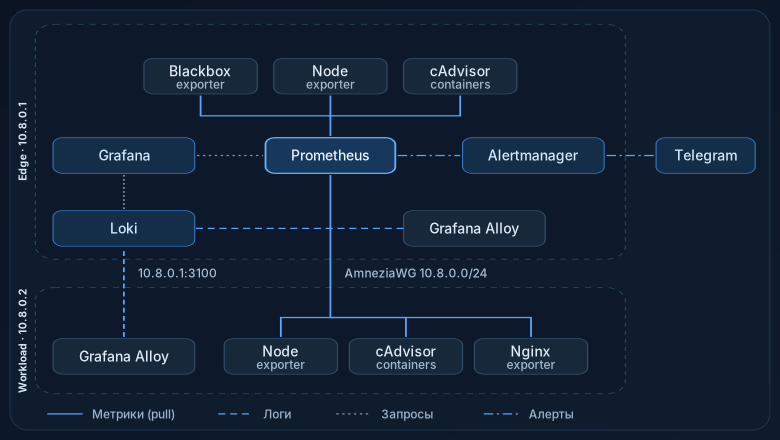
Edge / VPS — 10.8.0.1. Здесь расположена центральная часть системы: Prometheus, Grafana, Loki, Alertmanager и Blackbox Exporter. На этом же сервере работают Node Exporter, cAdvisor и экспортёр AdGuard Home. Кроме того, Prometheus может получать метрики wg-easy.
Workload / домашний сервер — 10.8.0.2. На нём установлены Node Exporter и cAdvisor. Отдельный Nginx Exporter собирает статистику веб-сервера, а Grafana Alloy обнаруживает контейнеры и передаёт их журналы на Edge.
Связь между узлами организована через внутреннюю подсеть 10.8.0.0/24. Prometheus опрашивает экспортёры напрямую по внутренним адресам. Это pull-модель: сервер мониторинга сам периодически обращается к целям и забирает метрики.
Для передачи логов используется другая модель. Alloy работает на каждом узле и отправляет записи в Loki — это push-модель. На Edge данные передаются по внутренней Docker-сети, а с Workload — на адрес 10.8.0.1:3100 через защищённое соединение между серверами.
Grafana подключена сразу к двум источникам данных: Prometheus и Loki. Благодаря этому метрики и журналы можно анализировать из одного интерфейса. Alertmanager получает события от Prometheus и отвечает за их доставку в Telegram.
Веб-интерфейсы Prometheus, Grafana и Alertmanager доступны через Nginx на Workload. В конфигурации виртуальных хостов доступ разрешён только с loopback-интерфейса и из внутренней подсети 10.8.0.0/24. Сами сервисы мониторинга также привязаны к внутреннему адресу Edge, а не к публичному интерфейсу.
❯ Сбор метрик с серверов и контейнеров
❯ Node Exporter
Для контроля состояния операционной системы на обоих узлах используется Node Exporter. Он предоставляет Prometheus метрики загрузки CPU, использования оперативной памяти, файловых систем и сетевых интерфейсов.
Конфиг из docker-compose.remote.yaml:node-exporter:
image: prom/node-exporter:v1.12.1
container_name: node-exporter
logging: *default-logging
restart: unless-stopped
cap_drop:
- ALL
security_opt:
- no-new-privileges:true
read_only: true
tmpfs:
- /tmp:rw,noexec,nosuid,size=16m
network_mode: "host"
pid: "host"
volumes:
- /proc:/host/proc:ro
- /sys:/host/sys:ro
- /:/rootfs:ro
- /run/udev:/run/udev:ro
- ./apps-data/node-exporter/textfile:/textfile_collector:ro
command:
- "--web.listen-address=10.8.0.1:9100"
- "--collector.textfile.directory=/textfile_collector"
- "--path.procfs=/host/proc"
- "--path.sysfs=/host/sys"
- "--path.rootfs=/rootfs"
- "--collector.filesystem.mount-points-exclude=^/rootfs/(sys|proc|dev|host|etc|var/lib/docker)($$|/)"
deploy:
resources:
limits:
memory: 1G
depends_on:
wg-easy:
condition: service_healthyЭкспортёр запущен в host network mode и слушает только внутренний IP соответствующего сервера. На Edge это 10.8.0.1:9100, на Workload — 10.8.0.2:9100.
В конфигурации Prometheus для них определены отдельные scrape jobs:
- job_name: node-exporter-local
    static_configs:
      - targets: ["10.8.0.2:9100"]

 - job_name: node-exporter-vps
    static_configs:
      - targets: ["10.8.0.1:9100"]
❯ cAdvisor
Node Exporter показывает состояние хоста, но при работе с контейнерами этого недостаточно. Например, общая загрузка процессора может выглядеть нормальной, хотя один из контейнеров уже потребляет слишком много ресурсов.
Для наблюдения за Docker-контейнерами используется cAdvisor. Он собирает метрики CPU, памяти, файловых систем и сетевой активности контейнеров. Экземпляры cAdvisor запущены на обоих серверах и также доступны Prometheus через внутреннюю подсеть: 10.8.0.1:8090 и 10.8.0.2:8090.
В дальнейшем эти данные можно использовать для анализа конкретного контейнера, а не только общей нагрузки на сервер.
Конфиг из docker-compose.remote.yaml: cadvisor:
image: ghcr.io/google/cadvisor:0.60.6
container_name: cadvisor
logging: *default-logging
restart: unless-stopped
security_opt:
- no-new-privileges:true
read_only: true
tmpfs:
- /tmp:rw,noexec,nosuid,size=64m
network_mode: "host"
command:
- "--allow_dynamic_housekeeping=false"
- "--housekeeping_interval=2m"
- "--max_housekeeping_interval=2m"
- "--disable_metrics=referenced_memory"
- "--raw_cgroup_prefix_whitelist=/system.slice,/user.slice"
- "--listen_ip=10.8.0.1"
- "--port=8090"
volumes:
- /:/rootfs:ro
- /var/run/docker.sock:/var/run/docker.sock:ro
- /run/containerd/containerd.sock:/run/containerd/containerd.sock:ro
- /sys:/sys:ro
- /var/lib/docker/:/var/lib/docker:ro
- /dev:/dev:ro
- /sys/fs/cgroup:/sys/fs/cgroup:ro
- /sys/fs/cgroup:/cgroup:ro
healthcheck:
test: ["CMD", "wget", "--spider", "-q", "http://10.8.0.1:8090/healthz"]
interval: 30s
timeout: 10s
retries: 3
start_period: 15s
deploy:
resources:
limits:
memory: 1G
depends_on:
wg-easy:
condition: service_healthy❯ Дополнительные экспортёры
Nginx Prometheus Exporter работает на Workload и получает данные из эндпоинта stub_status Nginx. Его эндпоинт доступен по адресу 10.8.0.2:9113.
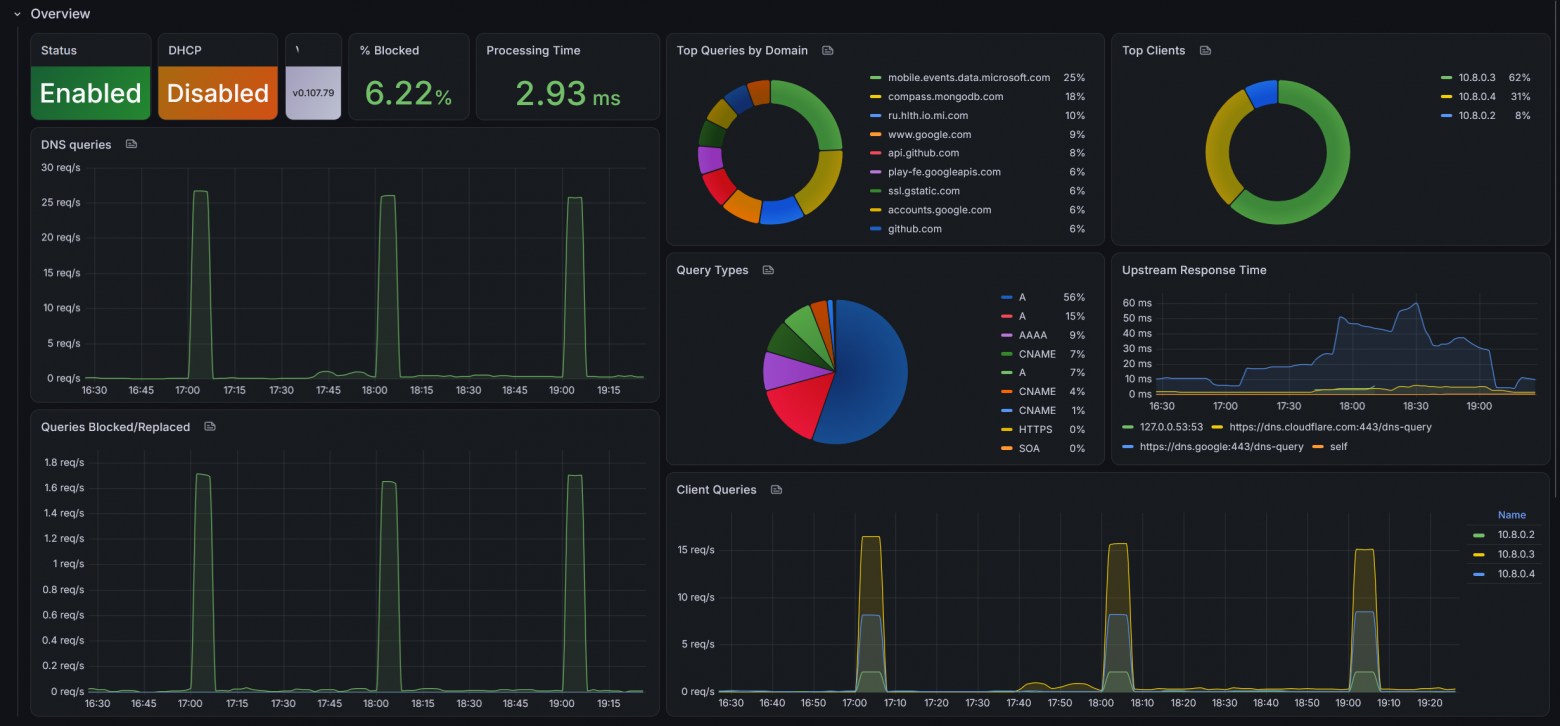
AdGuard Home Exporter работает на Edge и также предоставляет свои метрики. Prometheus забирает их с 10.8.0.1:9618.
wg-easy предоставляет собственный Prometheus endpoint на 10.8.0.1:51821/metrics/prometheus.
  nginx-exporter:
    image: nginx/nginx-prometheus-exporter:1.5.3
    container_name: nginx-exporter
    restart: unless-stopped
    cap_drop:
      - ALL
    security_opt:
      - no-new-privileges:true
    read_only: true
    tmpfs:
      - /tmp:rw,noexec,nosuid,size=16m
    logging: *default-logging
    ports:
      - "10.8.0.2:9113:9113"
    command: --nginx.scrape-uri=http://nginx:8080/stub_status
    depends_on:
      nginx:
        condition: service_healthy
      amnezia-client:
        condition: service_healthy
    deploy:
      resources:
        limits:
memory: 1Gadguard-exporter:
image: ghcr.io/henrywhitaker3/adguard-exporter:v1.2.1
container_name: adguard-exporter
restart: unless-stopped
cap_drop:
- ALL
security_opt:
- no-new-privileges:true
read_only: true
tmpfs:
- /tmp:rw,noexec,nosuid,size=16m
logging: *default-logging
ports:
- "10.8.0.1:9618:9618"
environment:
- ADGUARD_SERVERS=http://10.8.0.1:8082
- ADGUARD_USERNAMES=${ADMIN_USER}
- ADGUARD_PASSWORDS=${ADMIN_PASSWORD}
- INTERVAL=2m
depends_on:
adguardhome:
condition: service_started
wg-easy:
condition: service_healthy❯ Конфигурация Prometheus
Конфигурация Prometheus генерируется Ansible из Jinja2-шаблона ansible/templates/prometheus.yml.j2 и размещается на Edge как configs/monitoring/prometheus.generated.yml. Сам Prometheus запускается через docker-compose.remote.yaml.
prometheus.yml.j2:global:
scrape_interval: 2m
evaluation_interval: 2m
rule_files:
- /etc/prometheus/alert_rules.yml
alerting:
alertmanagers:
- static_configs:
- targets: ["10.8.0.1:9093"]
scrape_configs:
- job_name: blackbox-exporter
static_configs:
- targets: ["127.0.0.1:9115"]
- job_name: blackbox-http
scrape_interval: 5m
scrape_timeout: 15s
metrics_path: /probe
params:
module: [http_2xx]
static_configs:
- targets: ["http://10.8.0.2:8080/health-check"]
labels:
check_name: "Local server health endpoint"
- targets: ["http://10.8.0.1:9100/metrics"]
labels:
check_name: "VPS node exporter"
- targets: ["https://{{ server_name }}/"]
labels:
check_name: "Homepage"
- targets: ["https://grafana.{{ server_name }}/api/health"]
labels:
check_name: "Grafana"
- targets: ["https://hermes.{{ server_name }}/health-check"]
labels:
check_name: "Hermes Agent"
- targets: ["https://actual.{{ server_name }}/"]
labels:
check_name: "Actual Budget"
- targets: ["https://prometheus.{{ server_name }}/-/ready"]
labels:
check_name: "Prometheus"
- targets: ["https://alertmanager.{{ server_name }}/-/ready"]
labels:
check_name: "Alertmanager"
relabel_configs:
- source_labels: [__address__]
target_label: __param_target
- source_labels: [__param_target]
target_label: instance
- target_label: __address__
replacement: 127.0.0.1:9115
- job_name: blackbox-tls
scrape_interval: 1h
scrape_timeout: 15s
metrics_path: /probe
params:
module: [http_2xx]
static_configs:
- targets: ["https://grafana.{{ server_name }}/"]
labels:
check_name: "Wildcard TLS certificate"
relabel_configs:
- source_labels: [__address__]
target_label: __param_target
- source_labels: [__param_target]
target_label: instance
- target_label: __address__
replacement: 127.0.0.1:9115
- job_name: node-exporter-local
static_configs:
- targets: ["10.8.0.2:9100"]
- job_name: node-exporter-vps
static_configs:
- targets: ["10.8.0.1:9100"]
- job_name: cadvisor-local
static_configs:
- targets: ["10.8.0.2:8090"]
- job_name: cadvisor-vps
static_configs:
- targets: ["10.8.0.1:8090"]
- job_name: nginx-exporter-local
static_configs:
- targets: ["10.8.0.2:9113"]
- job_name: adguardhome-exporter
static_configs:
- targets: ["10.8.0.1:9618"]
- job_name: prometheus
static_configs:
- targets: ["10.8.0.1:9090"]
- job_name: alertmanager
static_configs:
- targets: ["10.8.0.1:9093"]
- job_name: grafana
static_configs:
- targets: ["10.8.0.1:3000"]
- job_name: loki
static_configs:
- targets: ["10.8.0.1:3100"]
- job_name: wg-easy
metrics_path: /metrics/prometheus
static_configs:
- targets: ["10.8.0.1:51821"]
Я решил установить интервалы сбора метрик и вычисления правил равными двум минутам. Возможно, такой интервал покажется довольно длинным, но для моей инфраструктуры максимальная точность не требуется.
Конфиг Prometheus в docker-compose.remote.yaml: prometheus:
image: prom/prometheus:v3.15.1
container_name: prometheus
logging: *default-logging
restart: unless-stopped
cap_drop:
- ALL
security_opt:
- no-new-privileges:true
read_only: true
tmpfs:
- /tmp:rw,noexec,nosuid,size=64m
network_mode: "host"
volumes:
- ./configs/monitoring/prometheus.generated.yml:/etc/prometheus/prometheus.yml:ro
- ./configs/monitoring/alert_rules.yml:/etc/prometheus/alert_rules.yml:ro
- ./apps-data/prometheus/data:/prometheus
command:
- "--config.file=/etc/prometheus/prometheus.yml"
- "--storage.tsdb.path=/prometheus"
- "--web.listen-address=10.8.0.1:9090"
- "--web.external-url=https://prometheus.${SERVER_NAME}/"
- "--web.route-prefix=/"
depends_on:
alertmanager:
condition: service_started
node-exporter:
condition: service_started
cadvisor:
condition: service_started
wg-easy:
condition: service_healthy
blackbox-exporter:
condition: service_started
deploy:
resources:
limits:
memory: 1G❯ Проверка доступности сервисов
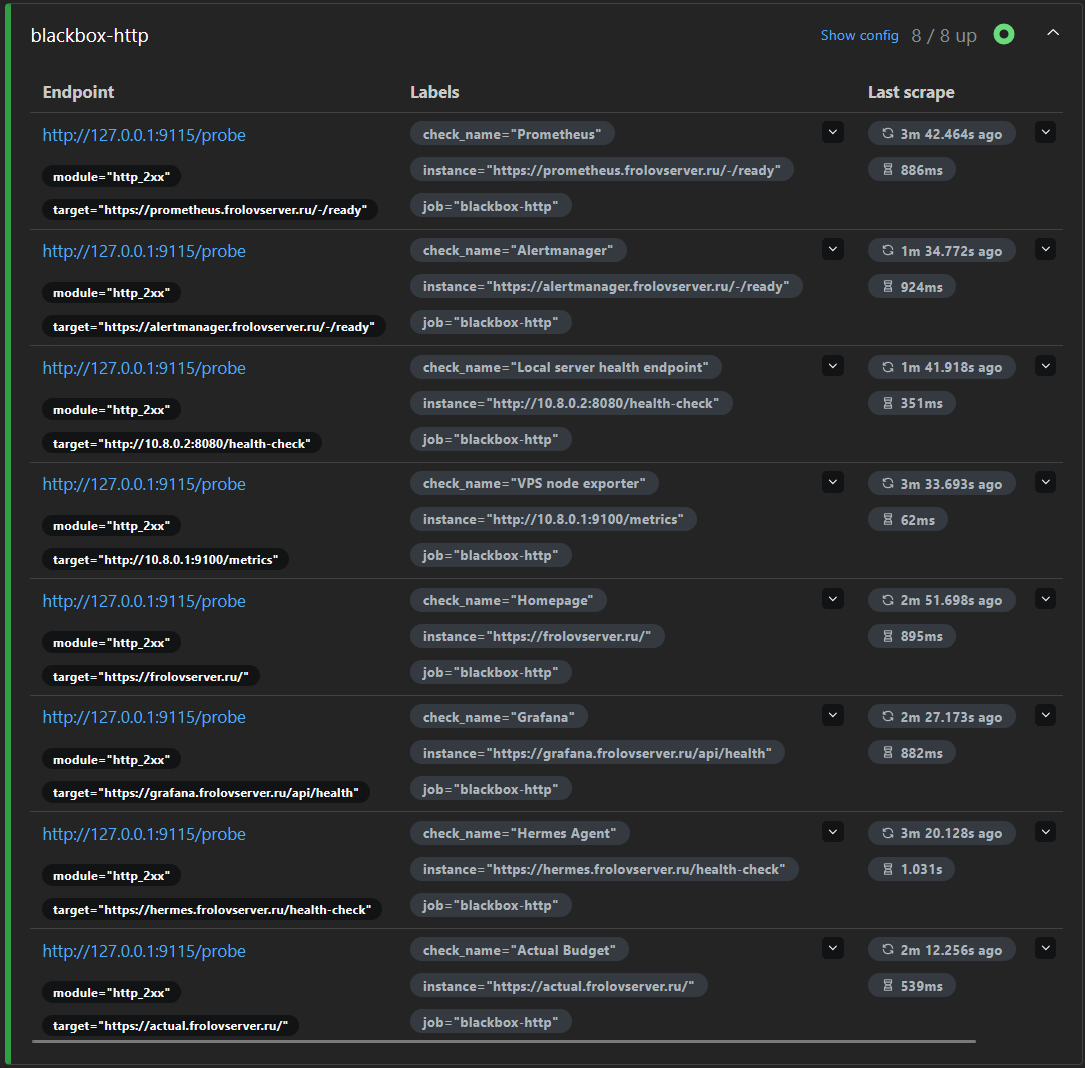
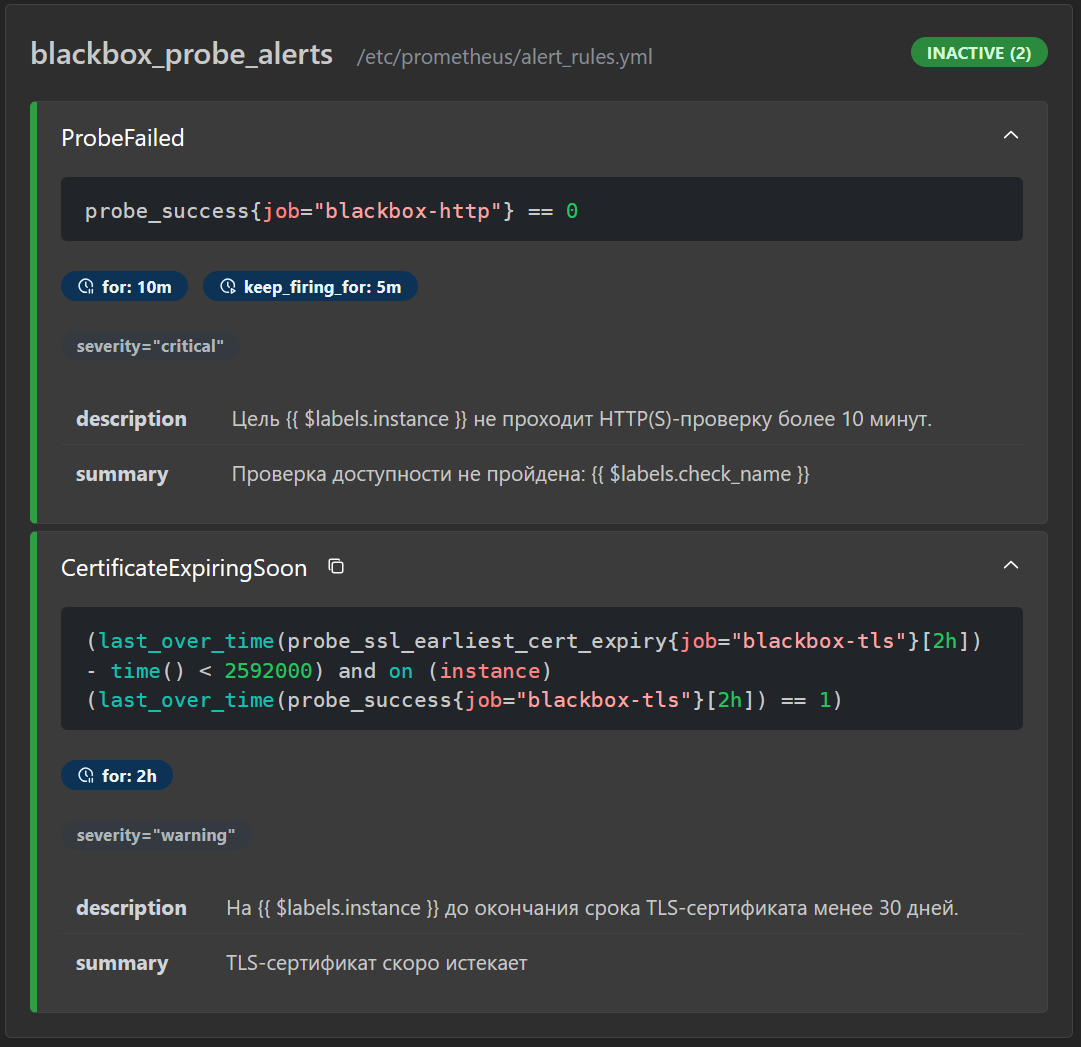
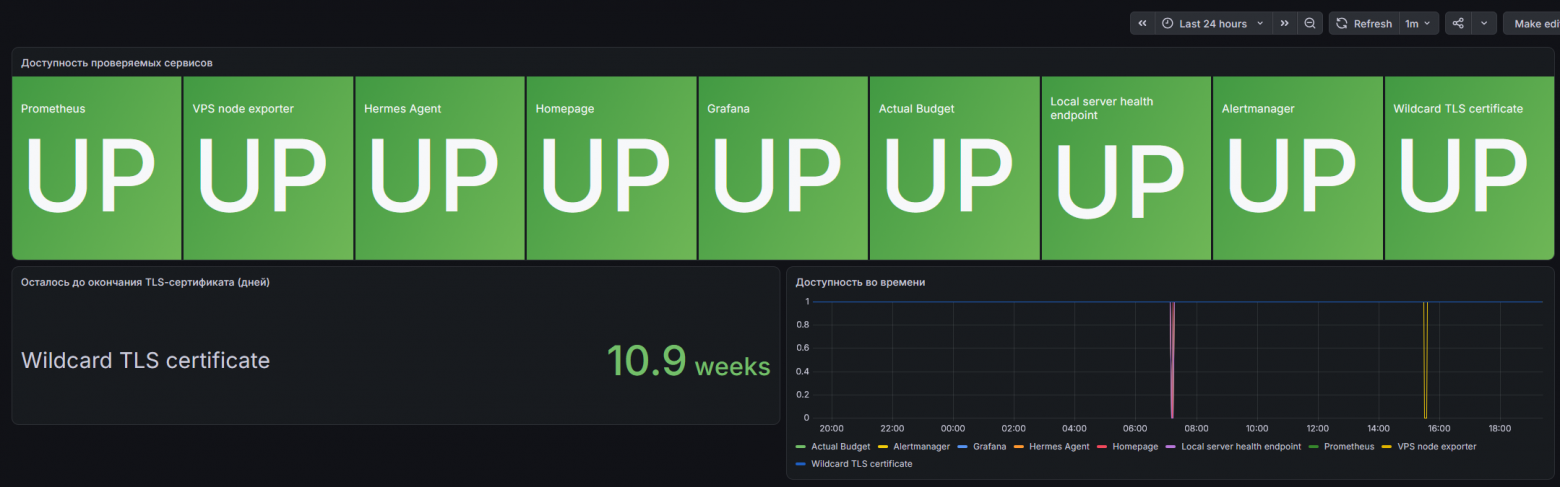
Наличие метрик ещё не означает, что приложение действительно работает. Для проверки доступности сервисов использую Blackbox Exporter. Он запущен на Edge и слушает 127.0.0.1:9115, то есть доступен локально для Prometheus, но не опубликован во внутреннюю или публичную сеть как отдельный сервис.
Prometheus передаёт Blackbox Exporter адрес проверяемой цели, а тот выполняет HTTP-запрос и возвращает результат в виде метрик. В текущей конфигурации проверяются, например:
health endpoint домашнего сервера http://10.8.0.2:8080/health-check;
endpoint Node Exporter на VPS;
Homepage;
health endpoint Grafana;
Hermes Agent;
Actual Budget;
readiness endpoints Prometheus и Alertmanager.
Сам конфиг Blackbox Exporter незамысловатый:
modules:
  http_2xx:
    prober: http
    timeout: 10s
    http:
      method: GET
      preferred_ip_protocol: ip4
      ip_protocol_fallback: false
      valid_status_codes: [200]
Проверки HTTP выполняются раз в пять минут. (можно посмотреть в prometheus.yml.j2). В конфигурации Blackbox задан единственный успешный HTTP-код — 200. Это означает, что любой другой код является неуспешной проверкой.
Отдельно я настроил проверку TLS-сертификата. Она выполняется раз в час. Если условие о том, что до окончания срока действия сертификата осталось меньше 30 дней, сохраняется в течение двух часов, Prometheus создает предупреждение.
❯ Централизованный сбор логов
Чтобы не подключаться к каждому хосту и не искать нужный контейнер вручную, для просмотра логов я использую связку Grafana Alloy и Loki.
Alloy запускается на обоих серверах. Он обнаруживает Docker-контейнеры через Docker API, получает их журналы и добавляет к записям метки. В частности, из метаданных Docker извлекаются имя контейнера и имя Compose-сервиса.
Для доступа к Docker API Alloy обращается не напрямую к сокету, а к отдельному docker-socket-proxy. В его конфигурации разрешены только необходимые группы API:
docker-socket-proxy:
    image: tecnativa/docker-socket-proxy:0.1.2
    container_name: docker-socket-proxy
    restart: unless-stopped
    logging: *default-logging
    cap_drop:
      - ALL
    security_opt:
      - no-new-privileges:true
    tmpfs:
      - /tmp:rw,noexec,nosuid,size=16m
      - /run:rw,noexec,nosuid,size=16m
      - /var/lib/haproxy:rw,noexec,nosuid,size=16m
    environment:
      - CONTAINERS=1
      - EVENTS=1
      - INFO=1
      - NETWORKS=1
      - PING=1
      - VERSION=1
      - POST=0
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
    networks:
      - docker_api
    deploy:
      resources:
        limits:
          memory: 128M
Конфигурации Alloy для двух узлов почти одинаковые. Отличаются они лишь метками сервера и адресом Loki, поэтому для понимания приведу только локальный конфиг configs/alloy/local.alloy:
discovery.docker "local_containers" {
  host             = "tcp://docker-socket-proxy:2375"
  refresh_interval = "2m"
}

discovery.relabel "docker_logs_relabel" {
  targets = []

  rule {
    source_labels = ["__meta_docker_container_name"]
    regex         = "/(.*)"
    target_label  = "container_name"
  }

  rule {
    source_labels = ["__meta_docker_container_label_com_docker_compose_service"]
    target_label  = "service_name"
  }
}

loki.source.docker "docker_logs" {
  host    = "tcp://docker-socket-proxy:2375"
  targets = discovery.docker.local_containers.targets

  labels = {
    "server"   = "local-minipc",
    "instance" = "local-minipc",
  }

  relabel_rules = discovery.relabel.docker_logs_relabel.rules

  forward_to = [loki.write.loki_storage.receiver]
}

loki.write "loki_storage" {
  endpoint {
    url        = "http://10.8.0.1:3100/loki/api/v1/push"
    batch_wait = "10s"
    batch_size = "1MiB"
  }
}
На Edge в configs/alloy/remote.alloy используются метки remote-ubuntu, а адрес Loki указан как http://loki:3100/loki/api/v1/push, поскольку оба контейнера находятся в одной Docker-сети.
В результате логи с обоих серверов попадают в один Loki, но остаются различимыми по меткам server, container_name и service_name. В Grafana можно отфильтровать записи по конкретному узлу или Compose-сервису.
❯ Хранение логов в Loki
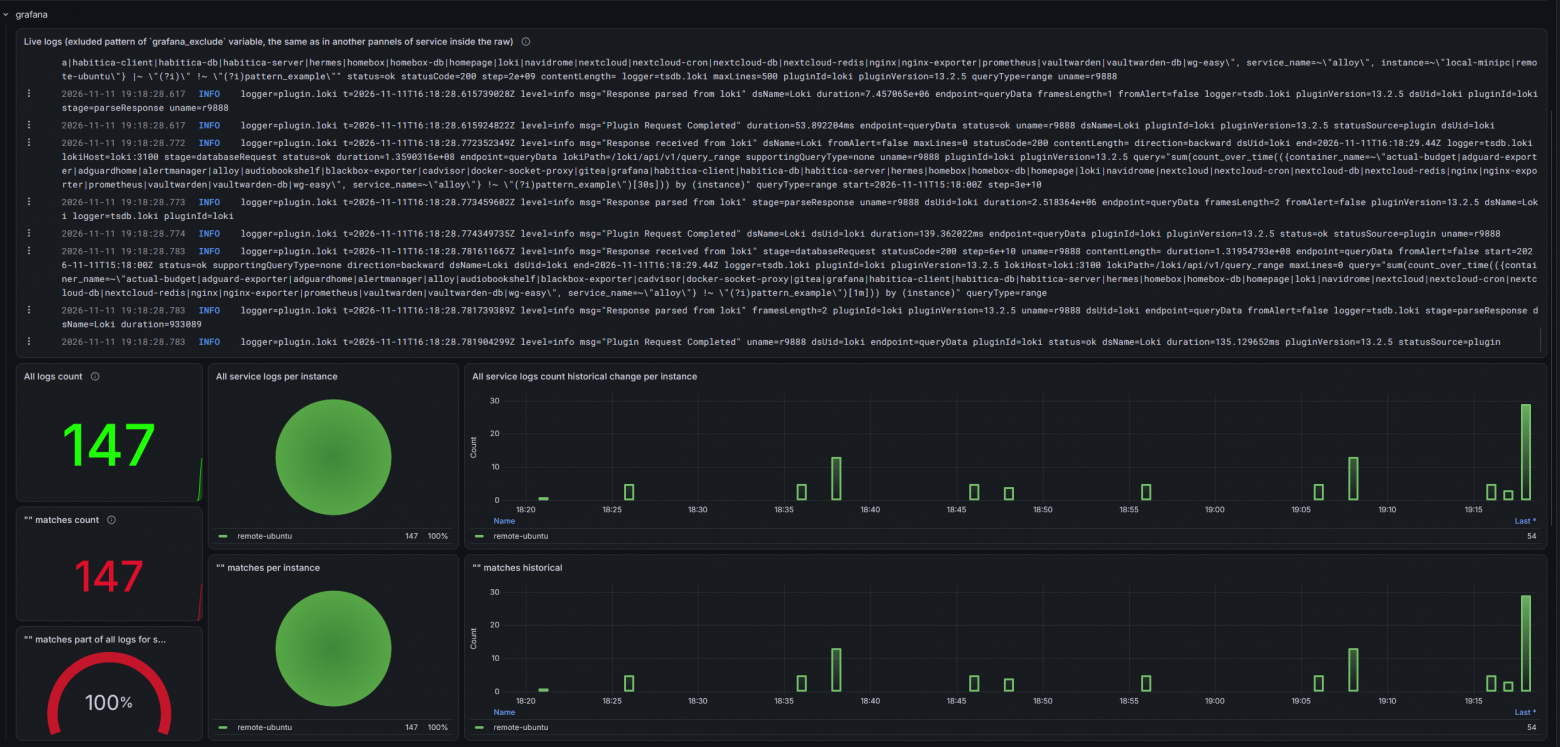
Loki работает на Edge. Данные размещаются в постоянном каталоге apps-data/loki. В конфигурации установлен срок хранения 30 дней (для домашней инфраструктуры такого времени более чем достаточно).
loki-config.yamlauth_enabled: false
server:
http_listen_port: 3100
grpc_listen_port: 9096
common:
instance_addr: 127.0.0.1
path_prefix: /loki
storage:
filesystem:
chunks_directory: /loki/chunks
rules_directory: /loki/rules
replication_factor: 1
ring:
kvstore:
store: inmemory
schema_config:
configs:
- from: 2024-01-01
store: tsdb
object_store: filesystem
schema: v13
index:
prefix: index_
period: 24h
limits_config:
allow_structured_metadata: true
reject_old_samples: true
reject_old_samples_max_age: 168h
retention_period: 30d
compactor:
working_directory: /loki/compactor
compaction_interval: 10m
retention_enabled: true
delete_request_store: filesystem
retention_delete_delay: 2h
retention_delete_worker_count: 150
analytics:
reporting_enabled: false❯ Дашборды в Grafana
Grafana выступает единой точкой просмотра данных. В качестве источников данных автоматически подключаются Prometheus и Loki. Адрес Prometheus — http://10.8.0.1:9090, Loki доступен Grafana по внутреннему адресу http://loki:3100.
Дашборды хранятся в репозитории в формате JSON и автоматически загружаются через provisioning. Для всех основных сервисов подготовлены отдельные дашборды.
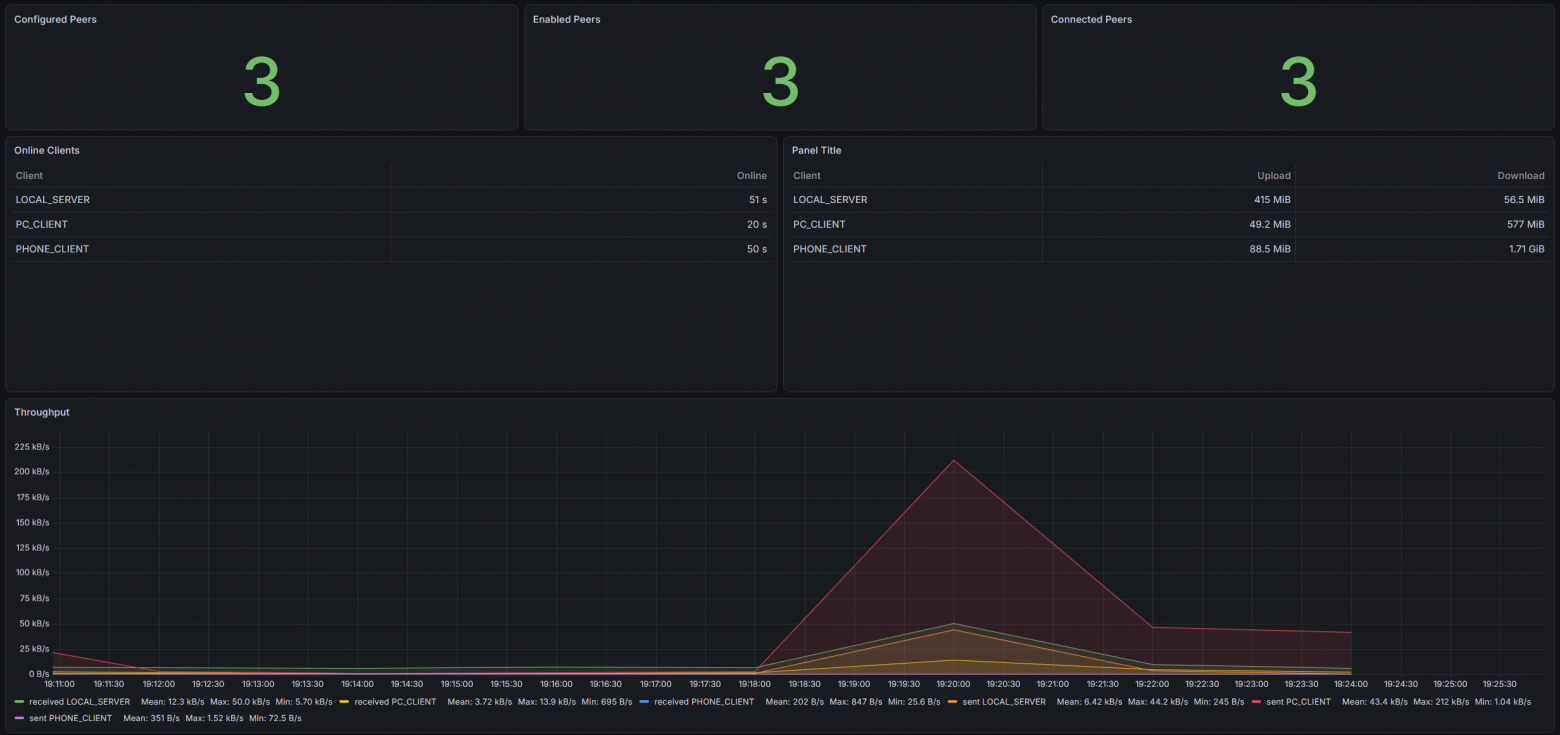
Ниже — несколько скриншотов дашбордов:
❯ Алертинг и уведомления в Telegram
Дашборды полезны, когда я сам открываю Grafana. Однако система мониторинга должна сообщать о проблемах и без ручной проверки.
Для этого используются правила Prometheus и Alertmanager. Prometheus вычисляет условия, описанные в configs/monitoring/alert_rules.yml, а при срабатывании передаёт событие в Alertmanager:
alert_rules.ymlgroups:
- name: blackbox_probe_alerts
rules:
- alert: ProbeFailed
expr: probe_success{job="blackbox-http"} == 0
for: 10m
keep_firing_for: 5m
labels:
severity: critical
annotations:
summary: "Проверка доступности не пройдена: {{ $labels.check_name }}"
description: "Цель {{ $labels.instance }} не проходит HTTP(S)-проверку более 10 минут."
- alert: CertificateExpiringSoon
expr: |
(
last_over_time(
probe_ssl_earliest_cert_expiry{job="blackbox-tls"}[2h]
) - time() < 2592000
)
and on(instance)
(
last_over_time(probe_success{job="blackbox-tls"}[2h]) == 1
)
for: 2h
labels:
severity: warning
annotations:
summary: "TLS-сертификат скоро истекает"
description: "На {{ $labels.instance }} до окончания срока TLS-сертификата менее 30 дней."
- name: container_alerts
rules:
- alert: ContainerDown
expr: time() - container_last_seen{name!=""} > 300
for: 2m
labels:
severity: critical
annotations:
summary: "Контейнер {{ $labels.name }} не обновляет метрику cAdvisor"
description: "Метрика cAdvisor для контейнера {{ $labels.name }} не обновлялась более 5 минут."
- name: exporter_alerts
rules:
- alert: ExporterDown
expr: up{job=~"node-exporter-.*|cadvisor-.*|nginx-exporter-.*|adguardhome-exporter|blackbox-exporter"} == 0
for: 5m
labels:
severity: critical
annotations:
summary: "Экспортёр {{ $labels.job }} недоступен"
description: "Цель {{ $labels.instance }} не отвечает более 5 минут."
- name: critical_target_alerts
rules:
- alert: CriticalTargetDown
expr: up{job=~"prometheus|alertmanager|grafana|loki|wg-easy"} == 0
for: 5m
labels:
severity: critical
annotations:
summary: "Критичная цель {{ $labels.job }} недоступна"
description: "Цель {{ $labels.instance }} не отвечает более 5 минут."
- name: host_alerts
rules:
- alert: HighCpuUsage
expr: 100 - (avg by(instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 90
for: 5m
labels:
severity: warning
annotations:
summary: "Высокая нагрузка на CPU"
description: "Нагрузка на CPU сервера превышает 90% (текущее значение: {{ $value | printf \"%.2f\" }}%)."
- alert: LowMemory
expr: (node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) * 100 < 10
for: 5m
labels:
severity: warning
annotations:
summary: "Мало оперативной памяти"
description: "Доступно менее 10% оперативной памяти (текущее значение: {{ $value | printf \"%.2f\" }}%)."
- name: disk_alerts
rules:
- alert: LowDiskSpace
expr: (node_filesystem_size_bytes - node_filesystem_free_bytes) / node_filesystem_size_bytes * 100 > 85
for: 10m
labels:
severity: warning
annotations:
summary: "Заканчивается место на диске"
description: "Диск заполнен более чем на 85% (текущее значение: {{ $value | printf \"%.2f\" }}%)."
- name: borgmatic_alerts
rules:
- alert: BorgmaticBackupFailed
expr: servehub_borgmatic_backup_last_run_success == 0
for: 5m
labels:
severity: critical
annotations:
summary: "Последний запуск Borgmatic завершился ошибкой"
description: "Проверь журнал резервного копирования на {{ $labels.instance }}."
- alert: BorgmaticBackupTooOld
expr: |
(time() - servehub_borgmatic_backup_last_success_timestamp_seconds > 108000)
and on(instance) (servehub_borgmatic_backup_last_success_timestamp_seconds > 0)
for: 10m
labels:
severity: critical
annotations:
summary: "Давно не было успешного бэкапа"
description: "Последняя успешная копия старше 30 часов на {{ $labels.instance }}."
- alert: OffsiteBackupFailed
expr: servehub_offsite_backup_last_run_success == 0
for: 5m
labels:
severity: critical
annotations:
summary: "Не удалось синхронизировать бэкап в S3"
description: "Последняя синхронизация off-site-копии или проверка размеров объектов завершилась ошибкой на {{ $labels.instance }}."
- alert: OffsiteBackupTooOld
expr: |
(time() - servehub_offsite_backup_last_success_timestamp_seconds > 108000)
and on(instance) (servehub_offsite_backup_last_success_timestamp_seconds > 0)
for: 10m
labels:
severity: critical
annotations:
summary: "Давно не было успешной off-site-копии"
description: "Последняя проверенная копия в S3 старше 30 часов на {{ $labels.instance }}."
- alert: BackupStackRestoreFailed
expr: servehub_backup_stack_restore_success == 0
for: 2m
labels:
severity: critical
annotations:
summary: "Не удалось запустить сервисы после резервного копирования"
description: "Проверьте журнал borgmatic.service и состояние Compose на {{ $labels.instance }}."
- alert: BackupPipelineTooOld
expr: |
(time() - servehub_backup_pipeline_last_success_timestamp_seconds > 108000)
and on(instance) (servehub_backup_pipeline_last_success_timestamp_seconds > 0)
for: 10m
labels:
severity: critical
annotations:
summary: "Полный цикл резервного копирования давно не завершался успешно"
description: "Локальная копия, выгрузка в S3 и восстановление сервисов не завершались успешно вместе более 30 часов на {{ $labels.instance }}."Сейчас правила сгруппированы по типам проверок. Среди них:
Доступность: HTTP(S)-цель не проходит проверку Blackbox более 10 минут.
Контейнеры: cAdvisor не обновляет метрику container_last_seen более пяти минут; после этого условие должно сохраняться ещё две минуты.
Экспортёры: Node Exporter, cAdvisor, Nginx Exporter, AdGuard Home Exporter или Blackbox Exporter недоступны более пяти минут.
Критичные сервисы: Prometheus, Alertmanager, Grafana, Loki или wg-easy не отвечают более пяти минут.
CPU: загрузка процессора выше 90% в течение пяти минут.
Память: доступно менее 10% оперативной памяти в течение пяти минут.
Диски: файловая система заполнена более чем на 85% в течение десяти минут.
TLS: до окончания действия сертификата осталось меньше 30 дней в течение двух часов.
Отдельно я интегрировал в мониторинг метрики резервного копирования. Скрипт scripts/borgmatic_with_metrics.sh публикует Prometheus-совместимый файл для Textfile Collector Node Exporter. Благодаря этому Prometheus видит не только доступность серверов и контейнеров, но и результат работы всей системы резервного копирования.
Для хранения off-site-копий я использую S3-хранилище Timeweb Cloud. Поэтому в мониторинг включена и проверка синхронизации данных с облачным хранилищем. Для этих показателей также настроены отдельные правила: например, если последняя успешная копия старше 30 часов или синхронизация завершилась ошибкой, формируется уведомление. Подробнее о реализации резервного копирования я рассказывал в своей предыдущей статье.
Формирование Prometheus-совместимого файла (часть кода из borgmatic_with_metrics.sh)# HELP servehub_borgmatic_backup_last_run_success Whether the most recent local Borgmatic backup succeeded.
# TYPE servehub_borgmatic_backup_last_run_success gauge
servehub_borgmatic_backup_last_run_success $([[ "$BORG_STATUS" -eq 0 ]] && printf 1 || printf 0)
# HELP servehub_borgmatic_backup_last_run_timestamp_seconds Unix timestamp of the last local Borg backup attempt.
# TYPE servehub_borgmatic_backup_last_run_timestamp_seconds gauge
servehub_borgmatic_backup_last_run_timestamp_seconds $LAST_RUN_TIMESTAMP
# HELP servehub_borgmatic_backup_last_success_timestamp_seconds Unix timestamp of the last successful local Borg backup.
# TYPE servehub_borgmatic_backup_last_success_timestamp_seconds gauge
servehub_borgmatic_backup_last_success_timestamp_seconds $LAST_BORG_SUCCESS
# HELP servehub_offsite_backup_last_run_success Whether the most recent rclone synchronization and size verification succeeded.
# TYPE servehub_offsite_backup_last_run_success gauge
servehub_offsite_backup_last_run_success $OFFSITE_STATUS
# HELP servehub_offsite_backup_last_run_timestamp_seconds Unix timestamp of the most recent off-site synchronization attempt.
# TYPE servehub_offsite_backup_last_run_timestamp_seconds gauge
servehub_offsite_backup_last_run_timestamp_seconds $LAST_RUN_TIMESTAMP
# HELP servehub_offsite_backup_last_success_timestamp_seconds Unix timestamp of the most recent successful off-site synchronization and verification.
# TYPE servehub_offsite_backup_last_success_timestamp_seconds gauge
servehub_offsite_backup_last_success_timestamp_seconds $LAST_OFFSITE_SUCCESS
# HELP servehub_backup_stack_restore_success Whether the previously running Compose services were restored after backup.
# TYPE servehub_backup_stack_restore_success gauge
servehub_backup_stack_restore_success $STACK_RESTORE_STATUS
# HELP servehub_backup_pipeline_last_run_success Whether local backup, S3 sync, and Compose restoration all succeeded.
# TYPE servehub_backup_pipeline_last_run_success gauge
servehub_backup_pipeline_last_run_success $PIPELINE_SUCCESS
# HELP servehub_backup_pipeline_last_run_timestamp_seconds Unix timestamp of the most recent full backup pipeline attempt.
# TYPE servehub_backup_pipeline_last_run_timestamp_seconds gauge
servehub_backup_pipeline_last_run_timestamp_seconds $LAST_RUN_TIMESTAMP
# HELP servehub_backup_pipeline_last_success_timestamp_seconds Unix timestamp of the last fully successful backup pipeline.
# TYPE servehub_backup_pipeline_last_success_timestamp_seconds gauge
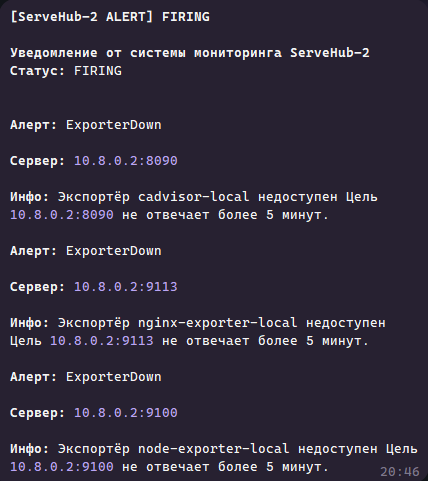
servehub_backup_pipeline_last_success_timestamp_seconds $LAST_PIPELINE_SUCCESSAlertmanager отвечает за доставку и группировку событий. В проекте все алерты направляются в Telegram. Уведомления группируются по имени алерта и нескольким дополнительным меткам, чтобы не получать отдельное сообщение на каждую затронутую цель.
Эту часть системы я планирую дорабатывать. Например, при сетевой проблеме Workload может полностью потерять связь с Edge. Вместо одного уведомления о недоступности сервера я получаю целую пачку алертов о падении отдельных сервисов. Это создаёт лишний шум и затрудняет поиск проблемы.
Сейчас конфигурация Alertmanager выглядит следующим образом:
global:
  resolve_timeout: 5m

route:
  group_by: ['alertname', 'check_name', 'cluster', 'service']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  receiver: 'telegram-notifications'

receivers:
  - name: 'telegram-notifications'
    telegram_configs:
      - bot_token: '{{ telegram_token }}'
        chat_id: {{ telegram_chat_id | int }}
        send_resolved: true
        parse_mode: 'HTML'
        message: |
          {% raw %}
          <b>[ServeHub-2 ALERT] {{ .Status | toUpper }}</b>

          <b>Уведомление от системы мониторинга ServeHub-2</b>
          <b>Статус:</b> {{ .Status | toUpper }}

          {{ range .Alerts }}
          <b>Алерт:</b> {{ .Labels.alertname | html }}

          <b>Сервер:</b> {{ .Labels.instance | html }}

          <b>Инфо:</b> {{ .Annotations.summary | html }} {{ .Annotations.description | html }}
          {{ end }}
          {% endraw %}
group_wait даёт время собрать связанные события в одну группу, group_interval определяет интервал отправки обновлений группы, а repeat_interval — период повторного уведомления, если проблема всё ещё актуальна. В конфигурации также включена отправка resolved-событий, поэтому Telegram сообщает не только о появлении проблемы, но и о её устранении.
❯ Ограничения и дальнейшее развитие
Edge остаётся единой точкой отказа. Если VPS или стек мониторинга недоступен, сбор метрик и логов, Grafana и обработка уведомлений также будут недоступны. Это ограничение можно частично компенсировать внешним мониторингом. Например, сервис мониторинга сайтов и серверов Timeweb Cloud позволяет проверять доступность серверов, а также получать уведомления о сбоях и восстановлении. Такой инструмент не заменяет Prometheus и Loki, но дополняет их независимой проверкой доступности инфраструктуры.
Собираются не все возможные журналы. Сбор пока ограничен Docker-контейнерами. Alloy получает сообщения, которые контейнеры передают через stdout/stderr. Системные журналы Linux из journald и отдельные файлы логов приложений пока не собираются.
Алерты не исключают друг друга при необходимости. Если Workload полностью теряет связь с Edge, вместо одного уведомления о недоступности сервера я получаю множество сообщений о недоступности отдельных сервисов.
Разумеется, у системы есть и другие недостатки. Здесь я перечислил только те, которые смог заметить сам.
❯ Заключение
В итоге в проекте получилось объединить мониторинг двух серверов в одну систему. Prometheus собирает метрики хостов, контейнеров и отдельных сервисов. Blackbox Exporter проверяет доступность выбранных endpoint. Alloy передаёт Docker-логи в Loki. Grafana предоставляет единый интерфейс для анализа. Alertmanager отправляет уведомления в Telegram.
Исходный код ServeHub-2 доступен на GitHub. Буду рад, если мои конфигурации послужат отправной точкой для вашей собственной инфраструктуры.
Если вам интересна тема сетевой архитектуры, администрирования Linux и DevOps, делюсь своими практическими заметками и опытом в Telegram-канале My Tech Notes.
Новости, обзоры продуктов и конкурсы от команды Timeweb.Cloud — в нашем Telegram‑канале →

Комментарии 0