Привет, Хабр! Я Александр Гуляев, архитектор центра сетевых решений «Инфосистемы Джет». Наша команда работает над очень разными проектами — от локальных вычислительных сетей до создания телекоммуникационных облаков. В облачной инфраструктуре важно не только её построить, но и корректно спланировать, в частности, оценить характеристики компонентов, участвующих в обработке транзитного трафика. В этой статье я расскажу об инструменте, который мы используем для нагрузочного тестирования производительности сетевых компонентов OpenStack.
Есть много программных инструментов для определения сетевой производительности. Как правило, они хорошо решают свою задачу в условиях, для которых были спроектированы.
Типичную задачу — измерить пропускную способность канала связи — можно решить с помощью iperf3, запустив сервер и клиент в двух точках, между которыми нужно определить доступную полосу пропускания.
Далее можно заняться исследованием (в меру своей изощрённости), проверяя возможности канала трафиком с разными протоколами (TCP/UDP), количеством потоков, длиной пакетов, алгоритмами congestion control и прочим. На выходе вы получите характеристики бутылочного горлышка вашей схемы организации связи. В большинстве случаев тестирования канала этого будет достаточно.
Но что, если в нашей схеме должно быть не две точки выполнения измерений, а несколько? Например, как измерить производительность сетевой подсистемы виртуализованного сервера, в котором трафик обрабатывается двадцатью виртуальными машинами? Запустить параллельно 20 iperf3, а потом просуммировать результаты? А если трафик должен обрабатываться внутри ВМ и возвращаться обратно (транзитный трафик)? Запустить столько же iperf3 в обратную сторону? Или 'iperf3 --bidir'? Запустить их все разом? Не слишком ли много iperf3?
Между тем, такая задача обработки транзитного трафика в облаке многочисленными ВМ не является надуманной — именно так он обрабатывается в VNF, типичных для телекома. Оценка способности сервера обрабатывать трафик с заданными характеристиками необходима для корректного планирования размещения на серверах виртуальных машин и выбора правильного datapath. Цена ошибки в данном случае может быть довольно значительной — от деградации сервиса в час наибольшей нагрузки (ЧНН) до перезаклада дорогостоящих вычислительных ресурсов — в зависимости от того, в какую сторону ошиблись.
Опытные «облаководы» возразят, что подобные проблемы решаются за счёт динамического масштабирования VNF, и никакой проблемы тут нет вовсе. Это тема для отдельного разговора, замечу лишь, что, если проблема в производительности datapath гипервизора, масштабирование числа ВМ VNF может и не сработать.
Добавим в требования управление развёртыванием тестовой среды из виртуальных машин в облаке OpenStack (типичной VIM-платформе для управления виртуальными ресурсами VNF в телекоме) — и получим довольно специфический набор задач.
Встречайте NFVBench
Предлагаю вспомнить теорию, затем перейдём к практической части.
NFVBench — это opensource Python-приложение, которое управляет генератором трафика Trex, развёртывает тестовую среду, запускает тесты и формирует отчёт. Комплекс ПО распространяется в виде контейнера и может работать на физическом сервере или внутри ВМ.
Судьба у него сложная: разработка началась в 2016 году командой инженеров из Cisco Systems, в 2017 году была передана в opensource-проект Open Platform for NFV (OPNFV) в качестве инструмента для тестирования производительности сетевых datapath. На текущий момент проект активно не развивается. Наиболее актуальная документация доступна здесь.
Как и что он тестирует?
NFVBench позволяет оценить производительность программных сетевых компонентов OpenStack — различных datapath, таких как OVS, OVS-DPDK, SR-IOV. Тест имитирует типичные для сетевых функций сервисные цепочки с транзитным трафиком.
NFVBench поддерживает два основных типа сервисных цепочек:
PVP (physical-virtual-physical) — трафик поступает в ВМ и возвращается обратно к генератору.
PVVP (physical-virtual-virtual-physical) — трафик поступает в одну ВМ, внутри гипервизора передаётся в другую, возвращается обратно из второй ВМ. Такая цепочка эмулирует service chain из нескольких ВМ.
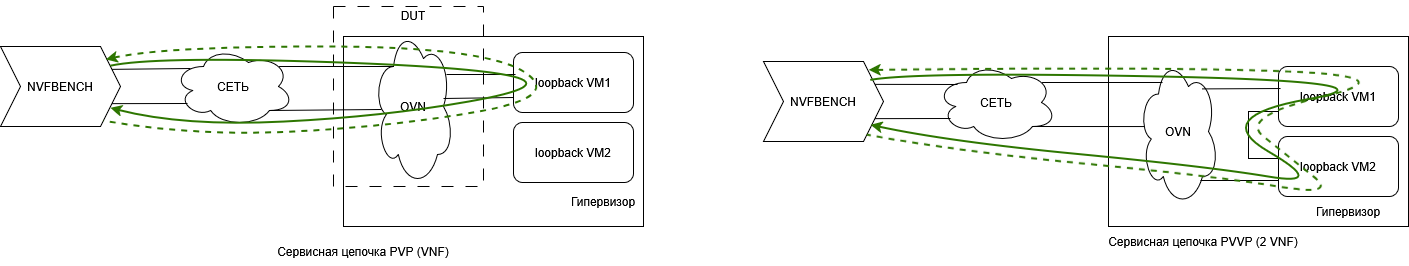
Потоки трафика запускаются сразу с обоих интерфейсов генератора, то есть в двух направлениях. Таким образом, каждая сервисная цепочка нагружает сетевой стек DUT и loopback VMs как минимум дважды: за счёт прямого и обратного трафика одной и той же цепочки. Пакеты сервисных цепочек возвращаются обратно в генератор, который определяет, сколько пакетов дошло, а сколько потерялось при различной интенсивности трафика.
NFVBench не заявлен как инструмент, реализующий какую-либо стандартизованную методику тестирования, например, RFC 2544, Y.1564 или более современные RFC 8204/9404. Скорее, он объединяет некоторые рекомендации из нескольких методик и привносит ряд полезных возможностей: трафик IMIX, определение PDR, более современный и быстрый алгоритм поиска NDR/PDR (MLRsearch).
NDR (Non Drop Rate) — измерение производительности при практически нулевом уровне потерь (по умолчанию 0,001%). Режим, аналогичный тесту производительности из RFC2544. PDR (Partial Drop Rate) — измерение производительности при заданном значении уровня потерь (по умолчанию 0,1%). DUT (Device Under Test) — тестируемый компонент (устройство).
NFVBench поддерживает два режима работы:
с заданным значением интенсивности трафика. Позволяет загрузить DUT заданным количеством пакетов и определить потери;
с автоматическим определением интенсивности трафика, при которой потери пакетов близки к нулю (NDR) или не превышают заданную величину (PDR, задается в %).
Как устроен NFVBench:
генератор трафика TRex;
loopback VMs — образы виртуальных машин, запускаемых в облаке OpenStack;
сетевые компоненты loopback. VMs обладают высокой производительностью, это позволяет утверждать, что слабое звено в цепочке обработки трафика (DUT) — это сам виртуальный коммутатор сервера (OVS или OVS-DPDK), производительность которого мы и измеряем;
непосредственно NFVBench, обеспечивающий оркестрацию процесса тестирования:
управление генератором TRex;
управление OpenStack для создания и удаления тестового окружения (loopback VMs);
генерация отчётов о тестировании;
интеграция с другими системами (fluentd, kibana);
CLI или REST API.
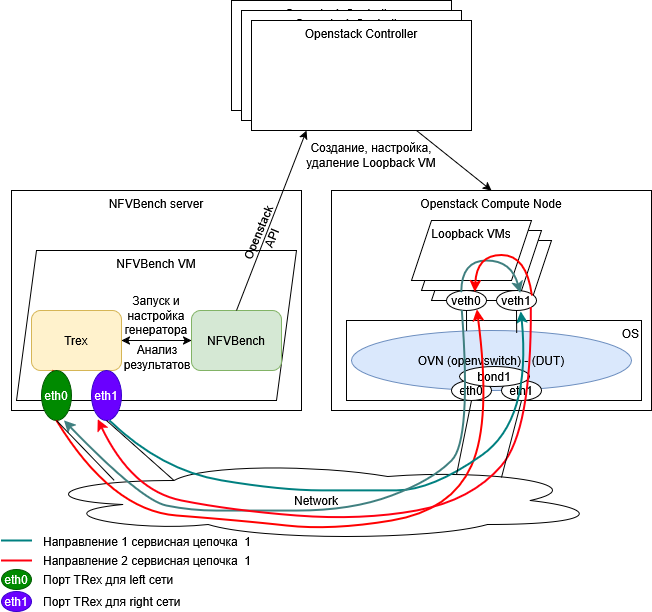
TRex под управлением NFVBench для каждой сервисной цепочки и в каждом направлении генерирует два потока UDP-пакетов:
поток для измерения latency с интенсивностью 1000 pps;
основной поток трафика, в котором может эмулироваться множество индивидуальных flow (пар SRC/DEST-адресов).
Трафик на портах может тегироваться одним VLAN ID-тегом (shared networks) или набором VLAN IDs (dedicated edge networks). MAC, IP-адреса, UDP port для traffic flow можно задавать в конфигурации.
Генератору трафика нужно минимум два порта NIC. При размещении контейнера NFVBench внутри виртуальной машины порты сетевого адаптера должны быть переданы внутрь ВМ с использованием PCI Passthrough. Выбирая сервер для NFVBench с интерфейсами 25GE, помните, что он сможет обеспечить тестирование гипервизоров с 10GE и 25GE NIC (при условии, что datapath сервера имеет производительность заведомо ниже 25GE). Для высокоскоростных datapath, использующих порты 25GE в бондах, стоит поискать сервер со 100GE NIC.
Особенности и сценарии применения NFVBench:
использование UDP позволяет избежать нюансов, связанных с управлением скоростью TCP-потока. Для тестирования эффективности алгоритмов TCP стоит поискать иные инструменты;
эффективное тестирование datapath с интерфейсами, объединёнными в bond: множество UDP-потоков будет хорошо балансироваться в разные интерфейсы bond'а и на сетевой фабрике;
возможность тестирования VNF или сетевого оборудования (любого сетевого элемента, который обрабатывает транзитный трафик). Если собрать «змейку» на портах коммутатора или маршрутизатора, можно загрузить работой dataplane даже достаточно производительного устройства. Настроенный NFVBench считывает конфигурацию из YAML-файла и параметров командной строки, запускается и выполняет полный цикл тестирования, включая запуск и настройку в облаке сервисных цепочек из одной или нескольких loopback VMs и необходимых виртуальных сетей. На выходе получаем человекочитаемый отчёт-summary и подробный отчёт в формате JSON.
Практика: как конфигурация PMD влияет на производительность
В качестве практического примера приведу часть данных, которые мы получили в ходе сравнения производительности OVS-DPDK с различной конфигурацией HyperThreading ядер CPU, назначенных драйверу PMD.
PMD — это Poll Mode Driver, компонент DPDK, который обеспечивает высокую скорость обработки пакетов за счёт отказа от прерываний и перехода на постоянный цикл опроса буферов сетевых интерфейсов.
Из-за специфики работы ядра PMD всегда утилизированы на 100% и непригодны для каких-либо других вычислительных задач. Их обычно изолируют, как и системные ядра, от планировщика Nova.
Мы тестировали три конфигурации ядер, изолированных под DPDK PMD, на двухпроцессорных серверах Intel Xeon Gold 6330N (2,2 ГГц, 112 vCPU):
Конфигурация 1 — PMD использует 8 HT-ядер с 4 физических ядер, auto PMD (default). PMD отданы полностью 4 физических ядра (8 vCPU). Nova получает в своё распоряжение 100 vCPU для запуска ВМ полезной нагрузки.
Конфигурация 2 — PMD использует 4 HT-ядра с 4 физических ядер, siblings spare, auto PMD (default). PMD отданы полностью 4 vCPU, ещё 4 vCPU с тех же ядер изолированы, но никак не задействованы. Nova получает в своё распоряжение 100 vCPU.
Конфигурация 3 — PMD использует 8 HT-ядер с 8 физических ядер, siblings spare, auto PMD (default). PMD отданы полностью 8 логических ядер, ещё 8 vCPU с тех же ядер изолированы, но никак не задействованы. Nova получает в своё распоряжение 92 vCPU.
Во всех тестах за операционной системой было зарезервировано 4 vCPU, Hyperthreading включен, ВМ размещались на обоих NUMA равномерно, security groups были отключены, количество потоков (flow) — 18 000. Чтобы ускорить получение результатов, алгоритмы NDR/PDR не использовались, результат фиксировался по значению RX Rate. Поток трафика с генератора (TX rate) во всех случаях превышал RX rate, то есть наблюдалось значительное количество потерянных пакетов.
Результаты первой группы тестов демонстрируют влияние конфигурации хоста на производительность OVS-DPDK. Используются разные типы сервисных цепочек, но количество трафика, обрабатываемого OVS-DPDK, одинаковое, так как количество ВМ в обоих случаях равно 6 и у каждой по 2 интерфейса. Выводы для обоих типов цепочек схожие:
конфигурации 1 и 2 предоставляют Nova одинаковое количество ядер для размещения ВМ, но использование 8 HT-ядер явно идёт на пользу производительности;
конфигурация 3 предоставляет PMD те же 8 ядер, как и конфигурация 1. Но прирост производительности — в два раза на мелких пакетах. Правда, при этом ядер для Nova остается на 8 меньше. Если отдать все 16 HT-ядер в PMD, наверное, будет ещё лучше, но такой эксперимент мы не проводили.
PMD создаёт на каждый виртуальный интерфейс очередь и назначает ей vCPU из числа доступных. Каждый vCPU вынужден обслуживать несколько очередей. Чем больше vCPU, тем лучше распределяется нагрузка и тем выше результат.
№ | Тесты | Конфигурация 1 | Конфигурация 2 | Конфигурация 3 | |||
Gbit/s | MPPS | Gbit/s | MPPS | Gbit/s | MPPS | ||
2.1. | PVP, 6 VM, 64 bytes | 2,2 | 3,2 | 1,4 | 2,1 | 4,2 | 6,2 |
4.1. | PVVP, 6 VM (3 service chains), | 2,2 | 3,3 | 1,6 | 3,1 | 4,0 | 5,9 |
2.2. | PVP, 6 VM, 300 bytes | 7,1 | 2,8 | 4,6 | 1,8 | 12,2 | 5,2 |
4.2. | PVVP, 6 VM (3 service chains), | 6,8 | 2,7 | 6,1 | 2,4 | 11,1 | 4,3 |
2.3. | PVP, 6 VM, | 17,1 | 1,4 | 8,7 | 0,7 | 16,9 | 1,4 |
4.3. | PVVP, 6 VM (3 service chains), | 16,0 | 1,3 | 11,9 | 1,0 | 20,8 | 1,7 |
Результаты показывают, что логические ядра-сиблинги могут дать прирост, если физических ядер мало (хотя это и не рекомендуется в различных гайдах). Однако при наличии ресурсов выделять PMD отдельные физические ядра всё же будет эффективнее.
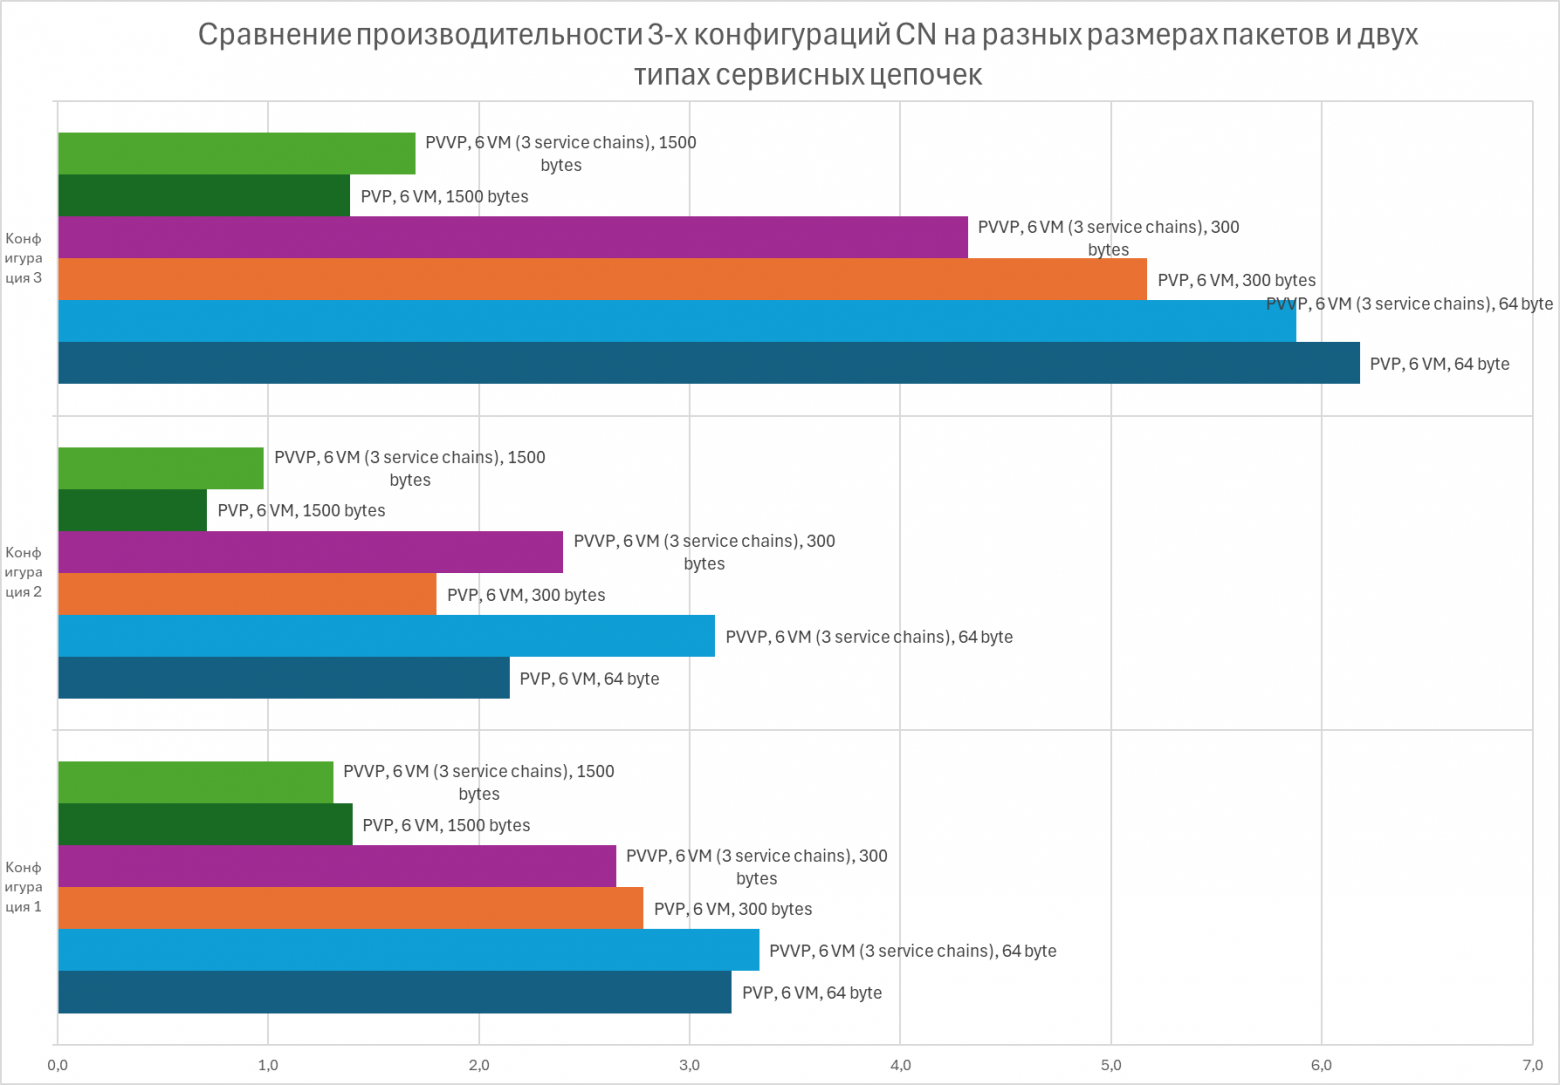
Вторую группу тестов мы проводили с различным количеством ВМ и разными сценариями PVP.
№ | Тесты | Конфигурация 1 | Конфигурация 2 | Конфигурация 3 | |||
Gbit/s | MPPS | Gbit/s | MPPS | Gbit/s | MPPS | ||
1.1. | PVP, 2 VM, | 4,0 | 6,0 | 3,1 | 4,7 | 5,3 | 7,9 |
1.2. | PVP, 2 VM, | 13,0 | 5,1 | 9,4 | 3,7 | 15,6 | 6,1 |
1.3. | PVP, 2 VM, | 31,7 | 2,6 | 17,9 | 1,5 | 34,0 | 2,8 |
3.1. | PVP, 12 VM, | 1,6 | 2,3 | 1,6 | 2,4 | 3,2 | 4,8 |
3.2. | PVP, 12 VM, | 5,2 | 2,0 | 5,4 | 2,1 | 10,0 | 3,9 |
3.3. | PVP, 12 VM, | 14,9 | 1,2 | 12,3 | 1,0 | 18,9 | 1,6 |
Результаты второй группы тестов демонстрируют, как производительность OVS-DPDK снижается с ростом числа ВМ на гипервизоре. В некоторых случаях наблюдается падение в 2,5 раза (например, если сравнить результаты 1.1 и 3.1). Компенсировать падение можно, выделив PMD дополнительные ядра.
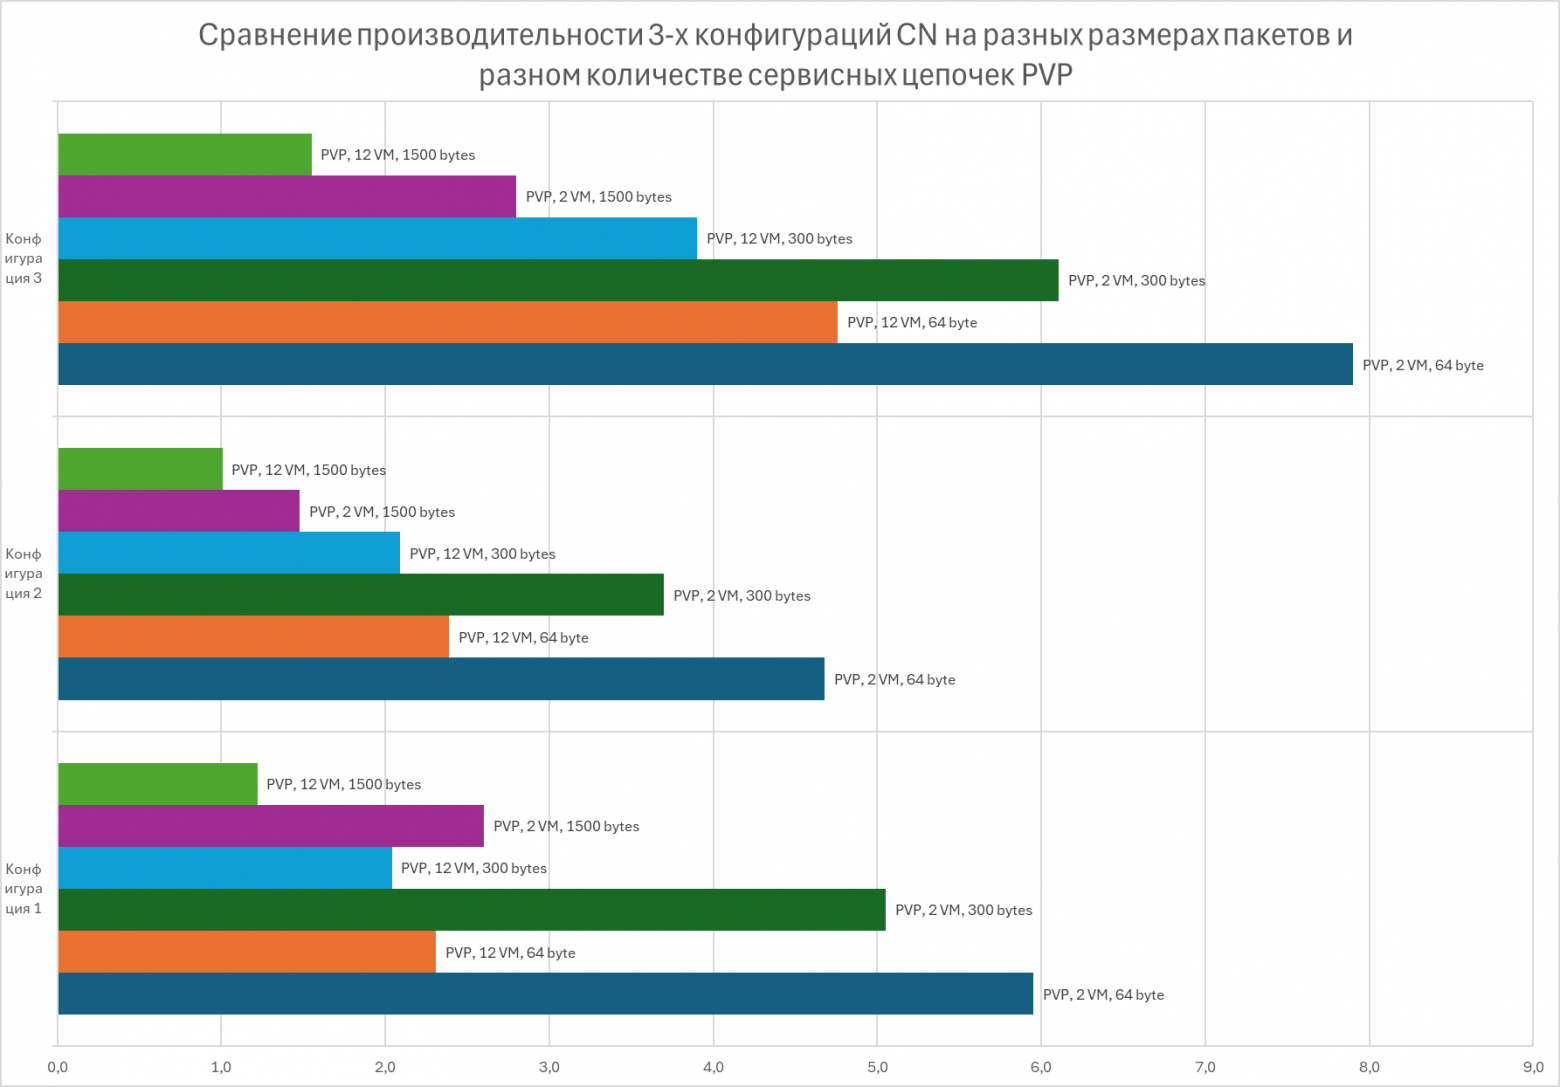
Примеры и результаты тестов, приведенные выше, демонстрируют как актуальность оценки производительности, так и цену неоптимальной конфигурации. Если производительность окажется ниже ожидаемой — дополнительные аппаратные ресурсы будут стоить денег. В этой ситуации тюнинг конфигурации сервера, возвращающий показатели в норму, будет очень кстати.
При переходе от замеров NDR (<0.001% потерь) к PDR (<0.1% потерь) показатели производительности очень сильно меняются — более чем в 5 раз (данные из другой тестовой среды):
Datapath | Сценарий | RX-полоса (FW+REV), Gbit/s | RX rate (FW+REV), Mpps | Drop Rate, % | Avg Latency, usec |
|---|---|---|---|---|---|
OVN-DPDK | PVP / 1 VM / 512b / NDR | 3.1738 | 0.746 | -0.0000% | 59.00 |
OVN-DPDK | PVP / 1 VM / 512b / PDR | 16.8457 | 3.958 | 0.0384% | 125.49 |
Достижение нулевых потерь при программной обработке трафика — дорогое удовольствие. Поэтому планировать производительность нужно с учётом особенностей трафика. Для сигнализации потери пакетов должны быть минимальны, лучше ориентироваться на значения NDR. Если трафик допускает определённый процент потерь и это укладывается в SLA сервисной функции, можно брать более высокие значения производительности, экономя ресурсы.
Я тоже хочу попробовать. Мне точно нужен целый OpenStack, чтобы запустить NFVBench?
Если хочется увидеть всё, то ответ утвердительный. Суперспособность NFVBench — это оркестрация тестовой среды в облаке. НоOpenStack не обязателен: в режиме External chains можно обойтись и без него. Однако в этом случае вся тестовая среда (DUT) должна быть подготовлена, настроена и запущена заранее. И она никак не будет управляться NFVBench.
Давайте попробуем, в традициях Хабра, собрать что-нибудь работающее, но не требующее при этом ни сложного OpenStack, ни дорогого железа.
В нашей лаборатории нашлось странное, но подходящее для этой цели железо: OEM Network Appliance Lanner NCA-4010B.
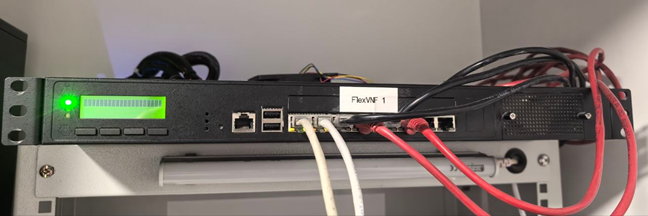
Характеристики Lanner:
CPU Xeon Processor D-1518 c поддержкой IOMMU, VT-D, 1 Gb hugepages;
32 Gb RAM DDR4 ECC;
8 x 1GE i210;
SSD 320 Gb.
Совет Для проверки поддержки процессором 1 ГБ hugepages ищите флаг
pdpe1gb:grep -E 'pse|pdpe1gb' /proc/cpuinfo | uniqpse— поддержка 2 МБ.pdpe1gb— поддержка 1 ГБ.
Попробуем собрать схему All-in-one только на нём одном.
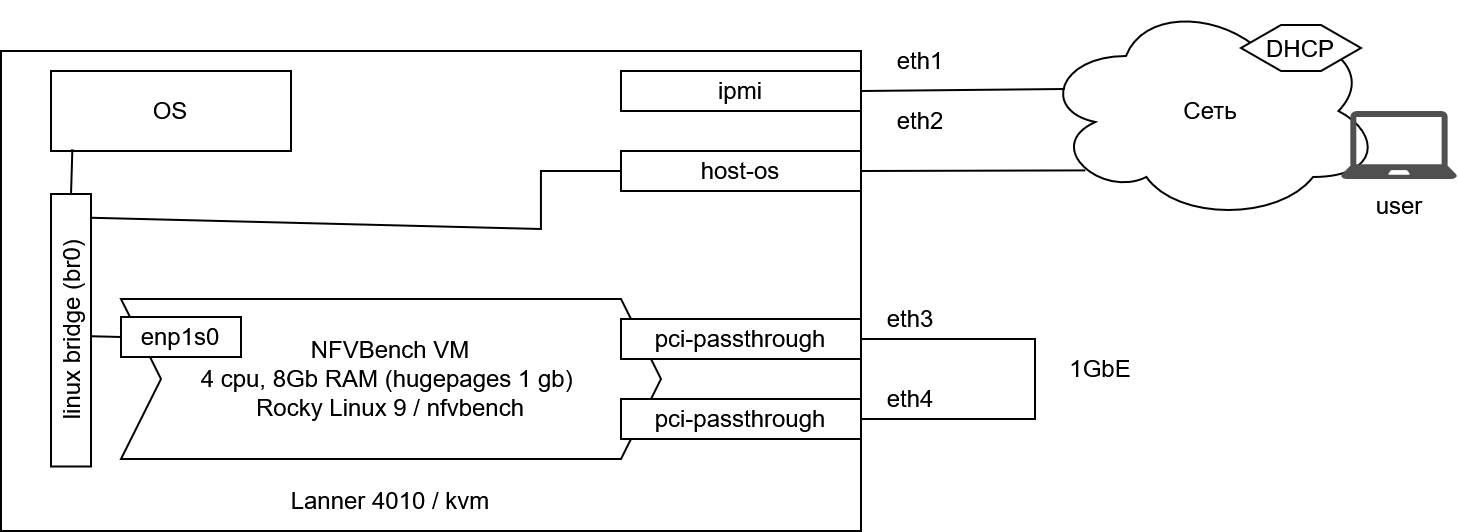
Вот основные шаги без второстепенных деталей:
1. Установим на Lanner ОС Rocky Linux 9 и kvm.
2. Настроим на гипервизоре hugepages через GRUB:
Отредактируем /etc/default/grub: в строку GRUB_CMDLINE_LINUX_DEFAULT добавим параметры hugepages (например, для 16 страниц по 1 ГБ) и IOMMU:
GRUB_CMDLINE_LINUX_DEFAULT="... default_hugepagesz=1G hugepagesz=1G hugepages=16 intel_iommu=on iommu=pt"
Обновим конфигурацию GRUB:
sudo grub2-mkconfig -o /boot/grub2/grub.cfg
Перезагрузимся. После перезагрузки 16 ГБ RAM «пропадут» из доступной памяти — это нормально: они зарезервированы под hugepages и понадобятся нашим ВМ, точнее DPDK-стеку внутри них.
3. Создадим ВМ nfvbench на базе образа Rocky Linux 9 и пробросим внутрь ВМ сетевые интерфейсы (pci-passthrough).
У ВМ nfvbench 3 интерфейса:
интерфейс управления, включен в br0 хоста, на нём назначен IP-адрес для управления через SSH;
два host-device-интерфейса, которые будет использовать Trex.
sudo virt-install \
-n test_nfvbench \
--description "vm_for_nfvbench" \
--os-variant=rocky9 \
--ram=8192 \
--memorybacking hugepages=on \
--vcpus=8 \
--disk path=/var/lib/libvirt/images/RL9_testvm_image.qcow2,format=qcow2,bus=virtio \
--cloud-init user-data=/opt/credits/user-data1.yaml \
--import \
--network bridge:br0 \
--host-device 0a:00.0 \
--host-device 0b:00.0
В /opt/credits/user-data1.yaml передадим настройки SSH, ключ, данные учётных записей, устанавливаемые пакеты.
4. Запустим ВМ, подготовим рабочую папку и скачаем образ nfvbench. Можно использовать latest из официального репозитория opnfv — он вполне рабочий:
sudo -i
dnf install pciutils nano podman
cd ~
mkdir nfvbench
cd nfvbench
podman pull opnfv/nfvbench:latest
Создадим файл рабочего окружения /root/nfvbench/openrc. Так как мы не планируем использовать OpenStack, содержимое этого файла не важно, подойдёт копипаста (см. ниже). Однако nfvbench ищет этот файл и без него не запустится.
$HOME/nfvbench/openrc
export OS_AUTH_TYPE=password
export OS_PASSWORD=
export OS_AUTH_URL=
export OS_USERNAME=
export OS_PROJECT_NAME=
export OS_IDENTITY_API_VERSION=3
export OS_PROJECT_DOMAIN_NAME=
export OS_USER_DOMAIN_NAME=
export OS_REGION_NAME=
export PYTHONWARNINGS='ignore:Certificate has no, ignore:A true SSLContext object is not available'
export OS_CACERT=/etc/ssl/certs/cacerts.pem
5. Создадим файл простейшей конфигурации тестового окружения:
$HOME/nfvbench/test_nfvbench.cfg
openrc_file: /tmp/nfvbench/.openrc
traffic_generator:
  generator_profile:
    - name: trex-local
      tool: TRex
      ip: 127.0.0.1
      cores: 2
      software_mode: true
      interfaces:
        - port: 0
          pci: '05:00.0'
        - port: 1
          pci: '06:00.0'
      intf_speed: 1Gbps
      platform:
        master_thread_id: 0
        latency_thread_id: 7
        dual_if:
          - socket: 0
            threads: [1,2,3,4]
6. Запустим контейнер с nfvbench (команду нужно выполнять в папке с nfvbench, если запускаете из другого каталога — укажите полный путь к папке с конфигурацией nfvbench):
podman run
podman run --detach --net=host --privileged -v $PWD:/tmp/nfvbench -v /dev:/dev -v /lib/modules/$(uname -r):/lib/modules/$(uname -r) -v /usr/src/kernels:/usr/src/kernels --name nfvbench opnfv/nfvbench7. Сделаем удобный alias и проверим, что в контейнере есть что-то живое:
alias create
alias nfvbench='podman exec -it nfvbench nfvbench'
nfvbench --version
nfvbench --help
8. Если приложение в контейнере отвечает, пробуем запустить nfvbench. Для начала берём патч-корд, замыкаем порты, которые проброшены в nfvbench, и запускаем его в режиме EXTERNAL CHAIN и l2-loopback. Работает!
nfvbench -c /tmp/nfvbench/test_nfvbench.cfg --service-chain EXT --service-chain-count 1 --flow-count 100 --l2-loopback no-tag --rate 100kpps
2026-04-03 17:29:06,632 INFO Loading configuration file: /tmp/nfvbench/test_nfvbench.cfg
<skip>
2026-04-03 17:29:31,710 INFO Connected to TRex
2026-04-03 17:29:31,710 INFO    Port 0: I210 Gigabit Network Connection speed=1Gbps mac=00:90:0b:4a:e9:02 pci=0000:05:00.0 driver=net_e1000_igb
2026-04-03 17:29:31,710 INFO    Port 1: I210 Gigabit Network Connection speed=1Gbps mac=00:90:0b:4a:e9:03 pci=0000:06:00.0 driver=net_e1000_igb
2026-04-03 17:29:31,710 INFO Ports: untagged
<skip>
2026-04-03 17:29:41,736 INFO Running traffic generator
2026-04-03 17:29:51,788 INFO TX:         991,754; RX:         991,754; (Est.) Dropped:            0; Drop rate:   0.0000%
2026-04-03 17:30:01,803 INFO TX:       1,993,640; RX:       1,993,639; (Est.) Dropped:            1; Drop rate:   0.0001%
2026-04-03 17:30:11,821 INFO TX:       2,995,527; RX:       2,995,527; (Est.) Dropped:           -1; Drop rate:  -0.0001%
2026-04-03 17:30:21,838 INFO TX:       3,997,240; RX:       3,997,239; (Est.) Dropped:            1; Drop rate:   0.0001%
2026-04-03 17:30:31,856 INFO TX:       4,999,139; RX:       4,999,140; (Est.) Dropped:           -2; Drop rate:  -0.0002%
2026-04-03 17:30:41,807 INFO TX:       5,992,250; RX:       5,992,250; (Est.) Dropped:            1; Drop rate:   0.0001%
2026-04-03 17:30:41,807 INFO ...traffic generating ended.
2026-04-03 17:30:41,815 INFO Service chain 'EXT' run completed.
<skip>

            L2 frame size: 64
            Run Config:
              +-------------+---------------------------+------------------------+-----------------+---------------------------+------------------------+-----------------+
              |  Direction  |  Requested TX Rate (bps)  |  Actual TX Rate (bps)  |  RX Rate (bps)  |  Requested TX Rate (pps)  |  Actual TX Rate (pps)  |  RX Rate (pps)  |
              +=============+===========================+========================+=================+===========================+========================+=================+
              |   Forward   |       33.6000 Mbps        |      33.5563 Mbps      |  33.5563 Mbps   |        50,000 pps         |       49,935 pps       |   49,935 pps    |
              +-------------+---------------------------+------------------------+-----------------+---------------------------+------------------------+-----------------+
              |   Reverse   |       33.6000 Mbps        |      33.5569 Mbps      |  33.5569 Mbps   |        50,000 pps         |       49,935 pps       |   49,935 pps    |
              +-------------+---------------------------+------------------------+-----------------+---------------------------+------------------------+-----------------+
              |    Total    |       67.2000 Mbps        |      67.1132 Mbps      |  67.1132 Mbps   |        100,000 pps        |       99,870 pps       |   99,870 pps    |
              +-------------+---------------------------+------------------------+-----------------+---------------------------+------------------------+-----------------+
 <skip>
В команде мы запросили --rate 100kpps — и получили, по 50 kpps в каждую сторону. Можно ли задать бо́льшую интенсивность pps? Можно, но на этом этапе мы лишь проверяем, что генератор исправен.
9. Если что-то пошло не так — идём в контейнер:
podman exec -it -u0 nfvbench bashи проверяем, как DPDK видит предоставленные ему порты. Должно быть примерно так:
dpdk-status
nfvbench:/# python3 /opt/trex/<version>/dpdk_nic_bind.py --status
Network devices using DPDK-compatible driver
============================================
0000:05:00.0 'I210 Gigabit Network Connection' drv=uio_pci_generic unused=
0000:06:00.0 'I210 Gigabit Network Connection' drv=uio_pci_generic unused=
Network devices using kernel driver
===================================
0000:01:00.0 'Virtio network device' if=eth0 drv=virtio-pci unused=uio_pci_generic Active
Other network devices
=====================
<none>
Если на интерфейсах генератора закреплён другой драйвер, например, igb, меняем его на uio_pci_generic:
# modprobe uio_pci_generic
# python3 /opt/trex/<version>/dpdk_nic_bind.py -u  0000:05:00.0  0000:06:00.0
# python3 /opt/trex/<version>/dpdk_nic_bind.py -b uio_pci_generic 0000:05:00.0  0000:06:00.0
# python3 /opt/trex/<version>/dpdk_nic_bind.py --status
В продуктивных средах с более производительными картами E810 мы используем более современный драйвер vfio-pci.
Теперь между портами NFVBench можно установить сетевой коммутатор или программный мост и протестировать его в режиме L2.
Когда полезен NFVBench и что дальше
В нашей практике мы применяем NFVBench для оценки производительности datapath гипервизоров OpenStack, а также планируем адаптировать и использовать этот инструмент для тестов сетевой подсистемы в Kubernetes и сетевого оборудования.
Результаты NFVBench полезны в трёх типах задач:
Planning: определение достижимой производительности для заданного сценария обработки трафика на конкретной аппаратной платформе;
Assessment: проверка корректности конфигурации инфраструктуры. Если что-то настроено некорректно, результаты будут отличаться от референсных;
R&D: исследование влияния на производительность различных конфигураций, результатов тюнинга и так далее. Всегда актуально «выжать» максимум возможностей из инфраструктуры, либо проверить, как изменения настроек повлияли на производительность стека.
Наиболее увлекательной и сложной является тема R&D: обширное русское поле экспериментов по тюнингу всего, что только можно:
опции и версии BIOS сервера;
версии FW сетевой карты;
конфигурации гипервизора;
конфигурации ВМ;
версии драйверов, ОС и ПО;
datapath;
влияния security groups;
условий функционирования сервера (да-да, перегретый сервер будет сваливаться в троттлинг, и это скажется на результате).
Не все эти факторы влияют равнозначно, но решение по выбору новой версии ПО или прошивки становится обоснованным, когда есть надёжные результаты тестов до и после обновления.
P.S. Если у хабровчан есть живой интерес к этой теме, в следующей статье можем рассказать о том, как собрать программный маршрутизатор на базе VPP/FD.io для использования совместно с NFVBench (аналог loopback ВМ) и настроить более сложные сценарии тестирования.

Комментарии 0