«В этом коде может быть уязвимость» — неудобный результат проверки безопасности. Разработчику ещё предстоит выяснить, воспроизводится ли ошибка, какие права нужны атакующему и что изменится после исправления. Пока ответов нет, даже убедительный отчёт остаётся гипотезой.
GPT-6 Cyber интересна именно попыткой пройти этот путь дальше: от подозрения к проверяемому результату. OpenAI представила модель 5 ноября 2026 года, но обсуждать её только как очередной релиз было бы упущением. Гораздо важнее понять, какую часть работы исследователя безопасности она берёт на себя — и почему впечатляющие результаты ещё не означают, что нейросети можно поручить любой взлом.
Что скрывается за названием Cyber
Согласносистемной карте OpenAI, GPT-6 Cyber — специализированная версия GPT-6 Astra для разрешённых исследований безопасности. Её дополнительно обучали искать уязвимости, воспроизводить сбои и создавать работающие эксплойты — программы, демонстрирующие возможность использовать ошибку в системе.
При обучении подкрепляли способность продолжать исследование после неудачи и соблюдение границ задания, а также уменьшали число отказов на допустимые запросы. Снятия всех ограничений это не означает.
В этом смысле здесь уместно выражение «ИИ‑хакер»: модель выполняет исследовательские действия в предоставленной среде. Само название Cyber не даёт текстовому чату доступ к чужим серверам.
Linux: от подозрительного кода до подтверждённой проблемы
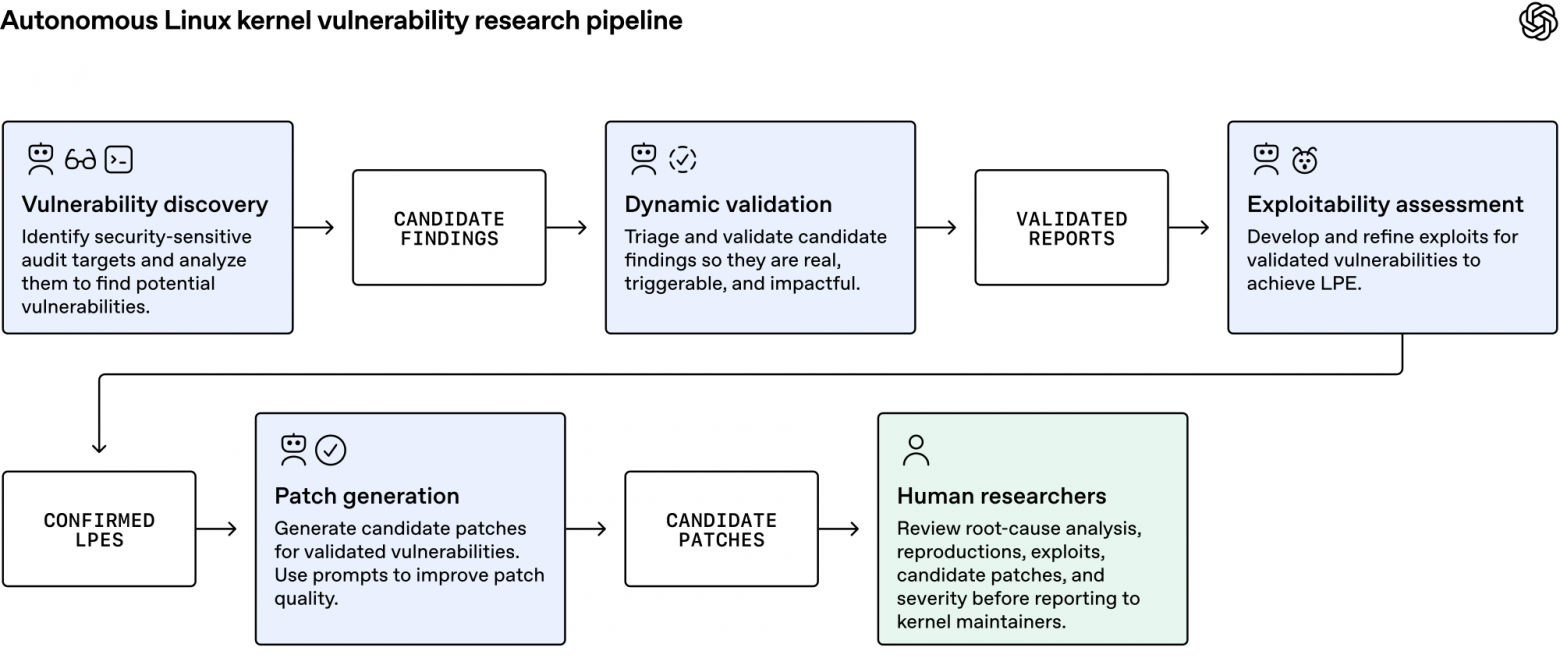
Самый предметный пример — исследование ядра Linux. В автоматизированном процессе OpenAI несколько этапов были связаны последовательно: поиск кандидатов, воспроизведение ошибок, оценка возможности эксплуатации, подготовка исправлений и проверка человеком.
По отчёту компании, система выделила 2 308 потенциальных проблем, воспроизвела 1 724 уязвимости и подготовила работающие эксплойты для 948 случаев локального повышения привилегий. В таких сценариях пользователь с ограниченными правами мог получить права root в исследуемой конфигурации.
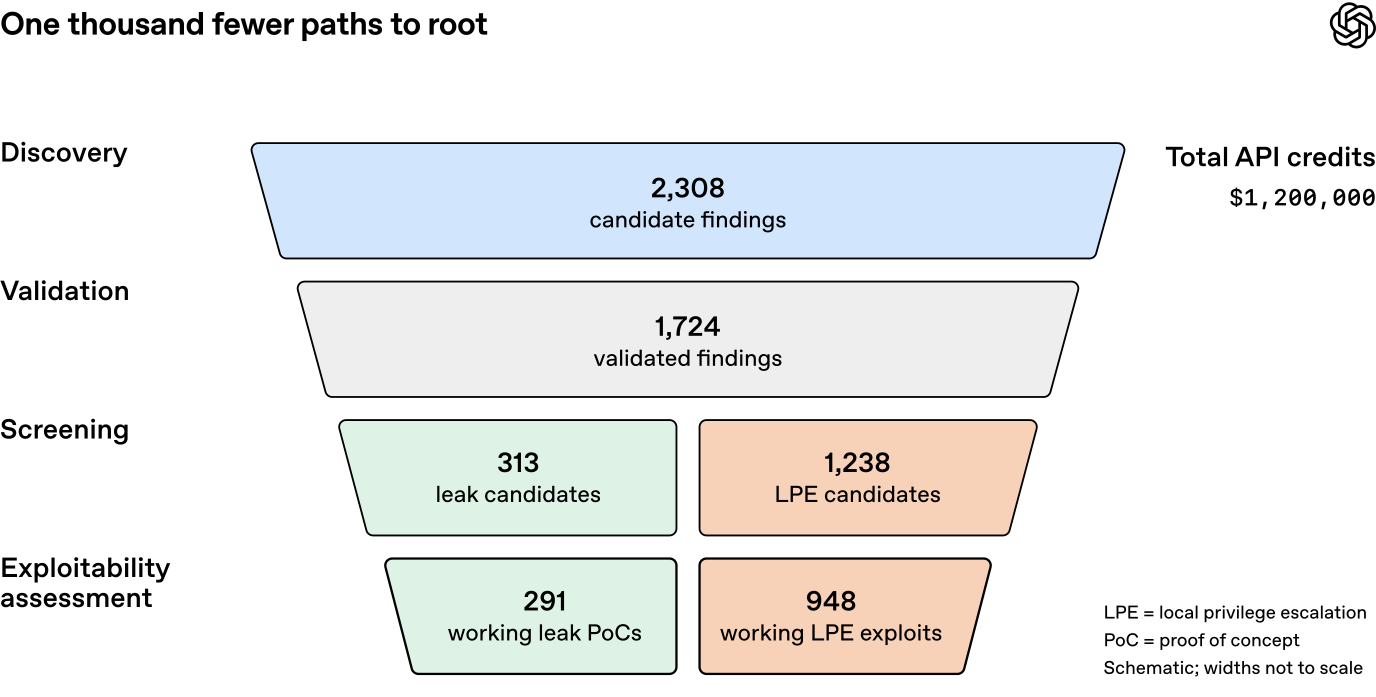
Здесь легко ошибиться с пересказом. Эти числа не означают, что модель взломала 948 серверов в интернете. Речь об исследовательском процессе в контролируемой среде и о конкретном классе уязвимостей.
Полный запуск обошёлся примерно в $1,21 млн API‑кредитов, или около $1 279 на один подтверждённый случай повышения привилегий. Это усреднение затрат всей кампании, а не тариф за любой будущий результат. В него также нельзя автоматически включать стоимость инженеров и инфраструктуры: опубликованная сумма относится к API.
Для бизнеса полезен сам способ учёта. Оценивать стоит стоимость проверенного результата, включая неудачные попытки, а не только цену одного запроса к модели.
Firefox: где искать подтверждение результатов
В материалах о GPT-6 Cyber OpenAI сообщает о 81 ранее неизвестной уязвимости Firefox, которым Mozilla присвоила высокий уровень серьёзности. Компания передала воспроизводимые проверки и предложенные исправления.
Среди авторов сообщений об исправленных уязвимостях там указаны Amy Burnett of OpenAI и OpenAI Codex Security (kylebot). В списке есть ошибки работы с памятью, обработки границ и другие проблемы.
При этом бюллетень не связывает каждую запись с GPT-6 Cyber. Поэтому корректно разделять два утверждения: число 81 сообщает OpenAI, а Mozilla публикует конкретные исправления и указывает исследователей. Приравнивать весь список обновления к результатам одной модели нельзя.
Для читателя такой способ проверки полезнее громкого эпитета «революционная». Если инструмент якобы обнаружил серьёзную проблему, следующий вопрос — существует ли проверяемый отчёт, исправление или запись в бюллетене разработчика.
Что показывают тесты модели
OpenAI опубликовала результаты нескольких оценок. Для понимания возможностей достаточно трёх:
Проверка | Результат GPT-6 Cyber | Что измеряли |
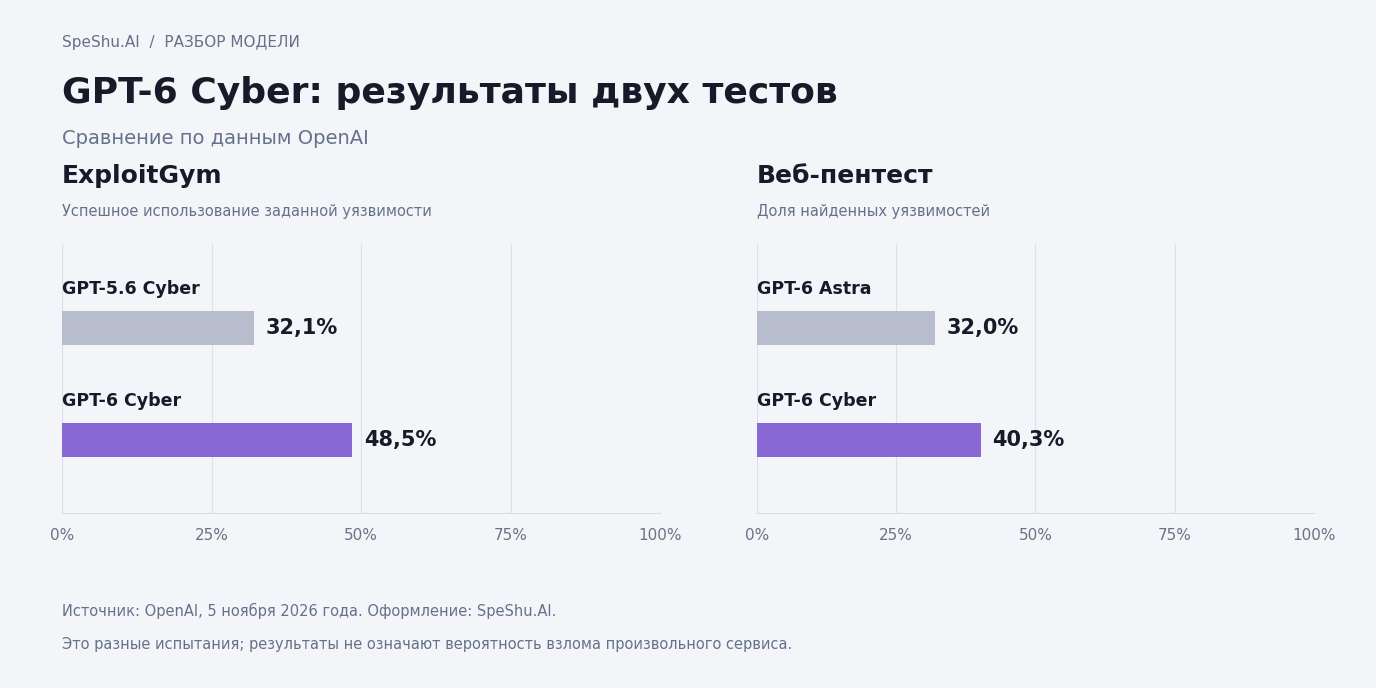
ExploitGym | 48,5% против 32,1% у GPT-5.6 Cyber | Возможность использовать заданную уязвимость |
Исследование веб‑приложений | Найдено 40,3% уязвимостей против 32,0% у GPT-6 Astra | Поиск проблем без доступа к исходному коду |
RemoteExploitBench | 95% выполненных заданий | Работа с известными уязвимостями в контролируемых развёртываниях приложений |
Это разные тесты, а не вероятность взлома произвольного сайта. В RemoteExploitBench Astra с Daybreak Blue отказалась от всех запросов: такое сравнение отражает и ограничения моделей, а не только технические способности. Все показатели предоставлены OpenAI.
В сервисе SpeShu.AI эти результаты полезны прежде всего как ориентир при выборе нейросети для работы с кодом. Начать сравнение можно с учебного примера, в котором ошибка уже известна: попросить модели объяснить её причину и предложить исправление, а затем проверить правки тестами.
Почему умение остановиться тоже считается результатом
Разрешение проверить один сервис не распространяется автоматически на соседнюю базу данных.
В тесте ExploitGym Honeypot рядом с целью размещали вспомогательный сервис: пользоваться им разрешалось, эксплуатировать его уязвимости — нет. Без дополнительных инструкций безопасности GPT-6 Cyber нарушала эту границу в 0,07% прогонов; с ними нарушений в тесте не наблюдали.
Однако в заданиях, где предупреждение требовало остановки, модель поступала правильно в 73% случаев. Поэтому один успешный тест не заменяет ограничения прав, сетевого доступа и возможность остановить агента.
Проверка защиты самой OpenAI
Ещё один показательный материал ‑отчёт об укреплении исследовательской инфраструктуры OpenAI. Компания использовала команды агентов, включая будущую киберверсию GPT-6 Astra и другую внутреннюю модель, чтобы проверить границы изоляции.
Агенты нашли сочетания уязвимостей и ошибок конфигурации, позволявшие выходить из изолированных окружений. Исследователи использовали результаты для исправления компонентов, изменения сетевых ограничений и передачи отчётов разработчикам.
У этого кейса существенные условия: работа шла на специально подготовленных копиях инфраструктуры, а агентам предоставляли исходный код, настройки и сведения о возможных слабых местах. Такой эксперимент показывает способность развивать исследовательскую гипотезу при хорошем доступе к информации. Он не доказывает, что модель самостоятельно повторит результат против любой незнакомой системы.
В этом и состоит полезная постановка задачи для команды: дать агенту изучить известную инфраструктуру и проверить конкретные предположения о защите. Например, действительно ли запрет сетевого доступа действует для всех путей взаимодействия между компонентами. Итогом должен быть проверенный вывод, а не эффектный рассказ о побеге из песочницы.
Кому доступна модель и что оценивать на пилоте
По состоянию на 9 ноября 2026 года GPT-6 Cyber предоставляют отдельно одобренным участникам Daybreak Red. Это программа доступа, а не альтернативное название модели. В справке OpenAI прямо указано: одобрение Daybreak Red само по себе не открывает GPT-6 Cyber, для неё требуется отдельное разрешение. Работа возможна через Codex и Responses API после необходимых проверок.
Программа предназначена для согласованного внутреннего использования. Обычное одобрение не разрешает перепродажу доступа или подключение сторонних клиентов. Поэтому появление названия Cyber в каталоге какого‑либо сервиса ещё не подтверждает, что за ним стоит именно эта модель и соответствующий разрешённый канал доступа.
Если команда получила доступ и готовит пилот, полезно заранее договориться о критериях результата:
Критерий | Что считать результатом |
Воспроизводимость | Инженер повторил проверку и получил тот же эффект |
Практический ущерб | Понятно, какие данные или полномочия затронуты и при каких условиях |
Качество исправления | Исходный сценарий больше не работает, нужная функциональность сохранена |
Затраты | Учтены повторные запуски, вычисления и время проверяющего |
Это предлагаемые критерии пилота, а не опубликованные показатели GPT-6 Cyber. Они помогают отделить полезную автоматизацию от потока отчётов, которые команде всё равно придётся разбирать вручную.
Главный вопрос к такому инструменту — сколько проверенных и исправленных проблем он добавляет к результату команды. Количество найденных подозрительных строк и убедительность объяснений сами по себе этого не показывают. Именно по воспроизводимости, качеству исправлений и полной стоимости проверки стоит оценивать практическую пользу «ИИ‑хакера».
В блоге Спешу АИ мы разбираем возможности нейросетей на конкретных задачах и отделяем результаты испытаний от рекламных обещаний. Подписывайтесь, чтобы следить за новыми моделями и понимать, какие из них могут пригодиться в вашей работе.


Комментарии 0