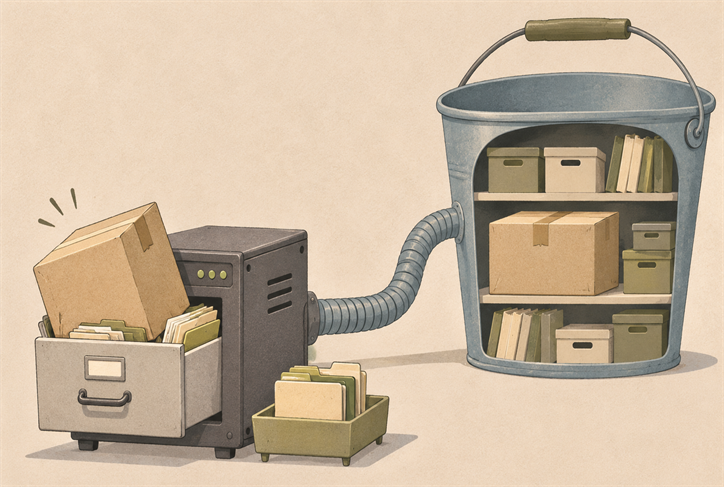
Недавно столкнулся с проблемой нехватки дискового пространства на VPS-сервере. Сейчас за 7 евро в месяц арендую VPS с таким конфигом: 4 vCPU RAM 8 GB 120 GB NVMe. На диске осталось свободного места 50 GB. А мне надо поднять докер-контейнер, образ которого 76 GB. Можно было расширить текущий VPS, чтобы диск стал 240 GB, но в месяц такая радость уже стоит 30 евро. Цены кусаются. Заметил, что хостинг дает всего за 4 евро в месяц хранилище S3 размером 250 GB, которое доступно по внутренней локальной сети. В общем, возник вопрос, как его превратить в файловую систему, чтобы Docker хранил файлы на нем.
Первым делом я попробовал rclone. Он позволяет создать FUSE-файловую систему из вашего S3-хранилища. Для ускорения работы можно создать на локальном SSD-диске кеш часто используемых файлов через ключ --vfs-cache-max-size. Но, к сожалению, Docker использует overlay2, которому нужны операции с файловой системой, которые rclone mount не гарантирует: атомарный rename, корректные chmod, chown, hard links и extended attributes. В общем, нужна полноценная POSIX-файловая система.
И я нашел решение: это s3backer. У него на GitHub 600+ звезд, и он дает полноценную файловую систему ext4. В общем, через ключ --blockCacheSize задал 20 Gb кеша на моем локальном SSD. Примонтировал к /mnt/s3 и перенастроил Docker, чтобы он имиджи, контейнеры и волумы хранил на /mnt/s3. В итоге самые часто используемые файлы кешируются локально и не тянутся по сети с S3. Как вам такое решение? За 4 евро в месяц расширить дисковое пространство своей виртуалки на 250 Gb? По-моему, красота!
Кстати вот сводная табличка существующих решений:
Решение | Принцип работы | Плюсы | Минусы |
|---|---|---|---|
s3backer + ext4 | S3 как блочное устройство | Полноценная POSIX-ФС, совместимость с Docker, кеширование | Сложная настройка, задержки, риск повреждения ФС |
rclone mount | FUSE поверх S3 | Простота, локальный кеш, поддержка разных облаков | Неполная POSIX-совместимость, ограничения операций |
s3fs | FUSE поверх S3 | Простое монтирование, привычная работа с файлами | Медленные операции с метаданными, ограничения POSIX |
JuiceFS | Распределённая ФС поверх S3 | POSIX, кеширование, высокая производительность | Требует отдельного хранилища метаданных |
S3QL | Файловая система поверх S3 | POSIX, сжатие, дедупликация, шифрование | Дополнительные накладные расходы, сложность восстановления |
Конечно, s3backer - далеко не единственный способ превратить S3 в файловую систему. Есть еще как минимум два интересных проекта: JuiceFS и S3QL. Оба умеют работать поверх S3, поддерживают POSIX-операции и локальное кеширование. Но для моей задачи они показались избыточными.
JuiceFS довольно мощная распределенная файловая система. Поддерживает одновременную работу нескольких серверов, кеширование, POSIX и многое другое. Но есть нюанс: кроме самого S3, ей требуется отдельное хранилище метаданных. Это может быть Redis, PostgreSQL, MySQL или даже локальный SQLite. Последний вариант не требует отдельного сервиса, но все равно приходится следить за сохранностью базы метаданных и ее резервным копированием. В общем, решение интересное, особенно если у вас кластер серверов. Но у меня всего один VPS, и поднимать дополнительную инфраструктуру ради хранения Docker-образов совершенно не хотелось.
S3QL еще один интересный вариант. Поддерживает POSIX, локальное кеширование, сжатие, дедупликацию и шифрование. Причем отдельный сервер базы данных ему не нужен: метаданные хранятся в SQLite и синхронизируются с объектным хранилищем. Но за дополнительные возможности приходится платить сложностью. Дедупликация требует вычисления хешей, сжатие расходует процессорное время, а восстановление файловой системы после сбоев может потребовать проверки и восстановления метаданных специальными утилитами. Это не критичные недостатки, но и особых преимуществ для моего сценария я не увидел.
Главное отличие в подходе. JuiceFS и S3QL сами реализуют файловые системы через FUSE. А s3backer предоставляет виртуальное блочное хранилище, поверх которого можно создать обычный ext4. В результате Docker работает с привычной файловой системой Linux, а s3backer занимается преобразованием блочных операций в запросы к S3. Никаких отдельных баз метаданных, никакой дедупликации или дополнительных уровней управления файлами.
Конечно, такое решение тоже имеет недостатки. Случайные операции чтения и записи могут сильно зависеть от задержек S3, а потеря соединения с хранилищем способна остановить работу контейнеров. Да и от повреждения файловой системы после серьезного сбоя никто не застрахован. Поэтому для критичных баз данных я бы такую схему не использовал. Но для хранения больших Docker-образов, которые один раз скачиваются и потом преимущественно читаются, идея показалась вполне разумной. Особенно когда S3 доступен через локальную сеть хостинг-провайдера. В общем, хотелось не строить распределенную систему хранения, а просто получить дополнительные 250 ГБ за €4 в месяц. С этой точки зрения s3backer оказался наиболее подходящим вариантом.


Комментарии 0