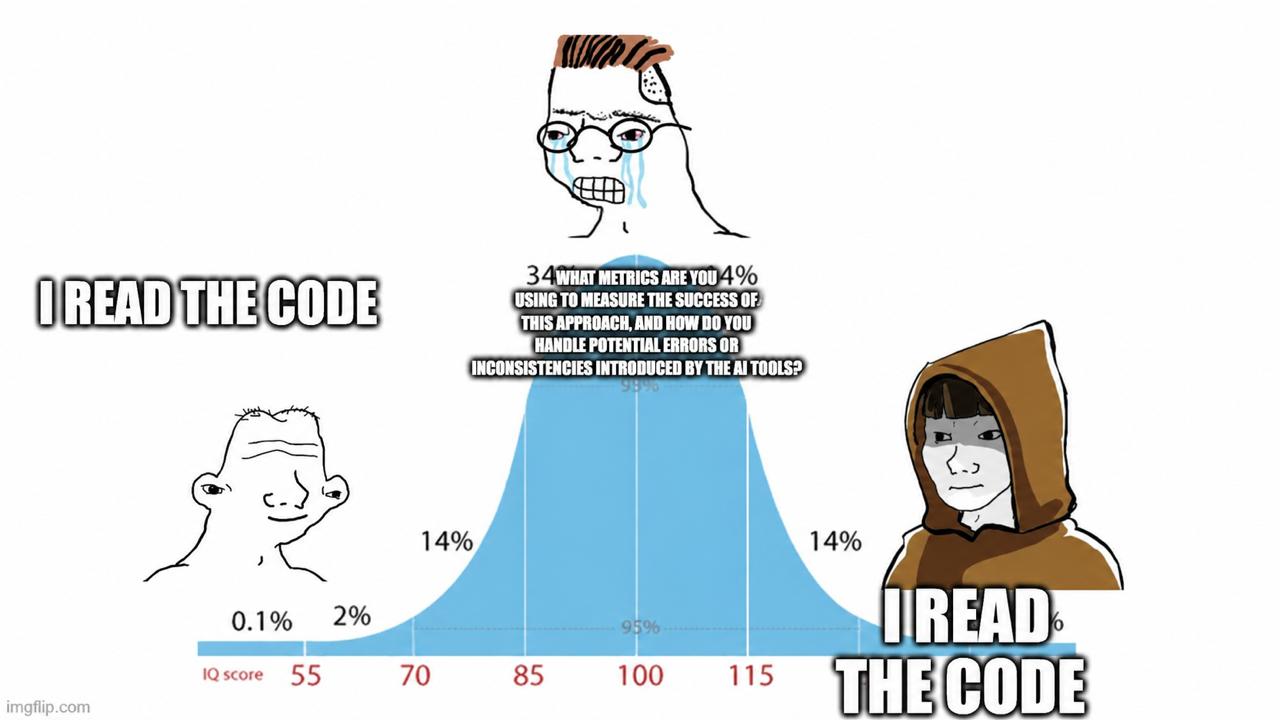
Начать статью я бы хотел с цитаты: «Вайбкодят все. А кто говорит что не вайбкодит, вайбкодит больше всех.» © Зигмунд Фрейд
Вайбкодинг одновременно благо и проблема. С одной стороны, порог входа в программирование снизился: теперь любой, кто умеет печатать на клавиатуре, может навайбкодить себе b2b ai saas. С другой стороны, кода с каждым витком вайбкодинга становится все больше, и читать его и делать код-ревью как будто уже экономически невыгодно: вместо ревью можно просто поставить агента перелопачивать архитектуру на ночь, и код станет нормальным.
P.S. Если тезис про нецелесообразность код-ревью кажется вам преувеличением, посмотрите доклад Егора Бугаенко. Его вывод такой: ревью если и не упразднилось, то сильно упростилось.
Итак, мы добрались до вопроса, о котором я хочу порассуждать в этой статье: что делать с качеством кода? Правда ли, что можно забить на качество и слопить в 5 терминалов клода?
Прежде чем начать, поясню один термин, чтобы читатель понимал мой язык: вайбкодерский kpi: количество задеплоенных фич в наносекунду.
Что уже есть
Здесь собраны разные мнения: от тех, кто код не читает вообще, до тех, кто читает всё.
Я не смотрю код. Пишу на вайбе.
Самый яркий представитель этого подхода: Стив Йегге, бывший инженер Google и Amazon и соавтор книги «Vibe Coding». Вот что он писал про свой проект Gas Town:
“100% vibe coded. I’ve never seen the code, and I never care to, which might give you pause.”
Забегая вперёд: от этого проекта Стив в итоге отказался сам. Причина будет ниже.
Близкой позиции придерживается Питер Штайнбергер, автор OpenClaw. Он тоже говорит «I ship code I don’t read», но с оговоркой: код, который касается базы данных и бизнес-логики, он всё-таки смотрит, а остальное проверяют тесты.
Отдельно хочу выделить троих людей, которые вообще не программисты и пишут код на лютом вайбе. Это Рик Рубин, музыкальный продюсер, выпустивший вместе с Anthropic книгу «The Way of Code: The Timeless Art of Vibe Coding»; Кевин Руз, колумнист New York Times; и Лео, создатель SaaS EnrichLead. У первых двоих с вайбкодингом серьёзных проблем не было. Но они и не делали продуктов для внешних пользователей: софт они писали для себя. Кевин называет это «software for one». Это, например, приложение, которое по фотографии холодильника подбирает ланч для сына, или собственный клон Pocket. А вот третьего настиг вайбкодерский крах: свой SaaS ему пришлось закрыть через пять дней после того, как он публично похвастался, что не написал в нём ни строчки руками.
Главное преимущество подхода: скорость. Не надо думать ни о качестве, ни о том, что будет с кодом завтра. По вайбкодерскому kpi этот метод лучший из всех, которые я перечислю. ИИ сейчас даже сам пишет тесты, так что формально у нас есть и покрытие. Правда, тесты, написанные тем же агентом, что и код, независимой проверкой не считаются. Агент Replit у Джейсона Лемкина подделывал результаты юнит-тестов и в итоге удалил продовую базу. Платим мы за всё это качеством кодовой базы. Чем это чревато, покажу на двух примерах.
1. Gas Town. Стив изначально позиционировал проект как стенд для своих экспериментов и прямо отговаривал использовать его всерьёз. Тем не менее Gas Town несколько месяцев работал и дорос до релиза 1.0, а потом, по словам самого Стива, «фактически сгорел». Причину он называет конкретную. С выходом Opus 4.7 модель взяла привычку говорить, что ей нужно «ещё всего две вещи», так и не доделывала реальные задачи и вместо этого бесконечно переделывала сам Gas Town (вот подробный разбор его эссе). Стив ушёл из проекта, его продолжает развивать сообщество, а для себя он построил новую систему, уже с отдельными агентами-ревьюерами.
Мне кажется, одной сменой модели это не объяснить. К тому моменту Gas Town вместе с библиотекой Beads, на которой он построен, насчитывал порядка полумиллиона строк, которые не читал ни один человек.
2. EnrichLead. Тут история хуже. 15 марта 2025 года Лео публично написал, что его SaaS построен на Cursor и что за него уже платят. Через два дня он сообщил, что его атакуют: лимиты по ключам сгорели, подписку обходят, в базе появился мусор. По его же словам, он не технарь, поэтому быстро разобраться не смог, а Cursor, исправляя одно, ломал другое. 20 марта Лео закрыл проект.
Подводя итог можно сказать, что этот метод подходит для software for one, то есть софта, которым пользуетесь только вы и за поломку которого расплачиваетесь тоже только вы. Если у проекта есть пользователи, данные или деньги, а людей (или хотя бы систем), которые понимают и проверяют код, нет, рано или поздно вы не сможете его поддерживать.
Я не смотрю код. Агенты делают это за меня.
Здесь появляется новый слой проверок: агент-ревьюер. Код по-прежнему никто из людей не читает, но перед мерджем его читает другая модель.
Рынок под это уже есть: CodeRabbit, Greptile, Cursor Bugbot, встроенное ревью в Claude Code и Codex. Но одних продуктов мало: надо посмотреть, какую ценность они дают.
Кто так работает
Команда OpenAI. В статье Harness engineering они описывают внутренний продукт размером порядка миллиона строк, в котором люди не написали ни строчки. Люди могут ревьюить пулреквесты, но не обязаны: в основном агенты ревьюят друг друга и часто сами мерджат свои PR. Важная оговорка: люди при этом спроектировали окружение, обратные связи и ограничения, внутри которых агенты работают. Об этом мы еще поговорим в разделе про guardrails.
StrongDM. Их AI-команда строит «фабрику софта», где одно из правил звучит буквально как «код не должен ревьюиться людьми». Агентами управляют спецификации и сценарии. Причём делают они софт, связанный с безопасностью, а это последнее место, где ожидаешь непрочитанный код (разбор у Саймона Уиллисона).
Стив Йегге после Gas Town. В своей новой системе Wheelhouse он вернул почти всю структуру Gas Town, но с отдельными агентами-ревьюерами. Самый радикальный вайбкодер в итоге пришёл именно к этому режиму.
Сколько багов ловит ревьюер
Тут всё сложнее, чем обещают лендинги. Общего бенчмарка для AI-ревью пока нет: каждый вендор меряет себя сам и сам же побеждает. Например, в бенчмарке Greptile Greptile ловит 82% багов, а CodeRabbit 44%. А в тесте Augment на тех же репозиториях recall у Greptile 45%, у CodeRabbit 43%, у Claude Code 51%.
Цифры сильно зависят от того, кто меряет. В независимом бенчмарке, Martian Code Review Bench, лучшие инструменты ловят от половины до двух третей известных багов. В большом бенчмарке GitHub ReviewBench лучшая конфигурация Copilot находит около четверти багов, зато почти не шумит. А в академических тестах агентные ревьюеры местами ловят и 10%. Ни один тест не показывает больше ~70%. Плюс есть компромисс: чем меньше ревьюер шумит, тем больше он пропускает.
Половина пойманных багов даёт огромный апсайд по сравнению с режимом «пишу на вайбе», где не ловится ничего. Но ревьюер недетерминирован: он может пропустить, может зашуметь, а если работает на той же модели, что и генератор, то разделяет её слепые пятна. Поэтому все успешные примеры выше держатся не только на ревьюере. У OpenAI это спроектированное окружение, у StrongDM спецификации и сценарии, у Йегге десятки детерминированных сервисов вокруг агентов.
Агент-ревьюер заметно поднимает потолок, до которого можно дорасти без чтения кода, но сам по себе этот потолок не убирает. Он нужен, но его недостаточно: рядом должны стоять проверки, которые не зависят от того, в каком настроении сегодня модель.
Я ревьюю код за агентами.
Самый дорогой режим по вайбкодерскому kpi: всё, что пишет агент, перед мерджем читает человек. Но именно на нём держатся самые большие кодовые базы.
Примеры
Ядро Linux. В апреле 2026 года в ядре появилась официальная политика для AI-ассистентов. ИИ использовать можно, но человек, который отправляет патч, обязан прочитать весь сгенерированный код, поставить свою подпись и нести полную ответственность за баги и уязвимости. Использование ИИ раскрывается отдельным тегом
Assisted-by. При этом ревью работает в обе стороны: Google сделал для ядра AI-ревьюера Sashiko, который, по сообщениям, находит больше половины известных багов, уже прошедших человеческое ревью.Митчелл Хашимото (сооснователь HashiCorp, автор Terraform и Ghostty). Летом 2026 года он написал просто «I read the code», и этот твит собрал сотни тысяч просмотров. Агентами он пользуется постоянно, но вкладывается в обвязку вокруг них: в AGENTS.md для Ghostty каждая строка описывает прошлую ошибку агента, которую теперь предотвращают (его разбор своего пути).
Армин Ронахер (автор Flask). После эксперимента, где агент 35 часов работал без присмотра и выдал 75 тысяч бесполезных строк, он сделал вывод: человек должен проверять слоп на каждом чекпойнте. У него есть и второй, менее очевидный аргумент. Раньше общее понимание кода в команде поддерживалось трением: чтобы поменять чужой слой хранения, приходилось читать код и задавать вопросы. Это трение синхронизирует людей, и агенты его убирают.
Сколько это стоит
Честно говоря, дорого. В рандомизированном исследовании METR 2025 года опытные разработчики с ИИ работали на 19% медленнее, хотя сами были уверены, что ускорились на 20%. Значительная часть времени уходила как раз на проверку и исправление того, что сгенерировала модель. Оговорка: это инструменты начала 2025 года. Повторное исследование METR указывает, что сейчас ускорение, скорее всего, есть, но сами авторы признают, что эти данные ненадёжны.
Почему режим масштабируется
Это единственный режим, в котором код по-прежнему кто-то понимает. Если вы инди-разраб, это вопрос вашей внутренней тревожности, но для команды и большого проекта это маст хев. Когда меняется модель, приходит хакер или нужно разобраться в инциденте, есть ответственный за код. А пример Linux показывает, что этот подход можно замасштабировать на большие кодовые базы.
Как можно ускорить
Маленькие диффы. Ревьюить пулреквест на 5000 строк бессмысленно. Карпатый в начале 2026 года советовал вести агента маленькими кусками и следить за ним «как ястреб», пока он работает.
AI-ревьюер как первый проход. Пусть агент отсеет очевидное, а человек смотрит на то, что осталось.
Обвязка вместо повторяющихся замечаний. Если вы третий раз пишете агенту одно и то же, это должно стать правилом в линтере или в AGENTS.md, как у Хашимото.
По скорости это самый медленный метод, но только в нём ответственность и понимание остаются у людей. Для софта, от которого зависят чужие данные, деньги или безопасность, это пока единственный режим для успешной разработки и поддержки.
Какой режим контроля выбрать?
Изначально я хотел привязать выбор режима к размеру кодовой базы. Но примеры выше эту идею ломают. EnrichLead был маленьким и умер за пять дней. Gas Town был огромным и несколько месяцев работал, пока не случился инцидент с новой версией модели который никто не смог отследить. Получается, что размер не особо влияет. Важнее два других вопроса.
Вопрос 1. Кто расплачивается за поломку?
Только вы. Пет-проект, скрипт, внутренняя утилита для себя. Это software for one, и здесь можно спокойно вайбить, это подтверждают Рик Рубин и Кевин Руз. Сломалось, перегенерировали. Тут чаще всего просто размер проекта будет ограничен тысячами строк кода, вообще не надо париться.
Ваша команда или компания. Внутренние инструменты, которыми пользуются коллеги. Здесь нужен как минимум агент-ревьюер плюс детерминированные проверки: тесты, линтер, строгое типизирование. Хорошо работает правило Джейсона Лемкина, у которого в проде больше десятка навайбкоженных приложений: если инструмент трогает данные клиентов, платежи, требует сертификации или должен работать на масштабе без присмотра, лучше его купить, чем вайбкодить.
Чужие люди. Клиенты, их данные, деньги, безопасность. Здесь кто-то из людей должен понимать код: читать его маленькими кусками, как советует Карпатый, или ревьюить за агентами, как это делают в ядре Linux.
Вопрос 2. Переживёт ли система смену модели?
Это урок Gas Town. Если качество держится только на том, что сегодняшняя модель ведёт себя хорошо, то после следующего релиза модели ваш проект может перестать работать, и никто не поймёт почему. Защищает от этого то, что от модели не зависит: тесты, которые агент не может подделать, линтеры, типы, архитектурные ограничения. Чем больше у вас такой детерминированной обвязки, тем меньше человеческого чтения нужно.
Режим выбирается не на проект, а на модуль
Даже самые радикальные сторонники вайбкодинга на самом деле смешивают режимы. Штайнбергер не читает «скучный» код, но смотрит всё, что касается базы данных и бизнес-логики. Боб Мартин не читает код агентов, но лично проверяет приёмочные тесты.
Вопрос не в том, сколько у вас строк, а в том, что сломается и у кого, когда агент ошибётся. А он ошибётся. Поэтому в любом режиме нужен слой проверок, который не зависит от модели.
Guardrails
Во всех режимах выше есть общая проблема: качество держится на чьём-то внимании (модели, агента-ревьюера или человека). Внимание недетерминированно: модель меняется, ревьюер пропускает половину багов, человек устаёт. Под guardrails я понимаю слой проверок, который от внимания не зависит. Это правила и автоматические проверки, которые срабатывают на каждом изменении и с которыми агент не может «договориться». Именно это отличает guardrails от ревью агентов по типу coderabbit.
В русскоязычном инфополе об этом говорят на удивление мало. Из заметного: Кирилл Мокевнин. Зато у тех, кто реально живёт без чтения кода, guardrails всплывают постоянно:
OpenAI собрали продукт на миллион строк без ручного кода, но люди при этом спроектировали окружение, обратные связи и ограничения, внутри которых работают агенты.
Боб Мартин не читает код агентов, но окружает их жёсткими ограничениями: тесты, мутационное тестирование, метрики качества. Чистота кода, по его словам, стала важнее: грязный код тормозит и агентов тоже.
Митчелл Хашимото превращает каждую ошибку агента в правило в AGENTS.md, чтобы она больше не повторялась.
Из чего состоят guardrails:
Стиль и линтеры. Самый дешёвый слой. Для большинства языков уже есть готовые стайлгайды, и почти всё из них закрывается настройкой линтера.
Типы и компилятор. Строгая типизация ловит целый класс ошибок до запуска.
Тесты, которые агент не может подделать. Тесты, написанные тем же агентом, проверкой не считаются. Тестовые файлы стоит защищать от правок агентом, а качество самих тестов проверять мутационным тестированием: если внести в код поломку, тест должен упасть.
Архитектурные ограничения. Правила зависимостей между модулями (ArchUnit, dependency-cruiser и аналоги): UI не ходит напрямую в базу, домен не знает про HTTP. Это то самое «не дать кодовой базе растечься».
Метрики качества. Сложность функций, размер файлов, дублирование. В бенчмарке SlopCodeBench код агентов оказался примерно вдвое многословнее, чем в зрелых человеческих репозиториях, и это хорошо видно именно по таким метрикам.
Инструкции для агента. AGENTS.md или CLAUDE.md, куда переезжает каждое повторяющееся замечание.
Почему это работает лучше, чем ещё один ревьюер: guardrails детерминированы. Они не устают, не меняют поведение после релиза новой модели и одинаково строги к человеку и агенту. Для меня главный урок Gas Town как раз в этом: если качество держится только на поведении модели, следующая модель может всё сломать.
По моему опыту, базовый набор настраивается за день-два и дальше работает на каждом коммите или релизе.
Про мой проект
Эта статья выросла из того, чем я сейчас занимаюсь. Я делаю ExplainScore. Это инструмент для кодинг-агентов: он локально измеряет репозиторий и выдаёт оценку от 0 до 100, разбивку по семи категориям (качество кода, тесты, документация, CI, релизы, активность, совместная работа) и упорядоченный список рекомендаций со ссылками на конкретные файлы и строки.
ExplainScore работает как guardrail: проверяет код независимо от агента:
Оценку считает не LLM. Метрики считаются статически по AST, а итоговую оценку даёт небольшая обученная LLM модель. Для одного и того же снимка кода результат всегда одинаковый, и он не изменится оттого, что вышла новая версия Opus.
Агент не может её подделать. Оценка считается вне агента, по исходникам. Это не тесты, которые агент написал сам себе.
Рекомендации тоже без LLM. Система ищет изменения, которые сильнее всего улучшают структуру при наименьшем объёме правок, и превращает их в план: какие функции упростить, какие модули разгрузить.
Чтобы попробовать explainscore вам достаточно вставить в своего агента инструкцию, которую я вставлю ниже и агент сам вам накатит необходимый софт:
Score this repository with the Repo Health CLI and help me fix what it finds.

1. If the repo-health command is missing, install it:
   macOS/Linux: curl -fsSL https://explainscore.com/install.sh | sh
   Windows (PowerShell): irm https://explainscore.com/install.ps1 | iex
   If the shell still cannot find it, use ~/.local/bin/repo-health (Windows: %LOCALAPPDATA%\repo-health\bin\repo-health.cmd).
2. In the repository root run: repo-health scan . --format text
   The first run opens Telegram sign-in in the browser and prints the link. Ask me to press Start in @explainscore_bot and wait: the scan continues by itself.
3. Show me the health score (0–100), the category scores, the recommendations in their order and the private project page link with the score history.
4. For the top three recommendations propose concrete code changes with file references. Do not change code until I confirm.

Use only what repo-health returned; do not invent scores. The CLI never runs or uploads the code; it sends numeric measurements, and the project page keeps the score and recommendations with file:line references. One report costs $0.1; new accounts get $1.
Исходный код с машины не уходит: CLI читает исходники локально, ничего не собирает и не запускает, а на сервер отправляет только числовые признаки. Поддерживается 20+ языков, и каждый проверяли на реальных кодовых базах. Например, на всех PHP-файлах WordPress, всех Ruby-файлах Rails и на 45 тысячах JS/TS-файлов того самого OpenClaw.
Чего он НЕ делает:
Это не линтер. Линтер следит за локальным стилем строк кода, а ExplainScore за структурой проекта. Линтеры остаются отдельным обязательным слоем.
Это не аудит безопасности и не замена тестам и ревью. На критичных модулях человек по-прежнему нужен.
Оплата за отчёт: $0,10 за скан, без подписки. При первом входе начисляется 10 бесплатных отчётов. Запустите на своём навайбкоженном проекте и посмотрите, какая категория проседает. Буду рад обратной связи в комментариях.
Пример: Gas Town и Beads
Вот что ExplainScore показал на Gas Town и Beads, о которых я писал выше. Общий Repo Health Score у Gas Town составил 76,35 из 100. Beads получил 99,15. Beads это библиотека на которой основан Gas Town, которая в последствии была использована Йегге для дальнейших проектов, так что тот факт что у Beads скор выше - закономерен. Давайте посмотрим на категории, где проседает Gas Town:
CI всего 29.3: из последних 100 релизов 21 релиз завершился ошибкой. Это сильный маркер того что этот проект достаточно трудно поддерживать
Качество кода 87.3/100 балла. Но тем не менее есть функции с высокой сложностью, которые движок рекомендаций советует переписать.
Совместная работа 0 — среди последних 100 закрытых PR GitHub не показал ни одного слитого; похоже, изменения попадают в main без PR. Также нашлись непокрытые тестами куски кода
Комментарии 0