Задача, которая часто приходит от продавцов на маркетплейсах: есть одно фото товара, нужен вертикальный ролик на 15 секунд, на предметную съёмку бюджета нет. Я собрал конвейер, который делает такой ролик через API: картинки в Gemini, раскадровка и промпт текстовой моделью, видео в bytedance/seedance-2.0 через OpenRouter, точечные пересъёмки планов. В статье код вызова Seedance и пересъёмки плана, четыре типа брака, которые конвейер выдаёт на товаре, и счёт: первый дубль $2,42, исправления ещё $1,83.
Схема
Фото товара. У клиента оно обычно есть. Для теста я сгенерировал выдуманную сыворотку «СЕВЕР» в
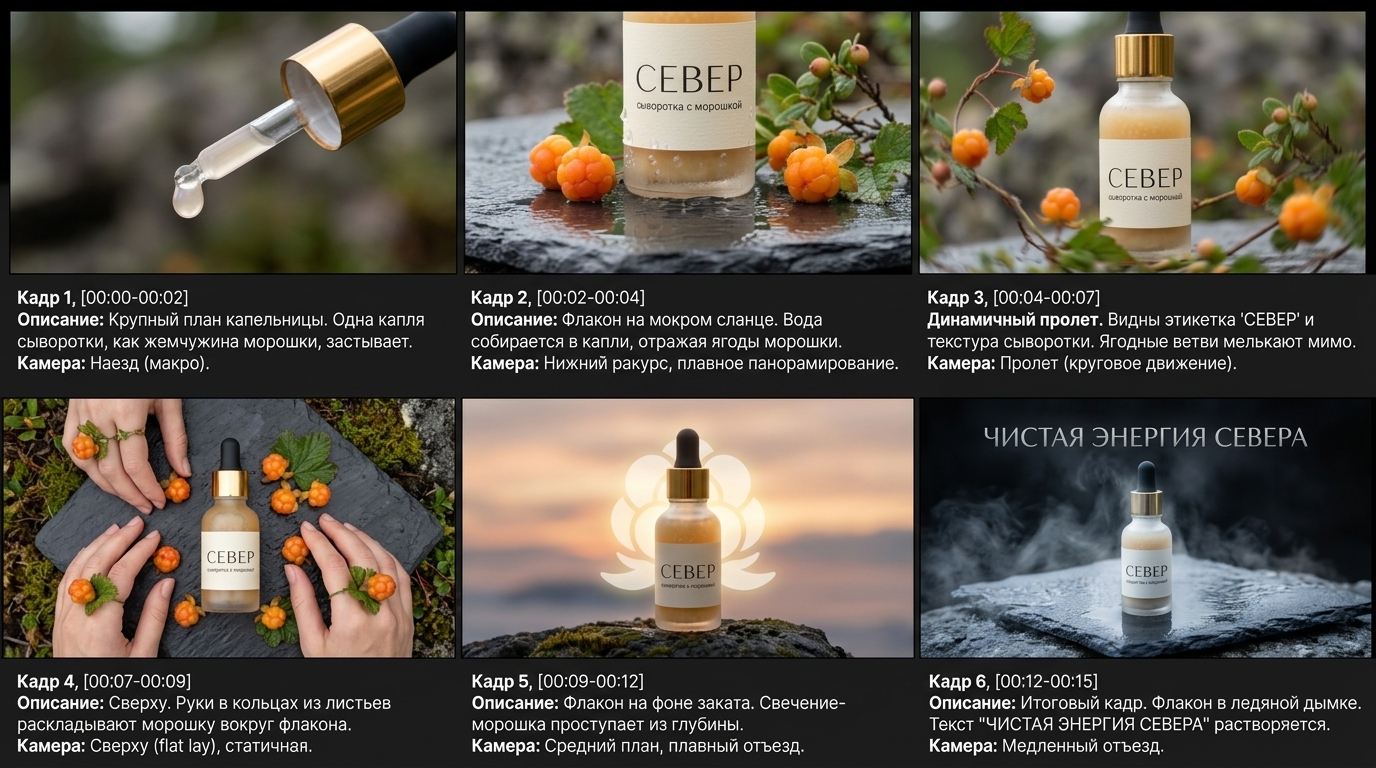
gemini-3.1-flash-image.Раскадровка. Фото товара плюс бриф уходят в генератор картинок: шесть кадров сеткой 2 на 3, хронометраж под каждым.
Промпт для видео. Раскадровка уходит в текстовую модель, она пишет промпт для Seedance по кадрам с таймкодами.
Видео. Фото и раскадровка уходят в Seedance референсами, 15 секунд, 9:16, 720p со звуком.
Отбор и пересъёмка. Ролик смотрится покадрово, сломанные планы переснимаются по одному, текст ставится в монтаже.
Шаги 1-4 занимают около получаса, из них восемь минут - ожидание видео. Шаг 5 занимает остаток вечера, и автоматизировать его целиком у меня не вышло.
Шаг 4. Видео через OpenRouter
OpenRouter отдаёт видеомодели асинхронно: POST /api/v1/videos создаёт задачу, дальше опрашиваешь GET /api/v1/videos/{id}, пока status не станет completed. Готовая задача приходит со ссылкой на файл и с usage.cost в долларах, так что цену дубля не нужно считать по токенам.
import base64, json, mimetypes, time, urllib.request

BASE = "https://openrouter.ai/api/v1"
KEY = open("/path/to/openrouter-key").read().strip()

def call(url, body=None, raw=False):
    req = urllib.request.Request(url, data=json.dumps(body).encode() if body is not None else None,
                                 headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=300) as r:
        return r.read() if raw else json.load(r)

def image_item(path, frame_type=None):
    mt = mimetypes.guess_type(path)[0] or "image/png"
    item = {"type": "image_url",
            "image_url": {"url": f"data:{mt};base64,{base64.b64encode(open(path, 'rb').read()).decode()}"}}
    return item | ({"frame_type": frame_type} if frame_type else {})

def seedance(prompt, out, refs=(), first=None, seconds=15, audio=True):
    body = {"model": "bytedance/seedance-2.0", "prompt": prompt, "duration": seconds,
            "aspect_ratio": "9:16", "resolution": "720p", "generate_audio": audio}
    if first:   # режим кадров: картинка становится первым кадром
        body["frame_images"] = [image_item(first, "first_frame")]
    elif refs:  # режим референсов: картинки - ориентир, а не кадры
        body["input_references"] = [image_item(p) for p in refs]
    job = call(f"{BASE}/videos", body)
    while True:
        time.sleep(10)
        st = call(f"{BASE}/videos/{job['id']}")
        if st["status"] == "completed":
            break
        if st["status"] == "failed":
            raise RuntimeError(json.dumps(st)[:400])
    open(out, "wb").write(call(st["unsigned_urls"][0], raw=True))
    return st.get("usage", {}).get("cost")
Два режима работают по-разному. input_references - это ориентир: модель берёт с фото упаковку и цвета, с раскадровки последовательность планов, но кадры строит сама. frame_images с first_frame - это точный первый кадр. Первый режим нужен для всего ролика, второй для пересъёмки одного плана. Есть и третий: first_frame плюс last_frame, когда модель достраивает движение между двумя кадрами.
В режиме референсов роли картинок я называю в начале промпта: первая - единственный образец флакона, этикетку не менять; вторая - только порядок планов. Это главная защита от перерисовки упаковки.
Время в моих прогонах: 15 секунд генерировались около восьми минут, план на 4 секунды около трёх.
Шаг 5. Пересъёмка одного плана
Когда сломан один план из шести, перегенерировать весь ролик за $2,27 нет смысла. Я вырезаю последний кадр предыдущего плана, отдаю его как first_frame и прошу продолжить движение. Так стык получается без прыжка.
# последний кадр второго плана: у меня он кончался около 3,8 с, подставьте свой таймкод
ffmpeg -v error -ss 3.75 -i product-video.mp4 -frames:v 1 sc2-last.png
cost = seedance(continue_prompt, "sc3.mp4", first="sc2-last.png", seconds=4, audio=False)
Звук для вставки я выключаю: generate_audio: false. Цены это в моём тесте не изменило, около $0,15 за секунду и со звуком, и без. Причина другая: одна из пересъёмок со звуком упала с ошибкой фильтра: модерация решила, что сгенерированная музыка похожа на чужую. Вставка всё равно ляжет под общий трек, так что звук в ней не нужен.
Четыре типа брака
С первого дубля ролик выглядит готовым: шесть планов по раскадровке, этикетка читается в каждом. На покадровом просмотре находится четыре брака, и все четыре типичны для товара.
Ошибка в тексте на экране. В финальном кадре модель написала слоган с буквой «Е» вместо «Э». Слоган пришёл из раскадровки, текстовая модель перенесла его в промпт, видеомодель нарисовала. Вывод для конвейера: в промпт для видео не должно попадать никакого нового текста, только надпись на этикетке. Титры ставятся в монтаже. Это правило я теперь передаю текстовой модели явно: «Не добавляй слоганы, титры и любой новый текст».
Приклеенная этикетка. Камера облетает флакон, фон меняется, а этикетка всё время смотрит в камеру, будто флакон крутится вместе с камерой. С одного фото модель знает одну сторону товара и держится за неё. Надёжный выход в моём тесте: боковой проезд вдоль товара или облёт не больше чем на четверть круга. Несколько ракурсов товара на входе, вероятно, тоже помогут, но это я не проверял.
Прыжок на стыке. Два соседних плана сняты почти с одной точки, на склейке флакон смещается на пару сантиметров, ягоды переставляются. Соседние планы должны резко отличаться крупностью или ракурсом, иначе склейка читается как сбой.
Модель игнорирует переходы. Я заказал мягкое растворение между четвёртым и пятым планом, а получил жёсткую склейку. Заказал продолжение движения «слева направо», и камера на стыке развернулась: в исходном плане модель уже ехала не туда, куда я писал в промпте. Продолжение надо заказывать по тому, что видно в кадре, и описывать видимым движением: «вся сцена уезжает вправо» надёжнее, чем «камера едет влево». Переходы надёжнее делать в монтаже.
Цифры
Что | Модель | Цена |
|---|---|---|
Фото товара и раскадровка |
| $0,14 |
Промпт по раскадровке |
| около $0,01 |
Ролик 15 секунд со звуком |
| $2,27 |
Три пересъёмки по 4 секунды без звука |
| $1,83 |
Итого | около $4,25 |
Оплачено 27 секунд видео, в ролик вошли 15: коэффициент расхода 1,8. Первый дубль вместе с кадрами и промптом стоил $2,42, исправления почти столько же. Цены на 8 октября 2026, картинки по тарифу Gemini API, видео через OpenRouter, без комиссий.
Ограничения API, о которых стоит знать заранее
Лица. В моём тесте bytedance/seedance-2.5 через OpenRouter отклонил фотореалистичные изображения людей на входе с ошибкой InputImageSensitiveContentDetected.PrivacyInformation. На 2.0 я это отдельно не проверял, но это одна линейка и одна защита ByteDance. Для товара это не мешает, но ролик «товар в руках у героя» с вашим персонажем этим путём не сделать: героя придётся описывать словами. Отклонённые запросы в моих тестах денег не стоили.
Модерация на выходе. Фильтр срабатывает и после генерации: в разных моих тестах отсекали и видео, и музыку как похожие на чужие. Списали только за удачные попытки, но время ожидания теряется.
Текст на упаковке. Модель держит надпись с фото, но любит её подправлять. Каждую надпись сверяйте с оригиналом буква в букву, в каждом плане.
Что проверяю перед сдачей
Надписи на товаре читаются в каждом плане и совпадают с оригиналом.
Нового текста в кадре нет, титры только из монтажа.
На облёте этикетка поворачивается вместе с товаром.
Соседние планы отличаются крупностью или ракурсом.
Движение камеры на стыке продолжается в ту же сторону.
В звуке нет случайной речи и пения. Это я проверяю расшифровкой: отдаю клип
gemini-flash-latestцеликом (видео уходит inline, до ~18 МБ) и прошу перечислить всю речь с таймкодами.
Пункт 6 автоматизируется легко, пункты 1-5 пока только глазами, на листе кадров.
Итог
Конвейер из одного фото до 15-секундного ролика собирается примерно за полчаса, включая восемь минут ожидания видео, сервисы стоят $2,42 за первый дубль. Но в рекламе товара первый дубль почти никогда не финальный: закладывайте на исправления столько же, сколько на первый прогон, держите текст вне генерации и проверяйте этикетку покадрово.
Схему с раскадровкой из фото я взял с доски Руслана Гамзатова и перенёс в API. Разборы роликов с промптами, браком и счётом выкладываю в Telegram-канале @tairantino.

Комментарии 0