Современный человек, который хоть иногда пользуется нейросетью, сразу подмечает ИИ-паттерны в текстах. Дело в том, что главная задача модели при обучении — предсказать наиболее вероятное слово на основе миллионов усредненных текстов из интернета. Даже если вы просите скопировать стиль конкретного автора, нейросеть опирается на шаблоны, которые находит в своих весах, сглаживая острые углы и избегая редких или рискованных речевых оборотов.
Мы разобрали, как рождается ИИ-текст, каковы его особенности и как грамотно настроить стиль ответа.
Коротко: почему нейросеть пишет как нейросеть
Стерильная и пафосная лексика. Из-за фильтров безопасности модель избегает резкости и грубости, превращая даже злой сарказм в вежливую имитацию. Поэтому ИИ так любит пустые штампы («погрузиться», «ключевой», «многогранный», «в современном мире») и кальки с английского («гобелен», «симфония»).
Монотонный ритм и шаблоны. При генерации ИИ стремится к статистическому среднему, поэтому держит предложения в безопасном диапазоне 12–18 слов и не меняет темп так, как это делает человек под влиянием эмоций и мыслей. Модель избегает рваного синтаксиса, поэтому в перечислениях постоянно использует три слова и старается все предложения делать одинаковыми.
Структура школьного сочинения. ИИ почти всегда начинает с общего захода издалека и заканчивает моралью («Таким образом...», «В конечном счёте...»). Он склеивает абзацы вводными словами («более того», «однако») и прямо называет эмоции вместо того, чтобы показать их через детали.
Поверхностная имитация стиля. Модель легко копирует внешние маркеры автора вроде сленга или длины фраз, но не способна воспроизвести его уникальный ход мыслей. Недостающие фрагменты ИИ заполняет своим стандартным усреднённым слогом, а его попытки имитировать живую небрежность выглядят нарочито.
Что показывают исследования имитации стиля
Образцы помогают, но не достигают цели
Работа «Catch Me If You Can? Not Yet» проверила, хватит ли модели нескольких прежних текстов автора, чтобы воспроизвести его манеру. Образцы стабильно улучшали результат по сравнению с отсутствием образцов. Но на блогах и форумах — неформальном стиле обычных людей — модели скатывались в обобщённый «ИИ-тон». Проверка авторства в блогах подтверждалась лишь в 8–20% случаев, а тексты GPT-4o в ряде категорий почти не проходили как человеческие. Новости и деловые письма модели имитировали лучше. Объяснение простое: в таких жанрах важны формат и регистр, их модель схватывает быстро.
Ближе к стилю не значит незаметнее
В другом исследовании без образцов проверка авторства подтверждалась менее чем в 7% случаев. Главное наблюдение: заметность текста как машинного не зависела ни от стратегии промпта, ни от того, насколько точно модель попала в стиль. Можно приблизиться к манере автора, но привкус ИИ-шности остается.
Стилометрия видит разницу
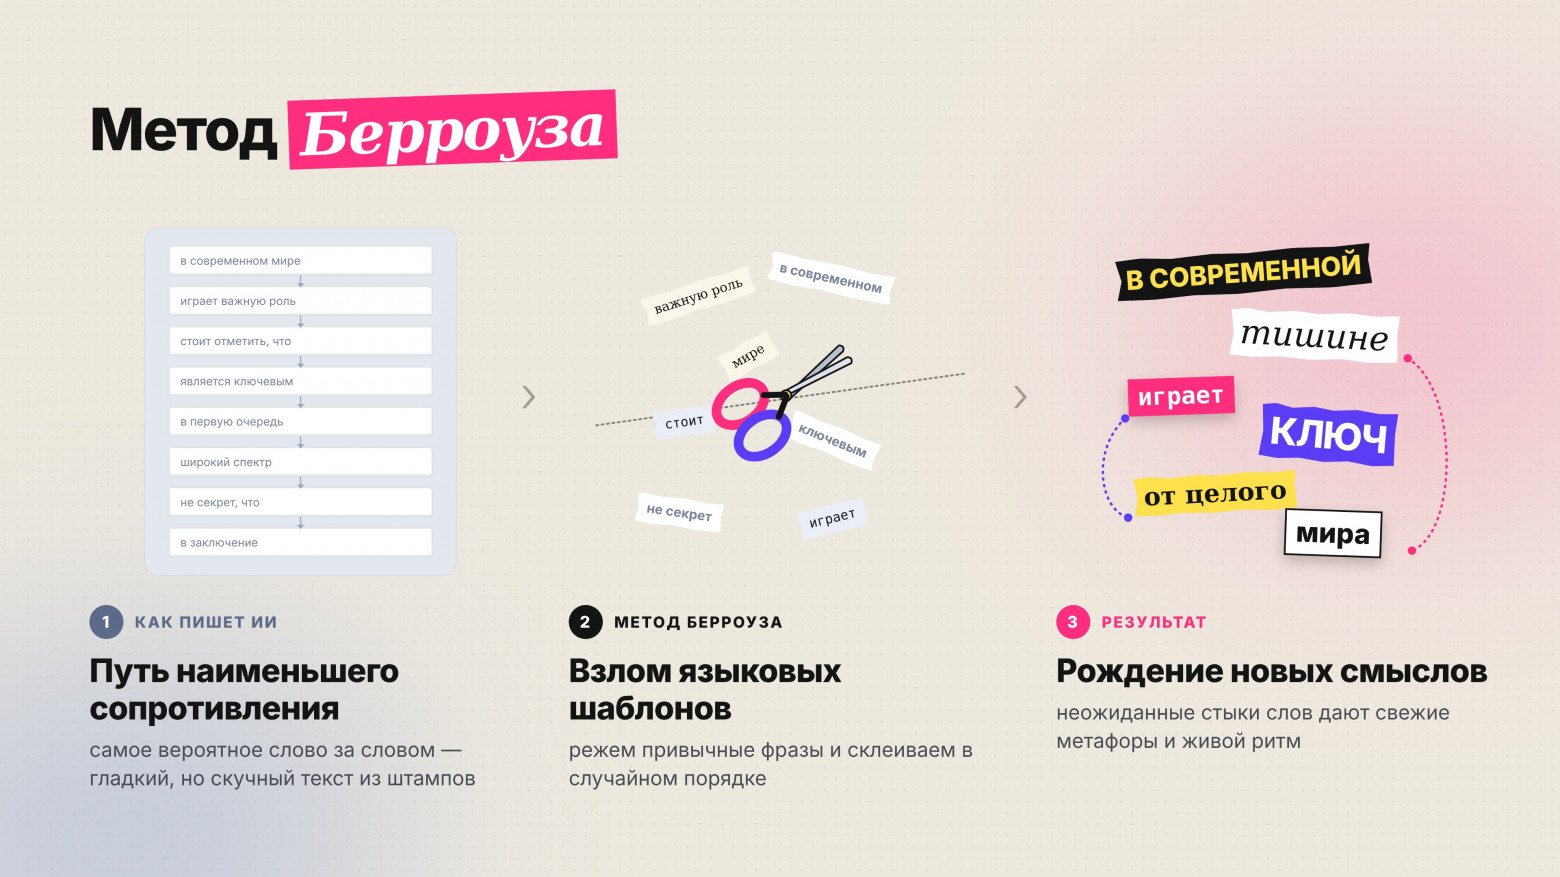
Классические методы атрибуции текстов, которые десятилетиями применяют в литературоведении, тоже разделяют людей и модели. В анализе по методу Берроуза тексты людей и моделей образуют разные кластеры, даже когда модель имитирует конкретного автора. Имитации одного автора, сделанные GPT-4o, группируются между собой, но отделимы от настоящих текстов этого автора.
Откуда берется «голос по умолчанию»
Оценщики любят типичное
После предобучения модель дообучают на человеческих оценках: люди выбирают, какой из ответов лучше. Статья о методе Verbalized Sampling объясняет, почему после такого дообучения тексты становятся однообразнее: оценщики систематически предпочитают знакомый, ожидаемый текст. Авторы называют это предвзятостью к типичности.
Важная деталь: по их данным, разнообразие у модели не уничтожено, а скрыто. Его можно частично вернуть промптом — например, попросив модель сгенерировать несколько вариантов вместе с вероятностями.
Выровненные модели однороднее людей
Это подтверждают и другие работы. Модели после дообучения на оценках дают меньше вариативности, чем люди и базовые версии тех же моделей, а базовые версии лучше справляются с непредсказуемыми задачами, включая творческое письмо. Выбор имён, мест и профессий персонажей в историях, которые пишут языковые модели, исследователи связывают именно с данными предпочтений, а не с корпусом предобучения. Писатели, работающие с GPT-4, создают более качественные, но и более похожие друг на друга истории.
Вывод для имитации стиля: промпт «пиши как автор» сдвигает распределение, но не снимает общую тягу модели к типичному.
Сравнить стиль ChatGPT, Claude и Gemini
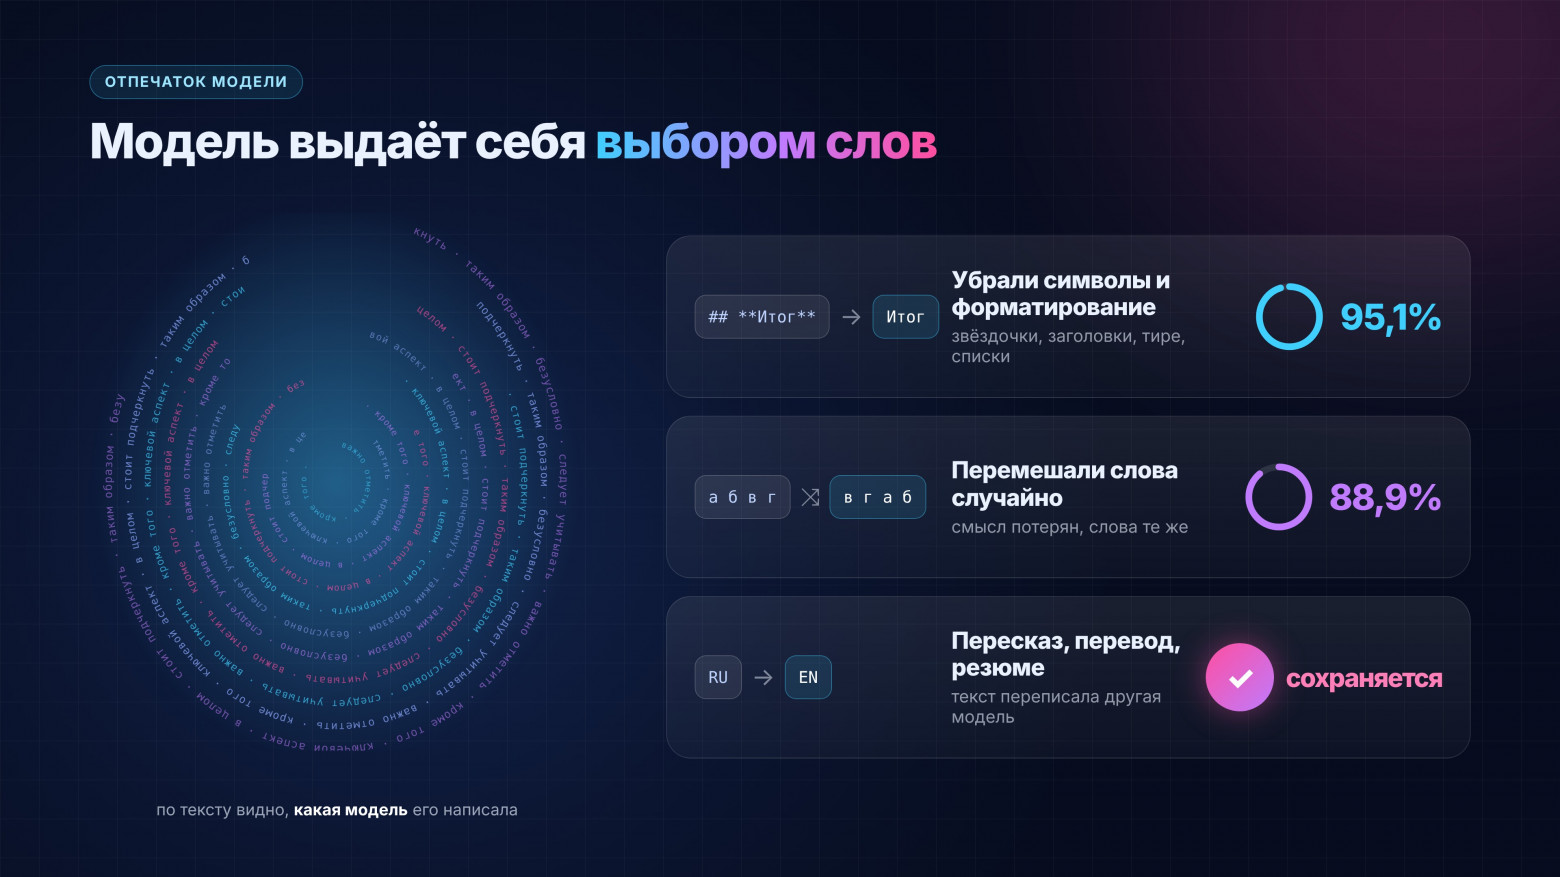
У каждой модели свой отпечаток, и он переживает правку
Работа «Idiosyncrasies in Large Language Models» показала, что модели отличаются друг от друга не меньше, чем от людей. Классификатор определял, какая из пяти моделей — ChatGPT, Claude, Grok, Gemini или DeepSeek — написала текст, с точностью 97,1% при случайном угадывании 20%.
Метки меняются быстро: что устарело, а что осталось
Длинное тире больше не примета
Ещё недавно длинное тире считали главным признаком ИИ-текста. Но разработчики учли критику. По оценке SEO-агентства Graphite (10 тыс. статей Claude Opus 5.5 VS 10 тыс. человеческих), в текстах Opus 5.5 тире почти исчезло: модель ставит его всего полтора раза на 100 000 слов. Это на 99% меньше, чем у Opus 5, и в сто с лишним раз реже, чем пишут люди.
Слова и обороты остаются
Та же работа Graphite нашла более 2500 слов, фраз и конструкций, которые в текстах Opus 5.5 встречаются минимум вдвое чаще, чем у людей. Среди английских примеров — «robust» (в 23 раза чаще), «clearer» (в 14 раз), «matters because» (в 146 раз). Стилистически выделяются шаблонные концовки, более длинные слова, частые запятые и «манерная проза» — образность там, где уместна прямота. У Opus 5.5 её на 37% меньше, чем у Opus 5, но всё ещё в 1,6 раза больше, чем у людей.
Русскоязычные маркеры
Для русского языка систематических исследований на современных моделях пока мало. Практические чек-листы и русская Википедия называют такие признаки:
конструкции «не только…, но и…» и «это не просто…, это…»;
слова-связки: «вкратце», «в заключение», «в целом»;
тройные перечисления;
симметричные абзацы одинаковой длины;
избыток длинных тире.
Исследование на корпусе из более чем 56 тыс. предложений указывает на новые приметы в пунктуации и длине фраз, но авторы сами предупреждают: такие метки быстро исчезают.
Вывод: любой список «слов-маркеров ИИ» нужно датировать и привязывать к версии модели. Через полгода он может описывать уже другую реальность.
Устойчивее всего структура
Если слова и пунктуацию модели меняют от версии к версии, то способ строить текст меняется медленнее. Исследование StoryScope проанализировало 61 608 рассказов по 10 272 промптам — по одному человеческому и пять от разных моделей на каждый промпт.
Результаты:
только по признакам сюжета и построения текста — активность персонажей, хронология — детектор отличал ИИ-рассказы от человеческих с точностью 93,2%;
только по стилю — 85,8%;
правка поверхности текста почти не помогала: точность снижалась с 95,5% до 93,9%.
ИИ-рассказы «объясняют» тему, тяготеют к аккуратному однолинейному сюжету и часто проговаривают мораль. Их признаки собираются в узкой области, а у людей разброс гораздо шире. Оговорка: это художественная проза длиной около 5000 слов, на смешанных текстах — человек плюс правка ИИ — и на деловых текстах метод не проверялся.
Что на самом деле убирает «ИИ-вид»: дообучение, а не промпт
Самое сильное исследование по теме провели Чакрабарти, Гинзбург и Диллон:
28 читателей с профессиональным писательским образованием и 516 образованных читателей сравнивали отрывки до 450 слов в стиле 50 известных авторов;
одни отрывки писали сами авторы, другие — ChatGPT, получивший образцы в промпте, третьи — ChatGPT, дообученный на полных собраниях сочинений автора.
Что получилось:
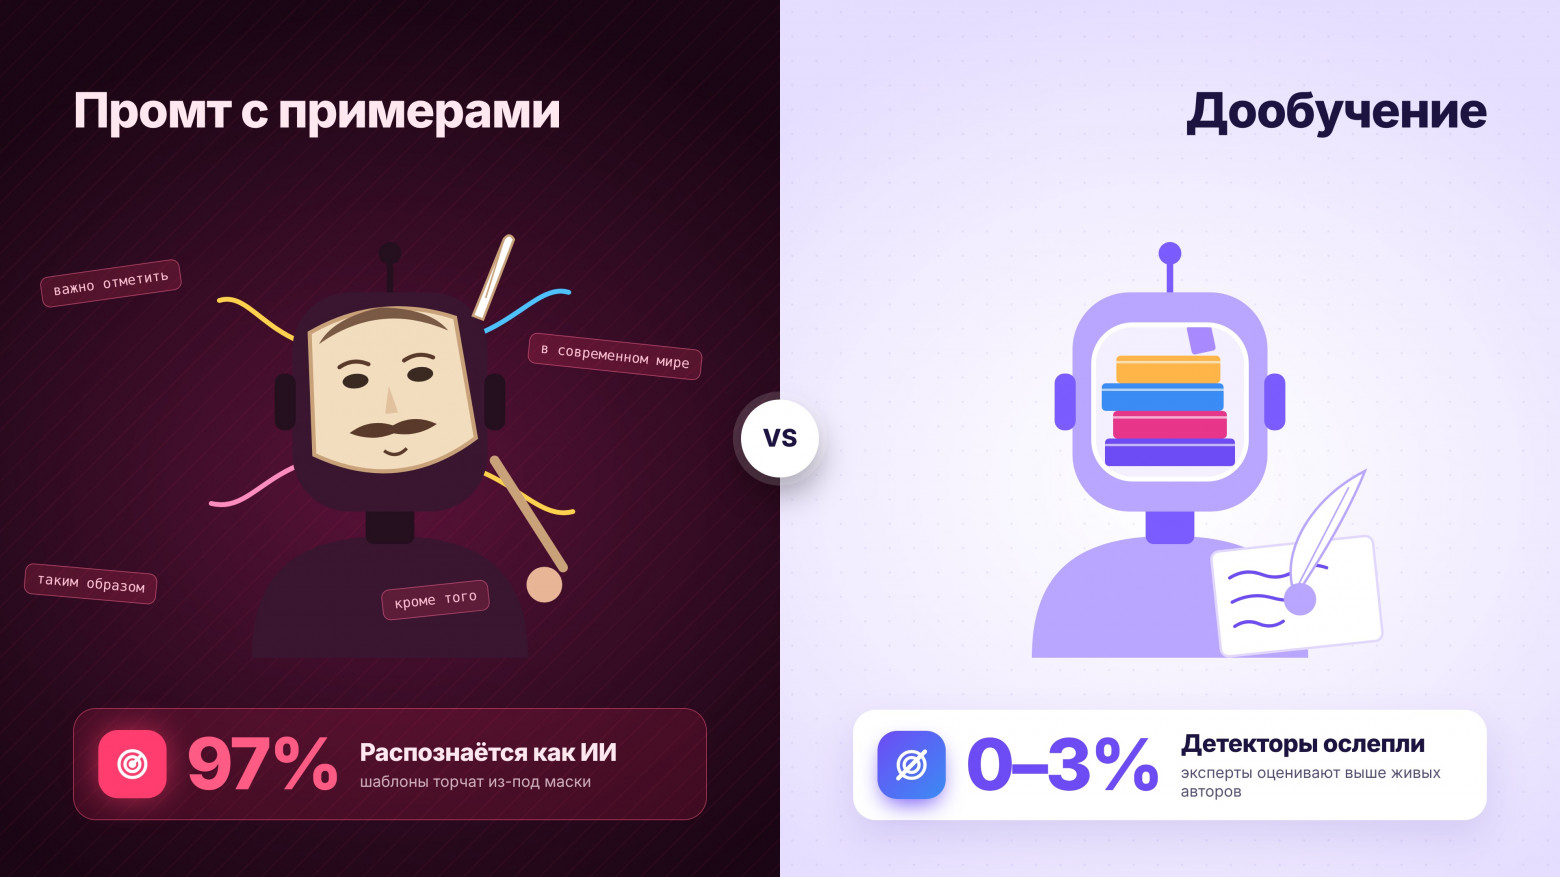
Промпт с образцами. Эксперты сильно предпочитали тексты людей и по стилю, и по качеству. Обычные читатели значимой разницы по стилю не увидели.
Дообучение. Результат перевернулся: эксперты стали предпочитать ИИ-тексты по стилю и качеству, обычные читатели — ещё сильнее.
Детекторы. Тексты, полученные промптом, распознавались как машинные в 97% случаев. После дообучения — только в 3% случаев у детектора Pangram и ни разу у GPTZero.
Анализ показал, что дообучение убирает именно «причуды» ИИ — например, плотность штампов. Медианная стоимость дообучения на одного автора — 81 доллар.
Оговорки существенные: небольшая выборка авторов, короткие отрывки, одна модель. А использование защищённых авторским правом книг для дообучения — юридически спорный вопрос.
Детекторы и люди: кто лучше распознаёт ИИ-текст
Люди без опыта. Читатели, которые сами не пользуются ИИ для письма, угадывают авторство на уровне случайности — около 56,7%.
Опытные пользователи. Пять человек, регулярно работающих с ИИ, при голосовании большинством ошиблись лишь на одном тексте из 300. Это сопоставимо с лучшими коммерческими детекторами и устойчиво к перефразированию. Тестировались GPT-4o, Claude 3.5 Sonnet и o1-pro.
Детекторы. В бенчмарке ARB лучшие детекторы ловили 91–94% «сырого» ИИ-текста, но после повторной обработки той же моделью — около 78–83%. Стандартные тесты переоценивают их устойчивость.
Важно: детектор не доказывает авторство. У всех детекторов есть ложные срабатывания, особенно на текстах людей, пишущих не на родном языке.
Как получить текст, похожий на ваш: пошагово
Исследования показывают, что промптом полностью убрать «машинность» нельзя. Но приблизить текст к своему стилю и сократить правку можно.
Шаг 1. Дайте образцы своих текстов
Три-пять текстов в том же жанре, что и нужный. Новости и деловые письма модель копирует лучше, чем неформальные посты: для неформального стиля образцов нужно больше.
Шаг 2. Опишите стиль словами
Образцы показывают жанр, но модель плохо извлекает из них индивидуальные привычки. Назовите их явно: длина предложений, любимые слова, чего вы никогда не пишете.
Шаг 3. Запретите известные маркеры
Перечислите конструкции, которые сразу выдают ИИ: «не только…, но и…», «это не просто…», вводные «в целом» и «в заключение», тройные перечисления, мораль в конце.
Шаг 4. Попросите несколько вариантов
Модель по умолчанию выдаёт самый типичный вариант. Просьба дать пять разных версий, включая необычные, возвращает часть разнообразия.
Шаг 5. Правьте структуру, слова — во вторую очередь
Замена слов почти не влияет на узнаваемость, а структура — влияет. Уберите вывод, который пересказывает текст, поменяйте порядок аргументов, оставьте неровности.
Шаг 6. Сравните модели
У каждой модели свой отпечаток. Один и тот же промпт в ChatGPT, Claude и Gemini даст тексты с разными привычками — выберите тот, который ближе к вашему.
Промпты для текста в своём стиле
Формула: образцы + явное описание стиля + запрет маркеров + несколько вариантов. Промпты на английском модели понимают точнее, строка «Answer in Russian» даёт ответ на русском.
1. Анализ своего стиля
Here are 5 of my texts. Describe my writing style as specific, observable rules: sentence length, typical words and phrases, how I open and close texts, what I never do. Do not praise, just describe. Answer in Russian.
2. Текст по своим правилам
Using the style rules above, write a post about [topic]. Do not use: "not only... but also", "it's not just... it's", "in conclusion", "overall", lists of three, a moral at the end. Vary paragraph length. Answer in Russian.
3. Несколько непохожих вариантов
Write 5 different versions of the opening paragraph about [topic]. Make at least two of them unusual and unlike a typical AI text. For each, estimate how typical it is from 0 to 1. Answer in Russian.
4. Поиск маркеров в готовом тексте
Review this text and list every phrase, construction or structural habit that makes it sound AI-generated. Suggest a more natural alternative for each. Do not rewrite the whole text. Answer in Russian.
5. Правка структуры
Restructure this text: remove the summary at the end, start with the most specific detail instead of a general statement, and make the paragraphs uneven in length. Keep the meaning. Answer in Russian.
Частые ошибки и как их исправить
Ждать, что образцы скопируют личность. Почему: модель схватывает жанр и регистр, но не идиолект. Как правильно: описать свои привычки словами и запретить чужие.
Бороться с тире. Почему: современные модели почти перестали его ставить, эта примета устарела. Как правильно: смотреть на структуру и обороты, а не на отдельные знаки.
Менять слова и думать, что текст стал «человечным». Почему: отпечаток модели переживает пересказ и перевод, а структура — правку поверхности. Как правильно: перестраивать композицию текста.
Принимать первый вариант. Почему: по умолчанию модель выдаёт самый типичный текст. Как правильно: просить несколько разных версий.
Доверять детектору как доказательству. Почему: у детекторов есть ложные срабатывания, особенно на текстах неносителей языка. Как правильно: считать результат детектора сигналом, а не вердиктом.
Пользоваться устаревшим списком маркеров. Почему: метки меняются с каждой версией модели. Как правильно: датировать чек-листы и обновлять их.
Где сравнить, как пишут разные модели
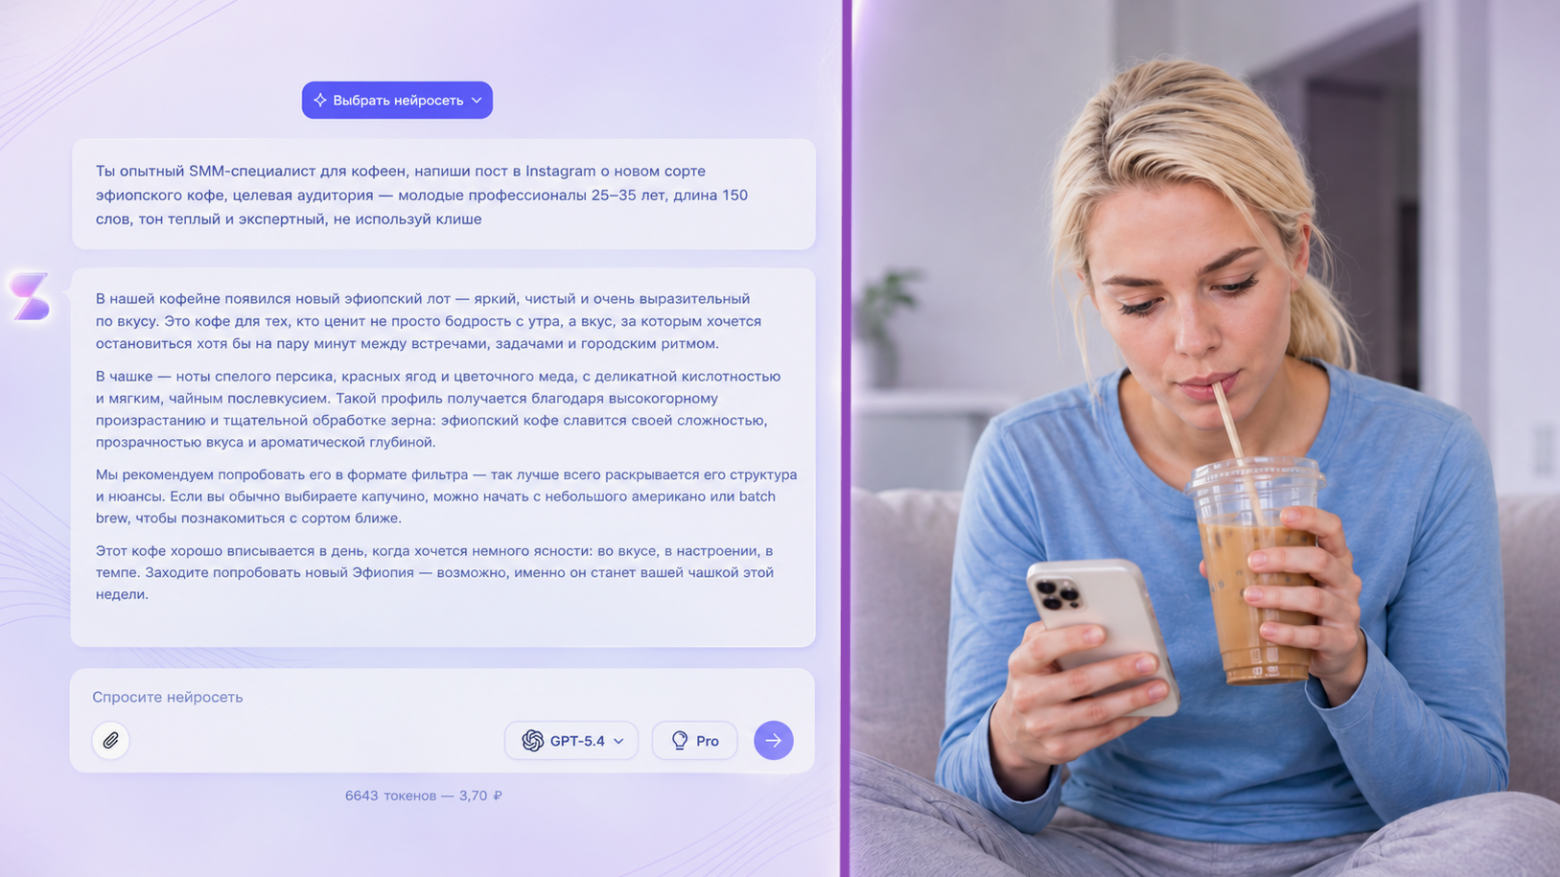
У ChatGPT, Claude, Gemini и DeepSeek разные «отпечатки», поэтому для текста в своём стиле полезно попробовать несколько моделей на одном промпте. В SpeShu.AI они и ещё 300+ моделей собраны в одном окне: можно отправить один запрос с образцами нескольким моделям и выбрать текст, который ближе к вашему. Оплата в рублях через СБП по факту использования, для разработчиков — API с единым ключом. По промокоду HABRSPESHUAI действует бонус 15% к сумме пополнения.
Частые вопросы
Почему нейросеть пишет как нейросеть?
Голос модели формируется при дообучении на человеческих оценках, а оценщики предпочитают типичный текст. Поэтому модели тяготеют к ожидаемым оборотам, аккуратной структуре и выводу в конце, даже когда их просят копировать чужой стиль.
Может ли нейросеть точно скопировать стиль автора?
Промптом с образцами — частично: модель схватывает жанр и формат, но не индивидуальную манеру. В исследовании Колумбийского университета близкого к автору результата добились дообучением модели на полном собрании его текстов.
Длинное тире — признак ИИ-текста?
Уже нет. Современные модели почти перестали его ставить: по оценке Graphite, Claude Opus 5.5 использует тире в сто раз реже человека.
Что сильнее всего выдаёт ИИ-текст?
Структура: объяснение темы вместо показа, аккуратный однолинейный сюжет, проговорённая мораль, симметричные абзацы. Правка отдельных слов это почти не меняет.
Можно ли определить, какая нейросеть написала текст?
В исследованиях классификатор определял одну из пяти моделей с точностью 97%, и отпечаток сохранялся после пересказа и перевода. Но для отдельного текста на практике такая проверка ненадёжна.
Насколько надёжны детекторы ИИ-текста?
На «сыром» ИИ-тексте лучшие детекторы ловят 91–94%, после повторной обработки — около 80%. У всех есть ложные срабатывания, поэтому детектор не доказывает авторство.
Итог
Нейросеть пишет как нейросеть, потому что дообучение на человеческих оценках приучает её к типичному тексту, и промпт с образцами это не исправляет. Слова-маркеры быстро устаревают, а структура остаётся заметной. Ближе к своему стилю помогают явные правила, несколько вариантов, правка композиции и сравнение моделей, например в SpeShu.AI.


Комментарии 0